{count, plural, one {Kursus} other {Kursus}}
Machine Learning dengan caret di R
{hours} jam
60.9K
Jika Anda perlu pengantar machine learning, ikuti kursus Introduction to Machine Learning dari DataCamp dan lihat tutorial Introduction to Machine Learning in Python.
Gunakan berbagai algoritme klasifikasi machine learning (ML) untuk membangun model langkah demi langkah yang memprediksi genre sebuah lagu dan apakah lagu tersebut akan sukses di tangga lagu Billboard — sepenuhnya berdasarkan lirik!
Ini adalah Bagian Tiga dari seri tutorial tiga bagian di mana Anda akan terus menggunakan R untuk melakukan berbagai tugas analitik pada studi kasus lirik musik dari artis legendaris Prince, serta artis dan penulis lainnya. Ketiga tutorial mencakup hal-hal berikut:
Sebagai Data Scientist, Anda perlu memahami pembelajaran terawasi (supervised) dan tidak terawasi (unsupervised). Tutorial ini menjelaskan dan menyediakan studi kasus musik untuk salah satu bentuk pembelajaran terawasi, khususnya klasifikasi, yang didasarkan pada lirik dari berbagai artis (dan beberapa penulis buku). Anda akan belajar cara membangun model untuk mengklasifikasikan lagu ke dalam genre terkaitnya dan menyelidiki kemungkinan menggunakan lirik untuk menentukan keberhasilan komersial.
Pernah menggunakan layanan radio internet streaming musik dan rekomendasi otomatis seperti Pandora, iHeart Radio, Spotify, dll.? Jika Anda menyiapkan stasiun hard rock, Anda mungkin tidak berharap mendengar lagu country tentang sepatu bot koboi dan kota kecil. Sistem rekomendasi musik pada umumnya berfokus pada kualitas suara sementara analisis lirik baru mulai muncul di makalah riset. Dengan teknik dalam tutorial ini, Anda dapat memanfaatkan metode mutakhir yang sedang diteliti para ilmuwan saat ini untuk menghasilkan ide yang memajukan bidang yang sedang berkembang ini.
Tutorial ini mengasumsikan pemahaman dasar tentang penambangan teks menggunakan tidytext. Ini adalah pengantar tingkat menengah untuk teknik machine learning menggunakan beberapa algoritme klasifikasi populer. Disarankan Anda memiliki pengalaman yang cukup dengan pemrograman R, sebaiknya sudah memiliki pengetahuan tentang machine learning dan ingin mempelajari lebih lanjut tentang penerapan serta implementasinya melalui use case langsung. Setiap algoritme hanya dijelaskan secara singkat, tetapi tautan selalu disediakan untuk analisis yang lebih mendalam.
Sepanjang artikel ini, Anda akan menggunakan kerangka kerja eksperimen machine learning di R bernama mlr. Meskipun tutorial ini bukan tentang mlr, Anda akan menggunakannya secara luas sebagai semacam antarmuka ke proses machine learning. Tujuannya adalah untuk menyederhanakan penjelasan berbagai langkah membangun model menggunakan algoritme yang berbeda. Saya sangat merekomendasikan tutorial komprehensif tentang paket ini.
Ada banyak sekali komponen dalam ML dan Anda hanya akan menyentuh permukaannya di tutorial ini. Berbeda dengan Bagian Satu dan Dua dari seri ini, narasi kali ini mungkin membuat Anda memiliki lebih banyak pertanyaan daripada jawaban. Anda akan mendapatkan hasil maksimal jika Anda ikut mencoba dengan data dan kode Anda sendiri, dan meneliti berbagai algoritme dengan kecepatan Anda sendiri.
Berikut garis besar tingkat tinggi langkah-langkah untuk membangun model Anda:
Bagian Satu: Pelajari cara memprediksi genre berdasarkan fitur lirik.
Anda sebaiknya meninjau tutorial sebelumnya untuk benar-benar memahami data dan nuansanya. Perlu diingat bahwa penambangan dan analitik prediktif pada lirik jauh lebih rumit dibandingkan nonfiksi karena konteks, makna, dan pesan halus sering tersembunyi di balik nuansa kreatif yang disiratkan penulis lagu. Seperti pada Bagian Dua-B tentang topic modeling, Anda akan terus bekerja dengan artis dari genre berbeda dan dengan konten dua buku tentang machine learning (dengan genre data science — untuk tujuan memperkenalkan bentuk teks lain).
Mulailah dengan memuat pustaka, lalu lihat struktur keseluruhan datanya.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Seperti pada tutorial sebelumnya, kode untuk plot lingkaran di bawah ini bisa terlihat rumit, tetapi saya sulit menolak grafik yang keren. Ini menampilkan sampul album/buku untuk masing-masing artis/penulis dalam data Anda. Ini mencakup dataset uji dan latih. Untuk detail lebih lanjut tentang paket circlize, lihat buku ini oleh Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)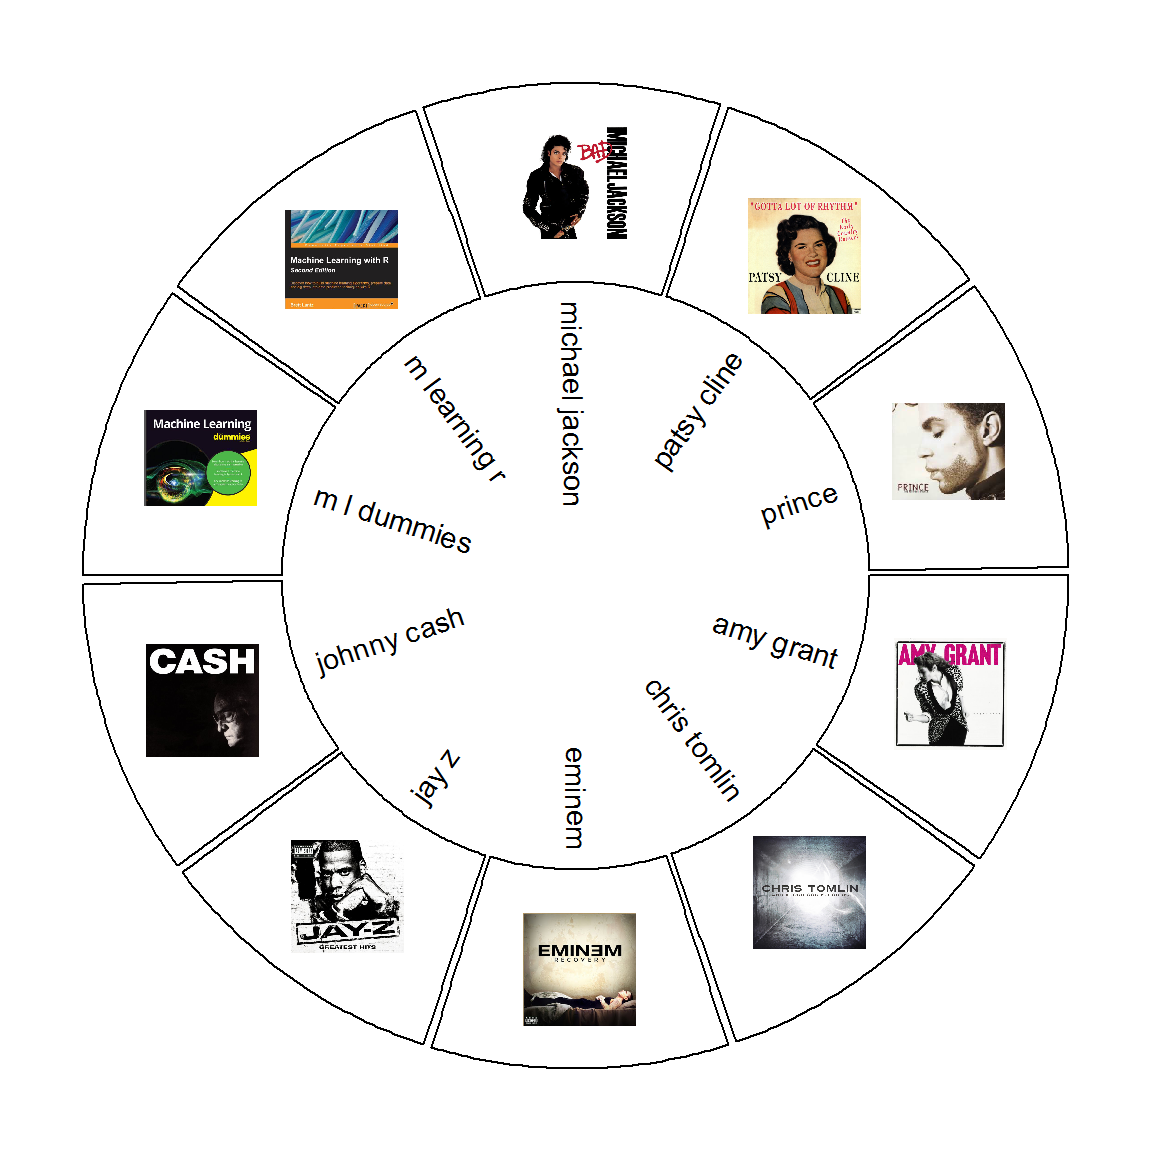
Untuk berfokus pada pemodelan, saya telah melakukan conditioning data di luar tutorial ini dan menyediakan semua data yang Anda perlukan untuk analisis. Berikut ringkasan pra-pemrosesan:
pdf_text() dari paket pdftools untuk mengumpulkan konten dua buku (setiap halaman merepresentasikan dokumen yang berbeda)Di bawah ini Anda akan membaca data latih dan uji yang sudah dipisah agar Anda muat secara terpisah. Lalu gunakan unnest() dari tidytext untuk membuat versi rapi dengan satu kata per rekaman.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Sekarang setelah data latih dan uji dimuat dan dirapikan, Anda dapat melihat berapa banyak lagu per artis/penulis. Karena dataset berisi lagu dan halaman buku, saya akan menyebut masing-masing sebagai dokumen. Fitur yang akan Anda buat didasarkan pada dokumen dan metadata terkaitnya, jadi penting untuk memahami konsep ini. Selain itu, karena ada artis dan penulis, saya akan menyebut mereka sebagai sumber setiap dokumen.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")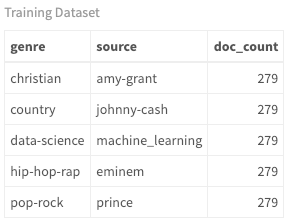
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")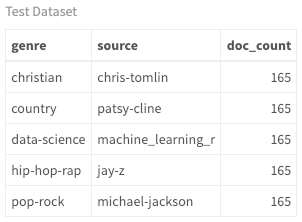
Meskipun Anda dapat melihat genre, sumber, dan jumlah dokumen, diagram kord berikut adalah cara yang lebih baik untuk melihat hubungan ini. Sepanjang tutorial, Anda dapat melihat progres bagaimana hubungan ini berubah dengan model baru Anda. Saat ini ada hubungan satu banding satu antara sumber dan genre karena artis dikelaskan dengan cara ini; namun, artis lintas-genre sangat umum, dan Anda akan melihat buktinya saat melihat versi diagram ini di bagian selanjutnya.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")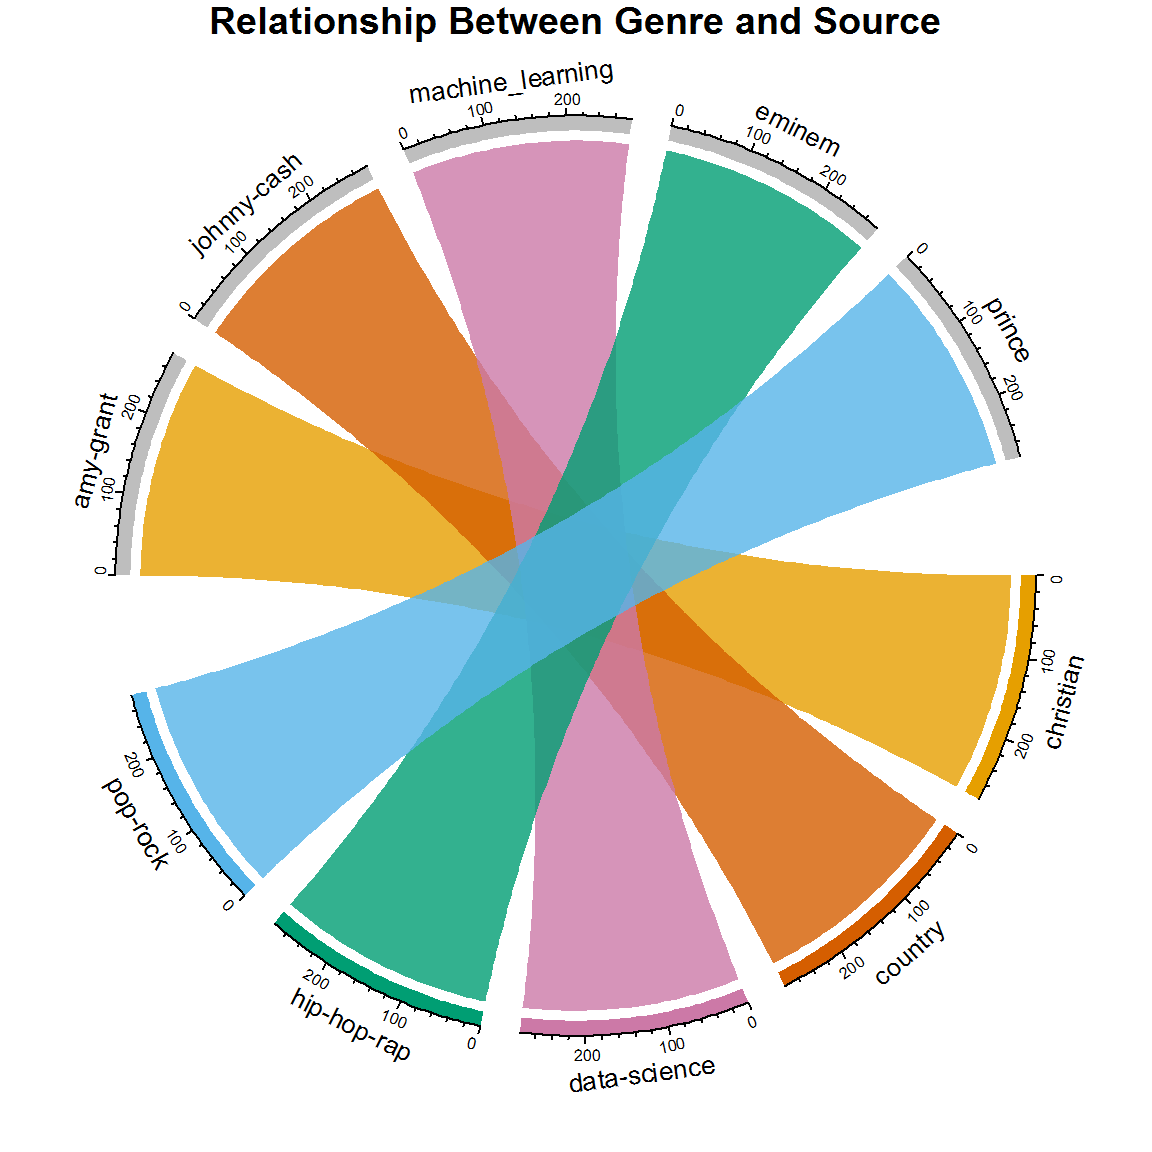
Pikirkan seperti apa diagram ini jika tidak ada hubungan satu banding satu. Jika Anda memprediksi genre hanya berdasarkan lirik, menurut Anda apa yang akan terjadi?
Jika satu-satunya yang Anda miliki untuk mengklasifikasikan lagu adalah lirik, bagaimana Anda akan menghasilkan variabel prediktor? Pertama pikirkan tentang lagu dan apa yang membuat satu lagu berbeda dari yang lain secara lirik. Tema umum di semua musik adalah repetisi. Apakah beberapa genre menggunakan repetisi lebih banyak daripada yang lain? Bagaimana dengan panjang kata? Apakah beberapa lebih sering memakai kata yang lebih panjang atau lebih pendek? Faktor lain apa yang dapat Anda pikirkan untuk mendeskripsikan lirik? Jika Anda mendapatkan hitungan ini per lagu, Anda memiliki set prediktor pertama!
Perhatikan bahwa semua variabel yang disebutkan di atas adalah fitur kuantitatif (jumlah, panjang, dll.) berdasarkan kata per lagu. Tetapi bagaimana dengan kata-kata individual yang spesifik untuk genre? Di tutorial sebelumnya, Anda mengerjakan analisis sentimen dan topic modeling. Aktivitas tersebut berfokus pada kata-kata yang spesifik untuk artis atau genre tertentu. Jadi jika Anda melangkah lebih jauh, Anda dapat membuat beberapa komponen prediktif terpenting yang didasarkan pada konten (atau konteks). Ini adalah langkah kreatif yang spesifik untuk analitik teks dan menghasilkan prediktor krusial bagi model Anda.
Pertama, Anda ingin mendapatkan kata-kata yang paling umum (sering digunakan) per genre. Ini telah dilakukan pada tutorial Bagian Satu. Mulailah dengan mendapatkan jumlah total kata per genre. Lalu kelompokkan berdasarkan kata per genre dan hitung seberapa sering setiap kata digunakan. Sekarang pilih n kata paling sering yang ditentukan oleh variabel number_of_words. Ini bagian yang rumit: berapa banyak kata yang harus Anda pilih? Jika tidak memilih cukup banyak, Anda tidak akan mengoptimalkan model, tetapi jika memilih terlalu banyak, Anda akan overfit dan mendistorsi hasil. Ini relatif rumit untuk dijelaskan, tetapi solusi nyatanya adalah trial and error. Saya mendapatkan total 5500 sebagai jumlah kata yang paling optimal. Cobalah ubah nilai ini dan lihat dampaknya pada hasil Anda. Anda mungkin menemukan hasil yang lebih baik! Jika langkah ini belum sepenuhnya jelas, tetap ikuti dan nanti akan makin masuk akal.
Banyak kata sangat umum di lebih dari satu genre (seperti time, life, dll.) dan saya telah menghapus kata-kata ini dengan variabel multi_genre di bawah. Ini menghasilkan daftar kata yang lebih bersih dan berbeda untuk menciptakan pembedaan yang lebih baik antar sumber.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Sekarang gunakan kata-kata spesifik genre sebagai fitur dalam dataset Anda. Karena Anda akan membuat fitur untuk beberapa dataset, buat fungsi agar Anda hanya perlu menuliskannya sekali. Dalam fungsi ini, Anda melihat referensi ke keragaman dan kerapatan leksikal. Lihat Bagian Satu untuk penjelasan konsep ini.
Pikirkan setiap fitur di bawah ini dan bagaimana bisa bervariasi menurut genre. Alih-alih menjelaskan setiap fitur, saya akan fokus pada langkah-langkah machine learning selanjutnya, jadi luangkan waktu sebentar untuk meninjau kode dan memahami apa yang dilakukannya. Dan jangan lupa prediktor spesifik genre yang krusial. Sebagai contoh, country_word_count hanyalah hitungan kata country teratas yang muncul di tiap lagu. Perhatikan bahwa saya memberikan bobot lebih pada kata eksplisit dan buku (lihat angka 10 dan 20 yang digunakan dalam fungsi sum()). Saya melakukan ini karena kata-kata tersebut sangat khas dan membantu mengklasifikasikan dokumen. Sekali lagi, ini hasil dari proses coba-coba!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Sekarang panggil fungsi features() untuk dataset latih dan uji Anda.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Jika Anda belum pernah menggunakan paket mlr sebelumnya, tidak masalah. Anda akan melangkahinya tahap demi tahap dan melihat bahwa ini sebenarnya proses yang lugas. Sekali lagi, saya sangat menyarankan meninjau tutorial ini karena ini dokumentasi paling komprehensif yang dapat Anda temukan tentang paket ini. Anda juga bisa mengunjungi mlr.org.
mlr (Machine Learning for R), adalah kerangka kerja yang mencakup semua algoritme machine learning yang sering digunakan. Alih-alih menjelaskan teori di balik setiap algoritme, saya akan fokus pada implementasinya. Di akhir tutorial ini, Anda akan telah menggunakan banyak alat klasifikasi, dan Anda akan mendapatkan hasil maksimal jika berlatih bersama kode yang disajikan di sini.
Setelah Anda melakukan rekayasa fitur, proses ML sederhana: buat task, buat learner, latih, uji. Berikut langkah-langkah yang akan Anda lakukan:
Sebuah task hanyalah dataset tempat seorang learner belajar. Karena ini masalah klasifikasi, Anda akan membuat classification task dengan menggunakan makeClassifTask(). Anda perlu menentukan variabel hasil klasifikasi Anda, genre, dengan meneruskannya sebagai argumen target.
Saya membuat tiga task di bawah ini, masing-masing dengan tujuan berbeda. Test dan train sudah jelas, tetapi ada juga dataset yang hanya menggunakan fitur kuantitatif dasar yang terdiri dari ringkasan dan hitungan dokumen. Task task_train_subset ini dibuat tanpa fitur jumlah kata per genre (misalnya, country_word_count, pop_rock_word_count, dll.) untuk mengilustrasikan pentingnya prediktor kontekstual ini dalam model akhir. Jadi menggunakan dataset train[3:13] menghapus variabel-variabel tersebut. Juga, Anda selalu ingin menghapus kolom teks saat membuat classifier task. Dalam kasus ini, kolom tersebut berada pada posisi satu dan dua dalam dataframe.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
                             data = test[-c(1:2)], target = "genre")
Normalisasi data adalah topik yang memerlukan sedikit penyelidikan, tidak selalu diperlukan, dan tergantung pada dataset; namun, dalam kasus ini, bermanfaat. Ini hanyalah metode penskalaan data sehingga semua nilai dinormalisasi antara nol dan satu (atau nilai lain yang Anda tentukan). Jika beberapa variabel memiliki nilai jauh lebih besar dan dalam skala berbeda dari yang lain, mereka akan mengacaukan model Anda dengan memberikan bobot lebih pada variabel tersebut. Normalisasi mengatasi masalah ini. Berikut thread yang bagus tentang topik ini. Ini jelas layak diselidiki lebih lanjut karena merupakan langkah penting dalam pra-pemrosesan. mlr menyediakan fungsi sederhana bernama normalizeFeatures() untuk langkah ini.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Seorang learner di mlr dibuat dengan memanggil makeLearner(). Di konstruktor, Anda perlu menentukan metode pembelajaran yang ingin digunakan. Anda dapat memperoleh daftar kemungkinan algoritme klasifikasi dengan memanggil listLearners("classif")[c("class","package")]. Ini menunjukkan algoritme yang dapat Anda pilih serta paket dependensinya (yang mungkin perlu Anda pasang secara terpisah).
Untuk latihan ini, saya memilih daftar yang dapat menangani lebih dari dua kelas dan akan memberi Anda berbagai teknik, dari decision tree hingga random forest, support vector machine, gradient boosting, dan neural network. Ada banyak learner yang bisa dipilih (saat ini ada lebih dari 80 learner klasifikasi di mlr), dan saya mendorong Anda untuk mencobanya!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)
Resampling adalah alat esensial dalam machine learning dan pantas mendapatkan tutorial terpisah. Untuk saat ini, pemahaman dasarnya dapat membantu Anda melalui langkah ini. Ini melibatkan pengambilan sampel berulang dari training set dan memasang ulang model pada setiap sampel. Ini memungkinkan Anda memperoleh informasi yang tidak tersedia jika hanya memasang model sekali dengan data latih asli.
Ada beberapa metode resampling, tetapi di sini Anda akan menggunakan yang disebut k-fold cross validation yang ditunjukkan oleh "CV" pada pemanggilan makeResampleDesc() yang mengembalikan objek deskripsi resample (rdesc). Pendekatan ini secara acak membagi dataset menjadi k kelompok (fold) berukuran sama. Fold pertama digunakan sebagai set validasi, dan fold sisanya digunakan untuk pelatihan. Ini diulang k kali pada masing-masing fold. Tingkat kesalahan ditangkap untuk setiap iterasi dan dirata-ratakan di akhir.
Ini mungkin terdengar asing jika ini pertama kali Anda berurusan dengan resampling, tetapi ini adalah langkah awal yang penting untuk membiasakan diri dengan konsepnya! Anda akan menggunakan 10-fold cross-validation pada contoh di bawah. "Untuk klasifikasi, biasanya diinginkan memiliki proporsi kelas yang sama di setiap fold." (Sumber) Gunakan stratify = TRUE untuk memastikan hal ini terjadi.
Untuk informasi lebih lanjut tentang resampling dalam mlr, lihat artikel ini.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)Tujuan tipikal klasifikasi adalah memperoleh akurasi prediksi yang tinggi dan meminimalkan jumlah kesalahan. Dalam pengertian ini, semua jenis kesalahan klasifikasi dianggap berbobot sama. Namun, dalam banyak aplikasi, jenis kesalahan yang berbeda memiliki dampak lebih besar daripada yang lain. Misalnya, jika Anda mengklasifikasikan apakah pasien mengidap penyakit atau tidak, salah klasifikasi yang tidak mengidentifikasi penyakit padahal sebenarnya ada dapat mengancam nyawa. Ukuran kinerja yang berbeda mengatasi nuansa ini. Namun, untuk analisis lirik Anda akan terutama melihat ukuran dasar akurasi dan error. Ingat bahwa akurasi dan error rate tidak selalu menjadi pilihan terbaik untuk mengevaluasi ketangguhan model. Ini topik penting yang juga pantas dibahas lebih lanjut di luar tutorial ini.
Akurasi adalah jumlah prediksi benar dari semua prediksi yang dibuat. Untuk memeriksa salah klasifikasi oleh model Anda, Anda juga akan melihat confusion matrix guna melihat bagaimana sesuatu diklasifikasikan (prediksi vs aktual). Lebih lanjut tentang itu sebentar lagi. Sekarang, siapkan daftar ukuran yang diminati. Saya menambahkan tiga ukuran di sini, tetapi Anda hanya akan melihat acc. Tautan ini akan memberi Anda lebih banyak informasi dan penjelasan tentang ukuran kinerja.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)Di mlr, Anda dapat melakukan eksperimen benchmark di mana algoritme berbeda (metode pembelajaran) diterapkan pada dataset Anda. Ini memungkinkan Anda membandingkan algoritme sesuai ukuran yang diminati (mis., akurasi). Anda akan menjalankan benchmark() untuk melatih model dan menghasilkan objek BenchmarkResult yang darinya Anda dapat mengakses model dan hasil.
Akhirnya, saatnya membangun model. Mulailah dengan task yang Anda buat yang tidak menyertakan jumlah kata spesifik genre. Teruskan ke benchmark daftar learner Anda, task subset, strategi resampling (rdesc), dan daftar ukuran yang ingin Anda lihat.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Jika Anda melihat objek BenchmarkResult, Anda dapat melihat acc.test.mean untuk masing-masing algoritme yang Anda berikan. Perhatikan ini secara spesifik merujuk ke test. Ini adalah akurasi rata-rata di seluruh sampel untuk validation dataset yang digunakan dalam cross-validation saat Anda melatih model. Ini tidak sama dengan test dataset yang akan Anda gunakan nanti. Ini topik lain yang pantas dijelaskan panjang lebar, tetapi ingat saja ada serangkaian validation dataset yang ditahan selama cross-validation, dan test dataset yang akan Anda gunakan setelah Anda memutuskan algoritme dan melakukan tuning model.
Dalam eksperimen benchmark ini, Anda dapat melihat bahwa Random Forest berkinerja terbaik di r rf_perf persen (dan membutuhkan waktu terlama untuk dilatih). Dengan nilai itu dalam ingatan, jalankan ulang eksperimen ini pada set fitur lengkap.
Kali ini teruskan task yang menyertakan jumlah kata spesifik genre per dokumen. Ini menambahkan fitur yang menunjukkan apakah sebuah lagu memiliki lebih banyak kata country, atau pop-rock, dll. Ingat, menggunakan dataset berlabel Anda, Anda memilih kata hip-hop paling umum dan menaruhnya dalam daftar bernama hip_hop_words. Ini berisi kata seperti thug, crib, dan drug. Daftar kata country berisi hal-hal seperti lonesome, coal, drunken, dan cattle. Anda paham maksudnya.
mlr menyediakan beberapa metode untuk mengakses hasil benchmark. Saya akan menggunakan beberapa saja, tetapi untuk membiasakan diri dengan objek benchmark, saya sarankan menggunakan fungsi getter getBMR*. Jika Anda memanggil str() pada objek benchMark Anda, Anda akan menunggu cukup lama hingga detailnya ditampilkan!
Sebelum melihat secara detail set fitur lengkap, luangkan waktu untuk melakukan benchmark beberapa task dan membandingkan set fitur lengkap dengan subset fitur di atas menggunakan fungsi getter plotBMRSummary(). Lakukan ini dengan membuat daftar task untuk diteruskan ke benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)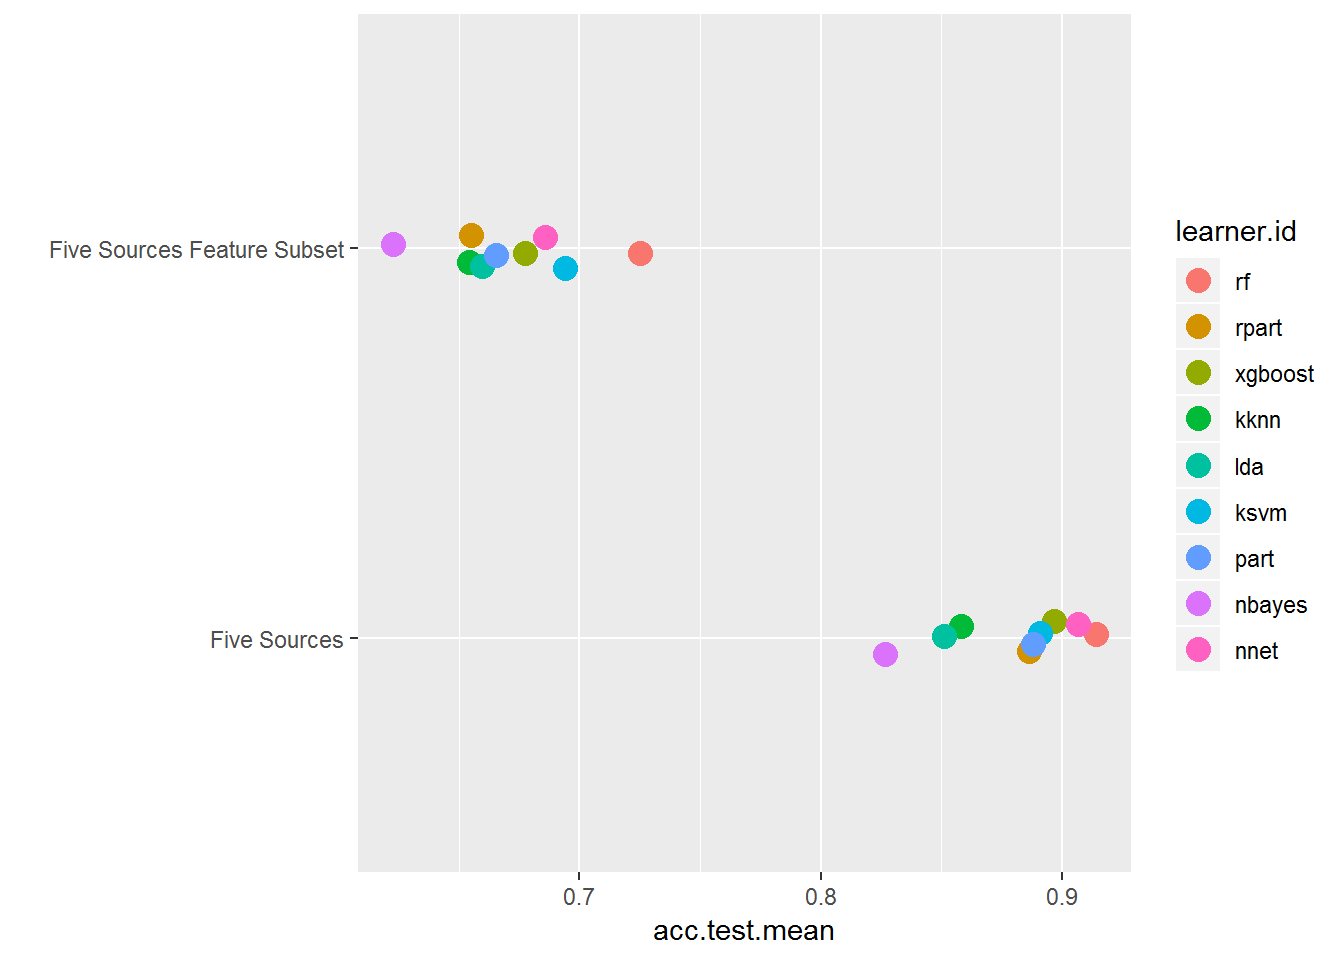
Di sini Anda dapat melihat bahwa acc.test.mean dari subset pelatihan tanpa jumlah kata spesifik genre per dokumen lebih rendah daripada dataset fitur lengkap. Ini menunjukkan bahwa fitur-fitur ini sangat berpengaruh! Melakukan langkah kreatif kecil ini adalah sesuatu yang hanya akan Anda lihat dalam machine learning menggunakan teks. Simpan trik ini untuk proyek Anda sendiri.
Meskipun Anda bisa mengakses hasil pelatihan dari bmr_multi_task, lanjutkan untuk melakukan benchmark lagi hanya dengan task pelatihan dan kemudian lihat lebih dekat hasilnya menggunakan getBMRAggrPerformances() dan plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)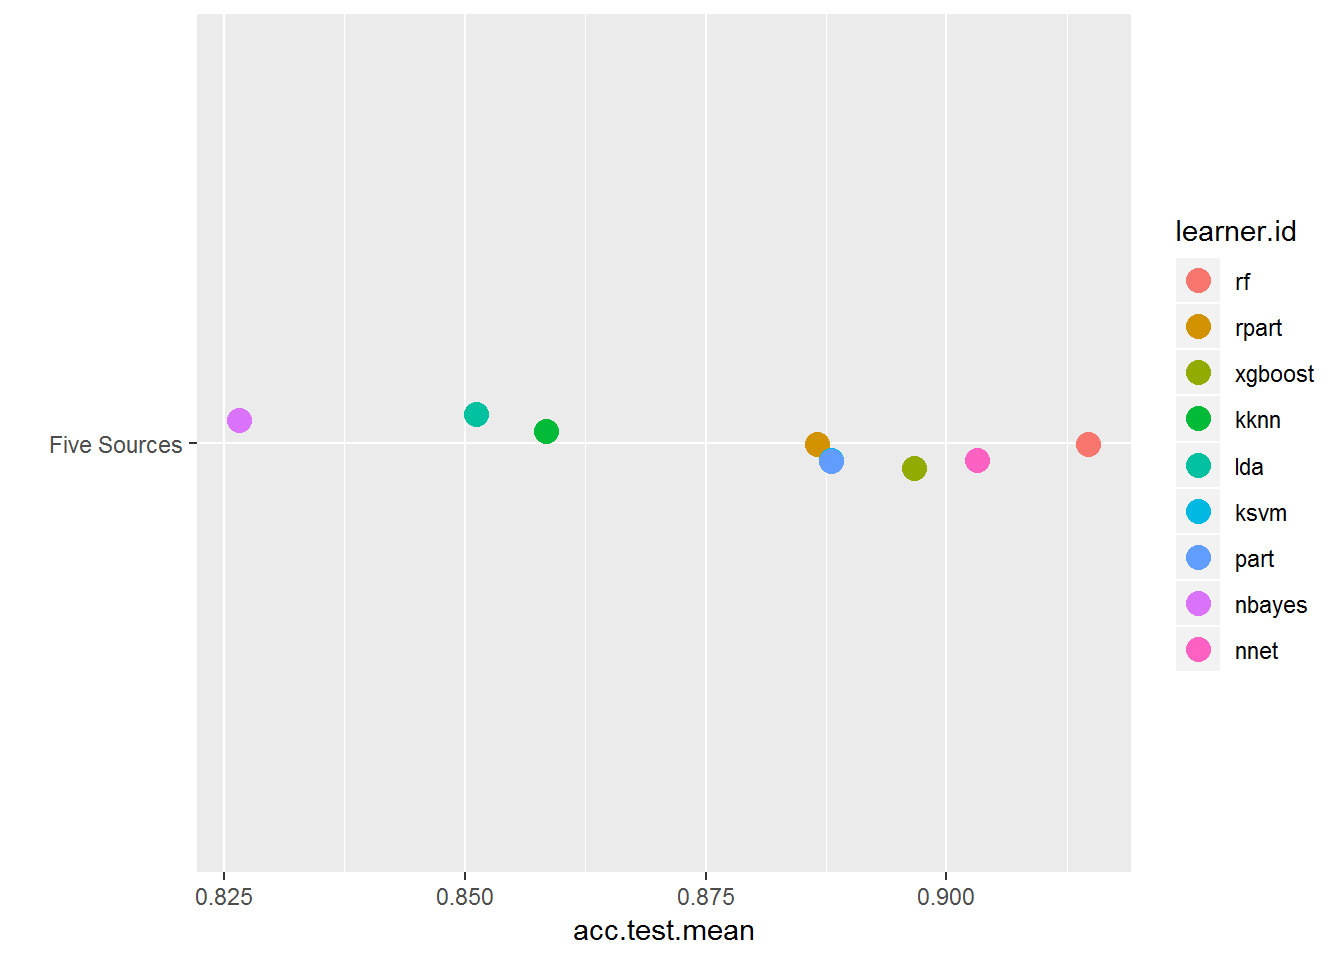
Ini memungkinkan Anda memperbesar hasil dataset dengan fitur lengkap. Sekarang Anda dapat lebih jelas melihat perbedaan antar algoritme dan bagaimana random forest mengungguli yang lain.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))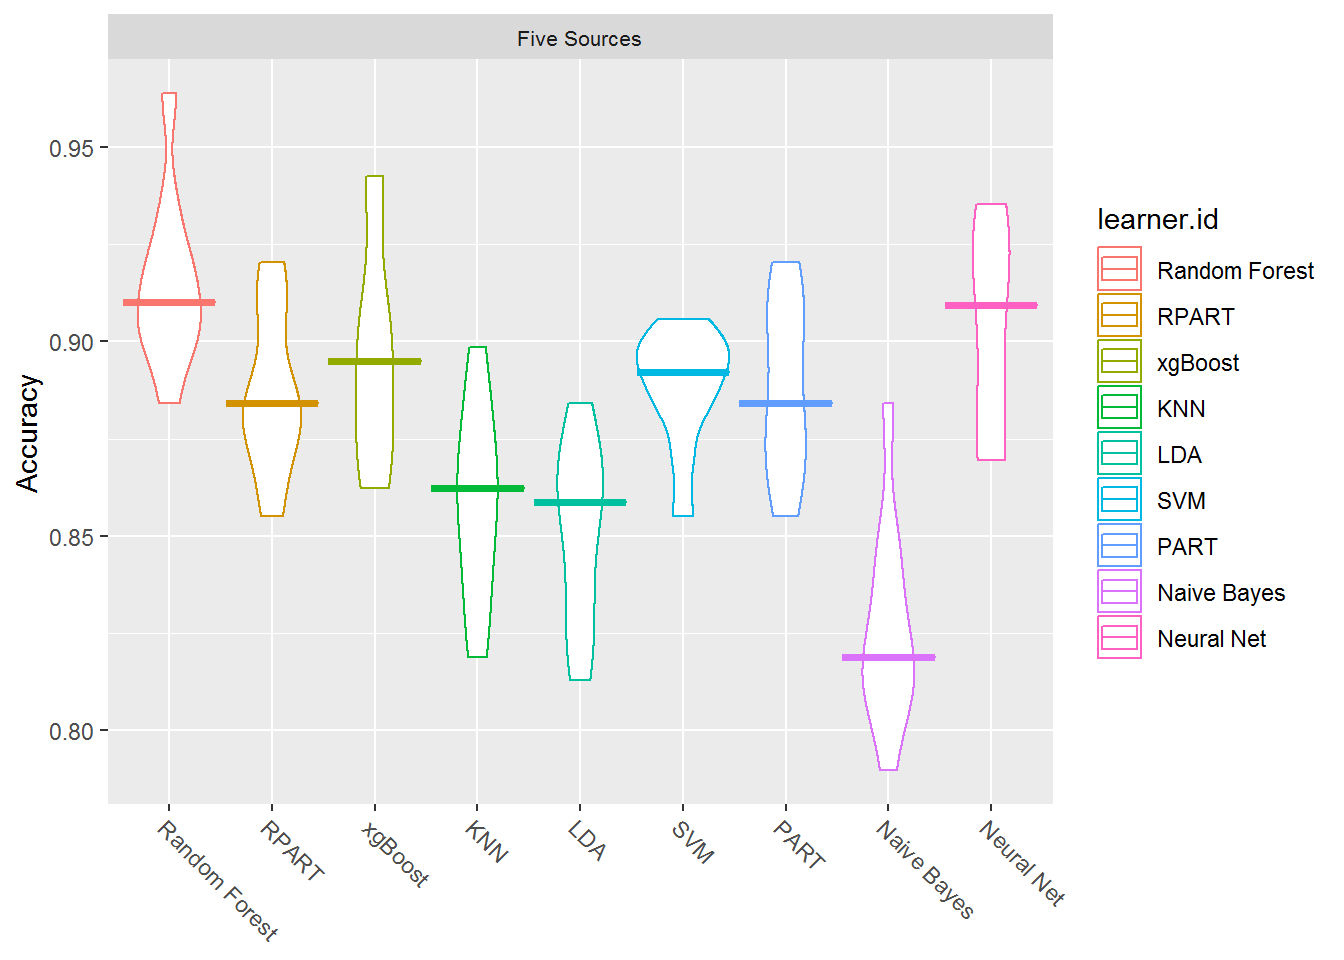
Boxplot ini menampilkan hasil untuk setiap metode di beberapa iterasi yang dilakukan oleh benchmarking.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")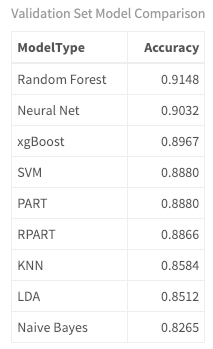
Di sini Anda dapat melihat akurasi tertinggi ada pada Random Forest, Neural Net, dan xgBoost dengan akurasi r first_three persen, masing-masing. Jadi apa yang sebenarnya terjadi pada modelnya? Bagaimana dokumen/lagu ini benar-benar diklasifikasikan? Genre mana yang paling sulit diklasifikasikan berdasarkan lirik? Untuk mendapatkan wawasan lebih lanjut, lihat confusion matrix dari prediksi. Dalam matriks ini, jumlah dokumen yang diklasifikasikan dengan benar muncul pada diagonal. Dokumen yang salah klasifikasi berada di luar diagonal. Hitungan observasi error ada di margin. Kolom merepresentasikan nilai prediksi, dan baris merepresentasikan nilai sebenarnya. Gunakan getBMRPredictions() untuk mengakses prediksi training/validation set. Kemudian lihat result dari confusion matrix model Random Forest yang dapat Anda akses menggunakan id Five Sources yang Anda beri label sebelumnya sebagai task pelatihan Anda. (Perhatikan bahwa Anda dapat melakukan ini untuk model apa pun dalam hasil benchmark.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")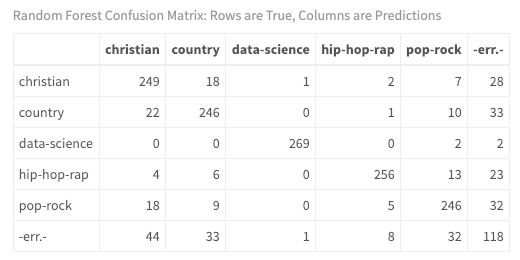
Akhirnya Anda memiliki wawasan tentang model Anda! Seperti yang mungkin Anda harapkan, dengan hanya satu salah klasifikasi, relatif mudah membedakan dokumen data science dari lirik lagu menggunakan fitur metadata tekstual yang Anda rancang. Selain itu, hip-hop-rap sangat berbeda dari genre musik lainnya dengan hanya delapan salah klasifikasi. Namun, meskipun kinerjanya cukup mengesankan, ada perbedaan yang lebih kecil antara lirik musik country, Christian, dan pop-rock.
Tujuan tutorial ini bukan hanya untuk mendapatkan pemaparan teknik machine learning prediktif tetapi juga melakukan analisis lirik sebagai kelanjutan dari tutorial sebelumnya dalam seri ini. Jadi pikirkan apa arti hasil ini. Jika Anda mengembangkan sistem rekomendasi yang dilengkapi dengan wawasan lirik, pertimbangan apa yang harus Anda ambil? Adakah kemungkinan sistem Anda merekomendasikan artis hip hop dengan lirik eksplisit kepada pendengar musik Christian atau penggemar musik country?
Ingat diagram kord di awal tutorial? Lihat lagi, kali ini dengan prediksi alih-alih label sebenarnya.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")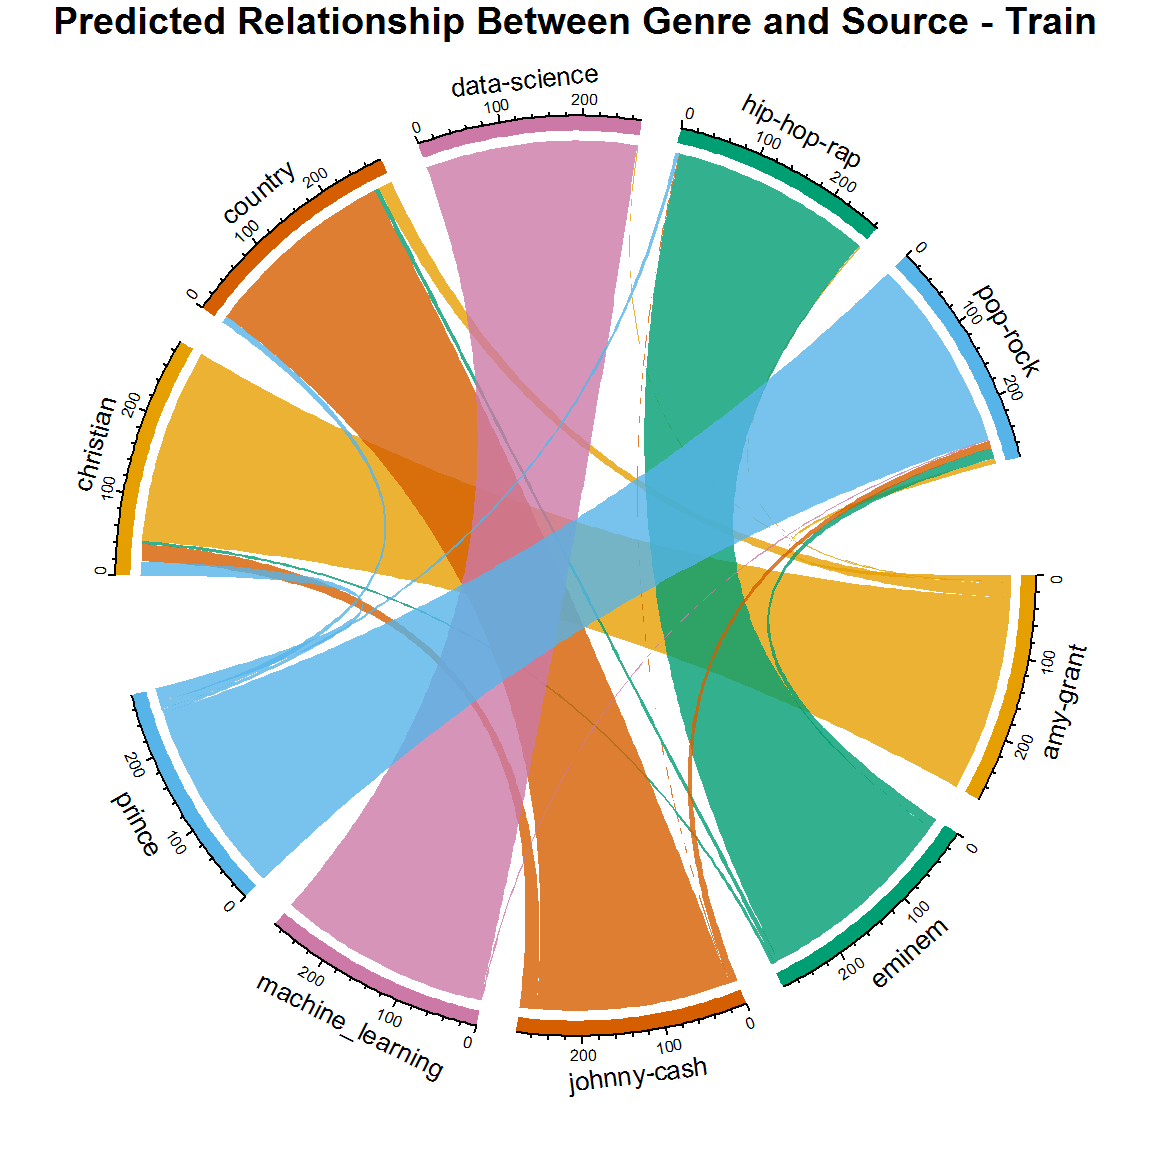
Keren, ya. Sekarang Anda dapat melihat seberapa baik performa Anda pada data pelatihan. Sekali lagi hasilnya mengesankan. Garis-garis kecil merepresentasikan salah klasifikasi. Namun inilah mungkin konsep terpenting yang bisa Anda ambil dari tutorial ini: meskipun ini adalah hasil akurasi validation set, ini tetap didasarkan pada dataset pelatihan berlabel! Jika tidak berhati-hati, Anda bisa overfit model Anda dan memperkenalkan varians tinggi. Varians tinggi berarti algoritme pembelajaran Anda sangat bervariasi tergantung pada data yang Anda berikan. Ini bisa berarti algoritme Anda mungkin tidak tahan terhadap noise yang dapat diperkenalkan oleh data baru yang belum pernah dilihat sebelumnya. Anda akan menjalankan uji sejati model sebentar lagi ketika Anda memberinya data yang benar-benar baru.
Sebelum menguji data baru, Anda akan memilih salah satu model dan melakukan tuning. Anda akan melakukannya dengan menyesuaikan hyperparameter-nya. Ini hanyalah istilah untuk mengonfigurasi parameter model Anda agar meningkatkan kinerjanya. Jika Anda baru-baru ini mengunjungi Kaggle, Anda mungkin memperhatikan algoritme trendi bernama extreme gradient boosting yang mendominasi kompetisi. Meskipun bukan model berkinerja teratas dalam benchmark kita, saya tetap akan memilihnya untuk dituning dan dijalankan pada dataset uji. Jika Anda baru dengan jenis algoritme ini, tuning mungkin bagian tersulit. Mengingat cakupan tutorial ini, saya tidak dapat membahas konsep di balik extreme gradient boosting atau bahkan hyperparameter-nya, tetapi kode di bawah akan memberi Anda titik awal. Saya sangat menyarankan meninjau konsep gradient boosting sebelum terlalu jauh melakukan tuning parameter. Tautan ini menyediakan artikel bagus oleh Prince Grover untuk memulai. Seperti yang ia jelaskan, berikut ringkasan umum gradient boosting klasik:
Pertama modelkan data dengan model sederhana dan analisis error data. Error ini menandakan titik data yang sulit dipasangi model sederhana. Lalu pada model-model berikutnya, fokus khususnya pada data yang sulit dipasangi model agar menjadi tepat. Pada akhirnya, gabungkan semua prediktor dengan memberi bobot pada masing-masing prediktor.
(Catatan sampingan: nilai maxit sebesar 150 pada makeTuneControlRandom() di bawah memerlukan waktu cukup lama. Anda mungkin ingin memulai dengan sesuatu yang jauh lebih kecil untuk memulai.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Anda dapat memeriksa parameter yang dioptimalkan dengan melihat keluaran tuneParams(). Sekarang Anda ingin membuat model baru menggunakan hyperparameter yang telah dituning dan kemudian melatih ulang pada dataset pelatihan.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))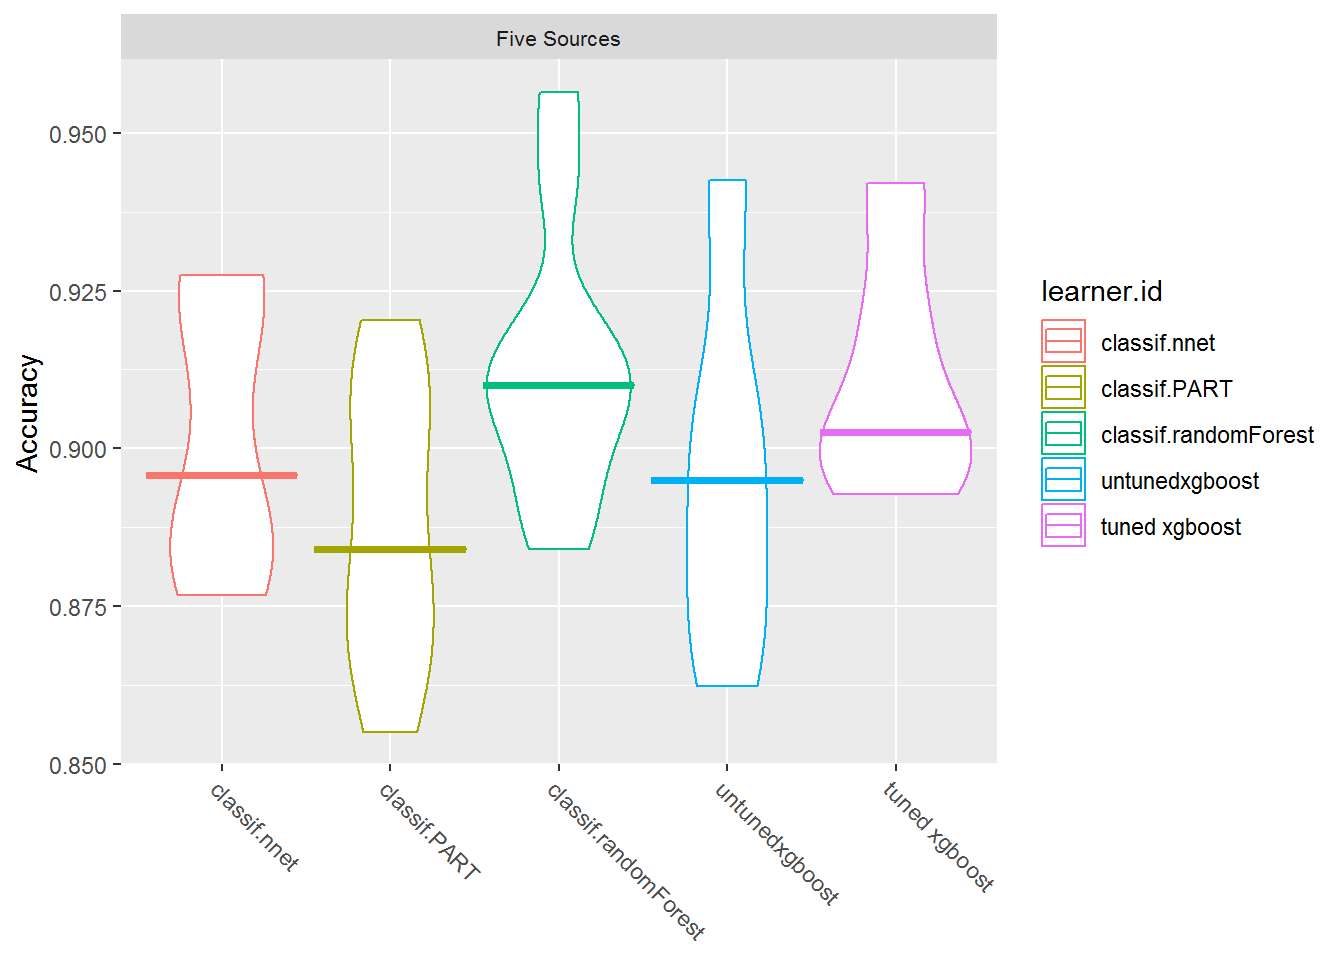
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")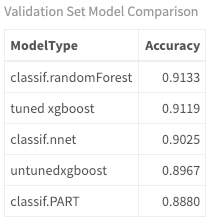
Model xgBoost yang dituning hanya sedikit lebih tinggi dibandingkan yang tidak dituning dan masih belum seakurat random forest. Tetapi bagaimana performanya pada data uji?
Sekarang setelah Anda memiliki model yang dituning dan benchmark, Anda dapat memanggil predict() untuk tiga model teratas Anda pada dataset uji yang belum pernah dilihat sebelumnya. Ini mencakup lima sumber yang benar-benar berbeda seperti ditampilkan sebelumnya. Lihat performanya dan klasifikasi aktualnya.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Hasil ini cukup menarik. Meskipun random forest memiliki akurasi lebih tinggi pada data pelatihan dibandingkan xgBoost yang dituning, akurasinya sedikit lebih rendah pada dataset uji. Akurasi uji untuk neural net juga jauh lebih rendah daripada saat pelatihan. Neural net bisa sangat fleksibel dan akibatnya dapat overfit pada set pelatihan.
Pada tingkat akurasi r round(test_perf,2)*100% untuk xgBoost yang dituning, masih ada penurunan kinerja yang dramatis pada data uji dibandingkan pelatihan dan tuning hanya memberikan sedikit peningkatan (menggunakan konfigurasi minimal ini!). Penurunan akurasi antara train dan test ini sangat umum dan inilah tepatnya alasan Anda harus menguji model pada data baru.
Sekarang, lihat klasifikasi aktualnya.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")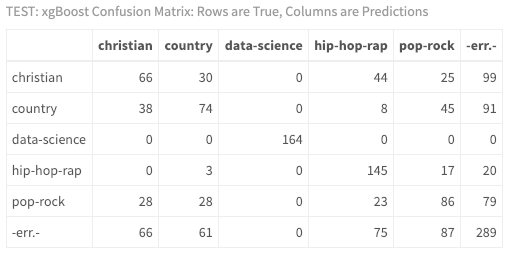
Melihat confusion matrix, kini Anda dapat melihat bahwa jauh lebih sulit mengklasifikasikan artis hip hop ini, Jay-Z. Tidak masalah jika Anda tidak mengenal musiknya, hasil Anda menunjukkan bahwa mungkin ada perbedaan antara artis yang digunakan untuk melatih model Anda Eminem, dan Jay-Z yang digunakan dalam data uji. Idealnya, Anda akan memiliki lebih banyak data, lebih banyak artis, lebih banyak tuning, dan Anda akan menjalankan model berkali-kali!!
Namun, pikirkan apa yang bisa ditunjukkan hal ini. Lihat lagi diagram kord:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")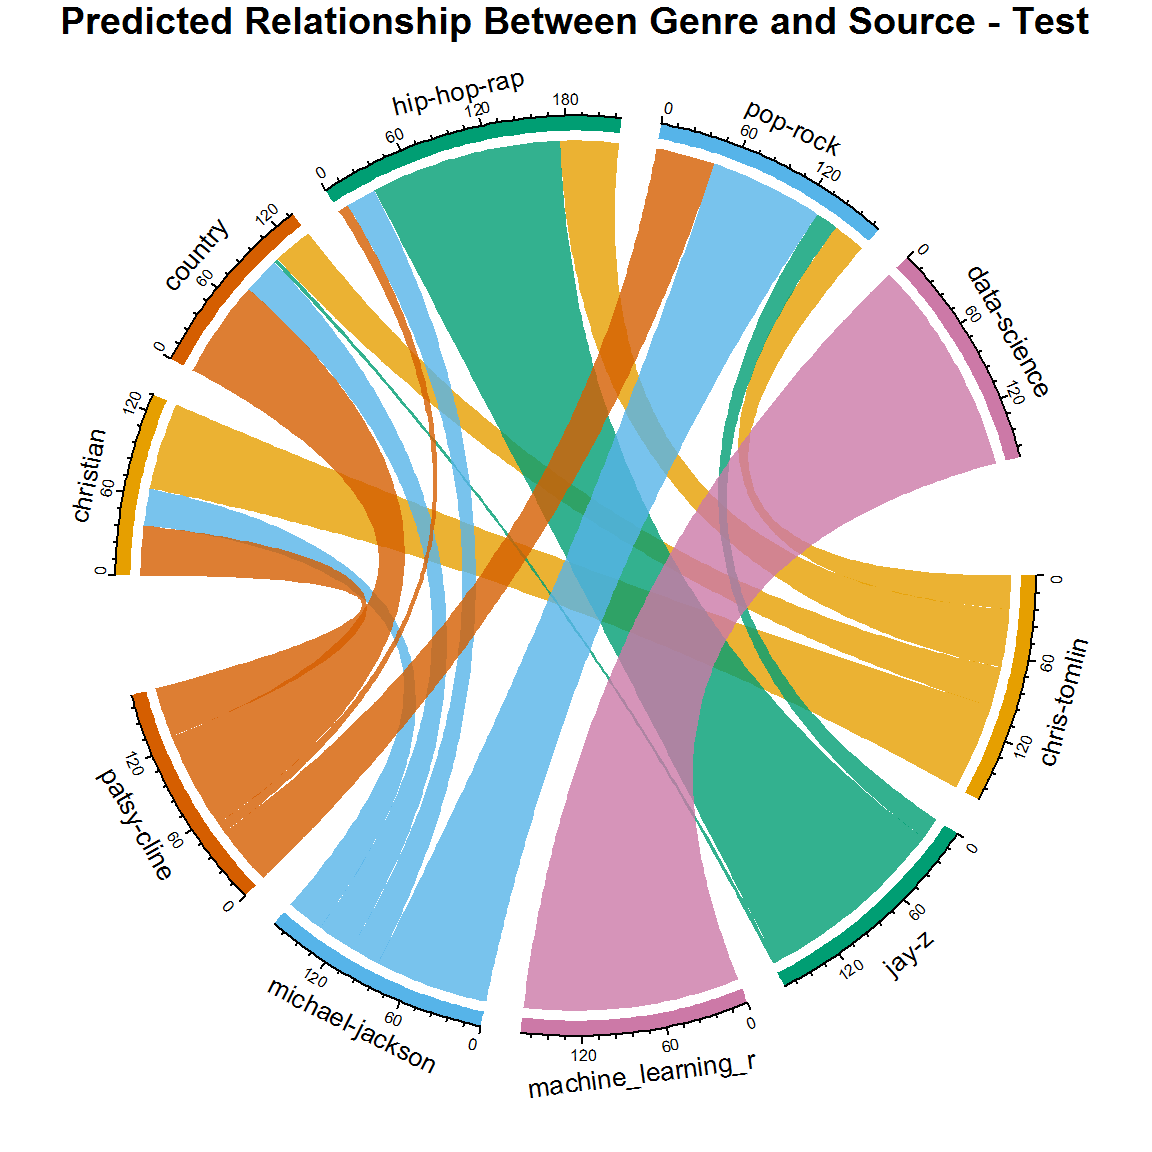
Apakah ini salah? Tidak akurat? Atau justru memberi wawasan? Saya pikir Anda mendapatkan gambaran nyata tentang dunia musik. Pikirkan: apakah Michael Jackson pernah berkolaborasi dengan artis rap? Pernahkah ia bernyanyi tentang topik religius? Pernahkah artis country menyeberang ke pop-rock? Diagram kord baru Anda sebenarnya memberikan versi klasifikasi lirik yang lebih realistis daripada yang ditampilkan di dataset asli! Dalam kehidupan nyata memang tidak ada hubungan satu banding satu antara artis dan genre, dan fleksibilitas itu tertanam dalam model Anda.
Untuk bagian selanjutnya, Anda akan melihat sebuah gagasan yang dapat diterapkan dalam pemasaran, penjualan, sains, ekonomi, dll., tetapi di sini Anda akan menerapkannya pada musik. Kesuksesan sebuah lagu sangat subjektif. Konsep kesuksesan komersial lebih jelas karena dapat didefinisikan oleh standar industri. Billboard Charts (dan banyak lainnya) adalah contoh ukuran kesuksesan tersebut. Jika Anda bekerja untuk label rekaman dan mencoba memutuskan artis mana yang akan dikontrak — atau artis yang sudah dikontrak mana yang akan dipromosikan, bukankah menarik jika Anda bisa memprediksi apakah mereka akan masuk tangga lagu berdasarkan liriknya menggunakan metode ilmiah? Anda memerlukan banyak data terkini dan segudang metadata yang mendeskripsikan setiap lagu. Karena sumber daya Anda terbatas di sini, ambil saja yang Anda miliki dan uji gagasan tersebut pada lirik Prince dengan data tangga lagu berlabel.
Pada tutorial sebelumnya, Anda membuat dataset lagu-lagu Prince di mana mayoritas lagu tidak masuk tangga lagu. Anda akan menggunakan set lirik yang seimbang dengan jumlah lagu charted vs. uncharted yang sama. Berikut angkanya:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")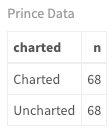
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Menggunakan proses yang sama seperti di atas, buat fitur menggunakan proses dua langkah. Kali ini alih-alih menghitung kata per genre dalam sebuah lagu, Anda akan menghitung kata per level tangga lagu. Dengan kata lain, dapatkan kata yang paling sering digunakan untuk lagu yang masuk tangga lagu dan yang paling sering digunakan untuk lagu yang tidak masuk tangga lagu dan simpan dalam daftar. Saya memilih menggunakan 1000 kata dan mendapatkan respons terbaik dengan jumlah itu. Cobalah nilai Anda sendiri. Lalu saat membuat fitur lagu, pastikan untuk menambahkan dua fitur yang menghitung jumlah kata dalam masing-masing daftar per lagu (proses yang sama seperti yang Anda gunakan dengan genre di atas).
Perhatikan lagi bahwa saya menghapus semua kata yang muncul di kedua daftar top lagu charted dan uncharted. Saya juga menambahkan beberapa fitur polinomial tambahan di mana saya mengkuadratkan input asli. Gagasan meningkatkan model bukan dengan men-tuning algoritme, melainkan dengan mentransformasi input, adalah hal mendasar dalam metode machine learning.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Lakukan langkah yang sama seperti di atas dengan membuat classifier task untuk dataset Prince dengan target pada field charted. Normalisasi data, siapkan cross-validation dan buat daftar learner. Saya menambahkan beberapa algoritme berbeda di sini karena Anda akan melakukan klasifikasi biner alih-alih multi-kelas seperti sebelumnya.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
Sekarang setelah Anda membuat benchmark, periksa hasilnya dalam beberapa format. Perhatikan perbedaan performa learner dibandingkan dengan yang di atas.
plotBMRSummary(bmr_prince)
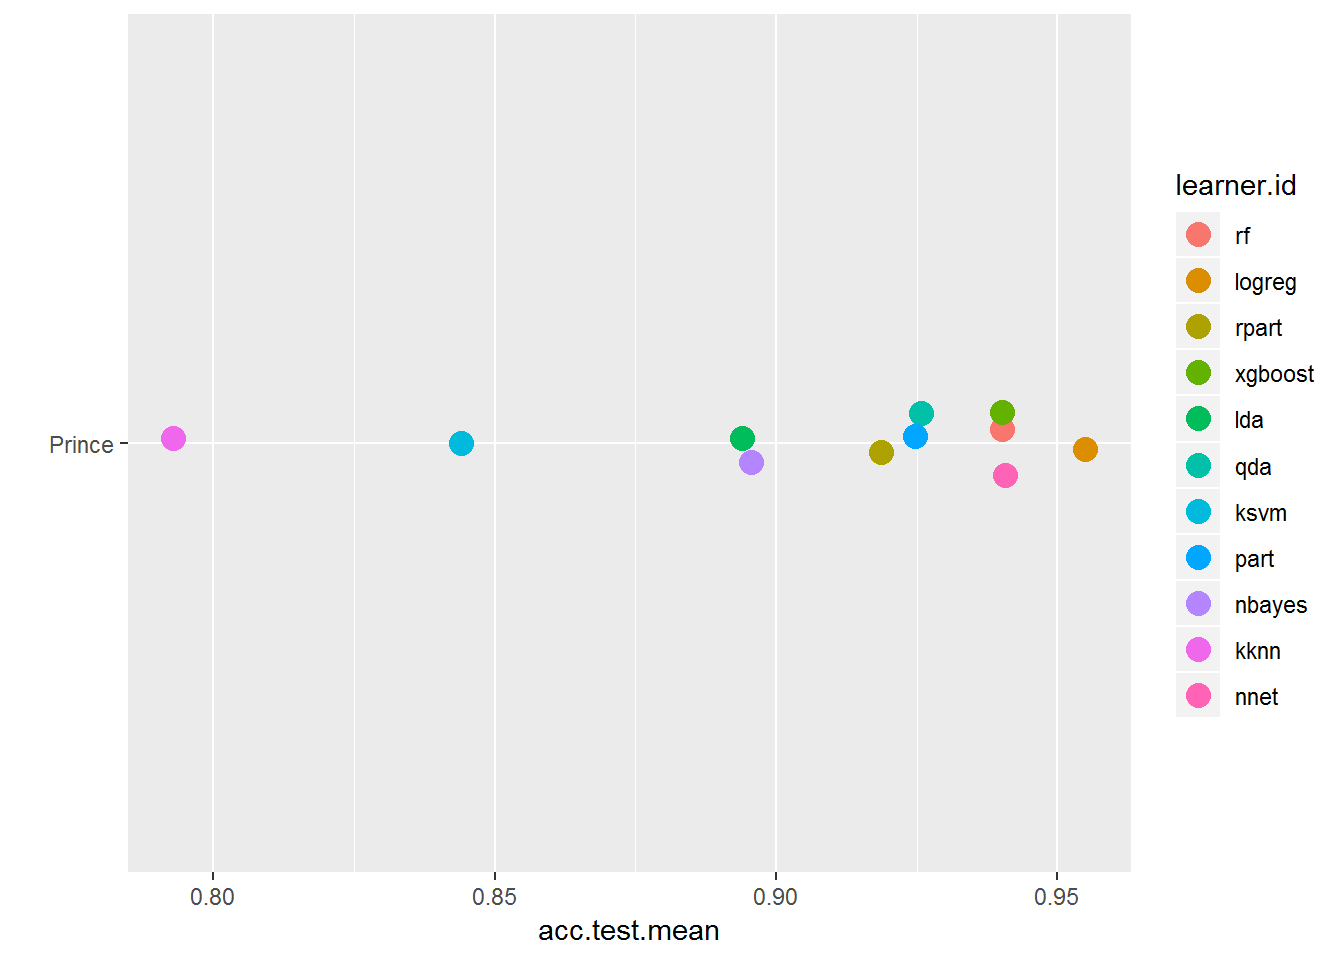
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))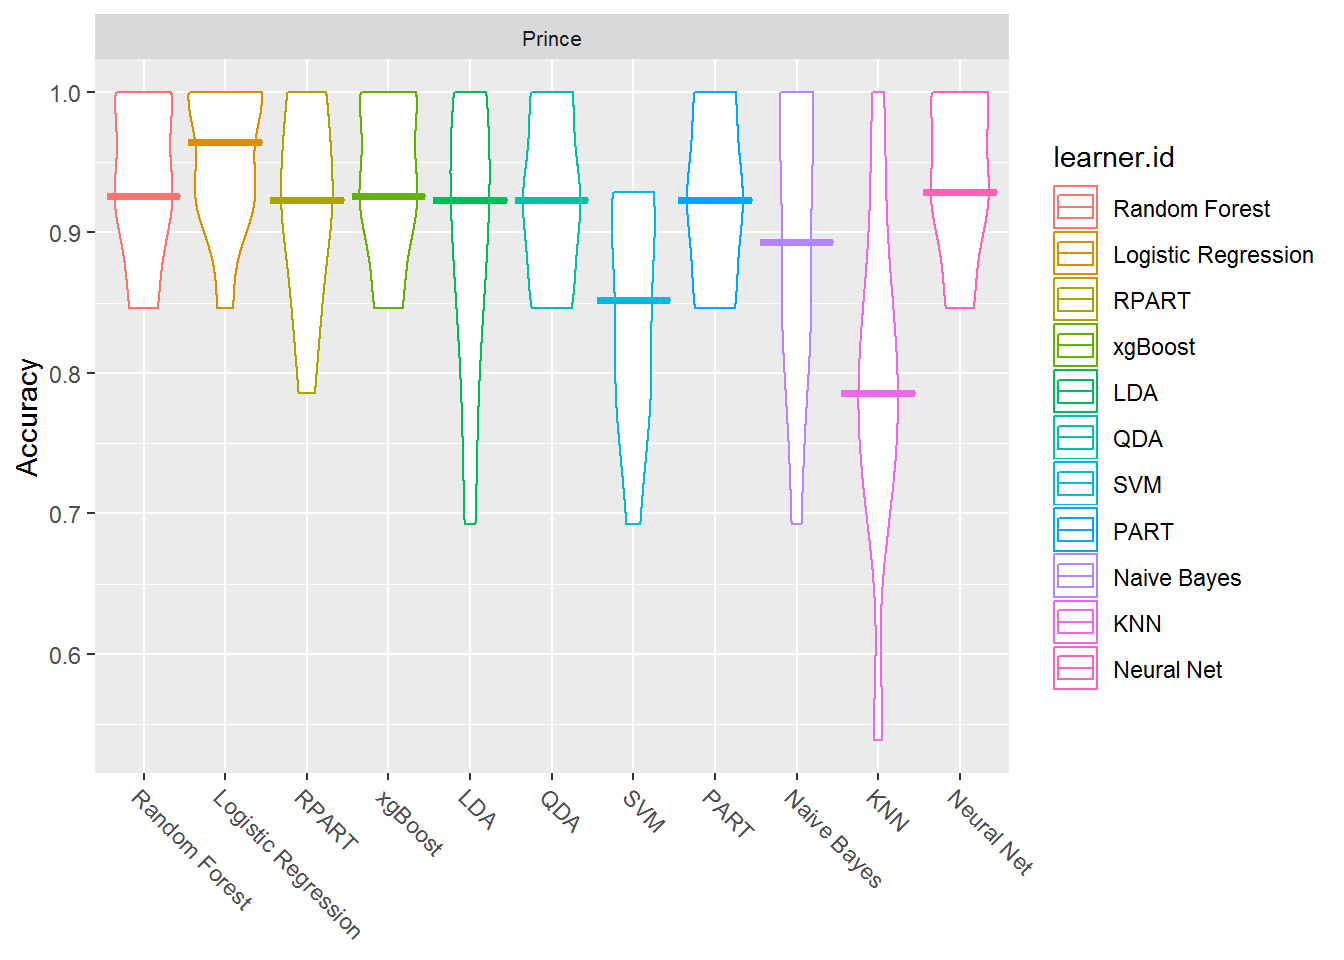
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")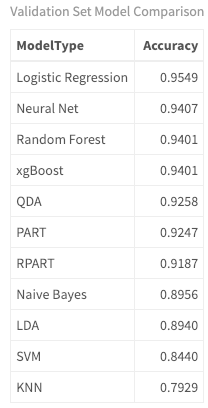
Dalam memprediksi level tangga lagu, Anda sekarang bekerja dengan masalah dua kelas. Hanya ada dua opsi: charted atau uncharted. Saat mengklasifikasikan genre, Anda memiliki masalah multi-kelas di mana ada lebih dari dua kemungkinan kelas. (Catat ini berbeda dengan masalah multi-label di mana sebuah observasi dapat memiliki lebih dari satu kelas. Itu mungkin sesuatu yang bisa diteliti!). Akibatnya, karena ini masalah klasifikasi binomial, saya menambahkan beberapa algoritme berbeda: QDA dan Logistic Regression. Keduanya lebih cocok untuk masalah dua kelas.
Logistic Regression dirancang untuk hasil biner dan memodelkan probabilitas bahwa sebuah observasi (lagu) termasuk dalam kategori tertentu. Ini didasarkan pada ambang batas yang default pada .5. Misalnya, apa pun dengan probabilitas lebih besar dari .5 termasuk ke kelas target, dan apa pun di bawah ambang ini termasuk ke kelas lainnya. Ambang ini dapat disesuaikan. QDA adalah singkatan dari quadratic discriminant analysis dan lebih fleksibel untuk menangani batas keputusan kuadratik dibandingkan linier. Baiklah, tidak adil jika saya melontarkan istilah teknis tanpa informasi lebih lanjut, jadi silakan luangkan waktu untuk melihat data yang Anda miliki, algoritme yang berkinerja baik, dan selidiki masing-masing secara terpisah. Saya harap analisis ini mendorong Anda untuk meneliti detailnya!
Langkah selanjutnya adalah menjalankan prediksi Anda dan melihat klasifikasinya.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")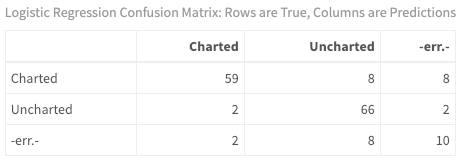
Sangat mudah untuk melihat bagaimana model mengklasifikasikan setiap lagu secara individual. Dengan klasifikasi biner, ada cukup banyak ukuran yang bisa diperiksa. Untuk saat ini, lihat saja false positive — yakni, lagu mana yang diprediksi akan masuk tangga lagu padahal sebenarnya tidak menembus Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")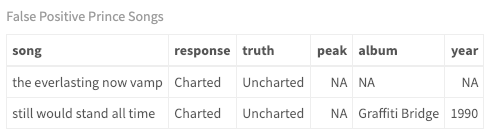
Meskipun Anda menggunakan cross-validation saat melatih model, Anda harus selalu menjalankan model tersebut terhadap dataset terpisah (seperti yang Anda lakukan dengan genre di atas). Saya menyerahkan itu sebagai latihan untuk Anda dan berharap Anda akan memberikan umpan balik atas hasil Anda. Agar ini menjadi uji sejati dari kekuatan prediktif di balik analisis lirik, hasil paling realistis akan datang dari artis terpisah yang juga berada pada genre pop-rock seperti Prince. Faktor lain adalah periode waktu. Lagu-lagu ini masuk tangga lagu terutama pada 70-an, 80-an, dan 90-an, jadi artis dari periode waktu yang sama itu krusial. Atau, pilih artis Anda sendiri untuk data latih dan uji dan lihat apa yang Anda dapatkan!
Dalam tutorial ini, Anda telah membangun model untuk memprediksi genre sebuah lagu sepenuhnya berdasarkan lirik. Anda menggunakan algoritme klasifikasi machine learning terawasi dan melatih model pada kumpulan lima artis dan lima genre berbeda. Dengan menggunakan kerangka kerja mlr, Anda membuat task, learner, dan strategi resampling untuk melatih lalu melakukan tuning model. Kemudian Anda menjalankan model Anda terhadap dataset uji yang belum pernah dilihat berisi artis yang berbeda. Anda mampu mengidentifikasi algoritme mana yang bekerja lebih baik dengan pengaturan default, dan pada akhirnya, memprediksi genre lagu baru yang belum pernah dilihat model Anda.
Terkait analisis lirik, harusnya kini jelas bahwa meskipun industri musik (dan Billboard Charts) memiliki genre yang telah ditentukan untuk setiap artis, analisis Anda menunjukkan bahwa menurut lirik, lagu-lagu melintasi genre dan biasanya tidak ada hubungan satu banding satu. (Sebagai penulis lagu sendiri, tag-line genre saya adalah "funkified, acoustic, rockin' soul!"). Anda juga dapat menggunakan teknik yang sama untuk memodelkan apakah sebuah lagu akan masuk tangga lagu sepenuhnya berdasarkan lirik dengan akurasi yang cukup baik pada data pelatihan. Misi Anda sekarang adalah menerapkan pengetahuan itu pada dataset Anda sendiri!
Saya menikmati bekerja bersama Anda sepanjang seri artikel tiga bagian (empat tutorial) tentang analisis lirik ini. Semoga Anda semakin menghargai kompleksitas bekerja dengan jenis teks ini dan kehalusan yang terlibat pada lirik dibandingkan bentuk teks lainnya (mis., nonfiksi). Saya harap Anda telah mempelajari keterampilan baru dan terinspirasi untuk menggunakan data Anda sendiri guna menangkap wawasan untuk topik baru yang menarik bagi Anda. Machine learning adalah bidang yang menarik, dan sebagai data scientist baru atau berpengalaman, kreativitas, inspirasi, dan ketekunan akan membuat Anda berbeda dari yang lain. Jadi ingatlah untuk berpikir di luar jajar genjang dan nikmati petualangan belajar Anda!
"I put my foot on the starting line, and took off into a brand new day. I blew a kiss into the wind, closed my eyes and kicked the fear away. - Debbie Liske, New Day"
(Ngomong-ngomong, saya telah menulis lebih dari 100 lagu sendiri dan menjalankan model terakhir itu pada musik saya. Model memprediksi 35 lagu saya seharusnya masuk tangga lagu! Andai saja saya mengetahui teknik ini lebih cepat!! Mungkin artikel saya berikutnya tentang cara menggunakan analisis lirik untuk menulis lagu hits berdasarkan artis masa kini...)
Saya menyinggung secara singkat topik-topik di bawah dan mendorong Anda untuk meluangkan waktu memahami lebih dalam masing-masing.
Silakan ajukan pertanyaan apa pun di kolom komentar!
Berikut tautan ke dataset:
Pelajari lebih lanjut tentang R dan Machine Learning
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



