Kurs
Machine Learning verstehen
2 Std.
308K
Setze moderne Techniken mit R, NLP und Machine Learning ein, um Themen in Texten zu modellieren – und bau dir dein eigenes Musik-Empfehlungssystem!
Dies ist Teil Zwei-B einer dreiteiligen Tutorial-Reihe. Du nutzt weiter R, um verschiedene Analysen an einem Fallbeispiel mit Songtexten der Legende Prince sowie weiterer Künstlerinnen, Künstler und Autorinnen/Autoren durchzuführen. Die drei Tutorials behandeln:
Stell dir vor, du bist Data Scientist bei der NASA. Du sollst zwei Raumsonden für Mondumlaufbahnen überwachen, die die Wechselwirkungen des Mondes mit der Sonne untersuchen. Wie bei jeder Raumsonde treten während Tests oder nach dem Start Probleme auf. Diese Anomalien werden in natürlicher Sprache in fast 20.000 Problemberichten dokumentiert. Deine Aufgabe: die wichtigsten Themen und Trends im Korpus zu identifizieren und den Ingenieurteams sowie der Programmleitung handlungsleitende Analysen zu liefern – mit realen Auswirkungen auf die Zukunft der Raumfahrt.
Das ist ein Beispiel aus einem realen Szenario und zeigt, welche Power du nach diesem Tutorial in den Händen hältst: moderne Verfahren wie Topic Modeling mit Machine Learning, Natural Language Processing (NLP) und R. Zum Glück musst du nicht bei der NASA arbeiten, um ähnlich Innovatives zu bauen. In diesem Tutorial lernst du Topic Modeling kennen und entwickelst ein einfaches Empfehlungssystem auf Basis von Songtexten und Sachbüchern.
Just for Fun!
Das hat zwar nichts mit Topic Modeling zu tun – aber nur zum Spaß: Nutze das geniale Paket circlize (im vorigen Tutorial vorgestellt), kurble deine Fotorezeptoren an und genieß dieses Kreisdiagramm aller Quellen, die du hier verwenden wirst.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)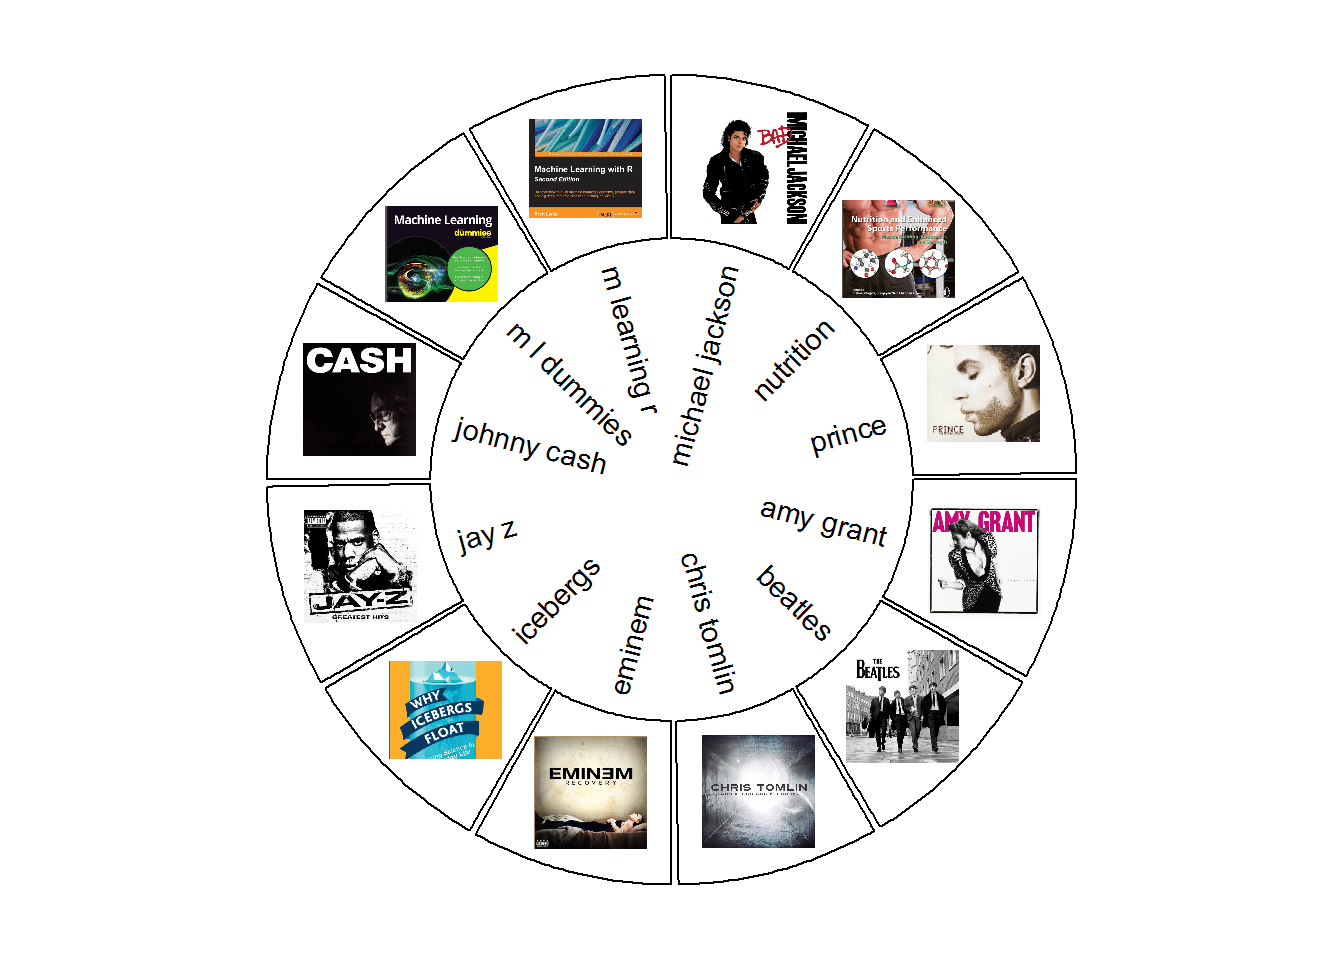
In den vorherigen Tutorials hast du den Inhalt von Prince’ Lyrics mit Wortfrequenzen, der tf-idf-Kennzahl und Sentimentanalyse untersucht. Mit Topic Modeling kannst du noch tiefer in Lyrics und andere Texte einsteigen.
In diesem Tutorial baust du vier Modelle mit Latent Dirichlet Allocation (LDA) und dem K-Means-Clustering-Algorithmus. Die Algorithmen erkläre ich später im Tutorial.
Modell Eins nutzt Texte aus Prince’ Lyrics kombiniert mit zwei Sachbüchern. Ziel ist ein einfaches Beispiel für LDA, einen unüberwachten Algorithmus, der Wortkollektionen generiert, die gemeinsam Themen andeuten. Diese Themen sind unbeschriftet und brauchen menschliche Interpretation. Nachdem du eine vordefinierte Anzahl an Themen identifiziert hast, klassifizierst du jeden Song bzw. jede Buchseite einer Kategorie zu. Ein Song kann alle erzeugten Topics enthalten, passt aber meist besser zu einem als zu den anderen. Das nennt man Dokumentklassifikation. Da du den/die Verfasser:in kennst, klassifizierst du letztlich Autorinnen/Autoren in thematische Gruppen.
Modell Zwei verwendet den Datensatz aus Modell Eins und zeigt kurz, wie sich Themen mit einem anderen Algorithmus, k-means, generieren lassen – und warum er fürs Topic Modeling oft nicht die beste Wahl ist.
Wieder mit LDA nutzt Modell Drei einen größeren Datensatz mit mehreren Artists aus unterschiedlichen Genres und zusätzlichen Buchautorinnen/-autoren. Wenn du die Mehrzahl der Dokumente eines/einer Autor:in dem wahrscheinlichsten Topic zuordnest, kannst du Schreibende mit ähnlicher Themenstruktur gruppieren. Bei einem guten Modell erscheinen ähnliche Genres in denselben Topics. Beispiel: Rap-Künstler:innen in einem Topic; zwei Bücher zum ähnlichen Thema gemeinsam in einem anderen. So kannst du potenziell ähnliche Autorinnen/Autoren empfehlen! Die Schreibenden und ihre Genres sind zwar beschriftet, die Topics jedoch nicht – das bleibt unüberwacht.
Modell Vier setzt LDA nur auf Prince’ Lyrics ein. Dieses Mal nutzt du einen annotierten Datensatz, in dem jedes Wort mit Wortart (z. B. Substantiv, Verb) und Grundform (lemmatisiert) gekennzeichnet ist. Außerdem untersuchst du, wie sich ein Topic im Zeitverlauf verändert.
NLP und Machine Learning sind Teilgebiete der Künstlichen Intelligenz. Es gibt aktuelle Versuche, KI fürs Songwriting einzusetzen. Das ist nicht das Ziel dieses Tutorials, aber ein gutes Beispiel für KI als Kunstform. Schließlich beginnen die ersten drei Buchstaben mit A-R-T! Vergleiche kurz KI mit Songwriting: Ein Schema und eine Struktur (Strophe, Refrain, Strophe …) sind leicht gebaut. Großartig wird ein Song, wenn Kreativität ins Spiel kommt. In diesem Tutorial brauchst du sowohl technische Kompetenzen zum Bau der Modelle als auch kreative Interpretation, um Ergebnisse zu deuten und zu erklären.
Denk mal so: Wenn Topic Modeling Kunst ist, dann sind Lyrics der Code, Songwriting ist der Algo-rhythm – und der Song ist das Modell! Was ist deine Analogie?
Typische Empfehlungssysteme basieren nicht ausschließlich auf Text. Netflix empfiehlt Filme etwa anhand früherer Auswahl und Metadaten. Pandora geht anders vor und nutzt ein Music Genome mit 400 musikalischen Attributen wie Melodie, Rhythmus, Komposition und Lyric-Zusammenfassungen; die Entwicklung begann im Jahr 2000 und brauchte fünf Jahre und 30 Expertinnen/Experten für Musiktheorie. Es gibt zahlreiche Forschungsarbeiten zu Filmempfehlungen anhand von Plot-Zusammenfassungen. Beispiele für Musikempfehlungen auf Basis des tatsächlichen Textinhalts sind seltener. Lust, es auszuprobieren?
Teil Zwei-B setzt Grundkenntnisse in „tidy data“ voraus – insbesondere in Paketen wie dplyr und ggplot2. Übung im Text Mining mit tidytext ist ebenfalls hilfreich und wurde in den vorherigen Tutorials behandelt. Du solltest außerdem mit R-Funktionen vertraut sein, da du einige nutzt, um Code für jedes Modell wiederzuverwenden. Um den Fokus auf Insights zu legen, habe ich Code beigefügt, der auf deinen eigenen Datensätzen läuft; Detailerklärungen erfordern ggf. zusätzliche Recherche.
Was kannst du mit Topic Modeling tun? Vielleicht bergen Dokumente in deinem Unternehmen geschäftskritische Informationen. Vielleicht scrapest du Twitter und findest heraus, was Leute über eure Produkte sagen. Vielleicht baust du eine eigene Klassifikation, um bestimmte Dokumente an die richtigen Abteilungen zu routen. Die Möglichkeiten sind riesig – leg los!
Einige Anwendungsfälle:
Neu in diesem Tutorial (nicht in Teil Eins oder Teil Zwei-A) sind topicmodels, tm und plotly. Du nutzt LDA() aus topicmodels, um Modelle lernen zu lassen, Dokumente zu unterscheiden. tm ist fürs Text Mining; hier verwendest du einmal inspect(), um in eine Document-Term-Matrix zu schauen. plotly nutzt du einmal für eine interaktive Variante eines ggplot2-Charts.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Die folgenden Funktionen wurden in früheren Tutorials definiert, mit Ausnahme von word_chart(); Inhalt und Beschreibung von word_chart() findest du aber ebenfalls in Teil Zwei-B. Wichtig: word_chart() nutzt ggplot() auf unkonventionelle Weise, um ein Wort-basiertes statt punktbasiertes Visual zu erzeugen.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Um die Stärke von Topic Modeling und Klassifikation wirklich zu sehen, nutzt du nicht nur Prince’ Lyrics wie zuvor, sondern arbeitest auch mit mehreren weiteren Artists aus unterschiedlichen Genres der Billboard-Charts. Zusätzlich habe ich einige Bücher mit verschiedenen Themen ergänzt – etwa Sporternährung, Eisberge und sogar Machine Learning! Mit einem vielfältigen Datensatz kannst du Dokumente passenden Topics zuordnen und ähnliche Artists/Autorinnen/Autoren unterscheiden.
Tipp: Ich nenne Songs und Buchseiten Dokumente und Musiker:innen/Autor:innen Writers. Im Code taucht das Wort source auf – das ist einfach die Zuordnung zum jeweiligen Writer. Genre verwende ich sowohl für Musikgenre als auch Buchkategorie. Bei Büchern nutze ich zur Klarheit die Buchtitel statt Autor:innennamen. Das wird im Verlauf des Tutorials schlüssig.
Damit der Fokus auf dem Modeling liegt, habe ich die Datenaufbereitung außerhalb dieses Tutorials durchgeführt und dir drei Dateien mit folgenden Vorarbeiten bereitgestellt:
pdf_text() aus dem pdftools-Paket extrahiert (jede Seite ist ein eigenes Dokument)tidytext (siehe Teil Eins) in tidy-Form gebrachtDu arbeitest hier mit drei Datensätzen:
three_sources_tidy_balanced: Prince-Lyrics und zwei Bücherall_sources_tidy_balanced: Lyrics von acht Artists und vier Bücherprince_tidy: nur Prince-LyricsAußerdem ist ein annotierter Datensatz von Prince’ Lyrics enthalten. Was „annotiert“ bedeutet, erkläre ich bei Modell Vier.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)Ziel des Topic Modelings ist es, bedeutsame thematisch verwandte Terme (Topics) in unstrukturierten Textdaten zu finden – gemessen als Muster gemeinsamer Wortauftretens. Grundbausteine sind Dokumente, Terme und Topics. Latent Dirichlet Allocation (LDA) ist ein unüberwachtes Verfahren, das die zugrunde liegenden Topics in einer Dokumentensammlung entdeckt, wobei jedes Dokument eine Sammlung von Wörtern ist. LDA nimmt an:
LDA sucht Gruppen verwandter Wörter. Es ist ein iterativer, generativer Algorithmus. Zwei Hauptschritte:
Die Idee hinter LDA: Wörter eines Topics treten gemeinsam in Dokumenten auf. Jedes Dokument ist eine Mischung aus Topics, jedes Topic eine Mischung aus Wörtern (auch Mixed-Membership-Modell genannt). Über die Wahrscheinlichkeit, dass ein Dokument zu einem Topic gehört, kannst du es klassifizieren. Da du den Writer kennst, kannst du Artists/Autor:innen auf Basis ähnlicher Topic-Strukturen empfehlen. Schauen wir uns ein Beispiel an.
Für dieses Modell nutzt du den Datensatz mit drei verschiedenen Writers (Sources) und suchst verborgene Topics. Um die Stärke des Topic Modelings zu zeigen, sind die drei Quellen sehr unterschiedlich – intuitiv weißt du, dass sie drei verschiedene Themen abdecken. Daher gibst du dem Modell drei Topics vor und prüfst, wie gut es ist. Zuerst schaust du dir den Datensatz mit my_kable_styling() sowie color_bar() und color_tile() aus formattable an.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
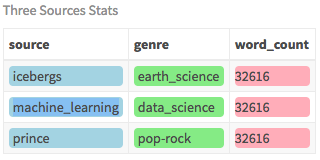
Hier nutzt du Prince-Lyrics, das Buch "Machine Learning For Dummies" und das Buch "Why Icebergs Float" – jeweils mit über 30.000 (nicht eindeutigen) Wörtern.
Da du einen balancierten, tidy Datensatz mit Prince-Lyrics und zwei Büchern hast, erstellst du zuerst eine Document-Term-Matrix (DTM): Jede Zeile ist ein Dokument, jede Spalte ein Term. Dieses Format benötigt LDA. Ein Dokument ist ein Song (bei Lyrics) bzw. eine Seite (bei Büchern). Zuerst zählst du Wörter je Dokument und leitest das Ergebnis an cast_dtm() aus tidytext weiter. document ist das Feld mit dem Dokumentnamen, word das Feld mit dem Term. Weitere Parameter sind möglich, diese zwei sind Pflicht.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Du siehst, wie viele Dokumente und Terme es gibt, und dass dies eine sehr spärliche Matrix ist – die meisten Felder sind leer. Der große Wortschatz über alle Dokumente hinweg führt dazu, dass in einem einzelnen Dokument nur wenige Terme auftreten.
Mit inspect() aus tm kannst du dir einige Zeilen und Spalten ansehen. Jede Zeile ist ein Dokument, jede Spalte ein Term. (Mit str() siehst du die Struktur.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Jetzt weißt du, was der Input fürs Modell ist. Setze zwei Variablen, die du pro Modell einfach neu zuweist: source_dtm und source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedJetzt kommt der spannende Teil. Der Code ist simpel – aber als gute:r Data Scientist willst du verstehen, was passiert. Online gibt es jede Menge zu LDA. Für uns sind vier Parameter wichtig: Input, Anzahl Topics, Sampling-Methode und Seed.
Da dein Datensatz drei unterschiedliche Writers enthält, setzt du k auf 3 und seed auf eine Konstante für reproduzierbare Ergebnisse. Es gibt weitere control-Parameter (daher list), wir verwenden hier nur seed. method legt den Sampling-Algorithmus fest. Wir nutzen GIBBS. Der Standard VEM performt aus meiner Erfahrung schlechter als GIBBS.
Kurz technisch: GIBBS-Sampling führt einen Random Walk aus, startet an einem Punkt (Initialwert standardmäßig 0) und bewegt sich bei jedem Schritt mit gleicher Wahrscheinlichkeit um plus oder minus eins. Details findest du hier.
Hinweis: Ich habe die Details des LDA-Algorithmus verkürzt. Du musst die Statistik nicht komplett verstehen, um ihn zu nutzen. Lies gern dieses Dokument von Ethen Liu für eine solide Erklärung.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Es entsteht ein LDA_Gibbs-Objekt mit drei Topics. str(lda) spare ich hier wegen des Umfangs – probier es gern selbst aus.
Als Nächstes schauen wir ins Objekt. Mit tidy() bringst du es in ein gut lesbares Format. Übergebe der matrix-Argument beta, um die Wortwahrscheinlichkeiten je Topic zu erhalten. Das Beispiel mit iceberg zeigt die Wahrscheinlichkeit dieses Wortes in jedem Topic. iceberg hat in Topic 1 die höchste Wahrscheinlichkeit.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Um das Modell zu verstehen, willst du sehen, welche Terme pro Topic dominieren. Baue eine Funktion, die das LDA-Modell tidy macht und die Top-Terme pro Topic extrahiert – also die Terme mit der höchsten beta. Darin nutzt du word_chart() für eine übersichtliche Darstellung der drei Topics und Top-Wörter. Setze num_words auf 10; probiere gern andere Werte.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)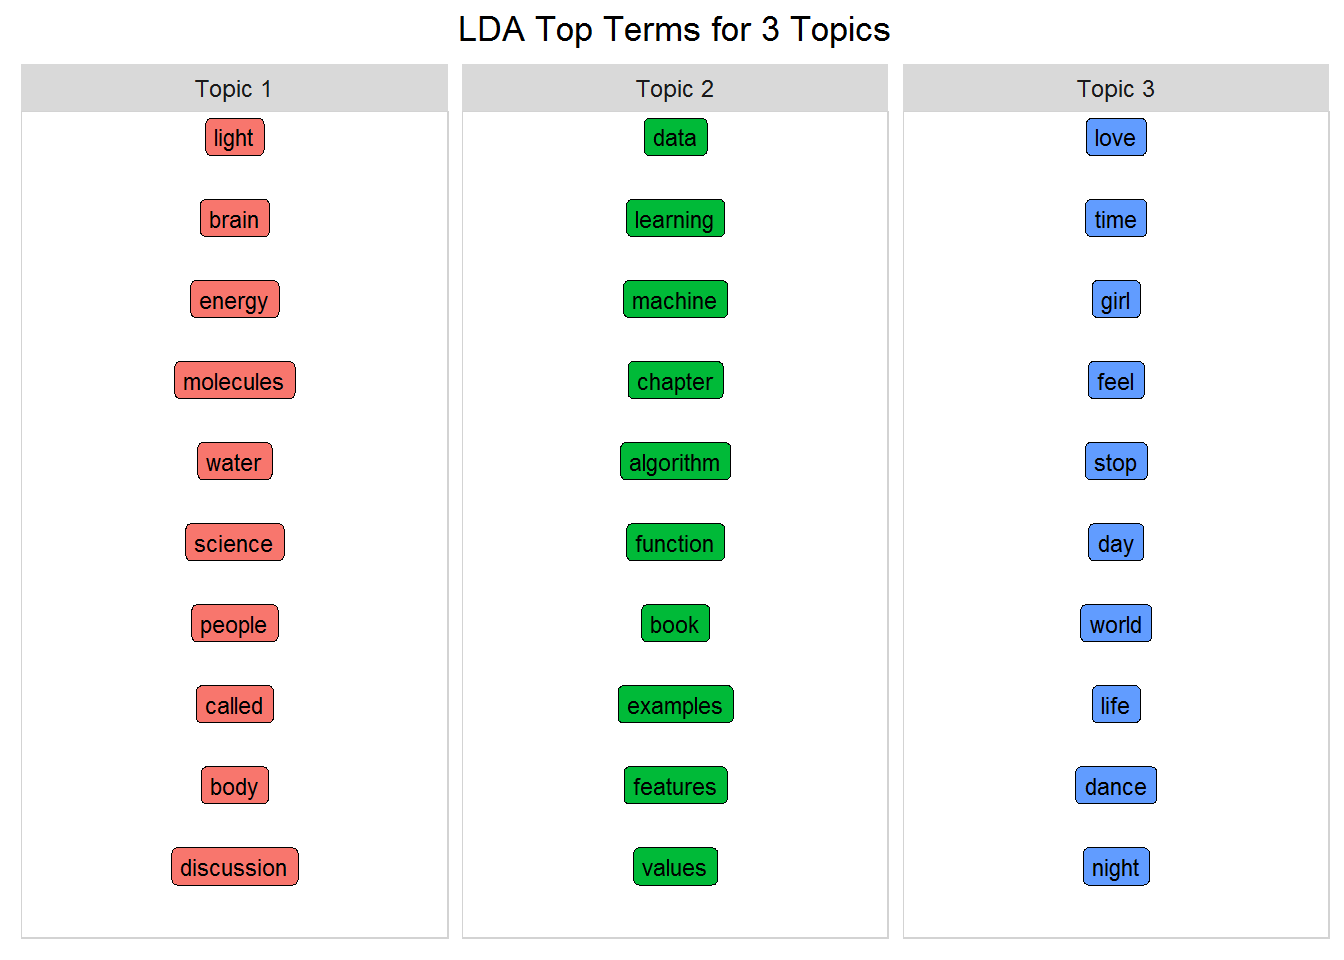
Unüberwachtes Lernen braucht immer menschliche Interpretation … aber diese Topics spiegeln klar die drei Quellen Icebergs, Machine Learning und Prince wider! Einfach – und doch beeindruckend, wenn man an die Möglichkeiten denkt.
Neben der Darstellung von Topics als Wortmischungen zeigt LDA auch Dokumente als Topic-Mischungen. Dieses Mal nutzt du matrix = "gamma" und erhältst die Dokument-zu-Topic-Wahrscheinlichkeiten. Beispiel: Prince’ Song 1999. Wie Wörter zu mehreren Topics gehören, gilt das auch für Dokumente (Mixed-Membership). Unten siehst du, dass 1999 am wahrscheinlichsten in Topic 3 liegt.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661Der Song gehört zu allen Topics, aber in unterschiedlichen Anteilen (gamma). Manche Dokumente passen besser in bestimmte Topics – hier hat 1999 den höchsten gamma-Wert in Topic 3.
Zur Veranschaulichung dient dieses Kreisdiagramm: Es zeigt, welcher Anteil der Dokumente je Quelle in welches Topic fällt. Dafür verknüpfst du das tidy LDA-Modell mit source_tidy über document, gruppierst richtig und berechnest den durchschnittlichen gamma-Wert je Quelle und Topic. So siehst du, in welches Topic die Mehrheit der Dokumente je Quelle fällt.
Nimm dir einen Moment, wenn du Kreisdiagramme noch nicht kennst. (Siehe Teil Zwei-A für chordDiagrams() und das circlize-Paket. Alles Nötige steht in diesem Buch von Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")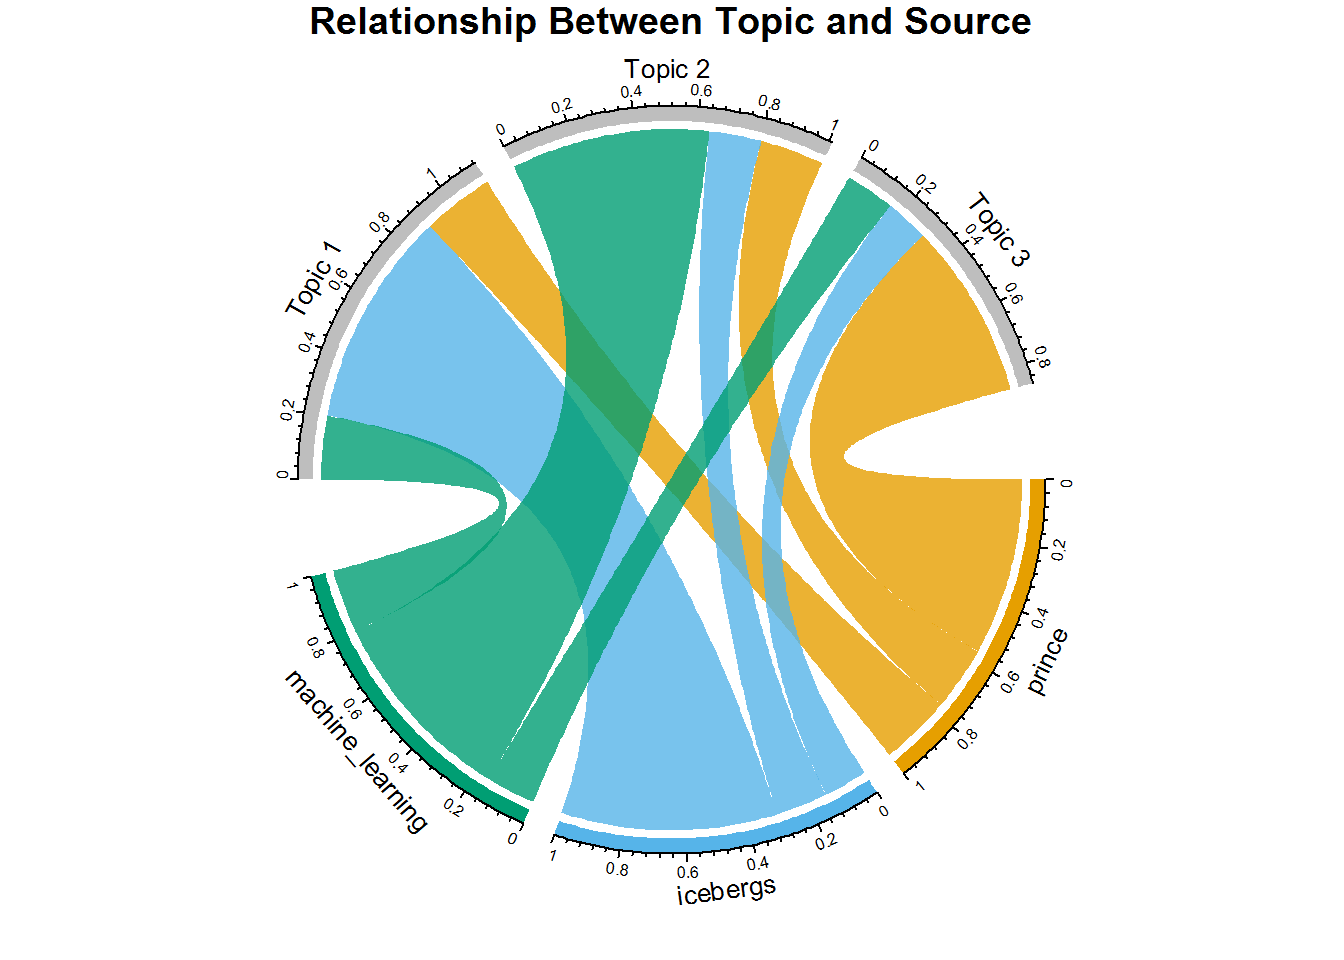
Spannend: Obwohl Dokumente jeder Quelle in allen Topics vorkommen, dominiert je Quelle ein Topic klar. Prince-Songs sind überwiegend in Topic 3 (der entsprechende Chord ist am größten). Gleiches für Icebergs mit Topic 1 und Machine Learning mit Topic 2. Das Muster ist deutlich.
Damit hast du Dokumente in Topics klassifiziert – basierend auf dem mittleren gamma je Topic/Quelle. Kennst du den Writer, und weißt, dass er/sie meist zu einem bestimmten Topic schreibt, kannst du davon ausgehen, dass ähnliche Genres in denselben Topics landen – und somit ähnliche Writers empfehlen. Mit dem größeren Datensatz setzen wir das in Praxis um.
Nun zoomst du auf Dokumentebene und zeigst die Top-Dokumente pro Topic.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)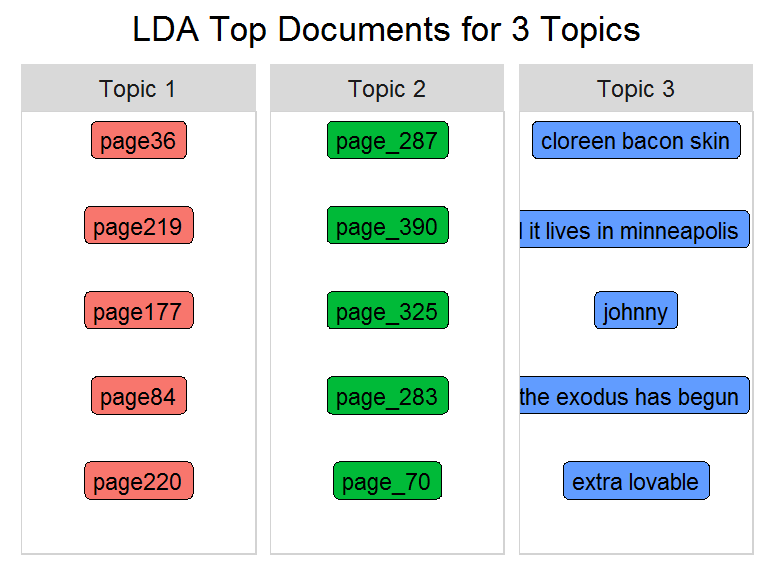
Da die Bezeichnungen der Dokument-/Songtitel nicht selbsterklärend sind (z. B. Seiten mit Unterstrich stammen aus dem Machine-Learning-Buch), ersetze ich den Dokumentnamen durch den Source-Namen.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)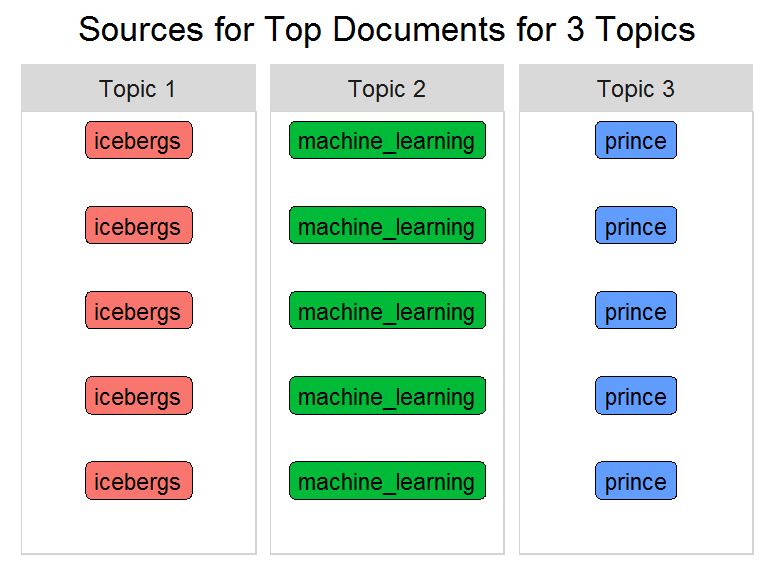
Die Top-Dokumente je Topic wurden durch ihre Source ersetzt. Die Klassifikation funktioniert gut – zumindest für diese Top 5! Die große Frage: Klappt das auch mit mehr als drei Sources? Wenn die Resultate stimmen, kannst du ähnliche Writers empfehlen.
Nun baust du dein zweites Modell mit einem anderen Verfahren: dem k-means-Algorithmus. Wie LDA ist k-means unüberwacht und erfordert die Vorabwahl der Topic-Anzahl. Im Gegensatz zum LDA-Mixed-Membership teilt k-means Dokumente in disjunkte Cluster (Topics). Es bildet Dokumente als numerische Vektoren mit Wortgewichten (ähnlich tf-idf) ab und gruppiert sie nach Ähnlichkeit. Jedes Dokument landet in genau einem Cluster – Hard Clustering. LDA ist dagegen Soft/Fuzzy Clustering, bei dem ein Datenpunkt mehreren Clustern angehören kann.
Konzeptionell liefert LDA für Sprache realistischere Topic-Zuordnungen als k-means, da Texte meist mehrere Themen enthalten. Baue das Modell, inspiziere das k-means-Objekt und prüfe die Annahme.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"Die Struktur zeigt zwei wichtige Infos: clusters und centers. Mit folgendem Format siehst du Inhalte je Variable, etwa für den Song 1999 und das Wort party, das darin vorkommt.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Diese Felder zeigen: 1999 liegt in genau einem Cluster (Cluster zwei) und party kommt in allen drei Clustern vor, dominiert aber Cluster eins. Nun schaust du auf die Top-Wörter anhand der centers-Werte, um Themen zu erkennen.
Erinnere dich: Der Datensatz enthält drei Quellen: Prince, Icebergs, Machine Learning. Drucke die Top-Wörter pro Cluster und vergleiche mit LDA. Du musst das Format leicht anpassen, um word_chart() zu nutzen. Die Details sind weniger wichtig als die Interpretation.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)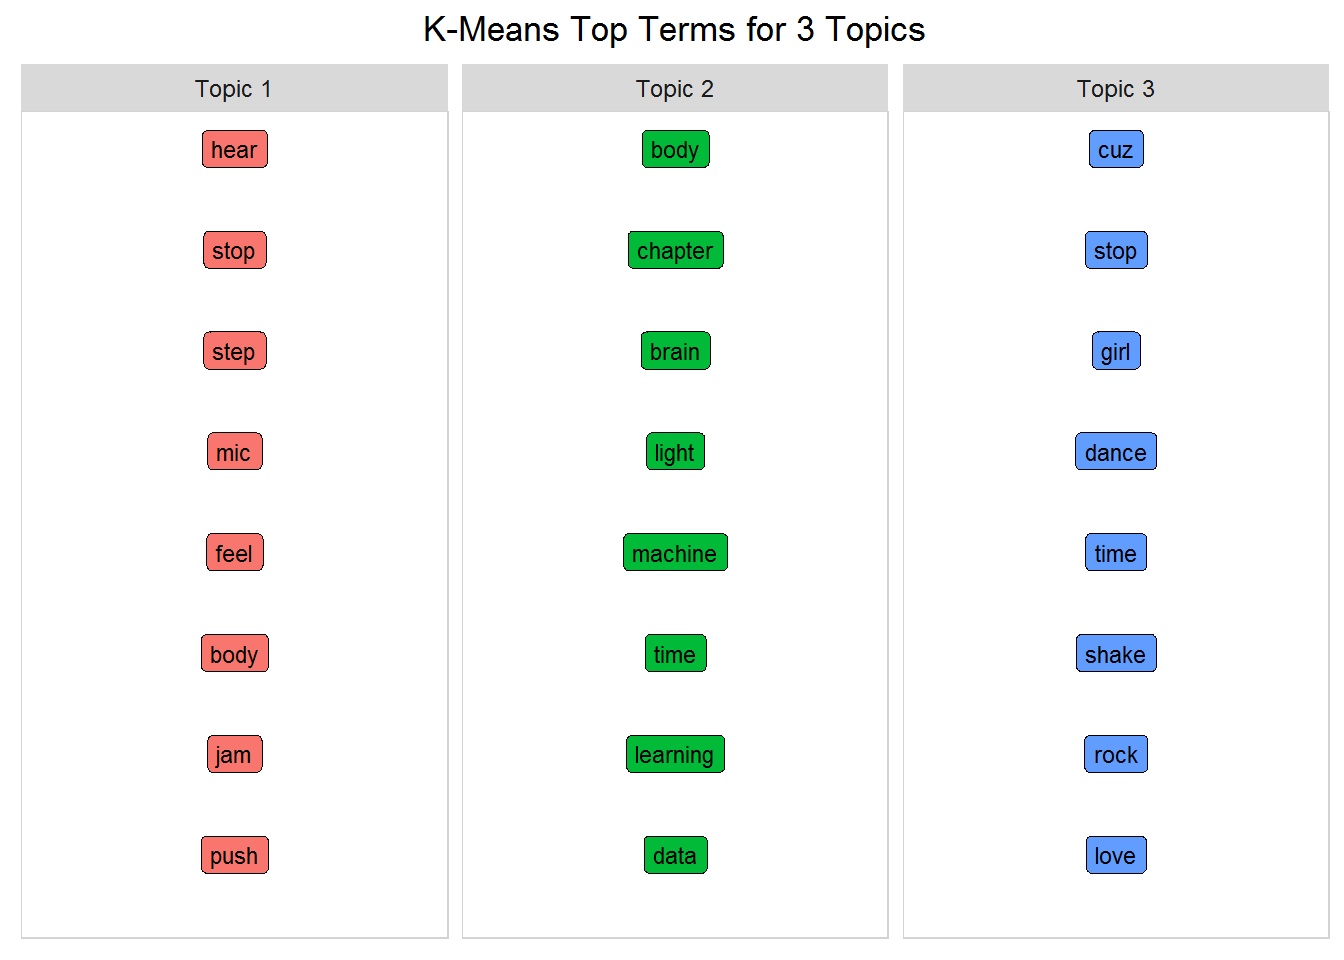
k-means trennt grob Buch- und Musikthemen: Topics 1 und 3 sind klar Prince, Topic 2 bündelt beide Bücher. Die beiden Bücher lassen sich hier jedoch nicht trennen – LDA konnte das. Man kann k-means wie LDA tunen; mit Defaults wirkt LDA hier geeigneter. (Alternative: das mallet-Paket.)
Jetzt setzt du LDA auf den Datensatz mit 12 Sources/Writers aus mehreren Genres ein. Der Datensatz ist bereits balanciert mit ähnlicher Zahl an Dokumenten und Wörtern je Writer. Überblick:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")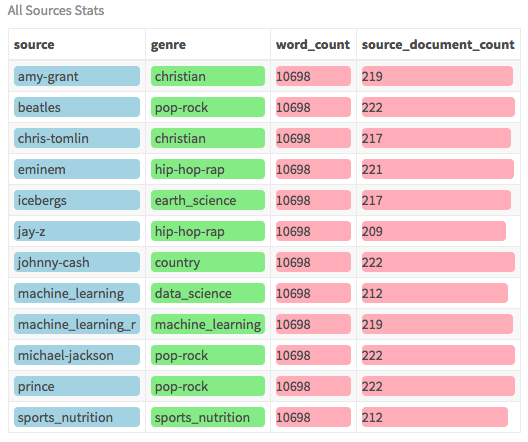
Der Datensatz deckt eine große Bandbreite ab – von Prince über Johnny Cash (Country) bis Eminem (Rap) sowie vier Bücher. Die Artists wurden ausgewählt, weil sie in ihren Genres besonders produktiv sind. Die Lyrics stammen von einer Website. Obwohl es zwei Machine-Learning-Bücher gibt, fokussiert eines allgemeine Data Science, das andere ML speziell mit R. Alle Bücher sind als PDFs verfügbar (die Roh-PDFs brauchst du hier nicht, tidy-Versionen sind enthalten).
Kleine Aufräumarbeit: Manche Genrebezeichnungen sind für Diagramme zu lang. Erstelle Abkürzungen für bessere Lesbarkeit.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedJetzt hast du zwölf Writers und acht Genres. Ideal wäre, wenn Writers desselben Genres im selben Topic landen. Setze die Topic-Anzahl auf acht und fitte das Modell erneut auf dem größeren Datensatz.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)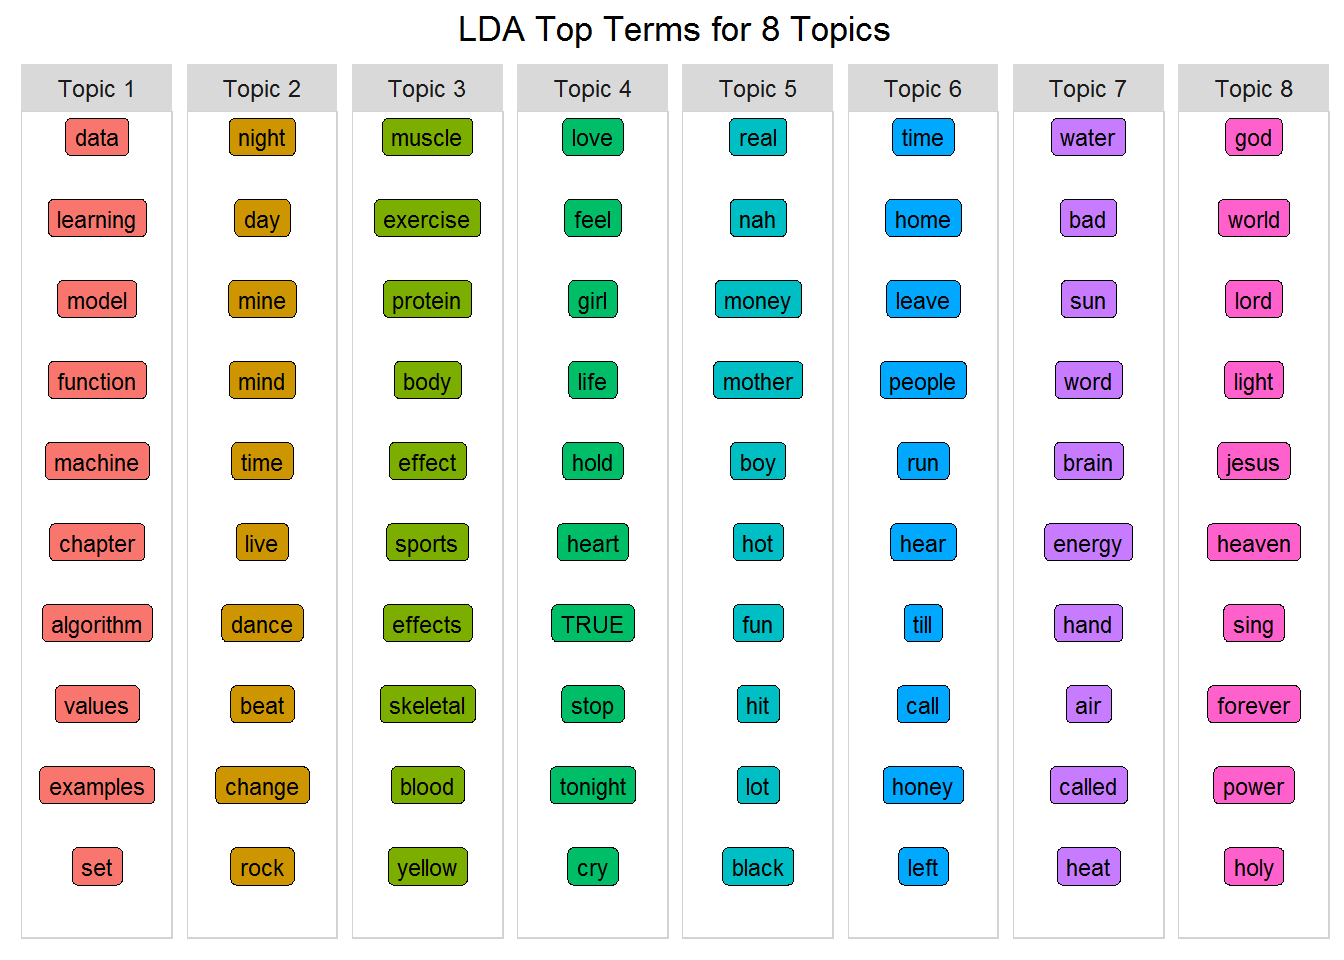
Ohne dir etwas vorwegzunehmen: „Wow“! Erkennst du die Themen? Ordne die Topics den acht bekannten Genres zu. Manche sind schwer, andere klar. Mögliche Deutungen:
Denk an Mixed-Membership: Topics sind nicht strikt disjunkt. Dennoch sind die Ergebnisse erstaunlich trennscharf. Nebenbei: LDA bietet mehr Parameter, du kannst dein Modell weiter tunen.
Der nächste Schritt ist richtig spannend: Wie machst du Topics noch greifbarer? Gelingt es dem Modell, Dokumente den wahrscheinlichsten Topics zuzuordnen, kannst du Writers gruppieren. Da du Genres kennst, kannst du die Ergebnisse eingeschränkt validieren. Zuerst klassifizierst du die Dokumente.
Zur Erinnerung: Jedes Dokument enthält mehrere Topics in unterschiedlichen Anteilen (gamma). Dieses Diagramm zeigt den durchschnittlichen gamma-Wert der Dokumente je Source pro Topic. Es ist derselbe Ansatz wie oben mit drei Writers, diesmal schaust du auf das Genre-Feld – eine fantastische Darstellung der Beziehung zwischen Genres und Topics.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")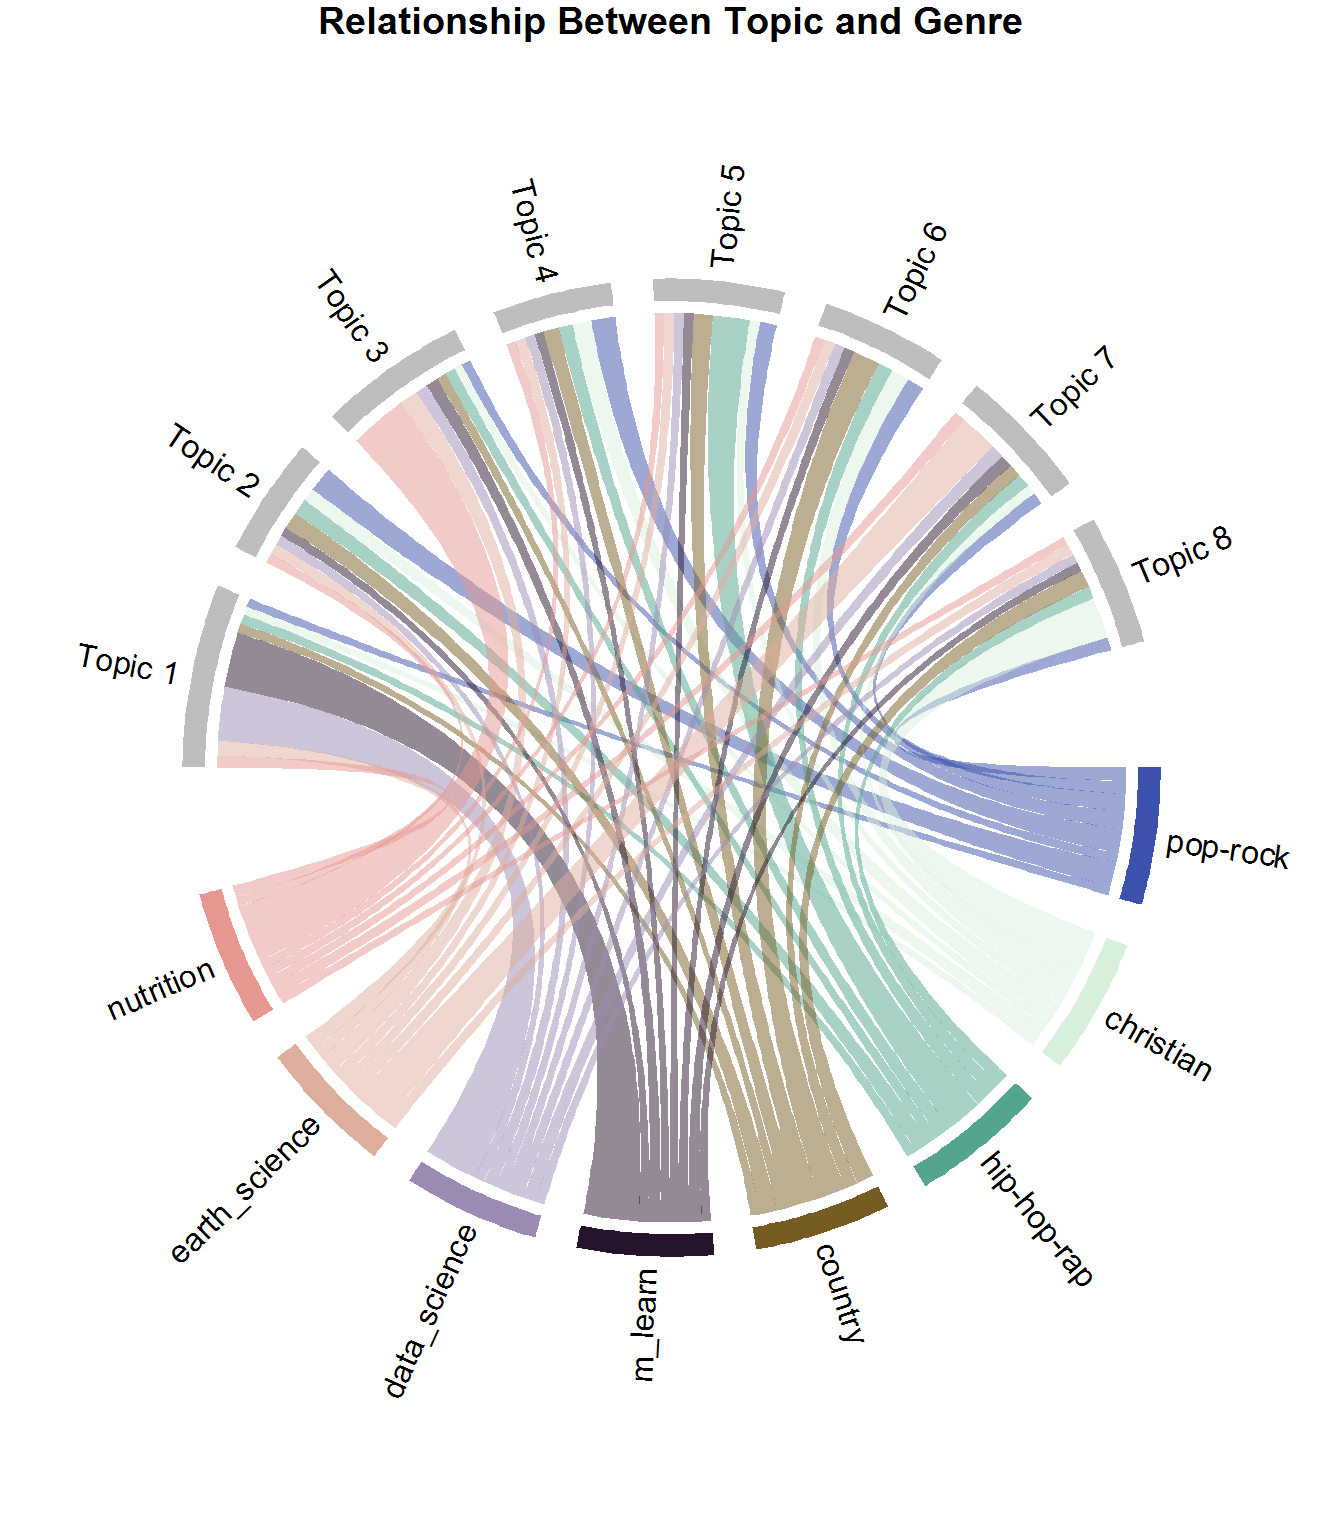
Jeder Chord (Link) repräsentiert den mittleren Gamma-Wert der Dokumente je Genre, die zu einem Topic gehören. Bei sports_nutrition ist der Chord zu Topic 3 am größten – mehr Seiten landen dort. Machine Learning/Data Science liegt überwiegend in Topic 1; Earth Science in Topic 7. Pop/Rock verteilt sich – logisch, Pop ist per Definition breiter Mainstream. Rap/Hip-Hop ist häufiger in Topic 5. Was fängst du damit an? Du kannst Hörer:innen themenbasiert Empfehlungen geben!
Klar, Lyrics müssen nicht das einzige Feature im Empfehlungssystem sein. In Kombination mit Metadaten wie Rhythmus, Instrumentierung, Tempo usw. wird das Erlebnis noch besser.
Da du nun die Beziehung zwischen Dokumenten und Topics siehst, gruppiere nach source (Writer) und Topic, summiere gamma je Gruppe und wähle je Writer das höchste topic_sum mit top_n(1). Da du das Gleiche für genre tun willst, erstelle top_items_per_topic() und übergib source als Typ. So kannst du die Funktion später mit genre erneut aufrufen.
Jetzt mappst du Writers auf Topics. Was erwartest du?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")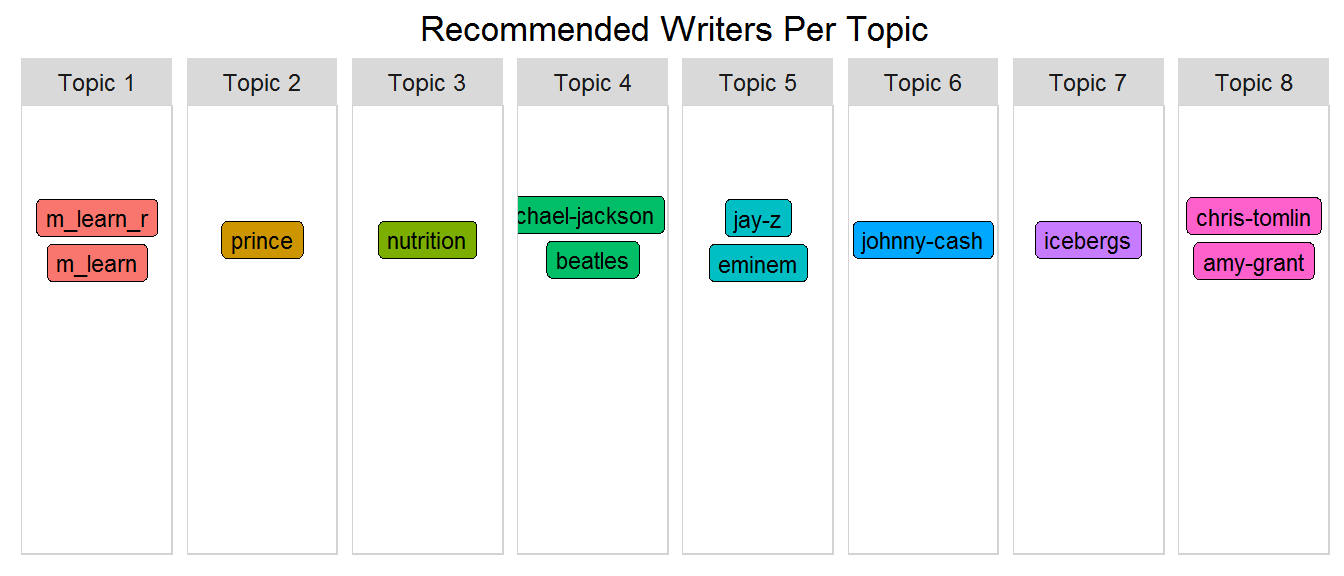
Sehr cool! Da dir die Artists evtl. nicht alle geläufig sind, machen wir es klarer und ersetzen den Writer durch das Genre. Bereit?
top_items_per_topic(lda, source_tidy, "genre")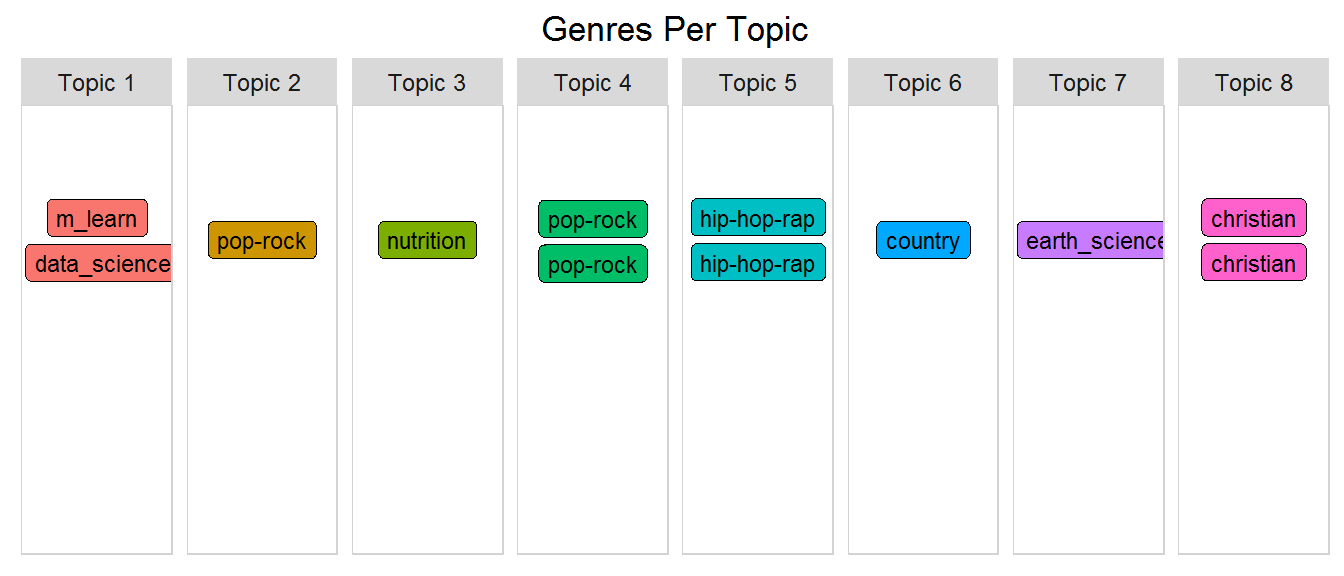
Hip-Hop/Rap-Artists sind gruppiert, christliche Artists ebenfalls; zwei Pop/Rock-Artists zusammen – und jedes Buch hat ein eigenes Topic! Beeindruckend, dass unüberwachtes Lernen allein anhand von Text solche Genre-Strukturen erkennt. Was passiert bei anderer Topic-Anzahl? Welche Genres würden zusammenfallen oder sich trennen? Probiere es aus. Als Nächstes fokussiert das Modell auf den Prince-Datensatz aus den vorherigen Tutorials.
Hier nutzt du den Datensatz nur mit Prince-Songs. Zwar gibt es unterschiedliche Themen in Lyrics, oft behandelt ein Song aber mehrere Themen. Mit nur einem Artist sind Topics stärker gemischt und weniger trennscharf – Interpretation ist umso wichtiger. Statt der Rohdaten nutzt du eine leicht veränderte, unten beschriebene Version.
Bisher hast du Wörter in ihrer Originalform verwendet. Jetzt nutzt du eine annotierte Datenform aus dem starken NLP-Paket cleanNLP. Das Paket bietet ein tidy Datenmodell für NLP mit Aufgaben wie Tokenisierung, Part-of-Speech-Tagging, Named Entity Recognition, Entity Linking, Sentimentanalyse u. v. m. Die Aufbereitung erfolgte außerhalb des Tutorials; alles Nötige fürs Topic Modeling ist enthalten.
Im annotierten Datensatz gibt es eine Zeile pro Wort im Korpus von Prince’ Lyrics mit wichtigen Infos zu jedem Wort.
Sieh dir das tokenisierte, annotierte Objekt über die Feldnamen an.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Fürs Erste nutzt du zwei Informationen:
word ist das Originalwort, lemma die lemmatisierte Form. upos ist der universelle POS-Code. Mit table() auf upos siehst du die Anzahl je Wortart. (Einige Wörter können mehrfach getaggt sein.)
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Zur Veranschaulichung fokussierst du auf ein paar Songs, bei denen lemma nicht dem Originalwort entspricht, und entfernst Stoppwörter.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
So kannst du sehr gezielt entscheiden, was du ins Modell gibst (Originalwort, Lemma oder eine Wortart). Ob du die lemmatisierte Form nutzt, ist eine Ermessensfrage. Eine weitere Option ist der Stamm (Stemming), erwähnt in Teil Zwei-A. Du kannst auch hinterfragen, was cleanNLP als Nomen vs. Adjektiv erkennt. Spiel mit verschiedenen Konfigurationen, bis es für dich passt.
Für dieses Tutorial modellierst du nur Nomen. Um Metadaten wie Genre und Jahr zu ergänzen, verknüpfst du prince_annotated mit prince_tidy über word und document und erstellst dann wie gewohnt die DTM. Einige sehr häufige, themenübergreifende Wörter entferne ich, um es interessanter zu halten. (Alternativ kannst du tf-idf aus Teil Eins nutzen, um verbreitete Wörter zu filtern.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)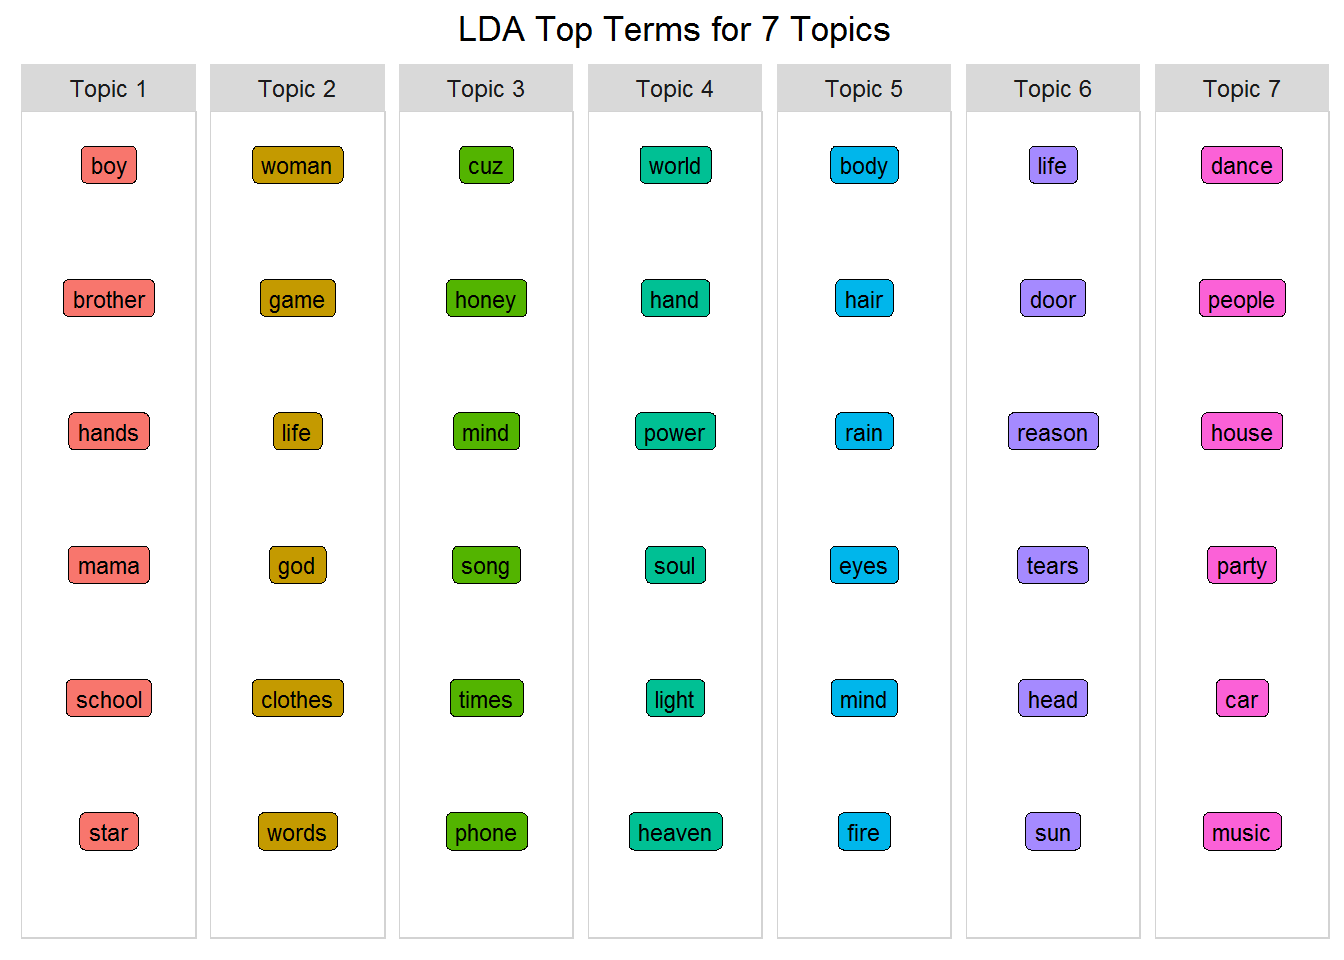
Über die Jahre wurden folgende potenzielle Prince-Themen genannt – mit typischen Schlüsselwörtern und teils überlappend (Reihenfolge zufällig!). Findest du sie in deinem Modell?
Es wirkt, als gehe Topic 1 um Menschen/Familie; Topic 7 um Musik/Tanz/Party; Topic 4 um Selbst/Gesellschaft/Religion. Die Interpretation ist subjektiv. Im Business-Kontext sollte sie idealerweise eine Fachexpertin/ein Fachexperte übernehmen. Hier zeigt sich, warum NLP an der Schnittstelle von KI und Computerlinguistik liegt.
Probiere andere Topic-Anzahlen, nur Verben, Originalwort statt Lemma, andere Top-Wort-Zahlen usw. aus. Neue Methoden helfen bei der Topic-Wahl: siehe Perplexity hier oder das Paket
ldatuninghier.
Da der Prince-Datensatz das Jahr enthält, kannst du Themen über die Zeit verfolgen. Hier nur ein einfacher Blick auf einige Wörter aus zwei Topics und ihre Häufigkeit über die Jahre. Trending allein könnte ein ganzes Tutorial füllen – eine gute Ressource findest du hier.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)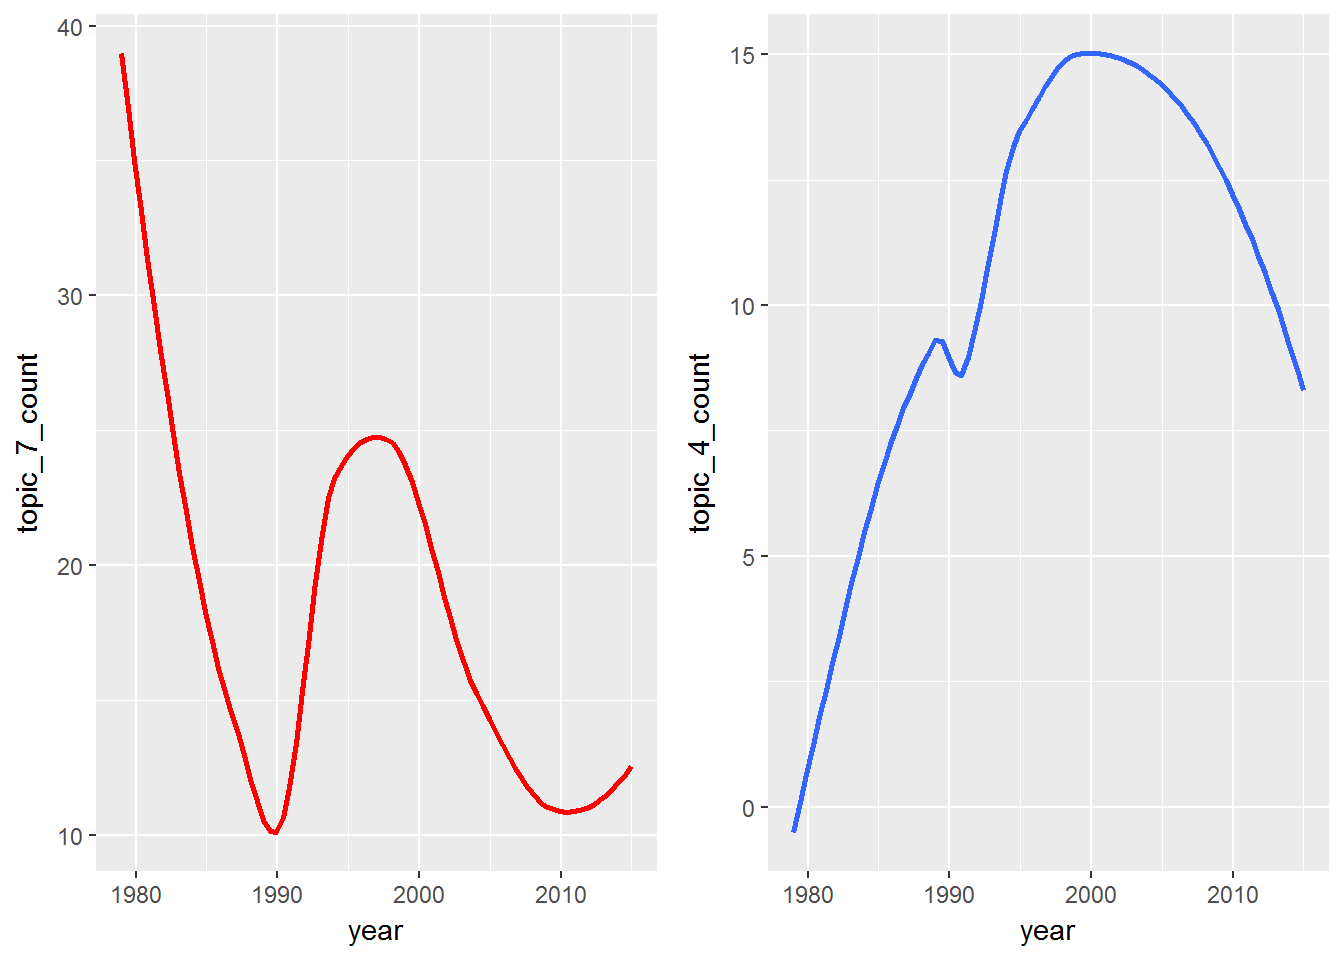
Das ist ein rudimentäres Beispiel dafür, wie sich Themen über die Zeit verändern. Übertrage diese Analyse auf andere Bereiche: Korrelation zwischen Produktverkäufen und Trendthemen in Kundentweets? Es gibt viele Anwendungen, um Themenverläufe zu verstehen.
Dieses Tutorial kratzt nur an der Oberfläche von Topic Modeling, NLP und Machine Learning. Das Feld boomt und wächst, je mehr Data Scientists die Ozeane unstrukturierter Daten erkunden. In der Musik findet die Klassifikation von Songs anhand ihrer Lyrics vor allem in der Forschung statt – vielleicht knüpfst du hier an und leistest deinen Beitrag zur KI-Welt.
Du hast Daten aus Lyrics und Sachbüchern genutzt, um Themen zu identifizieren, einzelne Dokumente den wahrscheinlichsten Topics zuzuordnen und ähnliche Writers anhand thematischer Inhalte zu finden. So entstand ein einfaches, textbasiertes Empfehlungssystem mit beschrifteten Writers.
Denk daran: Du modellierst Kunst mit Maschinen. Wenn ein Artist sagt: „You are the apple of my eye“, geht es nicht um Obst oder Körperteile. Du musst das Verborgene finden. Beim Hören nimmst du Hintergrundgesang nicht immer wahr – aber er ist da. Dreh deinen Lieblingssong auf, hör hinter die Lead-Vocals, und du entdeckst eine Welt versteckter Informationen. Lass Logik in den Hintergrund treten und bring Kreativität nach vorn!
Wie in allen Tutorials dieser Reihe: Nutze die Daten als unterhaltsame Fallstudie und als Ideenlieferant für Texte, die dich interessieren – deine Lieblingsartists, Social Media, Unternehmens-, wissenschaftliche oder sozioökonomische Texte. Welche Anwendungen siehst du für Topic Modeling? Teile deine Ideen unten in den Kommentaren!
Bleib dran für Teil Drei (den vierten Artikel) der Serie: Lyric Analysis: Predictive Analytics using Machine Learning with R. Dort nutzt du Lyrics und beschriftete Metadaten, um die Zukunft eines Songs vorherzusagen. Du arbeitest mit Algorithmen wie Decision Trees, Naive Bayes und weiteren, um Genre, Dekade und vielleicht sogar Chart-Erfolg zu prognostizieren! Bis bald!
Hinweise:
Hinweis eins: Die gleichen Ergebnisse erhältst du nur, wenn du den Code in exakt derselben Reihenfolge mit denselben, unveränderten Dateien ausführst. Andernfalls passen Verweise auf bestimmte Topics nicht mehr.
Hinweis zwei: Es gibt keine starren Regeln – die Arbeit basiert auf meiner eigenen Recherche. Obwohl Topic Modeling in realen Anwendungen existiert, gibt es bislang wenig Aktivität rund um Musik-Empfehlungen ausschließlich auf Basis von Lyrics.
Hinweis drei: Topic Modeling ist knifflig. Ein Modell zu bauen ist das Eine; die Interpretation ist herausfordernd, subjektiv und schwer vollständig zu validieren (es gibt aber Forschung, siehe diesen Artikel von Thomas W. Jones). Der Prozess ist unüberwacht, generativ, iterativ und probabilistisch. Topics sind subtil, verborgen und implizit, nicht explizit.
Wenn du mehr über Machine Learning mit R lernen möchtest, sieh dir unser Einsteiger-Tutorial an. Außerdem empfehlen wir den Kurs Introduction to Machine Learning course.
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs