Khóa học
Tìm hiểu Machine Learning
2 giờ
313.7K
Ứng dụng các kỹ thuật tiên tiến với R, NLP và Machine Learning để mô hình hóa chủ đề trong văn bản và tự xây dựng hệ thống gợi ý âm nhạc của riêng bạn!
Đây là Phần Hai-B trong loạt hướng dẫn gồm ba phần, nơi bạn sẽ tiếp tục dùng R để thực hiện nhiều tác vụ phân tích trên nghiên cứu tình huống về ca từ của nghệ sĩ huyền thoại Prince, cũng như các nghệ sĩ và tác giả khác. Ba hướng dẫn bao gồm:
Hãy tưởng tượng bạn là một Nhà khoa học dữ liệu làm việc cho NASA. Bạn được yêu cầu giám sát hai tàu vũ trụ vào quỹ đạo Mặt Trăng, nghiên cứu tương tác giữa Mặt Trăng và Mặt Trời. Như mọi tàu vũ trụ, có thể xuất hiện những vấn đề được ghi nhận trong quá trình thử nghiệm hoặc sau khi phóng. Những bất thường này được ghi chép bằng ngôn ngữ tự nhiên trong gần 20.000 báo cáo sự cố. Nhiệm vụ của bạn là xác định các chủ đề phổ biến nhất và xu hướng chủ đạo trong tập hợp báo cáo, đồng thời cung cấp kết quả phân tích mang tính khuyến nghị cho các kỹ sư và giám đốc chương trình, qua đó tác động đến tương lai của thám hiểm không gian.
Đây là một ví dụ tình huống thực tế và sẽ cho bạn hình dung về sức mạnh bạn sẽ có trong tay sau khi học cách sử dụng các kỹ thuật tiên tiến như mô hình chủ đề với học máy, Xử lý ngôn ngữ tự nhiên (NLP) và lập trình R. May mắn thay, bạn không cần làm việc cho NASA để làm điều gì đó sáng tạo không kém. Trong hướng dẫn này, nhiệm vụ của bạn, nếu bạn chọn nhận, là tìm hiểu về mô hình chủ đề và cách xây dựng một hệ thống gợi ý đơn giản dựa trên ca từ âm nhạc và sách phi hư cấu.
Vui một chút!
Phần này không liên quan đến mô hình chủ đề, nhưng để giải trí, hãy dùng gói tuyệt vời circlize (đã giới thiệu ở hướng dẫn trước) để kích hoạt các thụ thể ánh sáng và thưởng thức sơ đồ tròn của tất cả nguồn dữ liệu bạn sẽ dùng trong hướng dẫn này.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)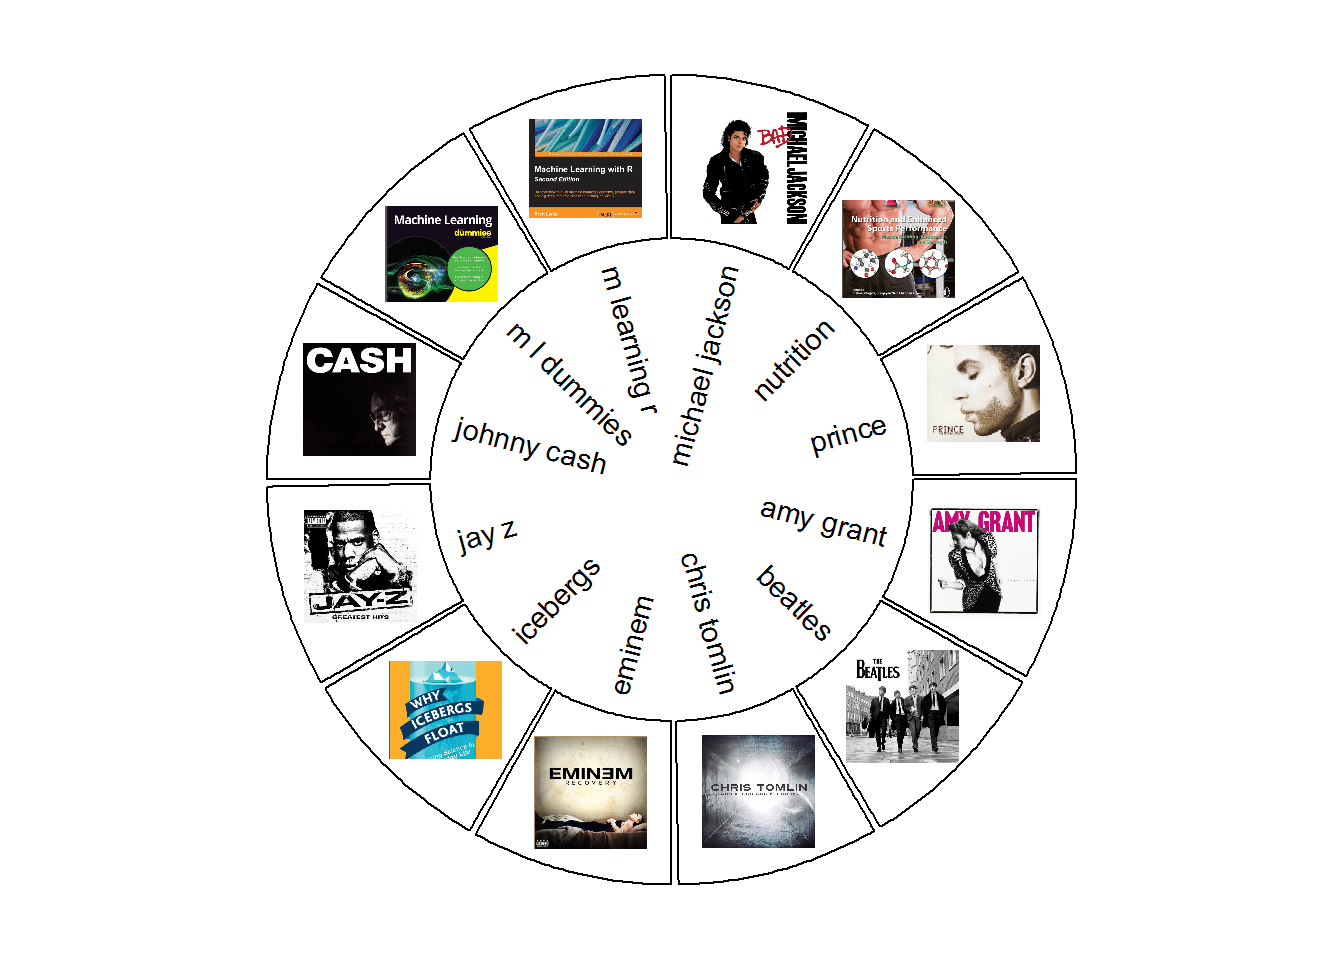
Trong các hướng dẫn trước, bạn đã nghiên cứu nội dung ca từ của Prince bằng tần suất từ, thống kê tf-idf và phân tích cảm xúc. Bạn có thể đi sâu hơn vào ca từ và văn bản khác bằng khái niệm mô hình chủ đề.
Trong hướng dẫn này, bạn sẽ xây dựng bốn mô hình sử dụng Latent Dirichlet Allocation (LDA) và các thuật toán học máy phân cụm K-Means. Tôi sẽ giải thích các thuật toán sau trong hướng dẫn.
Mô hình Một sử dụng văn bản từ ca từ của Prince kết hợp với hai cuốn sách phi hư cấu. Mục tiêu là mang đến ví dụ đơn giản về cách dùng LDA, một thuật toán không giám sát, để sinh ra các tập hợp từ gợi ý nên các chủ đề. Các chủ đề này không có nhãn và cần con người diễn giải. Sau khi xác định số lượng chủ đề định trước, bạn sẽ lấy kết quả mô hình và phân loại từng bài hát hoặc từng trang sách vào mỗi danh mục. Một bài hát có thể chứa tất cả chủ đề bạn tạo ra, nhưng phù hợp hơn với một chủ đề so với chủ đề khác. Điều này được gọi là phân loại tài liệu, nhưng vì bạn biết tác giả của tài liệu, về bản chất bạn đang phân loại các tác giả vào nhóm chủ đề.
Mô hình Hai dùng bộ dữ liệu của Mô hình Một và cho cái nhìn nhanh về việc sinh chủ đề bằng thuật toán khác, k-means, và vì sao nó có thể không phải lựa chọn tốt nhất cho mô hình chủ đề.
Tiếp tục dùng LDA, Mô hình Ba sử dụng bộ dữ liệu lớn hơn với nhiều nghệ sĩ thuộc các thể loại khác nhau và nhiều tác giả sách hơn. Khi bạn phân loại phần lớn tài liệu của một tác giả/nghệ sĩ vào chủ đề có khả năng nhất của họ, bạn có khả năng nhóm các tác giả có bố cục chủ đề tương đồng. Với mô hình tốt, bạn sẽ thấy các thể loại tương tự xuất hiện trong cùng nhóm chủ đề. Ví dụ, các nghệ sĩ rap sẽ xuất hiện trong một chủ đề, và hai cuốn sách về chủ đề tương tự sẽ xuất hiện cùng nhau trong chủ đề khác. Nhờ đó, bạn có thể gợi ý các tác giả tương đồng! Dĩ nhiên, tác giả và thể loại của họ có nhãn, nhưng các chủ đề thì không, nên vẫn là không giám sát.
Mô hình Bốn dùng LDA chỉ trên ca từ của Prince. Lần này bạn sẽ dùng bộ dữ liệu được gán nhãn tạo bên ngoài hướng dẫn này, trong đó mỗi từ được gắn nhãn loại từ (danh từ, động từ, v.v.) và dạng gốc (được lemmatize) của từ. Bạn cũng sẽ xem một chủ đề thay đổi theo thời gian như thế nào.
NLP và Machine Learning là các phân ngành của Trí tuệ nhân tạo. Gần đây đã có những thử nghiệm dùng AI để sáng tác nhạc. Đó không phải mục tiêu của hướng dẫn này, nhưng là ví dụ về AI như một hình thức nghệ thuật. Xét cho cùng, ba chữ cái đầu là A-R-T! Hãy so sánh AI với sáng tác: bạn có thể dễ dàng theo một khuôn mẫu và tạo cấu trúc (verse, chorus, verse, v.v.), nhưng điều làm nên một bài hát hay là khi người viết thổi sự sáng tạo vào quá trình. Trong hướng dẫn này, bạn cần vận dụng kỹ năng kỹ thuật để xây dựng mô hình, nhưng cũng cần đánh thức sự sáng tạo nghệ thuật và phát triển khả năng diễn giải, giải thích kết quả.
Hãy nghĩ thế này: Nếu mô hình chủ đề là nghệ thuật, thì ca từ là mã, viết bài hát là algo-rhythm, và bài hát chính là mô hình! Ẩn dụ của bạn là gì?
Các hệ thống gợi ý điển hình không hoàn toàn dựa trên văn bản. Ví dụ, Netflix có thể gợi ý phim dựa trên lựa chọn trước đó và metadata liên quan. Pandora có cách tiếp cận khác, dựa trên một Bộ gene Âm nhạc gồm 400 thuộc tính âm nhạc, bao gồm giai điệu, nhịp, hòa thanh và tóm tắt ca từ; tuy nhiên, việc phát triển bộ gene này bắt đầu năm 2000 và mất 5 năm cùng 30 chuyên gia lý thuyết âm nhạc để hoàn tất. Có rất nhiều bài nghiên cứu bàn về gợi ý phim dựa trên tóm tắt cốt truyện. Ví dụ về hệ thống gợi ý nhạc dựa hoàn toàn vào nội dung ca từ thì khó tìm hơn. Bạn muốn thử chứ?
Phần Hai-B của loạt hướng dẫn này yêu cầu hiểu biết cơ bản về dữ liệu tidy - đặc biệt là các gói như dplyr và ggplot2. Khuyến nghị thực hành khai phá văn bản bằng tidytext, vì đã được đề cập ở các hướng dẫn trước. Bạn cũng cần quen với hàm trong R, vì bạn sẽ dùng một vài hàm để tái sử dụng mã cho mỗi mô hình. Để tập trung vào rút ra insight, tôi đã kèm mã được thiết kế để dùng trên bộ dữ liệu của riêng bạn, nhưng giải thích chi tiết có thể cần bạn tự tìm hiểu thêm.
Bạn có thể làm gì với mô hình chủ đề? Có lẽ có những tài liệu chứa thông tin quan trọng cho doanh nghiệp mà bạn có thể khai thác. Có thể bạn có thể thu thập dữ liệu từ Twitter và xem mọi người nói gì về sản phẩm của công ty. Hoặc tự xây dựng hệ thống phân loại để chuyển đúng tài liệu đến đúng bộ phận phân tích. Có một thế giới khả năng để bạn khám phá! Hãy bắt đầu!
Dưới đây là một số ứng dụng của mô hình chủ đề:
Những gói mới trong hướng dẫn này không có trong Phần Một hay Phần Hai-A là topicmodels, tm và plotly. Bạn sẽ dùng hàm LDA() từ topicmodels cho phép mô hình học cách phân biệt giữa các tài liệu. Gói tm dùng cho khai phá văn bản, và bạn chỉ dùng inspect() một lần để xem bên trong ma trận tài liệu-từ, tôi sẽ giải thích sau. Bạn chỉ dùng plotly một lần để tạo phiên bản tương tác của biểu đồ ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Các hàm sau đã được định nghĩa ở những hướng dẫn trước, ngoại trừ word_chart(); tuy vậy, nội dung và mô tả của word_chart() cũng có trong Phần Hai-B. Chủ yếu, bạn cần biết rằng nó dùng ggplot() theo cách riêng để tạo trực quan dựa trên từ thay vì điểm.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Để thật sự thấy sức mạnh của mô hình chủ đề và phân loại, bạn sẽ không chỉ dùng ca từ của Prince như các hướng dẫn trước, mà còn làm việc với nhiều nghệ sĩ khác thuộc các thể loại được công nhận trên BXH Billboard. Ngoài ra, tôi thêm một vài cuốn sách về các chủ đề khác nhau như dinh dưỡng thể thao, băng trôi và cả machine learning! Với bộ dữ liệu đa dạng, bạn có thể phân loại tài liệu vào các chủ đề liên quan và phân biệt giữa các nghệ sĩ/tác giả tương tự.
Mẹo: Tôi sẽ gọi bài hát và các trang sách là tài liệu, và nhạc sĩ/tác giả là tác giả. Trong mã, bạn sẽ thấy tham chiếu đến từ source. Đơn giản nó chỉ nói đến tác giả mà dữ liệu đề cập. Tôi sẽ dùng từ genre để nói về cả thể loại âm nhạc lẫn hạng mục sách. Thay vì dùng tên tác giả sách, tôi dùng tựa sách để dễ hiểu. Những tham chiếu này sẽ hợp lý khi bạn đi qua hướng dẫn.
Để tập trung vào mô hình, tôi đã xử lý điều kiện dữ liệu bên ngoài hướng dẫn này và cung cấp sẵn cho bạn toàn bộ dữ liệu trong ba tệp dưới đây với các bước xử lý sau đã được áp dụng:
pdf_text() từ gói pdftools để lấy nội dung của bốn cuốn sách (mỗi trang là một tài liệu riêng)tidytext như mô tả ở Phần MộtBạn sẽ có ba bộ dữ liệu riêng để làm việc trong hướng dẫn này:
three_sources_tidy_balanced: chứa ca từ của Prince và hai cuốn sáchall_sources_tidy_balanced: chứa ca từ của tám nghệ sĩ và bốn cuốn sáchprince_tidy: chỉ chứa ca từ của PrinceTôi cũng kèm bộ dữ liệu chú giải (annotated) ca từ của Prince. Tôi sẽ giải thích “annotated” nghĩa là gì khi đến Mô hình Bốn.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)Mục tiêu chính của mô hình chủ đề là tìm các thuật ngữ có liên quan về mặt chủ đề (chủ đề) trong dữ liệu văn bản phi cấu trúc, được đo bằng các mẫu đồng xuất hiện của từ. Thành phần cơ bản của mô hình chủ đề là tài liệu, thuật ngữ và chủ đề. Latent Dirichlet Allocation (LDA) là phương pháp học không giám sát, khám phá các chủ đề khác nhau ẩn trong một tập hợp tài liệu, trong đó mỗi tài liệu là tập hợp các từ. LDA đưa ra các giả định sau:
LDA tìm cách phát hiện các nhóm từ có liên quan. Đây là một thuật toán sinh, lặp. Hai bước chính:
Ý tưởng đằng sau LDA là các từ thuộc một chủ đề sẽ xuất hiện cùng nhau trong tài liệu. Nó cố gắng mô hình hóa mỗi tài liệu như hỗn hợp của các chủ đề và mỗi chủ đề như hỗn hợp của các từ. (Bạn có thể thấy điều này được gọi là mô hình hỗn hợp thành viên.) Sau đó, bạn có thể dùng xác suất tài liệu thuộc một chủ đề cụ thể để phân loại. Trong trường hợp của bạn, vì biết tác giả của tài liệu từ dữ liệu gốc, bạn có thể gợi ý nghệ sĩ/tác giả dựa trên cấu trúc chủ đề tương tự. Giờ hãy xem ví dụ.
Với mô hình này, bạn sẽ dùng bộ dữ liệu gồm ba tác giả khác nhau (tức là nguồn) và tìm các chủ đề ẩn. Để giúp bạn hiểu sức mạnh của mô hình chủ đề, ba nguồn này rất khác nhau và theo trực giác bạn biết chúng bao quát ba chủ đề khác nhau. Do đó, bạn sẽ yêu cầu mô hình tạo ba chủ đề và xem mức độ “thông minh” của nó. Trước tiên, bạn muốn xem bộ dữ liệu bằng hàm my_kable_styling() cùng color_bar() và color_tile() từ gói formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
Tại đây bạn sẽ dùng ca từ của Prince, một cuốn sách tên "Machine Learning For Dummies", và một cuốn khác tên "Why Icebergs Float", mỗi nguồn có hơn 30.000 từ (không duy nhất).
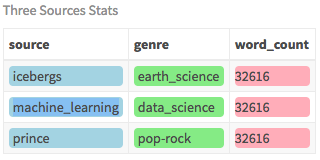
Vì hiện bạn có bộ dữ liệu tidy cân bằng với ca từ của Prince và hai cuốn sách, trước tiên bạn sẽ tạo ma trận tài liệu-từ (DTM) trong đó mỗi hàng là một tài liệu, mỗi cột là một thuật ngữ. Đây là định dạng bắt buộc cho thuật toán LDA. Tài liệu ở đây là bài hát trong ca từ và số trang trong sách. Trước hết, bạn lấy dữ liệu tidy và đếm từ trong một tài liệu, sau đó truyền vào hàm cast_dtm() của tidytext, trong đó document là tên trường chứa tên tài liệu và word là tên trường chứa thuật ngữ. Có thể truyền tham số khác, nhưng hai tham số này là bắt buộc.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Điều này cho bạn biết có bao nhiêu tài liệu và thuật ngữ, và đây là ma trận rất thưa. “Thưa” ngụ ý DTM chứa chủ yếu là ô trống. Vì vốn từ vựng rất lớn từ tất cả tài liệu, chỉ một phần nhỏ sẽ được dùng trong mỗi tài liệu riêng lẻ.
Nếu bạn xem nội dung một vài hàng và cột của DTM bằng hàm inspect() từ gói tm, bạn sẽ thấy mỗi hàng là một tài liệu và mỗi cột là một thuật ngữ. (Có thể dùng str() để xem cấu trúc thực.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Giờ bạn đã biết cần gì làm đầu vào để xây dựng mô hình, hãy đặt hai biến để đơn giản thay đổi khi dựng từng mô hình. Bạn sẽ gọi chúng là source_dtm và source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedCuối cùng đến phần thú vị là huấn luyện mô hình. Mã khá đơn giản, nhưng để trở thành Nhà khoa học dữ liệu tốt, bạn nên hiểu điều gì diễn ra bên trong. Dù đây chỉ là mô tả sơ lược, có rất nhiều tài liệu về LDA trên mạng. Với mục đích của bạn, chỉ cần biết bốn tham số: đầu vào, số chủ đề, phương pháp lấy mẫu và seed.
Vì bạn biết bộ dữ liệu có ba tác giả khác biệt, bạn đặt k là 3 và đặt seed hằng số để có thể lặp lại kết quả. Có các tham số control khác, nên dùng dạng list trong mã, nhưng giờ bạn chỉ dùng seed. Tham số method định nghĩa thuật toán lấy mẫu. Bạn sẽ dùng phương pháp lấy mẫu GIBBS. Mặc định là VEM, nhưng theo kinh nghiệm của tôi, nó không hoạt động tốt bằng GIBBS.
Giải thích kỹ thuật ngắn gọn về lấy mẫu GIBBS là nó thực hiện một bước ngẫu nhiên bắt đầu ở điểm nào đó bạn có thể khởi tạo (bạn sẽ dùng mặc định 0) và ở mỗi bước di chuyển cộng hoặc trừ một với xác suất bằng nhau. Đọc mô tả chi tiết tại đây nếu bạn quan tâm.
Lưu ý: Tôi đã lướt qua chi tiết của thuật toán LDA. Dù bạn không cần hiểu lý thuyết thống kê để dùng nó, tôi khuyên đọc tài liệu này của Ethen Liu để có giải thích vững chắc.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Bạn thấy đã tạo đối tượng LDA_Gibbs với ba chủ đề. Tôi không chạy str(lda) ở đây vì đầu ra dài, nhưng bạn có thể tự chạy để xem nó chứa gì.
Bước tiếp theo là mở đối tượng đó ra và xem kết quả. Bạn có thể dùng hàm tidy() để đưa về định dạng dễ hiểu. Trong lệnh gọi tidy(), truyền đối tượng LDA và beta cho đối số matrix. Truyền beta sẽ cho bạn xác suất theo chủ đề-theo-từ từ mô hình. Ví dụ dưới đây, với thuật ngữ iceberg, cho thấy xác suất từ đó ở mỗi chủ đề. Từ iceberg có xác suất cao hơn được sinh ra ở Chủ đề 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Để hiểu rõ mô hình, bạn cần xem những thuật ngữ nào nằm trong mỗi chủ đề. Xây dựng một hàm sẽ tidy mô hình LDA và trích xuất các thuật ngữ hàng đầu cho mỗi chủ đề. Nói cách khác, các thuật ngữ theo chủ đề có giá trị beta lớn nhất. Bên trong hàm này, bạn sẽ tham chiếu word_chart() đã xây dựng trước đó để tạo hiển thị đẹp của ba chủ đề và các từ hàng đầu. Đặt num_words là 10 cho ví dụ này, nhưng bạn có thể thay đổi để có góc nhìn khác.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)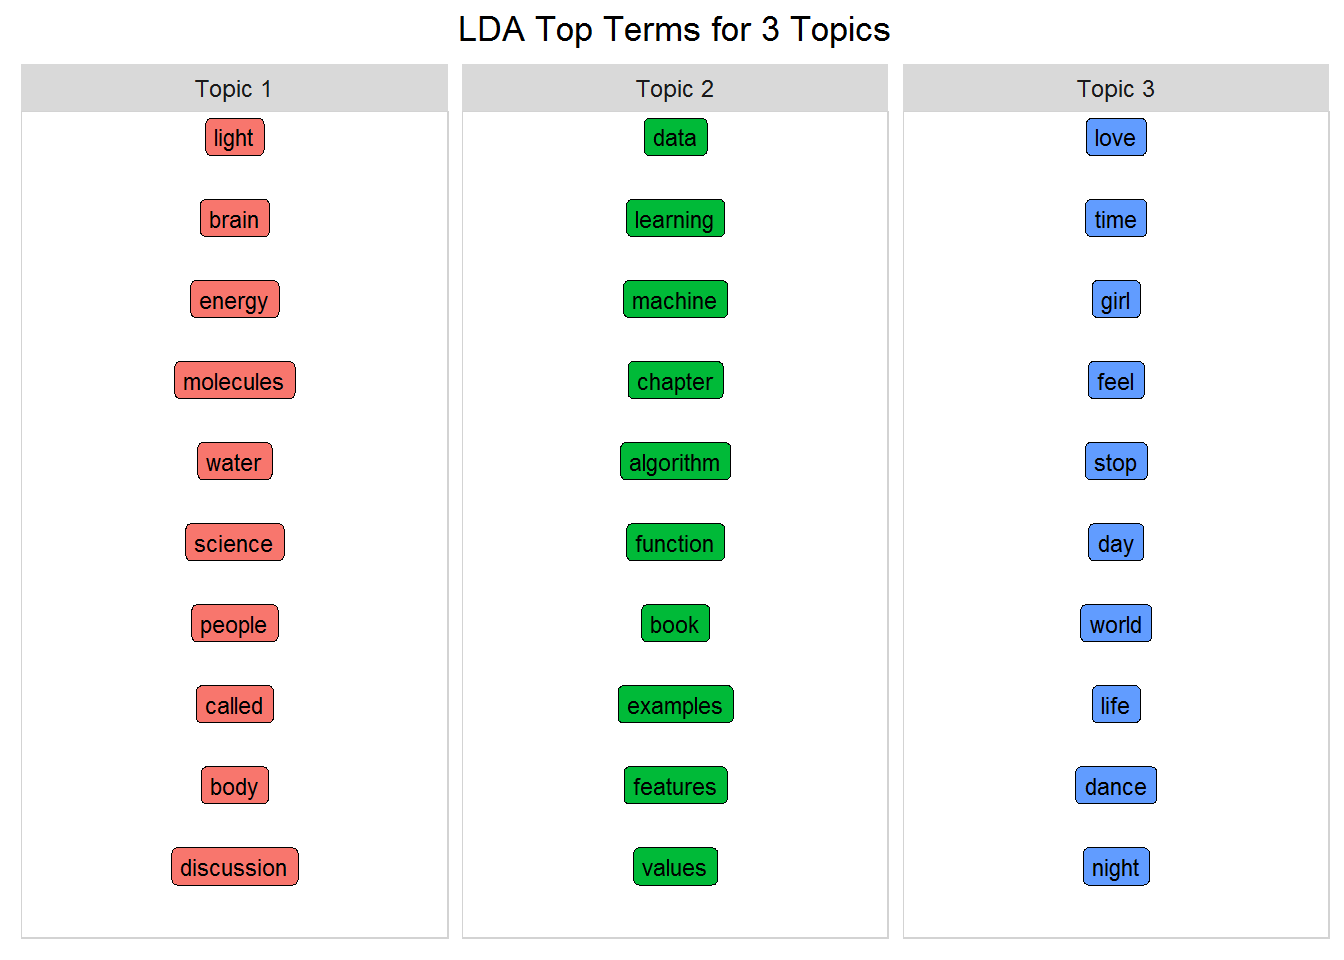
Học không giám sát luôn cần con người diễn giải... nhưng các chủ đề này rõ ràng phản ánh ba nguồn Icebergs, Machine Learning và Prince! Dù đây là ví dụ rất đơn giản, cũng thật ấn tượng nếu nghĩ về các khả năng!
Bên cạnh ước lượng mỗi chủ đề là hỗn hợp của từ, LDA còn cho thấy mỗi tài liệu là hỗn hợp của chủ đề. Lần này khi tidy mô hình LDA, dùng matrix = "gamma" và bạn sẽ có xác suất theo tài liệu-theo-chủ đề. Ví dụ, xem bài hát 1999 của Prince. Ở đây bạn thấy, cũng như một từ có thể liên quan đến nhiều chủ đề, tài liệu cũng vậy. Điều này quay lại khái niệm hỗn hợp thành viên. Dưới đây bạn có thể thấy 1999 có khả năng cao nhất xuất hiện trong Chủ đề 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661Bài hát này thuộc mọi chủ đề, nhưng ở tỷ lệ khác nhau, thể hiện bằng giá trị gamma. Một số tài liệu phù hợp với một số chủ đề hơn. Như trên, 1999 có giá trị gamma cao hơn với Chủ đề 3.
Để làm rõ hơn hiểu biết của bạn về LDA, hãy xem đồ thị tròn này. Đồ thị cho thấy tỷ lệ phần trăm tài liệu từ mỗi nguồn thuộc về mỗi chủ đề. Để tạo, hãy nối mô hình LDA dạng tidy trở lại source_tidy nơi bạn lưu source thực (tức tác giả), và nối theo document. Sau đó nhóm phù hợp, bạn có thể lấy giá trị gamma trung bình theo nguồn và chủ đề. Giờ bạn có thể thấy, với mỗi nguồn, đa số tài liệu rơi vào chủ đề nào.
Dành chút thời gian để thật sự xem nếu bạn chưa dùng biểu đồ tròn trước đây. (Xem Phần Hai-A để luyện với chordDiagrams() và gói circlize. Tất cả những gì bạn cần biết về gói được trình bày trong cuốn của Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")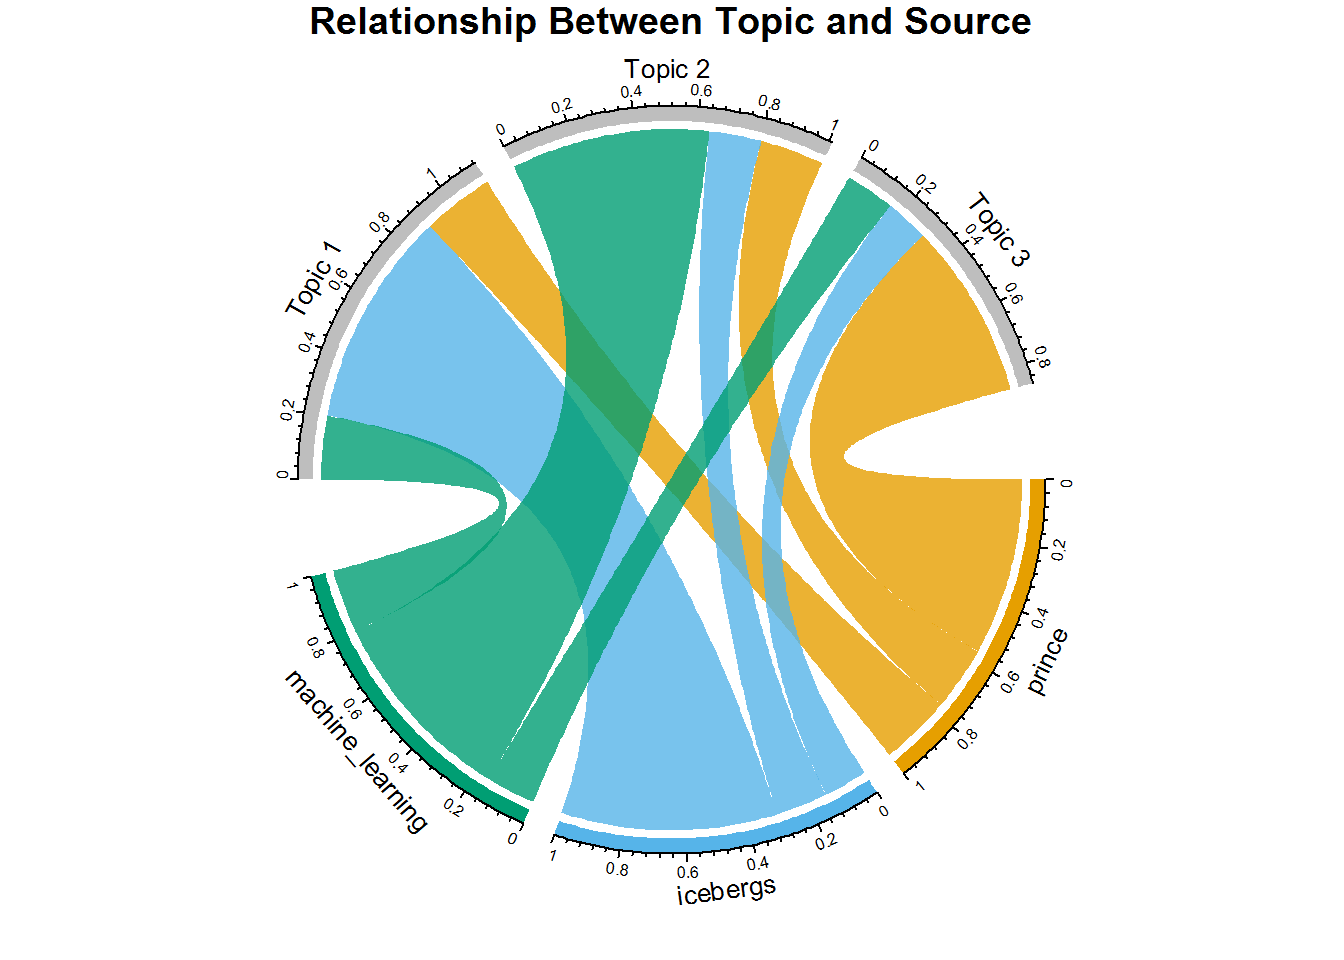
Đây là cách rất thú vị để thấy rằng dù tài liệu từ mỗi nguồn xuất hiện ở mỗi chủ đề, mỗi nguồn rõ ràng có đa số trong một chủ đề cụ thể. Ví dụ, bài hát của Prince chủ yếu liên quan Chủ đề 3 vì chord đó lớn hơn chord đi tới chủ đề một và hai. Tương tự với Icebergs và Chủ đề 1, và Machine Learning và Chủ đề 2. Khi thấy mẫu này, điều gì đang xảy ra trở nên rất rõ.
Nếu nghĩ về những gì vừa làm, bạn đã phân loại tài liệu vào Chủ đề dựa trên trung bình gamma cho một chủ đề/nguồn. Nếu bạn biết tác giả của tài liệu, và biết tác giả sáng tác phần lớn ca từ hoặc sách về một chủ đề cụ thể, bạn có thể giả định nghệ sĩ cùng thể loại sẽ rơi vào cùng chủ đề, từ đó có thể gợi ý tác giả tương tự... Khi xem bộ dữ liệu lớn hơn, bạn sẽ thực hành bài tập này.
Giờ xem ở cấp độ tài liệu và xem các tài liệu hàng đầu theo chủ đề.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)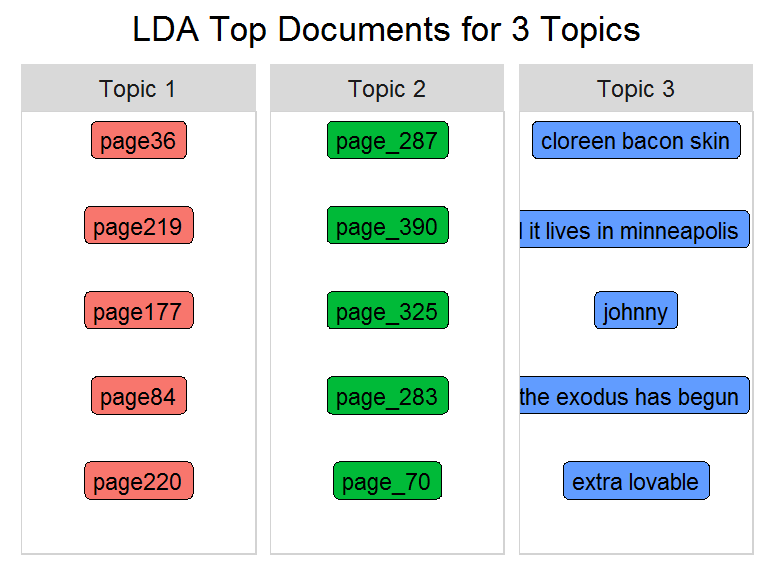
Vì bạn có thể không biết danh pháp của tiêu đề tài liệu/bài hát (ví dụ trang có dấu gạch dưới là từ sách machine learning), tôi sẽ thay tên tài liệu bằng tên nguồn.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)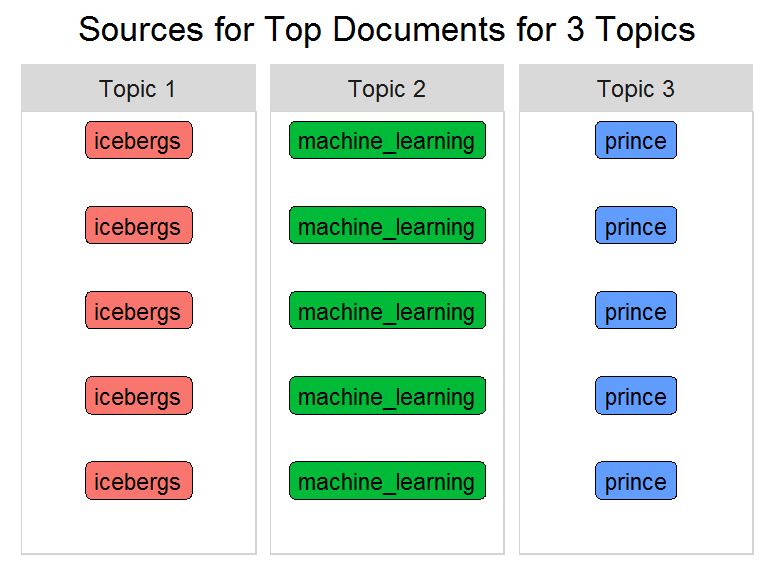
Các tài liệu hàng đầu cho mỗi chủ đề như ở biểu đồ trước đã được thay bằng nguồn của chúng. Mã của bạn đã phân loại tốt các tài liệu này vì chúng rơi vào cùng hạng mục (ít nhất là với top 5)! Câu hỏi lớn là liệu điều này có hiệu quả với nhiều hơn ba nguồn hay không. Nếu kết quả chính xác, bạn có thể gợi ý các tác giả có chủ đề tương tự.
Bạn sẽ tạo mô hình thứ hai bằng kỹ thuật học máy khác: thuật toán k-means. Cũng như LDA, k-means là thuật toán học không giám sát và yêu cầu bạn quyết định số chủ đề trước. Trái với mô hình hỗn hợp thành viên của LDA, k-means phân hoạch tài liệu thành các cụm rời rạc (tức là chủ đề). Ở đây, thuật toán gom tài liệu vào nhóm khác nhau dựa trên thước đo tương tự. Nó biến đổi tài liệu thành vector số với trọng số gán cho từ theo tài liệu (tương tự tf-idf). Mỗi tài liệu sẽ nằm chính xác trong một cụm. Đây gọi là phân cụm cứng. Đầu ra là tập các cụm và tài liệu của chúng. Ngược lại, LDA là phân cụm mềm (fuzzy) nơi một điểm dữ liệu có thể thuộc nhiều cụm.
Về mặt khái niệm, khi áp dụng cho ngôn ngữ tự nhiên, LDA sẽ cho kết quả gán chủ đề thực tế hơn k-means, vì văn bản thường bao hàm nhiều chủ đề. Hãy xây mô hình, kiểm tra đối tượng k-means và xem giả định của bạn có đúng không.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"Cấu trúc đối tượng k-means cho thấy hai thông tin quan trọng: clusters và centers. Bạn có thể dùng định dạng dưới đây để xem nội dung mỗi biến cho bài hát 1999 và từ party xuất hiện trong bài hát đó.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Các trường này cho thấy 1999 nằm trong một cụm duy nhất (cụm hai), và party có trong cả ba cụm, nhưng chủ yếu ở cụm một. Giờ hãy xem các từ hàng đầu dựa trên giá trị centers để nhận diện chủ đề.
Nhớ rằng bộ dữ liệu này có ba nguồn: Prince, Icebergs và Machine Learning. In ra các từ hàng đầu cho mỗi cụm và so sánh với đầu ra LDA. Bạn cần thao tác định dạng dữ liệu đôi chút để dùng hàm word_chart(). Bạn có thể đi theo mã, nhưng chi tiết không quan trọng bằng việc phân tích các từ hàng đầu.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)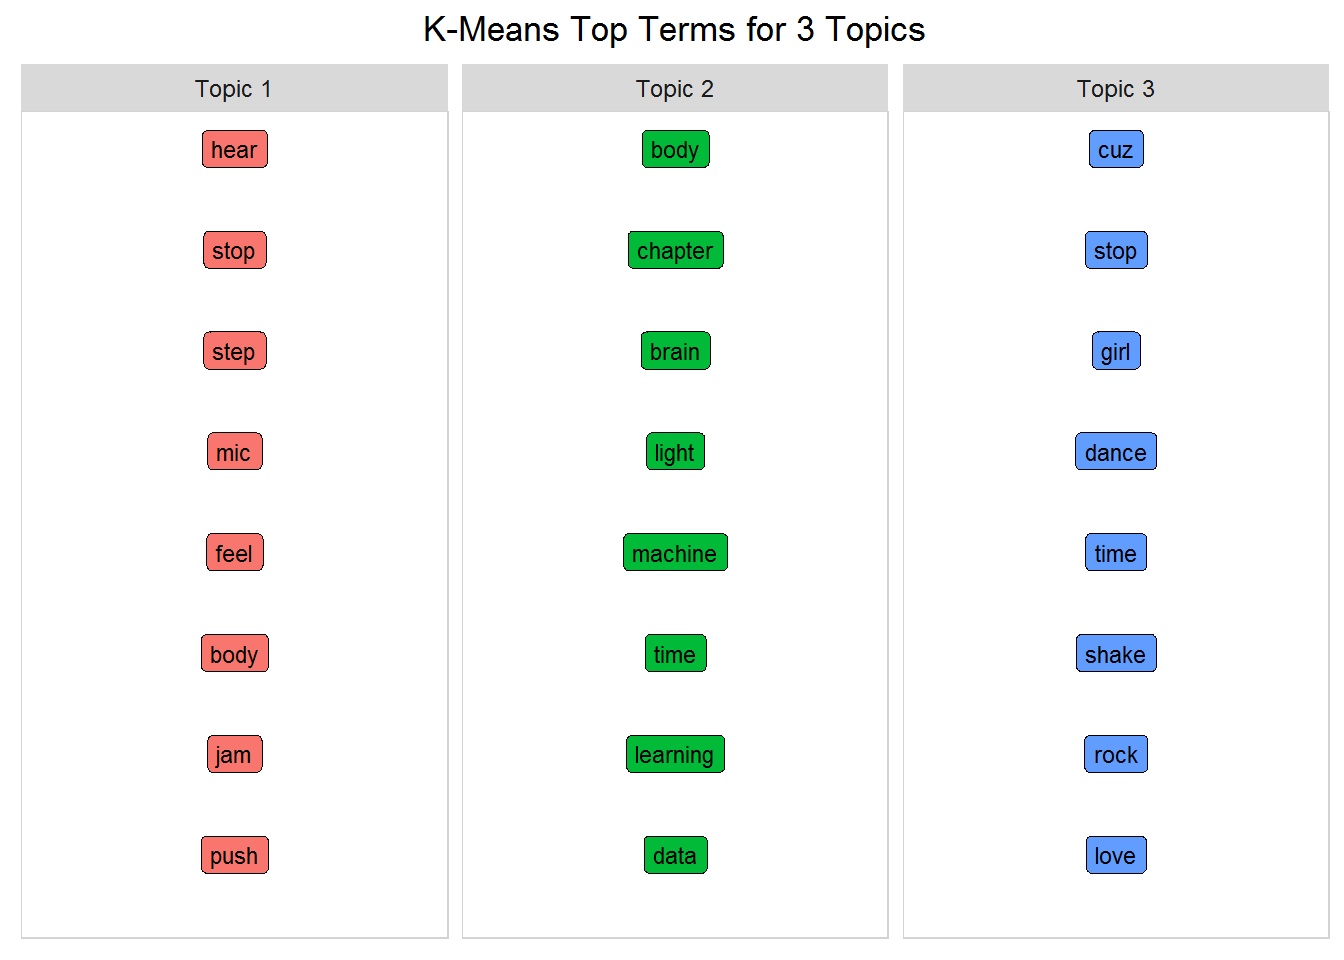
Thuật toán k-means đủ “thông minh” để tách chủ đề giữa sách và nhạc. Nói cách khác, Chủ đề 1 và 3 rõ ràng là chủ đề của Prince, còn Chủ đề 2 là kết hợp của hai cuốn sách. Tuy nhiên, nó không phân biệt được giữa hai cuốn sách như bạn đã làm với LDA. K-means có thể được tinh chỉnh để hiệu quả hơn, nhưng LDA cũng vậy. Nhìn nhanh, với tham số mặc định, k-means có vẻ không tốt bằng LDA, và trên thực tế, phân cụm cứng thường không dùng nhiều cho mô hình chủ đề. (Với lựa chọn khác, xem gói mallet.)
Với mô hình này, bạn sẽ dùng thuật toán LDA trên bộ dữ liệu có 12 nguồn/tác giả khác nhau bao phủ nhiều thể loại. Bộ dữ liệu đã được cân bằng với số tài liệu và số từ tương tự cho mỗi tác giả. Sau đây là tổng quan dữ liệu:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")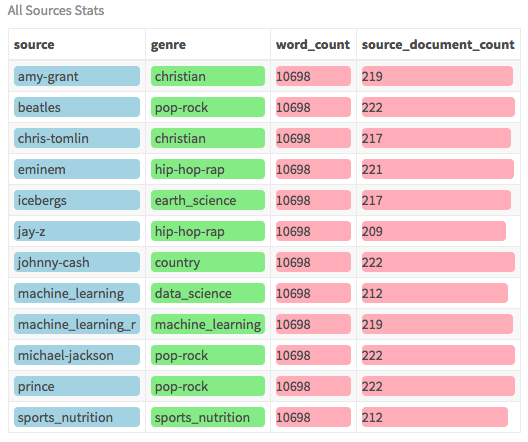
Bộ dữ liệu này chứa nhiều nghệ sĩ đa dạng từ Prince, đến Johnny Cash (country), đến Eminem (rap) cũng như bốn cuốn sách riêng biệt. Các nghệ sĩ được chọn vì họ có mức độ sáng tác dồi dào nhất trong thể loại tương ứng. Nội dung được thu thập từ một trang web ca từ. Dù có hai cuốn sách về machine learning, một tập trung vào khoa học dữ liệu tổng quát và một thiên về machine learning với R. Tất cả sách có thể tải dưới dạng PDF. (Không cần PDF thô cho phân tích này vì đã có phiên bản tidy.)
Một bước dọn dẹp nhanh: một số mô tả thể loại quá dài cho biểu đồ, nên hãy tạo dạng viết tắt để dễ đọc hơn.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedLần này bạn có mười hai tác giả và tám thể loại. Tôi hy vọng các tác giả từ cùng thể loại sẽ được nhóm vào cùng chủ đề. Đó mới là bài kiểm tra thực sự. Vậy, đặt số chủ đề là tám và huấn luyện lại mô hình với bộ dữ liệu lớn này.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)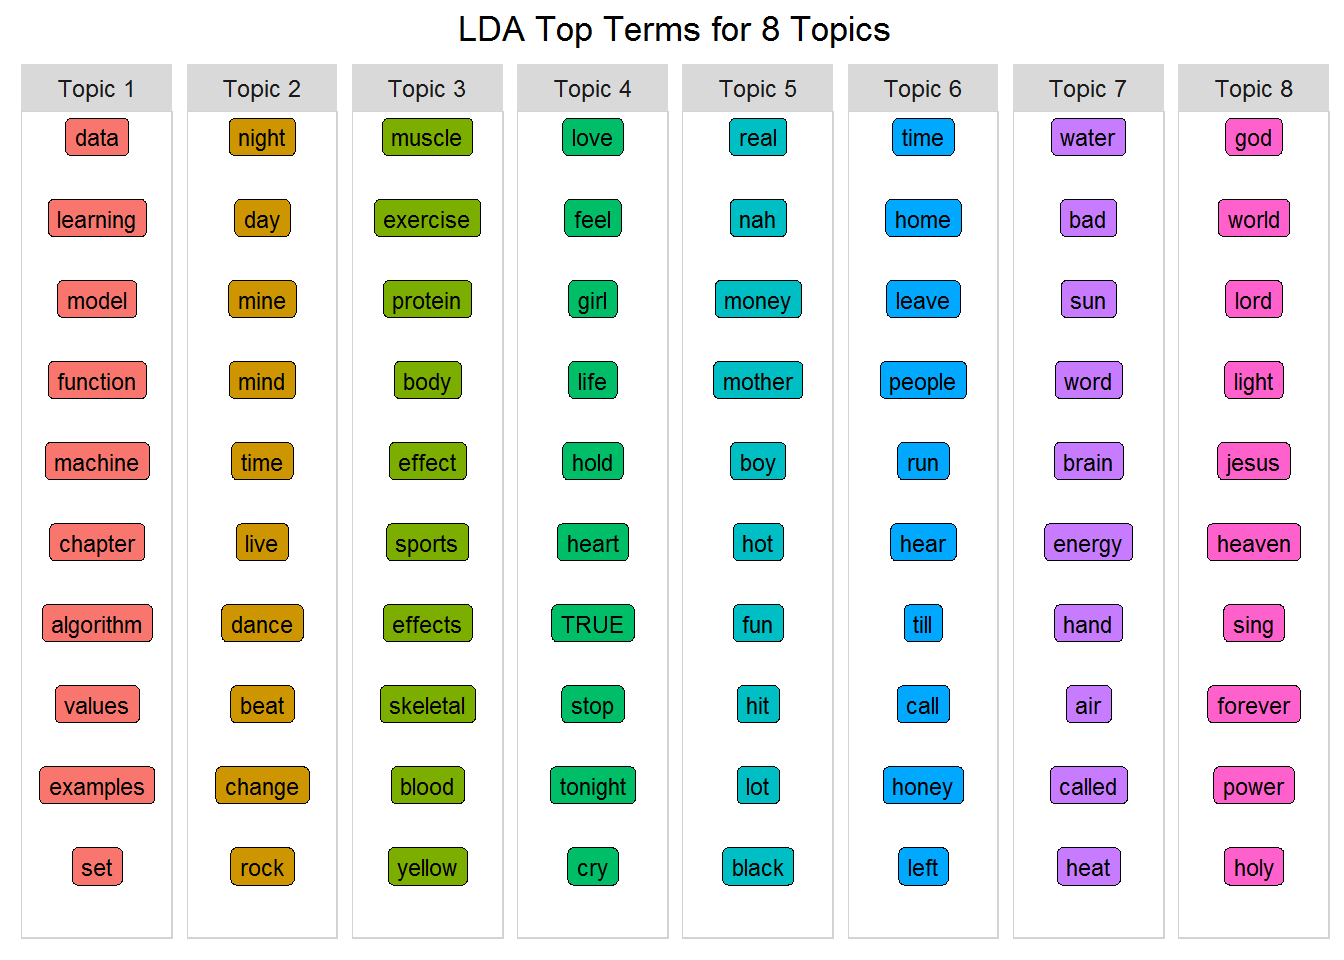
Không muốn ảnh hưởng đến ý kiến của bạn, nhưng phản ứng của tôi là: "Wow"! Với đầu vào cho mô hình này, bạn có nhìn ra chủ đề không? Hãy xem từng chủ đề và thử ghép với tám thể loại đã biết. Một số sẽ khó phân biệt, nhưng số khác khá rõ ràng. Ví dụ, đây là vài khả năng diễn giải:
Đừng quên khái niệm hỗn hợp thành viên và rằng các chủ đề không nhất thiết rời rạc hoàn toàn, nhưng tôi rất ấn tượng khi thấy kết quả tách bạch như thế này. Lưu ý: thuật toán LDA có nhiều tham số hơn bạn đã dùng, vì vậy bạn có thể tinh chỉnh mô hình mạnh hơn.
Phần tiếp theo rất thú vị. Làm thế nào để dễ nhìn hơn nội dung của các chủ đề này? Thông thường, khó để diễn giải, nhưng với bộ dữ liệu phù hợp, mô hình của bạn có thể hoạt động tốt. Nếu mô hình có thể xác định tài liệu có khả năng rơi vào chủ đề nào hơn, bạn có thể bắt đầu nhóm các tác giả lại. Và vì trong trường hợp của bạn biết thể loại của tác giả, bạn có thể kiểm chứng kết quả - ở mức độ nhất định! Bước đầu là phân loại từng tài liệu.
Nhắc lại, mỗi tài liệu chứa nhiều chủ đề nhưng ở các tỷ lệ khác nhau thể hiện bằng giá trị gamma. Một số tài liệu phù hợp với một số chủ đề hơn. Biểu đồ này cho thấy giá trị gamma trung bình của tài liệu từ mỗi nguồn cho mỗi chủ đề. Cách tiếp cận giống như bạn dùng ở trên với ba tác giả, nhưng lần này bạn sẽ nhìn vào trường thể loại. Đây là cách tuyệt vời để thể hiện mối quan hệ giữa thể loại của tác giả và các chủ đề.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")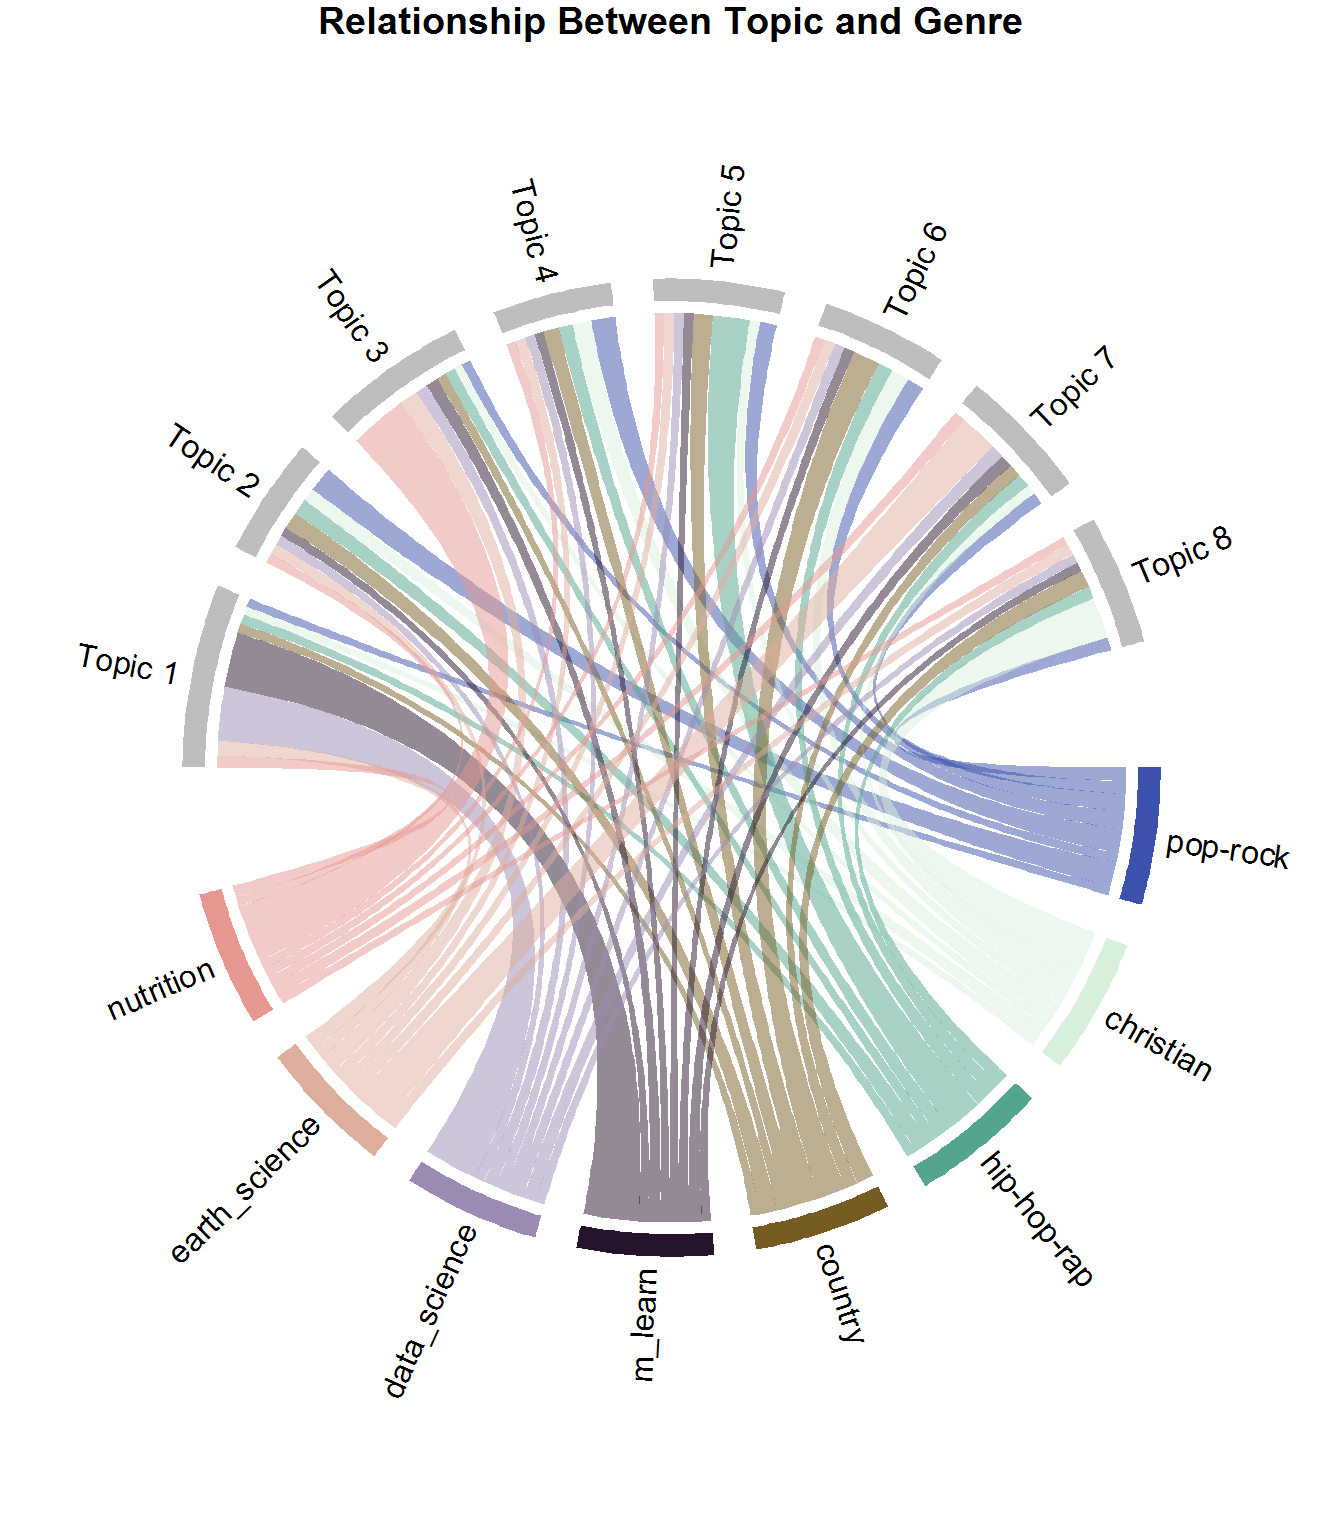
Mỗi chord (tức liên kết) đại diện cho giá trị gamma trung bình của tài liệu theo thể loại thuộc về một chủ đề. Nếu nhìn phần sports_nutrition, bạn sẽ thấy chord tới Chủ đề 3 lớn hơn các chord khác. Điều đó nghĩa là nhiều trang về dinh dưỡng thể thao rơi vào chủ đề đó hơn. Rõ ràng, phần lớn trang Machine Learning và Khoa học Dữ liệu rơi vào Chủ đề 1; phần lớn tài liệu Khoa học Trái đất rơi vào Chủ đề 7, và như mong đợi, Pop-Rock chia khá đều cho nhiều chủ đề. Điều này hợp lý vì Pop là thể loại phổ biến và mang tính tổng quát. Ngược lại, Rap-Hip-Hop phổ biến hơn ở Chủ đề 5. Vậy bạn có thể làm gì với thông tin này? Bạn có thể đưa ra gợi ý cho người nghe dựa trên nội dung chủ đề!
Dĩ nhiên, nội dung ca từ không nhất thiết là đặc trưng duy nhất dùng trong hệ thống gợi ý mà có thể kết hợp với metadata như nhịp điệu, nhạc cụ, tempo, v.v. để có trải nghiệm nghe tốt hơn.
Giờ bạn đã thấy mối quan hệ giữa tài liệu và chủ đề, hãy nhóm theo source (tức tác giả) và chủ đề, rồi lấy tổng các giá trị gamma theo nhóm. Sau đó chọn tác giả có topic_sum cao nhất cho mỗi chủ đề bằng top_n(1). Vì bạn sẽ muốn làm điều tương tự cho genre như đang làm với source, hãy tạo hàm tên top_items_per_topic() và truyền source làm type. Như vậy bạn có thể gọi lại khi phân loại tài liệu theo genre.
Đây là khoảnh khắc then chốt nơi bạn thực sự ánh xạ tác giả tới một chủ đề cụ thể. Bạn kỳ vọng điều gì sẽ xảy ra?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")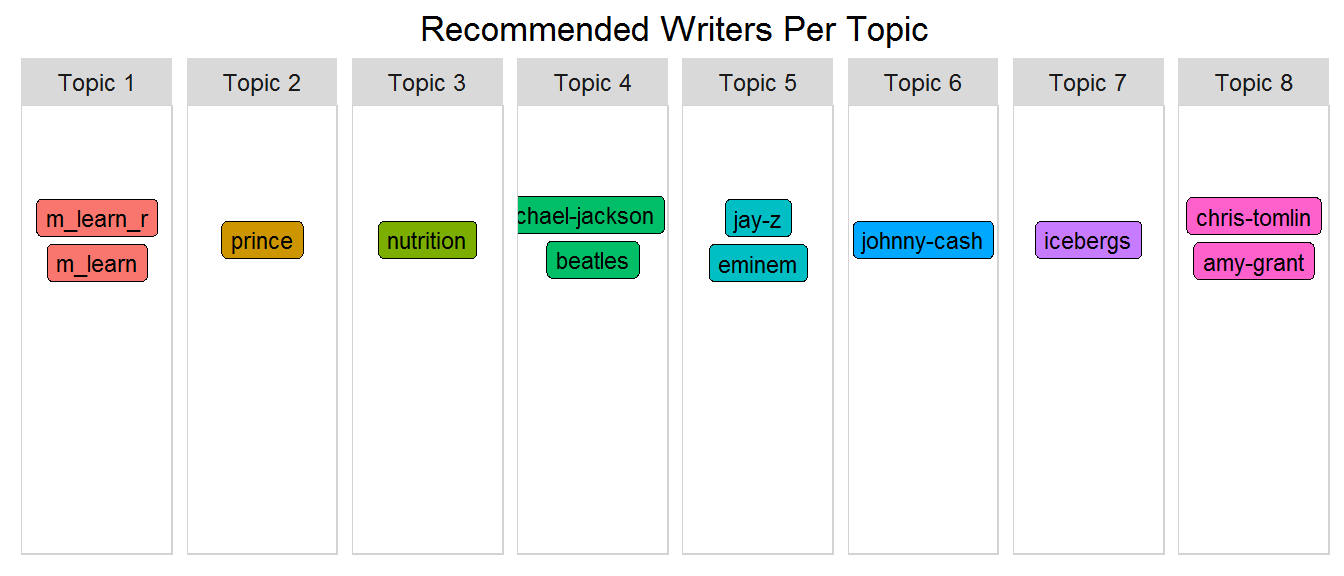
Thật hào hứng! Tuy nhiên, vì bạn có thể không quen các nghệ sĩ này lắm, tôi sẽ làm rõ bằng cách thay tác giả bằng thể loại. Sẵn sàng nhé...
top_items_per_topic(lda, source_tidy, "genre")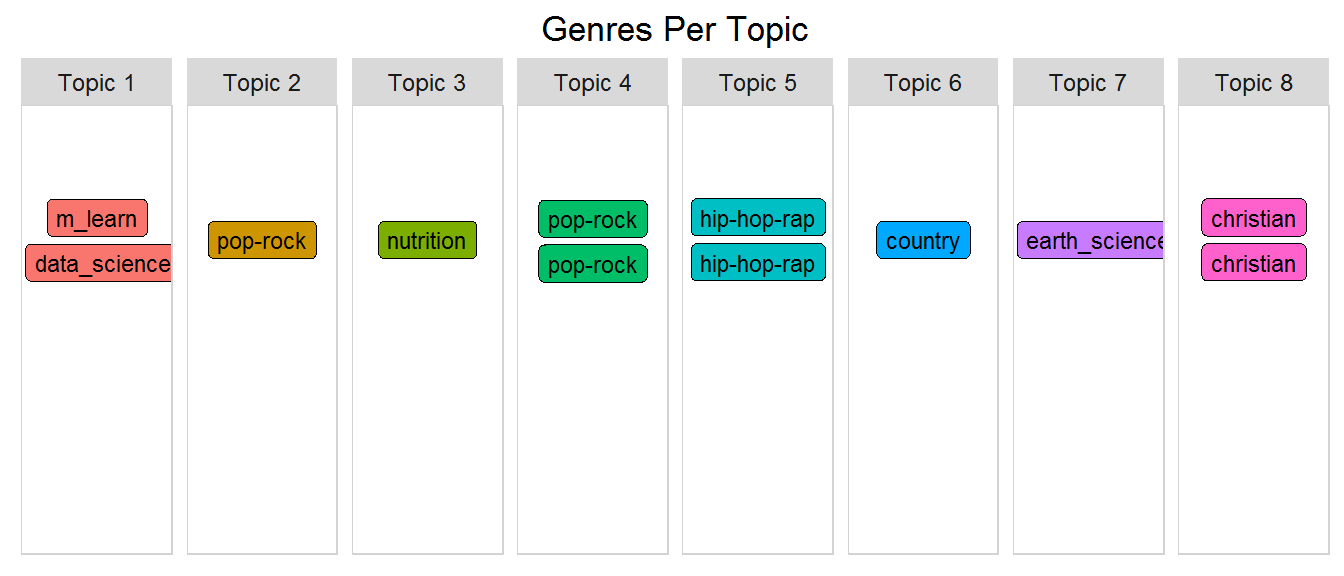
Các nghệ sĩ hip-hop-rap được nhóm lại; các nghệ sĩ Cơ Đốc ở cùng nhau; hai nghệ sĩ pop-rock ở cùng nhau, và mỗi cuốn sách có một chủ đề riêng! Thật ấn tượng khi học không giám sát có thể tạo ra kết quả như thế này (nhận ra các thể loại khác nhau) dựa hoàn toàn trên văn bản. Điều gì sẽ xảy ra nếu bạn chọn số chủ đề khác? Những thể loại nào sẽ được gộp hay tách? Có lẽ bạn có thể tự thử. Còn bây giờ, mô hình tiếp theo sẽ tập trung vào bộ dữ liệu Prince bạn đã dùng trong các hướng dẫn trước.
Với mô hình này, bạn sẽ dùng bộ dữ liệu chỉ gồm các bài hát của Prince. Dù có các chủ đề riêng trong ca từ, thường một bài hát bao trùm hơn một chủ đề. Khi bộ dữ liệu chỉ có một nghệ sĩ, các chủ đề sẽ pha trộn nhiều hơn và ít rời rạc. Điều này khiến việc diễn giải trở nên cực kỳ quan trọng. Thay vì dùng dữ liệu thô từ ca từ của Prince, bạn sẽ dùng phiên bản điều chỉnh nhẹ như mô tả dưới đây.
Trước đây bạn đã dùng các từ theo đúng như trong văn bản. Nhưng giờ bạn sẽ dùng dạng được gán nhãn của dữ liệu tạo ra từ gói NLP mạnh mẽ tên cleanNLP. Gói này là mô hình dữ liệu tidy cho Xử lý ngôn ngữ tự nhiên cung cấp các tác vụ chú giải như tách token, gán nhãn từ loại, nhận diện thực thể, liên kết thực thể, phân tích cảm xúc và nhiều tác vụ khác. Bài tập này thực hiện bên ngoài hướng dẫn, nhưng tôi đã cung cấp mọi thứ bạn cần cho mô hình chủ đề.
Trong bộ dữ liệu chú giải, có một hàng cho mỗi từ trong toàn bộ ca từ của Prince kèm thông tin quan trọng về mỗi từ.
Hãy xem kỹ hơn đối tượng chú giải token bằng cách xem tên trường.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Hiện tại, bạn sẽ chỉ dùng hai thông tin:
Trường word là từ gốc và lemma là dạng đã lemmatize. upos là mã loại từ phổ quát. Nếu gọi table() trên upos bạn sẽ thấy số lượng từ rơi vào mỗi loại từ được gán nhãn. (Lưu ý một số từ có thể được gán nhãn nhiều lần)
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Để bạn hình dung dữ liệu trông thế nào, hãy phóng to một vài bài hát nơi lemma khác từ gốc và loại bỏ stop words.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Điều này cho thấy bạn có thể rất chọn lọc trong việc đưa gì vào mô hình (tức từ gốc, lemma, hay một loại từ nhất định). Đây thực sự là quyết định mang tính phán đoán về việc dùng từ đã lemmatize hay từ gốc. Hoặc bạn thậm chí muốn dùng dạng khác gọi là stem đã được nhắc ở Phần Hai-A. Bạn cũng có thể đặt câu hỏi về kết quả của cleanNLP và việc phân định danh từ với tính từ. Tôi khuyên thử nhiều cấu hình khác nhau cho đến khi bạn tìm được cái phù hợp nhất.
Trong hướng dẫn này, bạn sẽ chỉ mô hình hóa các danh từ. Để lấy metadata liên quan của Prince như thể loại và năm, nối prince_annotated với prince_tidy theo word và document, rồi tạo DTM như thường lệ. Tôi chọn loại bỏ vài từ rất phổ biến xuất hiện trong mọi chủ đề để nội dung thú vị hơn. (Lưu ý dùng khái niệm tf-idf đã đề cập ở Phần Một là một phương pháp khác bạn có thể cân nhắc để loại từ phổ biến.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)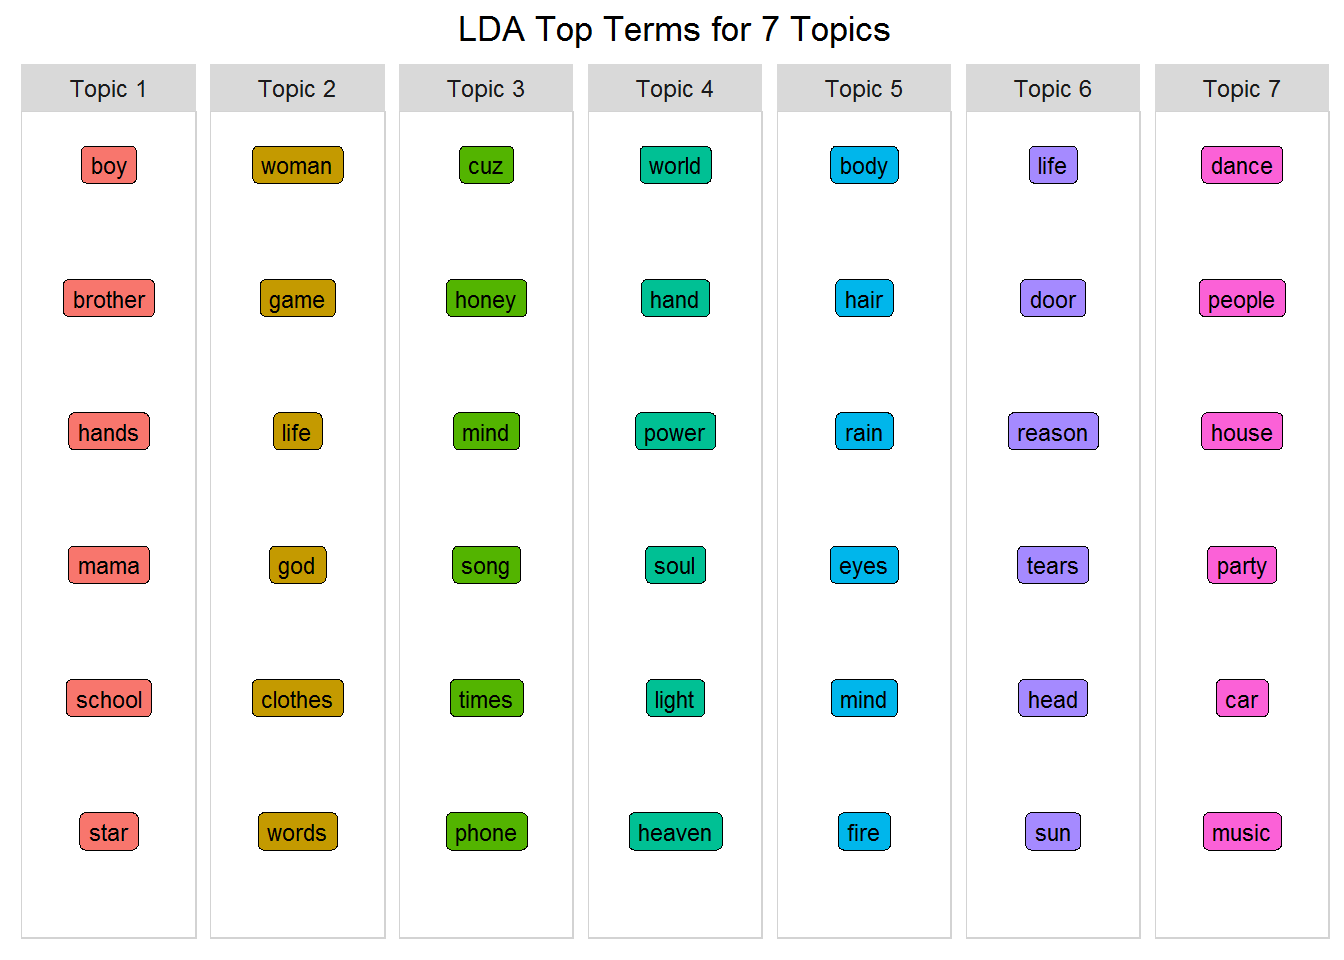
Dưới đây là danh sách các chủ đề mà mọi người đã gán làm chủ đề tiềm năng trong âm nhạc của Prince qua nhiều năm. Chúng được gắn với các từ nhất định, và như mọi mô hình chủ đề, có sự chồng lặp. Nhưng hãy nhìn các chủ đề gán tay này (sắp xếp ngẫu nhiên!) và xem bạn có tìm thấy chúng trong mô hình bạn xây dựng không.
Có vẻ Chủ đề 1 của bạn là về con người và gia đình; Chủ đề 7 là về âm nhạc, khiêu vũ và tiệc tùng; và Chủ đề 4 là về bản thân, xã hội và tôn giáo. Điều này đòi hỏi diễn giải rất chủ quan. Trong bối cảnh kinh doanh, bước này tốt nhất do chuyên gia lĩnh vực thực hiện, người có thể có kỳ vọng trước. Giờ bạn thấy vì sao NLP thực sự là giao điểm của trí tuệ nhân tạo và ngôn ngữ học tính toán!
Hãy thử chạy với số chủ đề khác, hoặc chỉ với động từ, hoặc dùng từ gốc thay vì dạng lemmatize, hoặc số từ hàng đầu khác và xem bạn rút ra insight gì. Có phương pháp mới giúp xác định số chủ đề: xem khái niệm perplexity tại đây, hoặc gói
ldatuningtại đây.
Vì bộ dữ liệu Prince có năm, bạn có thể theo dõi chủ đề theo thời gian. Bạn có thể sáng tạo ở đây, nhưng tạm thời hãy xem một vài từ từ hai chủ đề và quan sát tần suất theo thời gian. Phân tích xu hướng có thể là cả một hướng dẫn riêng, nên nếu bạn quan tâm, hãy xem nguồn này.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)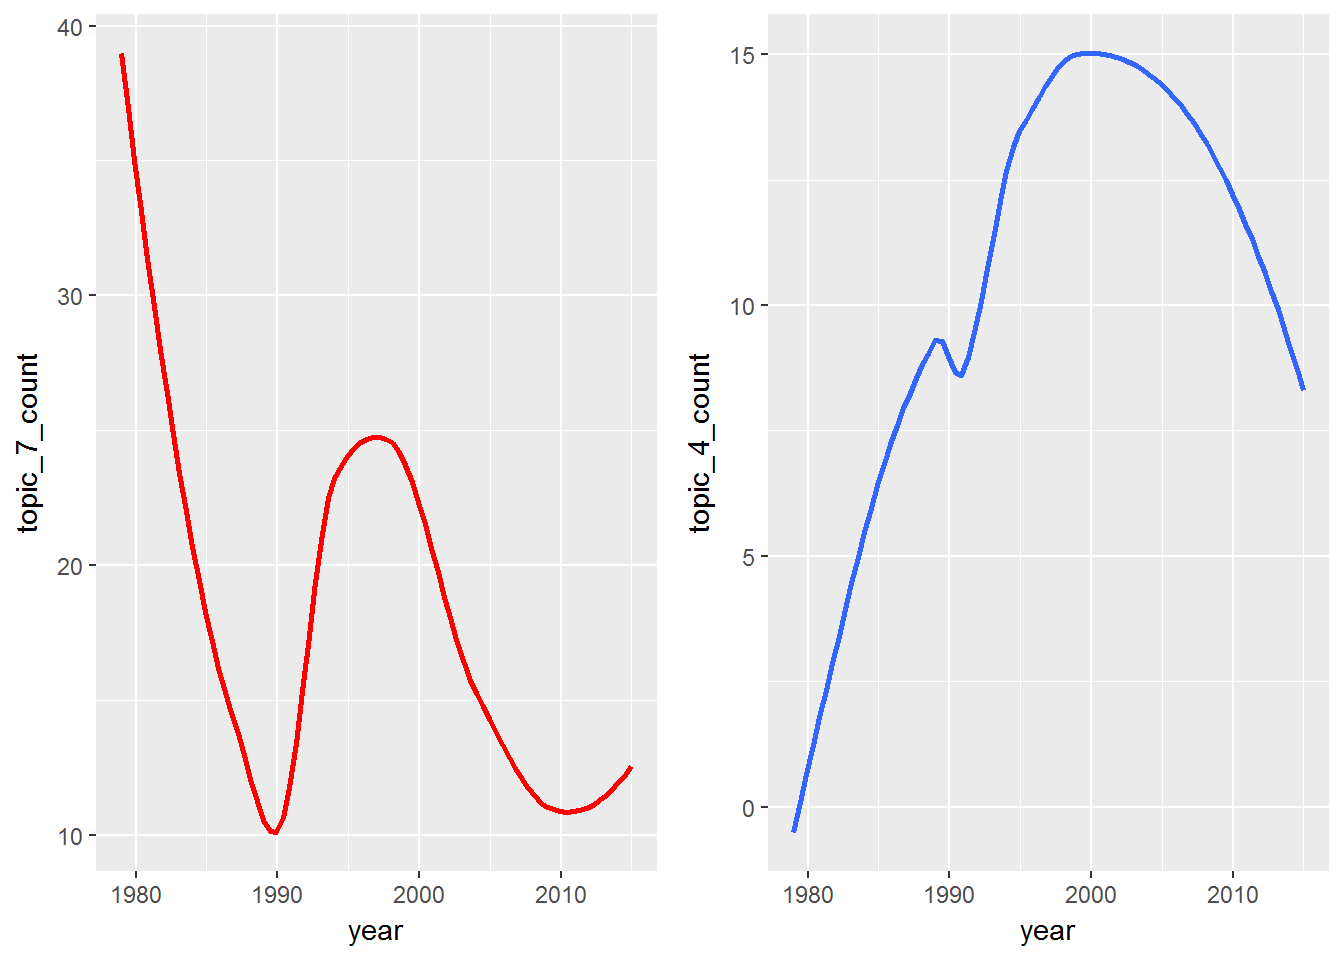
Đây là ví dụ cực kỳ sơ bộ về cách chủ đề thay đổi theo thời gian, nhưng nếu bạn mở rộng loại phân tích này ra ngoài âm nhạc thì sao? Có thể công ty bạn quan tâm đến tương quan giữa doanh số sản phẩm và xu hướng chủ đề trong các tweet của khách hàng về sản phẩm. Có rất nhiều ứng dụng cho việc hiểu chủ đề thay đổi theo thời gian.
Hướng dẫn này chỉ lướt qua bề mặt những gì có thể với mô hình chủ đề, NLP và machine learning. Đây là một lĩnh vực đang nở rộ của khoa học dữ liệu và sẽ tiếp tục phát triển khi nhiều nhà khoa học chinh phục đại dương dữ liệu phi cấu trúc chưa được khai phá. Trong âm nhạc, khái niệm phân loại bài hát dựa trên ca từ chủ yếu xuất hiện trong các bài nghiên cứu, vì vậy có lẽ bạn có thể dùng công việc này làm bàn đạp để đóng góp của riêng mình cho thế giới AI.
Bạn đã dùng dữ liệu từ ca từ và sách phi hư cấu để xác định chủ đề, phân loại từng tài liệu vào các chủ đề có khả năng nhất, và nhận diện tác giả tương tự dựa trên nội dung chủ đề. Nhờ đó bạn xây dựng được hệ thống gợi ý đơn giản dựa trên văn bản và tác giả có nhãn.
Hãy nhớ rằng; bạn đang cố gắng mô hình hóa nghệ thuật bằng máy móc. Một nghệ sĩ có thể nói "You are the apple of my eye", nhưng họ không nói về trái cây hay bộ phận cơ thể. Bạn phải tìm điều ẩn giấu. Khi nghe nhạc, bạn không phải lúc nào cũng nghe bè nền, nhưng chúng ở đó. Hãy mở thật to bài hát yêu thích và lắng nghe vượt qua giọng hát chính, bạn có thể ngạc nhiên khi phát hiện cả một thế giới thông tin ẩn. Vậy nên hãy đẩy logic về hậu cảnh và đưa sự sáng tạo lên phía trước trong quá trình khám phá!
Như trong tất cả các hướng dẫn trong loạt này, tôi khuyến khích bạn dùng dữ liệu được trình bày ở đây như một nghiên cứu tình huống thú vị, đồng thời như nguồn ý tưởng cho việc phân tích văn bản mà bạn quan tâm. Có thể là nghệ sĩ bạn yêu thích, mạng xã hội, văn bản doanh nghiệp, khoa học, hay kinh tế - xã hội. Bạn nghĩ gì về các ứng dụng tiềm năng của mô hình chủ đề? Hãy để lại bình luận bên dưới với ý tưởng của bạn!
Hãy đón xem Phần Ba (bài viết thứ tư) của loạt này: Phân tích ca từ: Phân tích dự đoán bằng Machine Learning với R. Ở đó bạn sẽ dùng ca từ và metadata có nhãn để dự đoán tương lai của một bài hát. Bạn sẽ làm việc với một số thuật toán như Cây quyết định, Naive Bayes và hơn thế nữa để dự đoán thể loại, thập niên, và thậm chí khả năng một bài hát sẽ vào bảng xếp hạng! Hẹn sớm gặp lại!
Lưu ý:
Lưu ý một: Cách duy nhất để bạn có cùng kết quả với tôi là chạy mã theo đúng thứ tự với cùng các tệp dữ liệu không chỉnh sửa. Nếu không, tham chiếu đến các chủ đề cụ thể sẽ không còn ý nghĩa.
Lưu ý hai: Không có quy tắc cứng nhắc cho công việc này, và nó dựa trên nghiên cứu của riêng tôi. Dù mô hình chủ đề có tồn tại trong ứng dụng thực tế, không có nhiều hoạt động phát triển bộ gợi ý âm nhạc dựa hoàn toàn vào ca từ.
Lưu ý ba: Mô hình chủ đề rất “khoai”. Xây mô hình là một chuyện, diễn giải kết quả là thách thức, mang tính chủ quan và khó xác thực đầy đủ (dù hiện đang có nghiên cứu: xem bài viết này của Thomas W. Jones). Quá trình là không giám sát, sinh, lặp và dựa trên xác suất. Chủ đề tinh tế, ẩn và ngụ ý, không tường minh.
Nếu bạn muốn tìm hiểu thêm về machine learning bằng R, hãy xem hướng dẫn cho người mới bắt đầu. Ngoài ra, hãy tham gia khóa học Nhập môn Machine Learning với R.
Tìm hiểu thêm về Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
