Cours
Comprendre le Machine Learning
2 h
308.2K
Exploitez des techniques de pointe avec R, le TAL (traitement automatique du langage) et l’apprentissage automatique pour modéliser des thématiques dans les textes et créer votre propre système de recommandation musicale !
Voici la partie Deux-B d’une série de trois tutoriels dans laquelle vous continuez à utiliser R pour mener différentes analyses sur une étude de cas portant sur des paroles de chansons de l’artiste légendaire Prince, ainsi que d’autres artistes et auteurs. Les trois tutoriels couvrent :
Imaginez que vous êtes Data Scientist à la NASA. On vous demande de surveiller deux sondes destinées à l’orbite lunaire, chargées d’étudier les interactions de la Lune avec le Soleil. Comme pour tout engin spatial, des problèmes peuvent survenir et être détectés lors des tests ou après le lancement. Ces anomalies sont rédigées en langage naturel dans près de 20 000 rapports d’incident. Votre mission : identifier les sujets les plus fréquents et les thèmes émergents dans ce corpus, puis fournir une analyse prescriptive aux ingénieurs et aux directeurs de programme, avec un impact direct sur l’exploration spatiale de demain.
Il s’agit d’un cas réel qui illustre la puissance que vous aurez entre les mains après avoir appris des techniques avancées telles que la modélisation de sujets avec l’apprentissage automatique, le traitement automatique du langage (TAL) et la programmation R. Bonne nouvelle : pas besoin de travailler à la NASA pour innover autant. Dans ce tutoriel, votre mission, si vous l’acceptez, est de découvrir la modélisation de sujets et de construire un système de recommandation simple (recommender) à partir de paroles de chansons et de livres de non-fiction.
Juste pour le plaisir !
Rien à voir avec la modélisation de sujets, mais pour le fun, servez-vous d’un excellent package nommé circlize, présenté dans un tutoriel précédent, pour stimuler vos photorécepteurs et apprécier ce diagramme circulaire de toutes les sources utilisées ici.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)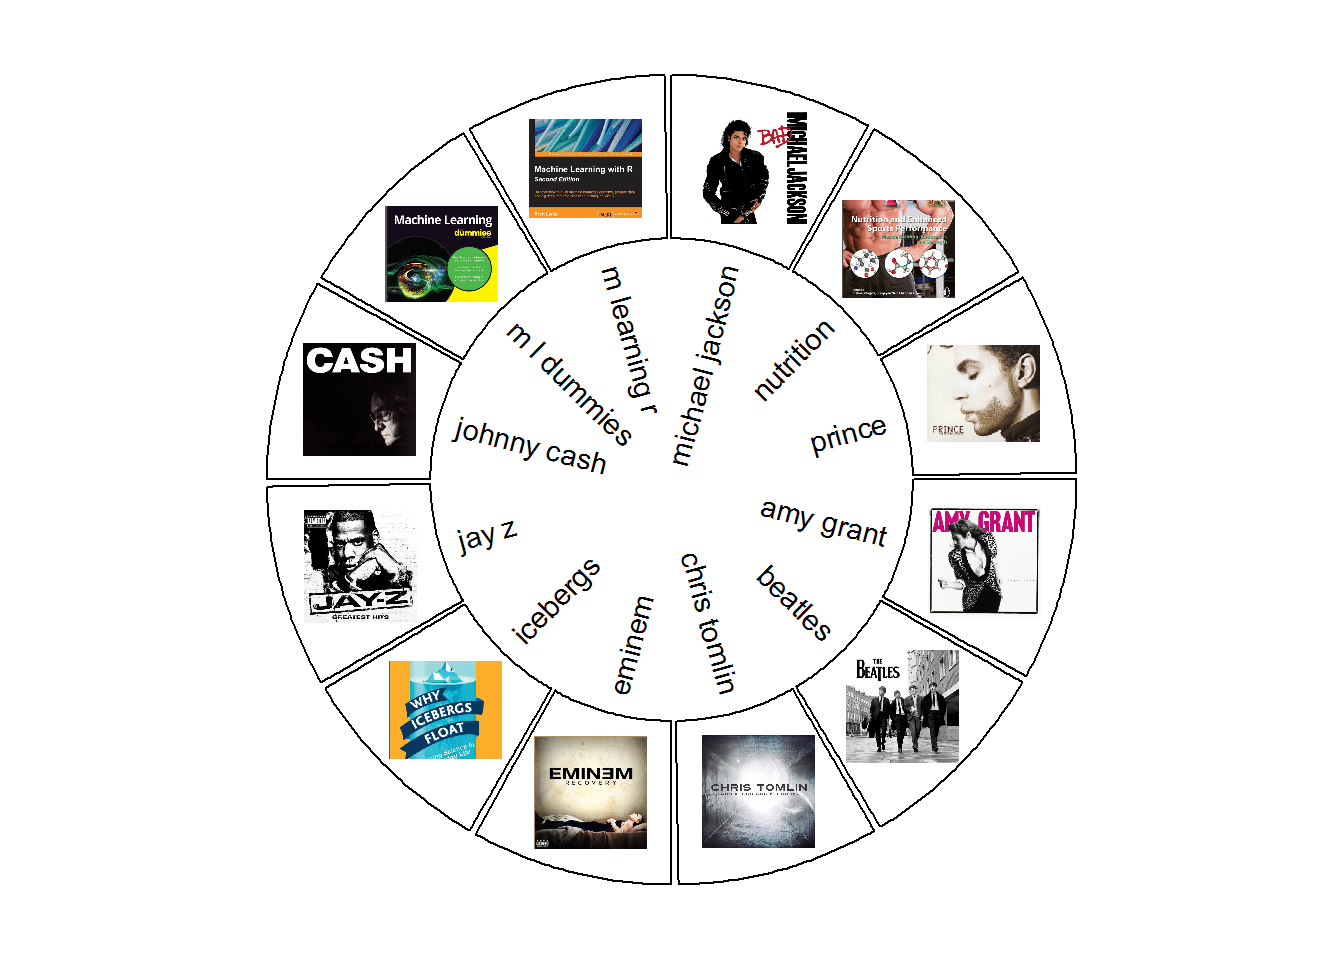
Dans les tutoriels précédents, vous avez étudié le contenu des paroles de Prince via la fréquence des mots, la statistique tf-idf et l’analyse de sentiment. Vous pouvez approfondir l’analyse de paroles et d’autres textes grâce à la modélisation de sujets.
Dans ce tutoriel, vous allez construire quatre modèles avec LDA (Latent Dirichlet Allocation) et l’algorithme de clustering k-means. Les algorithmes seront expliqués plus loin.
Le Modèle Un utilise les paroles de Prince combinées à deux livres de non-fiction. L’objectif est de vous donner un exemple simple d’utilisation de LDA, un algorithme non supervisé, pour générer des ensembles de mots suggérant des thèmes. Ces thèmes ne sont pas étiquetés et nécessitent une interprétation humaine. Une fois un nombre prédéfini de thèmes identifié, vous utiliserez les résultats pour classer chaque chanson ou page de livre dans une catégorie. Une chanson peut contenir tous les sujets détectés, mais s’inscrire plus nettement dans l’un d’eux. C’est ce qu’on appelle la classification de documents ; et comme vous connaissez l’auteur du document, vous classez en pratique des auteurs dans des regroupements thématiques.
Le Modèle Deux reprend le jeu de données du Modèle Un et illustre rapidement la génération de thèmes avec un autre algorithme, k-means, en montrant pourquoi ce n’est pas forcément le meilleur choix pour la modélisation de sujets.
À nouveau avec LDA, le Modèle Trois s’appuie sur un jeu de données plus large, contenant plusieurs artistes de genres différents et davantage d’auteurs. En classant la majorité des documents d’un auteur/artiste dans leur sujet le plus probable, vous pouvez regrouper des écrivains aux compositions thématiques similaires. Avec un bon modèle, des genres proches devraient apparaître dans le même groupe thématique : par exemple, les rappeurs dans un sujet, et deux livres sur des thèmes proches dans un autre. Vous pourriez ainsi recommander des auteurs similaires ! Bien sûr, les auteurs et leurs genres sont étiquetés, mais les sujets ne le sont pas : l’apprentissage reste non supervisé.
Le Modèle Quatre utilise LDA uniquement sur les paroles de Prince. Cette fois, vous utilisez un jeu de données annoté (généré en dehors de ce tutoriel) où chaque mot est étiqueté par sa classe grammaticale (nom, verbe, etc.) et sa forme de base (lemmatisée). Vous étudierez aussi l’évolution d’un sujet dans le temps.
Le TAL et l’apprentissage automatique sont des sous-domaines de l’intelligence artificielle. Des tentatives récentes utilisent l’IA pour écrire des chansons. Ce n’est pas le but ici, mais cela montre comment l’IA peut servir l’art. Après tout, les trois premières lettres sont A-R-T ! Un instant, comparez l’IA à l’écriture d’une chanson : on peut suivre un schéma (couplet, refrain, couplet…), mais ce qui rend un morceau grand, c’est la créativité de l’auteur. Dans ce tutoriel, vous devrez mobiliser vos compétences techniques pour construire des modèles, mais aussi votre créativité pour interpréter et expliquer les résultats.
Pensez-y : si la modélisation de sujets est un art, alors les paroles sont le code, l’écriture est l’algo-rythme, et la chanson est le modèle ! Quelle serait votre analogie ?
Les systèmes de recommandation classiques ne reposent pas uniquement sur le texte. Netflix recommande des films selon vos choix passés et des métadonnées associées. Pandora adopte une autre approche avec son Music Genome composé de 400 attributs musicaux (mélodie, rythme, composition, résumés de paroles…), mais ce génome a nécessité cinq ans et 30 experts en théorie musicale depuis l’an 2000. De nombreux travaux de recherche traitent de recommandations de films à partir de résumés. En revanche, les systèmes de recommandation musicale basés uniquement sur le contenu lyrique sont plus rares. Envie d’essayer ?
La partie Deux-B suppose une compréhension de base des données "tidy" – en particulier des packages comme dplyr et ggplot2. De la pratique en text mining avec tidytext est recommandée (voir les tutoriels précédents). Vous devrez aussi être à l’aise avec les fonctions R, car vous en utiliserez pour réemployer du code entre modèles. Pour se concentrer sur l’insight, j’ai inclus du code prêt à l’emploi sur vos propres données ; des explications détaillées peuvent nécessiter vos recherches complémentaires.
Que pouvez-vous faire avec la modélisation de sujets ? Peut-être extraire des informations critiques pour votre activité à partir de documents internes. Ou analyser des tweets pour savoir ce qui se dit sur vos produits. Ou encore bâtir votre propre système de routage documentaire vers les bons services. Les possibilités sont immenses. Lancez-vous !
Quelques applications :
Les seuls nouveaux packages par rapport à la Partie Une et à la Partie Deux-A sont topicmodels, tm et plotly. Vous utiliserez LDA() de topicmodels qui permet aux modèles d’apprendre à distinguer des documents. tm sert au text mining, et vous n’emploirez inspect() qu’une fois pour voir l’intérieur d’une matrice document-terme, expliquée plus loin. plotly vous servira une fois pour rendre interactif un graphique ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Les fonctions ci-dessous ont été définies dans les tutoriels précédents, sauf word_chart() ; toutefois son contenu et sa description figurent aussi en partie Deux-B. L’essentiel à savoir : elle utilise ggplot() de façon originale pour produire un visuel fondé sur des mots et non des points.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Pour démontrer pleinement la puissance de la modélisation de sujets et de la classification, vous n’utiliserez pas seulement les paroles de Prince comme précédemment, mais aussi celles d’autres artistes de genres variés reconnus dans les classements Billboard. J’ai ajouté quelques livres sur des thèmes différents (nutrition sportive, icebergs, et même l’apprentissage automatique !). Avec un jeu de données varié, vous pourrez classer des documents par sujets associés et distinguer des artistes/auteurs proches.
Astuce : j’appellerai documents les chansons et les pages de livres, et auteurs les musiciens/écrivains. Dans le code, source désigne simplement l’auteur associé. J’utiliserai genre pour parler à la fois du genre musical et de la catégorie d’un livre. Pour plus de clarté, j’ai remplacé certains noms d’auteurs par leurs titres de livres. Ces repères deviendront naturels au fil du tutoriel.
Pour vous concentrer sur le modeling, j’ai préparé les données en amont et fourni tout ce qu’il vous faut dans les trois fichiers ci-dessous, avec les traitements suivants déjà appliqués :
pdf_text() du package pdftools pour récupérer le contenu de quatre livres (chaque page constituant un document distinct)tidytext comme en Partie UneVous disposerez de trois jeux de données distincts :
three_sources_tidy_balanced : paroles de Prince et deux livresall_sources_tidy_balanced : paroles de huit artistes et quatre livresprince_tidy : uniquement des paroles de PrinceJ’ai également inclus un jeu de données annoté des paroles de Prince. Je préciserai ce que signifie « annoté » dans le Modèle Quatre.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)La modélisation de sujets vise à trouver des termes fortement liés thématiquement (sujets) dans des données textuelles non structurées, en analysant des motifs de cooccurrences. Les composants de base sont les documents, les termes et les sujets. LDA (Latent Dirichlet Allocation) est une méthode non supervisée qui découvre différents sujets sous-jacents à une collection de documents, où chaque document est un ensemble de mots. LDA repose sur deux hypothèses :
LDA cherche des groupes de mots apparentés. C’est un algorithme itératif et génératif. Deux étapes clés :
L’idée est que des mots d’un même sujet apparaissent ensemble dans les documents. On modélise chaque document comme un mélange de sujets et chaque sujet comme un mélange de mots (on parle de mixed-membership). Vous pouvez ensuite utiliser la probabilité d’appartenance d’un document à un sujet pour le classer. Dans notre cas, comme l’auteur est connu, vous pouvez recommander un artiste/auteur sur la base de structures thématiques similaires. Passons à l’exemple.
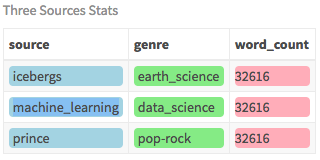
Pour ce modèle, vous utilisez le jeu de données combinant trois auteurs (sources) distincts et recherchez des sujets latents. Pour mettre en évidence la puissance de la modélisation de sujets, ces sources sont très différentes et couvrent intuitivement trois thèmes distincts. Vous demanderez donc au modèle de créer trois sujets et vérifierez sa pertinence. Commencez par examiner le jeu de données avec votre fonction my_kable_styling() et les fonctions color_bar() et color_tile() du package formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
Ici, vous utiliserez des paroles de Prince, un livre intitulé "Machine Learning For Dummies", et un autre intitulé "Why Icebergs Float", chacun comptant plus de 30 000 mots (non distincts).
Avec un jeu de données tidy et équilibré (paroles de Prince et deux livres), créez d’abord une matrice document-terme (DTM) où chaque ligne est un document et chaque colonne un terme. Ce format est requis pour LDA. Un document correspond à une chanson (paroles) ou à un numéro de page (livres). Comptez d’abord les mots par document, puis passez-les à cast_dtm() de tidytext, où document est le champ du nom de document et word celui du terme. D’autres paramètres existent, mais ces deux-là sont indispensables.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Cela vous indique le nombre de documents et de termes, ainsi que la forte parcimonie de la matrice (beaucoup de zéros), logique vu l’ampleur du vocabulaire global.
Si vous examinez quelques lignes et colonnes avec inspect() du package tm, vous verrez chaque ligne comme un document et chaque colonne comme un terme. (Utilisez aussi str() si besoin.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Maintenant que vous savez quels inputs sont nécessaires, définissez deux variables, source_dtm et source_tidy, que vous réassignerez à chaque modèle.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedPassons au plus intéressant : l’ajustement. Le code est simple, mais pour bien faire, comprenez ce qui se passe en coulisses. Vous devez connaître quatre paramètres : l’entrée, le nombre de sujets, la méthode d’échantillonnage et la graine aléatoire.
Puisque votre jeu comporte trois auteurs distincts, définissez k à 3 et fixez seed pour rendre les résultats reproductibles. D’autres paramètres de control existent (d’où le list), mais nous n’utiliserons ici que seed. Le paramètre method définit l’algorithme d’échantillonnage ; nous utiliserons GIBBS. Le défaut est VEM, mais d’expérience GIBBS donne souvent de meilleurs résultats.
En bref, l’échantillonnage GIBBS réalise une marche aléatoire à partir d’un point initial (par défaut 0) et se déplace à chaque pas de plus ou moins un avec probabilité égale. Pour les détails, lisez cette présentation.
Remarque : j’ai volontairement simplifié la description de LDA. Même si la théorie n’est pas indispensable pour l’utiliser, je vous recommande ce document d’Ethen Liu, très clair.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Vous obtenez un objet LDA_Gibbs avec trois sujets. Libre à vous d’exécuter str(lda) pour l’explorer.
Étape suivante : ouvrir l’objet et consulter les résultats. Utilisez tidy() pour un format lisible. Passez l’objet LDA et beta à l’argument matrix. Avec beta, vous obtenez les probabilités mot-par-sujet. L’exemple suivant, avec le terme iceberg, montre sa probabilité dans chaque sujet. Il a une probabilité plus élevée d’être généré dans le Sujet 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Pour bien comprendre, regardez quels termes composent chaque sujet. Créez une fonction qui tidy-fie le modèle LDA et extrait les principaux termes de chaque sujet (ceux avec les plus grands beta). Cette fonction appelle word_chart() pour afficher proprement les trois sujets et leurs mots clés. Fixez num_words à 10 pour commencer.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)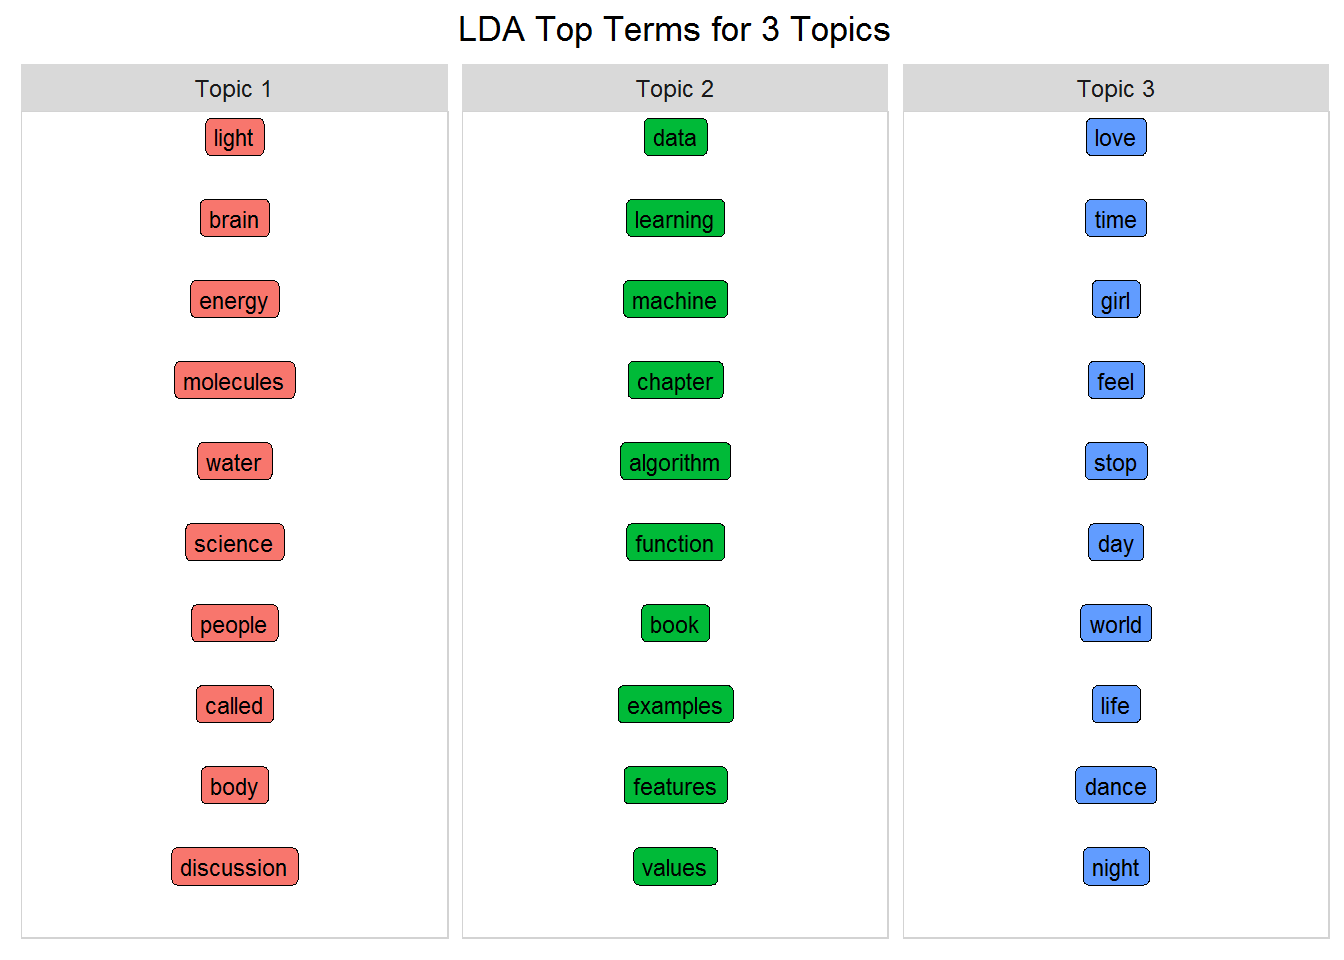
L’apprentissage non supervisé exige toujours une interprétation humaine… mais ces sujets reflètent clairement nos trois sources : Icebergs, Machine Learning et Prince ! Simple, mais bluffant quant aux possibilités.
Outre l’estimation de chaque sujet comme mélange de mots, LDA décrit chaque document comme mélange de sujets. Cette fois, avec matrix = "gamma" dans tidy(), vous obtenez les probabilités document-par-sujet. Par exemple, pour la chanson 1999 de Prince, on observe qu’un document, comme un mot, est associé à plusieurs sujets (le concept de mixed-membership). Ci-dessous, 1999 est le plus probable dans le Sujet 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661La chanson appartient à chaque sujet, mais avec des pourcentages différents (gamma). Certaines s’intègrent mieux dans certains sujets que d’autres. Ici, 1999 a un gamma plus élevé pour le Sujet 3.
Pour clarifier LDA, observez ce graphe circulaire. Il indique le pourcentage de documents de chaque source appartenant à chaque sujet. Pour le produire, joignez le modèle LDA tidy à source_tidy (qui contient la source, c.-à-d. l’auteur), via document. Avec les bons groupements, calculez la moyenne de gamma par source et par sujet. Vous voyez alors le sujet majoritaire pour chaque source.
Prenez le temps d’examiner le diagramme si vous n’êtes pas familier avec ce type de visualisation. (Consultez la Partie Deux-A pour pratiquer chordDiagram() et le package circlize. Tout y est détaillé dans cet ouvrage de Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")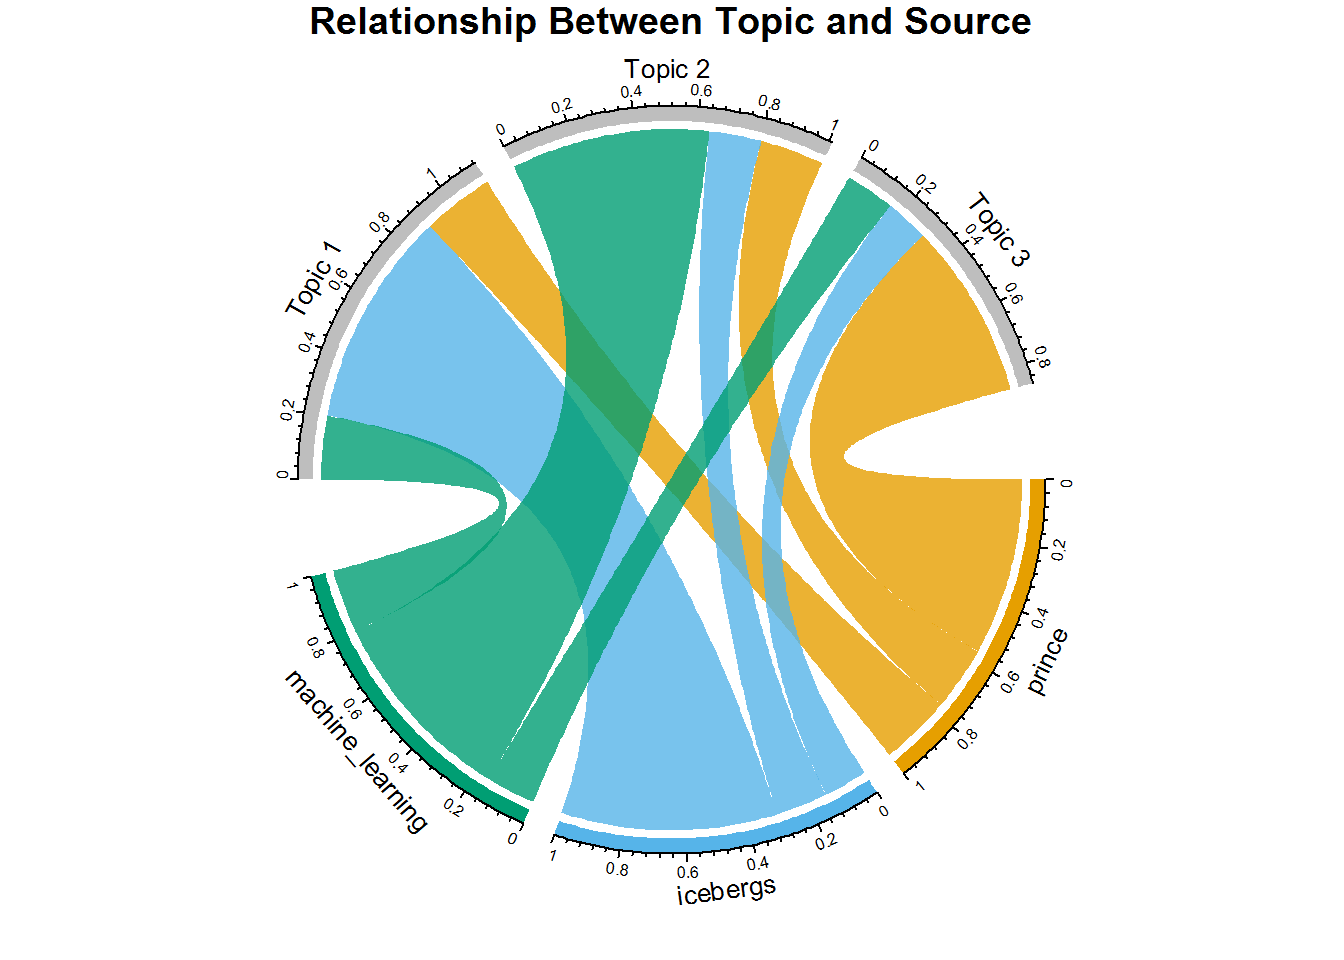
Visualisation parlante : même si chaque source apparaît dans chaque sujet, chacune a une majorité nette dans un sujet spécifique. Par exemple, les chansons de Prince sont surtout associées au Sujet 3 (ruban plus large que vers les sujets 1 et 2). Même logique pour Icebergs et le Sujet 1, et Machine Learning et le Sujet 2.
En somme, vous avez classé des documents dans des sujets selon la moyenne de gamma par sujet/source. Si vous connaissez l’auteur d’un document et son sujet dominant, vous pouvez supposer que des artistes de genres proches tomberont dans les mêmes sujets et donc recommander des auteurs similaires… Vous mettrez cela en pratique avec le jeu de données plus large.
Regardons maintenant les documents individuels : les meilleurs par sujet.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)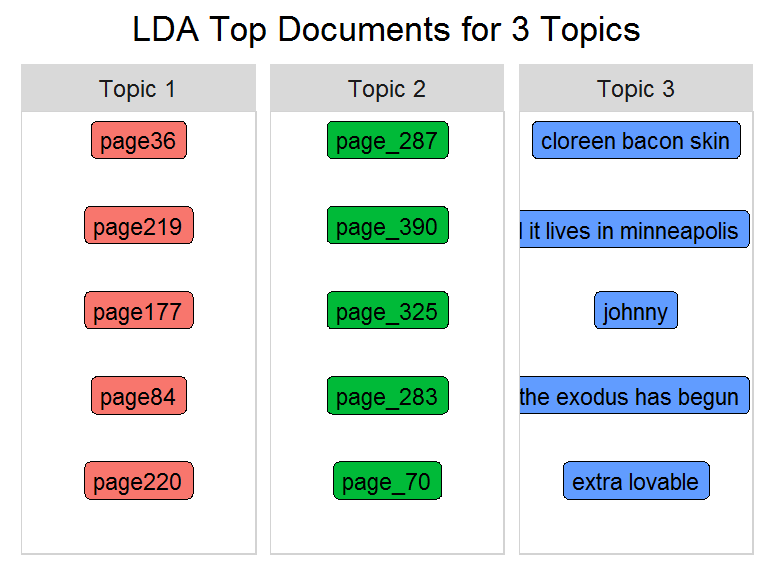
Comme les noms de documents/chansons ne vous parlent pas forcément (p. ex. les pages avec underscore proviennent du livre de machine learning), remplaçons le nom du document par la source.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)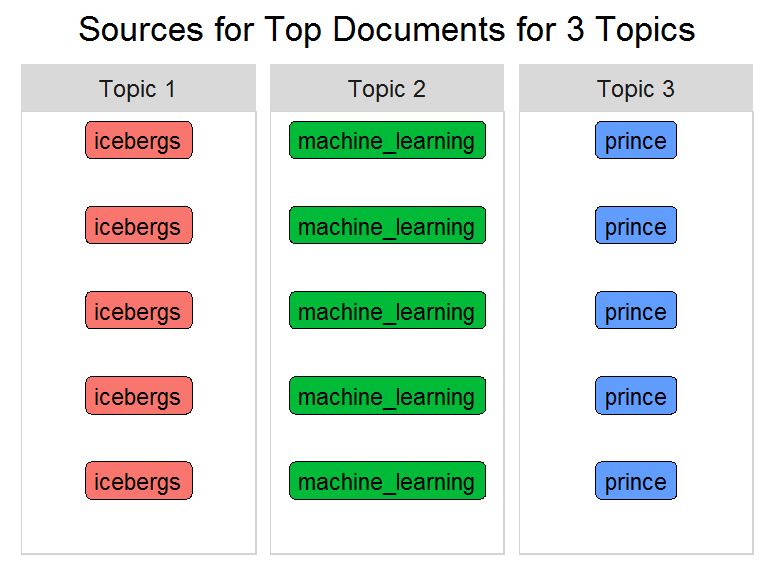
Les top documents par sujet (graphe précédent) sont ici remplacés par leur source. Votre code a bien classé ces documents : ils tombent dans la même catégorie (au moins pour ces 5 premiers) ! Reste à vérifier si cela tient au-delà de trois sources. Si les résultats sont probants, vous pouvez recommander des auteurs proches thématiquement.
Créez un deuxième modèle avec un autre algorithme d’apprentissage non supervisé : k-means. Comme LDA, k-means nécessite de fixer le nombre de sujets à l’avance. Contrairement au modèle à appartenance multiple (LDA), k-means partitionne les documents en clusters disjoints (sujets). Il transforme chaque document en vecteur numérique pondéré par mot (proche de tf-idf). Chaque document appartient à un unique cluster : c’est le clustering dur. La sortie est un ensemble de clusters et leurs documents. À l’inverse, LDA réalise un clustering flou (soft), où un point de données peut appartenir à plusieurs clusters.
Appliqué au langage, LDA devrait donc refléter plus fidèlement la réalité que k-means pour l’attribution de sujets, puisqu’un texte aborde souvent plusieurs thèmes. Construisez maintenant le modèle, examinez l’objet k-means, et validez cette hypothèse.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"La structure de l’objet k-means révèle deux éléments clés : clusters et centers. Vous pouvez en inspecter le contenu pour la chanson 1999 et le mot party qui y apparaît.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Ces champs indiquent que 1999 est placé dans un seul cluster (le 2), et que party apparaît dans les trois clusters mais surtout dans le 1. Affichons maintenant les mots clés selon les valeurs de centers pour identifier les thèmes.
Souvenez-vous : notre jeu contient trois sources : Prince, Icebergs, Machine Learning. Imprimez les top mots de chaque cluster et comparez au résultat LDA. Il faut réagencer un peu les données pour réutiliser word_chart() ; suivez le code, l’essentiel étant l’analyse.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)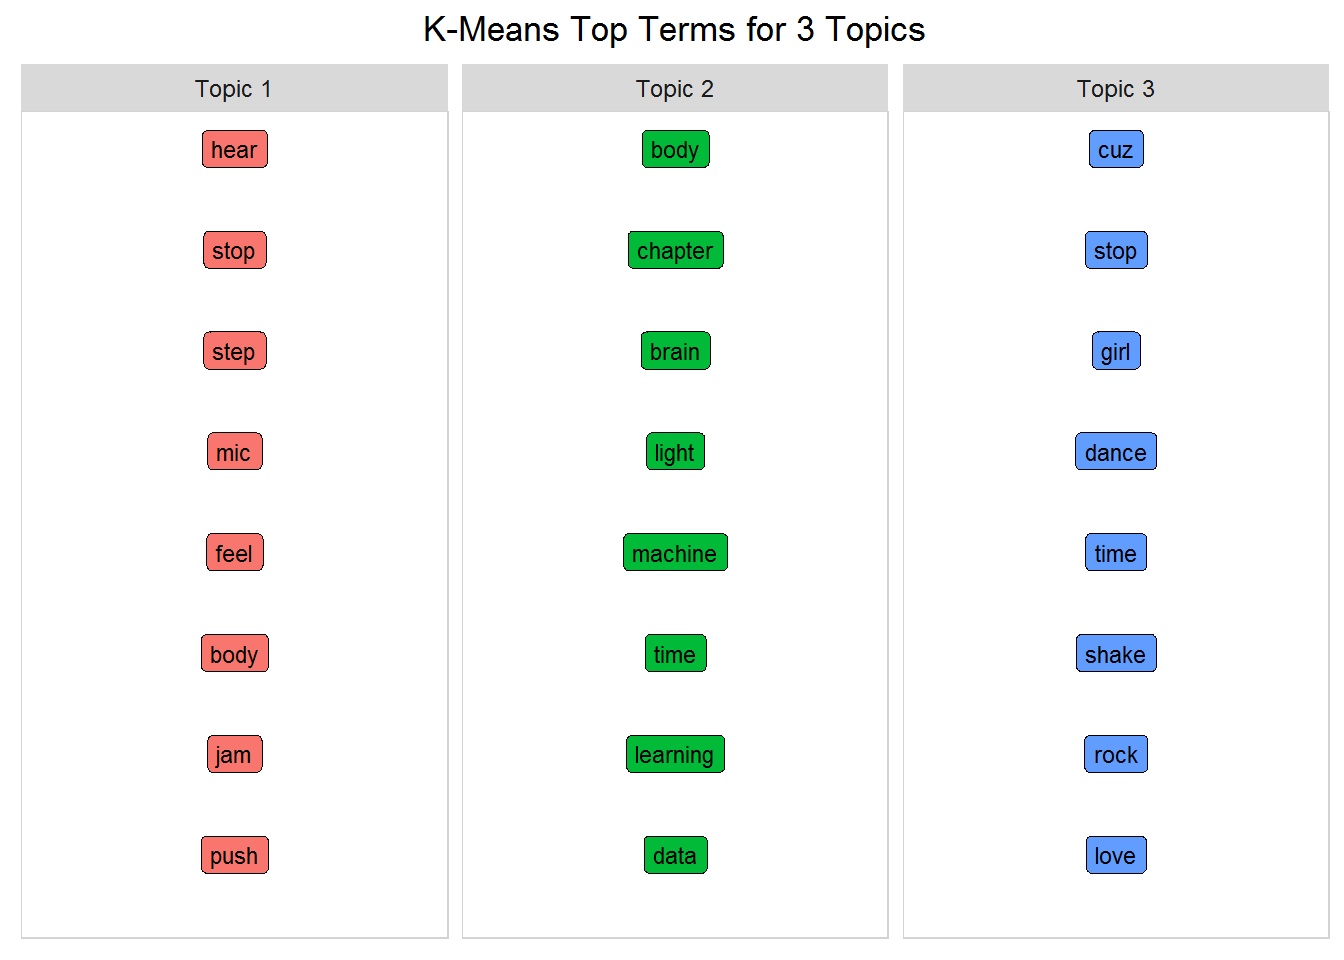
k-means sépare bien livres et musique : les Sujets 1 et 3 sont clairement « Prince », et le Sujet 2 regroupe les deux livres. En revanche, il ne parvient pas à distinguer les deux livres entre eux, contrairement à LDA. k-means peut être optimisé, tout comme LDA. À vue d’œil, avec des paramètres par défaut, k-means semble moins performant que LDA pour la modélisation de sujets. (Pour une autre option, regardez le package mallet.)
Appliquez LDA au jeu de données contenant 12 sources/auteurs couvrant plusieurs genres. Le jeu est déjà équilibré en nombre de documents et de mots par auteur. Aperçu :
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")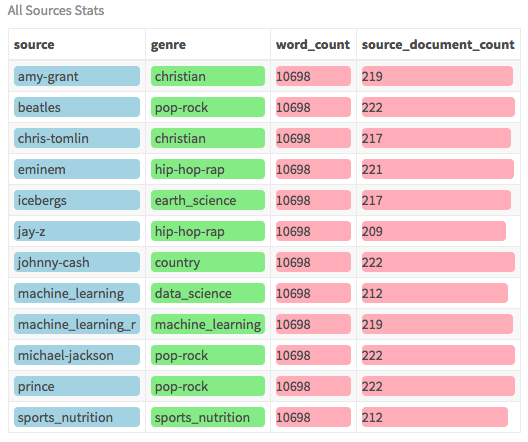
Ce jeu réunit des artistes divers, de Prince à Johnny Cash (country) et Eminem (rap), ainsi que quatre livres. Les artistes ont été choisis pour leur prolifique production dans leur genre. Le contenu a été extrait d’un site de paroles. Bien que deux livres traitent de machine learning, l’un porte sur la data science générale et l’autre sur le machine learning dans R. Tous les livres sont disponibles en PDF téléchargeable (les PDF bruts ne sont pas nécessaires ici, les versions tidy étant fournies).
Petite remise en forme : certains libellés de genre sont trop longs pour nos graphiques ; créons des abréviations plus lisibles.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedVous avez douze auteurs et huit genres. L’hypothèse : des auteurs du même genre devraient se regrouper dans un même sujet. Fixez donc le nombre de sujets à huit et ajustez le modèle sur ce jeu étendu.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)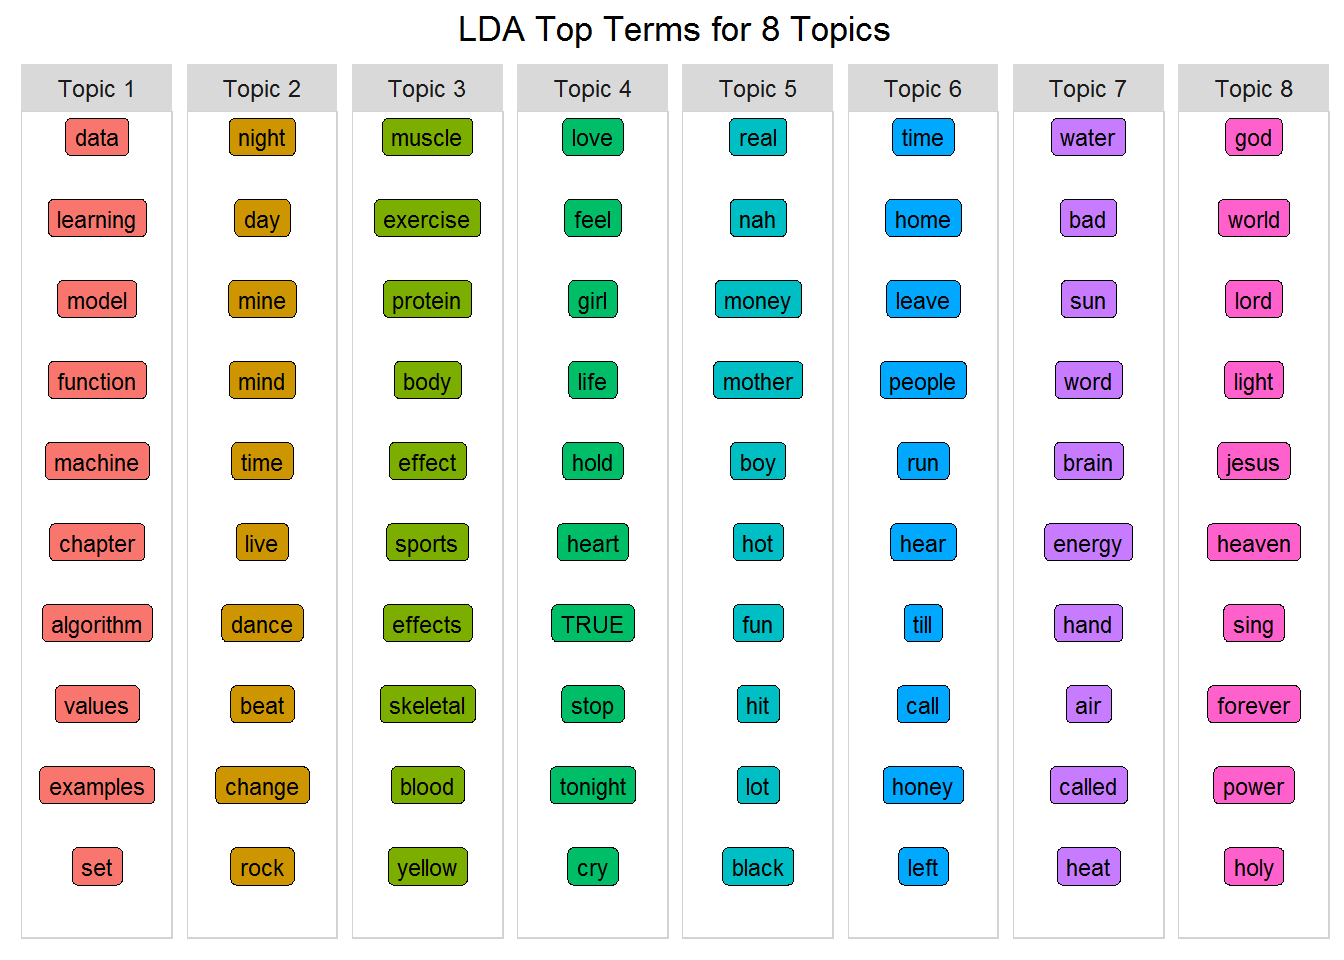
Sans vous influencer : « Waouh » ! Au vu des entrées, voyez-vous les thèmes ? Essayez de faire correspondre chaque sujet aux huit genres. Certains seront ambigus, d’autres évidents. Par exemple :
N’oubliez pas l’appartenance multiple : ces sujets ne sont pas strictement disjoints. Avec d’autres paramètres (LDA en a bien plus), vous pourriez encore améliorer le modèle.
La suite devient très intéressante. Comment faciliter l’interprétation des sujets ? Avec le bon jeu de données, votre modèle peut très bien s’en sortir. Si votre modèle détermine quels documents sont les plus susceptibles d’appartenir à chaque sujet, vous pouvez regrouper les auteurs. Et comme vous connaissez le genre de chaque auteur, vous pouvez en partie valider le résultat. Première étape : classer chaque document.
Rappel : chaque document contient plusieurs sujets, avec des pourcentages différents (gamma). Ce graphe montre la moyenne de gamma des documents de chaque source pour chaque sujet. Même approche qu’avec trois auteurs, mais cette fois en regardant le genre. C’est une excellente façon de visualiser la relation entre genres et sujets.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")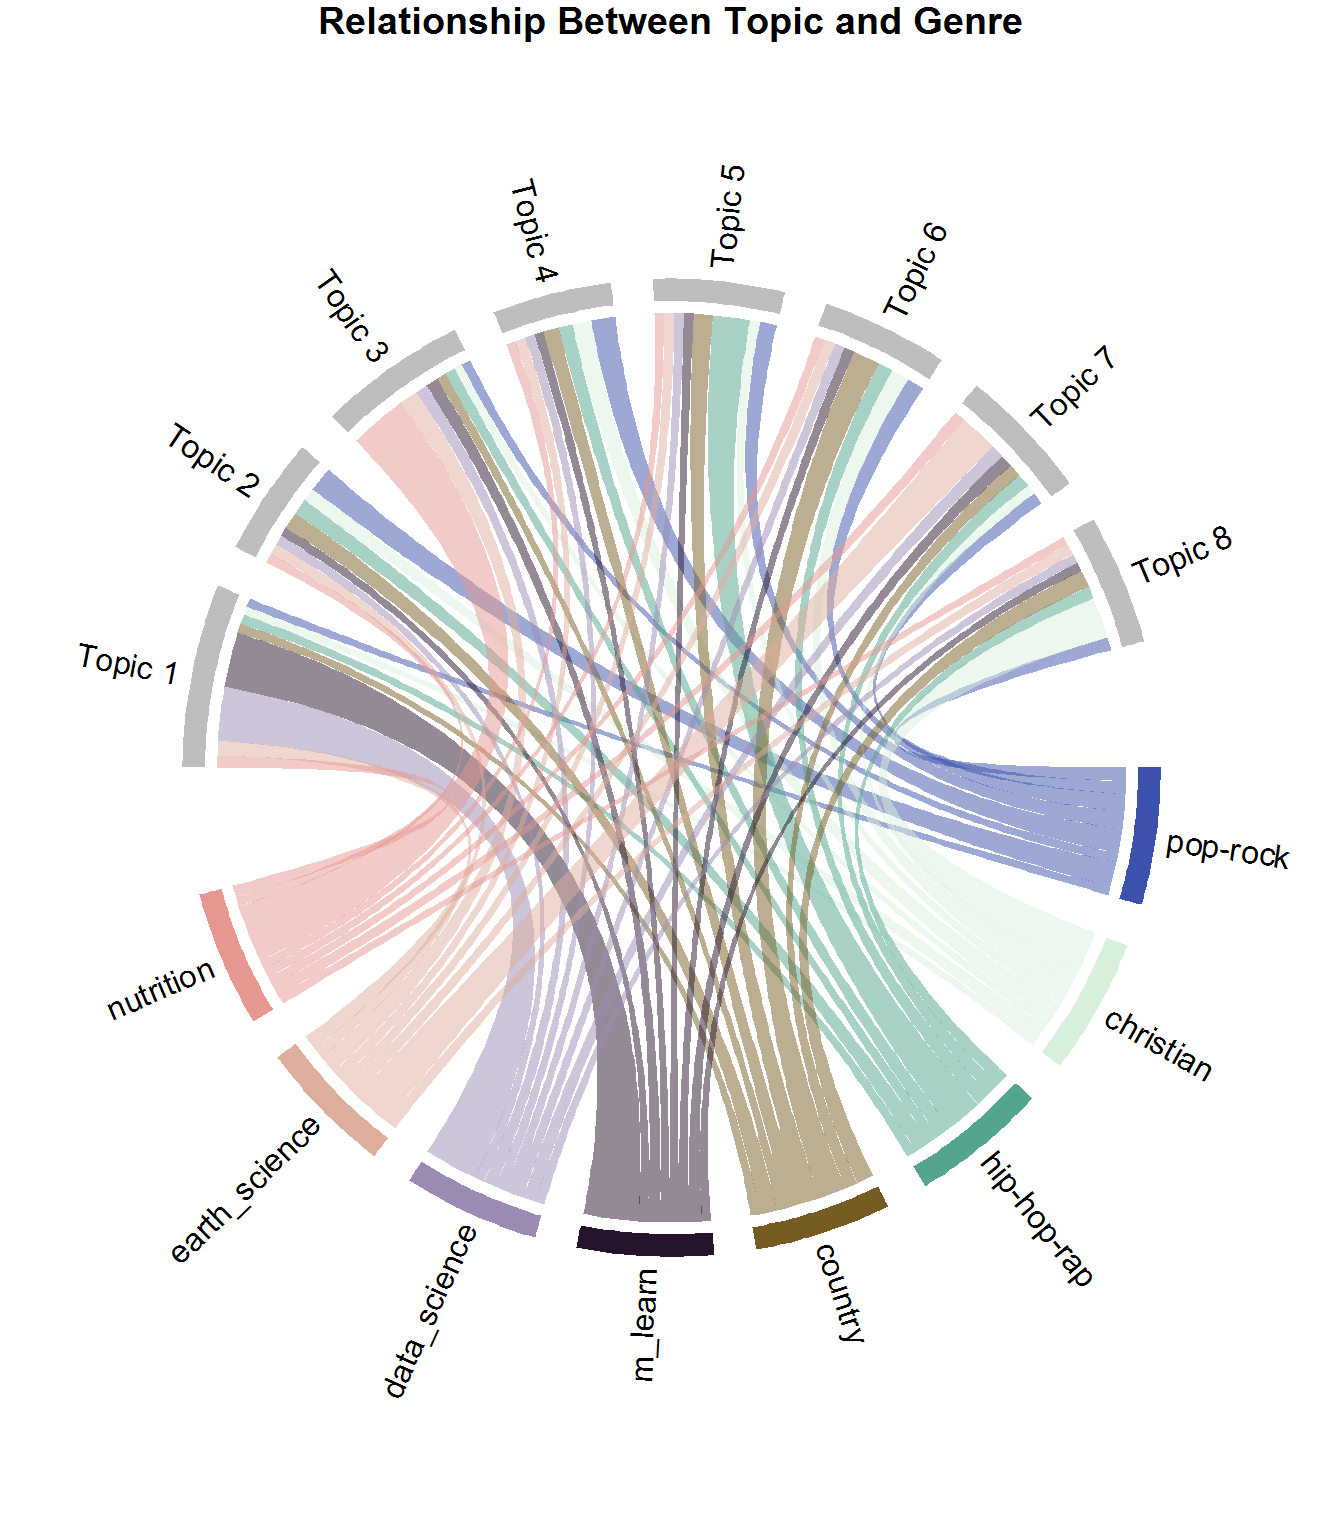
Chaque ruban représente la moyenne de gamma des documents d’un genre appartenant à un sujet. Pour sports_nutrition, le ruban vers le Sujet 3 est plus large : davantage de pages relèvent de ce sujet. De toute évidence, la majorité des pages de Machine Learning et Data Science tombent dans le Sujet 1 ; la majorité des documents de sciences de la Terre dans le Sujet 7 ; et, comme attendu, la pop/rock se répartit assez bien entre plusieurs sujets (genre plus généraliste). Le rap/hip-hop est bien plus présent dans le Sujet 5. Que faire de ces informations ? Formuler des recommandations aux auditeurs selon le contenu thématique !
Évidemment, le contenu lyrique n’a pas à être la seule caractéristique d’un système de recommandation ; on peut le combiner à des métadonnées comme le rythme, l’instrumentation, le tempo, etc., pour une meilleure expérience.
Maintenant que vous avez la relation documents/sujets, regroupez par source (auteur) et sujet, et calculez la somme de gamma par groupe. Sélectionnez ensuite, pour chaque sujet, l’auteur au topic_sum le plus élevé avec top_n(1). Comme vous souhaiterez faire la même chose par genre, créez une fonction top_items_per_topic() et passez source comme type. Vous pourrez la rappeler pour classifier par genre.
Moment clé : vous mappez effectivement un auteur à un sujet. À quoi vous attendez-vous ?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")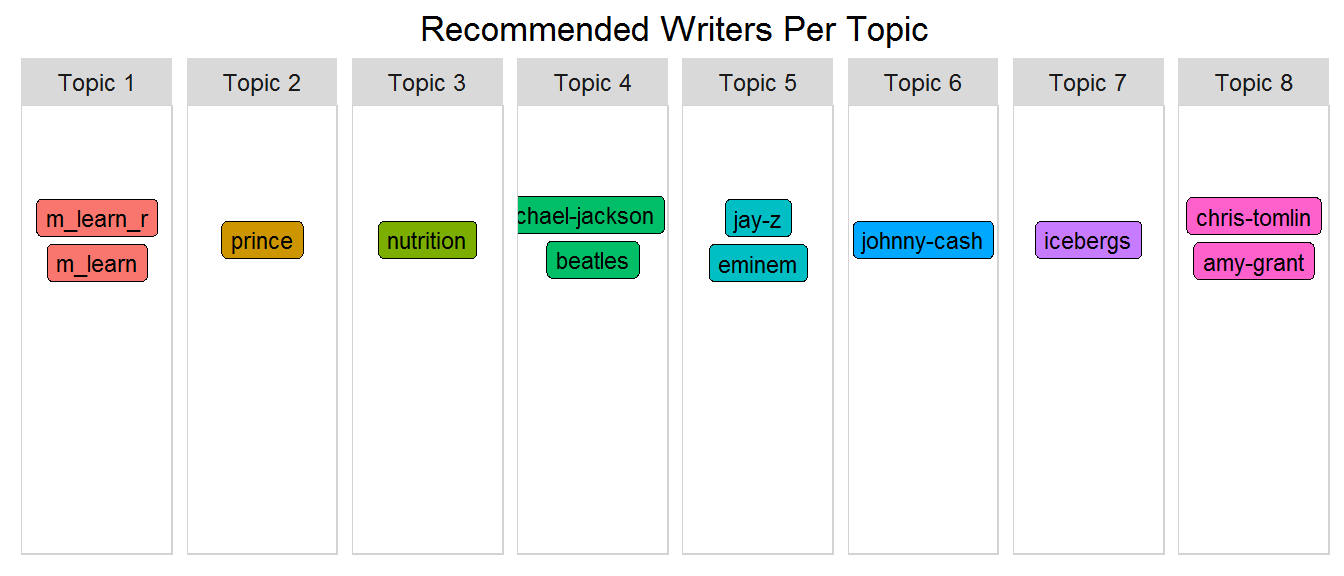
Passionnant ! Mais si vous connaissez mal ces artistes, rendons la lecture plus évidente en remplaçant l’auteur par le genre. Prêts…
top_items_per_topic(lda, source_tidy, "genre")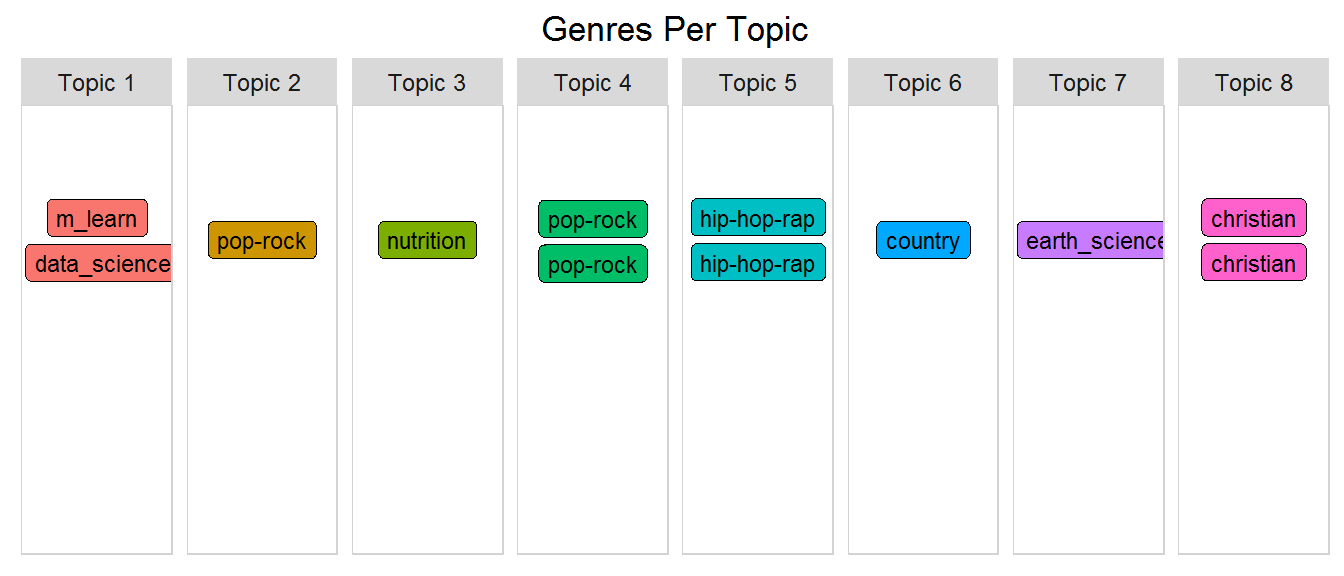
Les artistes hip-hop/rap sont regroupés, les artistes chrétiens aussi, deux artistes pop-rock se retrouvent ensemble, et chaque livre possède son sujet ! Impressionnant de voir un apprentissage non supervisé reconnaître des genres à partir du seul texte. Et si vous choisissiez un autre nombre de sujets ? Quels genres se regrouperaient ou se sépareraient ? À vous d’essayer. Le prochain modèle se concentre sur Prince uniquement, comme dans les tutoriels précédents.
Pour ce modèle, utilisez le jeu avec uniquement des chansons de Prince. Bien que des thèmes distincts existent, une chanson couvre souvent plusieurs sujets. Avec un seul artiste, les sujets seront plus mélangés et moins disjoints, rendant l’interprétation encore plus cruciale. Plutôt que d’utiliser les données brutes des paroles, vous allez travailler avec une version légèrement modifiée décrite ci-dessous.
Jusqu’ici, vous avez utilisé les mots tels que présents dans le texte. À présent, vous utilisez une forme annotée issue d’un puissant package TAL, cleanNLP. Ce package propose un modèle de données tidy pour le TAL avec des tâches d’annotation comme la tokenisation, l’étiquetage morpho-syntaxique, la reconnaissance d’entités nommées, le chaînage d’entités, l’analyse de sentiment, etc. L’exercice a été effectué en amont, mais je fournis tout le nécessaire pour la modélisation de sujets.
Dans le jeu annoté, chaque mot du corpus de paroles de Prince constitue une ligne, avec des informations clés sur ce mot.
Regardez de plus près l’objet annoté tokenisé en listant ses champs.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Nous n’utiliserons ici que deux informations :
Le champ word est le mot original et lemma sa forme lemmatisée. upos est le tag de catégorie grammaticale. Avec table() sur upos, vous verrez le décompte par catégorie (certains mots pouvant être multi-étiquetés).
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Pour visualiser la donnée, zoomez sur quelques chansons où le lemme diffère du mot d’origine, en retirant les stop words.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Vous pouvez choisir précisément ce que vous mettez dans vos modèles (mot, lemme, ou encore stem, évoqué en Partie Deux-A). Vous pouvez aussi questionner les résultats de cleanNLP (nom vs adjectif, etc.). Testez différentes configurations jusqu’à trouver la meilleure pour votre cas.
Dans ce tutoriel, nous ne modéliserons que les noms. Pour récupérer les métadonnées Prince (genre, année), joignez prince_annotated à prince_tidy par word et document, puis créez la DTM comme d’habitude. J’ai choisi de retirer quelques mots très fréquents et transverses pour garder l’analyse intéressante. (Note : la logique tf-idf vue en Partie Une est une autre méthode pour filtrer des mots communs.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)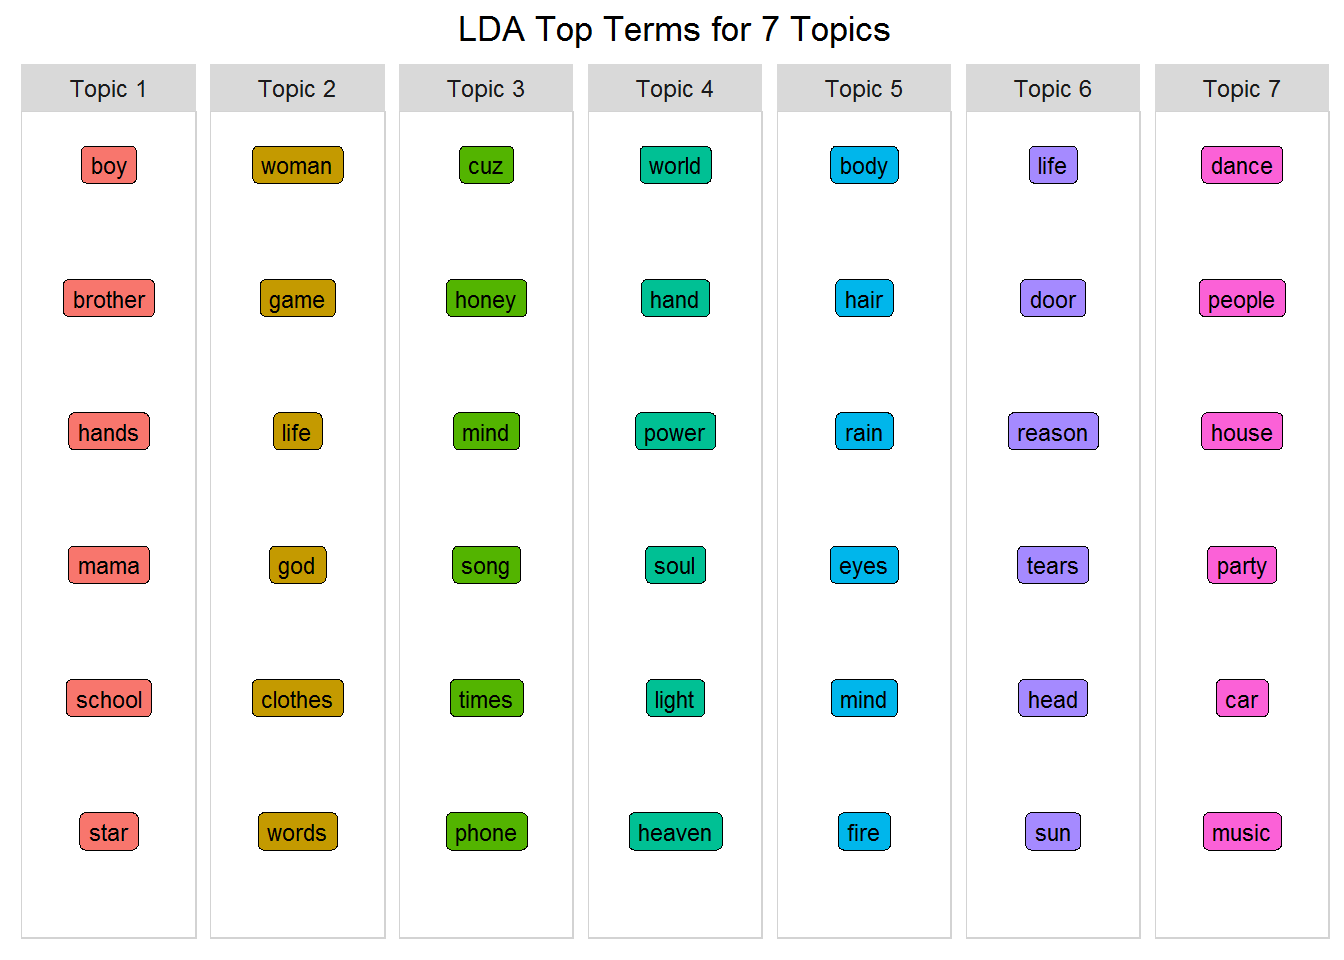
Voici des thèmes souvent évoqués dans la musique de Prince au fil des années. Ils sont associés à certains mots et, comme toujours en modélisation de sujets, se recoupent. Parcourez ces thèmes (listés dans un ordre aléatoire) et voyez si vous les retrouvez dans votre modèle :
On dirait que votre Sujet 1 parle de personnes et de famille ; le Sujet 7 de musique, danse, fête ; et le Sujet 4 de soi, société, religion. L’exercice reste subjectif. En contexte métier, cette étape d’interprétation est idéalement menée par un expert du domaine. Voilà pourquoi le TAL est bien à l’intersection entre IA et linguistique computationnelle.
Essayez avec un autre nombre de sujets, uniquement des verbes, les mots bruts plutôt que les lemmes, ou encore un autre nombre de mots clés… et voyez quels insights émergent. Pour choisir le nombre de sujets, voyez la notion de perplexité ici, ou le package
ldatuninglà.
Comme le jeu Prince contient l’année, vous pouvez suivre les thèmes au fil du temps. Soyez créatifs ! Pour l’instant, observons quelques mots de deux sujets et leur fréquence dans le temps. Le trending mériterait un tutoriel à part entière ; si cela vous intéresse, consultez cette ressource.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)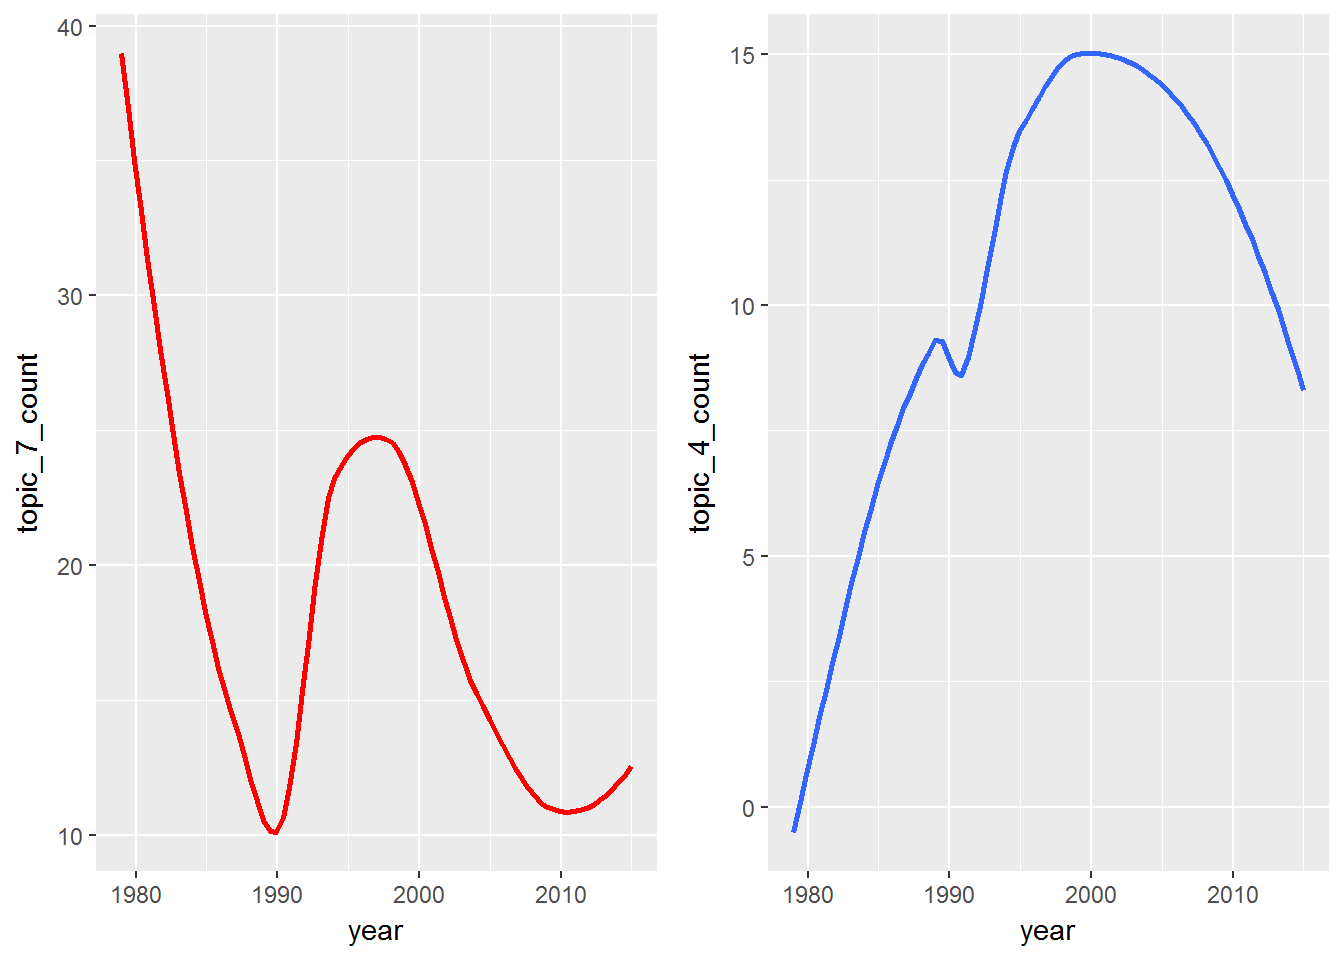
Exemple très rudimentaire d’évolution thématique. Imaginez étendre ce type d’analyse hors musique : corréler les ventes produit et des thèmes émergents dans les tweets clients, par exemple. Les applications sont nombreuses.
Ce tutoriel ne fait qu’effleurer le potentiel de la modélisation de sujets, du TAL et de l’apprentissage automatique. Le domaine est en plein essor et progressera à mesure que les data scientists exploreront l’océan d’informations non structurées. Dans la musique, la classification basée sur les paroles relève surtout de la recherche académique ; à vous de vous en inspirer pour contribuer au monde de l’IA.
Vous avez utilisé des paroles et des livres de non-fiction pour identifier des thèmes, classer des documents dans les sujets les plus probables et rapprocher des auteurs sur la base de contenus thématiques. Vous avez ainsi construit un système de recommandation simple reposant sur le texte et des auteurs étiquetés.
N’oubliez pas : vous cherchez à modéliser l’art à l’aide de machines. Un artiste peut écrire « You are the apple of my eye », sans parler ni de fruit ni d’anatomie. À vous de dévoiler l’implicite. Quand vous écoutez un morceau, vous n’entendez pas toujours les chœurs, mais ils sont bien là. Montez le son de votre titre préféré, écoutez au-delà de la voix principale, et vous découvrirez un monde d’informations cachées. Alors, reléguez un peu la logique, et mettez votre créativité au premier plan pendant l’exploration !
Comme dans toute cette série, servez-vous des données proposées comme étude de cas ludique et comme source d’idées pour analyser les textes qui vous passionnent : vos artistes favoris, les réseaux sociaux, des corpus d’entreprise, scientifiques, ou socio-économiques. Quelles applications voyez-vous pour la modélisation de sujets ? Partagez vos idées en commentaire !
Restez à l’écoute pour la Partie Trois (le quatrième article) de la série : Lyric Analysis : Predictive Analytics using Machine Learning with R. Vous y utiliserez des paroles et des métadonnées étiquetées pour prédire l’avenir d’une chanson. Vous testerez plusieurs algorithmes (arbres de décision, Naive Bayes, etc.) pour prédire le genre, la décennie, et peut-être même les chances d’entrer au classement ! À très vite !
Mises en garde :
Premier point : Vous n’obtiendrez exactement les mêmes résultats que moi qu’en exécutant le code dans le même ordre avec les mêmes fichiers de données non modifiés. Sinon, certaines références aux sujets ne correspondront plus.
Deuxième point : Il n’y a pas de règles absolues ici ; cette démarche s’appuie sur mes propres recherches. Si la modélisation de sujets existe en production, on voit peu de travaux de recommandation musicale basés exclusivement sur les paroles.
Troisième point : La modélisation de sujets est délicate. Construire le modèle est une chose, interpréter les résultats en est une autre : c’est subjectif et difficile à valider pleinement (des recherches sont en cours ; voir cet article de Thomas W. Jones). Le processus est non supervisé, génératif, itératif et probabiliste. Les sujets sont subtils, cachés, implicites, non explicites.
Pour aller plus loin sur le machine learning avec R, consultez notre tutoriel pour débuter. Suivez aussi notre cours Introduction to Machine Learning avec R.
En savoir plus sur le machine learning
Cours
Cours
Cours