Curso
Comprender el machine learning
2 h
308K
Aplica técnicas punteras con R, PLN y Machine Learning para modelar temas en texto y crear tu propio sistema de recomendación musical.
Este es el apartado Dos-B de una serie de tres tutoriales en la que seguirás usando R para realizar distintas tareas analíticas sobre un caso de estudio de letras musicales del legendario artista Prince, además de otros artistas y autores. Los tres tutoriales cubren lo siguiente:
Imagina que eres Data Scientist en la NASA. Te piden monitorizar dos naves destinadas a órbitas lunares que estudiarán la interacción de la luna con el sol. Como con cualquier nave, puede haber problemas detectados durante las pruebas o tras el lanzamiento. Estas anomalías se documentan en lenguaje natural en casi 20.000 informes de problemas. Tu trabajo es identificar los temas más populares y las tendencias en el corpus y ofrecer análisis prescriptivos a los ingenieros y directores del programa, influyendo así en el futuro de la exploración espacial.
Este es un caso real y debería darte una idea del poder que tendrás al dominar técnicas de vanguardia como el modelado de temas con aprendizaje automático, el procesamiento del lenguaje natural (PLN) y la programación en R. Por suerte, no hace falta trabajar en la NASA para hacer algo igual de innovador. En este tutorial, tu misión —si decides aceptarla— es aprender sobre modelado de temas y cómo construir un sistema de recomendación sencillo (recommender) basado en letras de canciones y libros de no ficción.
¡Solo por diversión!
Esto no tiene que ver con el modelado de temas, pero, por diversión, usa un paquete fantástico llamado circlize, presentado en un tutorial anterior, para despertar esos fotorreceptores y disfrutar de este diagrama circular con todas las fuentes que utilizarás en este tutorial.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)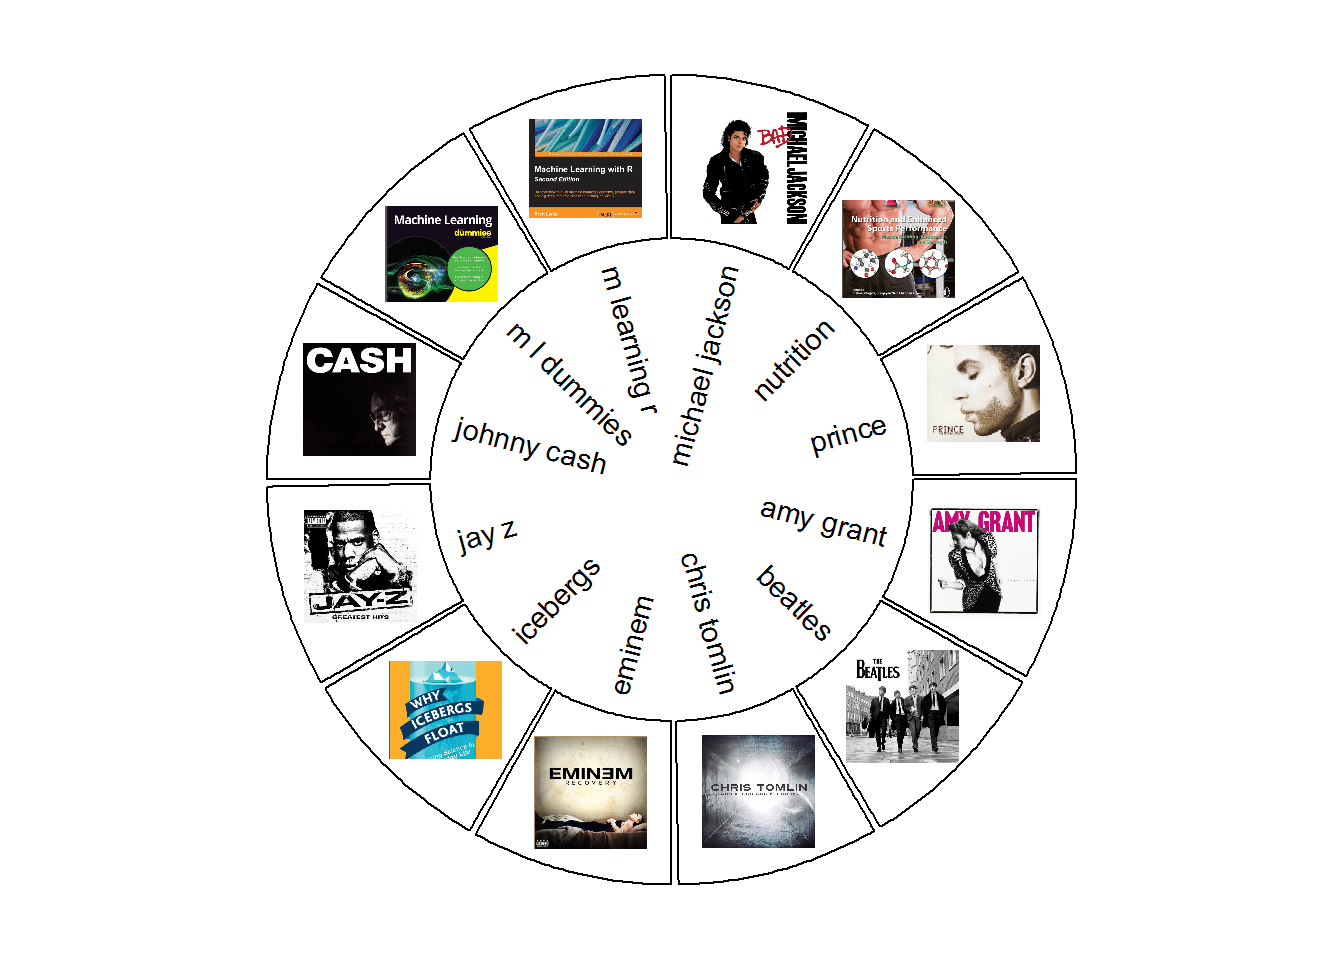
En tutoriales anteriores, analizaste el contenido de las letras de Prince usando frecuencia de palabras, la estadística tf-idf y análisis de sentimiento. Puedes profundizar más en letras y otros textos usando el concepto de modelado de temas.
En este tutorial, construirás cuatro modelos usando los algoritmos de aprendizaje automático Latent Dirichlet Allocation (LDA) y clustering K-Means. Explicaré los algoritmos más adelante.
El modelo uno utiliza texto de letras de Prince combinado con dos libros de no ficción. El objetivo es darte un ejemplo sencillo de cómo usar LDA, un algoritmo no supervisado, para generar colecciones de palabras que, juntas, sugieren temas. Estos temas no están etiquetados y requieren interpretación humana. Una vez que identifiques un número predefinido de temas, tomarás los resultados del modelo y clasificarás cada canción o página de libro en cada categoría. Una canción puede contener todos los temas que has generado, pero encajar mejor en uno que en otro. A esto se le llama clasificación de documentos, pero como conoces el autor del documento, en esencia estás clasificando autores en agrupaciones temáticas.
El modelo dos usa el dataset del modelo uno y ofrece una mirada rápida a la generación de temas con un algoritmo diferente, k-means, y a por qué quizá no sea la mejor opción para modelado de temas.
De nuevo con LDA, el modelo tres emplea un dataset mayor con múltiples artistas de distintos géneros y más autores. Cuando clasificas la mayoría de documentos de un autor/artista en su tema más probable, puedes agrupar escritores con composiciones temáticas similares. Con un modelo sólido, deberías ver géneros afines aparecer en el mismo grupo temático. Por ejemplo, artistas de rap en un tema, y dos libros sobre un tema parecido juntos en otro. Así, ¡podrías recomendar autores similares! Evidentemente, los autores y su género están etiquetados, pero los temas no, por lo que el proceso es no supervisado.
El modelo cuatro usa LDA solo sobre las letras de Prince. Esta vez usarás un dataset anotado generado fuera de este tutorial donde cada palabra está etiquetada con su categoría gramatical (sustantivo, verbo, etc.) y su forma base (lematizada). También examinarás cómo cambia un tema a lo largo del tiempo.
El PLN y el Machine Learning son subcampos de la inteligencia artificial. Recientemente ha habido intentos de usar IA para componer canciones. No es el objetivo de este tutorial, pero es un ejemplo de IA como arte. Al fin y al cabo, las tres primeras letras son A-R-T. Por un momento, compara la IA con componer: puedes seguir un patrón y crear una estructura (estrofa, estribillo, estrofa, etc.), pero lo que hace grande a una canción es cuando el autor inyecta creatividad en el proceso. En este tutorial, necesitarás tus habilidades técnicas para construir modelos, pero también tu creatividad para interpretar y explicar los resultados.
Piénsalo así: si el modelado de temas es un arte, las letras son el código, componer es el algo-ritmo y la canción es el modelo. ¿Cuál sería tu analogía?
Los sistemas de recomendación típicos no se basan solo en texto. Por ejemplo, Netflix recomienda películas según elecciones previas y metadatos asociados. Pandora tiene otro enfoque y se apoya en un Music Genome con 400 atributos musicales, como melodía, ritmo, composición y resúmenes de letras; sin embargo, ese genoma comenzó en 2000 y llevó cinco años y 30 expertos en teoría musical completarlo. Abundan los artículos científicos sobre recomendaciones de películas basadas en resúmenes de tramas. Ejemplos de recomendadores musicales basados en el contenido real de las letras son más escasos. ¿Te animas a probar?
La parte dos-B de esta serie requiere entender los principios de datos ordenados (tidy), en concreto paquetes como dplyr y ggplot2. También se recomienda práctica con minería de texto usando tidytext, tratado en los tutoriales anteriores. Además, deberías estar familiarizado con funciones en R, ya que reutilizarás código en cada modelo. Para centrarnos en extraer insights, he incluido código pensado para que lo apliques a tu propio dataset; puede que la explicación detallada requiera que investigues un poco más por tu cuenta.
¿Qué puedes hacer tú con modelado de temas? Quizá tengas documentos con información clave para tu negocio que podrías explotar. Tal vez puedas hacer scraping de Twitter y descubrir qué se dice sobre los productos de tu empresa. O construir tu propio sistema de clasificación para enviar ciertos documentos al departamento adecuado para su análisis. ¡Hay todo un mundo de posibilidades por explorar! ¡A por ello!
Algunas aplicaciones del modelado de temas:
Los únicos paquetes nuevos en este tutorial, que no aparecen en la parte uno o la parte dos-A, son topicmodels, tm y plotly. Usarás la función LDA() de topicmodels, que permite a los modelos aprender a distinguir entre documentos. El paquete tm es para text mining y usaremos inspect() una vez para ver el interior de una matriz documento-término, que explicaré luego. plotly lo usarás una vez para crear una versión interactiva de un gráfico de ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Las siguientes funciones se definieron en tutoriales anteriores, excepto word_chart(); aun así, el contenido y la descripción de word_chart() también aparecen en la parte dos-B. Básicamente, debes saber que usa ggplot() de una forma distinta para crear una visualización basada en palabras en lugar de puntos.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Para apreciar de verdad la potencia del modelado de temas y la clasificación, no solo usarás letras de Prince como en tutoriales previos, sino que también trabajarás con otros artistas de distintos géneros reconocidos en las Billboard Charts. Además, he añadido algunos libros sobre temas variados, como nutrición deportiva, icebergs e incluso machine learning. Con un dataset diverso, podrás clasificar documentos en temas asociados y distinguir entre artistas/autores similares.
Truco: me referiré a canciones y páginas de libros como documentos, y a músicos/autores como autores. En el código verás la palabra source, que indica el autor al que hace referencia cada dato. Usaré género tanto para el musical como para la categoría del libro. En lugar de nombres de autores, usé títulos de libros para mayor claridad. Todo tendrá sentido a medida que avances.
Para centrarte en el modelado, realicé la limpieza de datos fuera de este tutorial y te proporciono todo lo necesario en estos tres archivos con el siguiente preprocesado ya aplicado:
pdf_text() del paquete pdftools para extraer el contenido de cuatro libros (cada página es un documento distinto)tidytext descrito en la parte unoTrabajarás con tres datasets distintos:
three_sources_tidy_balanced: letras de Prince y dos librosall_sources_tidy_balanced: letras de ocho artistas y cuatro librosprince_tidy: solo letras de PrinceTambién he incluido un dataset anotado de las letras de Prince. Explicaré qué significa anotado cuando llegues al modelo cuatro.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)El objetivo principal del modelado de temas es encontrar términos temáticamente relacionados (temas) en datos textuales no estructurados medidos como patrones de coocurrencia de palabras. Los componentes básicos son documentos, términos y temas. LDA es un método no supervisado que descubre los temas subyacentes en una colección de documentos, donde cada documento es un conjunto de palabras. LDA asume que:
LDA busca grupos de palabras relacionadas. Es un algoritmo generativo e iterativo. Dos pasos principales:
La idea tras LDA es que palabras de un mismo tema tienden a aparecer juntas en documentos. Intenta modelar cada documento como mezcla de temas y cada tema como mezcla de palabras (a esto se le llama modelo de membresía mixta). Luego puedes usar la probabilidad de que un documento pertenezca a un tema para clasificarlo. En tu caso, como conoces el autor original, puedes recomendar artistas/autores con estructuras temáticas similares. Veamos un ejemplo.
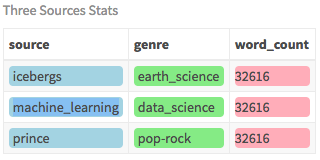
Para este modelo, usarás el dataset con tres autores (fuentes) distintos y buscarás temas ocultos. Para mostrar la potencia del modelado de temas, las tres fuentes elegidas son muy diferentes y, de forma intuitiva, sabes que cubren tres temas. Por tanto, le dirás a tu modelo que cree tres temas y comprobarás su "inteligencia". Primero, conviene explorar el dataset usando tu función my_kable_styling() junto con color_bar() y color_tile() del paquete formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
Aquí usarás letras de Prince, un libro llamado "Machine Learning For Dummies" y otro llamado "Why Icebergs Float", cada uno con más de 30.000 palabras (no distintas).
Como ya tienes un dataset tidy y equilibrado con letras de Prince y dos libros, primero crea una matriz documento-término (DTM) en la que cada fila es un documento y cada columna un término. Este formato es necesario para LDA. Un documento es una canción en las letras y un número de página en los libros. Primero, cuenta las palabras por documento y pásalo a la función cast_dtm() de tidytext, donde document es el campo con el nombre del documento y word el de la palabra. Hay otros parámetros, pero estos dos son obligatorios.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Esto te dice cuántos documentos y términos tienes y que la matriz es muy dispersa. Dispersa implica que la DTM contiene en su mayoría celdas vacías: dada la amplitud del vocabulario posible, solo unas pocas palabras aparecen en cada documento individual.
Si miras algunas filas y columnas con inspect() del paquete tm, verás que cada fila es un documento y cada columna un término. (Puedes usar str() para ver la estructura).
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Ya sabes lo que necesita el modelo como entrada, así que define dos variables que podrás reutilizar en cada modelo: source_dtm y source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedVamos a la parte divertida: ajustar el modelo. El código es sencillo, pero para ser un buen Data Scientist conviene entender qué ocurre "debajo del capó". Aunque esta es una descripción somera, hay muchísima información sobre LDA online. Para tus fines, necesitas cuatro parámetros: la entrada, el número de temas, el método de muestreo y la semilla.
Como sabes que tu dataset tiene tres autores distintos, fija k en 3 y define una seed constante para resultados repetibles. Hay otros parámetros de control (de ahí la lista en el código), pero usaremos seed. El parámetro method define el algoritmo de muestreo: usaremos GIBBS. El valor por defecto es VEM, pero en mi experiencia rinde peor que GIBBS.
En breve: el muestreo GIBBS realiza un paseo aleatorio que parte de un punto inicial (usaremos el 0 por defecto) y en cada paso se mueve ±1 con igual probabilidad. Si quieres detalles, lee esta introducción.
Nota: he pasado por alto detalles del algoritmo LDA. No necesitas toda la teoría estadística para usarlo, pero te recomiendo este documento de Ethen Liu con una explicación sólida.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Puedes ver que se ha creado un objeto LDA_Gibbs con tres temas. No ejecuto str(lda) aquí por la longitud de la salida; pruébalo tú para ver qué contiene.
El siguiente paso es abrir ese objeto y ver resultados. Usa tidy() para ponerlo en un formato fácil de entender. Dentro de tidy() pasa el objeto LDA y beta en el argumento matrix. Al pasar beta obtienes las probabilidades palabra-por-tema del modelo. El siguiente ejemplo, usando el término iceberg, muestra la probabilidad de esa palabra en cada tema. iceberg tiene mayor probabilidad de generarse en el tema 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Para entender bien el modelo, necesitas ver qué términos hay en cada tema. Crea una función que ordene el modelo LDA y extraiga los términos principales por tema, es decir, los de mayor beta. Dentro de esta función usarás word_chart() para mostrar claramente los tres temas y sus palabras principales. Fija num_words en 10 para este ejemplo y prueba con otros valores para ganar perspectiva.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)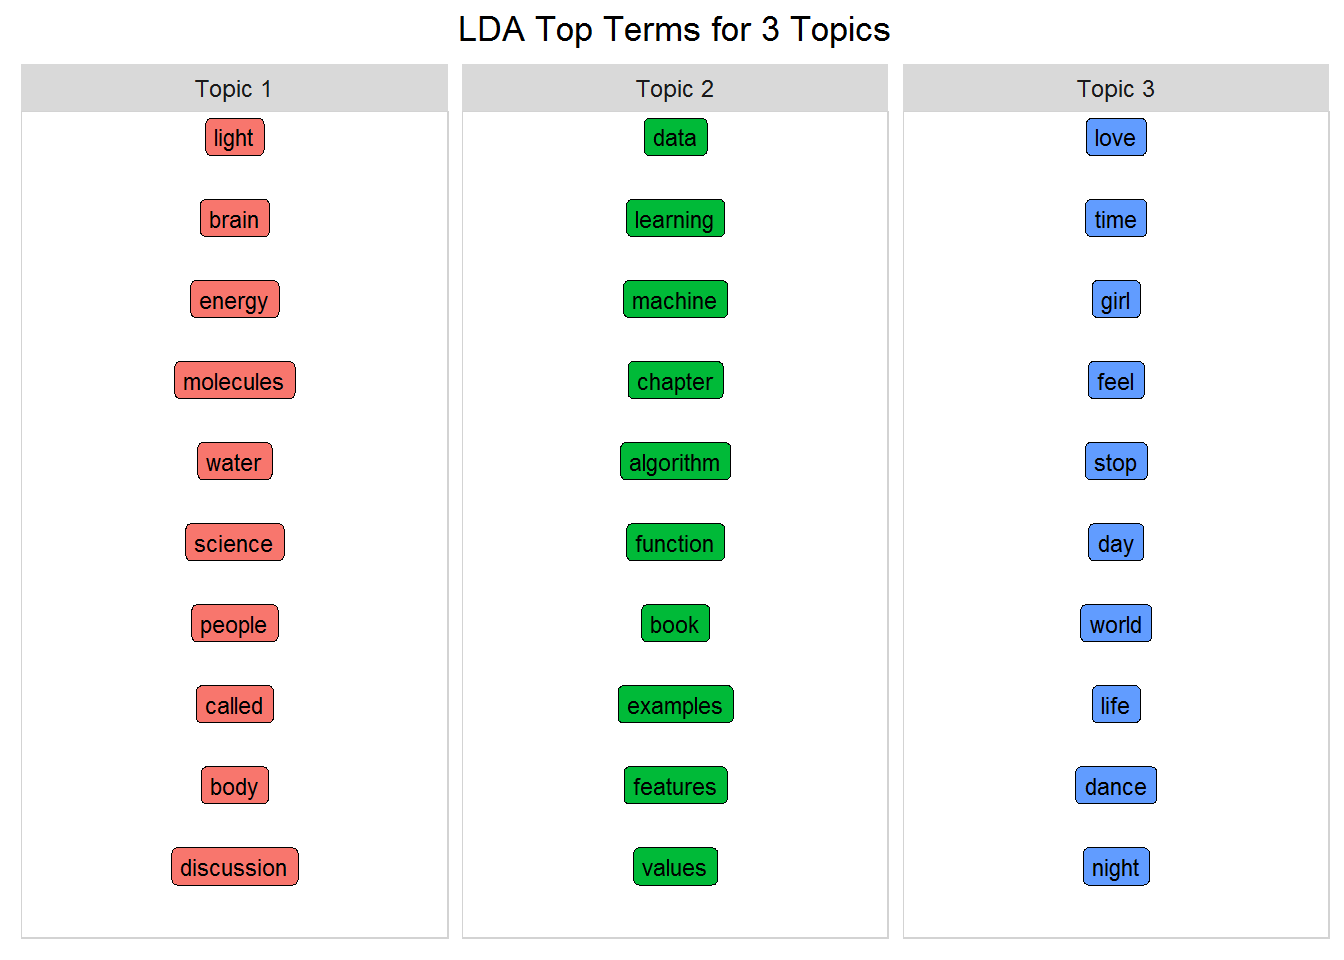
El aprendizaje no supervisado siempre requiere interpretación humana... pero estos temas reflejan claramente las tres fuentes: Icebergs, Machine Learning y Prince. Aunque es un ejemplo simple, piensa en las posibilidades: es sorprendente.
Además de estimar cada tema como mezcla de palabras, LDA muestra cada documento como mezcla de temas. Esta vez, al ordenar el modelo LDA, usa matrix = "gamma" para obtener las probabilidades documento-por-tema. Por ejemplo, mira la canción 1999 de Prince. Igual que una palabra puede asociarse a varios temas, lo mismo ocurre con los documentos (concepto de membresía mixta). Abajo ves que 1999 es más probable en el tema 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661La canción pertenece a todos los temas, pero con distinto porcentaje (gamma). Algunos documentos encajan mejor en ciertos temas. 1999 tiene mayor gamma en el tema 3.
Para aclarar qué hace LDA, mira este diagrama circular. Muestra el porcentaje de documentos de cada fuente que pertenece a cada tema. Para crearlo, une el modelo LDA ordenado con source_tidy por document para recuperar la fuente (autor). Con el agrupamiento adecuado, obtienes el gamma medio por fuente y tema. Así verás, para cada fuente, en qué tema cae la mayoría de sus documentos.
Dedícale un momento si no has usado diagramas circulares antes. (Consulta la parte dos-A para practicar con chordDiagrams() y circlize. Todo lo que necesitas saber del paquete está en este libro de Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")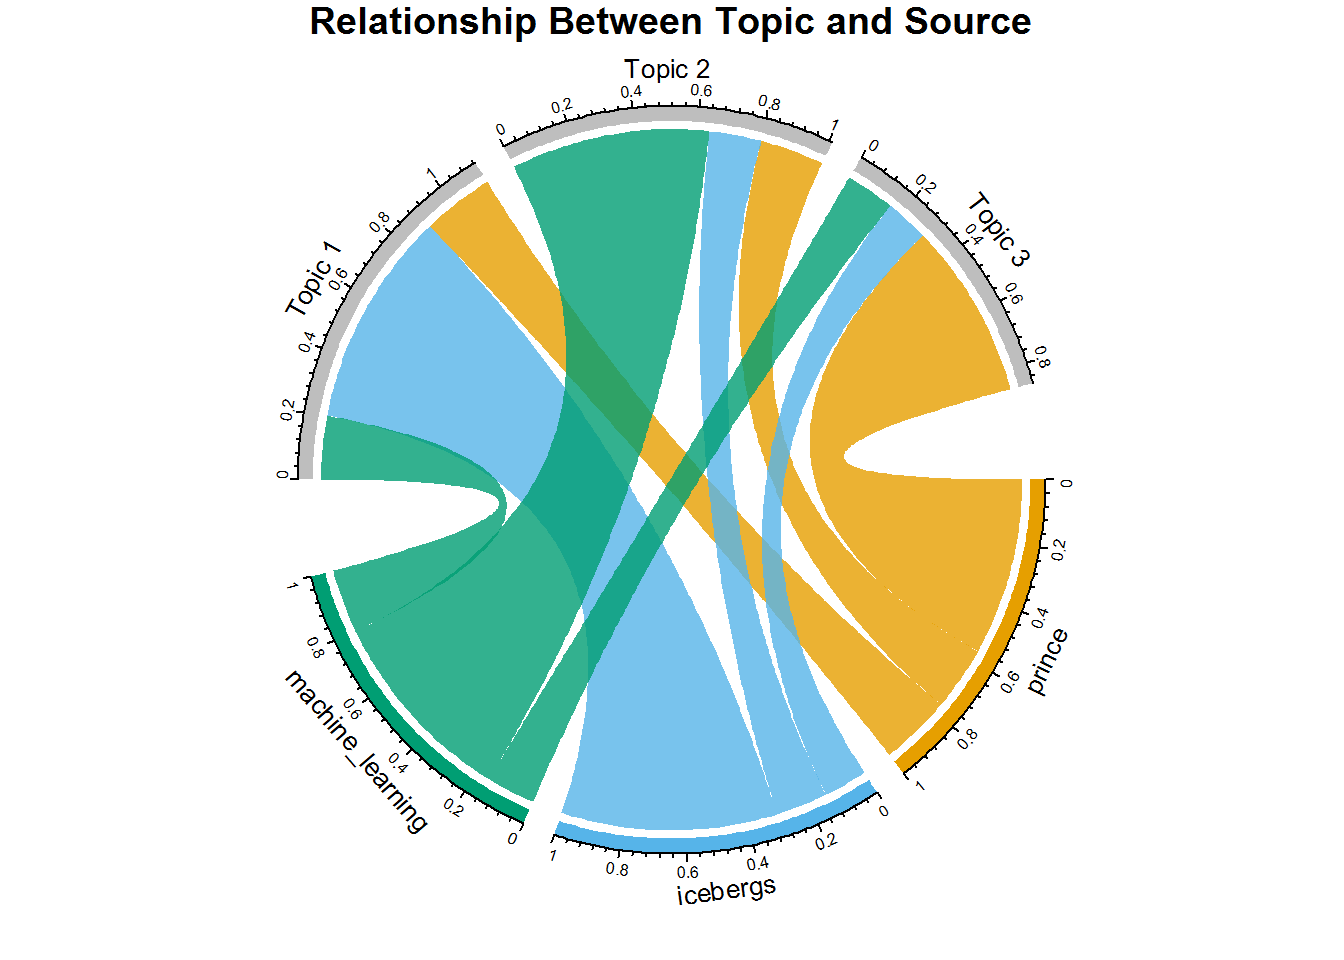
Es una forma muy clara de ver que, aunque documentos de cada fuente aparecen en cada tema, cada fuente tiene mayoría en un tema específico. Por ejemplo, las canciones de Prince se asocian sobre todo con el tema 3 (su acorde es mayor que hacia los temas uno y dos). Lo mismo ocurre con Icebergs y el tema 1, y Machine Learning y el tema 2. Una vez ves el patrón, todo encaja.
En esencia, acabas de clasificar documentos en temas según la media de gamma por tema/fuente. Si conoces el autor y sabes que compone principalmente sobre cierto tema, podrías suponer que artistas de géneros similares caerán en los mismos temas y, por tanto, podrás recomendar autores afines. Con el dataset más grande lo pondrás en práctica.
Ahora baja al nivel de documento individual y revisa los documentos destacados por tema.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)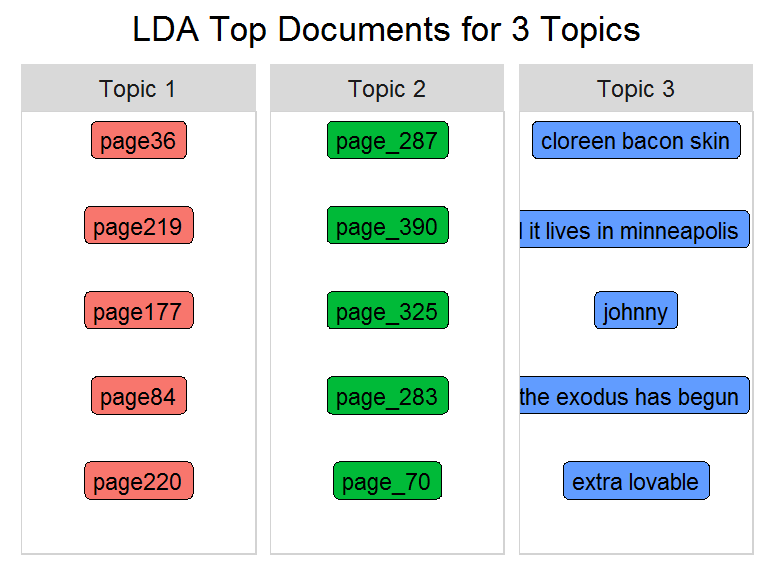
Como puede que no conozcas la nomenclatura de documentos/canciones (p. ej., páginas con guion bajo son del libro de machine learning), sustituiré el nombre del documento por el de la fuente.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)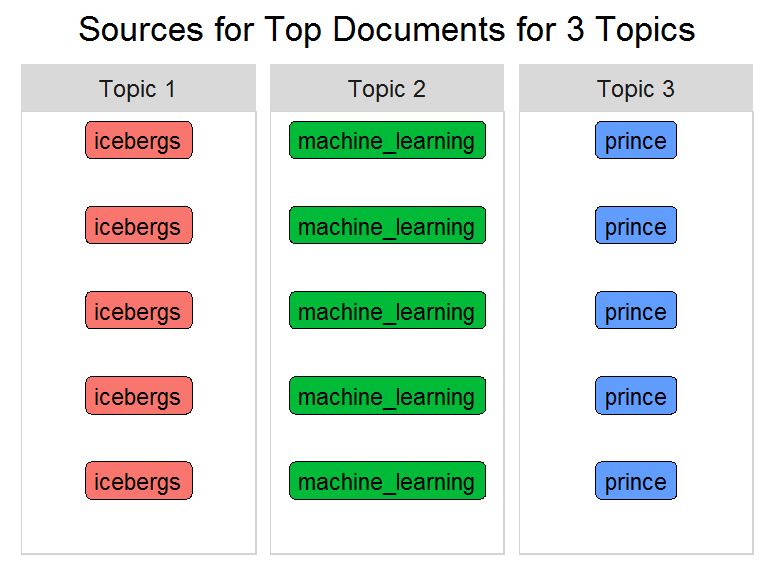
Los documentos destacados de cada tema en el gráfico anterior ahora aparecen sustituidos por su fuente. El código ha clasificado muy bien estos documentos porque han caído en la misma categoría (al menos en este top 5). La gran pregunta es si funcionará con más de tres fuentes. Si los resultados son precisos, podrás recomendar autores con temas similares.
Crearás el segundo modelo con otra técnica de machine learning: el algoritmo k-means. Al igual que LDA, k-means es no supervisado y requiere decidir el número de temas por adelantado. A diferencia del modelo de membresía mixta de LDA, k-means particiona los documentos en clusters disjuntos (temas). Agrupa documentos según una medida de similitud. Transforma documentos a un vector numérico con pesos por palabra (similar a tf-idf). Cada documento aparece en un único cluster: es hard clustering. La salida es un conjunto de clusters con sus documentos. En cambio, LDA es soft clustering: un dato puede pertenecer a más de un cluster.
Conceptualmente, aplicado a lenguaje natural, LDA suele dar resultados más realistas que k-means para asignación de temas, ya que el texto suele mezclar varios. Construye ahora tu modelo, examina el objeto de k-means y verifica la hipótesis.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"La estructura del objeto k-means revela dos piezas clave: clusters y centers. Puedes ver el contenido de cada variable para la canción 1999 y la palabra party que aparece en esa canción.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Estos campos muestran que 1999 cae en un único cluster (el dos) y party aparece en los tres, pero sobre todo en el uno. Ahora mira las palabras principales según los valores de centers para identificar temas.
Recuerda que este dataset tiene tres fuentes: Prince, Icebergs y Machine Learning. Imprime las palabras principales de cada cluster y compara con LDA. Necesitarás transformar un poco el formato para usar word_chart(). Sigue el código; aquí importa más el análisis de las palabras que los detalles de manipulación.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)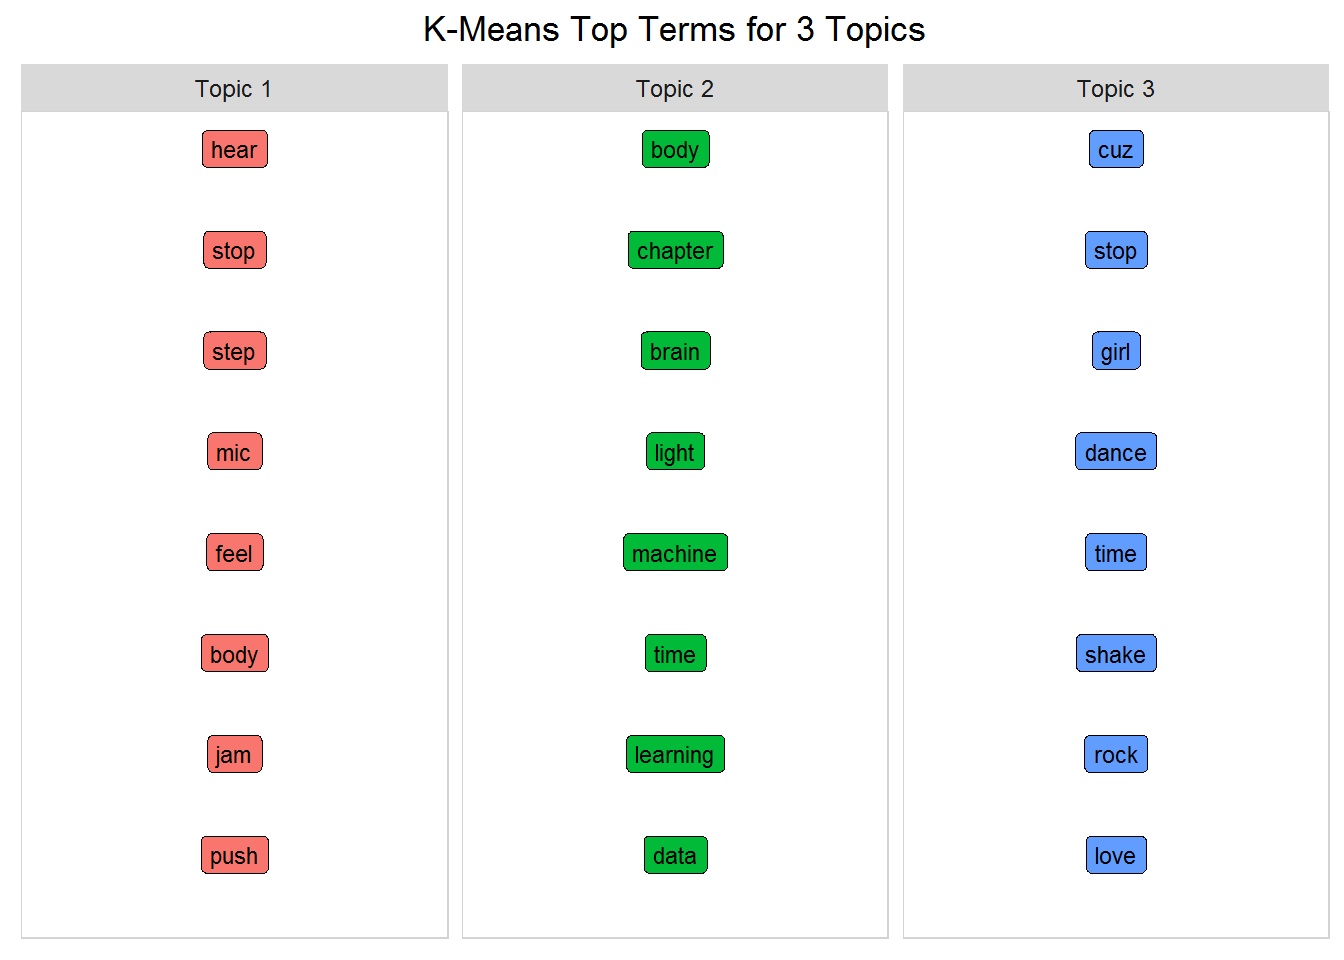
k-means acierta al separar libros y música. Es decir, los temas 1 y 3 son claramente de Prince y el tema 2 combina los dos libros. Sin embargo, no distingue entre los dos libros como sí hizo LDA. Se puede afinar k-means, pero también LDA. A simple vista, con parámetros por defecto, k-means no rinde tan bien como LDA y, de hecho, el hard clustering no suele usarse para modelado de temas. (Como alternativa, echa un vistazo al paquete mallet).
En este modelo, aplicarás LDA al dataset con 12 fuentes/autores de múltiples géneros. El dataset ya está equilibrado con un número similar de documentos y palabras por autor. Aquí tienes un resumen:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")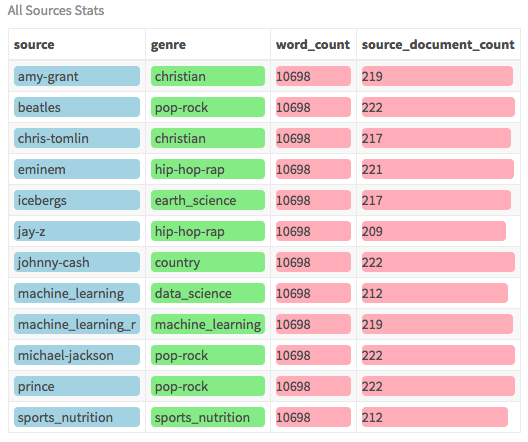
Este dataset incluye una gran variedad de artistas, desde Prince hasta Johnny Cash (country) o Eminem (rap), además de cuatro libros. Se eligieron por ser los más prolíficos en sus géneros y se obtuvieron de una web de letras. Aunque hay dos libros de machine learning, uno se centra en data science general y otro es más específico de R. Todos los libros están disponibles en PDF descargable. (No necesitas los PDFs brutos: ya se proporcionan las versiones tidy).
Un pequeño ajuste: algunas descripciones de género son demasiado largas para los gráficos, así que crea abreviaturas para que se lean mejor.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedEsta vez tienes doce autores y ocho géneros. La esperanza es que autores del mismo género se agrupen en el mismo tema: ese es el test real. Fija el número de temas en ocho y vuelve a ajustar el modelo con este dataset mayor.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)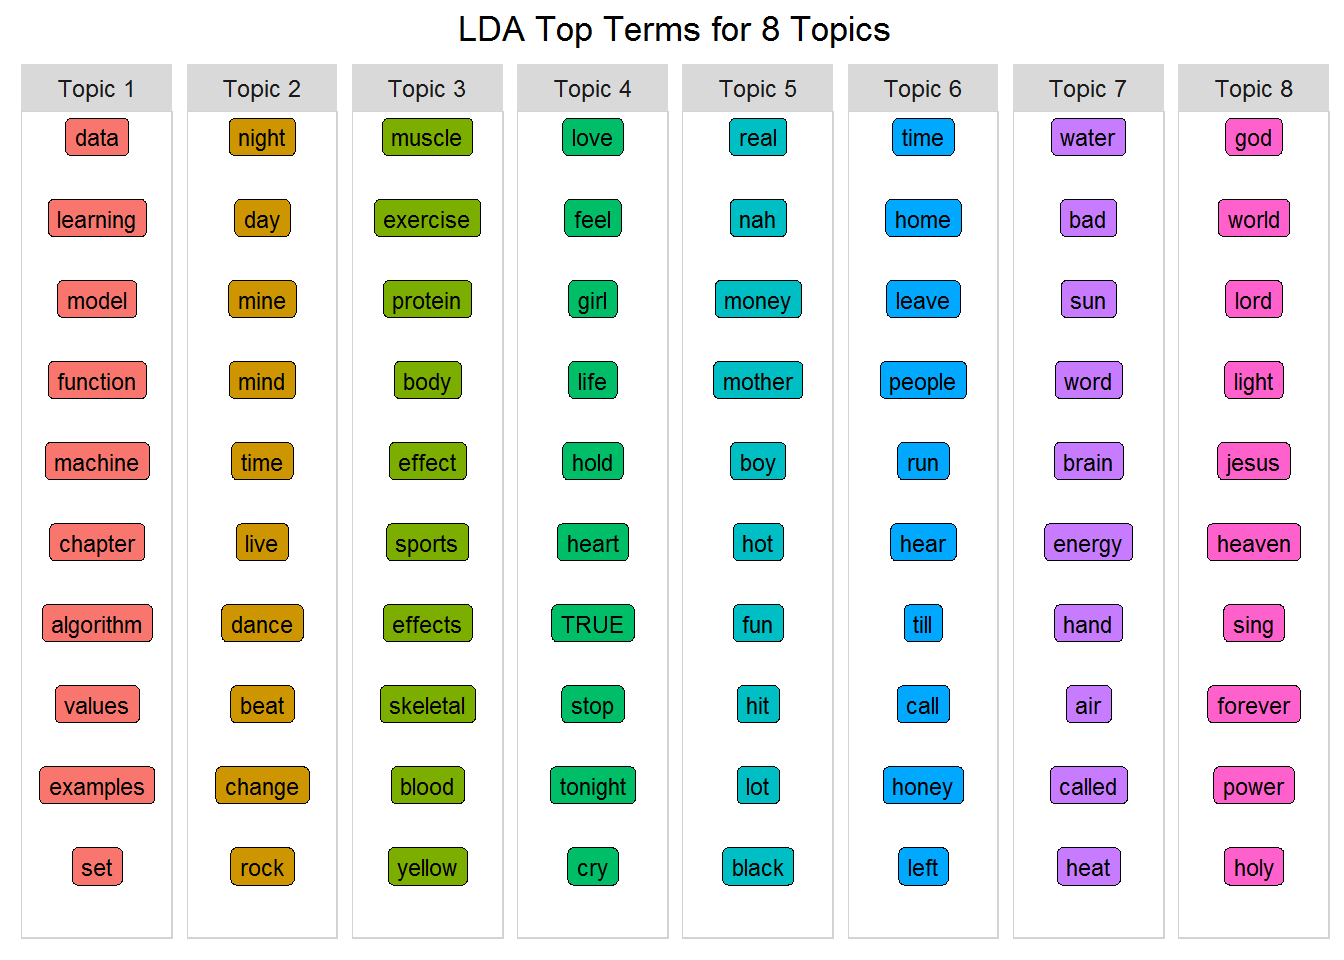
Sin condicionar tu opinión: ¡wow! Dado el input de este modelo, ¿ves los temas? Mira cada tema e intenta asociarlo con los ocho géneros conocidos. Algunos costarán más, otros serán bastante obvios. Por ejemplo, posibles interpretaciones:
Recuerda el concepto de membresía mixta: no son conjuntos disjuntos, pero me sorprendió ver resultados tan nítidos. Nota: LDA acepta más parámetros de los que hemos usado y puedes afinar aún más.
Ahora viene lo interesante. ¿Cómo facilitar la interpretación de los temas? A menudo es difícil, pero con el dataset adecuado, tu modelo rinde bien. Si el modelo determina a qué tema es más probable que pertenezca cada documento, puedes empezar a agrupar autores. Y como en tu caso conoces el género de un autor, puedes validar —hasta cierto punto— tus resultados. El primer paso es clasificar cada documento.
Recuerda: cada documento contiene múltiples temas con distintos porcentajes (gamma). Algunos encajan mejor que otros. Este gráfico muestra el gamma medio de documentos de cada fuente por tema. Es el mismo enfoque que antes con tres autores, salvo que ahora miramos el campo de género. Es una forma fantástica de mostrar la relación entre géneros y temas.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")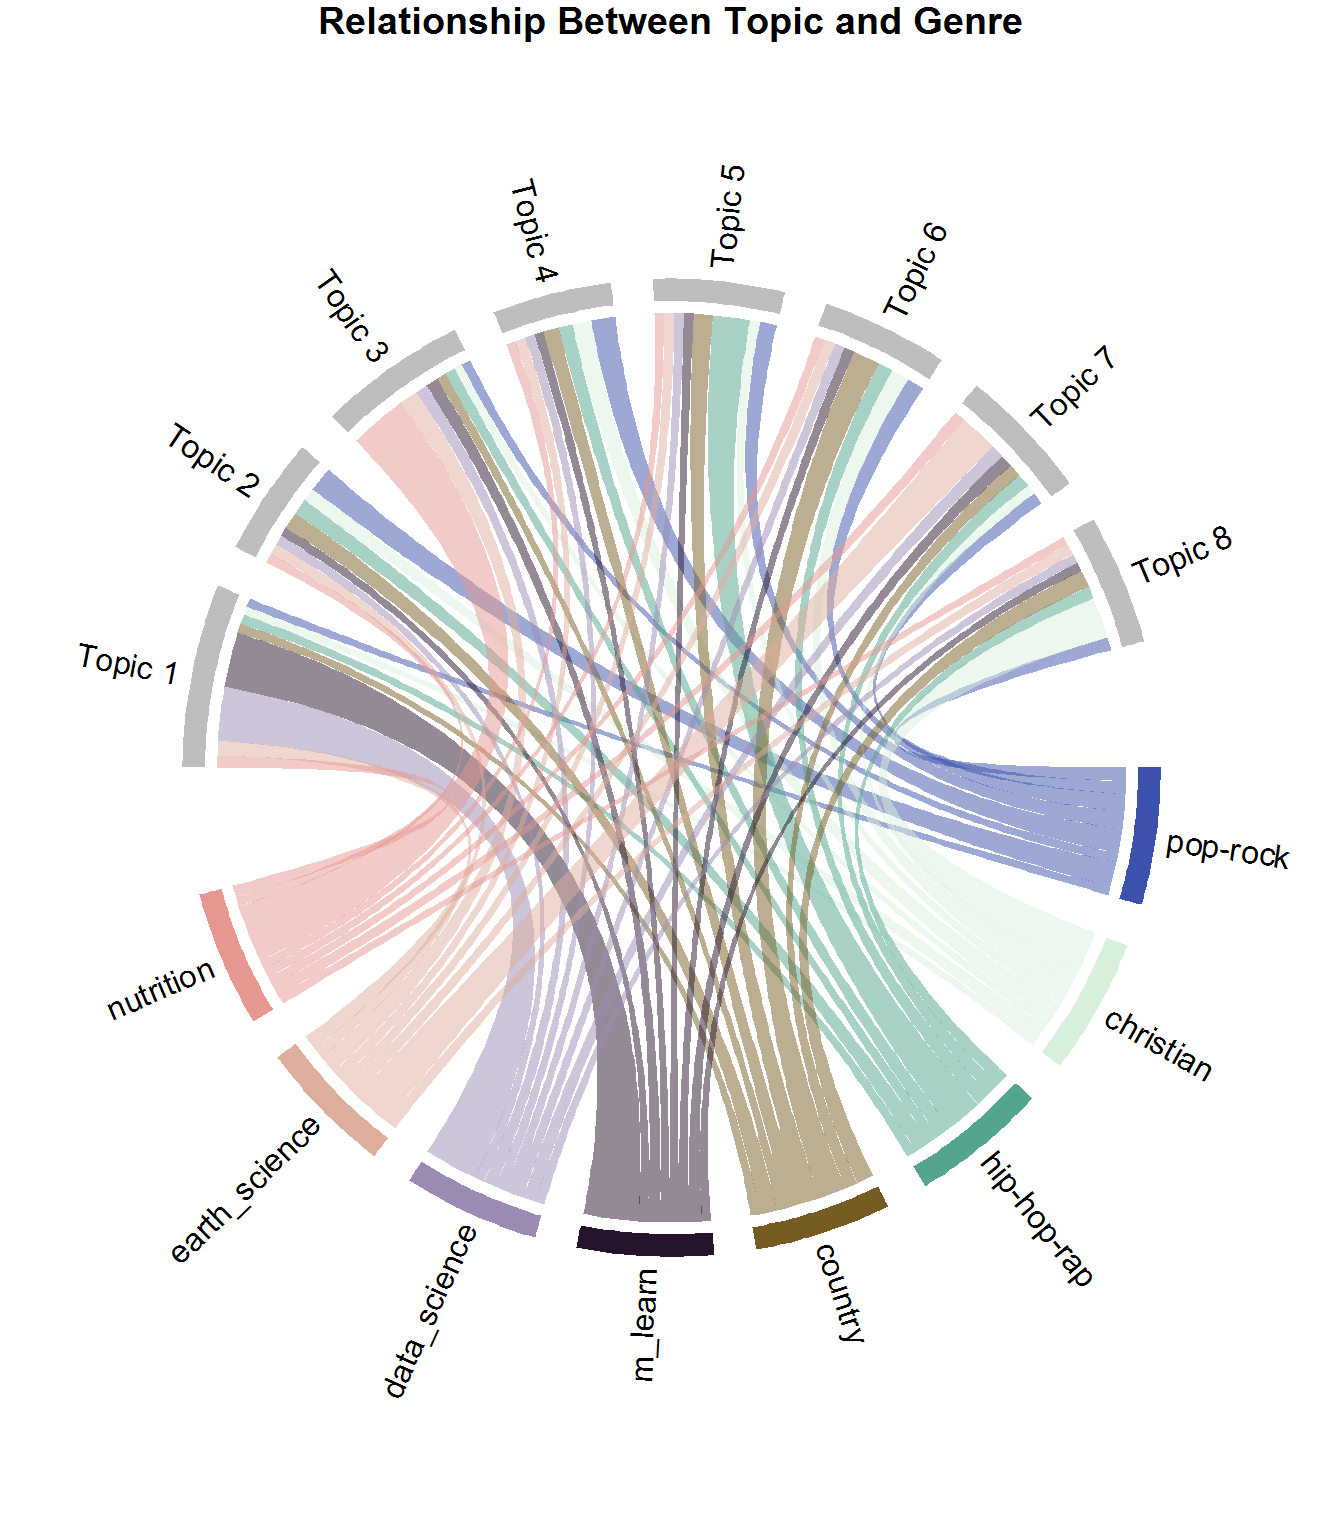
Cada acorde (enlace) representa el gamma medio de documentos por género que pertenecen a un tema. Si miras sports_nutrition, verás que el acorde al tema 3 es mayor que los demás: más páginas de nutrición deportiva caen ahí. Claramente, la mayoría de páginas de Machine Learning y Data Science caen en el tema 1; la mayoría de documentos de Earth Science, en el tema 7, y, como cabría esperar, Pop-Rock se reparte bien entre varios temas (tiene sentido: pop es un género amplio). Rap-Hip-Hop, en cambio, se concentra más en el tema 5. ¿Qué puedes hacer con esto? ¡Recomendar a oyentes según contenido temático!
Por supuesto, el contenido de las letras no tiene por qué ser la única característica en un recomendador; puede combinarse con metadatos como ritmo, instrumentación, tempo, etc., para una mejor experiencia.
Ahora que ves la relación entre documentos y temas, agrupa por source (autor) y tema y calcula la suma de gamma por grupo. Luego selecciona el autor con mayor topic_sum por tema con top_n(1). Como querrás hacer lo mismo por género, crea una función top_items_per_topic() y pasa source como tipo. Así podrás llamarla de nuevo para clasificar por género.
Este es el momento clave en el que mapeas el autor a un tema específico. ¿Qué esperas que ocurra?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")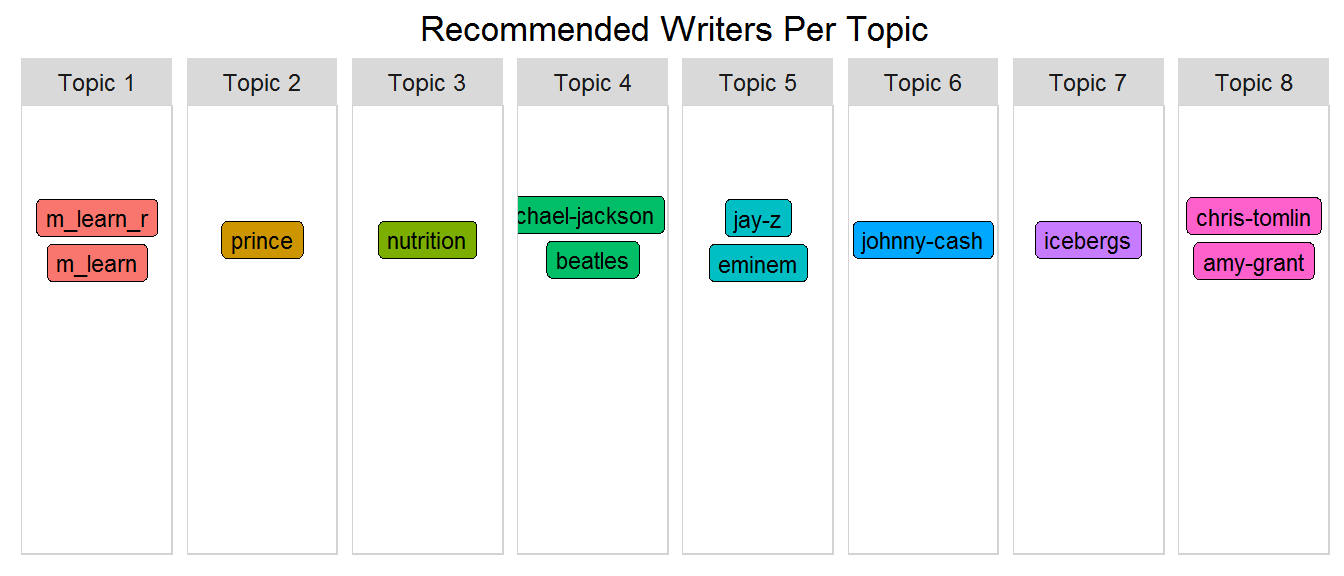
¡Emocionante! Pero, como puede que no conozcas bien a los artistas, lo aclararé reemplazando autor por género. Prepárate...
top_items_per_topic(lda, source_tidy, "genre")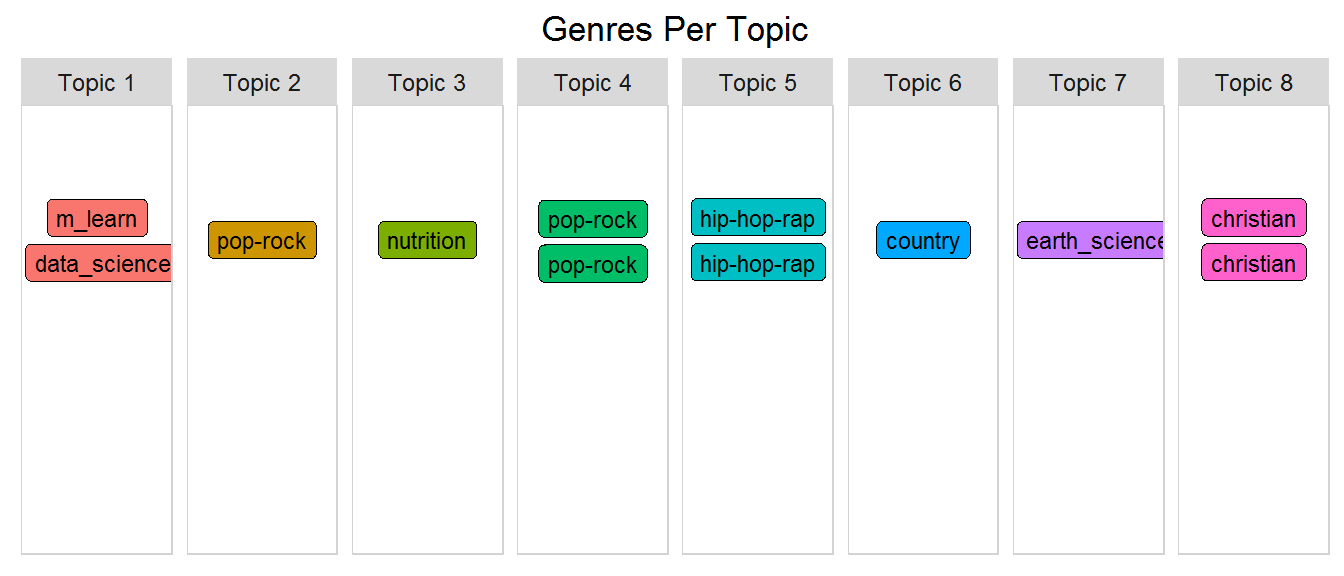
Los artistas de hip-hop/rap se agrupan; los cristianos también; dos de los de pop-rock van juntos y cada libro tiene su propio tema. Es impresionante que el aprendizaje no supervisado produzca algo así (reconocer géneros) solo con texto. ¿Qué pasaría si eliges otro número de temas? ¿Qué géneros combinaría o separaría? Pruébalo. De momento, el siguiente modelo se centra en el dataset de Prince que usaste antes.
Para este modelo, usarás tu dataset con canciones de Prince. Aunque hay temas distintos en las letras, a menudo una sola canción trata más de un tema. Con un solo artista, tus temas estarán más mezclados y menos disjuntos. La interpretación es crítica. En vez de usar los datos brutos de las letras de Prince, usarás una versión ligeramente modificada como se describe abajo.
Antes usabas las palabras tal cual aparecen. Ahora emplearás una versión anotada generada con el potente paquete de PLN cleanNLP. Este paquete ofrece un modelo tidy para PLN con tareas de anotación como tokenización, etiquetado gramatical, reconocimiento de entidades, enlace de entidades, análisis de sentimiento y mucho más. Este proceso se realizó fuera del tutorial, pero te proporciono lo necesario para el modelado de temas.
En el dataset anotado hay una fila por cada palabra del corpus de letras de Prince con información importante de cada palabra.
Observa el objeto tokenizado revisando los nombres de campos.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Por ahora, solo usarás dos piezas de información:
El campo word es la palabra original y lemma la forma lematizada. upos es el código gramatical universal. Si llamas a table() sobre upos, verás el recuento de palabras en cada categoría (algunas pueden etiquetarse varias veces).
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Para hacerte una idea del dato, acota a un par de canciones donde la lematización difiera de la palabra original y elimina stopwords.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Esto muestra lo selectivo que puedes ser al elegir qué introducir en tus modelos (palabra, lema o cierta categoría gramatical). Decidir usar lema u original es un juicio. También podrías usar la raíz (stemming), mencionada en la parte dos-A. También puedes cuestionar cómo cleanNLP distingue sustantivos de adjetivos. Te recomiendo probar varias configuraciones hasta dar con la que mejor te funcione.
En este tutorial, modelaremos solo los sustantivos. Para obtener el metadato de Prince (género y año), une prince_annotated con prince_tidy por word y document, y crea la DTM como siempre. He decidido eliminar algunas palabras muy comunes presentes en todos los temas para mantenerlo interesante. (Usar tf-idf, tratado en la parte uno, es otra opción para quitar palabras comunes).
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)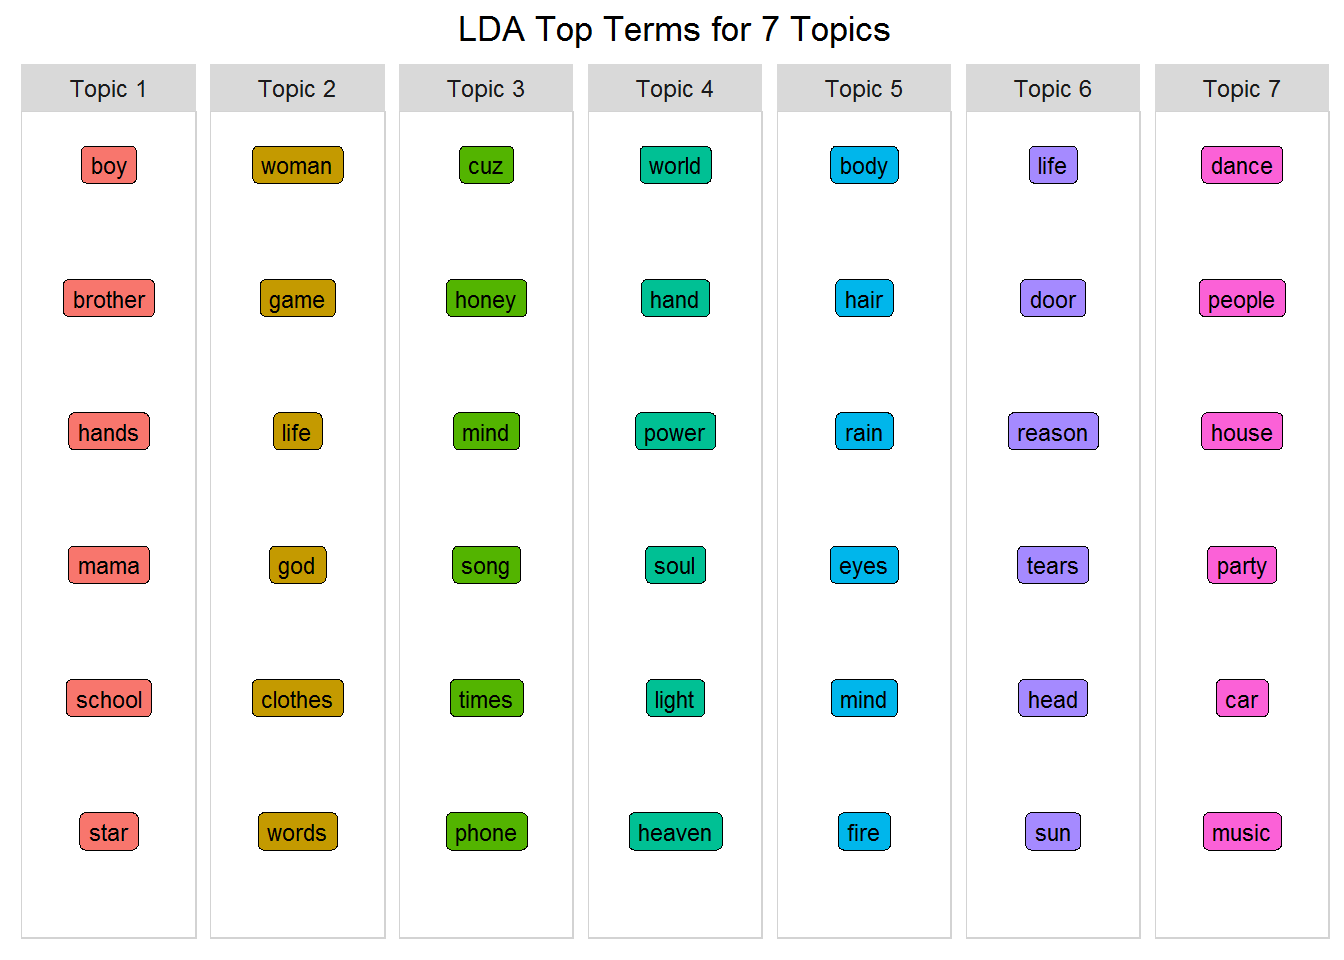
A continuación, verás una lista de temas que a lo largo de los años se han atribuido a la música de Prince. Están asociados a ciertas palabras y, como en todo modelado de temas, hay solapamientos. Observa estos temas manuales (en orden aleatorio) e intenta encontrarlos en tu modelo.
Parece que tu tema 1 trata sobre personas y familia; el tema 7, sobre música, baile y fiesta; y el tema 4, sobre yo, sociedad y religión. La interpretación es subjetiva. En un contexto empresarial, lo ideal es que esta fase la realice una persona experta en la materia. Aquí se ve por qué el PLN está en la intersección entre IA y lingüística computacional.
Prueba con un número distinto de temas, solo verbos, palabra original frente a lema, o cambiando el número de palabras principales, y observa qué insights obtienes. Hay métodos nuevos para estimar el número de temas: mira el concepto de perplejidad aquí, o el paquete
ldatuningaquí.
Como el dataset de Prince contiene año, puedes seguir la evolución de temas. Puedes ser muy creativo; por ahora, mira unas cuantas palabras de dos temas y su frecuencia en el tiempo. El análisis de tendencias daría para un tutorial entero; si te interesa, consulta este recurso.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)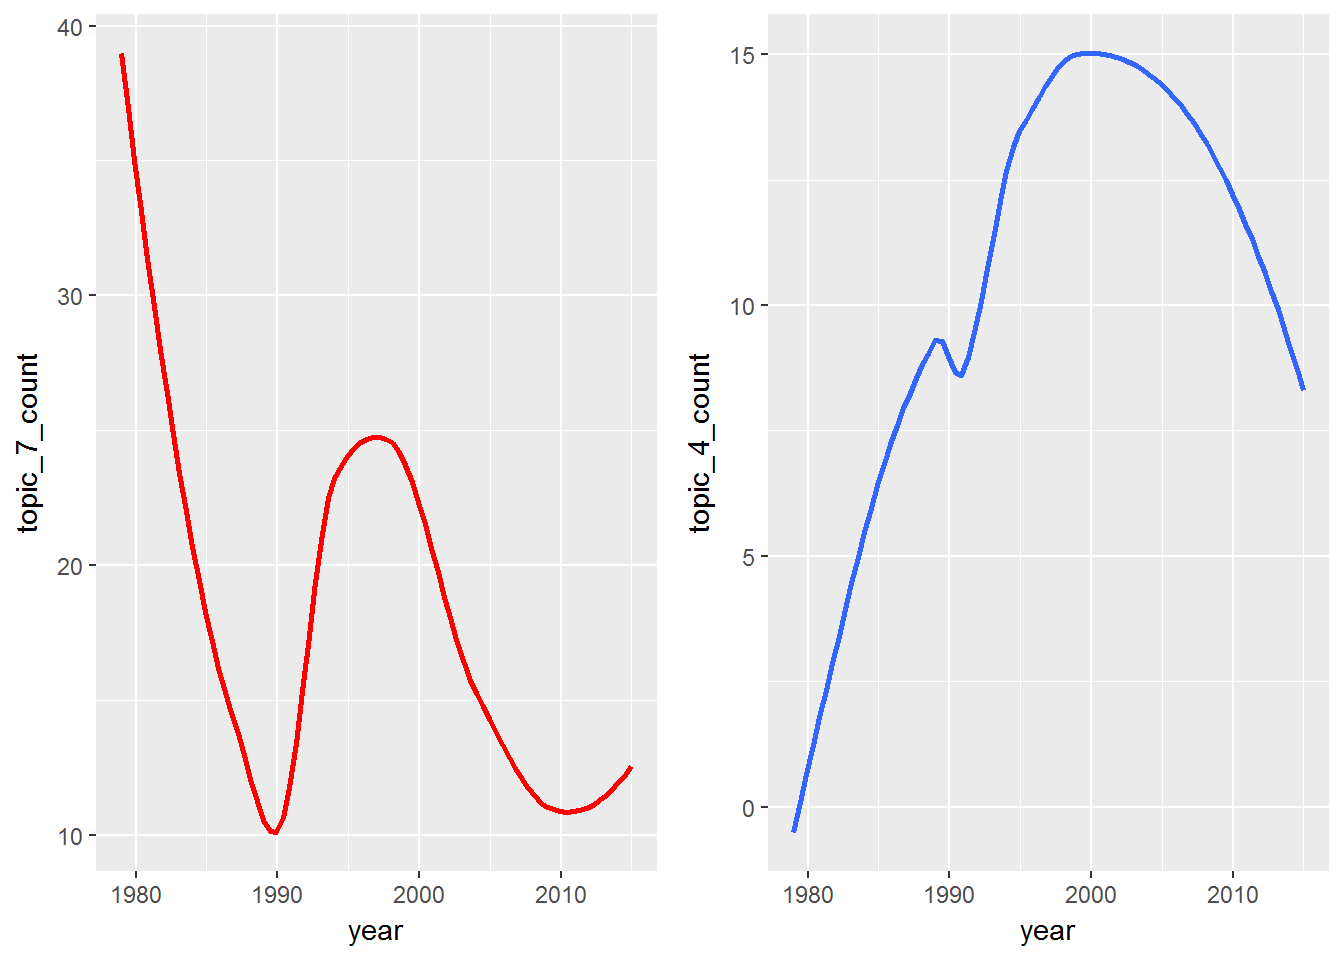
Es un ejemplo muy básico de cómo cambian los temas con el tiempo, pero ¿y si amplías este análisis fuera de la música? Tal vez a tu empresa le interese la correlación entre ventas y tendencias en tuits de clientes sobre tu producto. Hay muchas aplicaciones para entender cómo evolucionan los temas.
Este tutorial solo roza la superficie de lo posible con modelado de temas, PLN y machine learning. Es un campo en auge dentro de la ciencia de datos y seguirá creciendo a medida que más profesionales se adentren en los océanos inexplorados de datos no estructurados. En música, clasificar canciones por letras aparece sobre todo en papers de investigación, así que quizá puedas apoyarte en este trabajo para aportar tu contribución al mundo de la IA.
Has usado datos de letras y libros de no ficción para identificar temas, clasificar documentos en los temas más probables e identificar autores similares por contenido temático. Así, has construido un sistema de recomendación sencillo basado en texto y autores etiquetados.
Ten en cuenta que intentas modelar arte con máquinas. Un artista puede decir "Eres la niña de mis ojos" y no habla de fruta ni de anatomía. Hay que descubrir lo oculto. Cuando escuchas música, no siempre percibes los coros, pero están ahí. Sube tu canción favorita y atiende más allá de la voz principal: te sorprenderá la información escondida. Así que pon la lógica en segundo plano y trae la creatividad al frente en tu exploración.
Como en todos los tutoriales de la serie, te animo a usar los datos aquí como un caso de estudio divertido, pero también como generador de ideas para analizar textos que te interesen: tus artistas favoritos, redes sociales, textos corporativos, científicos o socioeconómicos. ¿Qué aplicaciones ves para el modelado de temas? ¡Déjanos un comentario con tus ideas!
No te pierdas la parte tres (el cuarto artículo) de la serie: Lyric Analysis: Predictive Analytics using Machine Learning with R. Allí usarás letras y metadatos etiquetados para predecir el futuro de una canción. Trabajarás con algoritmos como árboles de decisión, Naive Bayes y más para predecir género, década e incluso si una canción entrará en listas. ¡Te espero!
Advertencias:
Advertencia uno: Solo obtendrás los mismos resultados si ejecutas el código en el mismo orden y con los mismos archivos de datos sin modificar. En caso contrario, las referencias a temas específicos no tendrán sentido.
Advertencia dos: No hay reglas inamovibles; se basa en mi propia investigación. Aunque el modelado de temas existe en aplicaciones reales, no hay mucha actividad desarrollando recomendadores musicales basados únicamente en letras.
Advertencia tres: El modelado de temas es complejo. Construir el modelo es una cosa; interpretar resultados es difícil, subjetivo y complicado de validar por completo (aunque hay investigación en curso: consulta este artículo de Thomas W. Jones). El proceso es no supervisado, generativo, iterativo y basado en probabilidades. Los temas son sutiles, ocultos e implícitos, no explícitos.
Si quieres aprender más sobre machine learning con R, echa un vistazo a nuestro tutorial para principiantes. Además, haz nuestro curso de introducción al machine learning con R.
Aprende más sobre Machine Learning
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Zoumana Keita
14 min
Tutorial
Eugenia Anello
8 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
10 min