Curso
Entendendo Machine Learning
2 h
308K
Use técnicas de ponta com R, NLP e machine learning para modelar tópicos em textos e construir seu próprio sistema de recomendação musical!
Este é o Parte Dois-B de uma série de três tutoriais em que você continuará usando R para realizar diversas tarefas analíticas em um estudo de caso com letras do lendário artista Prince, além de outros artistas e autores. Os três tutoriais cobrem o seguinte:
Imagine que você é um cientista de dados na NASA. Pedem para você monitorar duas naves destinadas a órbitas lunares, que vão estudar as interações da lua com o sol. Como em qualquer espaçonave, podem ocorrer problemas capturados durante testes ou após o lançamento. Essas anomalias são documentadas em linguagem natural em quase 20.000 relatórios de problemas. Seu trabalho é identificar os tópicos mais recorrentes e temas em alta nesse corpus e fornecer análises prescritivas para engenheiros e diretores de programa, impactando o futuro da exploração espacial.
Este é um cenário real e deve dar uma ideia do poder que você terá ao aprender técnicas de ponta como topic modeling com machine learning, Processamento de Linguagem Natural (NLP) e programação em R. Felizmente, você não precisa trabalhar na NASA para fazer algo tão inovador. Neste tutorial, sua missão — caso aceite — é aprender sobre topic modeling e como construir um sistema simples de recomendação (recommender) usando letras de músicas e livros de não ficção.
Só por diversão!
Não tem a ver com topic modeling, mas, para se divertir, use um pacote incrível chamado circlize, apresentado no tutorial anterior, para ativar os fotorreceptores e curtir este diagrama circular com todas as fontes que você vai usar aqui.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)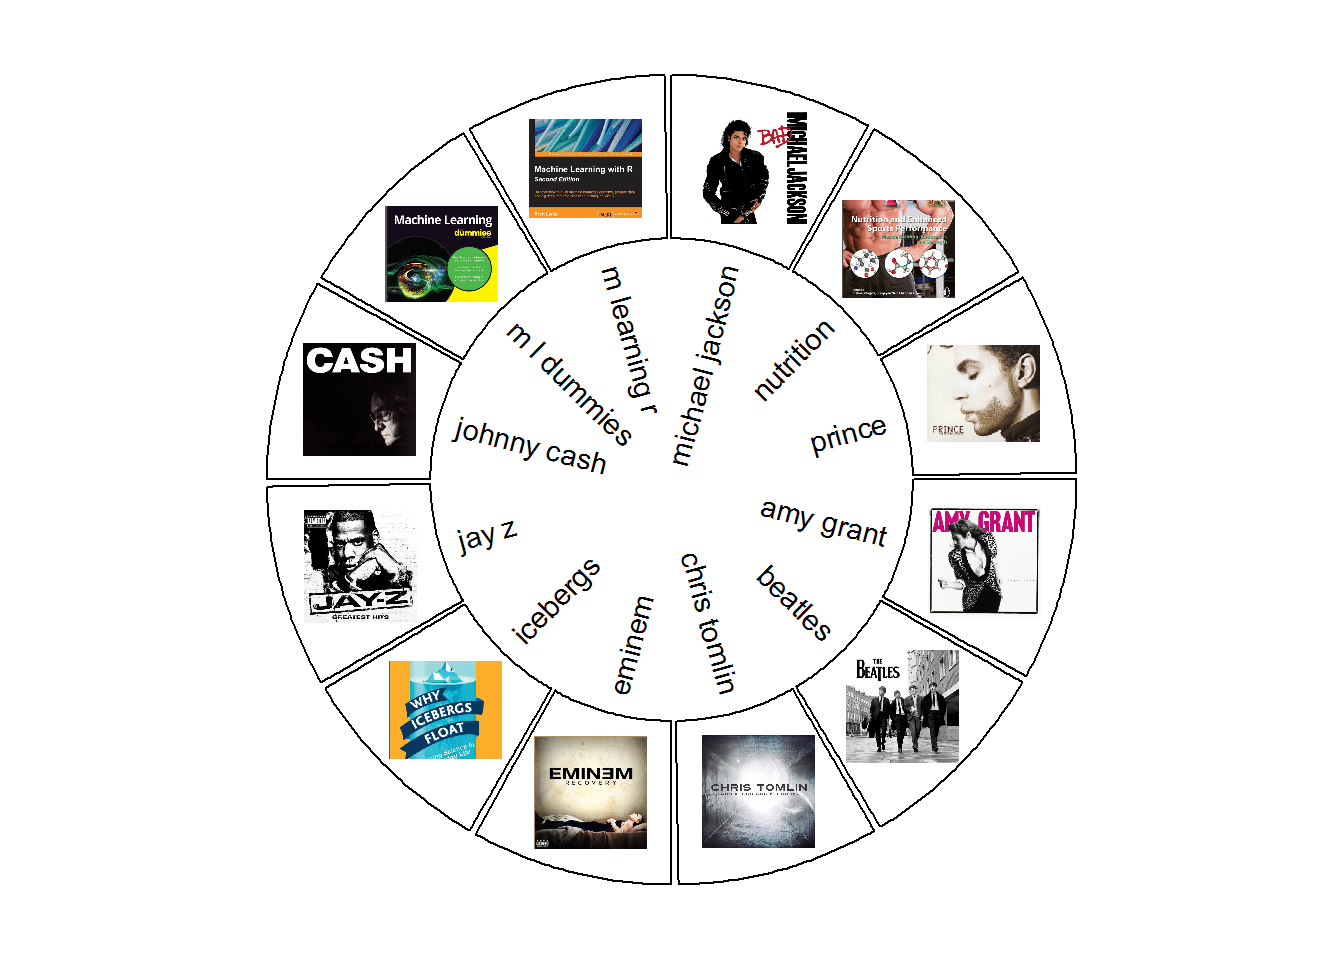
Nos tutoriais anteriores, você analisou o conteúdo das letras de Prince usando frequência de palavras, a estatística tf-idf e sentiment analysis. Dá para ir mais fundo em letras e outros textos usando o conceito de topic modeling.
Neste tutorial, você vai construir quatro modelos usando os algoritmos de machine learning Latent Dirichlet Allocation (LDA) e K-Means. Os algoritmos serão explicados mais adiante.
O Modelo Um usa textos das letras de Prince combinados com dois livros de não ficção. O objetivo é dar um exemplo simples de uso de LDA, um algoritmo não supervisionado, para gerar conjuntos de palavras que, em conjunto, sugerem temas. Esses temas não têm rótulos e exigem interpretação humana. Depois de identificar um número predefinido de temas, você vai pegar os resultados do modelo e classificar cada música ou página de livro em cada categoria. Uma música pode conter todos os tópicos gerados, mas se encaixar melhor em um do que em outro. Isso é chamado de classificação de documentos; como você conhece o autor do documento, essencialmente está classificando escritores em agrupamentos temáticos.
O Modelo Dois usa o dataset do Modelo Um e faz um teste rápido de geração de temas com outro algoritmo, k-means, mostrando por que ele pode não ser a melhor escolha para topic modeling.
Usando novamente LDA, o Modelo Três trabalha com um dataset maior, com vários artistas de gêneros diferentes e mais autores. Ao classificar a maioria dos documentos de um autor/artista em seu tópico mais provável, você passa a agrupar escritores com composições temáticas semelhantes. Com um bom modelo, gêneros parecidos devem aparecer no mesmo agrupamento de tópicos. Por exemplo, artistas de rap em um tópico, e dois livros de assunto semelhante juntos em outro. Assim, você pode recomendar escritores semelhantes! Os escritores e seus gêneros são conhecidos, mas os tópicos não — logo, é não supervisionado.
O Modelo Quatro usa LDA apenas nas letras de Prince. Desta vez você usará um dataset anotado, gerado fora deste tutorial, com cada palavra etiquetada com sua classe gramatical (substantivo, verbo etc.) e sua forma raiz (lematizada). Você também vai observar como um tópico muda ao longo do tempo.
NLP e machine learning são subáreas da inteligência artificial. Há tentativas recentes de usar IA para compor músicas. Não é o objetivo aqui, mas é um exemplo de IA como arte. Afinal, as três primeiras letras são A-R-T! Compare IA com composição: dá para seguir um padrão e criar a estrutura (verso, refrão, verso etc.), mas o que torna a música ótima é a criatividade do compositor. Neste tutorial, você vai exercitar habilidades técnicas para construir modelos e também sua criatividade para interpretar e explicar os resultados.
Pense assim: se topic modeling é arte, então a letra é o código, a composição é o algo-ritmo e a música é o modelo! Qual é a sua analogia?
Sistemas de recomendação típicos não se baseiam só em texto. A Netflix, por exemplo, recomenda filmes com base em escolhas anteriores e metadados associados. A Pandora segue outra abordagem e se apoia em um Music Genome com 400 atributos musicais — melodia, ritmo, composição e resumos de letras, entre outros; porém, esse genome começou em 2000 e levou cinco anos e 30 especialistas em teoria musical para ser concluído. Há muitos artigos científicos sobre recomendação de filmes com base em resumos de enredo. Exemplos de recomendação musical baseada no conteúdo lírico mesmo são mais raros. Quer tentar?
A Parte Dois-B exige noções básicas de tidy data — especialmente pacotes como dplyr e ggplot2. Prática com text mining usando tidytext também é recomendada, como visto nos tutoriais anteriores. Você também precisará estar familiarizado com funções em R, pois vai reutilizar código em cada modelo. Para focar nos insights, incluí código pronto para usar no seu próprio dataset; explicações detalhadas podem exigir investigação adicional da sua parte.
O que você pode fazer com topic modeling? Talvez existam documentos com informações críticas para o seu negócio que você poderia minerar. Talvez dê para coletar dados do Twitter e descobrir o que estão dizendo sobre os produtos da sua empresa. Talvez você crie seu próprio sistema de classificação para enviar documentos certos aos departamentos certos para análise. Há um mundo de possibilidades para explorar! Vá em frente!
Algumas aplicações de topic modeling:
Os únicos pacotes novos em relação à Parte Um e à Parte Dois-A são topicmodels, tm e plotly. Você usará a função LDA() de topicmodels, que permite aos modelos aprenderem a distinguir documentos. O pacote tm é para text mining — aqui usamos apenas inspect() para ver a estrutura de uma matriz documento-termo; explicarei depois. plotly será usado uma vez para criar uma versão interativa de um gráfico ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
As funções abaixo foram definidas nos tutoriais anteriores, com exceção de word_chart(); no entanto, o conteúdo e a descrição de word_chart() também estão nesta Parte Dois-B. O principal é saber que ela usa ggplot() de um jeito criativo para gerar um visual baseado em palavras, não em pontos.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Para evidenciar o poder do topic modeling e da classificação, além das letras de Prince usadas antes, você também trabalhará com outros artistas de gêneros diferentes reconhecidos nas paradas da Billboard. Além disso, incluí alguns livros sobre temas variados, como nutrição esportiva, icebergs e até machine learning! Com um dataset diverso, você consegue classificar documentos em tópicos relacionados e diferenciar artistas/autores semelhantes.
Dica: vou me referir a músicas e páginas de livros como documentos, e a músicos/autores como escritores. No código, você verá a palavra source (fonte). Ela indica de qual escritor vem o dado. Uso gênero para o gênero musical e também a categoria do livro. Em vez do nome do autor do livro, usei o título da obra, para ficar mais claro. Isso fará sentido conforme você avança.
Para focar na modelagem, fiz a preparação dos dados fora deste tutorial e disponibilizei tudo que você precisa nestes três arquivos, já com os seguintes tratamentos aplicados:
pdf_text() do pacote pdftools para coletar o conteúdo de quatro livros (cada página é um documento distinto)tidytext descrito na Parte UmVocê terá três datasets distintos para trabalhar neste tutorial:
three_sources_tidy_balanced: letras de Prince e dois livrosall_sources_tidy_balanced: letras de oito artistas e quatro livrosprince_tidy: apenas letras de PrinceTambém incluí um dataset anotado das letras de Prince. Explicarei o que é anotado no Modelo Quatro.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)O objetivo do topic modeling é encontrar termos tematicamente relacionados (tópicos) em dados textuais não estruturados, medidos como padrões de coocorrência de palavras. Os componentes básicos são documentos, termos e tópicos. Latent Dirichlet Allocation (LDA) é um método não supervisionado que descobre diferentes tópicos subjacentes a uma coleção de documentos, onde cada documento é um conjunto de palavras. LDA assume que:
O LDA busca grupos de palavras relacionadas. É um algoritmo gerativo e iterativo. Dois passos principais:
A ideia é: palavras de um tópico tendem a aparecer juntas em documentos. Ele modela cada documento como mistura de tópicos e cada tópico como mistura de palavras (modelo de membros mistos). Depois, você pode usar a probabilidade de um documento pertencer a um tópico para classificá-lo. Como você conhece o autor do documento, dá para recomendar artistas/autores com estruturas temáticas semelhantes. Vamos ao exemplo.
Neste modelo, você usará o dataset com três escritores (sources) distintos e buscará tópicos ocultos. Para evidenciar o poder do topic modeling, as três fontes escolhidas são bem diferentes — intuitivamente, cobrem três temas. Assim, você dirá ao modelo para criar três tópicos e verá o quão bem ele se sai. Primeiro, examine o dataset usando sua função my_kable_styling() junto com color_bar() e color_tile() do pacote formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
Aqui você usará letras do Prince, o livro "Machine Learning For Dummies" e o livro "Why Icebergs Float", cada um com mais de 30 mil palavras (não distintas).
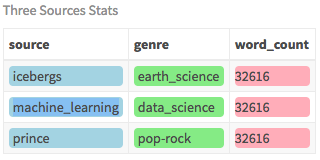
Como você tem um dataset tidy e balanceado com letras do Prince e dois livros, primeiro crie uma matriz documento-termo (DTM) em que cada linha é um documento e cada coluna é um termo. Esse formato é exigido pelo LDA. Um documento é uma música nas letras e um número de página nos livros. Conte as palavras por documento e passe para a função cast_dtm() do tidytext, onde document é o campo com o nome do documento e word é o campo com o termo. Outros parâmetros são possíveis, mas esses dois são obrigatórios.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Isso mostra quantos documentos e termos você tem e que a matriz é bem esparsa — ou seja, contém majoritariamente campos vazios. Pelo vasto vocabulário possível, poucos termos aparecem em cada documento individual.
Se você inspecionar algumas linhas e colunas da DTM com inspect() do pacote tm, verá que cada linha é um documento e cada coluna é um termo. (Use str() se quiser ver a estrutura.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Agora que você sabe o que precisa como entrada do modelo, defina duas variáveis que poderá redefinir em cada modelo: source_dtm e source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedVamos à parte divertida: ajustar o modelo. O código é simples, mas é importante entender o que acontece por trás dos panos. Há uma enorme quantidade de material sobre LDA online. Para nosso objetivo, você precisa conhecer quatro parâmetros: a entrada, o número de tópicos, o método de amostragem e a semente (seed).
Como você sabe que o dataset tem três escritores distintos, defina k como 3 e fixe seed para resultados reprodutíveis. Existem outros parâmetros de controle — por isso o formato em list —, mas usaremos só seed por enquanto. O parâmetro method define o algoritmo de amostragem; usaremos GIBBS. O padrão é VEM, mas, pela minha experiência, o GIBBS tende a performar melhor.
Resumidamente, a amostragem GIBBS realiza um random walk que começa em um ponto (por padrão, 0) e a cada passo se move mais ou menos um com probabilidade igual. Para uma descrição detalhada, leia aqui.
Observação: passei rapidamente pelos detalhes do LDA. Embora você não precise dominar a teoria estatística para usar o método, recomendo este documento do Ethen Liu com uma explicação sólida.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Vemos que foi criado um objeto LDA_Gibbs com três tópicos. Não rodei str(lda) aqui por ser muito verboso, mas faça por conta própria para ver o conteúdo.
O próximo passo é abrir o objeto e ver os resultados. Use tidy() para pôr tudo em um formato fácil de entender. Passe o objeto LDA e beta no argumento matrix. Com beta, você obtém as probabilidades por tópico por palavra. No exemplo a seguir, com o termo iceberg, vemos a probabilidade dessa palavra em cada tópico. Iceberg tem maior probabilidade em Topic 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Para entender o modelo, você precisa ver os termos de cada tópico. Construa uma função que deixe o LDA em formato tidy e extraia os termos de maior beta por tópico. Dentro dela, use word_chart() para gerar uma boa visualização dos três tópicos e suas palavras de topo. Defina num_words como 10 neste exemplo — experimente outros valores para novas perspectivas.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)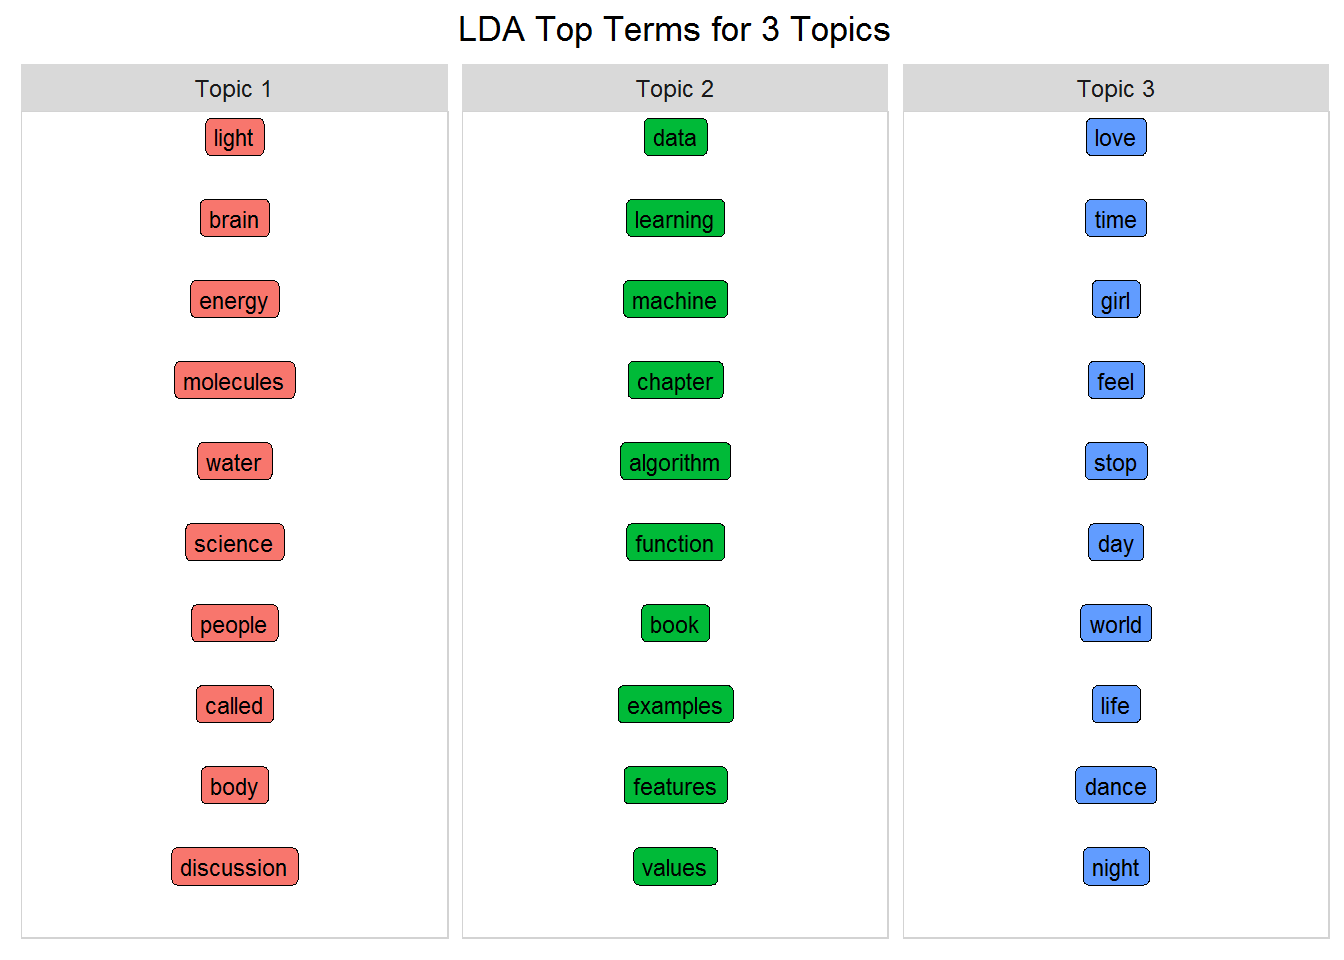
Aprendizado não supervisionado sempre requer interpretação humana... mas estes tópicos refletem claramente as três fontes: Icebergs, Machine Learning e Prince! Simples, mas surpreendente quando pensamos nas possibilidades.
Além de estimar cada tópico como mistura de palavras, o LDA também modela cada documento como mistura de tópicos. Desta vez, ao usar tidy, passe matrix = "gamma" para obter as probabilidades por documento por tópico. Por exemplo, veja a música 1999 do Prince. Assim como uma palavra pode estar associada a vários tópicos, o mesmo vale para documentos — o conceito de membros mistos. Abaixo vemos que 1999 tem maior probabilidade no Topic 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661Esta música pertence a todos os tópicos, mas em proporções diferentes, representadas por gamma. Alguns documentos se encaixam melhor em certos tópicos. Como visto, 1999 tem gamma mais alto no Topic 3.
Para clarear o entendimento do LDA, veja este gráfico circular. Ele mostra a porcentagem de documentos de cada fonte que pertence a cada tópico. Para criá-lo, junte o LDA em formato tidy com source_tidy para recuperar a source (escritor), fazendo join por document. Depois, com o agrupamento correto, obtenha a média de gamma por fonte e por tópico. Assim, você vê, para cada fonte, em qual tópico cai a maioria dos documentos.
Dedique um momento para analisar, caso não esteja familiarizado com gráficos circulares. (Confira a Parte Dois-A para praticar com chordDiagrams() do pacote circlize. Tudo que você precisa saber está neste livro do Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")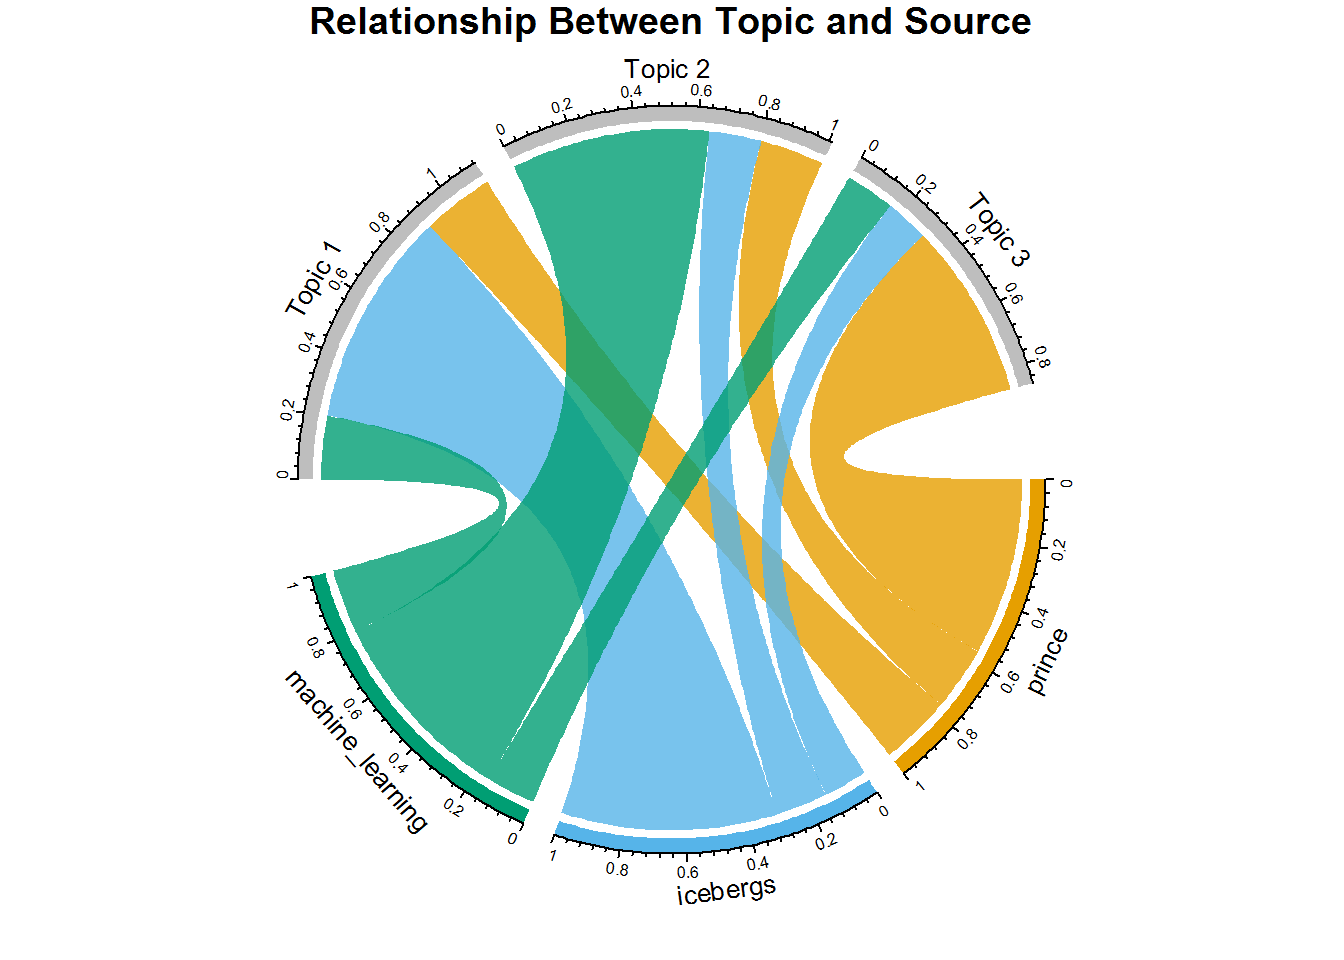
É interessante ver que, embora documentos de cada fonte apareçam em todos os tópicos, cada fonte tem maioria clara em um tópico específico. Por exemplo, as músicas do Prince se associam mais ao Topic 3 — o acorde é maior do que os que vão aos tópicos um e dois. O mesmo para Icebergs no Topic 1 e Machine Learning no Topic 2. O padrão fica evidente.
Pensando no que fizemos, você classificou documentos em Tópicos com base na média de gamma por tópico/fonte. Se você sabe o escritor, e que ele escreve principalmente sobre um tópico, pode supor que artistas de gêneros parecidos caiam nos mesmos tópicos — e, portanto, recomendar escritores semelhantes. No dataset maior, vamos colocar isso em prática.
Agora, olhe no nível do documento e veja os top documentos por tópico.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)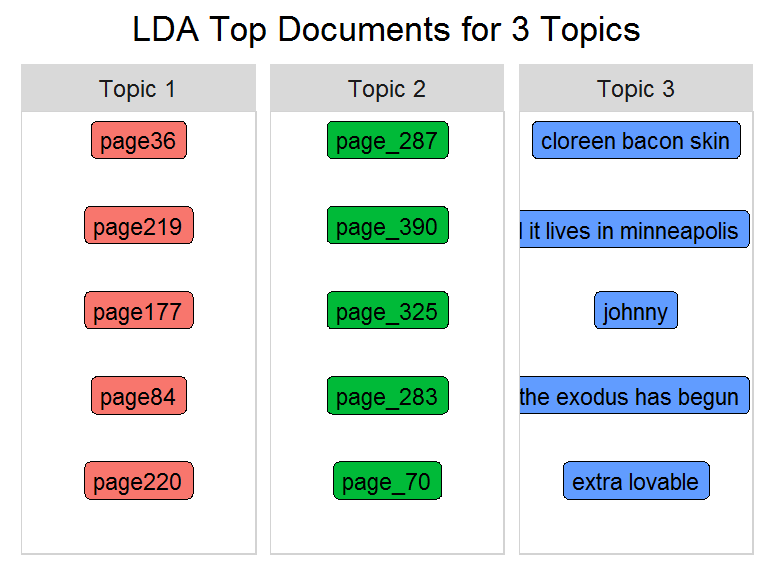
Como você pode não conhecer a nomenclatura dos títulos (p. ex., páginas com sublinhado são do livro de machine learning), vou substituir o nome do documento pela fonte.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)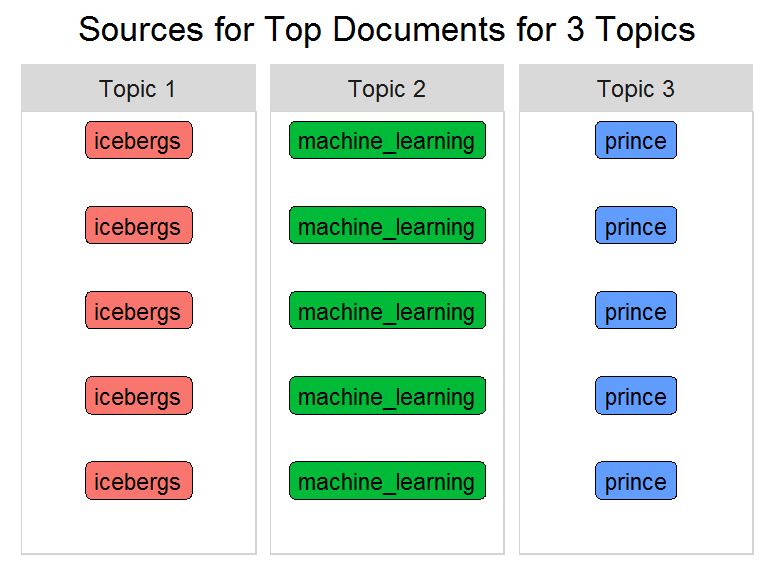
Os documentos principais por tópico, vistos no gráfico anterior, foram substituídos pela respectiva fonte. O seu código classificou bem esses documentos, pois caíram na mesma categoria (ao menos nesses 5 principais)! A grande questão: isso funciona com mais de três fontes? Se os resultados forem consistentes, você pode recomendar escritores com temas semelhantes.
Agora você criará um segundo modelo com outra técnica: o algoritmo k-means. Assim como o LDA, k-means é não supervisionado e exige definir o número de tópicos antes. Diferente do modelo de membros mistos do LDA, k-means particiona os documentos em clusters disjuntos (tópicos). O algoritmo agrupa documentos por uma medida de similaridade, transformando-os em vetores numéricos com pesos por palavra por documento (similar ao tf-idf). Cada documento fica em exatamente um cluster — hard clustering. A saída são clusters e seus documentos. Já o LDA é um soft clustering, em que um ponto pode pertencer a mais de um cluster.
Conceitualmente, para linguagem natural, LDA tende a dar resultados mais realistas que k-means para atribuição de tópicos, pois textos geralmente envolvem mais de um tema. Vamos construir o modelo, inspecionar o objeto k-means e ver se a hipótese se confirma.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"A estrutura do objeto k-means revela dois pontos importantes: clusters e centers. Você pode inspecionar o cluster da música 1999 e o peso da palavra party que aparece nela.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Esses campos mostram que 1999 está em um único cluster (cluster dois) e party aparece nos três clusters, mas pesa mais no cluster um. Agora, veja as palavras principais com base em centers para identificar temas.
Lembre que o dataset tem três fontes: Prince, Icebergs e Machine Learning. Imprima as palavras principais por cluster e compare com a saída do LDA. Será preciso manipular um pouco o formato dos dados para usar word_chart(). Acompanhe o código — aqui o foco está na análise dos termos principais.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)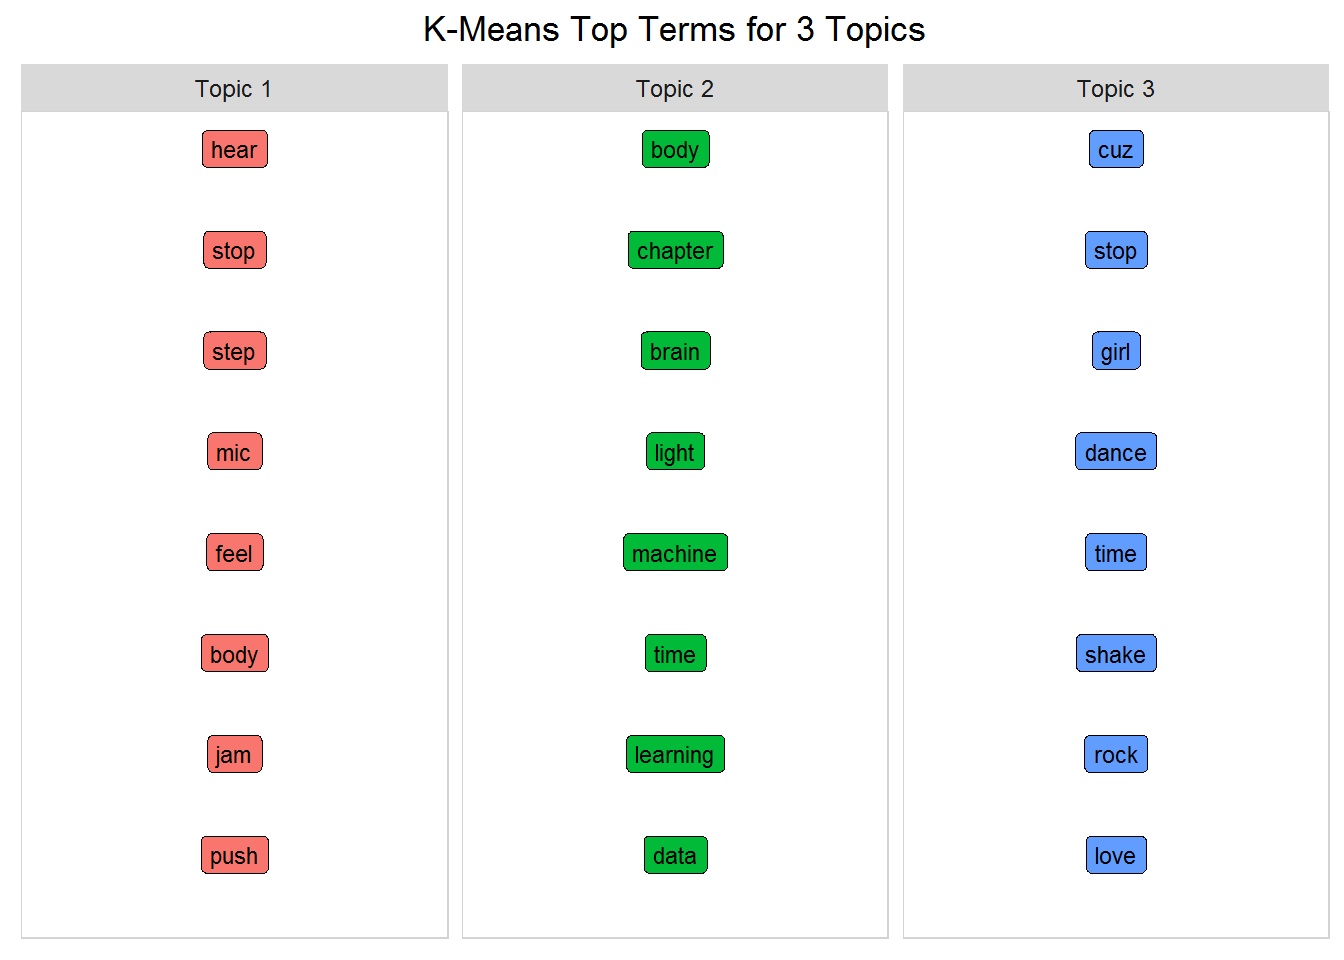
O k-means separa bem livros de músicas: Topics 1 e 3 são claramente temas do Prince, e o Topic 2 combina os dois livros. Porém, ele não distinguiu os dois livros entre si, como o LDA conseguiu. É possível tunar tanto k-means quanto LDA, mas, em uma passada rápida com parâmetros padrão, k-means tende a performar pior, e hard clustering geralmente não é o preferido para topic modeling. (Outra opção é o pacote mallet.)
Agora, aplique LDA ao dataset com 12 fontes/escritores de múltiplos gêneros. O dataset já está balanceado com número semelhante de documentos e palavras por escritor. Visão geral:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")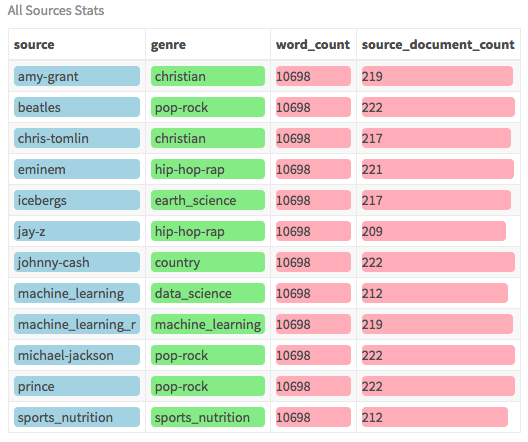
Este dataset traz uma variedade grande — de Prince a Johnny Cash (country) e Eminem (rap) — além de quatro livros distintos. Esses artistas foram escolhidos por serem prolíficos em seus gêneros. O conteúdo foi raspado de um site de letras. Embora haja dois livros de machine learning, um é de ciência de dados geral e outro é mais focado em R. Todos os livros estão disponíveis em PDF (os PDFs brutos não são necessários aqui, pois as versões tidy foram fornecidas).
Um ajuste rápido: algumas descrições de gênero ficam longas nos gráficos, então vamos abreviá-las.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedDesta vez, você tem doze escritores e oito gêneros. A expectativa é que escritores do mesmo gênero fiquem no mesmo tópico — esse é o teste real. Então, defina o número de tópicos como oito e ajuste o modelo com o dataset maior.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)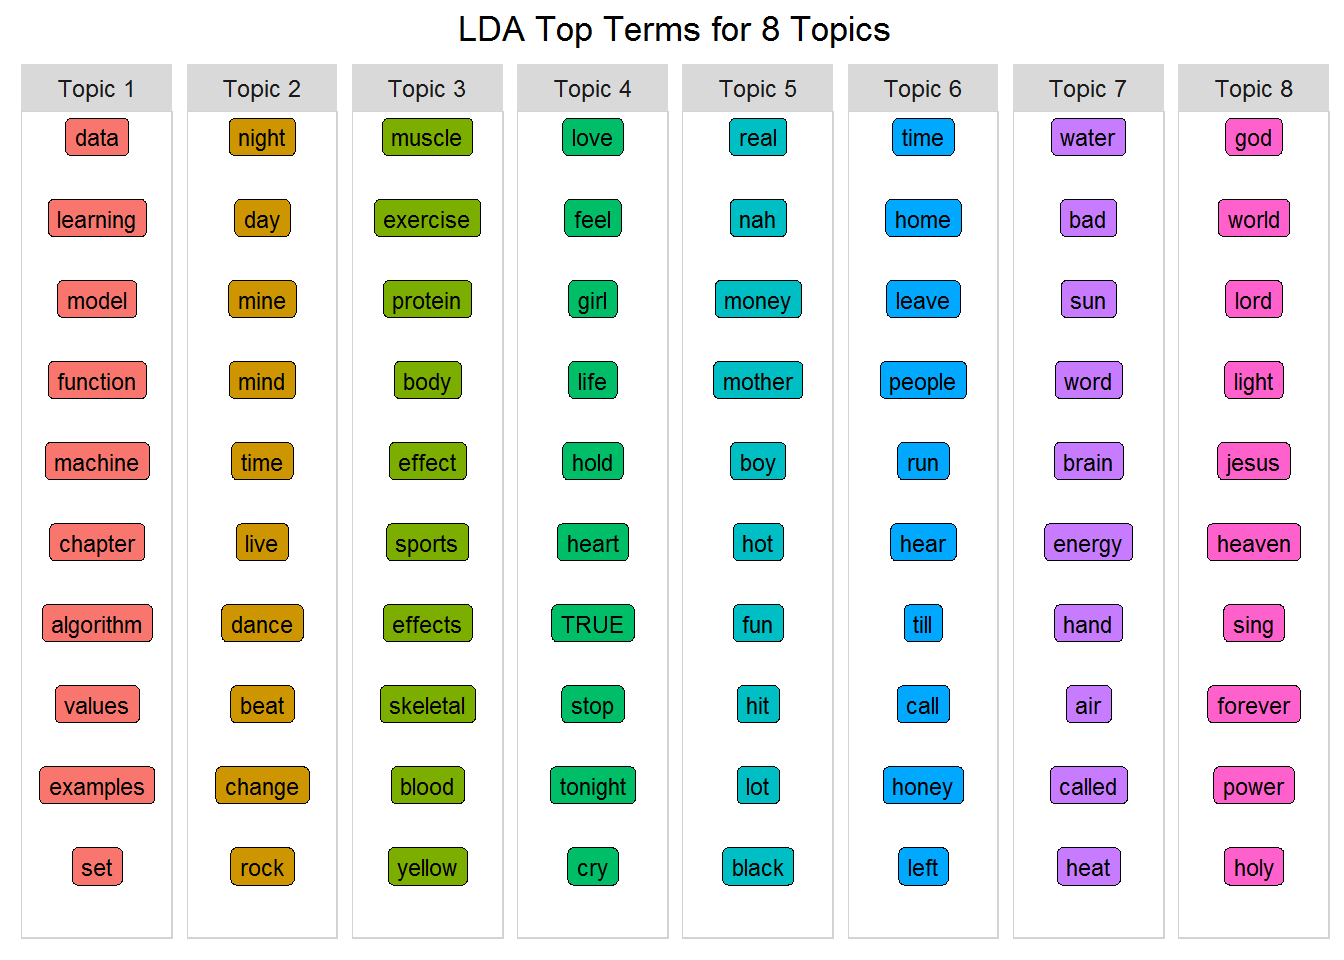
Sem influenciar demais, minha reação foi: "Uau"! Com essa entrada, você enxerga os temas? Olhe cada tópico e tente casar com os oito gêneros. Alguns são difíceis, outros bem óbvios. Por exemplo, possibilidades:
Lembre do conceito de membros mistos — os tópicos não precisam ser totalmente disjuntos —, mas é impressionante ver resultados tão discretos assim. Observação: o LDA aceita mais parâmetros do que usamos aqui, então dá para tunar o modelo e deixá-lo ainda mais forte.
Agora vem a parte empolgante: como facilitar a leitura desses tópicos? Em muitos casos, interpretar é difícil, mas com o dataset certo, o modelo funciona bem. Se o modelo determina em quais tópicos cada documento tende a cair, você começa a agrupar escritores. E como aqui você sabe o gênero de cada escritor, dá para validar — até certo ponto! O primeiro passo é classificar cada documento.
Relembrando: cada documento contém múltiplos tópicos, em porcentagens diferentes representadas por gamma. Alguns se encaixam melhor em certos tópicos. O gráfico mostra a média de gamma dos documentos de cada fonte para cada tópico. É a mesma abordagem usada com três escritores, mas agora olhando para o campo de gênero. É uma forma fantástica de mostrar a relação entre gêneros e tópicos.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")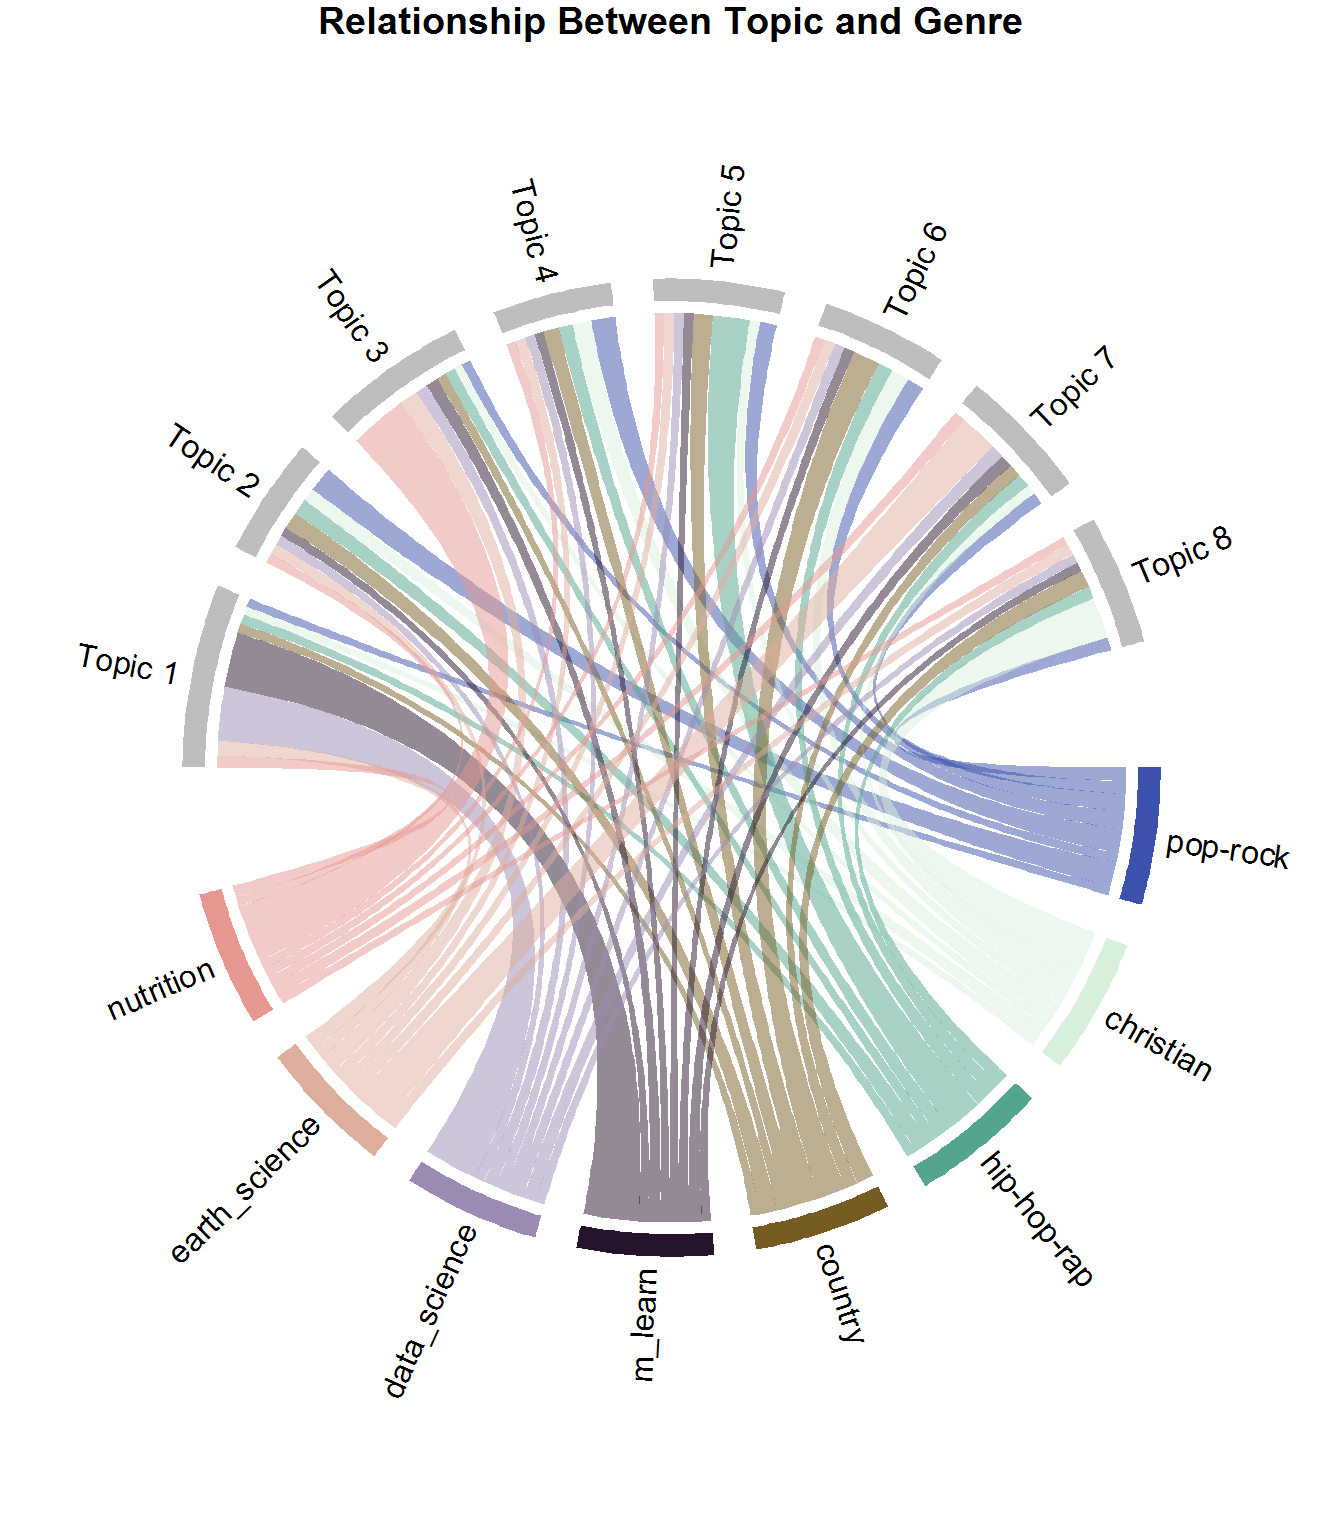
Cada acorde (link) representa a média de gamma dos documentos por gênero que pertencem a um tópico. Em sports_nutrition, o acorde para o Topic 3 é maior — mais páginas caem nesse tópico. Claramente, a maioria das páginas de Machine Learning e Data Science vão para o Topic 1; a maioria de Earth Science, para o Topic 7; e, como esperado, Pop-Rock se divide bem entre múltiplos tópicos. Faz sentido: Pop é um gênero amplo. Já Rap/Hip-Hop tende ao Topic 5. E o que fazer com isso? Você pode recomendar músicas a ouvintes com base no conteúdo temático!
Claro, o conteúdo lírico não precisa ser o único atributo de um sistema de recomendação; combine com metadados como ritmo, instrumentação, tempo etc. para uma experiência melhor.
Agora que você viu a relação entre documentos e tópicos, agrupe por source (escritor) e tópico e some os valores de gamma por grupo. Depois, selecione o escritor com maior topic_sum em cada tópico usando top_n(1). Como você vai querer fazer o mesmo por gênero, crie a função top_items_per_topic() e passe source como tipo. Assim, dá para reutilizar quando classificar por gênero.
Este é o momento crítico em que você mapeia o escritor a um tópico específico. O que você espera que aconteça?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")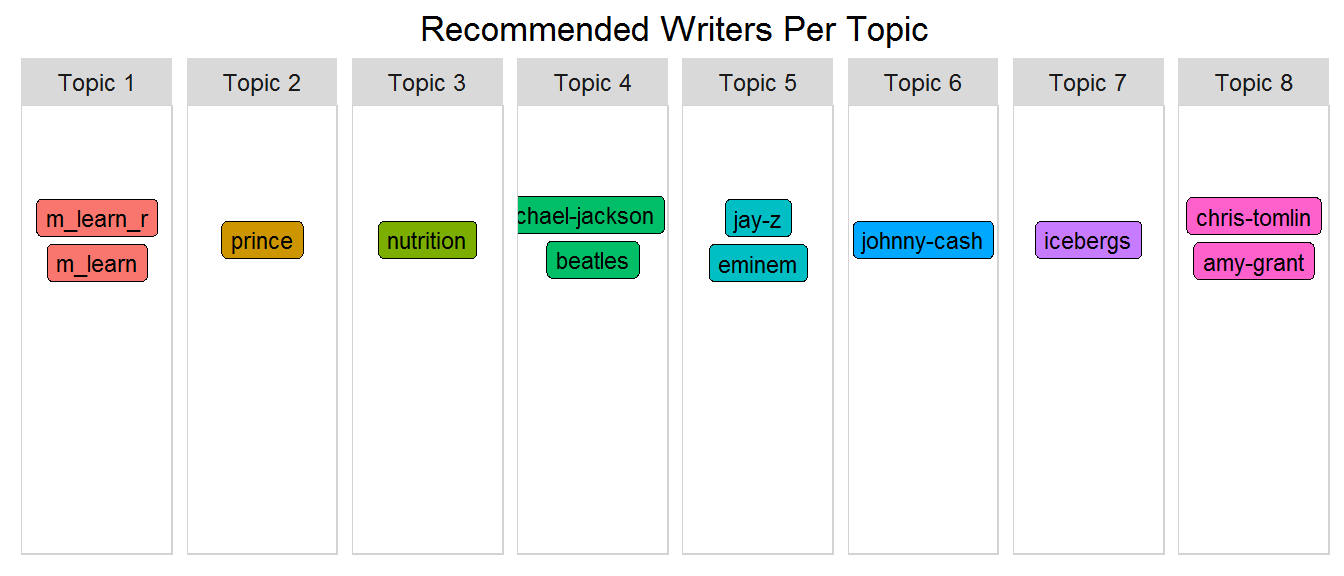
Empolgante! Mas, como você pode não conhecer bem os artistas, vamos clarear substituindo o escritor pelo gênero. Prepare-se…
top_items_per_topic(lda, source_tidy, "genre")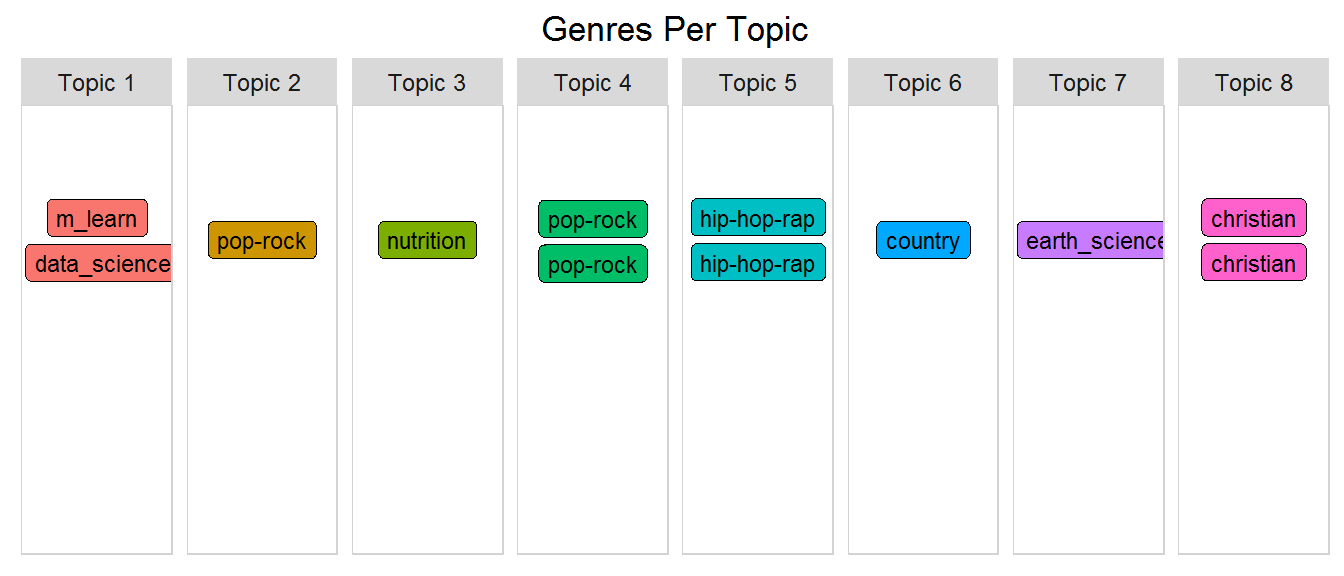
Os artistas de hip-hop/rap ficaram juntos; os artistas cristãos também; dois artistas de pop-rock aparecem juntos; e cada livro tem seu próprio tópico! É impressionante ver aprendizado não supervisionado reconhecer gêneros usando apenas texto. O que acontece se você escolher outro número de tópicos? Quais gêneros seriam combinados ou separados? Vale testar. Agora, o próximo modelo foca no dataset do Prince usado antes.
Aqui, você usará o dataset apenas com músicas do Prince. Embora haja temas distintos, é comum uma única música abordar mais de um. Com um único artista, os tópicos tendem a ser mais mistos e menos disjuntos — interpretação se torna crítica. Em vez dos dados brutos, usaremos uma versão levemente modificada, conforme abaixo.
Antes, você usou as palavras como aparecem no texto. Agora, usará uma forma anotada gerada pelo pacote poderoso cleanNLP. Esse pacote é um modelo tidy para Processamento de Linguagem Natural e fornece tarefas de anotação como tokenização, etiquetagem gramatical, reconhecimento de entidades, linking de entidades, sentiment analysis e outras. Esse processamento foi feito fora deste tutorial, mas disponibilizei o necessário para topic modeling.
No dataset anotado, há uma linha para cada palavra do corpus das letras do Prince, com informações importantes sobre cada termo.
Dê uma olhada no objeto anotado tokenizado examinando os nomes dos campos.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Por ora, usaremos apenas duas informações:
O campo word é a palavra original, e lemma, sua versão lematizada. upos é o código universal da classe gramatical. Se você chamar table() em upos, verá a contagem de palavras em cada classe (algumas podem ser etiquetadas mais de uma vez).
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Para ilustrar, foque em algumas músicas em que o lemma difere da palavra original e remova stop words.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Isso mostra como você pode ser seletivo no que entra no modelo (palavra, lemma ou uma classe gramatical específica). É uma decisão de julgamento usar a forma lematizada, a original ou até o stem, citado na Parte Dois-A. Você também pode questionar as marcações do cleanNLP sobre o que é substantivo versus adjetivo. Recomendo testar várias configurações e ver o que funciona melhor.
Neste tutorial, vamos modelar apenas substantivos. Para obter metadados do Prince, como gênero e ano, faça join de prince_annotated com prince_tidy por word e document, e depois crie a DTM como de costume. Optei por remover algumas palavras muito comuns presentes em todos os tópicos só para deixar mais interessante. (Usar tf-idf, visto na Parte Um, é outra forma de filtrar palavras comuns.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)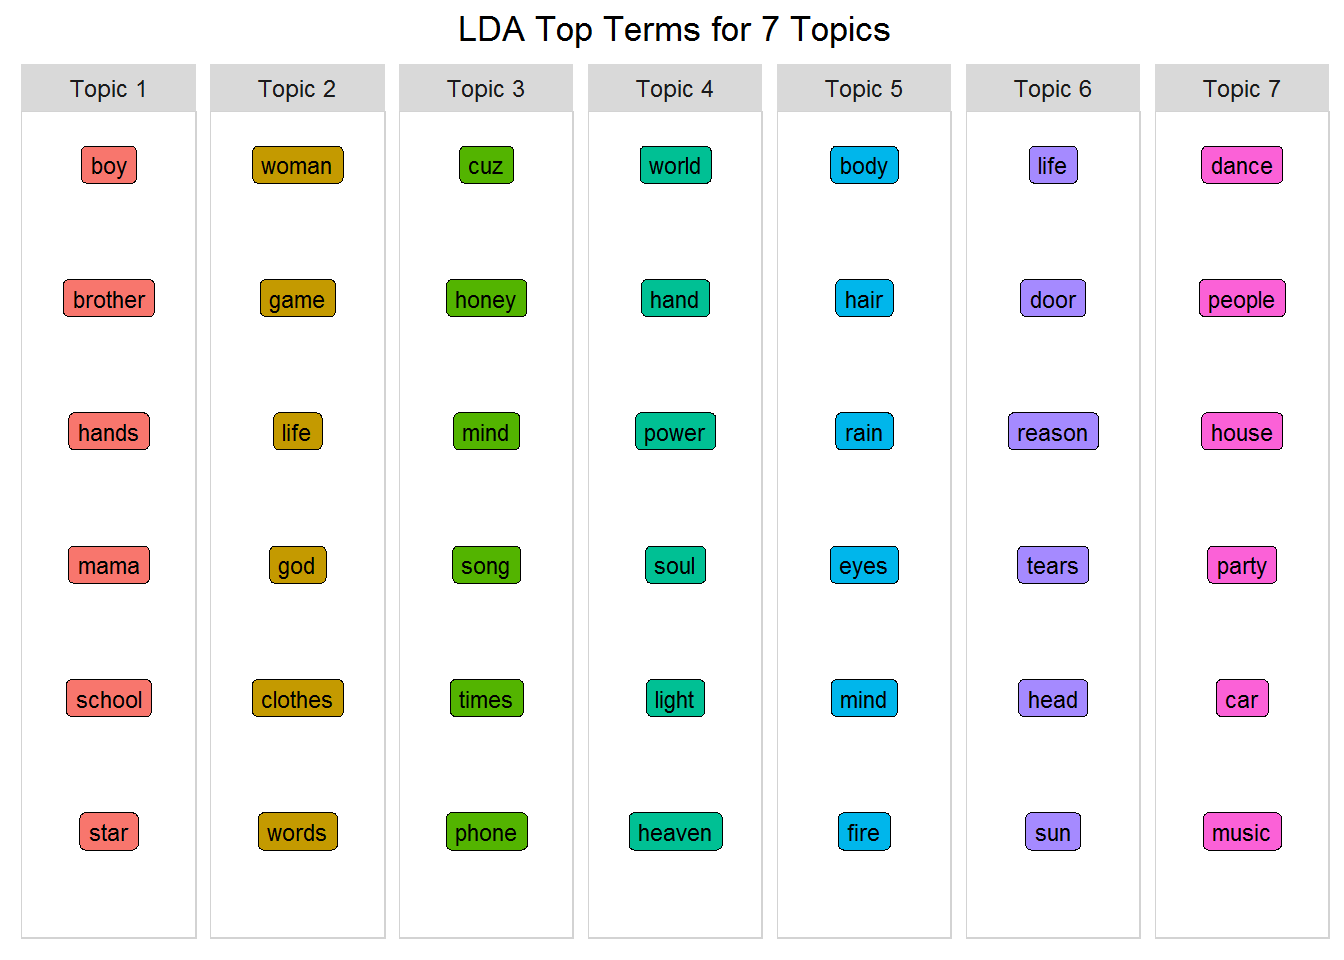
Abaixo estão temas que pessoas já atribuíram às músicas do Prince ao longo dos anos. Eles são marcados por certas palavras e, como em todo topic modeling, há sobreposição. Veja estes temas (listados em ordem aleatória!) e tente encontrá-los no seu modelo.
Parece que o Topic 1 fala de pessoas e família; o Topic 7, de música, dança e festa; e o Topic 4, de eu, sociedade e religião. É uma interpretação subjetiva. Em contexto de negócios, essa etapa é melhor feita por um especialista no assunto. Agora dá para ver por que NLP é a interseção entre IA e linguística computacional!
Tente rodar com outro número de tópicos, apenas verbos, palavra bruta versus lematizada, outro número de palavras principais — e veja que insights surgem. Há métodos novos para ajudar a definir o número de tópicos: veja perplexity aqui ou o pacote
ldatuningaqui.
Como o dataset do Prince tem o ano, dá para acompanhar temas ao longo do tempo. Você pode ser bem criativo aqui; por ora, veja algumas palavras de dois tópicos e sua frequência ao longo dos anos. Trending em si daria um tutorial inteiro — se tiver interesse, consulte este recurso.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)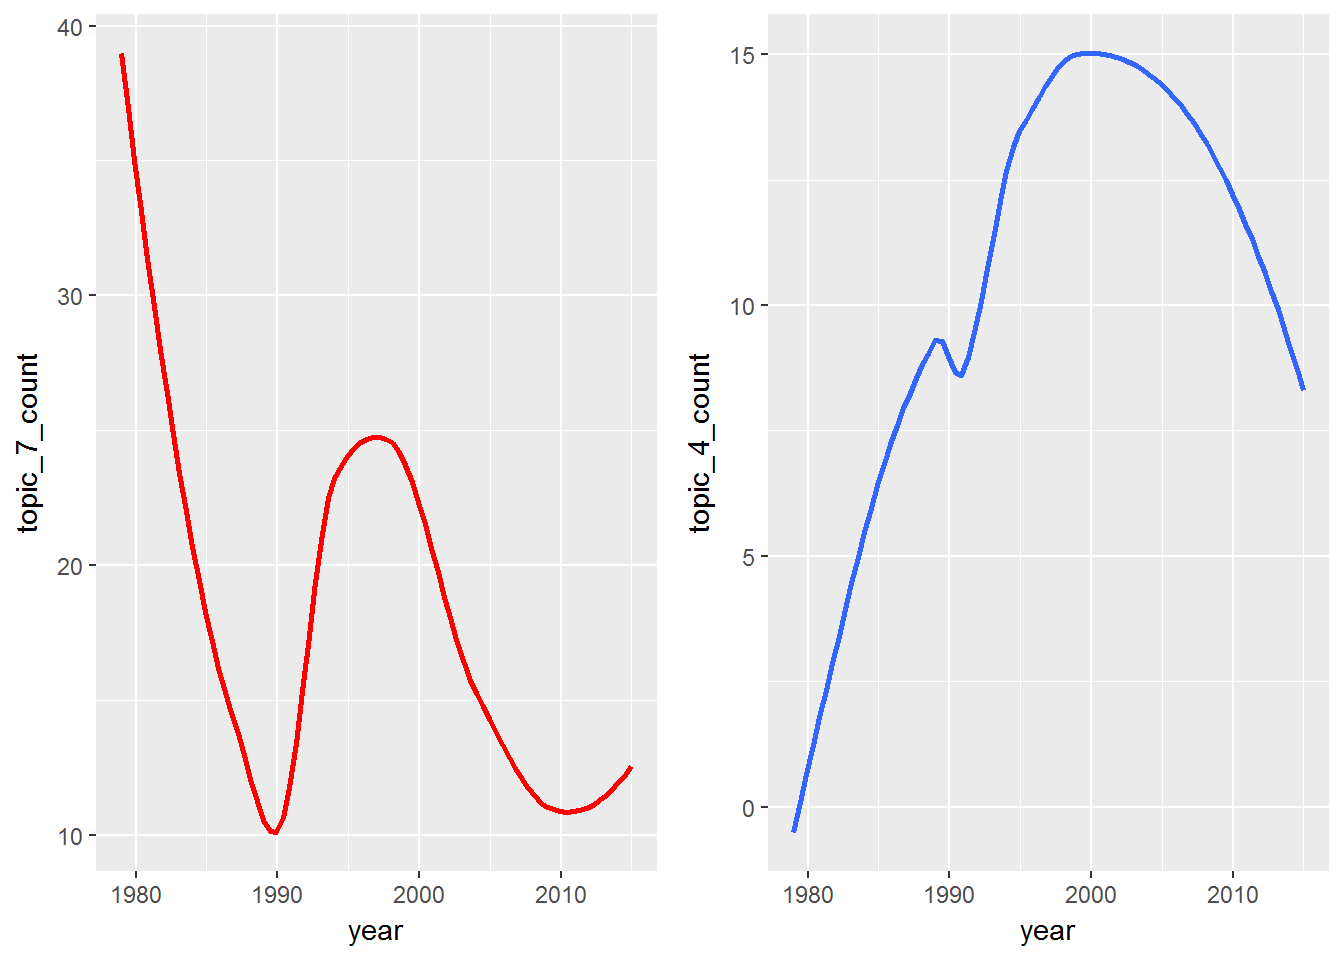
É um exemplo bem básico de como temas mudam no tempo, mas e se você levasse esse tipo de análise além da música? Talvez sua empresa queira ver correlação entre vendas e temas em alta em tweets de clientes. Há muitas aplicações para entender a evolução de tópicos.
Este tutorial só arranha a superfície do que é possível com topic modeling, NLP e machine learning. É uma área em expansão na ciência de dados e deve crescer conforme mais pesquisadores exploram os oceanos de dados não estruturados. Em música, classificar canções por letras ainda aparece mais em papers acadêmicos — quem sabe você usa este trabalho como trampolim e cria sua própria contribuição para o mundo da IA.
Você usou dados de letras e livros de não ficção para identificar temas, classificar documentos nos tópicos mais prováveis e identificar escritores similares com base no conteúdo temático. Assim, construiu um sistema simples de recomendação baseado em texto e escritores rotulados.
Lembre-se: você está tentando modelar arte com máquinas. Um artista pode dizer "You are the apple of my eye", mas não está falando de fruta nem de olho. É preciso encontrar o que está oculto. Quando você ouve música, nem sempre percebe os vocais de apoio, mas eles estão lá. Aumente sua música favorita e escute além da voz principal — pode se surpreender com um mundo de informações escondidas. Coloque a lógica em segundo plano e traga a criatividade para a linha de frente nessa jornada!
Como em todos os tutoriais desta série, recomendo usar estes dados como um estudo de caso divertido e também como gerador de ideias para analisar textos que te interessam — seus artistas favoritos, mídias sociais, textos corporativos, científicos ou socioeconômicos. Quais aplicações você imagina para topic modeling? Deixe um comentário com suas ideias!
Fique de olho na Parte Três (o quarto artigo) desta série: Lyric Analysis: Predictive Analytics using Machine Learning with R. Lá, você usará letras e metadados rotulados para prever o futuro de uma música. Vamos trabalhar com diferentes algoritmos como Decision Trees, Naive Bayes e outros para prever gênero, década e até se uma música vai para as paradas! Te espero lá!
Observações:
Observação 1: Você só obterá os mesmos resultados que eu se rodar o código na mesma ordem e com os mesmos arquivos de dados, sem modificações. Caso contrário, referências a tópicos específicos podem não fazer sentido.
Observação 2: Não há regras definitivas aqui — o trabalho se baseia na minha pesquisa. Embora topic modeling exista em aplicações do mundo real, há pouca atividade em recomendadores musicais baseados inteiramente em letras.
Observação 3: Topic modeling é traiçoeiro. Construir o modelo é uma coisa; interpretar os resultados é desafiador, subjetivo e difícil de validar completamente (embora haja pesquisa em andamento: veja este artigo de Thomas W. Jones). O processo é não supervisionado, gerativo, iterativo e baseado em probabilidades. Tópicos são sutis, ocultos e implícitos — não explícitos.
Se quiser aprender mais sobre machine learning com R, confira nosso tutorial para iniciantes. E faça nosso curso Introduction to Machine Learning course.
Saiba mais sobre machine learning
Curso
Curso
Curso
blog
Laiba Siddiqui
13 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Kevin Babitz
8 min
Tutorial
Eugenia Anello
8 min