{count, plural, one {Kursus} other {Kursus}}
Analisis Sentimen di R
{hours} jam
14.1K
Ikuti perjalanan penuh perasaan melalui kehidupan dan masa Prince, The Artist, di Bagian Dua-A dari seri tutorial tiga bagian yang menggunakan analisis sentimen dengan R untuk memberikan wawasan tentang karier dan pengaruh sosial The Artist. Tiga tutorial tersebut mencakup hal-hal berikut:
Jika Anda ingin mempelajari lebih lanjut tentang analisis sentimen, pastikan untuk melihat kursus kami Sentiment Analysis in R: The Tidy Way.
Tahukah Anda bahwa Prince memprediksi 9/11 di atas panggung tiga tahun sebelum itu terjadi? Ia mungkin juga memprediksi kematiannya sendiri. Benarkah? Menarik bukan jika menelaah liriknya dan membuat penilaian berdasarkan data? Pada 21 April 1985, ia merekam "Sometimes It Snows In April". Ia meninggal tepat 31 tahun kemudian pada 21 April 2016. Lihat pilihan katanya dalam analisis sentimen lagu ini:
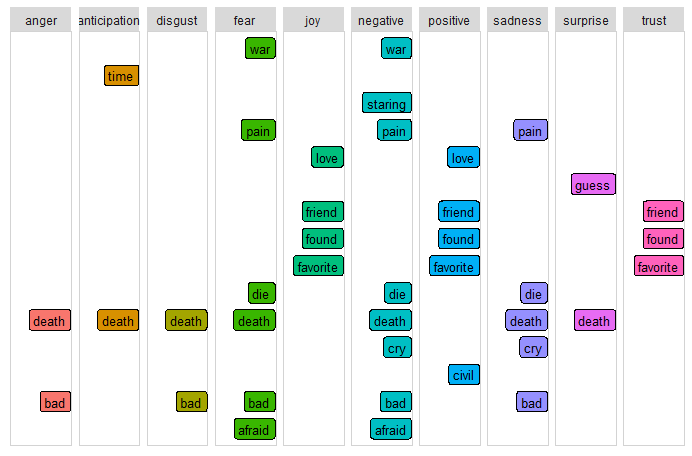
Ini memberi makna baru bagi Analytics Prediktif!
Setiap potongan kode diikuti dengan insight yang umumnya bersifat subjektif. Silakan berpindah dari satu bagian ke bagian lain dan buat asumsi Anda sendiri jika Anda mau! Saya sarankan membaca pengantar berikut, tetapi jika Anda ingin langsung ke kodenya, klik di sini. Jika Anda sudah memahami konsep leksikon, Anda bisa mengambil jalur cepat dengan langsung ke bagian analisis mendetail.
Saya baru saja menolong dua anak kucing dan seekor anak anjing, jadi sekarang saya berpikir dalam tiga. Selain itu, aturan tiga adalah prinsip penulisan yang menyatakan bahwa hal-hal dalam kelompok tiga cenderung lebih lucu, memuaskan, atau efektif dibanding jumlah lain—itulah sebabnya saya membaginya menjadi tiga bagian... Jadi, di Bagian Satu, Anda diperkenalkan pada penambangan teks dan analisis eksploratori menggunakan dataset berisi ratusan lirik lagu dari artis legendaris, Prince. Di Bagian Dua, Anda akan berfokus pada analisis sentimen (Dua-A) dan topic modeling (Dua-B) dengan NLP. Bagian Tiga akan ditutup dengan tugas analitik prediktif tambahan menggunakan teknik machine learning untuk menjawab pertanyaan seperti apakah mungkin menentukan dekade rilis sebuah lagu, atau yang lebih menarik, memprediksi apakah sebuah lagu akan masuk tangga lagu Billboard berdasarkan liriknya. Sepanjang tutorial, Anda akan menggunakan beragam algoritma machine learning—masing-masing disorot dengan warna merah pada grafik di bawah ini.
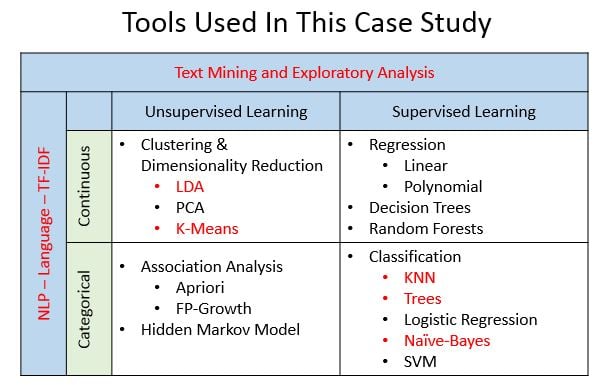
Ya, saya berkomitmen pada tiga bagian saja, tetapi saya memutuskan untuk memecah Bagian Dua menjadi Dua-A (Analisis Sentimen) dan Dua-B (Topic Modeling - segera menyusul), sehingga menjadi empat tutorial terpisah. Ada banyak artikel dan kursus hebat tentang proses di balik analisis sentimen, jadi tujuan Bagian Dua-A adalah berfokus pada penarikan insight dari hasil analisis—bukan sekadar menulis kode. Anda akan menggunakan lirik Prince sebagai contoh, tetapi Anda dapat menerapkan langkah-langkahnya pada artis favorit Anda sendiri. Perjalanan Anda melalui seri tutorial lengkap ini diharapkan memantik rasa ingin tahu tentang peluang yang ditawarkan oleh analisis lirik sambil mengenal teknik Natural Language Processing (NLP) dan machine learning.
Bagian Dua-A dari seri tutorial ini memerlukan pemahaman dasar tentang data tidy—khususnya paket seperti dplyr untuk transformasi data, ggplot2 untuk visualisasi, dan %>% operator pipa (awalnya dari paket magrittr). Anda akan melihat beberapa langkah sering digabung menggunakan operator %>% agar kode tetap ringkas dan dapat digunakan ulang.
Karena tutorial ini juga merupakan studi kasus, ia penuh dengan visualisasi di luar grafik dan bagan yang umum. Akibatnya, prasyarat lainnya adalah kemampuan menginstal paket baru di lingkungan Anda. Untuk berfokus pada penangkapan insight, saya sertakan kode yang dirancang untuk digunakan ulang pada dataset Anda sendiri, tetapi penjelasan terperinci memerlukan penelusuran lebih lanjut dari Anda. Tautan pendukung akan diberikan untuk setiap paket. Ini akan memperkenalkan Anda pada alat baru sambil berfokus pada penerapannya.
Tip: baca Bagian Satu terlebih dahulu untuk mendapatkan fondasi seri tutorial dan pemahaman tentang kosakata lirik Prince yang padat dan beragam.
Metode: Analisis sentimen adalah jenis penambangan teks yang bertujuan menentukan opini dan subjektivitas kontennya. Saat diterapkan pada lirik, hasilnya dapat merepresentasikan sikap sang artis sekaligus mengungkap pengaruh budaya yang meluas. Ada berbagai metode untuk analisis sentimen, termasuk melatih dataset yang sudah diketahui, membuat pengklasifikasi sendiri dengan aturan, dan menggunakan kamus leksikal (leksikon) yang sudah ditentukan. Dalam tutorial ini, Anda akan menggunakan pendekatan berbasis leksikon, namun saya mendorong Anda untuk menelusuri metode lain beserta komprominya.
Tingkat: Seperti halnya metode yang berbeda, terdapat pula berbagai tingkat analisis berdasarkan teks. Tingkat ini biasanya diidentifikasi sebagai dokumen, kalimat, dan kata. Dalam lirik, dokumen dapat didefinisikan sebagai sentimen per dekade, tahun, level tangga lagu, atau lagu. Tingkat kalimat biasanya bukan opsi dalam lirik karena tanda baca dapat mengganggu rima dan pola. Analisis tingkat kata menyingkap informasi detail dan dapat menjadi landasan untuk praktik yang lebih maju dalam topic modeling.
Setiap proyek data science perlu memiliki serangkaian pertanyaan untuk dieksplorasi. Berikut beberapa yang perlu diingat saat Anda menempuh tutorial ini: mungkinkah menulis program untuk menentukan suasana hati yang diekspresikan dalam lirik? Apakah leksikon yang sudah ditentukan memadai? Seberapa banyak persiapan data yang diperlukan? Bisakah Anda mengaitkan hasil dengan peristiwa nyata? Apakah sentimen berubah seiring waktu? Apakah lagu hit lebih positif atau negatif dibanding lagu yang tidak masuk tangga lagu? Kata apa yang menonjol dalam lirik pada tahun ketika Prince disebut memprediksi 9/11? Apakah ia memprediksi kematiannya sendiri?
Tip: analisis lirik sangat berbeda dan umumnya lebih kompleks daripada pidato atau buku, sehingga sulit menangkap insight, jadi ingat untuk berhati-hati terhadap semua asumsi! Saya akan mengajukan lebih banyak pertanyaan daripada jawaban di tutorial ini, jadi bersiaplah untuk berpikir di luar jajaran genjang segi empat!
Untuk mulai menganalisis lirik Prince, muat library di bawah ini. Ini mungkin tampak banyak pada awalnya, tetapi sebagian besar hanya untuk grafik dan bagan. Mengingat seringnya penggunaan visual, sebaiknya tetapkan skema warna standar agar konsisten. Saya membuat daftar menggunakan kode warna ANSI tertentu. Fungsi theme() dari ggplot2 memungkinkan kustomisasi grafik satu per satu, jadi Anda juga akan membuat fungsi sendiri, theme_lyrics(), yang akan memodifikasi pengaturan default. Paket knitr adalah mesin untuk pembuatan laporan dinamis dengan R. Gunakan bersama kableExtra dan formattable untuk membuat tabel teks berwarna yang menarik. Sekali lagi buat fungsi Anda sendiri, my_kable_styling() untuk menstandarkan keluaran dari library ini. Paket lain akan saya singgung saat digunakan.
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
Seperti biasa, Anda akan mulai dengan membaca data mentah ke dalam data frame. Di Bagian Satu, Anda melakukan beberapa pengondisian data pada dataset asli, seperti memperluas kontraksi, menghapus urutan escape, dan mengonversi teks menjadi huruf kecil. Anda menyimpan dataset bersih itu ke file CSV untuk digunakan dalam tutorial ini. Gunakan read.csv() untuk membuat prince_data dan ingat bahwa Anda menginginkan lirik sebagai string karakter, jadi pastikan stringsAsFactors = FALSE. Karena Anda tidak perlu penomoran baris, setel row.names = 1.
Catatan bahwa Anda bisa menghindari parameter ini dengan membaca ke dalam data frame modern bernama tibble, menggunakan read_csv(), tetapi demi konsistensi dengan Bagian Satu, read.csv() yang digunakan.
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
Lihat sekilas datanya:
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...Anda dapat melihat bahwa prince_data adalah data frame berisi 824 lagu dan 10 kolom. Artinya sebuah rekaman adalah sebuah lagu, betul-betul!
prince_tidyBerikut beberapa langkah perapian data yang tersisa:
Untuk mengubah data mentah menjadi format tidy, gunakan unnest_tokens() dari tidytext untuk membuat prince_tidy yang memecah lirik menjadi kata-kata individual dengan satu kata per baris. Lalu, Anda dapat menggunakan anti_join() dan filter() dari dplyr untuk langkah pembersihan lainnya. (Lihat Bagian Satu untuk penjelasan terperinci.)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
Dataset baru Anda, prince_tidy, kini dalam format tokenized dengan satu kata per baris beserta lagu asalnya. Sekarang Anda memiliki data frame berisi 76116 kata dan 10 kolom.
Jika Anda belum membaca Bagian Satu, Anda mungkin perlu melihat sekilas beberapa grafik ringkasan dari keseluruhan dataset. Anda akan melakukannya menggunakan grafik kreatif dari paket ggplot2, circlize, dan yarrr.
Seorang bajak laut akan berkata shipshape ketika semuanya tertata dengan baik, rapi, dan bersih. Jadi berikut sudut pandang menarik dari data yang bersih dan rapi yang menunjukkan keragaman leksikal, atau dengan kata lain, kosakata lirik dari waktu ke waktu. Pirate plot adalah metode lanjut untuk memetakan variabel dependen kontinu, seperti jumlah kata, sebagai fungsi dari variabel independen kategorikal, seperti dekade. Ini menggabungkan titik data mentah, statistik deskriptif dan inferensial ke dalam satu plot yang efektif. Lihat blog yang bagus ini untuk detail tentang pirateplot() dari paket yarrr.
Buat data frame word_summary yang menghitung jumlah kata unik per lagu. Semakin beragam liriknya, semakin besar kosakatanya. Memikirkan data dengan cara ini mempersiapkan Anda untuk analisis tingkat kata. Setel ulang field dekade agar berisi nilai "NONE" untuk lagu tanpa tanggal rilis dan ganti label field tersebut dengan label yang lebih rapi menggunakan select().
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
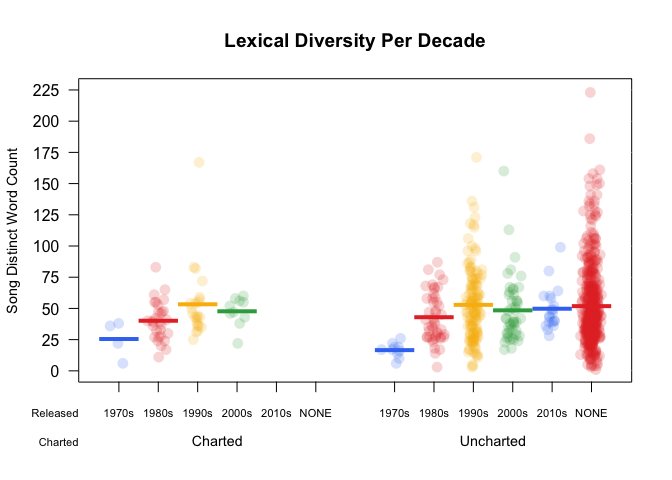
Setiap lingkaran berwarna dalam pirate plot ini mewakili sebuah lagu. Area merah padat dengan nilai "NONE" menunjukkan banyak lagu dalam dataset tidak memiliki tanggal rilis. Ada sedikit tren naik pada jumlah kata unik per lagu di dekade-dekade awal: garis horizontal solid menunjukkan rata-rata jumlah kata untuk dekade tersebut. Ini penting saat Anda mulai menganalisis sentimen dari waktu ke waktu. Kata-kata menjadi semakin mencerahkan sepanjang karier Prince.
Saya menantang Anda untuk mengeksplorasi pirate plot lebih jauh karena di sini kita baru menyentuh permukaannya!
Grafik melingkar adalah cara unik untuk memvisualisasikan hubungan yang rumit (atau sederhana!) di antara beberapa kategori. (Selain itu, album dulu berbentuk bundar!). Grafik di bawah ini adalah diagram batang melingkar sederhana menggunakan coord_polar() dari ggplot2 yang menunjukkan jumlah relatif lagu per tahun. Kodenya memang banyak untuk menghasilkan grafik sederhana, tetapi sepadan. Contoh serupa dengan detail lebih lanjut dapat ditemukan di R Graph Gallery di sini. Seperti pirate plot, ini hanya pengantar dari apa yang dapat Anda lakukan dengan plot melingkar.
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
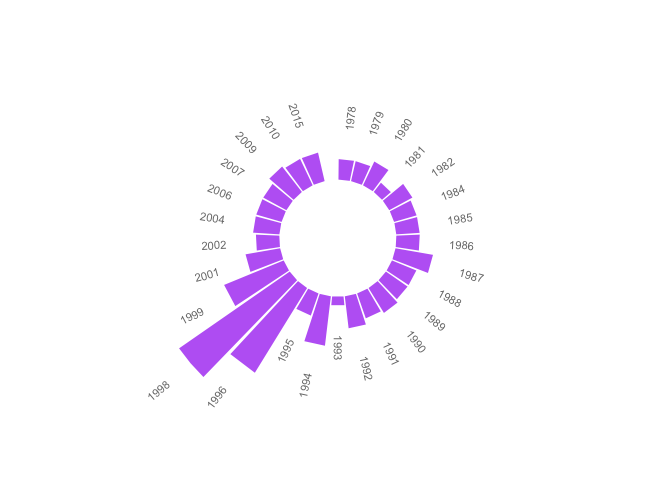
Lihat celah di bagian paling atas? Ini menunjukkan ratusan lagu tanpa tanggal rilis seperti yang Anda identifikasi di pirate plot. Dengan jumlah lagu yang belum dirilis sebanyak itu, grafik akan kurang berguna jika disertakan. Tahun yang hilang menunjukkan tidak ada lagu yang dirilis pada tahun tersebut. Tahun paling produktif adalah 1996 dan 1998.
Ingin tahu kenapa? Teruskan membaca!
Grafik berikut menunjukkan hubungan antara dekade rilis sebuah lagu dan apakah lagu tersebut masuk tangga lagu Billboard atau tidak. Menggunakan chordDiagram() untuk analisis musik rasanya pas! Alat grafis ini berasal dari paket circlize yang indah oleh Zuguang Gu. Grafik dibagi menjadi dua kategori: charted (atas), dan dekade (bawah). Dua kategori dipisahkan oleh celah lebar, dengan celah lebih kecil di antara nilainya. Komentar tingkat tinggi dalam kode di bawah dapat dilengkapi dengan detail lebih lanjut di sini.
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
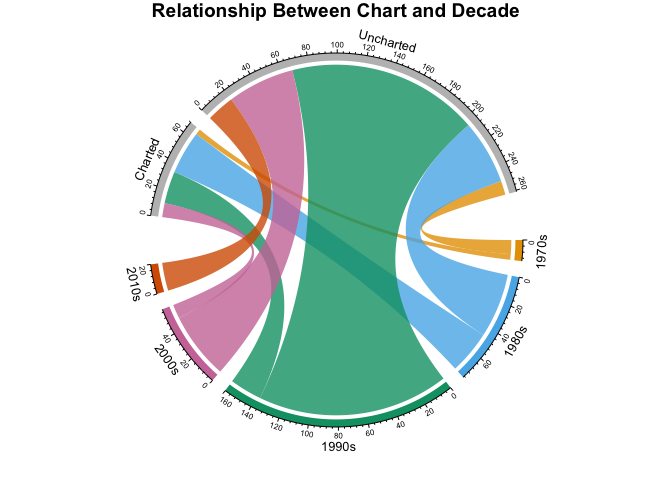
Grafik lingkaran di atas mungkin tampak rumit sekilas, tetapi ia dengan baik menggambarkan jumlah lagu per dekade per level tangga lagu. Anda dapat melihat Prince memulai karier pada 1970-an dengan hanya beberapa rilis, sebagian di antaranya masuk tangga lagu. Jika Anda membandingkan 1980-an dengan 1990-an, Anda akan mendapati lebih banyak lagu dirilis pada 1990-an, tetapi lebih banyak lagu masuk tangga lagu pada 1980-an. Hanya ada beberapa lagu yang sukses secara komersial pada 2000-an dan tidak ada lagu hit pada 2010-an.
Di bagian ini Anda akan:
Paket tidytext menyertakan dataset bernama sentiments yang menyediakan beberapa leksikon berbeda. Leksikon ini adalah kamus kata dengan kategori atau nilai sentimen yang ditetapkan. tidytext menyediakan tiga leksikon tujuan umum:
Untuk menelaah leksikon, buat data frame bernama new_sentiments. Saring leksikon finansial, buat field sentimen biner (juga disebut polar) untuk leksikon AFINN dengan mengonversi skor numerik menjadi positive atau negative, dan tambahkan field yang menyimpan jumlah kata unik untuk setiap leksikon.
new_sentiments memiliki satu kolom dengan berbagai kategori sentimen, jadi untuk tampilan yang lebih baik atas jumlah kata per leksikon per kategori, gunakan spread() dari tidyr untuk memutar kategori tersebut menjadi field terpisah. Manfaatkan paket knitr dan kableExtra dalam fungsi my_kable_styling() yang Anda buat sebelumnya. Tambahkan warna pada bagan menggunakan color_tile() dan color_bar() dari formattable untuk membuat tabel yang tertata dengan baik. Cetak tabel Anda dan telaah perbedaan tiap leksikon.
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
Tabel di atas memberi gambaran tentang ukuran dan struktur masing-masing leksikon.
Untuk menentukan leksikon mana yang lebih cocok untuk lirik, Anda perlu melihat rasio kecocokan kata yang sama-sama muncul di leksikon dan lirik. Sebagai pengingat, terdapat total 76116 kata dan 7851 kata unik di prince_tidy.
Lalu berapa banyak dari kata-kata tersebut yang benar-benar ada di leksikon?
Gunakan inner_join() antara prince_tidy dan new_sentiments lalu kelompokkan berdasarkan leksikon. Leksikon NRC memiliki 10 kategori berbeda, dan sebuah kata dapat muncul di lebih dari satu kategori: misalnya, kata bisa negatif dan sedih. Artinya, Anda ingin menggunakan n_distinct() dalam summarise() untuk mendapatkan jumlah kata unik per leksikon.
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
Leksikon NRC memiliki lebih banyak kata unik dari lirik dibanding AFINN atau Bing. Perhatikan jumlah rasio kecocokan rendah. Tidak ada leksikon yang memiliki semua kata, dan memang tidak seharusnya. Banyak kata dianggap netral dan tidak memiliki sentimen terkait. Misalnya, 2000 umumnya merupakan kata netral, sehingga tidak ada dalam leksikon. Namun, jika Anda ingat, orang dulu memprediksi pesawat akan jatuh dari langit dan komputer akan berhenti bekerja pada tahun itu. Jadi ada rasa takut yang terkait dalam lagu tersebut tetapi tidak tertangkap oleh analisis sentimen menggunakan leksikon umum.
Berikut beberapa alasan sebuah kata mungkin tidak muncul dalam leksikon:
Lihat beberapa kata spesifik dari lirik Prince yang tampaknya berdampak pada sentimen. Apakah kata-kata ini ada di semua leksikon?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy dan dark muncul dalam NRC dan Bing, tetapi gangster hanya muncul dalam Bing. Race tidak muncul sama sekali dan ini adalah topik penting dalam lirik Prince. Namun, apakah mudah mengaitkannya dengan sentimen? Perlu dicatat AFINN jauh lebih kecil dan hanya memiliki satu dari kata-kata ini.
Sekarang lihat contoh yang lebih rumit. Seksualitas adalah tema umum dalam musik Prince. Bagaimana analisis sentimen berbasis leksikon yang telah ditentukan terpengaruh oleh bentuk kata yang berbeda? Misalnya, berikut semua rujukan pada kata dasar sex dalam lirik. Bandingkan dengan Bing dan NRC dan lihat di mana ada kecocokan.
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
Perhatikan bahwa Prince sering menggunakan sexy, tetapi kata ini tidak ada dalam bentuk ini di NRC. Kata sex ditemukan dalam NRC tetapi tidak dalam Bing. Bagaimana jika Anda melihat stem atau akar kata, apakah itu membantu? Sungguh teka-teki! Teks Anda bisa mengandung bentuk lampau, jamak, atau adverbia dari kata dasar, tetapi mungkin tidak ada di leksikon mana pun. Bagaimana cara Anda mengatasinya?
Mungkin Anda memerlukan beberapa langkah persiapan data lagi. Berikut tiga teknik untuk dipertimbangkan sebelum melakukan analisis sentimen:
Konsep lanjut dalam analisis sentimen adalah penggantian sinonim (rekan semantik serupa) dan hipernim (induk umum). Ini adalah kata-kata yang lebih sering digunakan daripada kata terkait dalam lirik, dan benar-benar muncul dalam leksikon, sehingga memberikan persentase kecocokan lebih tinggi. Tidak cukup ruang dalam tutorial ini untuk membahas persiapan data tambahan, tetapi ini jelas patut dipertimbangkan!
Tantangan: lakukan sedikit riset tentang leksikon dan bagaimana leksikon dibuat. Apakah sudah ada yang lebih cocok untuk lirik musik? Jika Anda sangat tertarik, pertimbangkan apa yang diperlukan untuk membangun leksikon Anda sendiri. Apa perbedaan antara analisis sentimen berbasis pengklasifikasi dan berbasis leksikon?
Sekarang setelah Anda memahami dasar-dasar dataset dan leksikon, Anda dapat menerapkan pengetahuan itu dengan menggabungkannya untuk analisis. Berikut langkah-langkah tingkat tinggi yang akan Anda lakukan:
Mulailah dengan membuat dataset sentimen Prince untuk masing-masing leksikon dengan melakukan inner_join() pada fungsi get_sentiments(). Berikan nama leksikon untuk setiap pemanggilan. Untuk latihan ini, gunakan Bing untuk sentimen biner dan NRC untuk sentimen kategorikal. Karena kata dapat muncul di beberapa kategori di NRC, seperti Negative/Fear atau Positive/Joy, Anda juga akan membuat subset tanpa kategori positive dan negative untuk digunakan nanti.
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
Dalam analisis mendetail atas lirik, Anda akan menelaah berbagai tingkat teks, seperti semua lagu, level tangga lagu, level dekade, dan level kata. Mulailah dengan membuat grafik analisis sentimen NRC untuk keseluruhan dataset.
(Untuk seru-seruan, saya menggunakan paket memery dan magick untuk menambahkan gambar (meme) ke grafik.)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
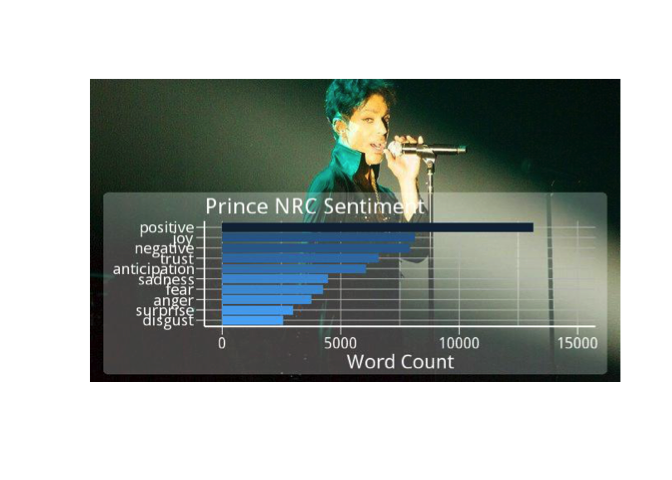
Tampaknya untuk lirik Prince, NRC sangat condong ke positive. Namun apakah semua kata dengan sentimen disgust atau anger juga masuk kategori negative? Mungkin layak diperiksa.
Sekarang lihat sentimen keseluruhan Bing. Dari 1185 kata unik dalam lirik Prince yang muncul di leksikon Bing, berapa yang positif dan berapa yang negatif?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
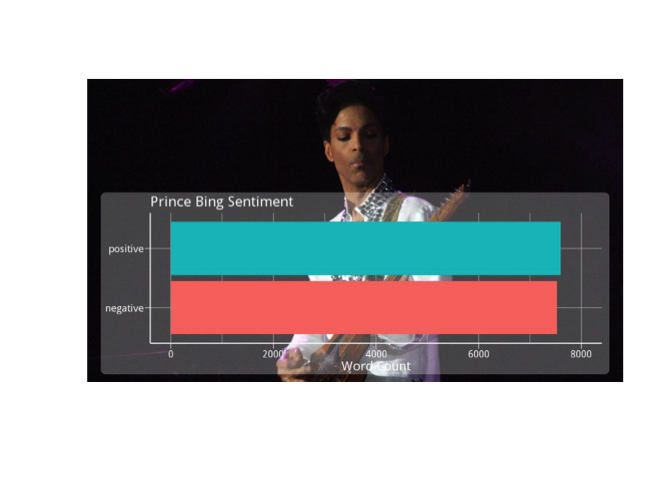
Mungkinkah pada Bing, tampak ada sentimen positive dan negative yang seimbang dalam musik Prince? Apakah sentimen keseluruhan saling meniadakan saat melihat dataset yang terlalu besar? Sulit untuk mengetahui, tetapi cobalah melihatnya per bagian dan lihat apa yang terjadi.
Dalam akustik, ada sesuatu yang disebut phase cancellation ketika frekuensi dari dua gelombang yang sama persis berlawanan fase dan saling meniadakan, misalnya saat merekam drum dengan dua mikrofon dan butuh waktu lebih lama bagi suara mencapai salah satu mikrofon. Ini menghasilkan keheningan total pada frekuensi tersebut! Bagaimana ini berlaku pada analisis sentimen dataset besar? Pikirkanlah.
Profesor Linguistik: "Dalam bahasa Inggris, negatif ganda menjadi positif. Dalam bahasa Rusia, negatif ganda tetap negatif. Namun, tidak ada bahasa di mana positif ganda bisa menjadi negatif." Mahasiswa yang tidak setuju: "Iya, kan."
Tingkatkan intensitas analisis Anda dengan mengurainya ke level tangga lagu menggunakan leksikon Bing. Buat grafik sentimen polar per level tangga lagu. Gunakan spread() untuk memisahkan sentimen ke kolom-kolom dan mutate() untuk membuat field polarity (positive - negative) dan field percent_positive ($positive / total sentiment * 100$), untuk sudut pandang berbeda. Untuk grafik polaritas, tambahkan yintercept dengan geom_hline(). Plot grafik berdampingan dengan grid.arrange().
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
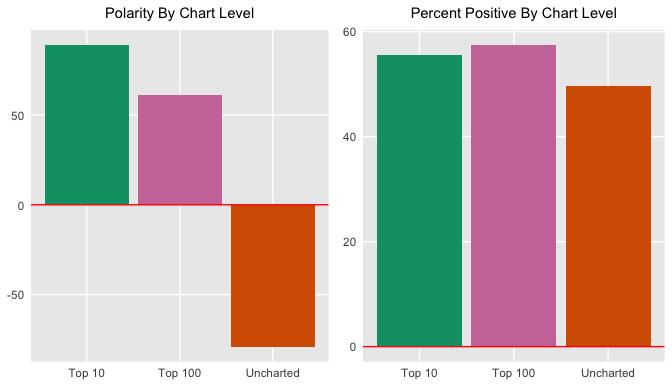
Apakah ini mengatakan bahwa lagu yang masuk tangga lagu biasanya lebih positif daripada negatif? Jika ya, apa artinya tentang apa yang ingin didengar masyarakat? Bisakah Anda membuat asumsi seperti itu? Melihat sentimen positif relatif terhadap total sentimen, tampaknya lagu yang masuk tangga lagu hanya sedikit lebih positif daripada negatif. Ini menarik mengingat leksikon Bing sendiri memiliki lebih banyak kata negatif daripada positif.
Karena Anda melihat sentimen dari perspektif polar, Anda mungkin ingin melihat apakah sentimen berubah seiring waktu (humor geek). Kali ini gunakan geom_smooth() dengan metode loess untuk kurva yang lebih halus dan satu lagi geom_smooth() dengan method = lm untuk kurva halus linear.
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
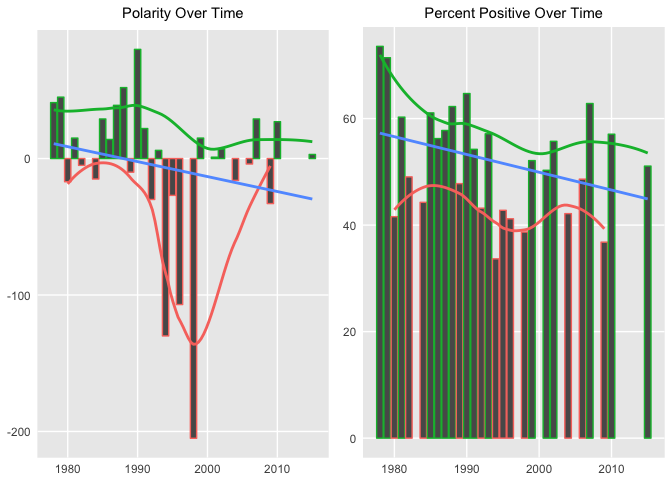
Beberapa nilai ekstrem disesuaikan pada grafik kedua di atas, tetapi tren polaritas keseluruhan dari waktu ke waktu bersifat negatif pada keduanya.
Anda akan kembali menggunakan kekuatan chordDiagram() untuk menelaah hubungan antara sentimen NRC dan dekade. Perhatikan bahwa kategori sentimen muncul di bagian atas cincin dan dekade di bagian bawah.
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
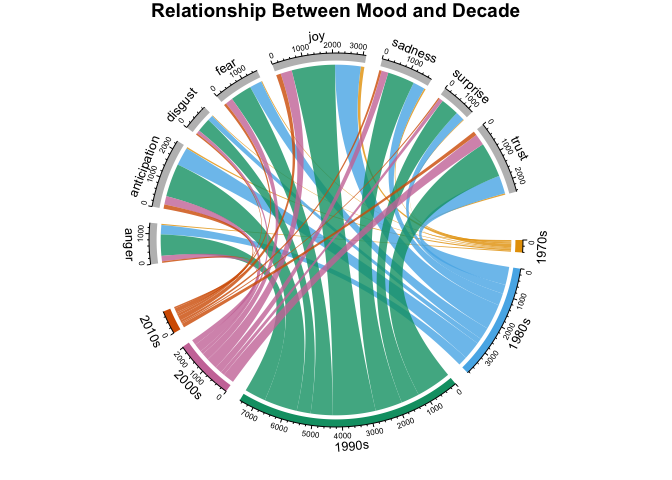
Grafik ini menunjukkan jumlah kata per kategori NRC per dekade. Memang cukup banyak untuk dicerna pada grafik kecil, tetapi menyajikan banyak sekali informasi tentang hubungan antara kategori dan waktu. Diagram seperti ini sangat dapat dikustomisasi dan bisa dibuat sesederhana atau seinformatif yang Anda inginkan.
Mengingat semua kursus hebat yang sudah Anda ikuti di DataCamp, Anda mungkin gatal untuk menerapkan keterampilan tersebut pada situasi dunia nyata. Jadi lakukan sekarang dengan memetakan analisis lirik Prince ke sesuatu yang nyata sepanjang kurun waktu. Namun, harap tetap skeptis dan berhati-hati saat melakukan analisis yang disederhanakan atas topik yang kompleks.
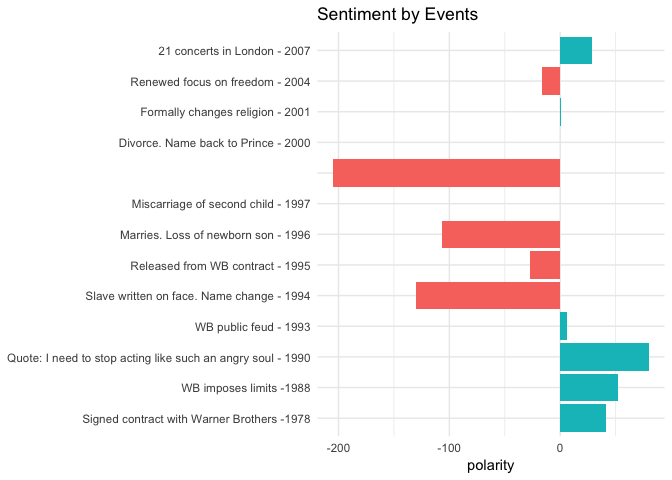
Saya telah membuat daftar peristiwa hidup Prince, dikumpulkan dari sumber populer seperti Rolling Stone Magazine, Biography.com, dan lain-lain. Saya memilih tahun-tahun yang sangat terekspos publik yang cocok dengan lagu-lagu yang memiliki tanggal rilis dalam dataset kita. Baca peristiwa-peristiwa tersebut dari princeEvents.csv sekarang. Lalu gunakan prince_bing dan spread() untuk membuat skor polaritas per tahun. Gabungkan dengan data frame events dan buat sebuah kolom sentimen agar Anda bisa mengisi warna pada diagram batang Anda. Seperti biasa, gunakan coord_flip() saat Anda menampilkan label teks yang panjang.
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
Tip: Anda dapat menemukan princeEvents.csv di sini.
Menurut saya menarik membandingkan peristiwa dengan sentimen. Walaupun subjektif, saya menemukan keduanya sangat berkorelasi. Memang, saya sendiri yang membuat dataset peristiwa tersebut. Saya bisa saja dengan mudah membuatnya bias agar sesuai dengan lirik. Namun, saya menggunakan beberapa sumber untuk setiap tahun guna menentukan fakta yang paling umum dilaporkan. Hasil ini seharusnya memotivasi Anda untuk menggali lebih dalam lagi ke analisis pada tingkat kata untuk melihat apa yang sebenarnya dinyanyikan Prince.
Pada 1994, Prince merilis The Black Album sebagai upaya merebut kembali audiens Afrika-Amerika. Mengingat fakta bahwa 1994 dan dua tahun berikutnya menonjol dalam analisis, Anda dapat melihat kata-kata teratas yang cocok dengan leksikon NRC untuk periode ini menggunakan geom_label_repel() dari paket ggrepel bersama dengan geom_point(). Ini adalah grafik yang agak rumit, jadi saya sarankan Anda bereksperimen dengan konfigurasi kode di bawah.
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
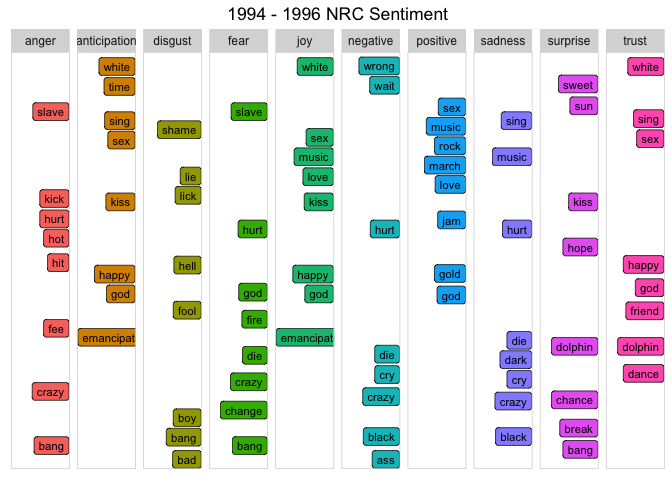
Pada 1994, Prince mengutip kepada majalah Rolling Stone,
"Ketika Anda menghentikan seorang pria dari bermimpi, ia menjadi budak. Di sanalah saya berada."
Maka ia tampil di depan publik dengan kata "slave" (budak) yang ditulis jelas di wajahnya, secara terbuka menyatakan sentimen anti-korporasi terhadap label musiknya saat itu. Ia juga mengganti namanya menjadi sebuah simbol. Seberapa baik kata-kata di atas mencocokkan peristiwa ini? Perhatikan kata "slave", "emancipation" (pembebasan), "black" (hitam), dan "change" (perubahan) pada grafik?
(Ingat, ini bukan hanya tentang Prince. Anda bisa menerapkannya pada teks apa pun! Misalnya, kata-kata dengan sentimen trust apa yang paling sering diucapkan Presiden Trump pada tahun pertamanya menjabat?)
Grafik Sentiment By Events di atas menunjukkan bahwa antara 1996 dan 1998, Prince menikah, kehilangan dua anak, dan disebut-sebut meramalkan 9/11 di atas panggung. (Coba cari di YouTube konsernya tahun 1998 di Belanda untuk mendengarnya sendiri!) Dengan langkah yang sama seperti grafik sebelumnya, lihat 10 kata teratas di setiap kategori NRC selama 1998.
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
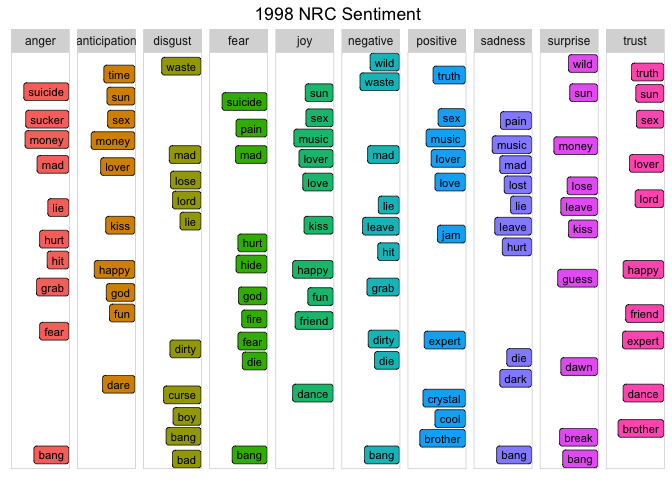
Mengingat kehilangan pribadi dan ancaman terorisme yang membayangi, kata-kata seperti "suicide" (bunuh diri), "waste" (sia-sia), "mad" (marah/gila), "hurt" (terluka), dan banyak lagi yang tidak tertangkap pada grafik ini sangat menggambarkan peristiwa sebenarnya. Kata-kata ini kuat dan memberikan wawasan nyata tentang sentimen pada periode tersebut.
Cara hebat lainnya untuk membandingkan sentimen antar kategori adalah menggunakan grafik radar, yang juga dikenal sebagai spider chart. Anda bisa membuat grafik jenis ini dengan paket radarchart. Grafik ini berguna untuk melihat variabel mana yang memiliki nilai serupa atau apakah ada pencilan pada tiap variabel.
Anda akan membagi analisis ini ke dalam tiga level: tahun, chart, dan dekade. (Untuk menghemat ruang, saya hanya akan menyertakan kode untuk tahun-tahun spesifik.)
prince_nrc_sub yang tidak berisi sentimen positive dan negative agar yang lain lebih terlihat. Kali ini Anda terlebih dahulu menghitung total jumlah kata berdasarkan sentimen per tahun, serta total sentimen untuk keseluruhan tahun dan memperoleh persentase ($jumlah kata sentimen per tahun / total per tahun * 100$).select().spread() terhadap nilai tahun dan persentase (pasangan key/value) ke dalam beberapa kolom sehingga Anda memiliki satu baris untuk setiap sentimen dan satu kolom untuk setiap tahun. Lalu gunakan chartJSRadar() untuk menghasilkan widget HTML interaktif. Anda dapat memberikan argumen untuk menampilkan label dataset saat mouse over. (FYI, kadang huruf J dan Y terpotong dari kata "joy" oleh radarchart sehingga terlihat seperti "iov".)#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
Anda harus menggulir naik turun untuk membandingkan grafik-grafik ini karena saya ingin membiarkannya berukuran penuh. Menarik untuk dicatat bahwa dengan dataset yang lebih kecil seperti year, Anda dapat melihat variasi tiap sentimen lebih jelas menggunakan visualisasi jenis ini. Anda mungkin juga memperhatikan bahwa berbeda dengan latihan sebelumnya, dengan menggunakan persentase, "joy" memiliki skor tertinggi di semua grafik (terutama pada awal karier Prince di 1978).
Spotify menggunakan pembelajaran mesin untuk membuat rekomendasi lagu bagi 140 juta pengguna aktifnya. Lirik belum digunakan. Bayangkan jika bisa... Sekarang, lihat lebih dalam lagi suasana hati lagu-lagu tertentu.
Pada 1987, Prince menulis lagu berjudul "Sign O' the Times". Sebuah artikel Billboard oleh Kenneth Partridge menyatakan:
"Saat ia membahas topik AIDS, geng, narkoba, bencana alam, hingga ledakan Challenger, Prince bersikap dingin dan berjarak. 'Sign O' the Times' adalah pembaruan status, bukan seruan untuk bertindak. Solusinya bukan berbaris di jalan atau menelepon anggota kongres Anda."
Lalu bagaimana sebuah mesin akan menafsirkan suasana lagu ini? Apakah sangat emosional atau sekadar informatif? Apakah mewakili Prince sebagai pribadi atau masyarakat secara umum? Grafikan kategori NRC dengan ggplot2.
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
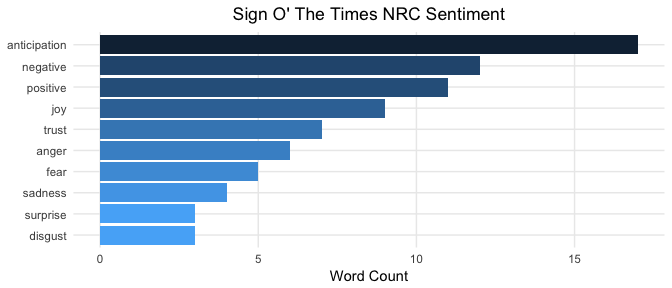
Walaupun kembali sangat subjektif, hasil Anda tampaknya menegaskan bahwa Prince "bersikap dingin dan berjarak", seperti yang dikatakan Partridge. Ini dapat ditafsirkan dari pengamatan bahwa kata-kata anticipation lebih dominan daripada kategori emosional seperti sadness, fear, dan anger. Berikut artikel yang menyatakan tiga kategori tersebut adalah emosi sedangkan anticipation adalah sentimen. Penulis Billboard juga menyatakan lagu ini hanyalah "pembaruan status, hampir tanpa emosi". Tampaknya mesin sependapat. Apakah Anda menafsirkannya demikian juga? Saya tahu ini adalah tutorial R, tetapi analisis sentimen tidak murni teknis. Katanya ini adalah wilayah di mana AI bertemu psikologi.
Menggunakan ggplot2 untuk membuat grafik yang sedikit berbeda, lihat kata-kata untuk setiap kategori.
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
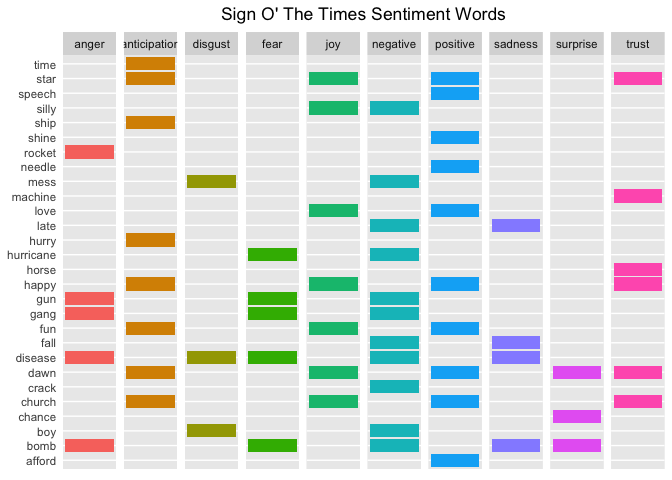
Dapatkah Anda mencocokkan kata-kata ini dengan topik yang disebutkan dalam artikel Billboard? Cukup mudah melihat keterkaitannya: bencana Challenger -> "rocket", AIDS -> "disease", Narkoba -> "crack", Bencana Alam -> "hurricane", Geng -> "gang", dan seterusnya.
Hampir seperti Partridge menulis sedikit kode R dan membuat grafik ini sebelum menulis artikelnya!
Lihat kategori sentimen untuk beberapa lagu dengan judul yang khas dan periksa apakah tampak berkorelasi.
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
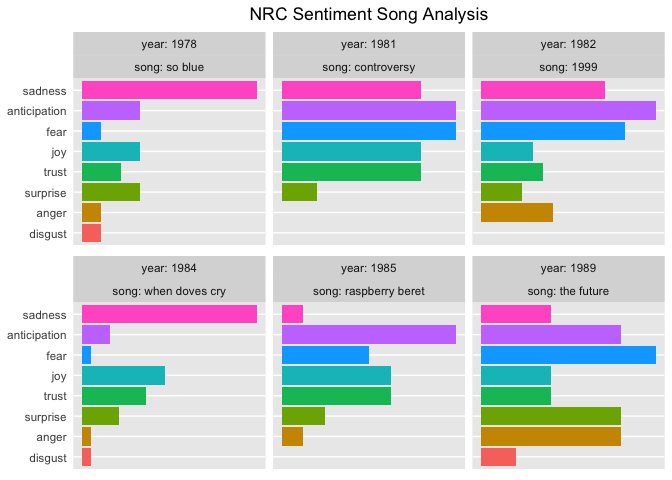
Sentimen NRC menunjukkan anticipation dan fear yang tinggi untuk lagu tentang the future, dan hal yang sama plus trust tinggi untuk lagu tentang controversy. Lagu-lagu yang dominan sad juga tampaknya cocok dengan judulnya.
Sejauh ini Anda hanya melihat unigram atau kata tunggal. Namun jika "love" adalah kata yang umum, apa yang mendahuluinya? Atau mengikutinya? Melihat kata tunggal di luar konteks bisa menyesatkan. Jadi, sekarang saatnya melihat beberapa bigram atau pasangan kata.
Kebetulan, paket tidytext menyediakan kemampuan untuk melepaskan pasangan kata maupun kata tunggal. Dalam hal ini, Anda akan memanggil unnest_tokens() dengan memberikan argumen token ngrams. Karena Anda hanya melihat bigram (dua kata berurutan), berikan n = 2. Gunakan prince_bigrams untuk menyimpan hasilnya.
Paket tidyr menyediakan kemampuan untuk memisahkan bigram menjadi kata-kata individual menggunakan fungsi separate(). Untuk menghapus stop word dan kata yang tidak diinginkan, Anda perlu memecah bigram dan menyaring yang tidak diinginkan, lalu gunakan unite() untuk menyatukan kembali pasangan kata. Ini memudahkan memvisualisasikan bigram paling umum per dekade. (Lihat Bagian Satu untuk penjelasan tentang slice() dan row_number())
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
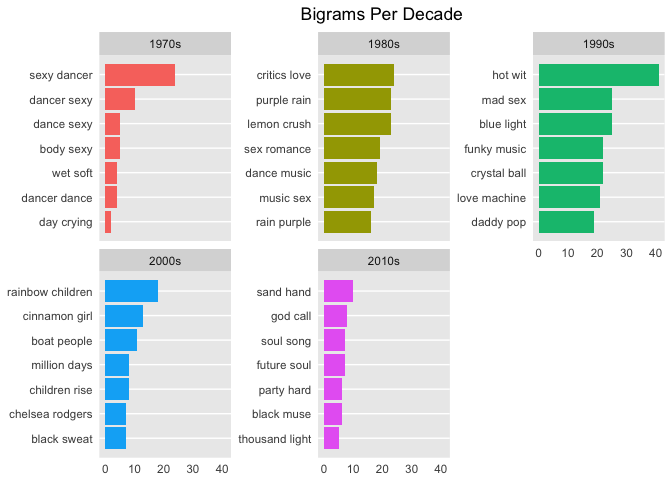
Menggunakan bigram, Anda hampir bisa melihat pergeseran frasa umum dari seks, dansa, dan romansa ke agama dan (anak-anak) pelangi. Jika Anda belum tahu, istilah "rainbow baby" terkadang digunakan oleh orang tua yang menantikan anak lagi setelah kehilangan bayi karena keguguran. Menariknya, saya tidak menemukan ulasan nyata tentang album Rainbow Children milik Prince yang menyinggung hal ini.
Lalu bagaimana bigram memengaruhi sentimen? Kali ini gunakan leksikon AFINN untuk melakukan analisis sentimen pada pasangan kata, melihat seberapa sering kata yang berasosiasi dengan sentimen didahului oleh "not" atau kata negasi lainnya.
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
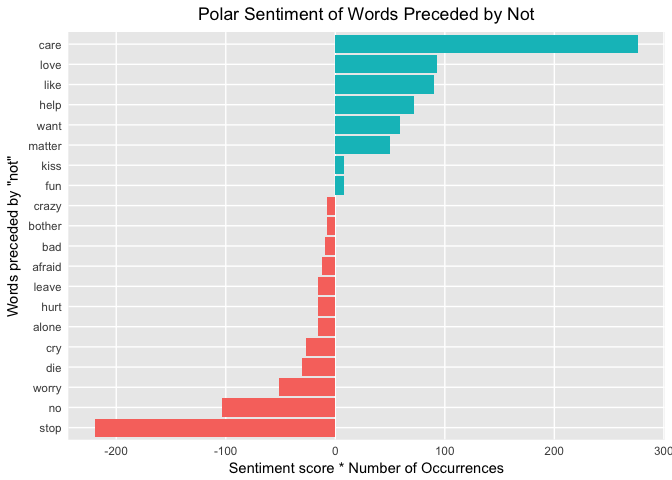
Pada baris pertama grafik, care diberi sentimen false positive karena "not" diabaikan pada analisis kata tunggal. Apakah bigram false positive menetralkan bigram false negative?
Lagi-lagi pertanyaan yang tidak bisa saya jawab, tetapi ini topik yang bagus untuk dieksplorasi lebih lanjut. Tip: Anda juga bisa memberikan parameter "trigrams" dan "n = 3" ke unnest_tokens() untuk melihat lebih banyak kata berurutan!
Ada juga kata negasi lain yang perlu dipertimbangkan. Kali ini Anda akan membuat grafik jaringan menggunakan paket ggraph dan igraph. Anda akan menata kata-kata menjadi simpul-simpul yang terhubung dengan kata negasi di pusatnya. Buat objek pertama dari dataset rapi menggunakan graph_from_data_frame() dan kemudian gunakan ggraph() untuk memplotnya. Anda dapat menyorot simpul utama dengan memanggil geom_edge_density(). Anda bisa mendapatkan detail lebih lanjut tentang contoh serupa di buku Julia Silge dan David Robinson tentang Tidy Text Mining.
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
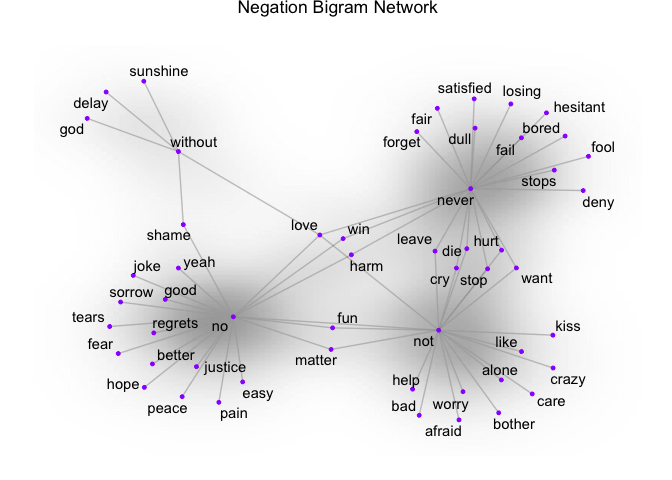
Di sini, Anda dapat melihat pasangan kata yang terkait dengan kata negasi. Jadi, jika analisis Anda berbasis unigram dan "alone" kembali sebagai negatif, bigram "not alone" seperti yang Anda lihat di atas akan memberi efek sebaliknya. Beberapa kata melintas ke beberapa simpul yang dapat dilihat dengan mudah pada visual seperti ini: misalnya, "never hurt" dan "not hurt".
Karena Anda kini telah melihat n-gram, lihatlah korelasi antar kata. Kata mana yang paling berkorelasi tinggi? Gunakan fungsi pairwise_count() dari paket widyr untuk mengidentifikasi jumlah ko-kemunculan. Artinya, Anda menghitung berapa kali setiap pasangan kata muncul bersama dalam sebuah lagu. Paket widyr menerima dataset rapi, lalu sementara melebarkannya sebelum mengembalikannya ke struktur rapi untuk visualisasi dan analisis lebih lanjut.
Untuk menyederhanakan, saya memilih empat kata menarik dalam lirik Prince.
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc$item2) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
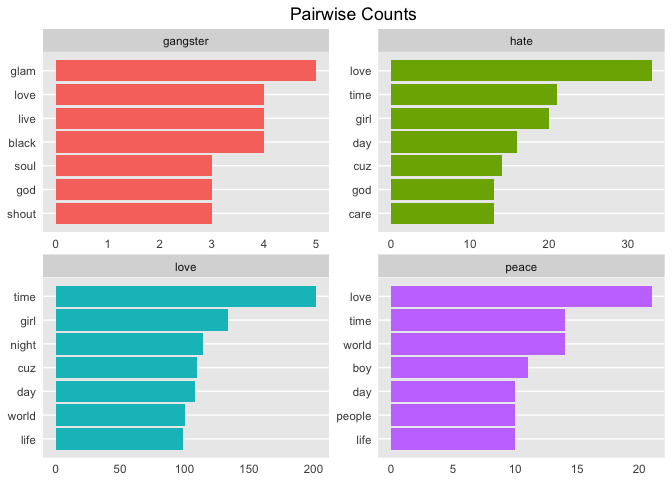
Bandingkan dengan korelasi berpasangan. Ini merujuk pada seberapa sering kata-kata muncul bersama relatif terhadap seberapa sering mereka muncul terpisah. Gunakan pairwise_cor() untuk menentukan korelasi antar kata berdasarkan seberapa sering mereka muncul dalam lagu yang sama.
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
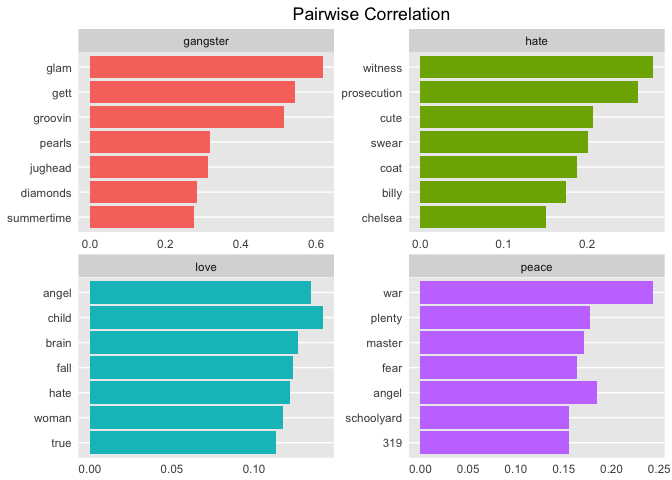
Menurut saya ini wawasan yang memikat tentang lirik, hanya berdasarkan empat kata ini saja! Melihat hasil ini Anda mulai melihat tema-tema yang muncul. Ini menjadi pengantar yang bagus untuk tutorial berikutnya tentang Topic Modeling!
Dalam tutorial ini, Anda membuat dataset rapi dan menganalisis informasi dasar seperti keragaman leksikal dan jumlah lagu per tahun rilis, serta menelaah hubungan antara dekade rilis dan apakah sebuah lagu masuk tangga lagu. Anda kemudian mengeksplorasi beberapa leksikon sentimen dan seberapa baik kecocokannya dengan lirik. Selanjutnya, Anda melakukan analisis sentimen pada semua lagu dalam dataset, sentimen dari waktu ke waktu, sentimen tingkat lagu, dan dampak bigram. Anda melakukannya dengan berbagai grafik menarik, masing-masing memberi perspektif berbeda.
Jadi, mungkinkah menulis program untuk menentukan suasana hati dalam lirik? Tentu bisa! Seberapa andal hasilnya? Tergantung pada berbagai kriteria seperti banyaknya persiapan data, pilihan leksikon, metode analisis, kualitas data sumber, dan seterusnya. Membandingkan peristiwa nyata, baik pribadi maupun sosial, dapat menerangi suasana hati lirik apa pun. Sentimen polar Prince tampaknya sedikit menurun seiring waktu, namun secara keseluruhan, joy memang tampak menonjol. Lagu yang masuk tangga lagu tampak lebih positif daripada yang tidak. Klaim memprediksi 9/11 dan kematiannya sendiri tampaknya secara menggetarkan cocok dengan kata-katanya.
Tetapi lirik itu kompleks dan terlalu banyak asumsi dapat menimbulkan masalah. Jika Anda membawa apa yang telah Anda pelajari tentang lirik ke tutorial berikutnya, Bagian Dua-B tentang Topic Modeling, Anda akan berada di jalur yang tepat untuk menggali tema dan motif. Seberapa banyak NLP yang dapat dilakukan pada lirik yang muncul tanpa tanda baca atau struktur kalimat? Sebenarnya tentang apa Prince bernyanyi? Sekarang setelah Anda memahami suasana hati, Anda lebih siap untuk menyelidiki topik-topik yang mungkin. Dan akhirnya, dapatkah Anda menerapkan teknik pembelajaran mesin untuk memprediksi dekade atau tingkat chart sebuah lagu? Ikuti saya di beberapa tutorial selanjutnya untuk mengetahuinya!
Saya harap Anda menikmati perjalanan sejauh ini. Di Bagian Dua-B kita akan berpesta seperti tahun 1999!
Pelajari lebih lanjut tentang R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



