Kursus
Konsep Keamanan dan Manajemen Biaya AWS
3 jam
11.2K
Dengan mengingat fitur-fitur yang baru saja kita bahas, berikut ringkasan singkat keunggulan Athena:
|
Manfaat |
Fitur |
Deskripsi |
|
Efisiensi Biaya |
Model bayar per kueri |
Hanya membayar data yang disentuh kueri Anda; tanpa biaya di muka atau lisensi kompleks; optimasi biaya dimungkinkan dengan partisi, kompresi data, dan format kolumnar. |
|
Kemudahan Penggunaan |
Serverless & SQL Standar |
Tidak perlu menyiapkan atau mengelola infrastruktur; pengguna dapat mulai melakukan kueri data dalam hitungan menit menggunakan sintaks SQL yang familier, sehingga mudah diakses dan sederhana digunakan. |
|
Fleksibilitas |
Dukungan multi-format |
Mendukung berbagai format data (misal, CSV, JSON, Parquet), memungkinkan pengguna melakukan kueri data dalam format aslinya langsung dari S3 tanpa memerlukan proses ETL. |
|
Insight Cepat |
Analisis cepat & kueri langsung ke S3 |
Memungkinkan analisis data segera dengan arsitektur serverless, sehingga ekstraksi insight cepat langsung dari data yang disimpan di S3 dan mempercepat waktu menuju nilai bagi pengambilan keputusan berbasis data. |
Kita telah mendefinisikan Athena serta menyebutkan fitur dan manfaatnya, tetapi untuk apa layanan ini digunakan? Pada bagian ini, kita akan meninjau beberapa kasus penggunaan yang paling populer.
Amazon Athena sering digunakan untuk analisis log, khususnya untuk melakukan kueri dan menganalisis log yang disimpan di Amazon S3. Organisasi sering kali menghasilkan volume data log yang sangat besar dari berbagai sumber, seperti log aplikasi, log server, dan log akses.
Dengan menyimpan log ini di S3 dan melakukan kueri menggunakan Athena, pengguna dapat dengan cepat mengidentifikasi tren, mendiagnosis masalah, dan memantau kinerja sistem tanpa memerlukan penyiapan yang kompleks.
Arsitektur serverless dan dukungan untuk SQL standar pada Athena menjadikannya alat yang sangat baik untuk eksplorasi data ad-hoc. Baik Anda seorang data scientist, analis, maupun engineer, Athena memungkinkan Anda dengan cepat melakukan kueri data yang disimpan di S3 tanpa memuatnya ke basis data tradisional.
Seiring organisasi semakin mengadopsi data lake untuk menyimpan sejumlah besar data mentah dan terproses, Athena berperan sebagai mesin kueri yang kuat untuk data lake tersebut. Layanan ini memungkinkan pengguna melakukan analitik langsung pada data yang disimpan di S3, menjadikannya bagian integral dari arsitektur data lake modern.
Athena juga umum digunakan sebagai bagian dari tumpukan business intelligence (BI), di mana layanan ini terintegrasi dengan alat BI seperti Amazon QuickSight untuk memungkinkan visualisasi data dan pelaporan. Dengan melakukan kueri data di S3 menggunakan Athena dan memvisualisasikannya di QuickSight, organisasi dapat membuat dasbor dan laporan interaktif untuk pengambilan keputusan.
Jika Anda familier dengan Amazon Redshift, Anda mungkin bertanya-tanya bagaimana perbedaannya dengan Athena.
Meskipun Athena dan Redshift sama-sama menangani kumpulan data, tujuan keduanya berbeda. Penggunaan utama Redshift adalah data warehousing dan analitik rutin yang melibatkan big data. AWS Athena berfokus pada memungkinkan pengguna melakukan analisis ad hoc pada data yang disimpan di S3.
Berikut perbandingan terperinci Athena vs Redshift:
|
Kriteria |
Amazon Athena |
Amazon Redshift |
|
Arsitektur |
Layanan kueri serverless; menjalankan kueri SQL langsung pada data yang disimpan di Amazon S3 dengan penskalaan otomatis; tanpa pengelolaan infrastruktur. |
Data warehouse terkelola sepenuhnya; memerlukan klaster data warehouse dengan infrastruktur khusus; dapat diskalakan sesuai kebutuhan. Opsi Redshift Serverless tersedia. |
|
Kasus Penggunaan |
Ideal untuk kueri dan analitik ad-hoc pada data S3 serta skenario yang memprioritaskan fleksibilitas dan efisiensi biaya tanpa transformasi data. |
Cocok untuk analitik dan pelaporan kompleks berskala besar; ideal untuk data terstruktur yang sering dikueri dan ditransformasikan. |
|
Struktur Biaya |
Model bayar per kueri: biaya berdasarkan data yang dipindai oleh kueri, sehingga hemat biaya untuk beban kerja yang berselang atau bervariasi. |
Harga berdasarkan ukuran klaster dan penggunaan; harga reserved instance tersedia untuk kueri berkapasitas tinggi yang dapat diprediksi. |
|
Kinerja |
Bergantung pada ukuran dan format data; dioptimalkan melalui partisi dan kompresi; terbaik untuk kueri yang lebih kecil dan kurang kompleks. |
Kinerja tinggi untuk kueri kompleks; menggunakan penyimpanan kolumnar, pemrosesan paralel, dan optimasi lanjutan untuk beban kerja intensif. |
|
Integrasi Data |
Melakukan kueri langsung pada data di S3 tanpa perlu transformasi atau pemuatan; mendukung berbagai format dan konektor yang dapat diperluas, termasuk Redshift. |
Memerlukan data dimuat ke dalam warehouse, terintegrasi dengan layanan AWS, dan mendukung berbagai metode pemasukan data namun hanya membaca dari data yang disimpannya. |
Saatnya praktik langsung, menyiapkan Athena, dan menjalankan beberapa kueri!
Menggunakan AWS Athena memerlukan akun AWS. Jika Anda belum memilikinya, Anda harus membuatnya. Untuk melakukannya, ikuti petunjuk pada panduan penyiapan AWS.
Meskipun tidak ada free tier untuk AWS Athena, Anda seharusnya dapat menjalankan 2-3 kueri uji kecil (~10MB) untuk memahami cara kerja sistem. Ikuti petunjuk di portal dan verifikasi identitas Anda. Lalu masuk ke akun AWS Anda.
Seperti semua produk Amazon AWS, Athena menggunakan kebijakan IAM (identity and access management) untuk izin. Anda akan menjadi pengguna root untuk akun Anda dan seharusnya memiliki izin yang diperlukan untuk menjalankan kueri Athena pada bucket S3 Anda sendiri.
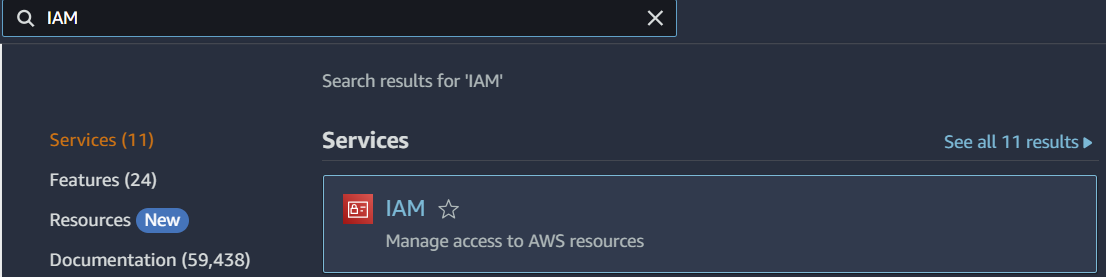
Anda dapat mengelola izin IAM dengan mencari layanan IAM pada bilah pencarian atas di dasbor utama AWS Anda dan menggunakan panduan IAM lengkap ini. Dokumentasi AWS juga menyediakan informasi lebih lanjut tentang penyiapan spesifik Athena.
Sebelum menjalankan kueri, kita perlu menyiapkan bucket S3 untuk menyimpan data kita.
Amazon S3 adalah singkatan dari Simple Storage Service dan merupakan komponen penting dari cara AWS mengelola penyimpanan dan data dalam lingkungan cloud. Dengan mengikuti panduan yang ditulis dengan baik tentang membuat bucket Amazon S3, kita dapat membuat lingkungan penyimpanan untuk data dan kueri kita.
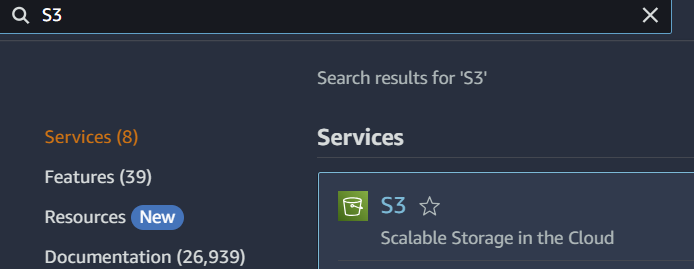
Singkatnya, Anda akan mencari layanan S3 di bilah pencarian untuk menuju beranda S3:
Anda akan melihat tombol “Create Bucket” di bilah sisi kanan pada beranda. Mengikuti petunjuk pada halaman ini, Anda akan membuat bucket yang memungkinkan layanan Athena menyimpan hasil kueri.
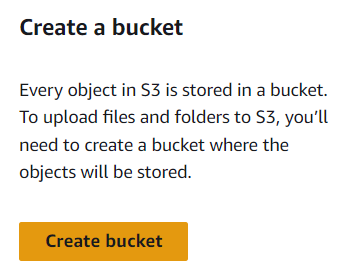
Saya akan membuat bucket bernama “athenadatacampguide” dengan semua opsi default lainnya. Karena bucket harus unik secara global di seluruh AWS, Anda harus memilih nama lain untuk tutorial ini.
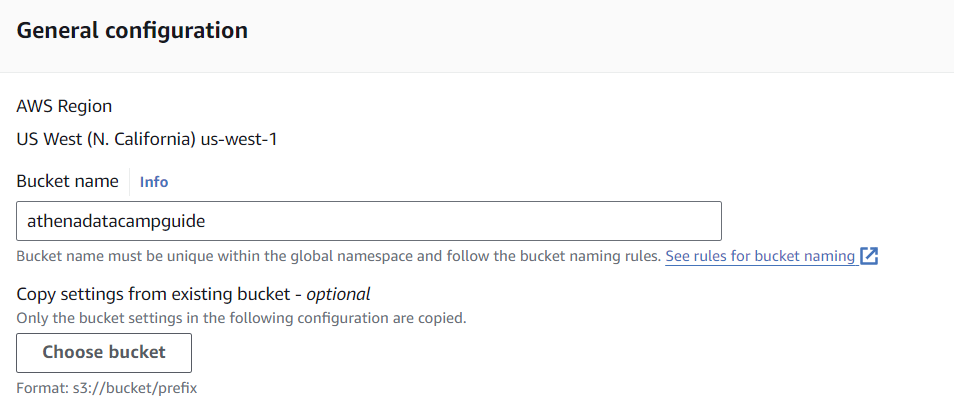
Sekarang, kita perlu menghubungkan bucket ini ke Athena. Saya akan menuju konsol Athena dan klik “Edit Settings” pada bilah notifikasi kecil di dekat bagian atas.
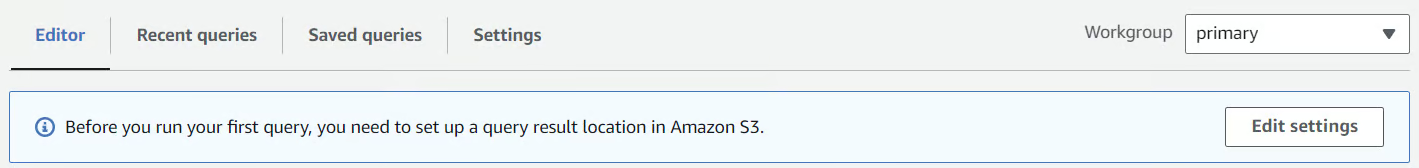
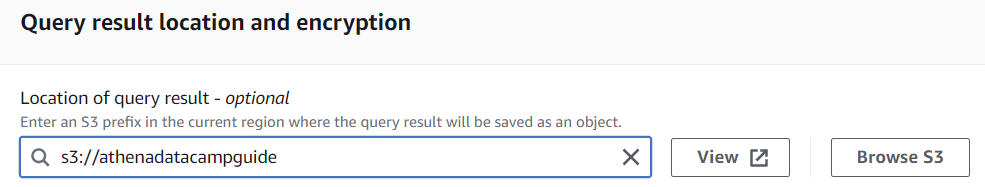
Saya kemudian akan memilih bucket yang baru saja saya buat. Untuk menemukan bucket Anda, gunakan tombol “Browse S3” di sebelah kanan atau ketik namanya dengan awalan “s3://”.
Setelah bucket dipilih, klik “Save” dan kembali ke Editor dengan mengkliknya di bilah alat atas.
AWS Athena mengatur data secara hierarkis. Layanan ini menggunakan “data catalog,” sekumpulan database yang juga dikenal sebagai skema.
Tabel yang sebenarnya kita kueri berada di dalam database. Untuk membuat data catalog baru, Anda bisa menggunakan Amazon Lambda dan terhubung ke sumber data eksternal. Data catalog kemudian dapat disimpan sebagai data catalog Lambda, Hive, atau Glue.
Default di AWS adalah menggunakan layanan Glue sebagai repositori data catalog pusat. Kita akan fokus membangun database yang akan menampung tabel-tabel untuk dikueri.
Di Editor, buka panel Query Editor. Di sinilah kita akan menulis kueri untuk membuat database, melakukan kueri pada tabel, dan menjalankan analitik.
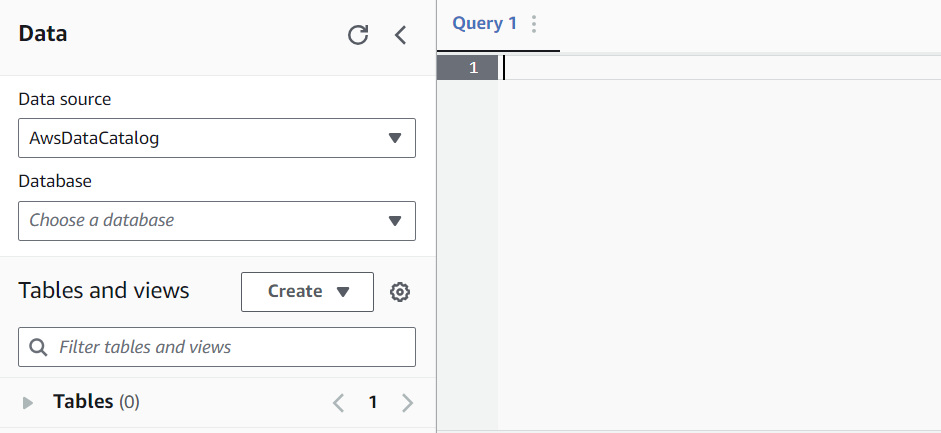
Untuk membuat database pertama kita, kita akan menjalankan kueri berikut:
CREATE DATABASE mydatabaseMenjalankan kueri ini akan memungkinkan Anda memilih database dari menu tarik-turun di bawah “Database” pada bilah sisi kiri.
Sekarang setelah kita memiliki database, kita akan fokus membuat tabel agar kita memiliki sesuatu untuk dikueri!
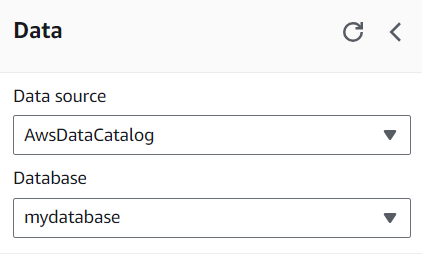
Memasukkan data ke database Anda akan sedikit berbeda bergantung pada penyiapan AWS Anda. Anda dapat memanfaatkan data yang disimpan di data warehouse seperti Redshift atau data streaming menggunakan AWS Kinesis dan Lambda untuk menghasilkan data tabular.
Hari ini, kita akan menggunakan data contoh dari sampel AWS Cloudfront Logs. Karena kompleksitas datanya, sebagian proses pembuatan menggunakan grup RegEx untuk mengurai data URL ke dalam kolom.
Dengan SQL berikut, kita dapat membuat tabel. Catatan: di bawah ini, ganti “myregion” dengan wilayah AWS Anda.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Jika tabel muncul di bilah sisi kiri, Anda siap memulai melakukan kueri!
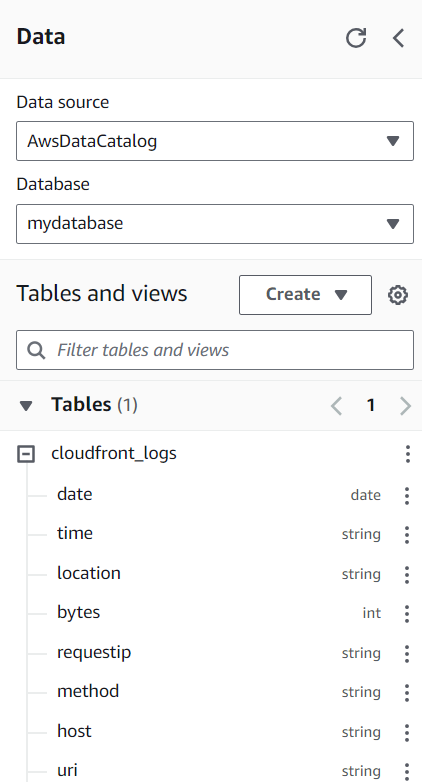
Menulis kueri di Athena mirip dengan menulis kueri di SQL tradisional. Anda cukup menulis dan mengirimkan kueri ke Athena, dan hasil yang diinginkan akan dikembalikan.
Salah satu praktik terbaik adalah menulis pernyataan FROM dengan sintaks berikut: “DataSource”.”database”.”table”. Dengan begitu, tidak akan ada kebingungan mengenai asal data.
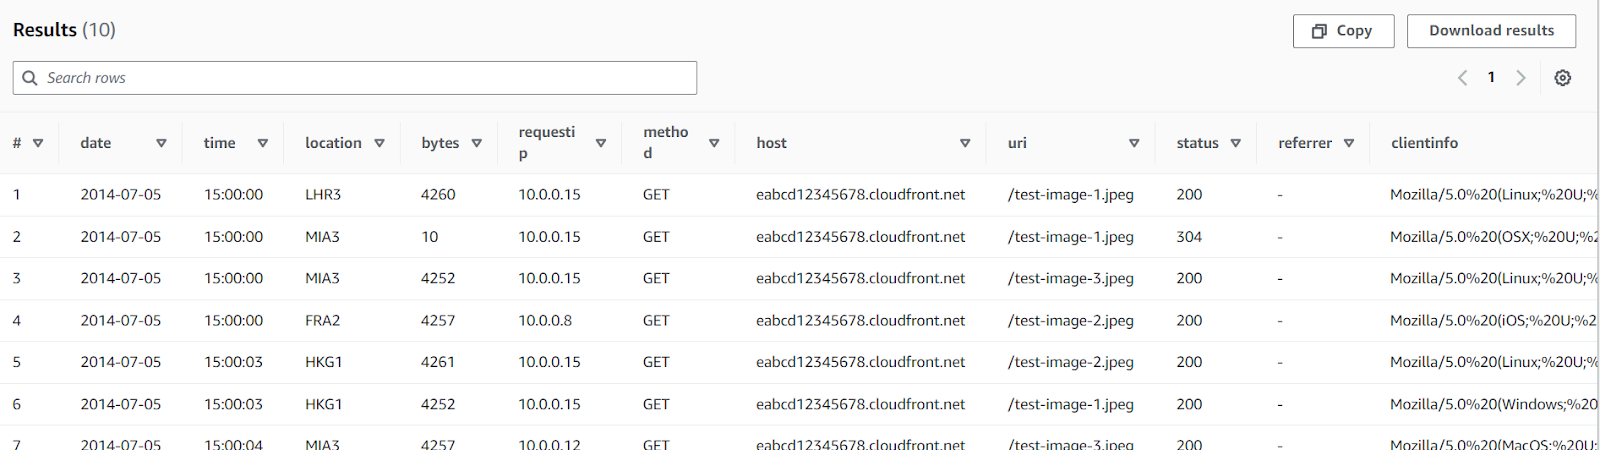
Mari coba pernyataan SELECT sederhana untuk memulai.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
Ini akan mengembalikan tabel dengan 10 hasil. Athena memungkinkan Anda menyalin atau mengunduh hasilnya. Pada saat yang sama, hasil ini disimpan ke bucket S3 yang Anda hubungkan ke layanan Athena Anda.
Kita bahkan bisa menulis kueri GROUP BY sederhana. Yang satu ini, khususnya, memberi tahu kita berapa banyak requestip (tidak harus unik) yang terlibat dengan metode HTTP tertentu.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Cara yang bagus untuk memanfaatkan Athena adalah untuk kueri yang lebih kompleks seperti window function. Berkat optimasi Athena, kita dapat melakukan komputasi yang rumit dengan lebih cepat.
Misalnya, kita dapat menggunakan Athena untuk menghasilkan ROW NUMBER() untuk setiap rekaman yang dipartisi berdasarkan wilayah dan tanggalnya serta diurutkan berdasarkan waktu menurun. Kita kemudian dapat memilih rekaman terbaru untuk setiap wilayah dan tanggal menggunakan filter WHERE untuk memilih baris pertama.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Ini baru permulaan dengan Athena. Anda dapat terus menulis kueri apa pun yang menurut Anda akan memungkinkan Anda memanfaatkan kapabilitas Athena.
Seperti alat pemrosesan data lainnya, AWS Athena memerlukan serangkaian praktik terbaik. Praktik ini tidak hanya akan memudahkan pekerjaan Anda tetapi juga meningkatkan kinerjanya.
Selain itu, karena AWS adalah layanan berbasis cloud dan pengguna dikenai biaya berdasarkan berbagai faktor penyimpanan dan komputasi, praktik ini dapat menghasilkan penghematan biaya yang signifikan!
Berbagai format data lebih nyaman digunakan di AWS Athena. Karena Athena menarik data dari bucket S3, memilih format data yang mudah dibaca dan terkompresi akan meningkatkan kinerja dan biaya.
Data mentah yang disimpan dalam CSV mungkin paling sederhana tetapi tidak efisien. Menyimpan data kita dalam format terkompresi seperti Parquet atau ORC akan menghemat biaya pembacaan data.
Manfaat tambahan Parquet dan ORC adalah kompresi berbasis kolomnya. Optimizer Athena memungkinkan layanan ini hanya mencari kolom data tertentu alih-alih memproses seluruh tabel untuk melakukan perhitungan.
Mempartisi data berarti membagi dataset secara teratur berdasarkan kunci tertentu, seperti tanggal. Misalnya, kita mungkin memiliki partisi harian di mana data diatur untuk secara otomatis dibagi dan disimpan per hari.
Saat data kita dipartisi, mesin SQL dapat melakukan optimasi yang lebih baik dengan melihat partisi yang relevan. Ini secara langsung meningkatkan pengurangan jumlah data yang dipindai, menurunkan biaya keseluruhan.
Meskipun beberapa kompleksitas diharapkan saat melakukan analisis data, mengoptimalkan kueri dapat membantu mengurangi waktu komputasi dan biaya. Sebagian biaya tidak berasal langsung dari Athena melainkan dari layanan lain yang digunakan oleh AWS Athena.
Komponen utama biaya Athena adalah pemindaian dan pemrosesan data, tetapi Anda mungkin menimbulkan biaya dari S3 jika menyimpan hasil yang sangat besar. Kita juga dapat meningkatkan kinerja kueri dan mengurangi biaya dengan memastikan kueri dioptimalkan mengikuti praktik terbaik SQL yang lazim.
Misalnya, semua hal berikut akan membantu dalam optimasi:
SELECT * jika memungkinkanLIMIT saat menguji kueriPraktik terbaik ini akan meningkatkan kinerja kueri dan mengurangi biaya!
AWS Athena dapat terhubung ke Amazon CloudWatch untuk menyimpan metrik kueri. Kita dapat menemukan kueri yang tidak efisien atau masalah dengan melihat log kinerja kueri.
Seperti disebutkan, AWS Athena terintegrasi dengan beberapa layanan AWS lainnya, meningkatkan kemampuan pengkatalogan data, visualisasi, pemrosesan, dan warehousing.
Di bawah ini adalah cara Athena bekerja dengan layanan seperti AWS Glue, Amazon QuickSight, AWS Lambda, dan Amazon Redshift.
Saat diintegrasikan dengan AWS Athena, AWS Glue menjadi repositori metadata pusat yang secara otomatis mengatalogkan data di Amazon S3. Integrasi ini menghilangkan kebutuhan definisi skema manual, sehingga memperlancar proses kueri data di Athena.
Glue juga menyediakan kemampuan ETL, mentransformasikan dan menyiapkan data untuk kueri optimal di Athena dengan mengotomatiskan tugas seperti kompresi data, partisi, dan konversi format, sehingga memastikan pemrosesan data yang efisien dan efektif.
Amazon QuickSight terintegrasi dengan AWS Athena untuk mengubah hasil kueri menjadi dasbor dan laporan interaktif. Koneksi ini memungkinkan Anda memvisualisasikan data langsung dari kueri Athena, sehingga pembuatan insight visual menjadi cepat dan mudah.
QuickSight mendukung fitur seperti penyegaran data otomatis dan analitik lanjutan, menjadikannya alat yang ampuh untuk mengeksplorasi dan menyajikan data.
AWS Lambda mengotomatiskan alur kerja pemrosesan data dengan Athena dalam lingkungan serverless. Fungsi Lambda dapat memicu kueri Athena sebagai respons terhadap peristiwa, seperti data baru di S3, sehingga memungkinkan pemrosesan real-time.
Lambda juga dapat mengotomatiskan tindakan selanjutnya berdasarkan hasil kueri, menciptakan alur kerja berbasis peristiwa yang dapat diskalakan tanpa intervensi manual.
Sementara Athena ideal untuk kueri ad-hoc data S3, Amazon Redshift menawarkan solusi analitik yang kuat, terstruktur, dan kompleks. Anda dapat menggunakan Athena untuk analisis cepat data mentah dan Redshift untuk kueri yang lebih intensif dan berkinerja tinggi.
Integrasinya memungkinkan perpindahan data antara S3 dan Redshift, memanfaatkan keunggulan keduanya untuk solusi analitik yang komprehensif.
AWS Athena adalah mesin kueri yang kuat yang terintegrasi langsung dalam ekosistem AWS. Dengan memungkinkan pengguna mengakses data yang disimpan di bucket S3 dengan cepat sambil menyimpan hasil kueri ke bucket S3, AWS Athena memberdayakan pengguna untuk menyelami data mereka dengan lebih fleksibel. Layanan ini memetik manfaat dari layanan AWS lainnya, seperti bersifat serverless, skalabel, dan sederhana.
Jika Anda ingin mempelajari lebih lanjut tentang AWS, DataCamp menawarkan berbagai sumber daya:
Pelajari lebih lanjut tentang AWS dan data engineering dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



