बिग-ओ नोटेशन और टाइम कॉम्प्लेक्सिटी गाइड: सहज समझ और गणित
टाइम कॉम्प्लेक्सिटी यह मापती है कि इनपुट आकार के साथ किसी एल्गोरिद्म का रनटाइम कैसे स्केल करता है, जिसे अक्सर बिग-ओ नोटेशन से व्यक्त किया जाता है, जो सबसे बुरे हालात के लिए ऊपरी सीमा देता है।
टाइम कॉम्प्लेक्सिटी विश्लेषण, एल्गोरिद्म की कार्यक्षमता का विश्लेषण और पूर्वानुमान लगाने का एक तरीका देता है जो न तो उस भाषा पर निर्भर करता है जिसमें हम उन्हें लागू करते हैं और न ही उस हार्डवेयर पर जिस पर उन्हें चलाया जाता है।
टाइम कॉम्प्लेक्सिटी विश्लेषण का लक्ष्य किसी एल्गोरिद्म के सटीक रनटाइम की भविष्यवाणी करना नहीं है, बल्कि इन प्रश्नों का उत्तर देने में सक्षम होना है:
यदि एक ही समस्या को हल करने वाले दो एल्गोरिद्म हों, तो समान मात्रा का डेटा मिलने पर कौन-सा तेज चलेगा?
यदि हम एल्गोरिद्म को दिए गए डेटा को दोगुना कर दें, तो निष्पादन समय पर क्या प्रभाव पड़ेगा? क्या यह रैखिक रूप से स्केल होकर दोगुना हो जाएगा? क्या यह वैसा ही रहेगा? या कुछ और?
इस लेख के अंत तक, आप किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी का विश्लेषण करना और इन प्रश्नों का उत्तर देना सीख जाएंगे।
क्या 2024 में टाइम कॉम्प्लेक्सिटी अभी भी मायने रखती है?
कंप्यूटर लगातार तेज हो रहे हैं, तो कोई पूछ सकता है कि क्या अब टाइम कॉम्प्लेक्सिटी की चिंता करने की कोई ज़रूरत है। क्या आजकल कोई भी सुपरकंप्यूटर, हम जो भी एल्गोरिद्म इस्तेमाल करें, उससे बेपरवाह होकर किसी भी समस्या को संभाल सकता है?
खैर, पूरी तरह नहीं। हालिया वर्षों में हार्डवेयर प्रदर्शन में भारी प्रगति से एआई का उभार हुआ है। फिर भी, सबसे उन्नत हार्डवेयर पर भी, यदि धीमा एल्गोरिद्म अपनाया जाए, तो साधारण समस्याएं भी विनाशकारी प्रदर्शन दे सकती हैं।
उदाहरण के लिए, कल्पना करें कि आप दस मिलियन प्रविष्टियों वाली डेटाबेस तालिका को सॉर्ट करने के लिए एक भोला-भाला एल्गोरिद्म इस्तेमाल कर रहे हैं। आधुनिक कंप्यूटर पर भी, यह सरल-सा ऑपरेशन पूरा होने में कई दिनों लेगा, जिससे डेटाबेस किसी भी व्यावहारिक अनुप्रयोग के लिए अनुपयोगी हो जाएगा। इसके विपरीत, एक कुशल एल्गोरिद्म का उपयोग करके, हम उम्मीद कर सकते हैं कि इसमें एक-दशमलव सेकंड से भी कम समय लगेगा।
बेसिक ऑपरेशंस और बेसिक इंस्ट्रक्शंस
हम Random Access Machine (RAM या RA-machine) मॉडल का उपयोग करके एल्गोरिद्म का विश्लेषण करते हैं। यह मॉडल मानता है कि निम्नलिखित ऑपरेशंस को ठीक एक टाइम स्टेप लगता है:
अंकगणितीय ऑपरेशंस
लॉजिक ऑपरेशंस (<, >, ==, आदि)
स्टेटमेंट्स जैसे ifया return
किसी मेमोरी लोकेशन तक पहुँचना, जैसे किसी वेरिएबल का मान लिखना या पढ़ना
इन ऑपरेशंस को बेसिक ऑपरेशंस कहा जाता है। कोड की वह पंक्ति जो एक नियत संख्या में बेसिक ऑपरेशंस चलाती है, उसे बेसिक इंस्ट्रक्शन कहा जाता है।
क्योंकि किसी बेसिक इंस्ट्रक्शन में ऑपरेशंस की संख्या नियत होती है, यह डेटा की मात्रा पर निर्भर नहीं करती। चूँकि हमें इस बात की परवाह है कि डेटा की मात्रा बढ़ने पर निष्पादन समय कैसे बढ़ता है, हम एल्गोरिद्म द्वारा किए गए बेसिक इंस्ट्रक्शंस की संख्या गिनने पर ध्यान केंद्रित कर सकते हैं।
फंक्शन कॉल्स और for और while जैसे लूप्स का मूल्यांकन, उनके अंदर मौजूद बेसिक इंस्ट्रक्शंस की संख्या जोड़कर किया जाता है। निम्नलिखित कोड पर विचार करें जो सूची के तत्वों का योग करता है।
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionसंचालित द्वारा
हमने प्रत्येक पंक्ति में टिप्पणियां जोड़कर बेसिक इंस्ट्रक्शंस की संख्या दिखाने में मदद की है। यदि N, lst की लंबाई है, तो बेसिक इंस्ट्रक्शंस की कुल संख्या 1 + N + 1 = N + 2 है।
बिग-ओ नोटेशन
मान लीजिए हमारे पास दो सॉर्टिंग एल्गोरिद्म हैं। हमने प्रत्येक के लिए बेसिक इंस्ट्रक्शंस की संख्या निकाली और निम्नलिखित अभिव्यक्तियाँ पाईं:
पहला एल्गोरिद्म
दूसरा एल्गोरिद्म
4N2 + 2N + 7
3N2 + 5N + 13
पहली नज़र में यह स्पष्ट नहीं है कि कौन-सा बेहतर स्केल करता है। बिग-ओ नोटेशन इन अभिव्यक्तियों को और सरल करने का एक तरीका देता है, इन सरलीकरणों को लागू करके:
कम घातांक वाले पद हटा दें
गुणांक स्थिरांक हटा दें
यदि हम यह प्रक्रिया दोनों अभिव्यक्तियों पर लागू करें, तो दोनों मामलों में N2 मिलता है:
सरलीकरण के बाद प्राप्त अभिव्यक्ति एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी होती है, जिसे हम O() से निरूपित करते हैं। इस मामले में, हम लिख सकते हैं कि 4N2 + 2N + 7 = O(N2) और 3N2 + 5N + 13 = O(N2)। इसका मतलब है कि दोनों एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी समान है, जो सूची के तत्वों की संख्या के वर्ग के अनुपात में है।
ऊपर, हमने गणना की कि sum_list एल्गोरिद्म ने N + 2 ऑपरेशंस किए, जहाँ N सूची की लंबाई है। वही सरलीकरण लागू करने पर, N प्राप्त होता है, इसलिए sum_list की टाइम कॉम्प्लेक्सिटी O(N) है।
इसका मतलब है कि निष्पादन समय सूची के आकार के अनुपात में है। यह अपेक्षित है क्योंकि योग निकालते समय, किसी सूची में तत्वों की संख्या दोगुनी होने पर दोगुना काम होना चाहिए—न कम, न ज़्यादा।
बिग-ओ नोटेशन: सहज व्याख्या
हम निचले पदों को नज़रअंदाज़ कर सकते हैं क्योंकि N बढ़ने पर, उच्चतम पद की तुलना में उनका योगदान नगण्य हो जाता है। निम्न प्लॉट तीन पदों 4N2, 2N और 7 के कुल योग में योगदान को दिखाता है।
द्विघात पद 4N2 बहुत जल्दी, छोटे N के लिए भी, कुल ऑपरेशंस में लगभग 100% का योगदान देने लगता है। इसलिए, बड़े डेटा के साथ काम करते समय, निचले-क्रम के पदों का समय, उच्च-क्रम के पदों की तुलना में नगण्य होगा।
हम गुणांक स्थिरांक को हटाते हैं क्योंकि यह मान डेटा की मात्रा से स्वतंत्र होता है।
बिग-ओ नोटेशन: गणितीय परिभाषा
उपरोक्त कदम अधिकांश व्यावहारिक उद्देश्यों के लिए किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी सही ढंग से निकालने के लिए पर्याप्त हैं। हम एल्गोरिद्म द्वारा किए गए बेसिक इंस्ट्रक्शंस गिनते हैं और कोई अभिव्यक्ति f(N) प्राप्त करते हैं। दो सरलीकरणों के बाद, एक सरल अभिव्यक्ति g(N) मिलती है। तब हम लिख सकते हैं f(N) = O(g(N))। इसे हम "+f is big O of g+" के रूप में पढ़ते हैं।
हालाँकि, यह औपचारिक गणितीय परिभाषा नहीं है, और कुछ मामलों में यह पर्याप्त नहीं होती।
गणितीय परिभाषा यह है कि एक धनात्मक फलन f(N) = O(g(N)) तब होता है जब हम कोई स्थिरांक C ढूँढ़ सकें ताकि बड़े N के लिए निम्न शर्त पूरी हो:
f(N) ≤ C × g(N)
हम इस परिभाषा का उपयोग करके दिखा सकते हैं कि f(N) = 4N2 + 2N + 7 = O(N2)। इस मामले में, हम C = 5 चुन सकते हैं और देख सकते हैं कि किसी भी N > 4 के लिए, f(N) ≤ 5 × N2:
व्यवहार में, हम ऊपर दिए सरलीकरण नियमों का ही उपयोग करेंगे।
टाइम कॉम्प्लेक्सिटी के प्रकार
अब जब हमें बिग-ओ नोटेशन की मूल बातें समझ आ गई हैं, तो आइए सामान्य टाइम कॉम्प्लेक्सिटीज़ और उनके निहितार्थों का अन्वेषण करें, सबसे कुशल से शुरू करते हुए: स्थिर समय।
कॉनस्टेंट टाइम: O(1)
जैसा कि नाम से स्पष्ट है, कॉनस्टेंट-टाइम एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी स्थिर होती है, यानी उनका प्रदर्शन डेटा की मात्रा पर निर्भर नहीं करता। ये एल्गोरिद्म आमतौर पर निश्चित संख्या के इनपुट्स के साथ गणनाओं में शामिल होते हैं, जैसे दो बिंदुओं के बीच की दूरी निकालना।
दो बिंदुओं के बीच की दूरी, उनके x और y निर्देशांकों के अंतर का वर्गमूल निकालकर तय की जाती है।
dist फंक्शन नीचे दिखाया गया है जो दो बिंदुओं के बीच दूरी निकालता है। यह तीन बेसिक इंस्ट्रक्शंस से बना है, जो एक स्थिर संख्या है। इस मामले में, हम लिखते हैं कि टाइम कॉम्प्लेक्सिटी O(1) है।
defdist(p, q):
dx =(p[0]- q[0])**2# 1 instruction
dy =(p[1]- q[1])**2# 1 instructionreturn(dx + dy)**0.5# 1 instructionसंचालित द्वारा
दिलचस्प बात यह है कि कोई फंक्शन बड़े डेटासेट्स पर काम करते हुए भी कॉनस्टेंट टाइम कॉम्प्लेक्सिटी दिखा सकता है। उदाहरण के लिए, len फंक्शन से किसी सूची की लंबाई निकालना O(1) होता है, क्योंकि उसके इम्प्लिमेंटेशन में आंतरिक रूप से सूची के आकार का हिसाब रखा जाता है—हर बार तत्वों को गिनने की ज़रूरत नहीं पड़ती।
लिनियर टाइम: O(N)
हम पहले sum_list को एक लिनियर टाइम फंक्शन के उदाहरण के रूप में चर्चा कर चुके हैं। सामान्यतः, लिनियर टाइम एल्गोरिद्म वे कार्य करते हैं जिनमें हर डेटा पॉइंट को अलग-अलग देखना आवश्यक होता है। न्यूनतम, अधिकतम या औसत निकालना इस श्रेणी के सामान्य ऑपरेशंस हैं।
आइए सूची का न्यूनतम मान निकालने वाले निम्न फंक्शन का विश्लेषण करके अभ्यास करें:
यदि सूची में N तत्व हैं, तो जटिलता 1 + (N - 1) + 1 = N + 1 = O(N) है।
लिनियर टाइम एल्गोरिद्म का निष्पादन समय सीधे डेटा की मात्रा के अनुपात में होता है। इसलिए, यदि डेटा दोगुना हो जाए, तो एल्गोरिद्म को डेटा प्रोसेस करने में लगने वाला समय भी दोगुना होना चाहिए।
लॉगरिदमिक टाइम: O(log(N))
नंबर-गेसिंग गेम में 1 और N के बीच छिपे नंबर का अनुमान लगाना होता है, जिसका उद्देश्य संभवतः सबसे कम प्रयासों में उसे पहचानना है। हर अनुमान के बाद हमें यह फीडबैक मिलता है कि छिपा नंबर हमारे अनुमान से बड़ा है, छोटा है या वही है। यदि अनुमान सही हुआ, तो हम गेम जीत जाते हैं; अन्यथा, हम अनुमान लगाते रहते हैं।
इस गेम के लिए एक प्रभावी रणनीति हमेशा मध्य मान का अनुमान लगाना है। मान लें N = 15। इस स्थिति में, हमारा पहला अनुमान 8 होगा। यदि गुप्त नंबर 8 से छोटा है, तो हमें पता है कि वह 1 और 7 के बीच होगा। यदि बड़ा है, तो 9 और 15 के बीच। हम शेष रेंज के मध्य का अनुमान तब तक लगाते रहते हैं जब तक सही उत्तर न मिल जाए। नीचे का डायग्राम इस रणनीति के संभावित रास्तों को दिखाता है।
आइए इस विधि की टाइम कॉम्प्लेक्सिटी देखें। पहले के उदाहरणों के विपरीत, इस एल्गोरिद्म के कदमों की संख्या केवल इनपुट आकार N पर निर्भर नहीं करती, क्योंकि पहली कोशिश में सही अनुमान होने की संभावना रहती है।
ऐसे एल्गोरिद्म का विश्लेषण करते समय, हम सबसे बुरी स्थिति पर ध्यान केंद्रित करते हैं। उदाहरण के लिए, N = 15 होने पर, सबसे बुरी स्थिति में हमें 4 अनुमान लगाने पड़ेंगे। हर बार मध्य मान का अनुमान लगाकर शेष संभावनाओं का आधा समाप्त हो जाता है। सबसे बुरी स्थिति में हम तब तक अनुमान लगाते रहते हैं जब तक केवल एक संभावना न रह जाए। इसलिए, हमें यह प्रश्न हल करना है:
N को 2 से कितनी बार भाग दें कि 1 प्राप्त हो?
उत्तर है N का आधार-2 लघुगणक, जिसे log2(N) से निरूपित किया जाता है। सही संख्या पहचानने के लिए प्रयुक्त एल्गोरिद्म को बाइनरी सर्च कहा जाता है। चूँकि अधिकतम अनुमान log2(N) हैं, हम इसकी कॉम्प्लेक्सिटी O(log2(N)) या सरलता से O(log(N)) लिख सकते हैं, क्योंकि टाइम कॉम्प्लेक्सिटी नोटेशन में स्थिरांक अप्रासंगिक होते हैं।
बेहद धीमी वृद्धि दर के कारण, लॉगरिदमिक टाइम कॉम्प्लेक्सिटी व्यवहार में बहुत वांछनीय होती है, जो लगभग कॉनस्टेंट टाइम जैसी लगती है। बड़े N के लिए भी, कुल ऑपरेशंस की संख्या आश्चर्यजनक रूप से कम रहती है। उदाहरण के लिए, N एक बिलियन होने पर भी, आवश्यक ऑपरेशंस केवल लगभग 30 होते हैं।
बाइनरी सर्च कंप्यूटर विज्ञान में एक बुनियादी एल्गोरिद्म है जिसके कई अनुप्रयोग हैं। उदाहरण के लिए, नेचुरल लैंग्वेज प्रोसेसिंग में, स्पेल चेकर और ऑटोकरेक्ट सिस्टम संभावित शब्दों को कुशलतापूर्वक पहचानने के लिए बाइनरी सर्च के विभिन्न संस्करणों का उपयोग कर सकते हैं।
क्वाड्रेटिक टाइम: O(N2)
डेटा को सॉर्ट करना एक बुनियादी काम है जिसे कंप्यूटर अक्सर करते हैं। N संख्याओं की सूची को सॉर्ट करने का एक तरीका सूची के न्यूनतम तत्व को बार-बार पहचानना है।
defselection_sort(lst):
sorted_lst =[]# 1 instructionfor _ inrange(len(lst)):
minimum =min(lst)# executed len(lst) times
lst.remove(minimum)# executed len(lst) times
sorted_lst.append(minimum)# executed len(lst) timesreturn sorted_lst # 1 instructionसंचालित द्वारा
किसी for लूप की जटिलता का विश्लेषण करने के लिए, हम उसके अंदर मौजूद इंस्ट्रक्शंस की जटिलता निकालते हैं और फिर उसे लूप के इटरेशंस की संख्या से गुणा करते हैं।
किसी सूची का न्यूनतम निकालना और सूची से कोई तत्व हटाना, दोनों O(N) ऑपरेशंस हैं। ऐपेंड करना कॉनस्टेंट टाइम O(1) में होता है। इसलिए, लूप के प्रत्येक इटरेशन की जटिलता O(N + N + 1) = O(2N + 1) है, जो O(N) में सरल हो जाती है। चूँकि N इटरेशंस हैं, कुल जटिलता N × O(N) = O(N2) है। selection_sort() का बाकी हिस्सा तीन सरल इंस्ट्रक्शंस से बना है, इसलिए समग्र जटिलता O(N2 + 3) = O(N2) है।
हमारा for लूप का विश्लेषण एक सरलीकरण था। हर इटरेशन में, हम सूची से एक तत्व निकालते हैं, यानी सभी इटरेशंस समान संख्या में इंस्ट्रक्शंस नहीं चलाते। पहला इटरेशन N इंस्ट्रक्शंस चलाता है, दूसरा N - 1, तीसरा N - 2, और यह क्रम चलता रहता है, जब तक कि अंतिम इटरेशन में केवल 1 इंस्ट्रक्शन न चले।
इसका मतलब है कि for लूप की वास्तविक जटिलता यह है:
N + (N - 1) + (N - 2) + … + 1
यह योग (N2 + N) / 2 के बराबर दिखाया जा सकता है। हालांकि,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
भले ही हमने अधिक गिना, समग्र जटिलता फिर भी द्विघात है। selection_sort() फंक्शन अपनी द्विघात जटिलता O(N2) के कारण एक धीमे सॉर्टिंग एल्गोरिद्म का उदाहरण है।
द्विघात जटिलता वाले फंक्शंस बुरी तरह स्केल होते हैं—ये छोटी सूचियों के लिए उपयुक्त हैं, पर लाखों डेटा पॉइंट्स को सॉर्ट करने के लिए अव्यावहारिक, क्योंकि इसमें दिनों लग सकते हैं। डेटा दोगुना होने पर निष्पादन समय चार गुना हो जाता है।
लॉग-लीनियर टाइम: O(Nlog(N))
ऐसा एल्गोरिद्म बनाया जा सकता है जो सूची को O(N log(N)) टाइम कॉम्प्लेक्सिटी में सॉर्ट करे। ऐसा ही एक एल्गोरिद्म मर्ज सॉर्ट कहलाता है। हम इसके इम्प्लिमेंटेशन के विवरण में नहीं जाएंगे, पर यदि आप और सीखना चाहें, तो इस मर्ज सॉर्ट का त्वरित परिचय और इस कोर्स Data Structures and Algorithms in Python देखें।
जैसा पहले बताया, व्यवहार में लॉगरिदमिक जटिलता लगभग कॉनस्टेंट जैसी ही रहती है। इसलिए O(N log(N)) एल्गोरिद्म का निष्पादन समय, वास्तविक अनुप्रयोगों में, लिनियर-टाइम एल्गोरिद्म के बराबर हो सकता है।
निम्न प्लॉट दिखाता है कि N log(N) और N समान दर से बढ़ते हैं, जबकि N2 बहुत तेज़ी से बढ़ता है और शीघ्र ही बहुत धीमा (कुशलता में) हो जाता है।
क्यूबिक टाइम: O(N3)
एआई में व्यापक रूप से प्रयुक्त क्यूबिक टाइम जटिलता वाला एल्गोरिद्म मैट्रिक्स गुणन है, जो GPT जैसे बड़े भाषा मॉडलों की कार्यक्षमता में अहम भूमिका निभाता है। यह एल्गोरिद्म प्रशिक्षण और इन्फरेंस, दोनों चरणों में होने वाली गणनाओं के लिए महत्वपूर्ण है।
दो N x N मैट्रिक्स, A और B, का गुणन करने के लिए, हमें पहले मैट्रिक्स A की प्रत्येक पंक्ति को दूसरे मैट्रिक्स B के प्रत्येक स्तंभ से गुणा करना होता है। विशेष रूप से, उत्पाद के (i, j) स्थान का मान, A की iवीं पंक्ति के तत्वों और B के jवें स्तंभ के तत्वों के गुणनों के योग से निर्धारित होता है।
यह रहा मैट्रिक्स गुणन का Python इम्प्लिमेंटेशन:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionसंचालित द्वारा
कुल मिलाकर, matrix_mul() N3 + N2 + 2 इंस्ट्रक्शंस चलाता है, इसलिए इसकी टाइम कॉम्प्लेक्सिटी O(N3) है।
वैकल्पिक रूप से, हम गणनाओं के बारे में तर्क करके भी जटिलता का विश्लेषण कर सकते थे। मैट्रिक्स गुणन का परिणाम N2 एंट्रीज़ रखता है। प्रत्येक एंट्री की गणना में O(N) समय लगता है, इसलिए समग्र जटिलता N2 × O(N) = O(N3) है।
क्यूबिक टाइम एल्गोरिद्म काफी धीमे होते हैं। डेटा दोगुना होने पर निष्पादन समय आठ गुना हो जाता है, जिससे ऐसे एल्गोरिद्म बहुत बुरी तरह स्केल होते हैं। अपेक्षाकृत छोटे N के लिए भी, इंस्ट्रक्शंस की संख्या बहुत तेज़ी से बढ़ जाती है।
मैट्रिक्स गुणन एक ऐसा संगणनात्मक चुनौती का उदाहरण है जहाँ हार्डवेयर में प्रगति ने भारी प्रभाव डाला है। हालाँकि मैट्रिक्स गुणन के थोड़े अधिक कुशल एल्गोरिद्म मौजूद हैं, पर मुख्यतः GPU चिप्स के डिज़ाइन में प्रगति—जो खास तौर पर मैट्रिक्स गुणन के लिए तैयार किए गए—ने GPT जैसे बड़े मॉडलों के प्रशिक्षण को वाजिब समयसीमा में संभव बनाया है।
हाल में, शोधकर्ताओं ने बड़े लर्निंग मॉडलों से मैट्रिक्स गुणन हटाने का प्रस्ताव रखा है—इसके बारे में अधिक पढ़ने के लिए यह लेख देखें: MatMul-Free LLMs: Key Concepts Explained।
घातीय टाइम कॉम्प्लेक्सिटी: O(2N) और O(N!)
घातीय समय वाले एल्गोरिद्म आमतौर पर तब उत्पन्न होते हैं जब किसी समस्या को सभी संभावित हलों की जाँच करके सुलझाया जाता है। मान लें कि किसी डिलीवरी ट्रक को N डिलीवरी स्थानों पर जाना है। इस समस्या को हल करने का एक तरीका है हर संभव डिलीवरी क्रम का मूल्यांकन करना। Python का itertools पैकेज सूची की सभी क्रमचयों (permutations) पर चक्र लगाने का आसान तरीका देता है।
import itertools
for order in itertools.permutations([1,2,3]):print(order)संचालित द्वारा
लंबाई N की सूची के क्रमचयों की संख्या को N! से निरूपित किया जाता है, जिसे "N फैक्टोरियल" पढ़ते हैं। फैक्टोरियल फलन घातीय वृद्धि दिखाता है। उदाहरण के लिए, N = 13 होने पर, क्रमचयों की संख्या 1 बिलियन से अधिक हो जाती है।
मान लें डिलीवरी स्थान 2D बिंदुओं की सूची के रूप में दिए गए हैं। ऐसी स्थिति में, हम सभी संभावित क्रमों से गुजरते हुए और सर्वश्रेष्ठ का हिसाब रखते हुए कुल दूरी को न्यूनतम करने वाला डिलीवरी क्रम निर्धारित कर सकते हैं।
defoptimize_route(locations):
minimum_distance =float("inf")# 1 instruction
best_order =None# 1 instructionfor order in itertools.permutations(locations):# N! iterations
distance =0# 1 instruction, N! timesfor i inrange(1,len(order)):
distance += dist(order[i -1], order[i])# N-1 instructions, N! timesif distance < minimum_distance:
distance = minimum_distance # 1 instruction, N! times
best_order = order # 1 instruction, N! timesreturn best_order # 1 instructionसंचालित द्वारा
पहला for लूप N! बार चलता है। इसलिए, optimize_route() में ऑपरेशंस की संख्या N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3 है।
हमने सीखा कि टाइम कॉम्प्लेक्सिटी निकालते समय, हम कम घातांक वाले पदों को नज़रअंदाज़ करते हैं। लेकिन यहाँ हमें N! पद मिलता है, जो N की घात नहीं है। हम अपने सरलीकरण नियमों को इस तरह परिष्कृत कर सकते हैं कि धीमी वृद्धि दर वाले पदों को हटाएँ। नीचे दी गई तालिका में किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी में आम तौर पर मिलने वाले पद, वृद्धि दर के अनुसार, सबसे कम से सबसे तेज़ तक क्रमबद्ध हैं।
1
log(N)
N
N2
N3
Nk
2N
N!
अत: हम optimize_route() की टाइम कॉम्प्लेक्सिटी को N! x N + 2N! + 3 = O(N! x N) लिख सकते हैं।
घातीय टाइम कॉम्प्लेक्सिटी वाले एल्गोरिद्म सामान्यतः बहुत छोटे उदाहरणों को हल करने के लिए ही व्यावहारिक रूप से कुशल होते हैं। केवल 13 स्थान होने पर भी, क्रमचयों की संख्या 1 बिलियन से अधिक हो जाती है, जिससे यह एल्गोरिद्म वास्तविक परिदृश्यों के लिए अव्यावहारिक बन जाता है।
टाइम कॉम्प्लेक्सिटी: वर्स्ट केस और बेस्ट केस
नंबर-गेसिंग गेम में, हमने वर्स्ट-केस जटिलता पर ध्यान केंद्रित किया। वर्स्ट केस पर ध्यान देने से हम एल्गोरिद्म के निष्पादन समय की वृद्धि दर की गारंटी दे पाते हैं।
बेस्ट केस में, हम पहली बार में ही सही अनुमान लगा लेते हैं, तो बेस्ट-केस जटिलता विश्लेषण O(1) देगा। यह सही है—बेस्ट केस में एक ही कॉनस्टेंट ऑपरेशन चाहिए। लेकिन यह खास उपयोगी नहीं, क्योंकि इसकी संभावना बहुत कम होती है।
सामान्यतः, जब हम किसी एल्गोरिद्म की जटिलता का विश्लेषण करते हैं, तो हम हमेशा वर्स्ट केस पर ध्यान देते हैं क्योंकि:
प्रदर्शन की गारंटी: वर्स्ट-केस जटिलता पर ध्यान देकर, हम सुनिश्चित कर सकते हैं कि हमारा एल्गोरिद्म किसी निश्चित सीमा से बदतर प्रदर्शन कभी नहीं करेगा। यह रियल-टाइम सिस्टम जैसे अनुप्रयोगों के लिए अहम है, जहाँ देरी से बड़ी समस्याएँ हो सकती हैं।
सुरक्षा और विश्वसनीयता: वर्स्ट-केस विश्लेषण, सबसे चुनौतीपूर्ण परिदृश्यों को सँभालने वाले मज़बूत एल्गोरिद्म डिजाइन करने में मदद करता है। यह सुनिश्चित करता है कि सबसे बुरी परिस्थितियों में भी एल्गोरिद्म स्वीकार्य सीमाओं के भीतर काम करेगा।
ऊपरी सीमा: वर्स्ट-केस जटिलता जानने से हमें प्रदर्शन की ऊपरी सीमा मिलती है। यह समझने में उपयोगी है कि एल्गोरिद्म अधिकतम कितने संसाधन (समय, मेमोरी) मांग सकता है।
टाइम कॉम्प्लेक्सिटी: व्यावहारिक निहितार्थ
टाइम कॉम्प्लेक्सिटी भले ही बहुत सैद्धांतिक विषय लगे, पर यह व्यवहार में बहुत उपयोगी साबित होती है।
उदाहरण के लिए, यदि कोई फंक्शन लगातार छोटा डेटा संभालता है, तो एक आसानी से समझ आने वाला O(N2) एल्गोरिद्म, किसी जटिल और बनाए रखने में कठिन O(N) एल्गोरिद्म से अधिक उपयुक्त हो सकता है। हालाँकि, यह एक सोच-समझकर लिया गया निर्णय होना चाहिए ताकि एप्लिकेशन बढ़ते यूज़र ट्रैफिक को सँभालने में असमर्थ होने पर आपको चौंकना न पड़े।
टाइम कॉम्प्लेक्सिटी विश्लेषण दिखाता है कि कोड में मामूली ऑप्टिमाइज़ेशन का एल्गोरिद्म के निष्पादन समय पर नगण्य प्रभाव होता है। असली सुधार तब मिलते हैं जब हम परिणाम निकालने के लिए आवश्यक बेसिक ऑपरेशंस की संख्या को बुनियादी रूप से घटा दें। सामान्यतः, साफ-सुथरा और समझने योग्य कोड बनाए रखना, उसे इतना ऑप्टिमाइज़ करने से बेहतर है कि वह समझ से बाहर हो जाए।
कोड के धीमे हिस्से अन्य हिस्सों पर हावी हो जाते हैं। तेज़ हिस्से को, धीमे हिस्से से पहले ऑप्टिमाइज़ करना आम तौर पर बेकार होता है। उदाहरण के लिए, मान लें हमारे पास एक फंक्शन है जो दो कार्य करता है:
defprocess_data(data):
clean_data(data)
analyze_data(data)संचालित द्वारा
यदि clean_data() की जटिलता O(N2) और analyze_data() की जटिलता O(N3) है, तो clean_data() की जटिलता घटाने से process_data() की समग्र जटिलता में सुधार नहीं होगा। बेहतर है कि analyze_data() फंक्शन में सुधार पर ध्यान दें।
इसके अलावा, टाइम कॉम्प्लेक्सिटी हार्डवेयर निर्णयों को भी सूचित कर सकती है। उदाहरण के लिए, O(N3) एल्गोरिद्म, भले ही उसकी स्केलेबिलिटी खराब हो, फिर भी बेहतर हार्डवेयर या तेज़ प्रोग्रामिंग भाषा पर चलाने पर सीमित डेटा वाले कार्यों के लिए पर्याप्त तेज़ हो सकता है। इसके विपरीत, यदि किसी एल्गोरिद्म की घातीय टाइम कॉम्प्लेक्सिटी O(2N) है, तो कोई हार्डवेयर अपग्रेड पर्याप्त नहीं होगा—यह अधिक कुशल एल्गोरिद्म की आवश्यकता दर्शाता है।
निष्कर्ष
कंप्यूटर तेज़ हो रहे हैं, फिर भी हम पहले से कहीं अधिक डेटा से जूझ रहे हैं। इसे यूँ समझें: इंटरनेट, स्मार्टफ़ोन या स्मार्ट होम डिवाइस का हर इस्तेमाल, ढेर सारी जानकारी उत्पन्न करता है। जैसे-जैसे यह डेटा-पर्वत बढ़ता है, उसमें से छांटना और ज़रूरी चीज़ें खोजना कठिन होता जाता है। इसलिए यह बेहद ज़रूरी है कि हम अपने औज़ार—खासकर एल्गोरिद्म—को लगातार बेहतर बनाते रहें, ताकि वे इस सारी जानकारी को संभालने और समझने में सक्षम हों।
टाइम कॉम्प्लेक्सिटी विश्लेषण, किसी एल्गोरिद्म के निष्पादन समय पर तर्क करने के लिए एक सीधा ढांचा देता है। इसका प्राथमिक लक्ष्य सटीक निष्पादन समय नहीं, बल्कि टाइम कॉम्प्लेक्सिटी की वृद्धि दर पर अंतर्दृष्टि देना है। मॉडल की कई सरलीकरणों और मान्यताओं के बावजूद, यह व्यवहार में अत्यंत उपयोगी सिद्ध हुआ है और एल्गोरिद्म के निष्पादन-समय के व्यवहार का सार प्रभावी ढंग से पकड़ता है।
मैं Python के बिल्ट-इन फंक्शंस की टाइम कॉम्प्लेक्सिटी कैसे जान सकता/सकती हूँ? ⌄
कभी-कभी दस्तावेज़ीकरण में जटिलता का उल्लेख होता है। अन्यथा, सोर्स कोड देखकर और उसका विश्लेषण करना अच्छा अभ्यास है। अधिकांश भाषाएँ सूचियों और डिक्शनरी जैसे सामान्य डेटा संरचनाओं के लिए मानक इम्प्लिमेंटेशन का पालन करती हैं, इसलिए इन डेटा संरचनाओं की जटिलता देखना सही उत्तर देता है। सामान्य ऑपरेशंस की जटिलता बेहतर समझने के लिए हम डेटा स्ट्रक्चर्स और एल्गोरिद्म पर एक सामान्य कोर्स करने की सलाह देते हैं।
क्या किसी भी k के लिए O(N^k) रूप की जटिलता हमेशा O(2^N) से बेहतर होती है?⌄
सैद्धांतिक रूप से, हाँ। पर्याप्त बड़े N के लिए, घातीय समय वाला एल्गोरिद्म अंततः धीमा पड़ जाएगा। हालाँकि, छोटे N के लिए घातीय समय वाला एल्गोरिद्म बहुत बेहतर प्रदर्शन कर सकता है। कुछ दुर्लभ मामलों में, हमें केवल छोटे डेटासेट्स की परवाह होती है, तो O(2N) एल्गोरिद्म वांछनीय हो सकता है।
क्या यहाँ सीखी गई जटिलताओं के अलावा भी अन्य जटिलता फलन होते हैं?⌄
हाँ। बहुत अजीब जटिलता फलनों वाले एल्गोरिद्म भी मौजूद हैं, पर लगभग सभी एल्गोरिद्म के लिए जटिलता वही फलन शामिल करेगी जिनका हमने इस लेख में उल्लेख किया है।
मुझे कैसे पता चलेगा कि बेहतर एल्गोरिद्म खोजना संभव है?⌄
यह सामान्यतः कठिन प्रश्न है। यह साबित करना कि बेहतर टाइम कॉम्प्लेक्सिटी वाला कोई एल्गोरिद्म नहीं है, समस्या के बारे में तर्क करने और दिखाने पर निर्भर करता है कि कम ऑपरेशंस में इसे हल करना असंभव है। कुछ मामलों में, यह आसान होता है। उदाहरण के लिए, यह जानने के लिए कि क्या किसी सूची में कोई दिया गया मान मौजूद है, O(N) से कम जटिलता वाला एल्गोरिद्म असंभव है क्योंकि वर्स्ट केस में उत्तर पाने के लिए हमें सभी तत्वों को देखना पड़ सकता है।
यदि एल्गोरिद्म में यादृच्छिकता हो तो हम टाइम कॉम्प्लेक्सिटी का विश्लेषण कैसे करें?⌄
यादृच्छिकता शामिल होने पर भी, अक्सर यादृच्छिक परिणामों के सबसे बुरे मामले के बारे में तर्क करना और जटिलता निकालना संभव होता है। वैकल्पिक रूप से, कुछ रैंडमाइज़्ड एल्गोरिद्म के लिए, हम अपेक्षित ऑपरेशंस की संख्या का अध्ययन करके औसत जटिलता का विश्लेषण करते हैं।
Full-stack इंजीनियर एवं संस्थापक, CheapGPT पर। पढ़ाना हमेशा से मेरा जुनून रहा है। विद्यार्थी जीवन से ही मैं उत्साहपूर्वक ट्यूशन देने और अन्य विद्यार्थियों की सहायता करने के अवसर तलाशता रहा हूँ। इसी जुनून ने मुझे पीएचडी करने के लिए प्रेरित किया, जहाँ मैंने अपने शैक्षणिक प्रयासों के साथ शिक्षण सहायक के रूप में भी काम किया। उन वर्षों में पारंपरिक कक्षा-परिवेश में काम करना, संबंध बनाना और सीखने को आसान बनाना मुझे अत्यंत संतोष देता था। लेकिन ऑनलाइन लर्निंग प्लेटफ़ॉर्म के आगमन के साथ, मैंने डिजिटल शिक्षा की रूपांतरकारी क्षमता को पहचाना। वास्तव में, हमारी ही विश्वविद्यालय में ऐसे एक प्लेटफ़ॉर्म के विकास में मैं सक्रिय रूप से शामिल था। मैं पारंपरिक शिक्षण सिद्धांतों को नवोन्मेषी डिजिटल पद्धतियों के साथ जोड़ने के लिए गहराई से प्रतिबद्ध हूँ। मेरा उद्देश्य ऐसे पाठ्यक्रम बनाना है जो न केवल रोचक और सूचनाप्रद हों, बल्कि इस डिजिटल युग के शिक्षार्थियों के लिए सुगम भी हों।


टाइम कॉम्प्लेक्सिटी विश्लेषण, एल्गोरिद्म की कार्यक्षमता का विश्लेषण और पूर्वानुमान लगाने का एक तरीका देता है जो न तो उस भाषा पर निर्भर करता है जिसमें हम उन्हें लागू करते हैं और न ही उस हार्डवेयर पर जिस पर उन्हें चलाया जाता है।
टाइम कॉम्प्लेक्सिटी विश्लेषण का लक्ष्य किसी एल्गोरिद्म के सटीक रनटाइम की भविष्यवाणी करना नहीं है, बल्कि इन प्रश्नों का उत्तर देने में सक्षम होना है:
इस लेख के अंत तक, आप किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी का विश्लेषण करना और इन प्रश्नों का उत्तर देना सीख जाएंगे।
क्या 2024 में टाइम कॉम्प्लेक्सिटी अभी भी मायने रखती है?
कंप्यूटर लगातार तेज हो रहे हैं, तो कोई पूछ सकता है कि क्या अब टाइम कॉम्प्लेक्सिटी की चिंता करने की कोई ज़रूरत है। क्या आजकल कोई भी सुपरकंप्यूटर, हम जो भी एल्गोरिद्म इस्तेमाल करें, उससे बेपरवाह होकर किसी भी समस्या को संभाल सकता है?
खैर, पूरी तरह नहीं। हालिया वर्षों में हार्डवेयर प्रदर्शन में भारी प्रगति से एआई का उभार हुआ है। फिर भी, सबसे उन्नत हार्डवेयर पर भी, यदि धीमा एल्गोरिद्म अपनाया जाए, तो साधारण समस्याएं भी विनाशकारी प्रदर्शन दे सकती हैं।
उदाहरण के लिए, कल्पना करें कि आप दस मिलियन प्रविष्टियों वाली डेटाबेस तालिका को सॉर्ट करने के लिए एक भोला-भाला एल्गोरिद्म इस्तेमाल कर रहे हैं। आधुनिक कंप्यूटर पर भी, यह सरल-सा ऑपरेशन पूरा होने में कई दिनों लेगा, जिससे डेटाबेस किसी भी व्यावहारिक अनुप्रयोग के लिए अनुपयोगी हो जाएगा। इसके विपरीत, एक कुशल एल्गोरिद्म का उपयोग करके, हम उम्मीद कर सकते हैं कि इसमें एक-दशमलव सेकंड से भी कम समय लगेगा।
बेसिक ऑपरेशंस और बेसिक इंस्ट्रक्शंस
हम Random Access Machine (RAM या RA-machine) मॉडल का उपयोग करके एल्गोरिद्म का विश्लेषण करते हैं। यह मॉडल मानता है कि निम्नलिखित ऑपरेशंस को ठीक एक टाइम स्टेप लगता है:
ifयाreturnइन ऑपरेशंस को बेसिक ऑपरेशंस कहा जाता है। कोड की वह पंक्ति जो एक नियत संख्या में बेसिक ऑपरेशंस चलाती है, उसे बेसिक इंस्ट्रक्शन कहा जाता है।
क्योंकि किसी बेसिक इंस्ट्रक्शन में ऑपरेशंस की संख्या नियत होती है, यह डेटा की मात्रा पर निर्भर नहीं करती। चूँकि हमें इस बात की परवाह है कि डेटा की मात्रा बढ़ने पर निष्पादन समय कैसे बढ़ता है, हम एल्गोरिद्म द्वारा किए गए बेसिक इंस्ट्रक्शंस की संख्या गिनने पर ध्यान केंद्रित कर सकते हैं।
फंक्शन कॉल्स और
forऔरwhileजैसे लूप्स का मूल्यांकन, उनके अंदर मौजूद बेसिक इंस्ट्रक्शंस की संख्या जोड़कर किया जाता है। निम्नलिखित कोड पर विचार करें जो सूची के तत्वों का योग करता है।हमने प्रत्येक पंक्ति में टिप्पणियां जोड़कर बेसिक इंस्ट्रक्शंस की संख्या दिखाने में मदद की है। यदि N,
lstकी लंबाई है, तो बेसिक इंस्ट्रक्शंस की कुल संख्या 1 + N + 1 = N + 2 है।बिग-ओ नोटेशन
मान लीजिए हमारे पास दो सॉर्टिंग एल्गोरिद्म हैं। हमने प्रत्येक के लिए बेसिक इंस्ट्रक्शंस की संख्या निकाली और निम्नलिखित अभिव्यक्तियाँ पाईं:
पहला एल्गोरिद्म
दूसरा एल्गोरिद्म
4N2 + 2N + 7
3N2 + 5N + 13
पहली नज़र में यह स्पष्ट नहीं है कि कौन-सा बेहतर स्केल करता है। बिग-ओ नोटेशन इन अभिव्यक्तियों को और सरल करने का एक तरीका देता है, इन सरलीकरणों को लागू करके:
यदि हम यह प्रक्रिया दोनों अभिव्यक्तियों पर लागू करें, तो दोनों मामलों में N2 मिलता है:
सरलीकरण के बाद प्राप्त अभिव्यक्ति एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी होती है, जिसे हम O() से निरूपित करते हैं। इस मामले में, हम लिख सकते हैं कि 4N2 + 2N + 7 = O(N2) और 3N2 + 5N + 13 = O(N2)। इसका मतलब है कि दोनों एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी समान है, जो सूची के तत्वों की संख्या के वर्ग के अनुपात में है।
ऊपर, हमने गणना की कि
sum_listएल्गोरिद्म ने N + 2 ऑपरेशंस किए, जहाँ N सूची की लंबाई है। वही सरलीकरण लागू करने पर, N प्राप्त होता है, इसलिएsum_listकी टाइम कॉम्प्लेक्सिटी O(N) है।इसका मतलब है कि निष्पादन समय सूची के आकार के अनुपात में है। यह अपेक्षित है क्योंकि योग निकालते समय, किसी सूची में तत्वों की संख्या दोगुनी होने पर दोगुना काम होना चाहिए—न कम, न ज़्यादा।
बिग-ओ नोटेशन: सहज व्याख्या
हम निचले पदों को नज़रअंदाज़ कर सकते हैं क्योंकि N बढ़ने पर, उच्चतम पद की तुलना में उनका योगदान नगण्य हो जाता है। निम्न प्लॉट तीन पदों 4N2, 2N और 7 के कुल योग में योगदान को दिखाता है।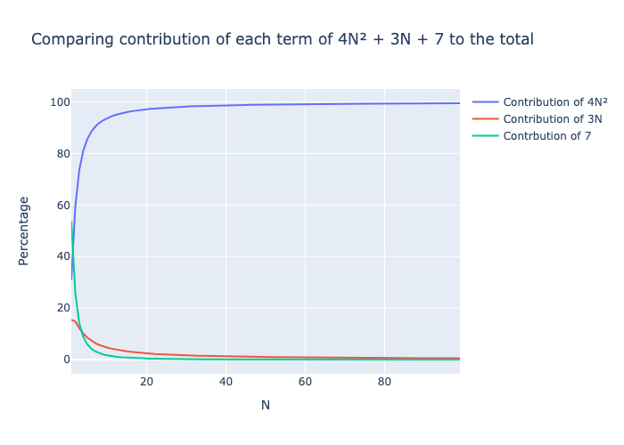
द्विघात पद 4N2 बहुत जल्दी, छोटे N के लिए भी, कुल ऑपरेशंस में लगभग 100% का योगदान देने लगता है। इसलिए, बड़े डेटा के साथ काम करते समय, निचले-क्रम के पदों का समय, उच्च-क्रम के पदों की तुलना में नगण्य होगा।
हम गुणांक स्थिरांक को हटाते हैं क्योंकि यह मान डेटा की मात्रा से स्वतंत्र होता है।
बिग-ओ नोटेशन: गणितीय परिभाषा
उपरोक्त कदम अधिकांश व्यावहारिक उद्देश्यों के लिए किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी सही ढंग से निकालने के लिए पर्याप्त हैं। हम एल्गोरिद्म द्वारा किए गए बेसिक इंस्ट्रक्शंस गिनते हैं और कोई अभिव्यक्ति f(N) प्राप्त करते हैं। दो सरलीकरणों के बाद, एक सरल अभिव्यक्ति g(N) मिलती है। तब हम लिख सकते हैं f(N) = O(g(N))। इसे हम "+f is big O of g+" के रूप में पढ़ते हैं।
हालाँकि, यह औपचारिक गणितीय परिभाषा नहीं है, और कुछ मामलों में यह पर्याप्त नहीं होती।
गणितीय परिभाषा यह है कि एक धनात्मक फलन f(N) = O(g(N)) तब होता है जब हम कोई स्थिरांक C ढूँढ़ सकें ताकि बड़े N के लिए निम्न शर्त पूरी हो:
f(N) ≤ C × g(N)
हम इस परिभाषा का उपयोग करके दिखा सकते हैं कि f(N) = 4N2 + 2N + 7 = O(N2)। इस मामले में, हम C = 5 चुन सकते हैं और देख सकते हैं कि किसी भी N > 4 के लिए, f(N) ≤ 5 × N2:
व्यवहार में, हम ऊपर दिए सरलीकरण नियमों का ही उपयोग करेंगे।
टाइम कॉम्प्लेक्सिटी के प्रकार
अब जब हमें बिग-ओ नोटेशन की मूल बातें समझ आ गई हैं, तो आइए सामान्य टाइम कॉम्प्लेक्सिटीज़ और उनके निहितार्थों का अन्वेषण करें, सबसे कुशल से शुरू करते हुए: स्थिर समय।
कॉनस्टेंट टाइम: O(1)
जैसा कि नाम से स्पष्ट है, कॉनस्टेंट-टाइम एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी स्थिर होती है, यानी उनका प्रदर्शन डेटा की मात्रा पर निर्भर नहीं करता। ये एल्गोरिद्म आमतौर पर निश्चित संख्या के इनपुट्स के साथ गणनाओं में शामिल होते हैं, जैसे दो बिंदुओं के बीच की दूरी निकालना।
दो बिंदुओं के बीच की दूरी, उनके x और y निर्देशांकों के अंतर का वर्गमूल निकालकर तय की जाती है।
distफंक्शन नीचे दिखाया गया है जो दो बिंदुओं के बीच दूरी निकालता है। यह तीन बेसिक इंस्ट्रक्शंस से बना है, जो एक स्थिर संख्या है। इस मामले में, हम लिखते हैं कि टाइम कॉम्प्लेक्सिटी O(1) है।दिलचस्प बात यह है कि कोई फंक्शन बड़े डेटासेट्स पर काम करते हुए भी कॉनस्टेंट टाइम कॉम्प्लेक्सिटी दिखा सकता है। उदाहरण के लिए, len फंक्शन से किसी सूची की लंबाई निकालना O(1) होता है, क्योंकि उसके इम्प्लिमेंटेशन में आंतरिक रूप से सूची के आकार का हिसाब रखा जाता है—हर बार तत्वों को गिनने की ज़रूरत नहीं पड़ती।
लिनियर टाइम: O(N)
हम पहले
sum_listको एक लिनियर टाइम फंक्शन के उदाहरण के रूप में चर्चा कर चुके हैं। सामान्यतः, लिनियर टाइम एल्गोरिद्म वे कार्य करते हैं जिनमें हर डेटा पॉइंट को अलग-अलग देखना आवश्यक होता है। न्यूनतम, अधिकतम या औसत निकालना इस श्रेणी के सामान्य ऑपरेशंस हैं।आइए सूची का न्यूनतम मान निकालने वाले निम्न फंक्शन का विश्लेषण करके अभ्यास करें:
यदि सूची में N तत्व हैं, तो जटिलता 1 + (N - 1) + 1 = N + 1 = O(N) है।
लिनियर टाइम एल्गोरिद्म का निष्पादन समय सीधे डेटा की मात्रा के अनुपात में होता है। इसलिए, यदि डेटा दोगुना हो जाए, तो एल्गोरिद्म को डेटा प्रोसेस करने में लगने वाला समय भी दोगुना होना चाहिए।
लॉगरिदमिक टाइम: O(log(N))
नंबर-गेसिंग गेम में 1 और N के बीच छिपे नंबर का अनुमान लगाना होता है, जिसका उद्देश्य संभवतः सबसे कम प्रयासों में उसे पहचानना है। हर अनुमान के बाद हमें यह फीडबैक मिलता है कि छिपा नंबर हमारे अनुमान से बड़ा है, छोटा है या वही है। यदि अनुमान सही हुआ, तो हम गेम जीत जाते हैं; अन्यथा, हम अनुमान लगाते रहते हैं।
इस गेम के लिए एक प्रभावी रणनीति हमेशा मध्य मान का अनुमान लगाना है। मान लें N = 15। इस स्थिति में, हमारा पहला अनुमान 8 होगा। यदि गुप्त नंबर 8 से छोटा है, तो हमें पता है कि वह 1 और 7 के बीच होगा। यदि बड़ा है, तो 9 और 15 के बीच। हम शेष रेंज के मध्य का अनुमान तब तक लगाते रहते हैं जब तक सही उत्तर न मिल जाए। नीचे का डायग्राम इस रणनीति के संभावित रास्तों को दिखाता है।
आइए इस विधि की टाइम कॉम्प्लेक्सिटी देखें। पहले के उदाहरणों के विपरीत, इस एल्गोरिद्म के कदमों की संख्या केवल इनपुट आकार N पर निर्भर नहीं करती, क्योंकि पहली कोशिश में सही अनुमान होने की संभावना रहती है।
ऐसे एल्गोरिद्म का विश्लेषण करते समय, हम सबसे बुरी स्थिति पर ध्यान केंद्रित करते हैं। उदाहरण के लिए, N = 15 होने पर, सबसे बुरी स्थिति में हमें 4 अनुमान लगाने पड़ेंगे। हर बार मध्य मान का अनुमान लगाकर शेष संभावनाओं का आधा समाप्त हो जाता है। सबसे बुरी स्थिति में हम तब तक अनुमान लगाते रहते हैं जब तक केवल एक संभावना न रह जाए। इसलिए, हमें यह प्रश्न हल करना है:
N को 2 से कितनी बार भाग दें कि 1 प्राप्त हो?
उत्तर है N का आधार-2 लघुगणक, जिसे log2(N) से निरूपित किया जाता है। सही संख्या पहचानने के लिए प्रयुक्त एल्गोरिद्म को बाइनरी सर्च कहा जाता है। चूँकि अधिकतम अनुमान log2(N) हैं, हम इसकी कॉम्प्लेक्सिटी O(log2(N)) या सरलता से O(log(N)) लिख सकते हैं, क्योंकि टाइम कॉम्प्लेक्सिटी नोटेशन में स्थिरांक अप्रासंगिक होते हैं।
बेहद धीमी वृद्धि दर के कारण, लॉगरिदमिक टाइम कॉम्प्लेक्सिटी व्यवहार में बहुत वांछनीय होती है, जो लगभग कॉनस्टेंट टाइम जैसी लगती है। बड़े N के लिए भी, कुल ऑपरेशंस की संख्या आश्चर्यजनक रूप से कम रहती है। उदाहरण के लिए, N एक बिलियन होने पर भी, आवश्यक ऑपरेशंस केवल लगभग 30 होते हैं।
बाइनरी सर्च कंप्यूटर विज्ञान में एक बुनियादी एल्गोरिद्म है जिसके कई अनुप्रयोग हैं। उदाहरण के लिए, नेचुरल लैंग्वेज प्रोसेसिंग में, स्पेल चेकर और ऑटोकरेक्ट सिस्टम संभावित शब्दों को कुशलतापूर्वक पहचानने के लिए बाइनरी सर्च के विभिन्न संस्करणों का उपयोग कर सकते हैं।
क्वाड्रेटिक टाइम: O(N2)
डेटा को सॉर्ट करना एक बुनियादी काम है जिसे कंप्यूटर अक्सर करते हैं। N संख्याओं की सूची को सॉर्ट करने का एक तरीका सूची के न्यूनतम तत्व को बार-बार पहचानना है।
किसी
forलूप की जटिलता का विश्लेषण करने के लिए, हम उसके अंदर मौजूद इंस्ट्रक्शंस की जटिलता निकालते हैं और फिर उसे लूप के इटरेशंस की संख्या से गुणा करते हैं।किसी सूची का न्यूनतम निकालना और सूची से कोई तत्व हटाना, दोनों O(N) ऑपरेशंस हैं। ऐपेंड करना कॉनस्टेंट टाइम O(1) में होता है। इसलिए, लूप के प्रत्येक इटरेशन की जटिलता O(N + N + 1) = O(2N + 1) है, जो O(N) में सरल हो जाती है। चूँकि N इटरेशंस हैं, कुल जटिलता N × O(N) = O(N2) है।
selection_sort()का बाकी हिस्सा तीन सरल इंस्ट्रक्शंस से बना है, इसलिए समग्र जटिलता O(N2 + 3) = O(N2) है।हमारा for लूप का विश्लेषण एक सरलीकरण था। हर इटरेशन में, हम सूची से एक तत्व निकालते हैं, यानी सभी इटरेशंस समान संख्या में इंस्ट्रक्शंस नहीं चलाते। पहला इटरेशन N इंस्ट्रक्शंस चलाता है, दूसरा N - 1, तीसरा N - 2, और यह क्रम चलता रहता है, जब तक कि अंतिम इटरेशन में केवल 1 इंस्ट्रक्शन न चले।
इसका मतलब है कि for लूप की वास्तविक जटिलता यह है:
N + (N - 1) + (N - 2) + … + 1
यह योग (N2 + N) / 2 के बराबर दिखाया जा सकता है। हालांकि,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
भले ही हमने अधिक गिना, समग्र जटिलता फिर भी द्विघात है।
selection_sort()फंक्शन अपनी द्विघात जटिलता O(N2) के कारण एक धीमे सॉर्टिंग एल्गोरिद्म का उदाहरण है।द्विघात जटिलता वाले फंक्शंस बुरी तरह स्केल होते हैं—ये छोटी सूचियों के लिए उपयुक्त हैं, पर लाखों डेटा पॉइंट्स को सॉर्ट करने के लिए अव्यावहारिक, क्योंकि इसमें दिनों लग सकते हैं। डेटा दोगुना होने पर निष्पादन समय चार गुना हो जाता है।
लॉग-लीनियर टाइम: O(N log(N))
ऐसा एल्गोरिद्म बनाया जा सकता है जो सूची को O(N log(N)) टाइम कॉम्प्लेक्सिटी में सॉर्ट करे। ऐसा ही एक एल्गोरिद्म मर्ज सॉर्ट कहलाता है। हम इसके इम्प्लिमेंटेशन के विवरण में नहीं जाएंगे, पर यदि आप और सीखना चाहें, तो इस मर्ज सॉर्ट का त्वरित परिचय और इस कोर्स Data Structures and Algorithms in Python देखें।
जैसा पहले बताया, व्यवहार में लॉगरिदमिक जटिलता लगभग कॉनस्टेंट जैसी ही रहती है। इसलिए O(N log(N)) एल्गोरिद्म का निष्पादन समय, वास्तविक अनुप्रयोगों में, लिनियर-टाइम एल्गोरिद्म के बराबर हो सकता है।
निम्न प्लॉट दिखाता है कि N log(N) और N समान दर से बढ़ते हैं, जबकि N2 बहुत तेज़ी से बढ़ता है और शीघ्र ही बहुत धीमा (कुशलता में) हो जाता है।
क्यूबिक टाइम: O(N3)
एआई में व्यापक रूप से प्रयुक्त क्यूबिक टाइम जटिलता वाला एल्गोरिद्म मैट्रिक्स गुणन है, जो GPT जैसे बड़े भाषा मॉडलों की कार्यक्षमता में अहम भूमिका निभाता है। यह एल्गोरिद्म प्रशिक्षण और इन्फरेंस, दोनों चरणों में होने वाली गणनाओं के लिए महत्वपूर्ण है।
दो N x N मैट्रिक्स, A और B, का गुणन करने के लिए, हमें पहले मैट्रिक्स A की प्रत्येक पंक्ति को दूसरे मैट्रिक्स B के प्रत्येक स्तंभ से गुणा करना होता है। विशेष रूप से, उत्पाद के (i, j) स्थान का मान, A की iवीं पंक्ति के तत्वों और B के jवें स्तंभ के तत्वों के गुणनों के योग से निर्धारित होता है।
यह रहा मैट्रिक्स गुणन का Python इम्प्लिमेंटेशन:
कुल मिलाकर,
matrix_mul()N3 + N2 + 2 इंस्ट्रक्शंस चलाता है, इसलिए इसकी टाइम कॉम्प्लेक्सिटी O(N3) है।वैकल्पिक रूप से, हम गणनाओं के बारे में तर्क करके भी जटिलता का विश्लेषण कर सकते थे। मैट्रिक्स गुणन का परिणाम N2 एंट्रीज़ रखता है। प्रत्येक एंट्री की गणना में O(N) समय लगता है, इसलिए समग्र जटिलता N2 × O(N) = O(N3) है।
क्यूबिक टाइम एल्गोरिद्म काफी धीमे होते हैं। डेटा दोगुना होने पर निष्पादन समय आठ गुना हो जाता है, जिससे ऐसे एल्गोरिद्म बहुत बुरी तरह स्केल होते हैं। अपेक्षाकृत छोटे N के लिए भी, इंस्ट्रक्शंस की संख्या बहुत तेज़ी से बढ़ जाती है।
मैट्रिक्स गुणन एक ऐसा संगणनात्मक चुनौती का उदाहरण है जहाँ हार्डवेयर में प्रगति ने भारी प्रभाव डाला है। हालाँकि मैट्रिक्स गुणन के थोड़े अधिक कुशल एल्गोरिद्म मौजूद हैं, पर मुख्यतः GPU चिप्स के डिज़ाइन में प्रगति—जो खास तौर पर मैट्रिक्स गुणन के लिए तैयार किए गए—ने GPT जैसे बड़े मॉडलों के प्रशिक्षण को वाजिब समयसीमा में संभव बनाया है।
हाल में, शोधकर्ताओं ने बड़े लर्निंग मॉडलों से मैट्रिक्स गुणन हटाने का प्रस्ताव रखा है—इसके बारे में अधिक पढ़ने के लिए यह लेख देखें: MatMul-Free LLMs: Key Concepts Explained।
घातीय टाइम कॉम्प्लेक्सिटी: O(2N) और O(N!)
घातीय समय वाले एल्गोरिद्म आमतौर पर तब उत्पन्न होते हैं जब किसी समस्या को सभी संभावित हलों की जाँच करके सुलझाया जाता है। मान लें कि किसी डिलीवरी ट्रक को N डिलीवरी स्थानों पर जाना है। इस समस्या को हल करने का एक तरीका है हर संभव डिलीवरी क्रम का मूल्यांकन करना। Python का itertools पैकेज सूची की सभी क्रमचयों (permutations) पर चक्र लगाने का आसान तरीका देता है।
लंबाई N की सूची के क्रमचयों की संख्या को N! से निरूपित किया जाता है, जिसे "N फैक्टोरियल" पढ़ते हैं। फैक्टोरियल फलन घातीय वृद्धि दिखाता है। उदाहरण के लिए, N = 13 होने पर, क्रमचयों की संख्या 1 बिलियन से अधिक हो जाती है।
मान लें डिलीवरी स्थान 2D बिंदुओं की सूची के रूप में दिए गए हैं। ऐसी स्थिति में, हम सभी संभावित क्रमों से गुजरते हुए और सर्वश्रेष्ठ का हिसाब रखते हुए कुल दूरी को न्यूनतम करने वाला डिलीवरी क्रम निर्धारित कर सकते हैं।
पहला
forलूप N! बार चलता है। इसलिए,optimize_route()में ऑपरेशंस की संख्या N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3 है।हमने सीखा कि टाइम कॉम्प्लेक्सिटी निकालते समय, हम कम घातांक वाले पदों को नज़रअंदाज़ करते हैं। लेकिन यहाँ हमें N! पद मिलता है, जो N की घात नहीं है। हम अपने सरलीकरण नियमों को इस तरह परिष्कृत कर सकते हैं कि धीमी वृद्धि दर वाले पदों को हटाएँ। नीचे दी गई तालिका में किसी एल्गोरिद्म की टाइम कॉम्प्लेक्सिटी में आम तौर पर मिलने वाले पद, वृद्धि दर के अनुसार, सबसे कम से सबसे तेज़ तक क्रमबद्ध हैं।
1
log(N)
N
N2
N3
Nk
2N
N!
अत: हम
optimize_route()की टाइम कॉम्प्लेक्सिटी को N! x N + 2N! + 3 = O(N! x N) लिख सकते हैं।घातीय टाइम कॉम्प्लेक्सिटी वाले एल्गोरिद्म सामान्यतः बहुत छोटे उदाहरणों को हल करने के लिए ही व्यावहारिक रूप से कुशल होते हैं। केवल 13 स्थान होने पर भी, क्रमचयों की संख्या 1 बिलियन से अधिक हो जाती है, जिससे यह एल्गोरिद्म वास्तविक परिदृश्यों के लिए अव्यावहारिक बन जाता है।
टाइम कॉम्प्लेक्सिटी: वर्स्ट केस और बेस्ट केस
नंबर-गेसिंग गेम में, हमने वर्स्ट-केस जटिलता पर ध्यान केंद्रित किया। वर्स्ट केस पर ध्यान देने से हम एल्गोरिद्म के निष्पादन समय की वृद्धि दर की गारंटी दे पाते हैं।
बेस्ट केस में, हम पहली बार में ही सही अनुमान लगा लेते हैं, तो बेस्ट-केस जटिलता विश्लेषण O(1) देगा। यह सही है—बेस्ट केस में एक ही कॉनस्टेंट ऑपरेशन चाहिए। लेकिन यह खास उपयोगी नहीं, क्योंकि इसकी संभावना बहुत कम होती है।
सामान्यतः, जब हम किसी एल्गोरिद्म की जटिलता का विश्लेषण करते हैं, तो हम हमेशा वर्स्ट केस पर ध्यान देते हैं क्योंकि:
टाइम कॉम्प्लेक्सिटी: व्यावहारिक निहितार्थ
टाइम कॉम्प्लेक्सिटी भले ही बहुत सैद्धांतिक विषय लगे, पर यह व्यवहार में बहुत उपयोगी साबित होती है।
उदाहरण के लिए, यदि कोई फंक्शन लगातार छोटा डेटा संभालता है, तो एक आसानी से समझ आने वाला O(N2) एल्गोरिद्म, किसी जटिल और बनाए रखने में कठिन O(N) एल्गोरिद्म से अधिक उपयुक्त हो सकता है। हालाँकि, यह एक सोच-समझकर लिया गया निर्णय होना चाहिए ताकि एप्लिकेशन बढ़ते यूज़र ट्रैफिक को सँभालने में असमर्थ होने पर आपको चौंकना न पड़े।
टाइम कॉम्प्लेक्सिटी विश्लेषण दिखाता है कि कोड में मामूली ऑप्टिमाइज़ेशन का एल्गोरिद्म के निष्पादन समय पर नगण्य प्रभाव होता है। असली सुधार तब मिलते हैं जब हम परिणाम निकालने के लिए आवश्यक बेसिक ऑपरेशंस की संख्या को बुनियादी रूप से घटा दें। सामान्यतः, साफ-सुथरा और समझने योग्य कोड बनाए रखना, उसे इतना ऑप्टिमाइज़ करने से बेहतर है कि वह समझ से बाहर हो जाए।
कोड के धीमे हिस्से अन्य हिस्सों पर हावी हो जाते हैं। तेज़ हिस्से को, धीमे हिस्से से पहले ऑप्टिमाइज़ करना आम तौर पर बेकार होता है। उदाहरण के लिए, मान लें हमारे पास एक फंक्शन है जो दो कार्य करता है:
यदि
clean_data()की जटिलता O(N2) औरanalyze_data()की जटिलता O(N3) है, तोclean_data()की जटिलता घटाने सेprocess_data()की समग्र जटिलता में सुधार नहीं होगा। बेहतर है किanalyze_data()फंक्शन में सुधार पर ध्यान दें।इसके अलावा, टाइम कॉम्प्लेक्सिटी हार्डवेयर निर्णयों को भी सूचित कर सकती है। उदाहरण के लिए, O(N3) एल्गोरिद्म, भले ही उसकी स्केलेबिलिटी खराब हो, फिर भी बेहतर हार्डवेयर या तेज़ प्रोग्रामिंग भाषा पर चलाने पर सीमित डेटा वाले कार्यों के लिए पर्याप्त तेज़ हो सकता है। इसके विपरीत, यदि किसी एल्गोरिद्म की घातीय टाइम कॉम्प्लेक्सिटी O(2N) है, तो कोई हार्डवेयर अपग्रेड पर्याप्त नहीं होगा—यह अधिक कुशल एल्गोरिद्म की आवश्यकता दर्शाता है।
निष्कर्ष
कंप्यूटर तेज़ हो रहे हैं, फिर भी हम पहले से कहीं अधिक डेटा से जूझ रहे हैं। इसे यूँ समझें: इंटरनेट, स्मार्टफ़ोन या स्मार्ट होम डिवाइस का हर इस्तेमाल, ढेर सारी जानकारी उत्पन्न करता है। जैसे-जैसे यह डेटा-पर्वत बढ़ता है, उसमें से छांटना और ज़रूरी चीज़ें खोजना कठिन होता जाता है। इसलिए यह बेहद ज़रूरी है कि हम अपने औज़ार—खासकर एल्गोरिद्म—को लगातार बेहतर बनाते रहें, ताकि वे इस सारी जानकारी को संभालने और समझने में सक्षम हों।
टाइम कॉम्प्लेक्सिटी विश्लेषण, किसी एल्गोरिद्म के निष्पादन समय पर तर्क करने के लिए एक सीधा ढांचा देता है। इसका प्राथमिक लक्ष्य सटीक निष्पादन समय नहीं, बल्कि टाइम कॉम्प्लेक्सिटी की वृद्धि दर पर अंतर्दृष्टि देना है। मॉडल की कई सरलीकरणों और मान्यताओं के बावजूद, यह व्यवहार में अत्यंत उपयोगी सिद्ध हुआ है और एल्गोरिद्म के निष्पादन-समय के व्यवहार का सार प्रभावी ढंग से पकड़ता है।
यदि आप कंप्यूटर विज्ञान के और विषयों का अन्वेषण करना चाहते हैं, तो मेरा लेख देखें: Data Structures: A Comprehensive Guide With Python Examples।