Büyük O Gösterimi ve Zaman Karmaşıklığı Rehberi: Sezgi ve Matematik
Zaman karmaşıklığı, bir algoritmanın çalışma süresinin girdi boyutuyla nasıl ölçeklendiğini ölçer; genellikle en kötü durum için bir üst sınır sağlayan Büyük-O gösterimiyle ifade edilir.
Zaman karmaşıklığı analizi, algoritmaların verimliliğini hem uygulandıkları dil hem de çalıştırıldıkları donanımdan bağımsız bir şekilde analiz edip öngörmenin bir yolunu sunar.
Zaman karmaşıklığı analizinin amacı, bir algoritmanın tam çalışma süresini tahmin etmek değil, şu soruları yanıtlayabilmektir:
Aynı problemi çözen iki algoritma verildiğinde, her ikisine de aynı miktarda veri sağlanırsa hangisinin daha hızlı çalışması beklenir?
Algoritmaya sağlanan veriyi iki katına çıkarsak yürütme süresi nasıl etkilenir? Doğrusal olarak mı ölçeklenir ve ikiye mi katlanır? Aynı mı kalır? Yoksa tamamen farklı bir şey mi olur?
Bu makalenin sonunda, bir algoritmanın zaman karmaşıklığını nasıl analiz edeceğinizi ve bu soruları nasıl yanıtlayacağınızı öğrenmiş olacaksınız.
2024’te Zaman Karmaşıklığı Hâlâ Önemli mi?
Bilgisayarlar giderek hızlanıyor; bu nedenle, artık zaman karmaşıklığı konusunda endişelenmeye gerek kalıp kalmadığı merak edilebilir. Günümüzde bir süper bilgisayar, hangi algoritmayı kullanırsak kullanalım her problemi halledebilir, öyle değil mi?
Pek öyle değil. Yapay zekâ patlaması, büyük ölçüde son yıllarda donanım performansındaki muazzam ilerlemeler sayesinde yaşandı. Ancak en gelişmiş donanımda bile, yavaş bir algoritma kullanıldığında basit problemler felakete varan performans düşüşlerine yol açabilir.
Örneğin, on milyon kayıttan oluşan bir veritabanı tablosunu sıralamak için naif bir algoritma kullandığınızı düşünün. Modern bir bilgisayarda bile bu basit işlem günler sürebilir ve veritabanını pratik uygulamalar için kullanılamaz hâle getirir. Buna karşılık, verimli bir algoritma kullanırsak bunun bir saniyenin onda birinden kısa sürede gerçekleşmesini bekleriz.
Temel İşlemler ve Temel Komutlar
Bir algoritmayı Rastgele Erişim Makinesi (RAM veya RA-makine) modeliyle analiz ederiz. Bu model, aşağıdaki işlemlerin tam olarak bir zaman adımı aldığı varsayımına dayanır:
Aritmetik işlemler
Mantık işlemleri (<, >, == vb.)
if veya return gibi deyimler
Bir değişken değerini yazmak ya da okumak gibi bir bellek konumuna erişmek
Bu işlemlere temel işlemler denir. Sabit sayıda temel işlem yürüten bir kod satırına temel komut denir.
Temel komut içindeki işlem sayısı sabit olduğundan, veri miktarına bağlı değildir. Yürütme süresinin veri miktarı arttıkça nasıl büyüdüğüyle ilgilendiğimiz için, algoritmanın gerçekleştirdiği temel komut sayısını saymaya odaklanabiliriz.
for ve while gibi fonksiyon çağrıları ve döngüler, içlerindeki temel komutların sayısı toplanarak değerlendirilir. Aşağıdaki, bir listenin elemanlarını toplayan kodu ele alalım.
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionAltyapı:
Temel komut sayısını görselleştirmeye yardımcı olmak için her satıra yorum ekledik. lst’nin uzunluğu N ise, toplam temel komut sayısı 1 + N + 1 = N + 2’dir.
Büyük-O Gösterimi
İki sıralama algoritmamız olduğunu düşünelim. Her biri için temel komut sayısını hesapladık ve şu ifadeleri elde ettik:
Birinci algoritma
İkinci algoritma
4N2 + 2N + 7
3N2 + 5N + 13
İlk bakışta hangisinin daha iyi ölçeklendiği açık değildir. Büyük-O gösterimi, şu sadeleştirmeleri uygulayarak bu ifadeleri daha da basitleştirmenin bir yolunu sunar:
Daha düşük üslü terimleri atın
Çarpan sabitleri kaldırın
Bu süreci her iki ifadeye de uygularsak, her iki durumda da N2 elde ederiz:
Sadeleştirme sonrası elde ettiğimiz ifade, algoritmanın zaman karmaşıklığıdır ve O() ile gösteririz. Bu durumda 4N2 + 2N + 7 = O(N2) ve 3N2 + 5N + 13 = O(N2) yazabiliriz. Bu, her iki algoritmanın da aynı zaman karmaşıklığına sahip olduğu, yani listenin eleman sayısının karesiyle orantılı olduğu anlamına gelir.
Yukarıda, sum_list algoritmasının, listenin uzunluğu N olmak üzere N + 2 işlem yaptığını hesaplamıştık. Aynı sadeleştirmeleri uygularsak N elde ederiz; dolayısıyla sum_list’in zaman karmaşıklığı O(N)’dir.
Bu, yürütme süresinin liste boyutuyla orantılı olduğu anlamına gelir. Bu beklenir; çünkü toplamı hesaplarken, listedeki eleman sayısını ikiye katlamak, gereken işi de ikiye katlamalıdır; ne daha az ne daha çok.
Büyük-O gösterimi: sezgisel açıklama
Düşük terimleri yok sayabiliriz; çünkü N büyüdükçe, bu terimlerin toplam üzerindeki etkisi en yüksek terime kıyasla önemsiz hâle gelir. Aşağıdaki grafik, 4N2, 2N ve 7 terimlerinin her birinin toplam içindeki katkısını gösterir.
Karesel terim 4N2, küçük N değerlerinde bile, toplam işlem sayısının neredeyse %100’ünü çok hızlı bir şekilde oluşturur. Bu nedenle, büyük miktarda verilerle uğraşırken daha düşük dereceli terimlere karşılık gelen süreler, daha yüksek dereceli terimlere kıyasla göz ardı edilebilir düzeyde olacaktır.
Çarpan sabiti, veri miktarından bağımsız olduğu için atarız.
Büyük-O gösterimi: matematiksel tanım
Yukarıdaki adımlar, çoğu pratik durumda bir algoritmanın zaman karmaşıklığını doğru biçimde çıkarmak için yeterlidir. Bir algoritmanın gerçekleştirdiği temel komut sayısını sayar ve bir f(N) ifadesi elde ederiz. İki sadeleştirme adımını uyguladıktan sonra basitleştirilmiş bir g(N) ifadesi elde ederiz. Ardından f(N) = O(g(N)) yazabiliriz. “f, g’nin büyük O’sudur” diye okunur.
Ancak bu, resmi bir matematiksel tanım değildir ve bazı durumlarda yeterli olmaz.
Matematiksel tanım şudur: Pozitif bir f(N) fonksiyonu için, yeterince büyük N değerleri için aşağıdaki sağlanacak şekilde bir C sabiti bulabiliyorsak f(N) = O(g(N))’dir:
f(N) ≤ C × g(N)
Bu tanımı kullanarak f(N) = 4N2 + 2N + 7 = O(N2) olduğunu gösterebiliriz. Bu durumda C = 5 seçebilir ve N > 4 için f(N) ≤ 5 × N2 eşitsizliğinin sağlandığını görebiliriz:
Artık Büyük-O gösteriminin temellerini anladığımıza göre, en verimliden başlayarak yaygın zaman karmaşıklıklarını ve sonuçlarını inceleyelim: sabit zaman.
Sabit zaman: O(1)
Adından da anlaşılacağı gibi, sabit zamanlı algoritmaların zaman karmaşıklığı sabittir; yani performansları veri miktarına bağlı değildir. Bu algoritmalar genellikle iki nokta arasındaki mesafenin hesaplanması gibi sabit sayıda girdiyle yapılan hesaplamaları içerir.
İki nokta arasındaki mesafe, iki noktanın x ve y koordinatları arasındaki farkın karekökü alınarak hesaplanır.
dist fonksiyonu aşağıda iki nokta arasındaki mesafeyi hesaplar. Üç temel komuttan oluşur ve bu bir sabittir. Bu durumda zaman karmaşıklığının O(1) olduğunu yazarız.
İlginçtir ki, bir fonksiyon büyük veri kümelerini işlerken bile sabit zaman karmaşıklığı sergileyebilir. Örneğin, bir listenin uzunluğunu len fonksiyonuyla hesaplamak bu duruma örnektir. Bu işlem O(1)’dir; çünkü uygulama, listenin boyutunu dahili olarak takip eder ve her uzunluk isteğinde elemanları tek tek saymaya gerek kalmaz.
Doğrusal zaman: O(N)
sum_list’i daha önce doğrusal zamanlı bir fonksiyon örneği olarak tartıştık. Genel olarak, doğrusal zamanlı algoritmalar, her veri noktasını tek tek incelemeyi gerektiren görevleri yürütür. Minimum, maksimum veya ortalama hesaplamak bu kategoriye tipik birer örnektir.
Aşağıdaki, bir listenin minimum değerini hesaplayan fonksiyonu analiz ederek pratik yapalım:
Liste N elemanlıysa, karmaşıklık 1 + (N - 1) + 1 = N + 1 = O(N)’dir.
Doğrusal zamanlı algoritmaların yürütme süresi, veri miktarıyla doğru orantılıdır. Dolayısıyla veri miktarı ikiye katlanırsa, algoritmanın veriyi işlemesi için gereken süre de ikiye katlanmalıdır.
Logaritmik zaman: O(log(N))
Sayı tahmin oyunu, 1 ile N arasında gizli bir sayıyı mümkün olan en az denemeyle bulmayı amaçlar. Her tahminden sonra gizli sayının tahminimizden büyük mü, küçük mü yoksa eşit mi olduğunu belirten geri bildirim alırız. Tahmin doğruysa oyunu kazanırız; değilse tahmin etmeye devam ederiz.
Bu oyun için etkili stratejilerden biri, sürekli olarak orta noktayı tahmin etmektir. Örneğin N = 15 olsun. Bu durumda ilk tahminimiz 8 olur. Gizli sayı 8’den küçükse 1 ile 7 arasındadır. Büyükse 9 ile 15 arasındadır. Doğru cevabı bulana kadar kalan aralığın orta noktasını tahmin etmeye devam ederiz. Aşağıdaki diyagram bu stratejinin izleyebileceği olası yolları gösterir.
Bu yaklaşımın zaman karmaşıklığını inceleyelim. Önceki örneklerden farklı olarak, bu algoritmanın adım sayısı yalnızca N giriş boyutuna bağlı değildir; ilk denemede doğru tahmin etme olasılığı vardır.
Bu tür algoritmaları analiz ederken en kötü duruma odaklanırız. Örneğin N = 15 için, en kötü durumda 4 tahmin yapmamız gerekir. Her tahmin, orta nokta olduğundan, kalan olasılıkların yarısını eler. En kötü durumda tek bir olasılık kalana kadar tahmin etmeye devam ederiz. Dolayısıyla yanıtlamamız gereken soru şudur:
1 elde etmek için N’i kaç kez 2’ye bölmeliyiz?
Cevap, log2(N) ile gösterilen 2 tabanındaki logaritmadır. Doğru sayıyı saptamak için kullanılan bu algoritmaya ikili arama denir. Maksimum tahmin sayısı log2(N) olduğundan, karmaşıklığını O(log2(N)) veya basitçe O(log(N)) olarak ifade edebiliriz; zira sabitler zaman karmaşıklığı gösteriminde önemsizdir.
Çok yavaş büyüme hızından ötürü logaritmik zaman karmaşıklığı pratikte çok arzu edilir; neredeyse sabit zaman gibi davranır. N büyük olsa bile toplam işlem sayısı şaşırtıcı derecede düşük kalır. Örneğin N bir milyar olsa dahi gereken işlem sayısı yalnızca yaklaşık 30’dur.
İkili arama, bilgisayar bilimlerinde sayısız uygulaması olan temel bir algoritmadır. Örneğin doğal dil işlemede, yazım denetleyicileri ve otomatik düzeltme sistemleri aday kelimeleri verimli şekilde belirlemek için ikili aramanın varyantlarını kullanabilir.
Karesel zaman: O(N2)
Veri sıralama, bilgisayarların sık sık gerçekleştirmesi gereken temel bir görevdir. N sayıdan oluşan bir listeyi sıralamanın yöntemlerinden biri, listedeki minimum elemanı yinelemeli olarak bulmaktır.
for döngüsünün karmaşıklığını analiz etmek için, içindeki komutların karmaşıklığını değerlendirir ve ardından bu sonucu döngünün yürütüldüğü yineleme sayısıyla çarparız.
Bir listenin minimumunu hesaplamak ve bir elemanı listeden kaldırmak O(N) işlemlerdir. Ekleme işlemi sabit zamanda, O(1) yapılır. Bu nedenle, döngünün her yinelemesinin karmaşıklığı O(N + N + 1) = O(2N + 1) olup O(N)’e sadeleşir. N tane yineleme olduğuna göre karmaşıklık N × O(N) = O(N2) olur. selection_sort() fonksiyonunun geri kalanı üç basit komuttan oluşur; dolayısıyla toplam karmaşıklık O(N2 + 3) = O(N2)’dir.
Döngü analizimizde bir basitleştirme yaptık. Her yinelemede listeden bir eleman çıkarıyoruz; bu da tüm yinelemelerin aynı sayıda komut yürütmediği anlamına gelir. İlk yineleme N komut yürütür, ikincisi N - 1, üçüncüsü N - 2 ve bu desen, son yinelemede yalnızca 1 komut yürütülene kadar devam eder.
Bu, döngünün gerçek karmaşıklığının şu olduğu anlamına gelir:
N + (N - 1) + (N - 2) + … + 1
Bu toplamın (N2 + N) / 2’ye eşit olduğu gösterilebilir. Ancak,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Fazla saymış olsak da toplam karmaşıklık yine kareseldir. selection_sort() fonksiyonu, karesel karmaşıklığı O(N2) nedeniyle daha yavaş bir sıralama algoritmasına örnektir.
Karesel karmaşıklığa sahip fonksiyonlar kötü ölçeklenir; küçük listeler için uygun olsalar da milyonlarca veri noktasını sıralamak için pratik değildirler; görevi tamamlamaları günler sürebilir. Veri miktarını ikiye katlamak, yürütme süresini dörde katlar.
Log-doğrusal zaman: O(Nlog(N))
O(N log(N)) zaman karmaşıklığına sahip bir sıralama algoritması tasarlamak mümkündür. Bu algoritmalardan biri birleştirme sıralaması (merge sort) olarak adlandırılır. Uygulama ayrıntılarına girmeyeceğiz; ancak daha fazla bilgi edinmek isterseniz bu kurstaki birleştirme sıralamasına hızlı giriş yazısına göz atabilirsiniz: Python’da Veri Yapıları ve Algoritmalar.
Daha önce de belirtildiği gibi, logaritmik karmaşıklık pratikte sabit karmaşıklığa benzer davranır. Bu nedenle, O(N log(N)) bir algoritmanın yürütme süresi, gerçek hayatta doğrusal zamanlı bir algoritmayla karşılaştırılabilir olabilir.
Aşağıdaki grafik, N log(N) ile N’in benzer hızda büyüdüğünü; N2’nin ise çok hızlı büyüyerek kısa sürede çok yavaşladığını gösterir.
Kübik zaman: O(N3)
Yapay zekâda yaygın olarak kullanılan kübik zaman karmaşıklığına sahip bir algoritma, büyük dil modelleri (ör. GPT) gibi sistemlerin işleyişinde kritik rol oynayan matris çarpımıdır. Bu algoritma, hem eğitim hem çıkarım aşamalarında yapılan hesaplamalar için temel önemdedir.
N x N boyutlarında iki A ve B matrisini çarpmak için, ilk matris A’nın her satırını ikinci matris B’nin her sütunu ile çarpmamız gerekir. Özellikle, (i, j) girişindeki çarpımın değeri, A’nın i. satırındaki elemanların B’nin j. sütunundaki karşılık gelen elemanlarla çarpılıp toplanmasıyla belirlenir.
İşte matris çarpımının bir Python uygulaması:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionAltyapı:
Toplamda, matrix_mul() N3 + N2 + 2 komut yürütür; bu nedenle zaman karmaşıklığı O(N3)’tür.
Alternatif olarak, hesaplamalar üzerinden akıl yürüterek karmaşıklığı analiz edebilirdik. Matris çarpımının sonucu N2 girişe sahiptir. Her girişin hesaplanması O(N) zaman alır; dolayısıyla toplam karmaşıklık N2 × O(N) = O(N3)’tür.
Kübik zamanlı algoritmalar oldukça yavaştır. Veri miktarını ikiye katlamak, yürütme süresini sekiz katına çıkarır; bu da bu algoritmaların çok kötü ölçeklenmesine yol açar. Nispeten küçük N değerlerinde bile komut sayısı çok hızlı biçimde patlar.
Matris çarpımı, donanımdaki ilerlemelerin büyük etki yarattığı bir hesaplama zorluğuna örnektir. Matris çarpımı için biraz daha verimli algoritmalar olsa da, esasen matris çarpımı yapmak için özel olarak tasarlanan GPU yongalarının tasarımındaki ilerlemeler, GPT gibi büyük modellerin makul sürelerde eğitilmesini önemli ölçüde kolaylaştırmıştır.
Daha yakın zamanda, araştırmacılar büyük öğrenme modellerinden matris çarpımını çıkarmayı önerdiler — bununla ilgili daha fazla bilgiyi şu yazıda okuyabilirsiniz: MatMul-Free LLM’ler: Temel Kavramlar Açıklanıyor.
Üstel zaman karmaşıklığı: O(2N) ve O(N!)
Üstel zamanlı algoritmalar genellikle bir problemin tüm olası çözümlerinin denenmesiyle ortaya çıkar. N teslimat noktasını ziyaret etmesi gereken bir teslimat kamyonu için bir rota planlamayı düşünün. Bu problemi ele almanın bir yolu, tüm olası teslimat sıralarını değerlendirmektir. Python itertools paketi, bir listenin tüm permütasyonları arasında gezinmek için basit bir yöntem sunar.
import itertools
for order in itertools.permutations([1,2,3]):print(order)Altyapı:
Uzunluğu N olan bir listenin permütasyonlarının sayısı N! ile gösterilir ve “N faktöriyel” diye okunur. Faktöriyel fonksiyonu üstel büyür. Örneğin N = 13 iken permütasyon sayısı 1 milyarı aşar.
Teslimat konumlarının bir 2B nokta listesi olarak verildiğini varsayalım. Bu durumda, tüm olası sıralamalar boyunca dolaşırken en iyisini takip ederek toplam mesafeyi en aza indiren teslimat sırasını belirleyebiliriz.
İlk for döngüsü N! kez yürütülür. Bu nedenle, optimize_route() içindeki işlem sayısı N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3’tür.
Zaman karmaşıklığını hesaplarken düşük üslü terimleri yok saymayı öğrenmiştik. Ancak bu senaryoda N’in bir kuvveti olmayan bir N! terimiyle karşılaşıyoruz. Sadeleştirme stratejimizi, büyüme hızı daha yavaş olan terimleri eleyecek şekilde rafine edebiliriz. Aşağıdaki tabloda, bir algoritmanın zaman karmaşıklığında yaygın olarak bulunan terimler, en düşükten en yükseğe büyüme hızına göre sıralanmıştır.
1
log(N)
N
N2
N3
Nk
2N
N!
Dolayısıyla, optimize_route()’un zaman karmaşıklığını N! x N + 2N! + 3 = O(N! x N) olarak ifade edebiliriz.
Üstel zaman karmaşıklığına sahip algoritmalar genellikle yalnızca çok küçük örnekler için etkilidir. Sadece 13 konumla bile permütasyon sayısı 1 milyarı aştığından, bu algoritma gerçek dünya senaryolarında uygulanabilir değildir.
Zaman Karmaşıklığı: En Kötü Durum ve En İyi Durum
Sayı tahmin oyununda en kötü durum karmaşıklığına odaklandık. En kötü duruma odaklanarak, algoritmanın yürütme süresinin büyüme hızını garanti altına alırız.
En iyi durumda, ilk seferde tahmin ederiz; dolayısıyla en iyi durum analizi O(1) karmaşıklığı verir. Bu doğrudur — en iyi durumda tek bir sabit işleme ihtiyaç duyarız. Ancak bu pek kullanışlı değildir; çünkü oldukça düşük bir olasılıktır.
Genel olarak, bir algoritmanın karmaşıklığını analiz ederken her zaman en kötü duruma odaklanırız; çünkü:
Performans garantisi: En kötü durum karmaşıklığına odaklanarak, algoritmanın belirli bir eşiğin altında asla daha kötü performans göstermeyeceğinden emin olabiliriz. Bu, gecikmelerin ciddi sorunlara yol açabileceği gerçek zamanlı sistemler gibi güvenilir performans gerektiren uygulamalar için kritiktir.
Güvenlik ve güvenilirlik: En kötü durum analizi, en zorlu senaryoları kaldırabilecek sağlam algoritmalar tasarlamaya yardımcı olur. En kötü koşullarda bile algoritmanın kabul edilebilir sınırlar içinde çalışmasını sağlar.
Üst sınır: En kötü durum karmaşıklığını bilmek bize performans için bir üst sınır verir. Bu, bir algoritmanın ihtiyaç duyabileceği maksimum kaynakları (zaman, bellek) anlamak için yararlıdır.
Zaman Karmaşıklığı: Pratik Sonuçlar
Zaman karmaşıklığı çok teorik bir konu gibi görünebilir; ancak pratikte oldukça yararlı olabilir.
Örneğin bir fonksiyon sürekli olarak küçük bir veri kümesini işliyorsa, anlaşılması kolay bir O(N2) algoritması, karmaşık ve bakımı zor bir O(N) algoritmasından daha uygun olabilir. Ancak bu, uygulamanın artan kullanıcı trafiğini kaldıramadığı durumlarda hazırlıksız yakalanmamak için bilinçli bir karar olmalıdır.
Zaman karmaşıklığı analizi, küçük kod iyileştirmelerinin bir algoritmanın yürütme süresi üzerinde ihmal edilebilir bir etkisi olduğunu gösterir. Önemli iyileştirmeler, sonucu hesaplamak için gereken temel işlem sayısını kökten azaltmakla elde edilir. Genel olarak, kodu anlaşılmaz hâle getirecek kadar optimize etmektense, temiz ve anlaşılır kodu korumak tercih edilir.
Kodun daha yavaş kısımları, diğerlerine baskın gelir. Daha yavaş olanı optimize etmeden önce daha hızlı olanı optimize etmek genellikle anlamsızdır. Örneğin, iki görev gerçekleştiren bir fonksiyonumuz olduğunu hayal edin:
Eğer clean_data() fonksiyonu O(N2) ve analyze_data() O(N3) karmaşıklığına sahipse, clean_data()’nın karmaşıklığını düşürmek process_data()’nın toplam karmaşıklığını iyileştirmez. Odaklanılması gereken analyze_data() fonksiyonunu iyileştirmektir.
Ayrıca zaman karmaşıklığı, donanım kararlarını da bilgilendirebilir. Örneğin, O(N3) bir algoritma, zayıf ölçeklenebilirliğine rağmen, üstün donanımda veya daha hızlı bir programlama dilinde çalıştırılırsa, verisi sınırlı görevler için yine de yeterince hızlı olabilir. Tersine, bir algoritmanın üstel zaman karmaşıklığı O(2N) ise, hiçbir donanım yükseltmesi yeterli olmayacaktır; bu da daha verimli bir algoritmaya ihtiyaç olduğunu gösterir.
Sonuç
Bilgisayarlar hızlansa da, hiç olmadığı kadar çok veriyle uğraşıyoruz. Şöyle düşünün: İnternet’i, akıllı telefonları veya akıllı ev cihazlarını her kullandığımızda tonlarca bilgi üretiyoruz. Bu veri yığını büyüdükçe, içinden kayda değer olanı ayıklamak ve bulmak zorlaşıyor. Bu yüzden araçlarımızı — özellikle algoritmaları — tüm bu bilgiyi işleme ve anlama konusunda daha iyi hâle getirmek çok önemli.
Zaman karmaşıklığı analizi, bir algoritmanın yürütme süresi hakkında akıl yürütmek için yalın bir çerçeve sunar. Birincil amacı, tam yürütme sürelerini tahmin etmekten ziyade, zaman karmaşıklığının büyüme hızı hakkında içgörü sağlamaktır. Modelin pek çok basitleştirme ve varsayımına rağmen, pratikte son derece yararlı olduğu kanıtlanmış, algoritma yürütme süresi davranışlarının özünü etkili biçimde yakalamıştır.
Python yerleşik fonksiyonlarının zaman karmaşıklığını nasıl öğrenebilirim? ⌄
Bazen dokümantasyonda karmaşıklık belirtilir. Aksi hâlde, kaynak koda bakıp analiz etmek iyi bir egzersizdir. Çoğu dil, listeler ve sözlükler gibi yaygın veri yapıları için standart uygulamaları izler; bu nedenle bu veri yapılarının karmaşıklıklarını araştırmak doğru cevabı verir. Yaygın işlemlerin karmaşıklığını daha iyi anlamak için veri yapıları ve algoritmalar üzerine genel bir kurs takip etmenizi öneririz.
k değeri ne olursa olsun, O(N^k) biçimindeki karmaşıklık her zaman O(2^N)’den daha mı iyidir?⌄
Teorik açıdan bakıldığında, evet. Yeterince büyük N için, üstel zamanlı algoritma eninde sonunda daha yavaş hâle gelir. Ancak üstel zamanlı algoritma, küçük N değerleri için çok daha iyi performans gösterebilir. Nadir bazı durumlarda yalnızca küçük veri kümeleriyle ilgileniriz; bu nedenle O(2N) algoritması tercih edilebilir.
Burada öğrendiğimizden farklı karmaşıklık fonksiyonları var mı?⌄
Evet. Çok tuhaf karmaşıklık fonksiyonlarına sahip algoritmalar da vardır; ancak neredeyse tüm algoritmalar için karmaşıklık, bu makalede bahsettiğimiz fonksiyonları içerir.
Daha iyi bir algoritma bulmanın mümkün olup olmadığını nasıl bilebiliriz?⌄
Genelde zor bir sorudur. Daha iyi zaman karmaşıklığına sahip bir algoritma olmadığını kanıtlamak, problem hakkında akıl yürütmeyi ve daha az işlemle çözmenin imkânsız olduğunu göstermeyi gerektirir. Bazı durumlarda bu kolaydır. Örneğin, bir listenin belirli bir değeri içerip içermediğini bulmak için, O(N)’den daha düşük karmaşıklığa sahip bir algoritmaya sahip olmak imkânsızdır; çünkü en kötü durumda yanıtı bulmak için tüm elemanlara bakmamız gerekir.
Algoritma rastgelelik içeriyorsa zaman karmaşıklığını nasıl analiz ederiz?⌄
Rastgelelik söz konusu olsa bile, genellikle rastgele sonuçların en kötü olası durumu hakkında akıl yürütmek ve karmaşıklığı türetmek mümkündür. Alternatif olarak, bazı rastgeleleştirilmiş algoritmalar için, beklenen işlem sayısını inceleyerek ortalama karmaşıklığı analiz ederiz.
CheapGPT’te full-stack mühendisi ve kurucuyum. Öğretmek her zaman tutkum oldu. Öğrencilik yıllarımdan itibaren diğer öğrencilere ders verme ve yardımcı olma fırsatlarını hevesle aradım. Bu tutku beni doktora yapmaya yönlendirdi; bu süreçte akademik çalışmalarımı desteklemek için araştırma görevlisi olarak da görev aldım. O yıllarda, geleneksel sınıf ortamında bağlar kurmaktan ve öğrenmeyi kolaylaştırmaktan büyük bir tatmin duydum. Ancak çevrim içi öğrenme platformlarının ortaya çıkmasıyla birlikte dijital eğitimin dönüştürücü potansiyelini fark ettim. Nitekim üniversitemizde bu tür bir platformun geliştirilmesinde aktif rol aldım. Geleneksel öğretim ilkelerini yenilikçi dijital yöntemlerle bütünleştirmeye derinden bağlıyım. Tutkum, yalnızca ilgi çekici ve bilgilendirici olmakla kalmayan, aynı zamanda bu dijital çağdaki öğrenenler için erişilebilir kurslar tasarlamaktır.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!





Zaman karmaşıklığı analizi, algoritmaların verimliliğini hem uygulandıkları dil hem de çalıştırıldıkları donanımdan bağımsız bir şekilde analiz edip öngörmenin bir yolunu sunar.
Zaman karmaşıklığı analizinin amacı, bir algoritmanın tam çalışma süresini tahmin etmek değil, şu soruları yanıtlayabilmektir:
Bu makalenin sonunda, bir algoritmanın zaman karmaşıklığını nasıl analiz edeceğinizi ve bu soruları nasıl yanıtlayacağınızı öğrenmiş olacaksınız.
2024’te Zaman Karmaşıklığı Hâlâ Önemli mi?
Bilgisayarlar giderek hızlanıyor; bu nedenle, artık zaman karmaşıklığı konusunda endişelenmeye gerek kalıp kalmadığı merak edilebilir. Günümüzde bir süper bilgisayar, hangi algoritmayı kullanırsak kullanalım her problemi halledebilir, öyle değil mi?
Pek öyle değil. Yapay zekâ patlaması, büyük ölçüde son yıllarda donanım performansındaki muazzam ilerlemeler sayesinde yaşandı. Ancak en gelişmiş donanımda bile, yavaş bir algoritma kullanıldığında basit problemler felakete varan performans düşüşlerine yol açabilir.
Örneğin, on milyon kayıttan oluşan bir veritabanı tablosunu sıralamak için naif bir algoritma kullandığınızı düşünün. Modern bir bilgisayarda bile bu basit işlem günler sürebilir ve veritabanını pratik uygulamalar için kullanılamaz hâle getirir. Buna karşılık, verimli bir algoritma kullanırsak bunun bir saniyenin onda birinden kısa sürede gerçekleşmesini bekleriz.
Temel İşlemler ve Temel Komutlar
Bir algoritmayı Rastgele Erişim Makinesi (RAM veya RA-makine) modeliyle analiz ederiz. Bu model, aşağıdaki işlemlerin tam olarak bir zaman adımı aldığı varsayımına dayanır:
ifveyareturngibi deyimlerBu işlemlere temel işlemler denir. Sabit sayıda temel işlem yürüten bir kod satırına temel komut denir.
Temel komut içindeki işlem sayısı sabit olduğundan, veri miktarına bağlı değildir. Yürütme süresinin veri miktarı arttıkça nasıl büyüdüğüyle ilgilendiğimiz için, algoritmanın gerçekleştirdiği temel komut sayısını saymaya odaklanabiliriz.
forvewhilegibi fonksiyon çağrıları ve döngüler, içlerindeki temel komutların sayısı toplanarak değerlendirilir. Aşağıdaki, bir listenin elemanlarını toplayan kodu ele alalım.Temel komut sayısını görselleştirmeye yardımcı olmak için her satıra yorum ekledik.
lst’nin uzunluğu N ise, toplam temel komut sayısı 1 + N + 1 = N + 2’dir.Büyük-O Gösterimi
İki sıralama algoritmamız olduğunu düşünelim. Her biri için temel komut sayısını hesapladık ve şu ifadeleri elde ettik:
Birinci algoritma
İkinci algoritma
4N2 + 2N + 7
3N2 + 5N + 13
İlk bakışta hangisinin daha iyi ölçeklendiği açık değildir. Büyük-O gösterimi, şu sadeleştirmeleri uygulayarak bu ifadeleri daha da basitleştirmenin bir yolunu sunar:
Bu süreci her iki ifadeye de uygularsak, her iki durumda da N2 elde ederiz:
Sadeleştirme sonrası elde ettiğimiz ifade, algoritmanın zaman karmaşıklığıdır ve O() ile gösteririz. Bu durumda 4N2 + 2N + 7 = O(N2) ve 3N2 + 5N + 13 = O(N2) yazabiliriz. Bu, her iki algoritmanın da aynı zaman karmaşıklığına sahip olduğu, yani listenin eleman sayısının karesiyle orantılı olduğu anlamına gelir.
Yukarıda,
sum_listalgoritmasının, listenin uzunluğu N olmak üzere N + 2 işlem yaptığını hesaplamıştık. Aynı sadeleştirmeleri uygularsak N elde ederiz; dolayısıylasum_list’in zaman karmaşıklığı O(N)’dir.Bu, yürütme süresinin liste boyutuyla orantılı olduğu anlamına gelir. Bu beklenir; çünkü toplamı hesaplarken, listedeki eleman sayısını ikiye katlamak, gereken işi de ikiye katlamalıdır; ne daha az ne daha çok.
Büyük-O gösterimi: sezgisel açıklama
Düşük terimleri yok sayabiliriz; çünkü N büyüdükçe, bu terimlerin toplam üzerindeki etkisi en yüksek terime kıyasla önemsiz hâle gelir. Aşağıdaki grafik, 4N2, 2N ve 7 terimlerinin her birinin toplam içindeki katkısını gösterir.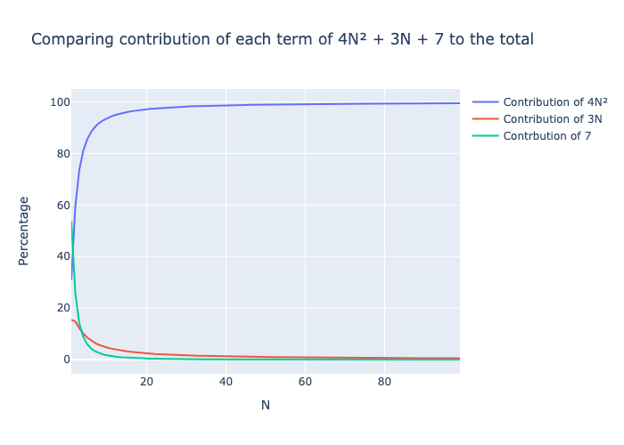
Karesel terim 4N2, küçük N değerlerinde bile, toplam işlem sayısının neredeyse %100’ünü çok hızlı bir şekilde oluşturur. Bu nedenle, büyük miktarda verilerle uğraşırken daha düşük dereceli terimlere karşılık gelen süreler, daha yüksek dereceli terimlere kıyasla göz ardı edilebilir düzeyde olacaktır.
Çarpan sabiti, veri miktarından bağımsız olduğu için atarız.
Büyük-O gösterimi: matematiksel tanım
Yukarıdaki adımlar, çoğu pratik durumda bir algoritmanın zaman karmaşıklığını doğru biçimde çıkarmak için yeterlidir. Bir algoritmanın gerçekleştirdiği temel komut sayısını sayar ve bir f(N) ifadesi elde ederiz. İki sadeleştirme adımını uyguladıktan sonra basitleştirilmiş bir g(N) ifadesi elde ederiz. Ardından f(N) = O(g(N)) yazabiliriz. “f, g’nin büyük O’sudur” diye okunur.
Ancak bu, resmi bir matematiksel tanım değildir ve bazı durumlarda yeterli olmaz.
Matematiksel tanım şudur: Pozitif bir f(N) fonksiyonu için, yeterince büyük N değerleri için aşağıdaki sağlanacak şekilde bir C sabiti bulabiliyorsak f(N) = O(g(N))’dir:
f(N) ≤ C × g(N)
Bu tanımı kullanarak f(N) = 4N2 + 2N + 7 = O(N2) olduğunu gösterebiliriz. Bu durumda C = 5 seçebilir ve N > 4 için f(N) ≤ 5 × N2 eşitsizliğinin sağlandığını görebiliriz:
Pratikte, yukarıdaki sadeleştirme kurallarını kullanacağız.
Zaman Karmaşıklığı Türleri
Artık Büyük-O gösteriminin temellerini anladığımıza göre, en verimliden başlayarak yaygın zaman karmaşıklıklarını ve sonuçlarını inceleyelim: sabit zaman.
Sabit zaman: O(1)
Adından da anlaşılacağı gibi, sabit zamanlı algoritmaların zaman karmaşıklığı sabittir; yani performansları veri miktarına bağlı değildir. Bu algoritmalar genellikle iki nokta arasındaki mesafenin hesaplanması gibi sabit sayıda girdiyle yapılan hesaplamaları içerir.
İki nokta arasındaki mesafe, iki noktanın x ve y koordinatları arasındaki farkın karekökü alınarak hesaplanır.
distfonksiyonu aşağıda iki nokta arasındaki mesafeyi hesaplar. Üç temel komuttan oluşur ve bu bir sabittir. Bu durumda zaman karmaşıklığının O(1) olduğunu yazarız.İlginçtir ki, bir fonksiyon büyük veri kümelerini işlerken bile sabit zaman karmaşıklığı sergileyebilir. Örneğin, bir listenin uzunluğunu len fonksiyonuyla hesaplamak bu duruma örnektir. Bu işlem O(1)’dir; çünkü uygulama, listenin boyutunu dahili olarak takip eder ve her uzunluk isteğinde elemanları tek tek saymaya gerek kalmaz.
Doğrusal zaman: O(N)
sum_list’i daha önce doğrusal zamanlı bir fonksiyon örneği olarak tartıştık. Genel olarak, doğrusal zamanlı algoritmalar, her veri noktasını tek tek incelemeyi gerektiren görevleri yürütür. Minimum, maksimum veya ortalama hesaplamak bu kategoriye tipik birer örnektir.Aşağıdaki, bir listenin minimum değerini hesaplayan fonksiyonu analiz ederek pratik yapalım:
Liste N elemanlıysa, karmaşıklık 1 + (N - 1) + 1 = N + 1 = O(N)’dir.
Doğrusal zamanlı algoritmaların yürütme süresi, veri miktarıyla doğru orantılıdır. Dolayısıyla veri miktarı ikiye katlanırsa, algoritmanın veriyi işlemesi için gereken süre de ikiye katlanmalıdır.
Logaritmik zaman: O(log(N))
Sayı tahmin oyunu, 1 ile N arasında gizli bir sayıyı mümkün olan en az denemeyle bulmayı amaçlar. Her tahminden sonra gizli sayının tahminimizden büyük mü, küçük mü yoksa eşit mi olduğunu belirten geri bildirim alırız. Tahmin doğruysa oyunu kazanırız; değilse tahmin etmeye devam ederiz.
Bu oyun için etkili stratejilerden biri, sürekli olarak orta noktayı tahmin etmektir. Örneğin N = 15 olsun. Bu durumda ilk tahminimiz 8 olur. Gizli sayı 8’den küçükse 1 ile 7 arasındadır. Büyükse 9 ile 15 arasındadır. Doğru cevabı bulana kadar kalan aralığın orta noktasını tahmin etmeye devam ederiz. Aşağıdaki diyagram bu stratejinin izleyebileceği olası yolları gösterir.
Bu yaklaşımın zaman karmaşıklığını inceleyelim. Önceki örneklerden farklı olarak, bu algoritmanın adım sayısı yalnızca N giriş boyutuna bağlı değildir; ilk denemede doğru tahmin etme olasılığı vardır.
Bu tür algoritmaları analiz ederken en kötü duruma odaklanırız. Örneğin N = 15 için, en kötü durumda 4 tahmin yapmamız gerekir. Her tahmin, orta nokta olduğundan, kalan olasılıkların yarısını eler. En kötü durumda tek bir olasılık kalana kadar tahmin etmeye devam ederiz. Dolayısıyla yanıtlamamız gereken soru şudur:
1 elde etmek için N’i kaç kez 2’ye bölmeliyiz?
Cevap, log2(N) ile gösterilen 2 tabanındaki logaritmadır. Doğru sayıyı saptamak için kullanılan bu algoritmaya ikili arama denir. Maksimum tahmin sayısı log2(N) olduğundan, karmaşıklığını O(log2(N)) veya basitçe O(log(N)) olarak ifade edebiliriz; zira sabitler zaman karmaşıklığı gösteriminde önemsizdir.
Çok yavaş büyüme hızından ötürü logaritmik zaman karmaşıklığı pratikte çok arzu edilir; neredeyse sabit zaman gibi davranır. N büyük olsa bile toplam işlem sayısı şaşırtıcı derecede düşük kalır. Örneğin N bir milyar olsa dahi gereken işlem sayısı yalnızca yaklaşık 30’dur.
İkili arama, bilgisayar bilimlerinde sayısız uygulaması olan temel bir algoritmadır. Örneğin doğal dil işlemede, yazım denetleyicileri ve otomatik düzeltme sistemleri aday kelimeleri verimli şekilde belirlemek için ikili aramanın varyantlarını kullanabilir.
Karesel zaman: O(N2)
Veri sıralama, bilgisayarların sık sık gerçekleştirmesi gereken temel bir görevdir. N sayıdan oluşan bir listeyi sıralamanın yöntemlerinden biri, listedeki minimum elemanı yinelemeli olarak bulmaktır.
fordöngüsünün karmaşıklığını analiz etmek için, içindeki komutların karmaşıklığını değerlendirir ve ardından bu sonucu döngünün yürütüldüğü yineleme sayısıyla çarparız.Bir listenin minimumunu hesaplamak ve bir elemanı listeden kaldırmak O(N) işlemlerdir. Ekleme işlemi sabit zamanda, O(1) yapılır. Bu nedenle, döngünün her yinelemesinin karmaşıklığı O(N + N + 1) = O(2N + 1) olup O(N)’e sadeleşir. N tane yineleme olduğuna göre karmaşıklık N × O(N) = O(N2) olur.
selection_sort()fonksiyonunun geri kalanı üç basit komuttan oluşur; dolayısıyla toplam karmaşıklık O(N2 + 3) = O(N2)’dir.Döngü analizimizde bir basitleştirme yaptık. Her yinelemede listeden bir eleman çıkarıyoruz; bu da tüm yinelemelerin aynı sayıda komut yürütmediği anlamına gelir. İlk yineleme N komut yürütür, ikincisi N - 1, üçüncüsü N - 2 ve bu desen, son yinelemede yalnızca 1 komut yürütülene kadar devam eder.
Bu, döngünün gerçek karmaşıklığının şu olduğu anlamına gelir:
N + (N - 1) + (N - 2) + … + 1
Bu toplamın (N2 + N) / 2’ye eşit olduğu gösterilebilir. Ancak,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Fazla saymış olsak da toplam karmaşıklık yine kareseldir.
selection_sort()fonksiyonu, karesel karmaşıklığı O(N2) nedeniyle daha yavaş bir sıralama algoritmasına örnektir.Karesel karmaşıklığa sahip fonksiyonlar kötü ölçeklenir; küçük listeler için uygun olsalar da milyonlarca veri noktasını sıralamak için pratik değildirler; görevi tamamlamaları günler sürebilir. Veri miktarını ikiye katlamak, yürütme süresini dörde katlar.
Log-doğrusal zaman: O(N log(N))
O(N log(N)) zaman karmaşıklığına sahip bir sıralama algoritması tasarlamak mümkündür. Bu algoritmalardan biri birleştirme sıralaması (merge sort) olarak adlandırılır. Uygulama ayrıntılarına girmeyeceğiz; ancak daha fazla bilgi edinmek isterseniz bu kurstaki birleştirme sıralamasına hızlı giriş yazısına göz atabilirsiniz: Python’da Veri Yapıları ve Algoritmalar.
Daha önce de belirtildiği gibi, logaritmik karmaşıklık pratikte sabit karmaşıklığa benzer davranır. Bu nedenle, O(N log(N)) bir algoritmanın yürütme süresi, gerçek hayatta doğrusal zamanlı bir algoritmayla karşılaştırılabilir olabilir.
Aşağıdaki grafik, N log(N) ile N’in benzer hızda büyüdüğünü; N2’nin ise çok hızlı büyüyerek kısa sürede çok yavaşladığını gösterir.
Kübik zaman: O(N3)
Yapay zekâda yaygın olarak kullanılan kübik zaman karmaşıklığına sahip bir algoritma, büyük dil modelleri (ör. GPT) gibi sistemlerin işleyişinde kritik rol oynayan matris çarpımıdır. Bu algoritma, hem eğitim hem çıkarım aşamalarında yapılan hesaplamalar için temel önemdedir.
N x N boyutlarında iki A ve B matrisini çarpmak için, ilk matris A’nın her satırını ikinci matris B’nin her sütunu ile çarpmamız gerekir. Özellikle, (i, j) girişindeki çarpımın değeri, A’nın i. satırındaki elemanların B’nin j. sütunundaki karşılık gelen elemanlarla çarpılıp toplanmasıyla belirlenir.
İşte matris çarpımının bir Python uygulaması:
Toplamda,
matrix_mul()N3 + N2 + 2 komut yürütür; bu nedenle zaman karmaşıklığı O(N3)’tür.Alternatif olarak, hesaplamalar üzerinden akıl yürüterek karmaşıklığı analiz edebilirdik. Matris çarpımının sonucu N2 girişe sahiptir. Her girişin hesaplanması O(N) zaman alır; dolayısıyla toplam karmaşıklık N2 × O(N) = O(N3)’tür.
Kübik zamanlı algoritmalar oldukça yavaştır. Veri miktarını ikiye katlamak, yürütme süresini sekiz katına çıkarır; bu da bu algoritmaların çok kötü ölçeklenmesine yol açar. Nispeten küçük N değerlerinde bile komut sayısı çok hızlı biçimde patlar.
Matris çarpımı, donanımdaki ilerlemelerin büyük etki yarattığı bir hesaplama zorluğuna örnektir. Matris çarpımı için biraz daha verimli algoritmalar olsa da, esasen matris çarpımı yapmak için özel olarak tasarlanan GPU yongalarının tasarımındaki ilerlemeler, GPT gibi büyük modellerin makul sürelerde eğitilmesini önemli ölçüde kolaylaştırmıştır.
Daha yakın zamanda, araştırmacılar büyük öğrenme modellerinden matris çarpımını çıkarmayı önerdiler — bununla ilgili daha fazla bilgiyi şu yazıda okuyabilirsiniz: MatMul-Free LLM’ler: Temel Kavramlar Açıklanıyor.
Üstel zaman karmaşıklığı: O(2N) ve O(N!)
Üstel zamanlı algoritmalar genellikle bir problemin tüm olası çözümlerinin denenmesiyle ortaya çıkar. N teslimat noktasını ziyaret etmesi gereken bir teslimat kamyonu için bir rota planlamayı düşünün. Bu problemi ele almanın bir yolu, tüm olası teslimat sıralarını değerlendirmektir. Python itertools paketi, bir listenin tüm permütasyonları arasında gezinmek için basit bir yöntem sunar.
Uzunluğu N olan bir listenin permütasyonlarının sayısı N! ile gösterilir ve “N faktöriyel” diye okunur. Faktöriyel fonksiyonu üstel büyür. Örneğin N = 13 iken permütasyon sayısı 1 milyarı aşar.
Teslimat konumlarının bir 2B nokta listesi olarak verildiğini varsayalım. Bu durumda, tüm olası sıralamalar boyunca dolaşırken en iyisini takip ederek toplam mesafeyi en aza indiren teslimat sırasını belirleyebiliriz.
İlk
fordöngüsü N! kez yürütülür. Bu nedenle,optimize_route()içindeki işlem sayısı N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3’tür.Zaman karmaşıklığını hesaplarken düşük üslü terimleri yok saymayı öğrenmiştik. Ancak bu senaryoda N’in bir kuvveti olmayan bir N! terimiyle karşılaşıyoruz. Sadeleştirme stratejimizi, büyüme hızı daha yavaş olan terimleri eleyecek şekilde rafine edebiliriz. Aşağıdaki tabloda, bir algoritmanın zaman karmaşıklığında yaygın olarak bulunan terimler, en düşükten en yükseğe büyüme hızına göre sıralanmıştır.
1
log(N)
N
N2
N3
Nk
2N
N!
Dolayısıyla,
optimize_route()’un zaman karmaşıklığını N! x N + 2N! + 3 = O(N! x N) olarak ifade edebiliriz.Üstel zaman karmaşıklığına sahip algoritmalar genellikle yalnızca çok küçük örnekler için etkilidir. Sadece 13 konumla bile permütasyon sayısı 1 milyarı aştığından, bu algoritma gerçek dünya senaryolarında uygulanabilir değildir.
Zaman Karmaşıklığı: En Kötü Durum ve En İyi Durum
Sayı tahmin oyununda en kötü durum karmaşıklığına odaklandık. En kötü duruma odaklanarak, algoritmanın yürütme süresinin büyüme hızını garanti altına alırız.
En iyi durumda, ilk seferde tahmin ederiz; dolayısıyla en iyi durum analizi O(1) karmaşıklığı verir. Bu doğrudur — en iyi durumda tek bir sabit işleme ihtiyaç duyarız. Ancak bu pek kullanışlı değildir; çünkü oldukça düşük bir olasılıktır.
Genel olarak, bir algoritmanın karmaşıklığını analiz ederken her zaman en kötü duruma odaklanırız; çünkü:
Zaman Karmaşıklığı: Pratik Sonuçlar
Zaman karmaşıklığı çok teorik bir konu gibi görünebilir; ancak pratikte oldukça yararlı olabilir.
Örneğin bir fonksiyon sürekli olarak küçük bir veri kümesini işliyorsa, anlaşılması kolay bir O(N2) algoritması, karmaşık ve bakımı zor bir O(N) algoritmasından daha uygun olabilir. Ancak bu, uygulamanın artan kullanıcı trafiğini kaldıramadığı durumlarda hazırlıksız yakalanmamak için bilinçli bir karar olmalıdır.
Zaman karmaşıklığı analizi, küçük kod iyileştirmelerinin bir algoritmanın yürütme süresi üzerinde ihmal edilebilir bir etkisi olduğunu gösterir. Önemli iyileştirmeler, sonucu hesaplamak için gereken temel işlem sayısını kökten azaltmakla elde edilir. Genel olarak, kodu anlaşılmaz hâle getirecek kadar optimize etmektense, temiz ve anlaşılır kodu korumak tercih edilir.
Kodun daha yavaş kısımları, diğerlerine baskın gelir. Daha yavaş olanı optimize etmeden önce daha hızlı olanı optimize etmek genellikle anlamsızdır. Örneğin, iki görev gerçekleştiren bir fonksiyonumuz olduğunu hayal edin:
Eğer
clean_data()fonksiyonu O(N2) veanalyze_data()O(N3) karmaşıklığına sahipse,clean_data()’nın karmaşıklığını düşürmekprocess_data()’nın toplam karmaşıklığını iyileştirmez. Odaklanılması gerekenanalyze_data()fonksiyonunu iyileştirmektir.Ayrıca zaman karmaşıklığı, donanım kararlarını da bilgilendirebilir. Örneğin, O(N3) bir algoritma, zayıf ölçeklenebilirliğine rağmen, üstün donanımda veya daha hızlı bir programlama dilinde çalıştırılırsa, verisi sınırlı görevler için yine de yeterince hızlı olabilir. Tersine, bir algoritmanın üstel zaman karmaşıklığı O(2N) ise, hiçbir donanım yükseltmesi yeterli olmayacaktır; bu da daha verimli bir algoritmaya ihtiyaç olduğunu gösterir.
Sonuç
Bilgisayarlar hızlansa da, hiç olmadığı kadar çok veriyle uğraşıyoruz. Şöyle düşünün: İnternet’i, akıllı telefonları veya akıllı ev cihazlarını her kullandığımızda tonlarca bilgi üretiyoruz. Bu veri yığını büyüdükçe, içinden kayda değer olanı ayıklamak ve bulmak zorlaşıyor. Bu yüzden araçlarımızı — özellikle algoritmaları — tüm bu bilgiyi işleme ve anlama konusunda daha iyi hâle getirmek çok önemli.
Zaman karmaşıklığı analizi, bir algoritmanın yürütme süresi hakkında akıl yürütmek için yalın bir çerçeve sunar. Birincil amacı, tam yürütme sürelerini tahmin etmekten ziyade, zaman karmaşıklığının büyüme hızı hakkında içgörü sağlamaktır. Modelin pek çok basitleştirme ve varsayımına rağmen, pratikte son derece yararlı olduğu kanıtlanmış, algoritma yürütme süresi davranışlarının özünü etkili biçimde yakalamıştır.
Daha fazla bilgisayar bilimi konusunu keşfetmek isterseniz, şu yazıma göz atın: Veri Yapıları: Python Örnekleriyle Kapsamlı Rehber.