
Cours
Structures de données et algorithmes en Python
4 h
47.1K
L’analyse de la complexité temporelle permet d’évaluer et de prévoir l’efficacité des algorithmes indépendamment du langage d’implémentation et du matériel d’exécution.
L’objectif n’est pas de prédire le temps d’exécution exact d’un algorithme, mais plutôt de pouvoir répondre aux questions suivantes :
À la fin de cet article, vous saurez analyser la complexité temporelle d’un algorithme et répondre à ces questions.
Les ordinateurs deviennent toujours plus rapides, et l’on pourrait se demander s’il est encore utile de se soucier de complexité temporelle. Un supercalculateur ne peut-il pas désormais résoudre n’importe quel problème quel que soit l’algorithme choisi ?
Pas vraiment. L’essor de l’IA tient en grande partie aux immenses progrès matériels de ces dernières années. Pourtant, même avec du matériel de pointe, des problèmes simples peuvent se traduire par des performances catastrophiques si l’algorithme est mal choisi.
Par exemple, imaginez trier une table de base de données de dix millions d’entrées avec un algorithme naïf. Même sur un ordinateur moderne, cette opération élémentaire prendrait plusieurs jours, rendant la base inutilisable. À l’inverse, avec un algorithme efficace, on peut s’attendre à moins d’un dixième de seconde.
Nous analysons un algorithme avec le modèle Random Access Machine (RAM ou machine à accès aléatoire). Ce modèle suppose que les opérations suivantes prennent exactement un pas de temps :
if ou returnCes opérations sont appelées opérations de base. Une ligne de code qui exécute un nombre constant d’opérations de base est une instruction de base.
Comme le nombre d’opérations d’une instruction de base est constant, il ne dépend pas de la quantité de données. Or, ce qui nous intéresse est la croissance du temps d’exécution avec la taille des données : nous pouvons donc nous concentrer sur le comptage du nombre d’instructions de base exécutées par l’algorithme.
Les appels de fonctions et les boucles comme for et while sont évalués en additionnant les instructions de base qu’ils contiennent. Considérez le code suivant qui calcule la somme des éléments d’une liste.
def sum_list(lst):
  total = 0          # 1 instruction
  for value in lst:
    total += value   # executed len(lst) times
  return total       # 1 instruction
Nous avons ajouté des commentaires pour visualiser le nombre d’instructions de base. Si N est la longueur de lst, alors le nombre total d’instructions de base est 1 + N + 1 = N + 2.
Imaginons deux algorithmes de tri. Nous avons compté le nombre d’instructions de base pour chacun et obtenu les expressions suivantes :
|
Premier algorithme |
Second algorithme |
|
4N2 + 2N + 7 |
3N2 + 5N + 13 |
À première vue, il n’est pas évident de savoir lequel passe à l’échelle le mieux. La notation grand O permet de simplifier davantage ces expressions en appliquant deux règles :
En appliquant ce processus aux deux expressions, on obtient N2 dans les deux cas :
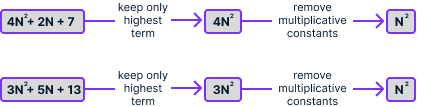
L’expression obtenue après simplification est la complexité temporelle de l’algorithme, que l’on note avec O(). Ici, on peut écrire 4N2 + 2N + 7 = O(N2) et 3N2 + 5N + 13 = O(N2). Cela signifie que les deux algorithmes ont la même complexité temporelle, proportionnelle au carré du nombre d’éléments de la liste.
Plus haut, nous avons calculé que l’algorithme sum_list exécute N + 2 opérations, où N est la longueur de la liste. En appliquant les mêmes simplifications, on obtient N, donc la complexité de sum_list est O(N).
Cela signifie que le temps d’exécution est proportionnel à la taille de la liste. C’est attendu : pour calculer une somme, doubler le nombre d’éléments doit nécessiter deux fois plus de travail, ni moins, ni plus.
On peut ignorer les termes inférieurs car, lorsque N grandit, leur impact devient négligeable face au terme dominant. Le graphique suivant montre la contribution de chacun des trois termes 4N2, 2N et 7 à la somme totale.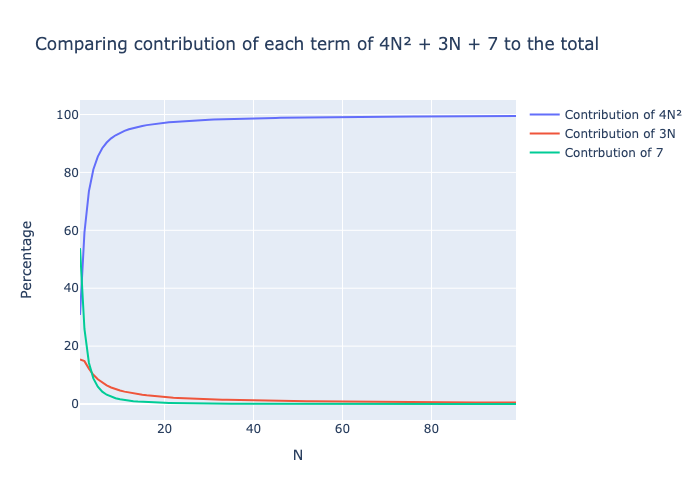
Le terme quadratique 4N2 domine très vite, même pour de petites valeurs de N. Ainsi, avec de grands volumes de données, le temps dû aux termes d’ordre inférieur devient négligeable face au terme d’ordre supérieur.
On ignore la constante multiplicative car elle est indépendante de la quantité de données.
Les étapes ci-dessus suffisent dans la plupart des cas pratiques pour établir correctement la complexité d’un algorithme. On compte le nombre d’instructions de base exécutées et on obtient une expression f(N). Après simplification, on obtient une expression g(N). On écrit alors f(N) = O(g(N)). On lit : « f est grand O de g ».
Cependant, ce n’est pas une définition mathématique formelle, et dans certains cas, elle ne suffit pas.
La définition mathématique est : une fonction positive f(N) = O(g(N)) s’il existe une constante C telle que, pour de grandes valeurs de N, on ait :
f(N) ≤ C × g(N)
On peut utiliser cette définition pour montrer que f(N) = 4N2 + 2N + 7 = O(N2). Ici, on peut choisir C = 5 et vérifier que pour tout N > 4, f(N) ≤ 5 × N2 :
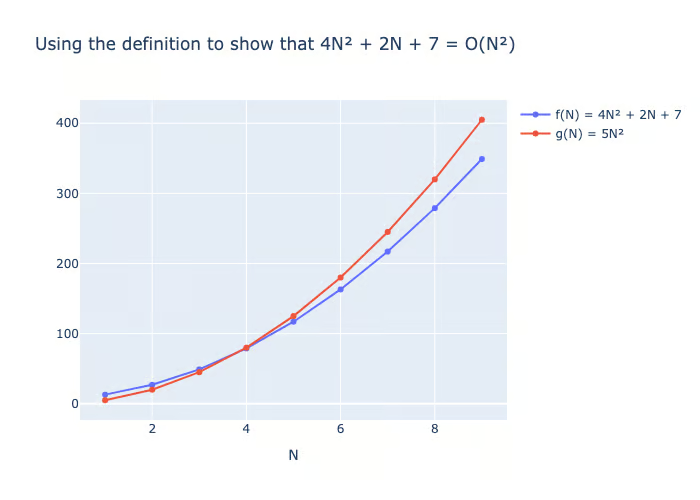
En pratique, nous utiliserons surtout ces règles de simplification.
Maintenant que les bases de la notation grand O sont posées, explorons les complexités les plus courantes et leurs implications, en commençant par la plus efficace : le temps constant.
Comme son nom l’indique, un algorithme en temps constant a une complexité indépendante de la quantité de données. Il s’agit en général de calculs à nombre d’entrées fixe, comme le calcul de la distance entre deux points.
La distance entre deux points se calcule à partir de la racine carrée de la différence entre les coordonnées x et y des deux points.
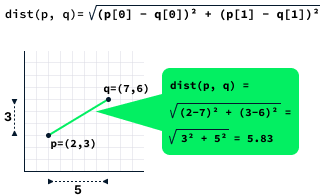
La fonction dist ci-dessous calcule la distance entre deux points. Elle comporte trois instructions de base, un nombre constant. On dit donc que sa complexité est O(1).
def dist(p, q):
  dx = (p[0] - q[0]) ** 2  # 1 instruction
  dy = (p[1] - q[1]) ** 2  # 1 instruction
  return (dx + dy) ** 0.5  # 1 instruction
Fait intéressant : une fonction peut avoir une complexité constante même si elle traite de grands volumes de données. Par exemple, calculer la longueur d’une liste avec len est O(1) car l’implémentation mémorise la taille de la liste, évitant de recompter les éléments à chaque appel.
Nous avons déjà évoqué sum_list comme exemple en temps linéaire. En général, les algorithmes linéaires doivent examiner chaque donnée une par une. Calculer le minimum, le maximum ou la moyenne entre dans cette catégorie.
Exerçons-nous avec la fonction suivante qui calcule le minimum d’une liste :
def minimum(lst):
  min_value = lst[0]                    # 1 instruction
  for i in range(1, len(lst)):
    min_value = min(min_value, lst[i])  # executed len(lst) - 1 times
  return min_value                      # 1 instruction
Si la liste a N éléments, la complexité est 1 + (N - 1) + 1 = N + 1 = O(N).
Le temps d’exécution d’un algorithme linéaire est directement proportionnel au volume de données : si l’on double la quantité de données, le temps de traitement doit, lui aussi, être doublé.
Le jeu du « plus ou moins » consiste à deviner un nombre caché entre 1 et N en un minimum d’essais. Après chaque proposition, on apprend si le nombre caché est plus grand, plus petit ou égal. Si la proposition est correcte, on gagne ; sinon on continue.
Une stratégie efficace consiste à proposer systématiquement le milieu de l’intervalle. Supposons N = 15. Le premier essai serait 8. Si le nombre secret est inférieur à 8, il est entre 1 et 7. S’il est supérieur, il est entre 9 et 15. On continue à viser le milieu jusqu’à trouver la bonne réponse. Le schéma ci-dessous illustre les chemins possibles de cette stratégie.
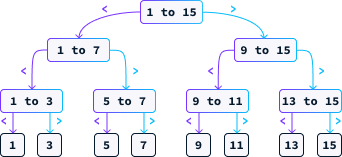
Examinons la complexité de cette approche. Contrairement aux exemples précédents, le nombre d’étapes ne dépend pas uniquement de N : on peut deviner juste dès le premier coup.
Lors de l’analyse, on se concentre sur le pire cas. Par exemple, pour N = 15, dans le pire cas, il faut 4 essais. Chaque essai (le milieu) élimine la moitié des possibilités restantes. On continue jusqu’à ne laisser qu’une possibilité. La question devient donc :
Combien de fois faut-il diviser N par 2 pour obtenir 1 ?
La réponse est le logarithme en base 2 de N, noté log2(N). L’algorithme permettant d’identifier le bon nombre est la recherche binaire. Comme le nombre maximal d’essais est log2(N), sa complexité est O(log2(N)) ou simplement O(log(N)), les constantes étant négligeables en notation de complexité.
Grâce à sa croissance extrêmement lente, la complexité logarithmique est très recherchée en pratique, se comportant presque comme du temps constant. Même pour de grandes valeurs de N, le nombre d’opérations reste remarquablement faible : pour N d’un milliard, il faut environ 30 opérations.
La recherche binaire est un algorithme fondamental en informatique et possède de nombreuses applications. Par exemple, en traitement du langage naturel, les correcteurs orthographiques et systèmes d’autocorrection exploitent des variantes de recherche binaire pour identifier efficacement des mots candidats.
Le tri est une tâche fondamentale que les ordinateurs effectuent très souvent. Une méthode pour trier une liste de N nombres consiste à identifier itérativement l’élément minimal.
def selection_sort(lst):
  sorted_lst = []              # 1 instruction
  for _ in range(len(lst)):
    minimum = min(lst)         # executed len(lst) times
    lst.remove(minimum)        # executed len(lst) times
    sorted_lst.append(minimum) # executed len(lst) times
  return sorted_lst            # 1 instruction
Pour analyser une boucle for, on évalue la complexité des instructions qu’elle contient, puis on multiplie par le nombre d’itérations.
Calculer le minimum d’une liste et supprimer un élément d’une liste sont deux opérations en O(N). L’ajout en fin de liste est O(1). Chaque itération a donc une complexité O(N + N + 1) = O(2N + 1), qui se simplifie en O(N). Comme il y a N itérations, la complexité est N × O(N) = O(N2). Le reste de selection_sort() se résume à trois instructions simples ; la complexité globale est donc O(N2 + 3) = O(N2).
Notre analyse de la boucle for simplifie un peu la réalité. À chaque itération, on retire un élément de la liste ; toutes les itérations n’exécutent donc pas le même nombre d’instructions. La première en exécute N, la seconde N - 1, la troisième N - 2, et ainsi de suite jusqu’à 1.
La véritable complexité de la boucle est donc :
N + (N - 1) + (N - 2) + … + 1
Cette somme vaut (N2 + N) / 2. Or,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Même si nous avons surévalué, la complexité globale reste quadratique. La fonction selection_sort() illustre un algorithme de tri lent en raison de sa complexité O(N2).
Les fonctions de complexité quadratique passent mal à l’échelle : elles peuvent convenir à de petites listes, mais deviennent impraticables pour des millions de points de données, car elles peuvent prendre des jours. Doubler les données quadruple le temps d’exécution.
Il est possible de concevoir un algorithme de tri en O(N log(N)). L’un d’eux est le tri fusion. Nous n’entrerons pas dans les détails de son implémentation ; pour en savoir plus, consultez cette courte introduction au tri fusion issue du cours Data Structures and Algorithms in Python.
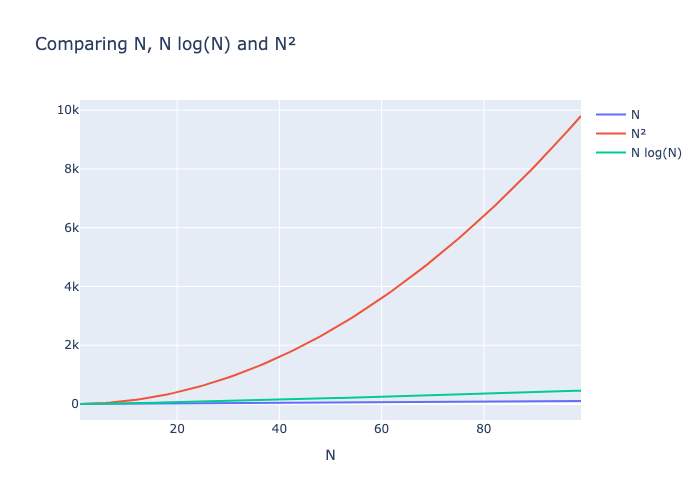
Comme mentionné, la complexité logarithmique se comporte presque comme du temps constant en pratique. Ainsi, l’exécution d’un algorithme en O(N log(N)) peut être comparable à celle d’un algorithme linéaire dans des cas réels.
Le graphique suivant montre que N log(N) et N croissent à des rythmes similaires, tandis que N2 croît très vite et devient rapidement très lent.
Un algorithme en temps cubique très répandu en IA est la multiplication de matrices, au cœur du fonctionnement des grands modèles de langage comme GPT, tant à l’entraînement qu’à l’inférence.
Pour multiplier deux matrices N×N, A et B, il faut multiplier chaque ligne de A par chaque colonne de B. Plus précisément, l’entrée (i, j) du produit est la somme des produits des éléments de la ligne i de A par ceux de la colonne j de B.
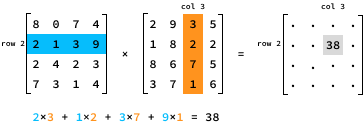
Voici une implémentation Python de la multiplication de matrices :
def matrix_mul(A, B):
  n = len(A)                                       # 1 instruction
  res = [[0 for _ in range(n)] for _ in range(n)]  # N^2 instructions
  for i in range(n):
    for j in range(n):
      for k in range(n):
        res[i][j] += A[i][k] * B[k][j]             # executed N×N×N = N^3 times
  return res                                       # 1 instruction
Au total, matrix_mul() exécute N3 + N2 + 2 instructions ; sa complexité est donc O(N3).
On aurait aussi pu raisonner ainsi : le résultat a N2 entrées. Chaque entrée coûte O(N) à calculer ; la complexité totale est donc N2 × O(N) = O(N3).
Les algorithmes en temps cubique sont lents : doubler les données multiplie le temps d’exécution par huit, ce qui passe très mal à l’échelle. Même pour des N modestes, le nombre d’instructions explose rapidement.
La multiplication de matrices illustre un défi de calcul où les progrès matériels ont eu un impact majeur. Il existe des algorithmes légèrement plus efficaces, mais ce sont surtout les avancées des GPU — conçus spécialement pour multiplier des matrices — qui ont permis l’entraînement de grands modèles comme GPT dans des délais raisonnables.
Plus récemment, des chercheurs proposent de supprimer la multiplication de matrices des grands modèles d’apprentissage — vous pouvez en lire davantage dans cet article MatMul-Free LLMs : concepts clés expliqués.
Les algorithmes exponentiels apparaissent souvent lorsqu’on explore toutes les solutions possibles. Considérez la planification d’une tournée de livraison devant visiter N adresses. Une approche consiste à évaluer tous les ordres de visite possibles. Le module Python itertools permet d’itérer simplement sur toutes les permutations d’une liste.
import itertools
for order in itertools.permutations([1, 2, 3]):
  print(order)
(1, 2, 3)
(1, 3, 2)
(2, 1, 3)
(2, 3, 1)
(3, 1, 2)
(3, 2, 1)Le nombre de permutations d’une liste de longueur N est noté N !, « factorielle de N ». La fonction factorielle croît de façon exponentielle. Par exemple, pour N = 13, le nombre de permutations dépasse le milliard.
Si les adresses de livraison sont données comme une liste de points 2D, on peut déterminer l’ordre minimisant la distance totale en parcourant toutes les séquences possibles et en conservant la meilleure.
def optimize_route(locations):
  minimum_distance = float("inf")                  # 1 instruction
  best_order = None                                # 1 instruction
  for order in itertools.permutations(locations):  # N! iterations
    distance = 0                                   # 1 instruction, N! times
    for i in range(1, len(order)):
      distance += dist(order[i - 1], order[i])     # N-1 instructions, N! times
    if distance < minimum_distance:
      distance = minimum_distance                  # 1 instruction, N! times
      best_order = order                           # 1 instruction, N! times
  return best_order                                # 1 instruction
La première boucle for est exécutée N ! fois. Le nombre d’opérations de optimize_route() est donc N ! × (1 + N - 1 + 2) + 3 = N ! × (N + 2) + 3 = N ! × N + 2N ! + 3.
Nous avons appris qu’en calculant une complexité on ignore les termes d’exposant inférieur. Ici, le terme N ! n’est pas une puissance de N. On affine donc : on omet les termes à croissance plus lente. Le tableau ci-dessous liste des termes fréquents classés du plus lent au plus rapide.
|
1 |
log(N) |
N |
N2 |
N3 |
Nk |
2N |
N ! |
On peut donc écrire la complexité de optimize_route() comme N ! × N + 2N ! + 3 = O(N ! × N).
Les algorithmes de complexité exponentielle ne sont efficaces que pour de très petites instances. Avec seulement 13 adresses, le nombre de permutations dépasse le milliard, rendant cet algorithme impraticable en situation réelle.
Avec le jeu de devinette, nous nous sommes focalisés sur le pire cas. En se concentrant sur le pire cas, on garantit un plafond sur la croissance du temps d’exécution.
Dans le meilleur des cas, on devine du premier coup : l’analyse du meilleur cas donnerait donc O(1). C’est exact — dans le meilleur cas, une seule opération constante suffit. Mais ce n’est pas très utile car hautement improbable.
De manière générale, on analyse la complexité en se concentrant sur le pire cas, car :
La complexité temporelle peut sembler théorique, mais elle est très utile en pratique.
Par exemple, si une fonction traite toujours un petit jeu de données, un algorithme O(N2) simple à comprendre peut être préférable à un O(N) complexe et difficile à maintenir. Mais cela doit être un choix éclairé, pour éviter d’être pris de court si la charge augmente.
L’analyse montre que les micro‑optimisations ont peu d’effet sur le temps d’exécution. Les gains significatifs viennent d’une réduction fondamentale du nombre d’opérations de base nécessaires. En général, il vaut mieux garder un code clair et compréhensible que l’optimiser au point de le rendre illisible.
Les parties lentes du code dominent les autres. Optimiser d’abord la partie déjà rapide est souvent inutile. Par exemple, imaginons une fonction qui effectue deux tâches :
def process_data(data):
  clean_data(data)
  analyze_data(data)
Si clean_data() est en O(N2) et analyze_data() en O(N3), alors améliorer clean_data() ne changera pas la complexité globale de process_data(). Il vaut mieux se concentrer sur analyze_data().
Par ailleurs, la complexité peut guider des choix matériels. Par exemple, un algorithme en O(N3), malgré une faible scalabilité, peut rester suffisamment rapide sur peu de données si on le fait tourner sur un meilleur matériel ou dans un langage plus performant. À l’inverse, avec une complexité exponentielle O(2N), aucune amélioration matérielle ne suffira : il faut un algorithme plus efficace.
Même si les ordinateurs gagnent en puissance, nous traitons plus de données que jamais. À chaque utilisation d’Internet, de smartphones ou d’objets connectés, nous générons d’énormes volumes d’informations. À mesure que cette montagne grandit, trier et extraire l’essentiel devient plus difficile. D’où l’importance d’améliorer en continu nos outils — en particulier les algorithmes — pour mieux ingérer et comprendre ces données.
L’analyse de complexité temporelle offre un cadre simple pour raisonner sur le temps d’exécution d’un algorithme. Son but est d’éclairer la vitesse de croissance de ce temps plutôt que de prédire un timing précis. Malgré ses simplifications et hypothèses, ce modèle s’avère extrêmement utile en pratique et capture l’essentiel du comportement des temps d’exécution.
Pour approfondir l’informatique, consultez mon article Data Structures : guide complet avec exemples Python.
Apprenez Python avec ces cours !
Cours
Cours
Cours