Hướng dẫn Ký hiệu Big O và Độ phức tạp thời gian: Trực giác và Toán học
Độ phức tạp thời gian đo lường cách thời gian chạy của thuật toán tăng theo kích thước đầu vào, thường được biểu diễn bằng ký hiệu Big-O, cung cấp cận trên cho kịch bản tệ nhất.
Phân tích độ phức tạp thời gian cung cấp một cách để phân tích và dự đoán hiệu quả của thuật toán theo cách độc lập với cả ngôn ngữ lập trình mà ta triển khai và phần cứng mà chúng được thực thi.
Mục tiêu của phân tích độ phức tạp thời gian không phải để dự đoán chính xác thời gian chạy của thuật toán mà là để có thể trả lời các câu hỏi sau:
Cho hai thuật toán giải cùng một bài toán, thuật toán nào được kỳ vọng chạy nhanh hơn nếu cung cấp cùng một lượng dữ liệu cho cả hai?
Nếu chúng ta tăng gấp đôi dữ liệu đưa vào thuật toán, thời gian thực thi sẽ bị ảnh hưởng như thế nào? Nó có tỷ lệ tuyến tính và cũng tăng gấp đôi không? Hay giữ nguyên? Hay hoàn toàn khác?
Kết thúc bài viết này, bạn sẽ biết cách phân tích độ phức tạp thời gian của một thuật toán và trả lời các câu hỏi này.
Độ phức tạp thời gian còn quan trọng trong năm 2024 không?
Máy tính ngày càng nhanh hơn nên có thể có người tự hỏi liệu còn cần bận tâm đến độ phức tạp thời gian hay không. Chắc hẳn ngày nay một siêu máy tính có thể xử lý mọi vấn đề bất kể thuật toán ta dùng để giải quyết, đúng không?
Thực ra không hẳn vậy. Sự bùng nổ AI phần lớn nhờ vào những tiến bộ to lớn về hiệu năng phần cứng trong những năm gần đây. Tuy nhiên, ngay cả trên phần cứng tiên tiến nhất, các bài toán đơn giản vẫn có thể dẫn đến hiệu năng thảm họa nếu dùng một thuật toán chậm.
Ví dụ, hãy tưởng tượng dùng một thuật toán ngây thơ để sắp xếp một bảng cơ sở dữ liệu có mười triệu bản ghi. Ngay cả trên máy tính hiện đại, thao tác đơn giản này cũng sẽ mất vài ngày để hoàn thành, khiến cơ sở dữ liệu không thể sử dụng trong bất kỳ ứng dụng thực tiễn nào. Trái lại, dùng một thuật toán hiệu quả, ta có thể kỳ vọng chỉ mất chưa đến một phần mười giây.
Phép toán cơ bản và chỉ lệnh cơ bản
Chúng ta phân tích một thuật toán bằng mô hình Máy Truy cập Ngẫu nhiên (RAM hoặc RA-machine). Mô hình này giả định các thao tác sau mất đúng một bước thời gian:
Phép toán số học
Phép toán logic (<, >, ==, v.v.)
Các câu lệnh như ifhoặc return
Truy cập một vị trí bộ nhớ, như ghi hoặc đọc giá trị biến
Các thao tác này gọi là phép toán cơ bản. Một dòng mã thực thi một số hằng các phép toán cơ bản được gọi là một chỉ lệnh cơ bản.
Vì số phép toán trong một chỉ lệnh cơ bản là hằng số, nó không phụ thuộc vào lượng dữ liệu. Do ta quan tâm đến việc thời gian thực thi tăng như thế nào khi lượng dữ liệu tăng, nên ta có thể tập trung đếm số chỉ lệnh cơ bản mà thuật toán thực hiện.
Lời gọi hàm và các vòng lặp như for và while được đánh giá bằng cách cộng số chỉ lệnh cơ bản bên trong chúng. Xét đoạn mã sau tính tổng các phần tử của một danh sách.
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionĐược hỗ trợ bởi
Chúng tôi thêm chú thích vào mỗi dòng để giúp hình dung số chỉ lệnh cơ bản. Nếu N là độ dài của lst, thì tổng số chỉ lệnh cơ bản là 1 + N + 1 = N + 2.
Ký hiệu Big-O
Hãy tưởng tượng chúng ta có hai thuật toán sắp xếp. Chúng ta tính số chỉ lệnh cơ bản cho mỗi thuật toán và thu được các biểu thức sau:
Thuật toán thứ nhất
Thuật toán thứ hai
4N2 + 2N + 7
3N2 + 5N + 13
Thoạt nhìn, không rõ cái nào mở rộng tốt hơn. Ký hiệu Big-O đưa ra cách đơn giản hóa các biểu thức này hơn nữa bằng cách áp dụng các giản lược sau:
Bỏ các hạng tử có số mũ thấp hơn
Loại bỏ các hằng số nhân
Nếu áp dụng quy trình này cho cả hai biểu thức, ta được N2 trong cả hai trường hợp:
Biểu thức thu được sau khi giản lược là độ phức tạp thời gian của thuật toán, ký hiệu bằng O(). Trong trường hợp này, ta có thể viết 4N2 + 2N + 7 = O(N2) và 3N2 + 5N + 13 = O(N2). Điều này có nghĩa cả hai thuật toán có cùng độ phức tạp thời gian, tỷ lệ với bình phương số phần tử của danh sách.
Ở trên, ta đã tính rằng thuật toán sum_list thực hiện N + 2 thao tác, với N là độ dài danh sách. Áp dụng cùng giản lược, ta được N, vì vậy độ phức tạp thời gian của sum_list là O(N).
Điều này có nghĩa thời gian thực thi tỷ lệ với kích thước danh sách. Điều này là dễ hiểu vì khi tính tổng, tăng gấp đôi số phần tử trong danh sách sẽ cần lượng công việc gấp đôi, không ít hơn cũng không nhiều hơn.
Ký hiệu Big-O: giải thích trực quan
Ta có thể bỏ qua các hạng tử bậc thấp vì khi N tăng, ảnh hưởng của chúng đến tổng trở nên không đáng kể so với hạng tử bậc cao nhất. Biểu đồ sau cho thấy mức đóng góp của từng hạng tử trong ba hạng 4N2, 2N và 7 vào tổng.
Hạng tử bậc hai 4N2 rất nhanh chóng chiếm gần 100% tổng số thao tác ngay cả với các giá trị N nhỏ. Do đó, khi xử lý lượng dữ liệu lớn, thời gian tương ứng với các hạng bậc thấp sẽ không đáng kể so với các hạng bậc cao.
Ta bỏ hằng số nhân vì giá trị này độc lập với lượng dữ liệu.
Ký hiệu Big-O: định nghĩa toán học
Các bước trên là đủ cho hầu hết mục đích thực tiễn để suy ra chính xác độ phức tạp thời gian của một thuật toán. Ta có thể đếm số chỉ lệnh cơ bản mà một thuật toán thực hiện và thu được một biểu thức f(N). Sau khi áp dụng hai bước giản lược, ta thu được một biểu thức giản lược g(N). Khi đó ta có thể viết f(N) = O(g(N)). Đọc là “f là big O của g”.
Tuy nhiên, đây không phải là một định nghĩa toán học chặt chẽ, và trong một số trường hợp, nó chưa đủ.
Định nghĩa toán học là: một hàm dương f(N) = O(g(N)) nếu ta có thể tìm một hằng số C sao cho với các giá trị N đủ lớn, điều sau đúng:
f(N) ≤ C × g(N)
Ta có thể dùng định nghĩa để chỉ ra rằng f(N) = 4N2 + 2N + 7 = O(N2). Trong trường hợp này, ta có thể chọn C = 5 và thấy rằng với mọi N > 4, f(N) ≤ 5 × N2:
Trong thực tế, ta sẽ chỉ dùng các quy tắc giản lược trên.
Các loại độ phức tạp thời gian
Giờ khi đã hiểu những điều cơ bản về ký hiệu Big-O, hãy khám phá các độ phức tạp thời gian thường gặp và ý nghĩa của chúng, bắt đầu từ loại hiệu quả nhất: thời gian hằng số.
Thời gian hằng số: O(1)
Đúng như tên gọi, các thuật toán thời gian hằng số có độ phức tạp thời gian hằng số, nghĩa là hiệu năng của chúng không phụ thuộc vào lượng dữ liệu. Các thuật toán này thường liên quan đến phép tính với số lượng đầu vào cố định, chẳng hạn như tính khoảng cách giữa hai điểm.
Khoảng cách giữa hai điểm được tính bằng cách lấy căn bậc hai của tổng bình phương hiệu giữa tọa độ x và y của hai điểm.
Hàm dist bên dưới tính khoảng cách giữa hai điểm. Nó gồm ba chỉ lệnh cơ bản, là một hằng số. Trong trường hợp này, ta viết độ phức tạp thời gian là O(1).
defdist(p, q):
dx =(p[0]- q[0])**2# 1 instruction
dy =(p[1]- q[1])**2# 1 instructionreturn(dx + dy)**0.5# 1 instructionĐược hỗ trợ bởi
Thú vị là một hàm hoàn toàn có thể thể hiện độ phức tạp thời gian hằng số, ngay cả khi xử lý bộ dữ liệu lớn. Chẳng hạn, việc tính độ dài của một danh sách bằng hàm len là O(1) vì phần triển khai nội bộ theo dõi sẵn kích thước của danh sách, loại bỏ nhu cầu đếm phần tử mỗi lần yêu cầu độ dài.
Thời gian tuyến tính: O(N)
Chúng ta đã thảo luận trước đó về sum_list như một ví dụ hàm thời gian tuyến tính. Nói chung, các thuật toán thời gian tuyến tính thực hiện các tác vụ cần kiểm tra từng điểm dữ liệu một. Tính giá trị nhỏ nhất, lớn nhất hoặc trung bình là các thao tác điển hình thuộc loại này.
Hãy luyện tập bằng cách phân tích hàm sau để tính giá trị nhỏ nhất của một danh sách:
Nếu danh sách có N phần tử, độ phức tạp là 1 + (N - 1) + 1 = N + 1 = O(N).
Thời gian thực thi của các thuật toán thời gian tuyến tính tỷ lệ thuận trực tiếp với lượng dữ liệu. Do đó, nếu lượng dữ liệu tăng gấp đôi, thời gian để thuật toán xử lý dữ liệu cũng nên tăng gấp đôi.
Thời gian logarit: O(log(N))
Trò chơi đoán số gồm việc cố gắng đoán một số ẩn từ 1 đến N, nhằm xác định số này với ít lần đoán nhất có thể. Sau mỗi lần đoán, ta nhận phản hồi cho biết số ẩn lớn hơn, nhỏ hơn, hay bằng với dự đoán. Nếu đoán đúng, ta thắng; nếu không, tiếp tục đoán.
Một chiến lược hiệu quả cho trò chơi này là luôn đoán ở điểm giữa. Giả sử N = 15. Khi đó, lần đoán đầu tiên là 8. Nếu số bí mật nhỏ hơn 8, ta biết nó nằm trong khoảng 1 đến 7. Nếu lớn hơn, thì nằm trong khoảng 9 đến 15. Ta tiếp tục đoán điểm giữa của khoảng còn lại cho đến khi tìm được đáp án đúng. Sơ đồ dưới đây minh họa các nhánh có thể xảy ra theo chiến lược này.
Hãy xem xét độ phức tạp thời gian của cách tiếp cận này. Không giống các ví dụ trước, số bước mà thuật toán này thực hiện không chỉ phụ thuộc vào kích thước đầu vào N, vì vẫn có khả năng đoán đúng ngay lần đầu.
Khi phân tích các thuật toán này, ta tập trung vào kịch bản tệ nhất. Ví dụ, với N = 15, trong trường hợp tệ nhất, ta sẽ cần 4 lần đoán. Mỗi lần đoán, vì là điểm giữa, loại bỏ một nửa khả năng còn lại. Trong kịch bản tệ nhất, ta tiếp tục đoán cho đến khi chỉ còn một khả năng. Do đó, câu hỏi cần giải là:
Cần chia N cho 2 bao nhiêu lần để thu được 1?
Câu trả lời là logarit cơ số 2 của N, ký hiệu là log2(N). Thuật toán dùng để xác định số đúng được gọi là tìm kiếm nhị phân. Do số lần đoán tối đa là log2(N), ta có thể biểu diễn độ phức tạp là O(log2(N)) hoặc đơn giản là O(log(N)) vì các hằng số là không đáng kể trong ký hiệu độ phức tạp thời gian.
Nhờ tốc độ tăng trưởng cực chậm, độ phức tạp thời gian logarit rất được ưa chuộng trong thực tế, hành xử gần như thời gian hằng số. Ngay cả với N rất lớn, tổng số thao tác vẫn cực kỳ thấp. Ví dụ, ngay cả khi N là một tỷ, số thao tác cần thiết chỉ khoảng 30.
Tìm kiếm nhị phân là một thuật toán nền tảng trong khoa học máy tính với vô số ứng dụng. Ví dụ, trong xử lý ngôn ngữ tự nhiên, hệ thống kiểm tra chính tả và tự động sửa có thể sử dụng các biến thể của tìm kiếm nhị phân để xác định hiệu quả các từ ứng viên tiềm năng.
Thời gian bậc hai: O(N2)
Sắp xếp dữ liệu là một tác vụ cơ bản mà máy tính thường xuyên cần thực hiện. Một cách để sắp xếp danh sách N số là lặp lại việc tìm phần tử nhỏ nhất của danh sách.
defselection_sort(lst):
sorted_lst =[]# 1 instructionfor _ inrange(len(lst)):
minimum =min(lst)# executed len(lst) times
lst.remove(minimum)# executed len(lst) times
sorted_lst.append(minimum)# executed len(lst) timesreturn sorted_lst # 1 instructionĐược hỗ trợ bởi
Để phân tích độ phức tạp của một vòng lặp for, ta đánh giá độ phức tạp của các chỉ lệnh bên trong rồi nhân kết quả đó với số lần lặp của vòng lặp.
Tính phần tử nhỏ nhất của một danh sách và loại bỏ một phần tử khỏi danh sách đều là thao tác O(N). Thêm phần tử vào cuối là thời gian hằng số, O(1). Do đó, mỗi lượt lặp của vòng for có độ phức tạp O(N + N + 1) = O(2N + 1), giản lược thành O(N). Vì có N lượt lặp, độ phức tạp là N × O(N) = O(N2). Phần còn lại của hàm selection_sort() gồm ba chỉ lệnh đơn giản, nên tổng thể độ phức tạp là O(N2 + 3) = O(N2).
Phân tích của chúng ta về vòng lặp for có phần đơn giản hóa quá mức. Ở mỗi lượt lặp, ta loại bỏ một phần tử khỏi danh sách, có nghĩa là không phải mọi lượt lặp đều thực thi cùng một số chỉ lệnh. Lượt đầu thực thi N chỉ lệnh, lượt thứ hai thực thi N - 1, lượt thứ ba N - 2, và cứ thế cho đến lượt cuối cùng chỉ thực thi 1 chỉ lệnh.
Điều này ngụ ý rằng độ phức tạp thực sự của vòng lặp for là:
N + (N - 1) + (N - 2) + … + 1
Tổng này có thể chứng minh bằng (N2 + N) / 2. Tuy nhiên,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Mặc dù ta đếm dư, tổng thể độ phức tạp vẫn là bậc hai. Hàm selection_sort() là ví dụ về một thuật toán sắp xếp chậm hơn do độ phức tạp bậc hai, O(N2).
Các hàm có độ phức tạp bậc hai mở rộng rất kém, phù hợp với danh sách nhỏ nhưng không thực tế để sắp xếp hàng triệu điểm dữ liệu, vì có thể mất hàng ngày để hoàn thành. Tăng gấp đôi dữ liệu dẫn đến thời gian thực thi gấp bốn lần.
Thời gian log-tuyến: O(Nlog(N))
Hoàn toàn có thể thiết kế một thuật toán để sắp xếp danh sách với độ phức tạp thời gian O(N log(N)). Một thuật toán như vậy gọi là merge sort. Chúng ta sẽ không đi sâu vào chi tiết triển khai, nhưng nếu bạn muốn tìm hiểu thêm, hãy xem giới thiệu nhanh về merge sort từ khóa học Cấu trúc dữ liệu và Thuật toán trong Python.
Như đã đề cập, độ phức tạp logarit trong thực tế hành xử tương tự độ phức tạp hằng số. Do đó, thời gian thực thi của một thuật toán O(N log(N)) có thể tương đương với một thuật toán thời gian tuyến tính trong các ứng dụng thực tế.
Biểu đồ sau cho thấy N log(N) và N tăng với tốc độ tương tự trong khi N2 tăng rất nhanh, nhanh chóng trở nên rất chậm.
Thời gian bậc ba: O(N3)
Một thuật toán độ phức tạp bậc ba được dùng rộng rãi trong AI là phép nhân ma trận, đóng vai trò then chốt trong hoạt động của các mô hình ngôn ngữ lớn như GPT. Thuật toán này là trung tâm của các phép tính trong cả giai đoạn huấn luyện và suy luận.
Để nhân hai ma trận N nhân N, A và B, ta cần nhân mỗi hàng của ma trận A với mỗi cột của ma trận B. Cụ thể, giá trị của tích tại ô (i, j) được xác định bằng cách nhân các phần tử ở hàng i của A với các phần tử tương ứng ở cột j của B.
Dưới đây là một triển khai Python của phép nhân ma trận:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionĐược hỗ trợ bởi
Tổng cộng, matrix_mul() thực thi N3 + N2 + 2 chỉ lệnh nên độ phức tạp thời gian là O(N3).
Ngoài ra, ta có thể phân tích độ phức tạp bằng cách lập luận về các phép tính. Kết quả của phép nhân ma trận có N2 ô. Mỗi ô mất O(N) thời gian để tính, nên tổng thể độ phức tạp là N2 × O(N) = O(N3).
Các thuật toán bậc ba khá chậm. Tăng gấp đôi dữ liệu dẫn đến thời gian thực thi gấp tám lần, khiến các thuật toán này mở rộng rất kém. Ngay cả với giá trị N tương đối nhỏ, số chỉ lệnh cũng tăng vọt rất nhanh.
Nhân ma trận là một ví dụ về thách thức tính toán mà những tiến bộ phần cứng đã tạo ra ảnh hưởng đáng kể. Dù có những thuật toán nhân ma trận hiệu quả hơn đôi chút, chủ yếu chính là các tiến bộ trong thiết kế chip GPU — được tối ưu riêng cho phép nhân ma trận — đã hỗ trợ đáng kể việc huấn luyện các mô hình lớn như GPT trong khung thời gian hợp lý.
Các thuật toán thời gian hàm mũ thường xuất hiện khi giải một bài toán bằng cách duyệt qua mọi lời giải có thể. Xét bài toán lập kế hoạch lộ trình cho một xe tải giao hàng phải ghé N điểm giao. Một cách tiếp cận là đánh giá mọi thứ tự giao hàng có thể. Gói itertools của Python cung cấp một cách đơn giản để duyệt qua mọi hoán vị của một danh sách.
import itertools
for order in itertools.permutations([1,2,3]):print(order)Được hỗ trợ bởi
Số hoán vị của một danh sách độ dài N được ký hiệu N!, đọc là "N giai thừa". Hàm giai thừa tăng theo hàm mũ. Chẳng hạn, khi N = 13, số hoán vị đã vượt quá 1 tỷ.
Giả sử các điểm giao hàng được cho dưới dạng một danh sách các điểm 2D. Khi đó, ta có thể xác định thứ tự giao hàng tối thiểu hóa tổng quãng đường bằng cách lặp qua mọi thứ tự có thể trong khi lưu lại thứ tự tốt nhất.
defoptimize_route(locations):
minimum_distance =float("inf")# 1 instruction
best_order =None# 1 instructionfor order in itertools.permutations(locations):# N! iterations
distance =0# 1 instruction, N! timesfor i inrange(1,len(order)):
distance += dist(order[i -1], order[i])# N-1 instructions, N! timesif distance < minimum_distance:
distance = minimum_distance # 1 instruction, N! times
best_order = order # 1 instruction, N! timesreturn best_order # 1 instructionĐược hỗ trợ bởi
Vòng lặp for đầu tiên được thực thi N! lần. Do đó, số thao tác trong optimize_route() là N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.
Ta đã học rằng khi tính độ phức tạp thời gian, ta bỏ qua các hạng có số mũ thấp hơn. Tuy nhiên, trong tình huống này, ta gặp một hạng N!, không phải lũy thừa của N. Ta có thể tinh chỉnh chiến lược giản lược bằng cách chọn bỏ các hạng có tốc độ tăng chậm hơn. Bảng dưới liệt kê các hạng thường gặp trong độ phức tạp thời gian của thuật toán, sắp xếp từ tốc độ tăng thấp đến cao.
1
log(N)
N
N2
N3
Nk
2N
N!
Vì vậy, ta có thể biểu diễn độ phức tạp thời gian của optimize_route() là N! x N + 2N! + 3 = O(N! x N).
Các thuật toán có độ phức tạp thời gian hàm mũ thường chỉ hiệu quả với những trường hợp rất nhỏ. Chỉ với 13 điểm dừng, số hoán vị đã vượt quá 1 tỷ, khiến thuật toán này không thực tế trong các kịch bản đời thực.
Độ phức tạp thời gian: Trường hợp xấu nhất và tốt nhất
Với trò chơi đoán số, chúng ta tập trung vào độ phức tạp trường hợp xấu nhất. Bằng cách tập trung vào trường hợp xấu nhất, ta đảm bảo tốc độ tăng của thời gian thực thi của thuật toán.
Trong trường hợp tốt nhất, ta đoán đúng ngay lần đầu, nên phân tích trường hợp tốt nhất sẽ cho độ phức tạp O(1). Điều này chính xác — trong trường hợp tốt nhất, ta cần một thao tác hằng số. Tuy nhiên, điều này không quá hữu ích vì rất khó xảy ra.
Nói chung, khi phân tích độ phức tạp của một thuật toán, ta luôn tập trung vào trường hợp xấu nhất vì:
Đảm bảo hiệu năng: Tập trung vào độ phức tạp trường hợp xấu nhất giúp đảm bảo thuật toán không bao giờ hoạt động tệ hơn một ngưỡng nhất định. Điều này rất quan trọng đối với các ứng dụng cần hiệu năng đáng tin cậy, như hệ thống thời gian thực, nơi các độ trễ có thể gây ra vấn đề lớn.
An toàn và độ tin cậy: Phân tích trường hợp xấu nhất giúp thiết kế các thuật toán vững chắc có thể xử lý các kịch bản đòi hỏi nhất. Nó đảm bảo rằng thuật toán vẫn hoạt động trong giới hạn chấp nhận được ngay cả trong tình huống xấu nhất.
Cận trên: Biết độ phức tạp trường hợp xấu nhất cho ta cận trên về hiệu năng. Điều này hữu ích để hiểu lượng tài nguyên tối đa (thời gian, bộ nhớ) mà một thuật toán có thể cần.
Độ phức tạp thời gian: Hệ quả thực tiễn
Độ phức tạp thời gian có vẻ rất lý thuyết, nhưng lại cực kỳ hữu ích trong thực tế.
Ví dụ, nếu một hàm luôn xử lý một bộ dữ liệu nhỏ, một thuật toán O(N2) dễ hiểu có thể phù hợp hơn một thuật toán O(N) phức tạp và khó bảo trì. Tuy nhiên, đây nên là quyết định có chủ đích để tránh bị bất ngờ khi ứng dụng không thể xử lý lưu lượng người dùng tăng lên.
Phân tích độ phức tạp thời gian cho thấy các tối ưu hóa mã nhỏ có ảnh hưởng không đáng kể đến thời gian thực thi của thuật toán. Cải thiện đáng kể đạt được bằng cách giảm một cách căn bản số phép toán cơ bản cần để tính kết quả. Nói chung, duy trì mã sạch và dễ hiểu được ưu tiên hơn việc tối ưu đến mức trở nên khó hiểu.
Phần chậm hơn của mã sẽ lấn át các phần khác. Thường là vô ích khi tối ưu phần nhanh hơn trước khi tối ưu phần chậm. Ví dụ, giả sử ta có một hàm thực hiện hai tác vụ:
defprocess_data(data):
clean_data(data)
analyze_data(data)Được hỗ trợ bởi
Nếu hàm clean_data() có độ phức tạp O(N2) và analyze_data() có độ phức tạp O(N3), thì giảm độ phức tạp của clean_data() sẽ không cải thiện độ phức tạp tổng thể của process_data(). Tốt hơn là tập trung cải thiện hàm analyze_data().
Hơn nữa, độ phức tạp thời gian có thể định hướng các quyết định về phần cứng. Ví dụ, một thuật toán O(N3), dù mở rộng kém, vẫn có thể đủ nhanh cho tác vụ với dữ liệu hạn chế nếu chạy trên phần cứng vượt trội hoặc ngôn ngữ lập trình nhanh hơn. Ngược lại, nếu một thuật toán có độ phức tạp thời gian hàm mũ O(2N), thì không nâng cấp phần cứng nào là đủ, cho thấy cần một thuật toán hiệu quả hơn.
Kết luận
Dù máy tính ngày càng nhanh, chúng ta đang xử lý nhiều dữ liệu hơn bao giờ hết. Hãy nghĩ như thế này: mỗi lần dùng Internet, điện thoại thông minh hay thiết bị nhà thông minh, chúng ta tạo ra vô số thông tin. Khi núi dữ liệu này lớn lên, việc sàng lọc và tìm điều quan trọng trở nên khó hơn. Đó là lý do tại sao việc không ngừng cải thiện các công cụ — đặc biệt là thuật toán — để xử lý và thấu hiểu tất cả thông tin này là vô cùng quan trọng.
Phân tích độ phức tạp thời gian cung cấp một khung tiếp cận đơn giản để lý giải thời gian thực thi của thuật toán. Mục tiêu chính của nó là cung cấp hiểu biết về tốc độ tăng trưởng của độ phức tạp thời gian thay vì dự đoán thời gian thực thi chính xác. Dù mô hình có nhiều giản lược và giả định, nó đã chứng tỏ cực kỳ hữu ích trong thực tế, nắm bắt hiệu quả bản chất hành vi thời gian thực thi của thuật toán.
Làm sao biết độ phức tạp thời gian của các hàm dựng sẵn trong Python? ⌄
Đôi khi, tài liệu có đề cập đến độ phức tạp. Nếu không, xem mã nguồn và tự phân tích là một bài tập tốt. Hầu hết ngôn ngữ đều theo các triển khai tiêu chuẩn cho các cấu trúc dữ liệu phổ biến như danh sách và từ điển, nên tra cứu độ phức tạp của các cấu trúc này sẽ cho đáp án đúng. Chúng tôi khuyến nghị theo học một khóa tổng quát về cấu trúc dữ liệu và thuật toán để hiểu rõ hơn độ phức tạp của các thao tác phổ biến.
Độ phức tạp dạng O(N^k) có luôn tốt hơn O(2^N), bất kể giá trị k không?⌄
Về mặt lý thuyết, có. Với N đủ lớn, thuật toán thời gian hàm mũ cuối cùng sẽ chậm hơn. Tuy nhiên, thuật toán thời gian hàm mũ có thể hoạt động tốt hơn nhiều với các giá trị N nhỏ. Trong một số trường hợp hiếm, ta chỉ quan tâm đến bộ dữ liệu nhỏ, nên thuật toán O(2N) có thể được ưu tiên.
Có các hàm độ phức tạp nào khác ngoài những gì ta học ở đây không?⌄
Có. Tồn tại các thuật toán có hàm độ phức tạp rất lạ, nhưng với gần như tất cả thuật toán, độ phức tạp sẽ chỉ liên quan đến các hàm mà chúng tôi đề cập trong bài viết này.
Làm sao biết có thể tìm được thuật toán tốt hơn hay không?⌄
Đây là một câu hỏi khó nói chung. Chứng minh rằng không tồn tại thuật toán có độ phức tạp thời gian tốt hơn đòi hỏi lập luận về chính bài toán và chỉ ra rằng giải nó với ít thao tác hơn là không thể. Trong một số trường hợp, điều này dễ. Ví dụ, để tìm xem một danh sách có chứa một giá trị cho trước hay không, không thể có thuật toán có độ phức tạp thấp hơn O(N) vì trong trường hợp xấu nhất, ta cần xem tất cả phần tử để tìm câu trả lời.
Ta phân tích độ phức tạp thời gian thế nào nếu thuật toán có yếu tố ngẫu nhiên?⌄
Ngay cả khi có yếu tố ngẫu nhiên, ta vẫn thường có thể lập luận về trường hợp xấu nhất của các kết quả ngẫu nhiên và suy ra độ phức tạp. Ngoài ra, với một số thuật toán ngẫu nhiên, ta phân tích độ phức tạp trung bình bằng cách nghiên cứu số phép toán kỳ vọng.
Kỹ sư full-stack & nhà sáng lập tại CheapGPT. Giảng dạy luôn là niềm đam mê của tôi. Từ những ngày còn là sinh viên, tôi đã háo hức tìm kiếm cơ hội kèm cặp và hỗ trợ các bạn học khác. Niềm đam mê đó đã thôi thúc tôi theo học tiến sĩ, nơi tôi cũng đảm nhiệm vai trò trợ giảng để hỗ trợ con đường học thuật của mình. Trong những năm ấy, tôi tìm thấy sự mãn nguyện lớn lao trong môi trường lớp học truyền thống, xây dựng kết nối và thúc đẩy việc học tập. Tuy nhiên, với sự ra đời của các nền tảng học trực tuyến, tôi nhận ra tiềm năng thay đổi của giáo dục số. Thực tế, tôi đã trực tiếp tham gia phát triển một nền tảng như vậy tại trường đại học của chúng tôi. Tôi tận tâm kết hợp các nguyên tắc giảng dạy truyền thống với những phương pháp số đổi mới. Đam mê của tôi là tạo ra các khóa học không chỉ hấp dẫn và giàu thông tin mà còn dễ tiếp cận với người học trong thời đại số này.


Phân tích độ phức tạp thời gian cung cấp một cách để phân tích và dự đoán hiệu quả của thuật toán theo cách độc lập với cả ngôn ngữ lập trình mà ta triển khai và phần cứng mà chúng được thực thi.
Mục tiêu của phân tích độ phức tạp thời gian không phải để dự đoán chính xác thời gian chạy của thuật toán mà là để có thể trả lời các câu hỏi sau:
Kết thúc bài viết này, bạn sẽ biết cách phân tích độ phức tạp thời gian của một thuật toán và trả lời các câu hỏi này.
Độ phức tạp thời gian còn quan trọng trong năm 2024 không?
Máy tính ngày càng nhanh hơn nên có thể có người tự hỏi liệu còn cần bận tâm đến độ phức tạp thời gian hay không. Chắc hẳn ngày nay một siêu máy tính có thể xử lý mọi vấn đề bất kể thuật toán ta dùng để giải quyết, đúng không?
Thực ra không hẳn vậy. Sự bùng nổ AI phần lớn nhờ vào những tiến bộ to lớn về hiệu năng phần cứng trong những năm gần đây. Tuy nhiên, ngay cả trên phần cứng tiên tiến nhất, các bài toán đơn giản vẫn có thể dẫn đến hiệu năng thảm họa nếu dùng một thuật toán chậm.
Ví dụ, hãy tưởng tượng dùng một thuật toán ngây thơ để sắp xếp một bảng cơ sở dữ liệu có mười triệu bản ghi. Ngay cả trên máy tính hiện đại, thao tác đơn giản này cũng sẽ mất vài ngày để hoàn thành, khiến cơ sở dữ liệu không thể sử dụng trong bất kỳ ứng dụng thực tiễn nào. Trái lại, dùng một thuật toán hiệu quả, ta có thể kỳ vọng chỉ mất chưa đến một phần mười giây.
Phép toán cơ bản và chỉ lệnh cơ bản
Chúng ta phân tích một thuật toán bằng mô hình Máy Truy cập Ngẫu nhiên (RAM hoặc RA-machine). Mô hình này giả định các thao tác sau mất đúng một bước thời gian:
ifhoặcreturnCác thao tác này gọi là phép toán cơ bản. Một dòng mã thực thi một số hằng các phép toán cơ bản được gọi là một chỉ lệnh cơ bản.
Vì số phép toán trong một chỉ lệnh cơ bản là hằng số, nó không phụ thuộc vào lượng dữ liệu. Do ta quan tâm đến việc thời gian thực thi tăng như thế nào khi lượng dữ liệu tăng, nên ta có thể tập trung đếm số chỉ lệnh cơ bản mà thuật toán thực hiện.
Lời gọi hàm và các vòng lặp như
forvàwhileđược đánh giá bằng cách cộng số chỉ lệnh cơ bản bên trong chúng. Xét đoạn mã sau tính tổng các phần tử của một danh sách.Chúng tôi thêm chú thích vào mỗi dòng để giúp hình dung số chỉ lệnh cơ bản. Nếu N là độ dài của
lst, thì tổng số chỉ lệnh cơ bản là 1 + N + 1 = N + 2.Ký hiệu Big-O
Hãy tưởng tượng chúng ta có hai thuật toán sắp xếp. Chúng ta tính số chỉ lệnh cơ bản cho mỗi thuật toán và thu được các biểu thức sau:
Thuật toán thứ nhất
Thuật toán thứ hai
4N2 + 2N + 7
3N2 + 5N + 13
Thoạt nhìn, không rõ cái nào mở rộng tốt hơn. Ký hiệu Big-O đưa ra cách đơn giản hóa các biểu thức này hơn nữa bằng cách áp dụng các giản lược sau:
Nếu áp dụng quy trình này cho cả hai biểu thức, ta được N2 trong cả hai trường hợp:
Biểu thức thu được sau khi giản lược là độ phức tạp thời gian của thuật toán, ký hiệu bằng O(). Trong trường hợp này, ta có thể viết 4N2 + 2N + 7 = O(N2) và 3N2 + 5N + 13 = O(N2). Điều này có nghĩa cả hai thuật toán có cùng độ phức tạp thời gian, tỷ lệ với bình phương số phần tử của danh sách.
Ở trên, ta đã tính rằng thuật toán
sum_listthực hiện N + 2 thao tác, với N là độ dài danh sách. Áp dụng cùng giản lược, ta được N, vì vậy độ phức tạp thời gian củasum_listlà O(N).Điều này có nghĩa thời gian thực thi tỷ lệ với kích thước danh sách. Điều này là dễ hiểu vì khi tính tổng, tăng gấp đôi số phần tử trong danh sách sẽ cần lượng công việc gấp đôi, không ít hơn cũng không nhiều hơn.
Ký hiệu Big-O: giải thích trực quan
Ta có thể bỏ qua các hạng tử bậc thấp vì khi N tăng, ảnh hưởng của chúng đến tổng trở nên không đáng kể so với hạng tử bậc cao nhất. Biểu đồ sau cho thấy mức đóng góp của từng hạng tử trong ba hạng 4N2, 2N và 7 vào tổng.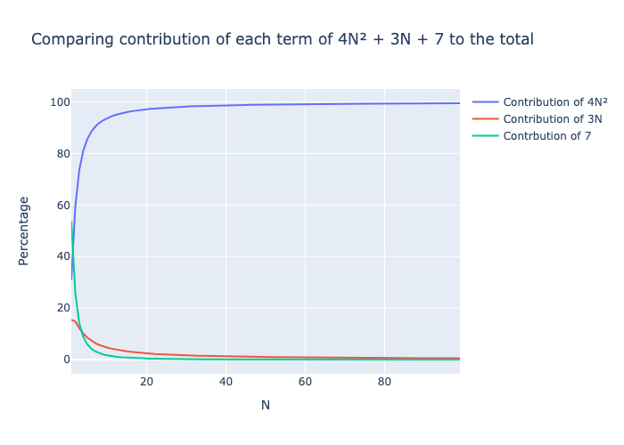
Hạng tử bậc hai 4N2 rất nhanh chóng chiếm gần 100% tổng số thao tác ngay cả với các giá trị N nhỏ. Do đó, khi xử lý lượng dữ liệu lớn, thời gian tương ứng với các hạng bậc thấp sẽ không đáng kể so với các hạng bậc cao.
Ta bỏ hằng số nhân vì giá trị này độc lập với lượng dữ liệu.
Ký hiệu Big-O: định nghĩa toán học
Các bước trên là đủ cho hầu hết mục đích thực tiễn để suy ra chính xác độ phức tạp thời gian của một thuật toán. Ta có thể đếm số chỉ lệnh cơ bản mà một thuật toán thực hiện và thu được một biểu thức f(N). Sau khi áp dụng hai bước giản lược, ta thu được một biểu thức giản lược g(N). Khi đó ta có thể viết f(N) = O(g(N)). Đọc là “f là big O của g”.
Tuy nhiên, đây không phải là một định nghĩa toán học chặt chẽ, và trong một số trường hợp, nó chưa đủ.
Định nghĩa toán học là: một hàm dương f(N) = O(g(N)) nếu ta có thể tìm một hằng số C sao cho với các giá trị N đủ lớn, điều sau đúng:
f(N) ≤ C × g(N)
Ta có thể dùng định nghĩa để chỉ ra rằng f(N) = 4N2 + 2N + 7 = O(N2). Trong trường hợp này, ta có thể chọn C = 5 và thấy rằng với mọi N > 4, f(N) ≤ 5 × N2:
Trong thực tế, ta sẽ chỉ dùng các quy tắc giản lược trên.
Các loại độ phức tạp thời gian
Giờ khi đã hiểu những điều cơ bản về ký hiệu Big-O, hãy khám phá các độ phức tạp thời gian thường gặp và ý nghĩa của chúng, bắt đầu từ loại hiệu quả nhất: thời gian hằng số.
Thời gian hằng số: O(1)
Đúng như tên gọi, các thuật toán thời gian hằng số có độ phức tạp thời gian hằng số, nghĩa là hiệu năng của chúng không phụ thuộc vào lượng dữ liệu. Các thuật toán này thường liên quan đến phép tính với số lượng đầu vào cố định, chẳng hạn như tính khoảng cách giữa hai điểm.
Khoảng cách giữa hai điểm được tính bằng cách lấy căn bậc hai của tổng bình phương hiệu giữa tọa độ x và y của hai điểm.
Hàm
distbên dưới tính khoảng cách giữa hai điểm. Nó gồm ba chỉ lệnh cơ bản, là một hằng số. Trong trường hợp này, ta viết độ phức tạp thời gian là O(1).Thú vị là một hàm hoàn toàn có thể thể hiện độ phức tạp thời gian hằng số, ngay cả khi xử lý bộ dữ liệu lớn. Chẳng hạn, việc tính độ dài của một danh sách bằng hàm len là O(1) vì phần triển khai nội bộ theo dõi sẵn kích thước của danh sách, loại bỏ nhu cầu đếm phần tử mỗi lần yêu cầu độ dài.
Thời gian tuyến tính: O(N)
Chúng ta đã thảo luận trước đó về
sum_listnhư một ví dụ hàm thời gian tuyến tính. Nói chung, các thuật toán thời gian tuyến tính thực hiện các tác vụ cần kiểm tra từng điểm dữ liệu một. Tính giá trị nhỏ nhất, lớn nhất hoặc trung bình là các thao tác điển hình thuộc loại này.Hãy luyện tập bằng cách phân tích hàm sau để tính giá trị nhỏ nhất của một danh sách:
Nếu danh sách có N phần tử, độ phức tạp là 1 + (N - 1) + 1 = N + 1 = O(N).
Thời gian thực thi của các thuật toán thời gian tuyến tính tỷ lệ thuận trực tiếp với lượng dữ liệu. Do đó, nếu lượng dữ liệu tăng gấp đôi, thời gian để thuật toán xử lý dữ liệu cũng nên tăng gấp đôi.
Thời gian logarit: O(log(N))
Trò chơi đoán số gồm việc cố gắng đoán một số ẩn từ 1 đến N, nhằm xác định số này với ít lần đoán nhất có thể. Sau mỗi lần đoán, ta nhận phản hồi cho biết số ẩn lớn hơn, nhỏ hơn, hay bằng với dự đoán. Nếu đoán đúng, ta thắng; nếu không, tiếp tục đoán.
Một chiến lược hiệu quả cho trò chơi này là luôn đoán ở điểm giữa. Giả sử N = 15. Khi đó, lần đoán đầu tiên là 8. Nếu số bí mật nhỏ hơn 8, ta biết nó nằm trong khoảng 1 đến 7. Nếu lớn hơn, thì nằm trong khoảng 9 đến 15. Ta tiếp tục đoán điểm giữa của khoảng còn lại cho đến khi tìm được đáp án đúng. Sơ đồ dưới đây minh họa các nhánh có thể xảy ra theo chiến lược này.
Hãy xem xét độ phức tạp thời gian của cách tiếp cận này. Không giống các ví dụ trước, số bước mà thuật toán này thực hiện không chỉ phụ thuộc vào kích thước đầu vào N, vì vẫn có khả năng đoán đúng ngay lần đầu.
Khi phân tích các thuật toán này, ta tập trung vào kịch bản tệ nhất. Ví dụ, với N = 15, trong trường hợp tệ nhất, ta sẽ cần 4 lần đoán. Mỗi lần đoán, vì là điểm giữa, loại bỏ một nửa khả năng còn lại. Trong kịch bản tệ nhất, ta tiếp tục đoán cho đến khi chỉ còn một khả năng. Do đó, câu hỏi cần giải là:
Cần chia N cho 2 bao nhiêu lần để thu được 1?
Câu trả lời là logarit cơ số 2 của N, ký hiệu là log2(N). Thuật toán dùng để xác định số đúng được gọi là tìm kiếm nhị phân. Do số lần đoán tối đa là log2(N), ta có thể biểu diễn độ phức tạp là O(log2(N)) hoặc đơn giản là O(log(N)) vì các hằng số là không đáng kể trong ký hiệu độ phức tạp thời gian.
Nhờ tốc độ tăng trưởng cực chậm, độ phức tạp thời gian logarit rất được ưa chuộng trong thực tế, hành xử gần như thời gian hằng số. Ngay cả với N rất lớn, tổng số thao tác vẫn cực kỳ thấp. Ví dụ, ngay cả khi N là một tỷ, số thao tác cần thiết chỉ khoảng 30.
Tìm kiếm nhị phân là một thuật toán nền tảng trong khoa học máy tính với vô số ứng dụng. Ví dụ, trong xử lý ngôn ngữ tự nhiên, hệ thống kiểm tra chính tả và tự động sửa có thể sử dụng các biến thể của tìm kiếm nhị phân để xác định hiệu quả các từ ứng viên tiềm năng.
Thời gian bậc hai: O(N2)
Sắp xếp dữ liệu là một tác vụ cơ bản mà máy tính thường xuyên cần thực hiện. Một cách để sắp xếp danh sách N số là lặp lại việc tìm phần tử nhỏ nhất của danh sách.
Để phân tích độ phức tạp của một vòng lặp
for, ta đánh giá độ phức tạp của các chỉ lệnh bên trong rồi nhân kết quả đó với số lần lặp của vòng lặp.Tính phần tử nhỏ nhất của một danh sách và loại bỏ một phần tử khỏi danh sách đều là thao tác O(N). Thêm phần tử vào cuối là thời gian hằng số, O(1). Do đó, mỗi lượt lặp của vòng
forcó độ phức tạp O(N + N + 1) = O(2N + 1), giản lược thành O(N). Vì có N lượt lặp, độ phức tạp là N × O(N) = O(N2). Phần còn lại của hàmselection_sort()gồm ba chỉ lệnh đơn giản, nên tổng thể độ phức tạp là O(N2 + 3) = O(N2).Phân tích của chúng ta về vòng lặp for có phần đơn giản hóa quá mức. Ở mỗi lượt lặp, ta loại bỏ một phần tử khỏi danh sách, có nghĩa là không phải mọi lượt lặp đều thực thi cùng một số chỉ lệnh. Lượt đầu thực thi N chỉ lệnh, lượt thứ hai thực thi N - 1, lượt thứ ba N - 2, và cứ thế cho đến lượt cuối cùng chỉ thực thi 1 chỉ lệnh.
Điều này ngụ ý rằng độ phức tạp thực sự của vòng lặp for là:
N + (N - 1) + (N - 2) + … + 1
Tổng này có thể chứng minh bằng (N2 + N) / 2. Tuy nhiên,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Mặc dù ta đếm dư, tổng thể độ phức tạp vẫn là bậc hai. Hàm
selection_sort()là ví dụ về một thuật toán sắp xếp chậm hơn do độ phức tạp bậc hai, O(N2).Các hàm có độ phức tạp bậc hai mở rộng rất kém, phù hợp với danh sách nhỏ nhưng không thực tế để sắp xếp hàng triệu điểm dữ liệu, vì có thể mất hàng ngày để hoàn thành. Tăng gấp đôi dữ liệu dẫn đến thời gian thực thi gấp bốn lần.
Thời gian log-tuyến: O(N log(N))
Hoàn toàn có thể thiết kế một thuật toán để sắp xếp danh sách với độ phức tạp thời gian O(N log(N)). Một thuật toán như vậy gọi là merge sort. Chúng ta sẽ không đi sâu vào chi tiết triển khai, nhưng nếu bạn muốn tìm hiểu thêm, hãy xem giới thiệu nhanh về merge sort từ khóa học Cấu trúc dữ liệu và Thuật toán trong Python.
Như đã đề cập, độ phức tạp logarit trong thực tế hành xử tương tự độ phức tạp hằng số. Do đó, thời gian thực thi của một thuật toán O(N log(N)) có thể tương đương với một thuật toán thời gian tuyến tính trong các ứng dụng thực tế.
Biểu đồ sau cho thấy N log(N) và N tăng với tốc độ tương tự trong khi N2 tăng rất nhanh, nhanh chóng trở nên rất chậm.
Thời gian bậc ba: O(N3)
Một thuật toán độ phức tạp bậc ba được dùng rộng rãi trong AI là phép nhân ma trận, đóng vai trò then chốt trong hoạt động của các mô hình ngôn ngữ lớn như GPT. Thuật toán này là trung tâm của các phép tính trong cả giai đoạn huấn luyện và suy luận.
Để nhân hai ma trận N nhân N, A và B, ta cần nhân mỗi hàng của ma trận A với mỗi cột của ma trận B. Cụ thể, giá trị của tích tại ô (i, j) được xác định bằng cách nhân các phần tử ở hàng i của A với các phần tử tương ứng ở cột j của B.
Dưới đây là một triển khai Python của phép nhân ma trận:
Tổng cộng,
matrix_mul()thực thi N3 + N2 + 2 chỉ lệnh nên độ phức tạp thời gian là O(N3).Ngoài ra, ta có thể phân tích độ phức tạp bằng cách lập luận về các phép tính. Kết quả của phép nhân ma trận có N2 ô. Mỗi ô mất O(N) thời gian để tính, nên tổng thể độ phức tạp là N2 × O(N) = O(N3).
Các thuật toán bậc ba khá chậm. Tăng gấp đôi dữ liệu dẫn đến thời gian thực thi gấp tám lần, khiến các thuật toán này mở rộng rất kém. Ngay cả với giá trị N tương đối nhỏ, số chỉ lệnh cũng tăng vọt rất nhanh.
Nhân ma trận là một ví dụ về thách thức tính toán mà những tiến bộ phần cứng đã tạo ra ảnh hưởng đáng kể. Dù có những thuật toán nhân ma trận hiệu quả hơn đôi chút, chủ yếu chính là các tiến bộ trong thiết kế chip GPU — được tối ưu riêng cho phép nhân ma trận — đã hỗ trợ đáng kể việc huấn luyện các mô hình lớn như GPT trong khung thời gian hợp lý.
Gần đây hơn, các nhà nghiên cứu đã đề xuất loại bỏ phép nhân ma trận khỏi các mô hình học lớn — bạn có thể đọc thêm trong bài viết MatMul-Free LLMs: Giải thích các khái niệm then chốt.
Độ phức tạp thời gian hàm mũ: O(2N) và O(N!)
Các thuật toán thời gian hàm mũ thường xuất hiện khi giải một bài toán bằng cách duyệt qua mọi lời giải có thể. Xét bài toán lập kế hoạch lộ trình cho một xe tải giao hàng phải ghé N điểm giao. Một cách tiếp cận là đánh giá mọi thứ tự giao hàng có thể. Gói itertools của Python cung cấp một cách đơn giản để duyệt qua mọi hoán vị của một danh sách.
Số hoán vị của một danh sách độ dài N được ký hiệu N!, đọc là "N giai thừa". Hàm giai thừa tăng theo hàm mũ. Chẳng hạn, khi N = 13, số hoán vị đã vượt quá 1 tỷ.
Giả sử các điểm giao hàng được cho dưới dạng một danh sách các điểm 2D. Khi đó, ta có thể xác định thứ tự giao hàng tối thiểu hóa tổng quãng đường bằng cách lặp qua mọi thứ tự có thể trong khi lưu lại thứ tự tốt nhất.
Vòng lặp
forđầu tiên được thực thi N! lần. Do đó, số thao tác trongoptimize_route()là N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.Ta đã học rằng khi tính độ phức tạp thời gian, ta bỏ qua các hạng có số mũ thấp hơn. Tuy nhiên, trong tình huống này, ta gặp một hạng N!, không phải lũy thừa của N. Ta có thể tinh chỉnh chiến lược giản lược bằng cách chọn bỏ các hạng có tốc độ tăng chậm hơn. Bảng dưới liệt kê các hạng thường gặp trong độ phức tạp thời gian của thuật toán, sắp xếp từ tốc độ tăng thấp đến cao.
1
log(N)
N
N2
N3
Nk
2N
N!
Vì vậy, ta có thể biểu diễn độ phức tạp thời gian của
optimize_route()là N! x N + 2N! + 3 = O(N! x N).Các thuật toán có độ phức tạp thời gian hàm mũ thường chỉ hiệu quả với những trường hợp rất nhỏ. Chỉ với 13 điểm dừng, số hoán vị đã vượt quá 1 tỷ, khiến thuật toán này không thực tế trong các kịch bản đời thực.
Độ phức tạp thời gian: Trường hợp xấu nhất và tốt nhất
Với trò chơi đoán số, chúng ta tập trung vào độ phức tạp trường hợp xấu nhất. Bằng cách tập trung vào trường hợp xấu nhất, ta đảm bảo tốc độ tăng của thời gian thực thi của thuật toán.
Trong trường hợp tốt nhất, ta đoán đúng ngay lần đầu, nên phân tích trường hợp tốt nhất sẽ cho độ phức tạp O(1). Điều này chính xác — trong trường hợp tốt nhất, ta cần một thao tác hằng số. Tuy nhiên, điều này không quá hữu ích vì rất khó xảy ra.
Nói chung, khi phân tích độ phức tạp của một thuật toán, ta luôn tập trung vào trường hợp xấu nhất vì:
Độ phức tạp thời gian: Hệ quả thực tiễn
Độ phức tạp thời gian có vẻ rất lý thuyết, nhưng lại cực kỳ hữu ích trong thực tế.
Ví dụ, nếu một hàm luôn xử lý một bộ dữ liệu nhỏ, một thuật toán O(N2) dễ hiểu có thể phù hợp hơn một thuật toán O(N) phức tạp và khó bảo trì. Tuy nhiên, đây nên là quyết định có chủ đích để tránh bị bất ngờ khi ứng dụng không thể xử lý lưu lượng người dùng tăng lên.
Phân tích độ phức tạp thời gian cho thấy các tối ưu hóa mã nhỏ có ảnh hưởng không đáng kể đến thời gian thực thi của thuật toán. Cải thiện đáng kể đạt được bằng cách giảm một cách căn bản số phép toán cơ bản cần để tính kết quả. Nói chung, duy trì mã sạch và dễ hiểu được ưu tiên hơn việc tối ưu đến mức trở nên khó hiểu.
Phần chậm hơn của mã sẽ lấn át các phần khác. Thường là vô ích khi tối ưu phần nhanh hơn trước khi tối ưu phần chậm. Ví dụ, giả sử ta có một hàm thực hiện hai tác vụ:
Nếu hàm
clean_data()có độ phức tạp O(N2) vàanalyze_data()có độ phức tạp O(N3), thì giảm độ phức tạp củaclean_data()sẽ không cải thiện độ phức tạp tổng thể củaprocess_data(). Tốt hơn là tập trung cải thiện hàmanalyze_data().Hơn nữa, độ phức tạp thời gian có thể định hướng các quyết định về phần cứng. Ví dụ, một thuật toán O(N3), dù mở rộng kém, vẫn có thể đủ nhanh cho tác vụ với dữ liệu hạn chế nếu chạy trên phần cứng vượt trội hoặc ngôn ngữ lập trình nhanh hơn. Ngược lại, nếu một thuật toán có độ phức tạp thời gian hàm mũ O(2N), thì không nâng cấp phần cứng nào là đủ, cho thấy cần một thuật toán hiệu quả hơn.
Kết luận
Dù máy tính ngày càng nhanh, chúng ta đang xử lý nhiều dữ liệu hơn bao giờ hết. Hãy nghĩ như thế này: mỗi lần dùng Internet, điện thoại thông minh hay thiết bị nhà thông minh, chúng ta tạo ra vô số thông tin. Khi núi dữ liệu này lớn lên, việc sàng lọc và tìm điều quan trọng trở nên khó hơn. Đó là lý do tại sao việc không ngừng cải thiện các công cụ — đặc biệt là thuật toán — để xử lý và thấu hiểu tất cả thông tin này là vô cùng quan trọng.
Phân tích độ phức tạp thời gian cung cấp một khung tiếp cận đơn giản để lý giải thời gian thực thi của thuật toán. Mục tiêu chính của nó là cung cấp hiểu biết về tốc độ tăng trưởng của độ phức tạp thời gian thay vì dự đoán thời gian thực thi chính xác. Dù mô hình có nhiều giản lược và giả định, nó đã chứng tỏ cực kỳ hữu ích trong thực tế, nắm bắt hiệu quả bản chất hành vi thời gian thực thi của thuật toán.
Nếu bạn muốn khám phá thêm các chủ đề khoa học máy tính, hãy xem bài viết của tôi về Cấu trúc dữ liệu: Hướng dẫn toàn diện với ví dụ Python.