Kursus
Pengantar R
4 jam
3.1M
Sebagai data scientist, Anda akan menganalisis distribusi fitur dalam dataset Anda. Biasanya ini dilakukan dengan histogram; cara ini sangat berguna untuk menunjukkan rentang nilai variabel, penyimpangan, dan di mana nilai-nilai terkonsentrasi.
Tutorial ini menggunakan R. Jika Anda belum familiar dengan R, saya sarankan mengikuti kursus gratis Introduction to R di DataCamp.
Untuk tutorial ini, Anda akan menggunakan Bike Sharing Demand Dataset dari kompetisi Kaggle.
Buka tautan tersebut dan pergi ke tab data, lalu unduh file train.csv.
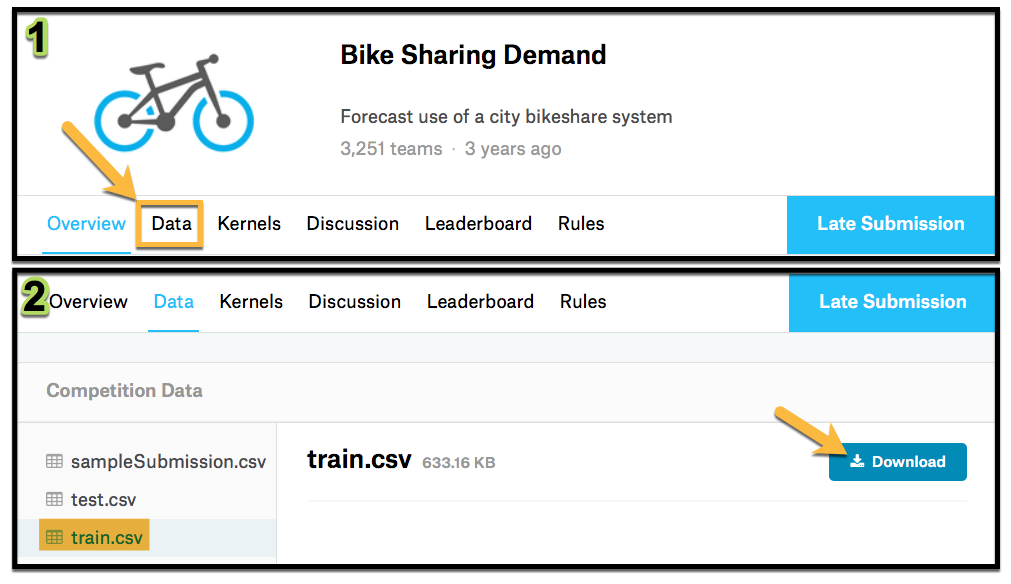
Muat dataset ke R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Fitur | Deskripsi |
|---|---|
| datetime | tanggal + stempel waktu per jam |
| season | 1 = semi 2 = panas 3 = gugur 4 = dingin |
| holiday | apakah hari tersebut tergolong hari libur |
| workingday | apakah hari tersebut bukan akhir pekan maupun hari libur |
| weather | 1: Cerah, Berawan tipis, Sebagian berawan, Sebagian berawan 2: Kabut + Berawan, Kabut + Berawan pecah, Kabut + Berawan tipis, Kabut 3: Salju ringan, Hujan ringan + Guntur + Awan tersebar, Hujan ringan + Awan tersebar 4: Hujan lebat + Butiran es + Guntur + Kabut, Salju + Kabut |
| temp | suhu dalam Celsius |
| atemp | suhu "terasa" dalam Celsius |
| humidity | kelembapan relatif |
| windspeed | kecepatan angin |
| casual | jumlah penyewaan oleh pengguna tidak terdaftar yang dimulai |
| registered | jumlah penyewaan oleh pengguna terdaftar yang dimulai |
| count | jumlah total penyewaan |
Anda akan menganalisis hubungan antara atemp dan humidity menurut season, jadi pilih fitur-fitur tersebut dari dataset. Ingat untuk memuat paket dplyr.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Sekarang Anda siap mulai menganalisis data. Mulailah dengan membuat histogram untuk setiap fitur menurut musim. Anda akan menggunakan pustaka ggplot2, jadi jangan lupa untuk memuatnya.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)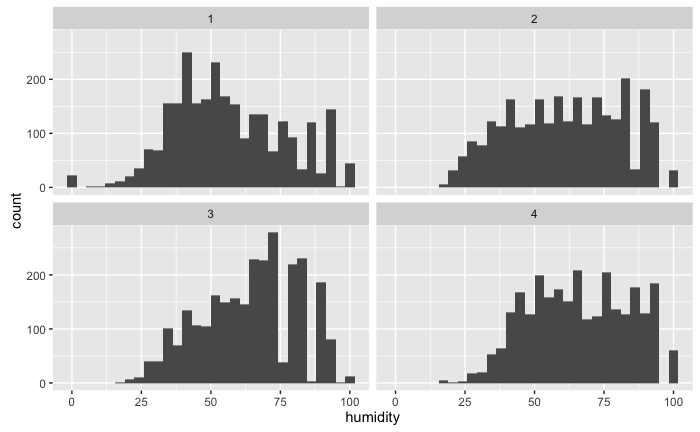
Dari histogram, Anda dapat melihat kelembapan lebih tinggi saat musim dingin (yang memang wajar), tetapi Anda juga mendapatkan gambaran bagaimana distribusinya pada setiap musim.
Sekarang tambahkan kerapatan (density), rug density, dan ubah nama facet agar visualisasinya lebih enak dilihat.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")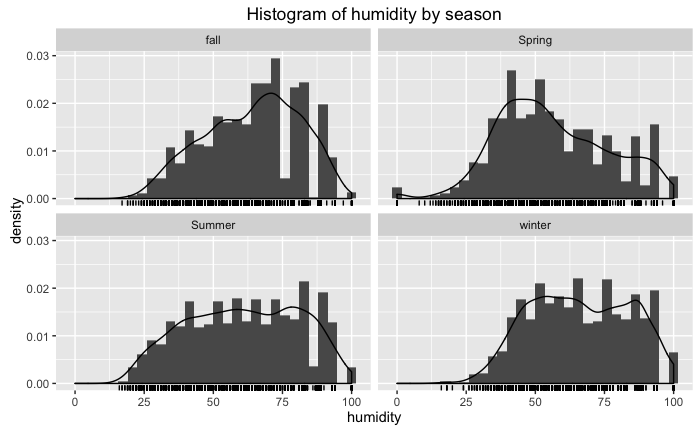
Sekarang, ini memberi Anda gambaran lebih baik tentang perilaku kelembapan. Lakukan hal yang sama untuk atemp.
Gunakan kembali kode di atas dan ganti variabelnya menjadi atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")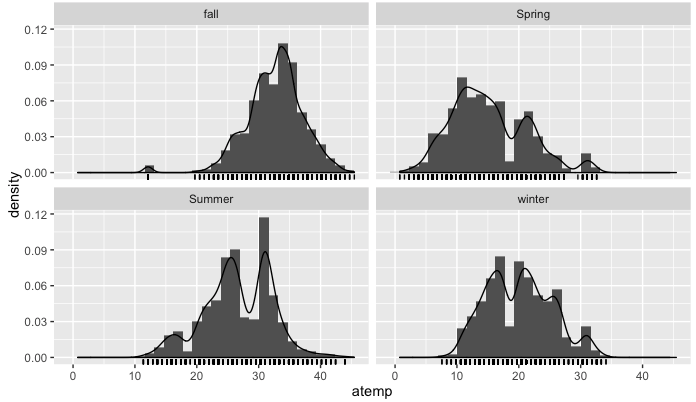
Baik, sejauh ini semuanya sesuai ekspektasi untuk tiap musim. Pada setiap grafik, Anda memiliki pendekatan terhadap fungsi distribusi probabilitas.
Namun, dari grafik-grafik ini sulit memvisualisasikan bagaimana kedua fitur saling berinteraksi. Kesulitan pertama yang Anda hadapi adalah histogram Anda harus 3D karena Anda mencoba mencari fungsi distribusi untuk dua fitur.
Tujuannya adalah memvisualisasikan distribusi bivariat. Untuk melakukannya, Anda terlebih dahulu perlu memasang distribusi bivariat ke data. Ini akan dilakukan menggunakan pustaka MASS dan fungsi kde2d. Fungsi kde2d akan mengestimasi distribusi bivariat dengan mengasumsikan kenormalan untuk variabel acak. Masukan ke fungsi ini adalah sebagai berikut,
| input | deskripsi |
|---|---|
| x | data koordinat x |
| y | data koordinat y |
| n | jumlah titik grid untuk tiap sumbu |
| lims | batas untuk x dan y |
Sekarang terapkan pada dataset dengan memfilter untuk musim panas,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Catatan: Saat memuat pustaka MASS terdapat fungsi
select, yang akan bentrok dengan fungsiselectdari dplyr. Untuk mengatasinya, saat menggunakanselectdari dplyr Anda perlu menambahkan awalandplyr::sepertidplyr::select()agar berfungsi dengan benar.
Sekarang lihat kelas dan struktur dari bike_density
class(bike_density)
str(bike_density)
Objek ini adalah list dengan 3 nilai x, y, dan z. Dua yang pertama berisi nilai fitur dan yang ketiga adalah matriks dengan nilai pdf. Lihat kerapatannya menggunakan fungsi contour,
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)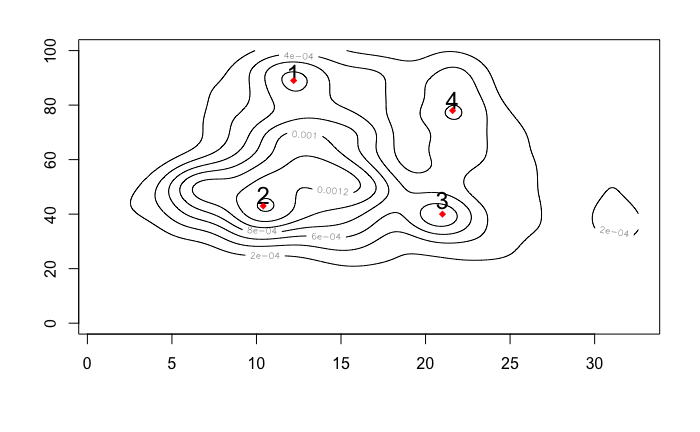
Dari sini Anda dapat mengidentifikasi beberapa titik akumulasi, yang dapat dipahami sebagai nilai paling sering untuk kombinasi kedua fitur. Nilai untuk setiap titik dirangkum pada tabel berikut,
| titik | atemp (°C) | humidity (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Untuk membuat heatmap, pertama-tama Anda perlu menentukan skala warna yang ingin digunakan. Anda bisa melakukannya dengan fungsi colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale adalah sebuah vektor dari hitam ke merah menggunakan kode RGB dalam 1000 langkah.
Sekarang plot heat map Anda menggunakan fungsi image, fungsi ini digunakan untuk memplot matriks.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
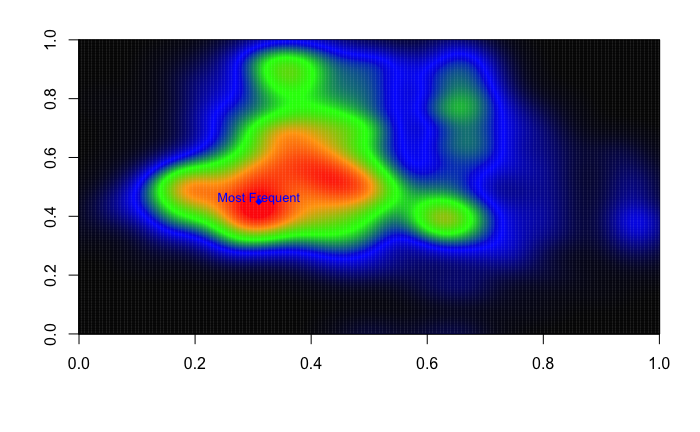
Seperti yang terlihat, ini memuat lebih banyak informasi dibanding plot kontur karena warna sekarang menunjukkan seberapa tinggi titik akumulasi tersebut. Anda dapat melihat bahwa nilai paling sering untuk humidity dan atemp selama musim semi berada di sekitar titik (10.4, 43)
Sekarang Anda tahu cara membuat heat map, giliran Anda untuk membuatnya sendiri. Mulailah dengan melihat musim lainnya dan hubungannya dengan variabel lain.
Pikirkan bagaimana Anda dapat menggunakan ini untuk mendapatkan wawasan tentang berapa banyak sepeda yang harus Anda sediakan untuk berbagai nilai variabel, dengan mempertimbangkan bahwa titik yang paling sering memiliki probabilitas lebih tinggi.
Jika Anda ingin mempelajari lebih lanjut tentang membuat visualisasi data dengan ggplot, pastikan untuk melihat kursus Data Visualization with ggplot2 kami.
Pelajari lebih lanjut tentang R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



