Cours
Introduction à R
4 h
3.1M
En tant que data scientist, vous devrez analyser la distribution des variables de votre jeu de données. En général, on utilise des histogrammes : c’est très utile pour visualiser l’étendue des valeurs, leur dispersion et les zones de concentration.
Ce tutoriel utilise R. Si vous ne maîtrisez pas encore R, nous vous recommandons notre cours gratuit Introduction to R sur DataCamp.
Pour ce tutoriel, vous allez utiliser le jeu de données Bike Sharing Demand issu d’une compétition Kaggle.
Suivez le lien, ouvrez l’onglet Data, puis téléchargez le fichier train.csv.
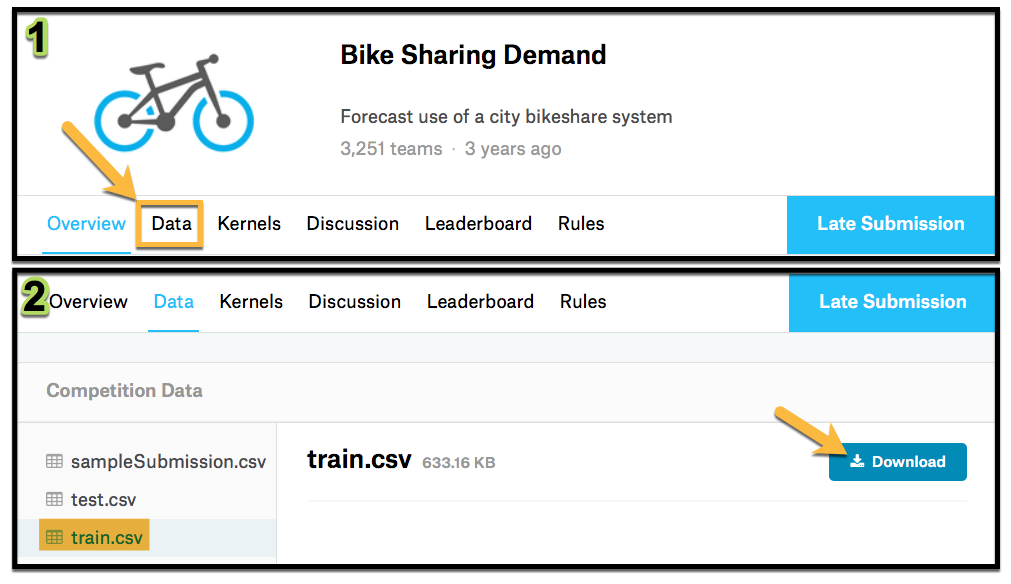
Chargez le jeu de données dans R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Variable | Description |
|---|---|
| datetime | date + horodatage à l’heure |
| season | 1 = printemps 2 = été 3 = automne 4 = hiver |
| holiday | indique si le jour est férié |
| workingday | indique si le jour n’est ni un week-end ni un jour férié |
| weather | 1 : Dégagé, Quelques nuages, Partiellement nuageux 2 : Brume + Nuageux, Brume + Éclaircies, Brume + Quelques nuages, Brume 3 : Neige faible, Pluie faible + Orage + Éclaircies, Pluie faible + Éclaircies 4 : Pluie forte + Grésil + Orage + Brume, Neige + Brouillard |
| temp | température en °C |
| atemp | température « ressentie » en °C |
| humidity | humidité relative |
| windspeed | vitesse du vent |
| casual | nombre de locations initiées par des utilisateurs non enregistrés |
| registered | nombre de locations initiées par des utilisateurs enregistrés |
| count | nombre total de locations |
Vous allez analyser la relation entre atemp et humidity selon la season. Sélectionnez donc ces colonnes dans le jeu de données. N’oubliez pas de charger le package dplyr.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Vous pouvez maintenant commencer l’analyse. Commencez par créer un histogramme pour chacune des variables, par saison. Nous allons utiliser la librairie ggplot2 : n’oubliez pas de la charger.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)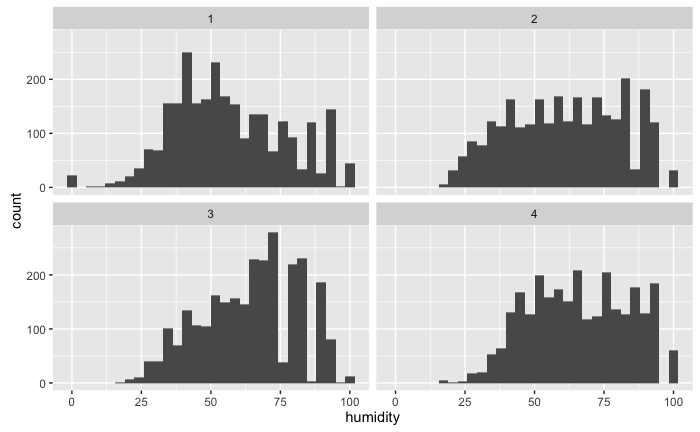
Avec l’histogramme, on voit qu’il y a davantage d’humidité en hiver (ce qui est logique), et l’on perçoit la distribution pour chaque saison.
Ajoutez maintenant la densité, un « rug » de densité et renommez les facettes, pour une visualisation plus soignée.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")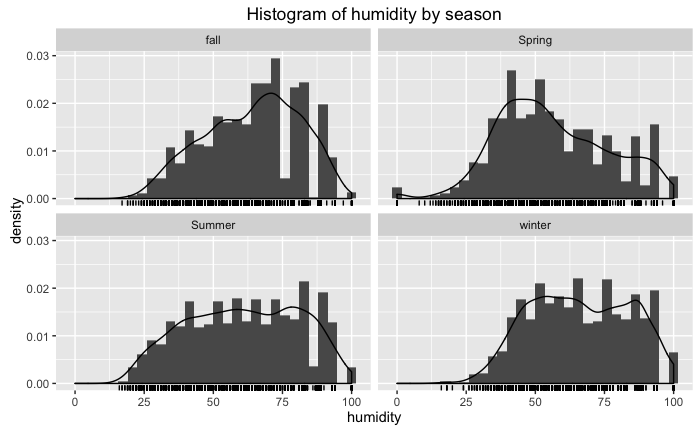
Vous avez maintenant une meilleure idée du comportement de l’humidité. Faites la même chose avec atemp.
Réutilisez le code ci-dessus en remplaçant la variable par atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")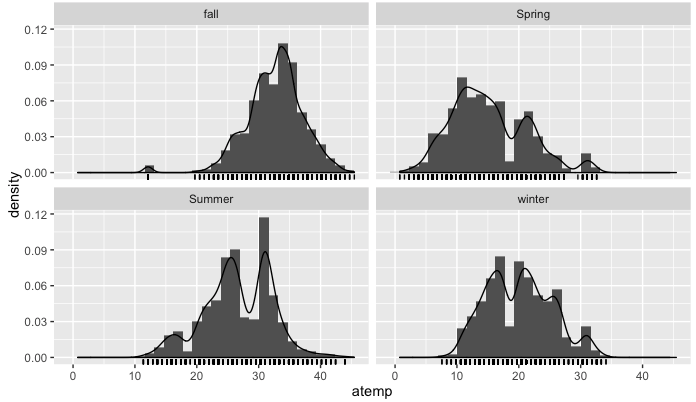
Jusqu’ici, tout se passe comme prévu pour chaque saison. Sur chaque graphique, vous disposez d’une approximation de la fonction de densité de probabilité.
Mais avec ces graphiques, il reste difficile de visualiser l’interaction entre les variables. Première difficulté : il vous faudrait un histogramme en 3D, puisque vous cherchez la fonction de distribution de deux variables.
L’objectif est de visualiser la distribution bivariée. Pour cela, vous devez d’abord l’ajuster aux données. Nous allons utiliser la librairie MASS et la fonction kde2d. Cette fonction estime la distribution bivariée en supposant la normalité des variables aléatoires. Ses entrées sont les suivantes :
| entrée | description |
|---|---|
| x | coordonnées x |
| y | coordonnées y |
| n | nombre de points de grille par axe |
| lims | bornes pour x et y |
Appliquez-la maintenant au jeu de données en filtrant l’été,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Remarque : Lors du chargement de MASS, un objet
selectest défini, ce qui peut entrer en conflit avec la fonctionselectde dplyr. Pour éviter cela, lorsque vous utilisez la fonction de dplyr, préfixez-la pardplyr::comme ceci :dplyr::select().
Examinez maintenant la classe et la structure de bike_density
class(bike_density)
str(bike_density)
Il s’agit d’une liste contenant 3 éléments : x, y et z. Les deux premiers portent les valeurs des variables, et le troisième est une matrice avec les valeurs de la densité (pdf). Visualisez la densité avec la fonction contour :
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)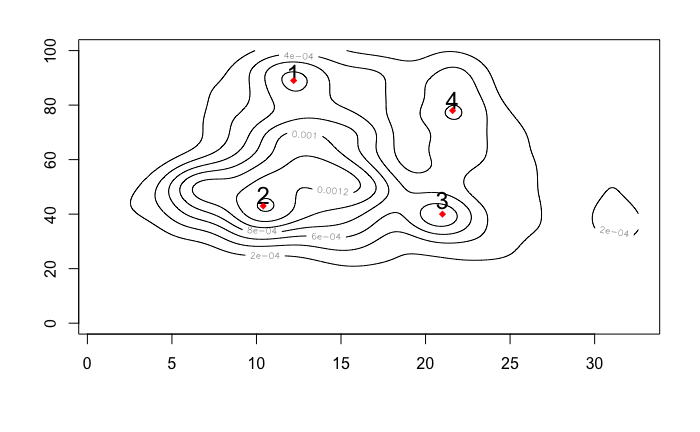
À la lecture de ce graphique, vous identifiez des points d’accumulation, que l’on peut interpréter comme les valeurs les plus fréquentes pour la combinaison des deux variables. Les valeurs de chaque point sont résumées dans le tableau suivant :
| point | atemp (°C) | humidité (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Pour créer votre carte de chaleur, commencez par définir l’échelle de couleurs à utiliser, via la fonction colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale est un vecteur allant du noir au rouge, en 1000 paliers RVB.
Tracez ensuite la carte de chaleur avec la fonction image, utilisée pour représenter des matrices.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
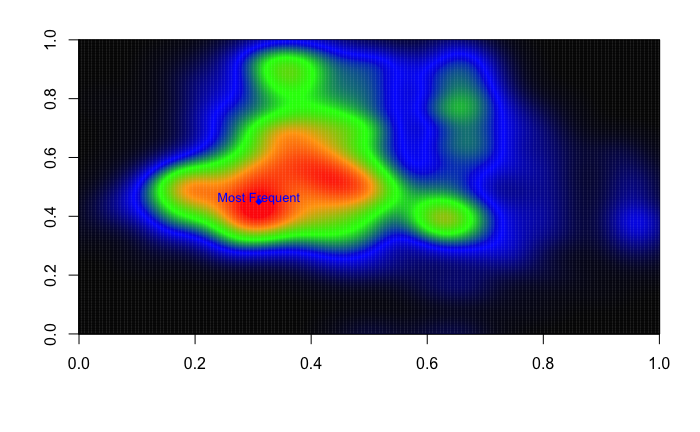
Comme vous le voyez, cette représentation apporte plus d’information que le tracé de contours : la couleur indique l’intensité des points d’accumulation. Les valeurs les plus fréquentes d’humidité et d’atemp au printemps se situent autour du point (10,4 ; 43).
Vous savez désormais créer une carte de chaleur : à vous de jouer. Explorez les autres saisons et la relation avec d’autres variables.
Réfléchissez à la manière d’exploiter ces informations pour estimer le nombre de vélos à fournir selon les valeurs des variables, en gardant à l’esprit que les points les plus fréquents ont une probabilité plus élevée.
Pour aller plus loin dans la création de visualisations avec ggplot, découvrez notre cours Data Visualization with ggplot2.
En savoir plus sur R
Cours
Cours
Cours