Kurs
Einführung in R
4 Std.
3.1M
Als Data Scientist musst du die Verteilung der Merkmale in deinem Datensatz analysieren. Üblicherweise nutzt man dafür Histogramme – sie zeigen den Wertebereich einer Variablen, ihre Streuung und wo sich Werte ballen.
Dieses Tutorial verwendet R. Wenn du noch nicht mit R vertraut bist, empfehlen wir dir unseren kostenlosen Introduction to R-Kurs auf DataCamp.
Für dieses Tutorial nutzt du den Bike Sharing Demand Dataset aus einem Kaggle-Wettbewerb.
Folge dem Link, wechsle zum Tab „Data“ und lade die Datei train.csv herunter.
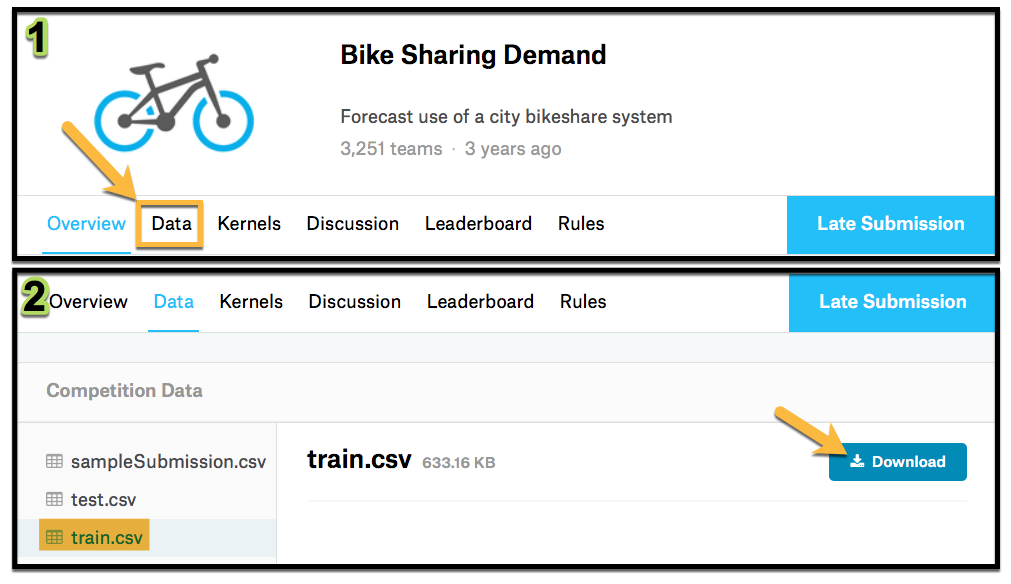
Lade den Datensatz in R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Feature | Beschreibung |
|---|---|
| datetime | stündliches Datum + Zeitstempel |
| season | 1 = Frühling 2 = Sommer 3 = Herbst 4 = Winter |
| holiday | ob der Tag ein Feiertag ist |
| workingday | ob der Tag weder Wochenende noch Feiertag ist |
| weather | 1: Klar, wenige Wolken, teils bewölkt 2: Nebel + bewölkt, Nebel + aufgelockerte Bewölkung, Nebel + wenige Wolken, Nebel 3: Leichter Schnee, Leichter Regen + Gewitter + aufgelockerte Bewölkung, Leichter Regen + aufgelockerte Bewölkung 4: Starker Regen + Eiskörner + Gewitter + Nebel, Schnee + Nebel |
| temp | Temperatur in Celsius |
| atemp | gefühlte Temperatur in Celsius |
| humidity | relative Luftfeuchtigkeit |
| windspeed | Windgeschwindigkeit |
| casual | Anzahl gestarteter Ausleihen durch nicht registrierte Nutzer |
| registered | Anzahl gestarteter Ausleihen durch registrierte Nutzer |
| count | Gesamtzahl der Ausleihen |
Du analysierst die Beziehung zwischen atemp und humidity nach season. Wähle diese Spalten aus dem Datensatz aus. Denk daran, das Paket dplyr zu laden.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Jetzt kannst du mit der Analyse starten. Erstelle zunächst für jede Saison ein Histogramm der einzelnen Features. Du verwendest dafür die Bibliothek ggplot2 – vergiss also nicht, sie zu laden.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)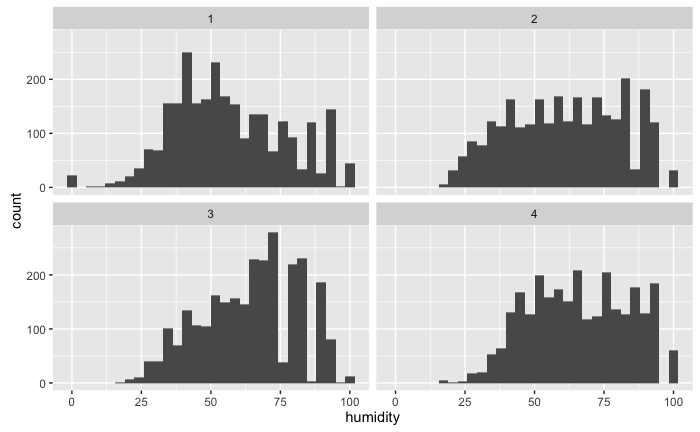
Im Histogramm sieht man, dass die Luftfeuchtigkeit im Winter höher ist (nicht überraschend). Du bekommst außerdem ein Gefühl dafür, wie sie sich in den einzelnen Jahreszeiten verteilt.
Füge nun die Dichtekurve, einen Rug-Plot und sinnvoll benannte Facetten hinzu, damit die Visualisierung ansprechender wird.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")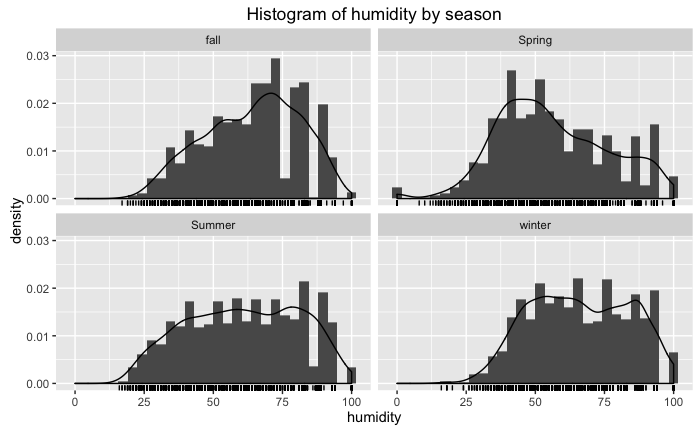
Damit bekommst du ein noch besseres Gefühl für das Verhalten der Luftfeuchtigkeit. Wiederhole das Gleiche für atemp.
Verwende den obigen Code erneut und tausche die Variable gegen atemp aus.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")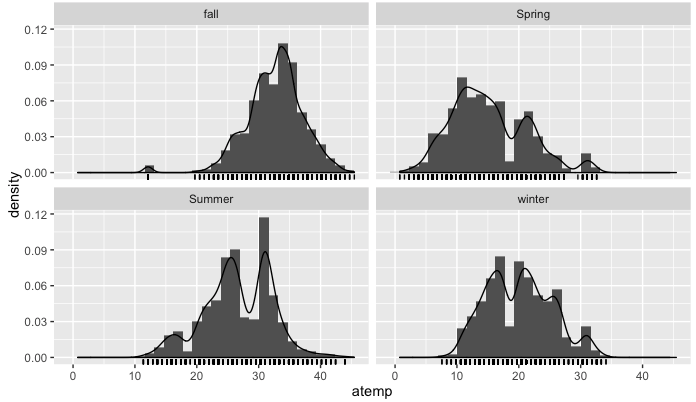
Soweit läuft alles wie erwartet – in jedem Diagramm siehst du eine Annäherung an die Wahrscheinlichkeitsdichtefunktion.
Allerdings ist es mit diesen Diagrammen schwer zu erkennen, wie die Features miteinander interagieren. Das erste Problem: Ein Histogramm müsste hier 3D sein, weil du die Verteilung zweier Variablen gemeinsam betrachten willst.
Das Ziel ist, die bivariate Verteilung zu visualisieren. Dafür musst du zunächst eine bivariate Verteilung an die Daten anpassen. Das erledigst du mit der Bibliothek MASS und der Funktion kde2d. kde2d schätzt die bivariate Verteilung und nimmt dabei Normalität der Zufallsvariablen an. Die Eingaben sind:
| Input | Beschreibung |
|---|---|
| x | x-Koordinatendaten |
| y | y-Koordinatendaten |
| n | Anzahl der Gitterpunkte pro Achse |
| lims | Grenzen für x und y |
Wende das nun auf den Datensatz an und filtere auf den Sommer,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Hinweis: Beim Laden von MASS wird eine Funktion
selectmitgebracht. Diese kollidiert mitdplyr::select. Verwende deshalb beim dplyr-selectden Präfixdplyr::, alsodplyr::select(), damit alles korrekt läuft.
Schaue dir nun Klasse und Struktur von bike_density an.
class(bike_density)
str(bike_density)
Es handelt sich um eine Liste mit drei Elementen: x, y und z. Die ersten beiden enthalten die Werte der Features, das dritte ist eine Matrix mit den Werten der Dichtefunktion. Betrachte die Dichte mit der Funktion contour:
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)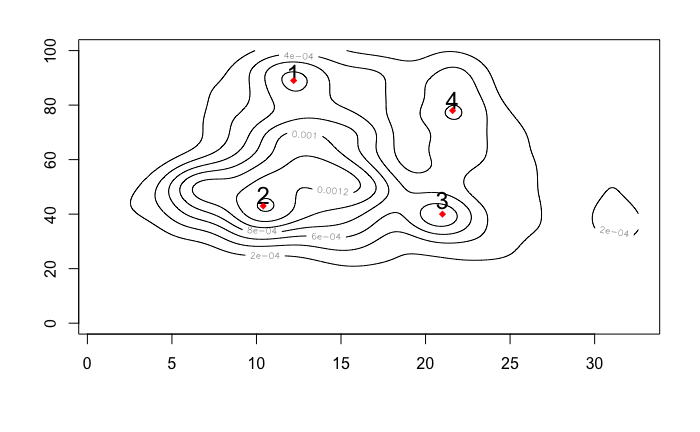
Daran lassen sich einige Häufungspunkte erkennen – also die häufigsten Wertekombinationen der beiden Features. Die Werte der markierten Punkte sind in der folgenden Tabelle zusammengefasst:
| Punkt | atemp (°C) | humidity (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Um eine Heatmap zu erstellen, definierst du zuerst die gewünschte Farbskala. Das geht mit colorRampPalette.
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale ist ein Vektor, der in 1000 Schritten per RGB von Schwarz bis Rot verläuft.
Zeichne nun die Heatmap mit der Funktion image, die zum Plotten von Matrizen verwendet wird.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
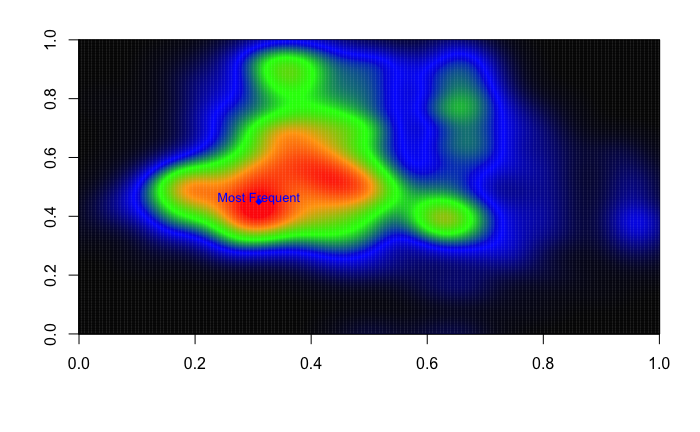
Wie du siehst, enthält das gegenüber dem Konturplot mehr Information, da die Farben zeigen, wie hoch die Dichte an den Häufungspunkten ist. Die häufigsten Werte für Luftfeuchtigkeit und atemp im Frühling liegen etwa bei (10,4; 43).
Jetzt weißt du, wie du eine Heatmap erstellst – probiere es aus. Schau dir die anderen Jahreszeiten und deren Beziehung zu weiteren Variablen an.
Überlege, wie du damit abschätzen kannst, wie viele Bikes du für unterschiedliche Merkmalswerte bereitstellen solltest – die häufigsten Punkte haben die höchste Wahrscheinlichkeit.
Wenn du mehr über das Erstellen von Visualisierungen mit ggplot lernen möchtest, schau dir unseren Kurs Data Visualization with ggplot2 an.
Mehr über R lernen
Kurs
Kurs
Kurs