Kursus
Pengantar Tidyverse
4 jam
397.1K
Tutorial ini merupakan ringkasan dari acara Facebook Live yang kami adakan seminggu lalu. Topiknya adalah "Pengantar Tidyverse" dan tutorial ini akan membawa Anda melalui seluruh konten yang kami bahas selama sesi code-along!
Anda dapat menonton bagian pertama sesi tersebut di sini:
Dan bagian keduanya di sini:
Catatan Anda dapat menemukan seluruh kode untuk sesi ini di repositori ini.
Tidyverse inti mencakup paket-paket yang kemungkinan besar Anda gunakan dalam analisis data sehari-hari, seperti ggplot2 untuk visualisasi data dan dplyr untuk pengolahan data. Anda akan berfokus pada dua paket ini dalam tutorial ini.
Ingat bahwa paket pada dasarnya adalah seperangkat alat untuk melakukan berbagai hal dengan data. Jika Anda ingin mengetahui lebih banyak tentang paket di R, lihat tutorial ini.
Untuk informasi lebih lanjut tentang Tidyverse, lihat kursus Introduction to Tidyverse oleh David Robinson di DataCamp dan sumber belajar Tidyverse.
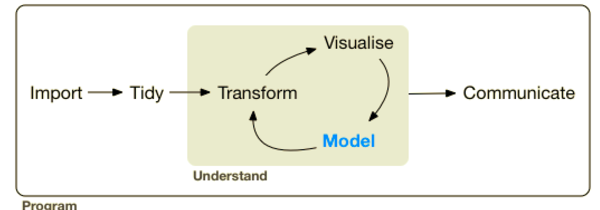
Untuk memulai, Anda sebaiknya memasang tidyverse, jika belum:
# Install the tidyverse
# install.packages("tidyverse")
Sekarang setelah Anda memasang tidyverse, saatnya memuat data dan meninjau beberapa observasi.
Dalam tutorial ini, Anda akan mengeksplorasi dataset Titanic, di mana setiap observasi adalah seorang penumpang dan setiap variabel adalah fitur seperti Name, Age, dan apakah Survived (selamat) atau tidak.
Muat data Anda seperti ini:
 # Import the Tidyverse
library(tidyverse)

# Import data
passengers <- read.csv("data/train.csv")

# Check out the first several observations of your dataframe
passengers

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6     0           330877  8.4583              Q
Catatan bahwa path yang Anda berikan ke read.csv() dapat berubah tergantung pada pengaturan Anda. Jika Anda ingin tetap menggunakan path file yang sama, Anda selalu dapat melihat struktur folder proyek ini di repositori GitHub kami, yang dapat Anda temukan di sini.
Perhatikan juga bahwa jika Anda ingin mengetahui lebih banyak tentang semua variabel yang Anda lihat sebagai hasil eksekusi passengers, Anda dapat melihat deskripsi dataset.
Untuk mendapatkan gambaran umum tentang data Anda, Anda dapat menggunakan fungsi summary():
# Summarize titanic
summary(passengers)

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
##  (Other)    :186
Sekarang lakukan hal yang sama menggunakan pipe %>%, salah satu alat paling praktis di tidyverse:
# Summarize titanic using a pipe
passengers %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:223.5   1st Qu.:0.0000   1st Qu.:2.000
##  Median :446.0   Median :0.0000   Median :3.000
##  Mean   :446.0   Mean   :0.3838   Mean   :2.309
##  3rd Qu.:668.5   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:314   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :577   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :885                NA's   :177
##      SibSp           Parch             Ticket         Fare
##  Min.   :0.000   Min.   :0.0000   1601    :  7   Min.   :  0.00
##  1st Qu.:0.000   1st Qu.:0.0000   347082  :  7   1st Qu.:  7.91
##  Median :0.000   Median :0.0000   CA. 2343:  7   Median : 14.45
##  Mean   :0.523   Mean   :0.3816   3101295 :  6   Mean   : 32.20
##  3rd Qu.:1.000   3rd Qu.:0.0000   347088  :  6   3rd Qu.: 31.00
##  Max.   :8.000   Max.   :6.0000   CA 2144 :  6   Max.   :512.33
##                                   (Other) :852
##          Cabin     Embarked
##             :687    :  2
##  B96 B98    :  4   C:168
##  C23 C25 C27:  4   Q: 77
##  G6         :  4   S:644
##  C22 C26    :  3
##  D          :  3
## (Other) :186Tip: jika Anda ingin mengetahui lebih lanjut tentang penggunaan operator pipe di R, Anda dapat melihat tutorial ini.
Lakukan hal yang sama setelah menghapus observasi yang memiliki nilai hilang. Petunjuk: Anda dapat menggabungkan beberapa pipe!
# Summarize titanic after dropping na
passengers %>%
  drop_na() %>%
  summary()

##   PassengerId       Survived          Pclass
##  Min.   :  1.0   Min.   :0.0000   Min.   :1.000
##  1st Qu.:222.2   1st Qu.:0.0000   1st Qu.:1.000
##  Median :445.0   Median :0.0000   Median :2.000
##  Mean   :448.6   Mean   :0.4062   Mean   :2.237
##  3rd Qu.:677.8   3rd Qu.:1.0000   3rd Qu.:3.000
##  Max.   :891.0   Max.   :1.0000   Max.   :3.000
##
##                                     Name         Sex           Age
##  Abbing, Mr. Anthony                  :  1   female:261   Min.   : 0.42
##  Abbott, Mr. Rossmore Edward          :  1   male  :453   1st Qu.:20.12
##  Abbott, Mrs. Stanton (Rosa Hunt)     :  1                Median :28.00
##  Abelson, Mr. Samuel                  :  1                Mean   :29.70
##  Abelson, Mrs. Samuel (Hannah Wizosky):  1                3rd Qu.:38.00
##  Adahl, Mr. Mauritz Nils Martin       :  1                Max.   :80.00
##  (Other)                              :708
##      SibSp            Parch                 Ticket         Fare
##  Min.   :0.0000   Min.   :0.0000   347082      :  7   Min.   :  0.00
##  1st Qu.:0.0000   1st Qu.:0.0000   3101295     :  6   1st Qu.:  8.05
##  Median :0.0000   Median :0.0000   347088      :  6   Median : 15.74
##  Mean   :0.5126   Mean   :0.4314   CA 2144     :  6   Mean   : 34.69
##  3rd Qu.:1.0000   3rd Qu.:1.0000   382652      :  5   3rd Qu.: 33.38
##  Max.   :5.0000   Max.   :6.0000   S.O.C. 14879:  5   Max.   :512.33
##                                    (Other)     :679
##          Cabin     Embarked
##             :529    :  2
##  B96 B98    :  4   C:130
##  C23 C25 C27:  4   Q: 28
##  G6         :  4   S:554
##  C22 C26    :  3
##  D          :  3
##  (Other)    :167
Anda mungkin memperhatikan konsistensi gaya dalam kode yang Anda tulis di atas. Itu karena Anda mengikuti panduan gaya. Dalam sains data dan pemrograman/koding secara umum, penting untuk membiasakan diri menggunakan panduan gaya sedini mungkin. Seperti yang dikatakan Hadley Wickham dalam panduan gaya tidyverse,
Gaya penulisan kode yang baik seperti tanda baca yang benar: Anda bisa saja tanpanya, tetapiitsuremakesthingseasiertoread.
Pada bagian berikutnya, Anda akan menangani pengolahan data dengan dplyr untuk memfilter data, mengurutkannya, dan membuat fitur baru dengan memodifikasi yang lama.
Sekarang saatnya mengeksplorasi data Anda dan mendapatkan wawasan awal tentang dataset. Anda akan menggunakan verba dplyr seperti filter(), arrange(), dan mutate(), yang melakukan persis seperti namanya.
Misalkan Anda ingin memilih serangkaian observasi tertentu, katakanlah, yang "Sex"-nya adalah 'female'. dplyr memungkinkan kita melakukannya secara intuitif dan dengan bahasa yang mencerminkan cara Anda berpikir dan berbicara tentang data.
Verba filter memilih hanya observasi yang memenuhi kondisi. Lihat contohnya:
# Filter to get all "male" rows
passengers %>%
  filter(Sex == "male")

##   PassengerId Survived Pclass                           Name  Sex Age
## 1           1        0      3        Braund, Mr. Owen Harris male  22
## 2           5        0      3       Allen, Mr. William Henry male  35
## 3           6        0      3               Moran, Mr. James male  NA
## 4           7        0      1        McCarthy, Mr. Timothy J male  54
## 5           8        0      3 Palsson, Master. Gosta Leonard male   2
## 6          13        0      3 Saundercock, Mr. William Henry male  20
##   SibSp Parch    Ticket    Fare Cabin Embarked
## 1     1     0 A/5 21171  7.2500              S
## 2     0     0    373450  8.0500              S
## 3     0     0    330877  8.4583              Q
## 4     0     0     17463 51.8625   E46        S
## 5     3     1    349909 21.0750              S
## 6     0     0 A/5. 2151  8.0500              S
Saat melihat hasil potongan kode di atas, Anda akan melihat bahwa tampaknya banyak laki-laki tidak selamat dari tenggelamnya RMS Titanic. Ini menarik, dan Anda akan mengeksplorasinya lebih lanjut nanti dalam tutorial ini!
Catatan Anda dapat membaca kode dplyr seperti kalimat: ambil data Anda lalu (%>%) saring sesuai kondisi bahwa jenis kelaminnya laki-laki. Kode dalam potongan di atas tidak mengubah data frame asli. filter(Sex = "male") adalah kesalahan umum (Hugo juga pernah membuat kesalahan yang sama!); ada panduan galat tidyverse yang keren.
# Filter to get all "female" rows
passengers %>%
  filter(Sex == "female")

##   PassengerId Survived Pclass
## 1           2        1      1
## 2           3        1      3
## 3           4        1      1
## 4           9        1      3
## 5          10        1      2
## 6          11        1      3
##                                                  Name    Sex Age SibSp
## 1 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 2                              Heikkinen, Miss. Laina female  26     0
## 3        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 4   Johnson, Mrs. Oscar W (Elisabeth Vilhelmina Berg) female  27     0
## 5                 Nasser, Mrs. Nicholas (Adele Achem) female  14     1
## 6                     Sandstrom, Miss. Marguerite Rut female   4     1
##   Parch           Ticket    Fare Cabin Embarked
## 1     0         PC 17599 71.2833   C85        C
## 2     0 STON/O2. 3101282  7.9250              S
## 3     0           113803 53.1000  C123        S
## 4     2           347742 11.1333              S
## 5     0           237736 30.0708              C
## 6     1          PP 9549 16.7000    G6        S
Secara anekdotal, wanita tampaknya lebih mungkin selamat dari bencana Titanic.
Saat mengeksplorasi data, Anda sebaiknya mengajukan dan menjawab pertanyaan yang menarik minat Anda semampu Anda! Saat ini, Anda mungkin ingin arrange() observasi Anda berdasarkan Fare yang meningkat untuk melihat apakah Anda dapat melihat tren apa pun. Anda dapat menggunakan verba arrange() untuk melakukannya:
# Arrange by increasing Fare
passengers %>%
  arrange(Fare)

##   PassengerId Survived Pclass                            Name  Sex Age
## 1         180        0      3             Leonard, Mr. Lionel male  36
## 2         264        0      1           Harrison, Mr. William male  40
## 3         272        1      3    Tornquist, Mr. William Henry male  25
## 4         278        0      2     Parkes, Mr. Francis "Frank" male  NA
## 5         303        0      3 Johnson, Mr. William Cahoone Jr male  19
## 6         414        0      2  Cunningham, Mr. Alfred Fleming male  NA
##   SibSp Parch Ticket Fare Cabin Embarked
## 1     0     0   LINE    0              S
## 2     0     0 112059    0   B94        S
## 3     0     0   LINE    0              S
## 4     0     0 239853    0              S
## 5     0     0   LINE    0              S
## 6     0     0 239853    0              S
Banyak orang yang membayar lebih sedikit tidak selamat dari bencana. Itu hal menarik yang baru saja Anda temukan hanya dengan mengurutkan ulang data Anda!
Anda juga dapat arrange berdasarkan Fare menurun:
# Arrange by decreasing Fare
passengers %>%
  arrange(desc(Fare))

##   PassengerId Survived Pclass                               Name    Sex
## 1         259        1      1                   Ward, Miss. Anna female
## 2         680        1      1 Cardeza, Mr. Thomas Drake Martinez   male
## 3         738        1      1             Lesurer, Mr. Gustave J   male
## 4          28        0      1     Fortune, Mr. Charles Alexander   male
## 5          89        1      1         Fortune, Miss. Mabel Helen female
## 6         342        1      1     Fortune, Miss. Alice Elizabeth female
##   Age SibSp Parch   Ticket     Fare       Cabin Embarked
## 1  35     0     0 PC 17755 512.3292                    C
## 2  36     0     1 PC 17755 512.3292 B51 B53 B55        C
## 3  35     0     0 PC 17755 512.3292        B101        C
## 4  19     3     2    19950 263.0000 C23 C25 C27        S
## 5  23     3     2    19950 263.0000 C23 C25 C27        S
## 6  24     3     2    19950 263.0000 C23 C25 C27        S
Memang ada lebih banyak penyintas di kelompok yang membayar paling tinggi!
Terkadang Anda mungkin ingin membuat variabel baru. Anda tahu bahwa variabel Parch adalah jumlah orang tua dan anak, sedangkan SibSp adalah jumlah saudara kandung dan pasangan. Anda dapat menjumlahkannya untuk mendapatkan variabel baru FamSize. Ini adalah rekayasa fitur dan sering kali menjadi bagian besar dari machine learning!
Sekarang, untuk membuat variabel baru, Anda melakukan mutate() pada variabel asli menjadi variabel baru.
# Create new column FamSize (size of family)
passengers %>%
  mutate(FamSize = Parch + SibSp)

##   PassengerId Survived Pclass
## 1           1        0      3
## 2           2        1      1
## 3           3        1      3
## 4           4        1      1
## 5           5        0      3
## 6           6        0      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked FamSize
## 1     0        A/5 21171  7.2500              S       1
## 2     0         PC 17599 71.2833   C85        C       1
## 3     0 STON/O2. 3101282  7.9250              S       0
## 4     0           113803 53.1000  C123        S       1
## 5     0           373450  8.0500              S       0
## 6     0           330877  8.4583              Q       0
Catatan bahwa mutate() dapat digunakan untuk membuat kolom baru sekaligus memodifikasi kolom yang sudah ada dengan cara yang kurang lebih mirip dengan mutasi dari perspektif biologis. Tidak persis sama, tetapi cara yang bagus untuk memberi konteks pemilihan verba.
Sekarang setelah Anda memiliki variabel tambahan, Anda dapat mengajukan pertanyaan lain, seperti "Apakah mungkin keluarga yang lebih besar memiliki tingkat kelangsungan hidup yang lebih rendah?".
Untuk menguji hipotesis ini, buat variabel baru FamSize sebagai jumlah dari Parch dan SibSp seperti di atas, lalu urutkan berdasarkan FamSize menurun:
# Create new column FamSize (size of family)
# Arrange by decreasing FamSize
passengers %>%
  mutate(FamSize = Parch + SibSp) %>%
  arrange(desc(FamSize))

##   PassengerId Survived Pclass                         Name    Sex Age
## 1         160        0      3   Sage, Master. Thomas Henry   male  NA
## 2         181        0      3 Sage, Miss. Constance Gladys female  NA
## 3         202        0      3          Sage, Mr. Frederick   male  NA
## 4         325        0      3     Sage, Mr. George John Jr   male  NA
## 5         793        0      3      Sage, Miss. Stella Anna female  NA
## 6         847        0      3     Sage, Mr. Douglas Bullen   male  NA
##   SibSp Parch   Ticket  Fare Cabin Embarked FamSize
## 1     8     2 CA. 2343 69.55              S      10
## 2     8     2 CA. 2343 69.55              S      10
## 3     8     2 CA. 2343 69.55              S      10
## 4     8     2 CA. 2343 69.55              S      10
## 5     8     2 CA. 2343 69.55              S      10
## 6     8     2 CA. 2343 69.55              S      10
Semua anggota keluarga teratas tidak selamat! Ini bisa jadi indikasi: mungkin jika Anda bagian dari keluarga besar, Anda tidak sempat turun dari Titanic tepat waktu.
Namun, karena nol dan satu sering kali tidak banyak bercerita, ubah nilai variabel Survived menjadi string No dan Yes (dan buat data frame baru!):
# Turn numerical values of Survived column to "No" & "Yes" (new data frame)
passengers1 <- passengers %>%
  mutate(Survived = ifelse(Survived == 0, "No", "Yes"))
passengers1

##   PassengerId Survived Pclass
## 1           1       No      3
## 2           2      Yes      1
## 3           3      Yes      3
## 4           4      Yes      1
## 5           5       No      3
## 6           6       No      3
##                                                  Name    Sex Age SibSp
## 1                             Braund, Mr. Owen Harris   male  22     1
## 2 Cumings, Mrs. John Bradley (Florence Briggs Thayer) female  38     1
## 3                              Heikkinen, Miss. Laina female  26     0
## 4        Futrelle, Mrs. Jacques Heath (Lily May Peel) female  35     1
## 5                            Allen, Mr. William Henry   male  35     0
## 6                                    Moran, Mr. James   male  NA     0
##   Parch           Ticket    Fare Cabin Embarked
## 1     0        A/5 21171  7.2500              S
## 2     0         PC 17599 71.2833   C85        C
## 3     0 STON/O2. 3101282  7.9250              S
## 4     0           113803 53.1000  C123        S
## 5     0           373450  8.0500              S
## 6 0 330877 8.4583 QUntuk memplot data menggunakan ggplot2, Anda menentukan tiga hal:
Pertama Anda akan membuat barplot dari Sex untuk melihat berapa banyak laki-laki dan perempuan yang tercatat di Titanic:
# Plot barplot of passenger Sex
ggplot(passengers, aes(x = Sex)) +
  geom_bar()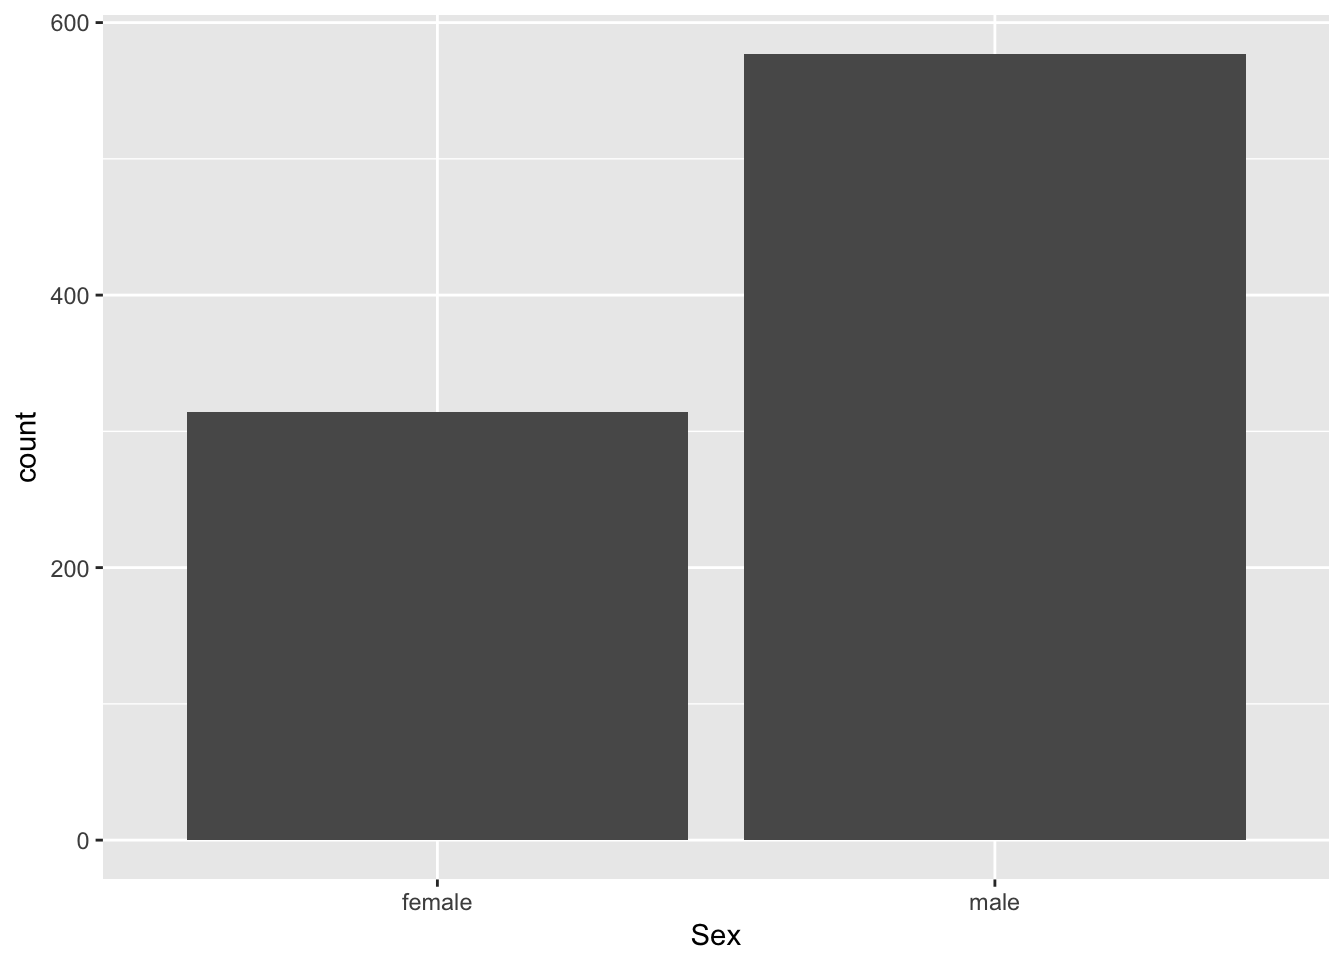
Dari plot di atas, Anda dapat mengetahui bahwa ada sekitar 600 pria dan 300 wanita di atas RMS Titanic.
Catatan bahwa fungsi aes() adalah cara untuk memetakan aestetik plot ke variabel dalam data. Lihat Modern Dive oleh Chester Ismay & Albert Y. Kim untuk lebih lanjut.
Sekarang saatnya membuat scatter plot. Apakah Age seorang penumpang berkorelasi dengan Fare yang mereka bayar?
# Scatter plot of Age vs Fare
ggplot(passengers, aes(x = Age, y = Fare)) +
  geom_point()

## Warning: Removed 177 rows containing missing values (geom_point).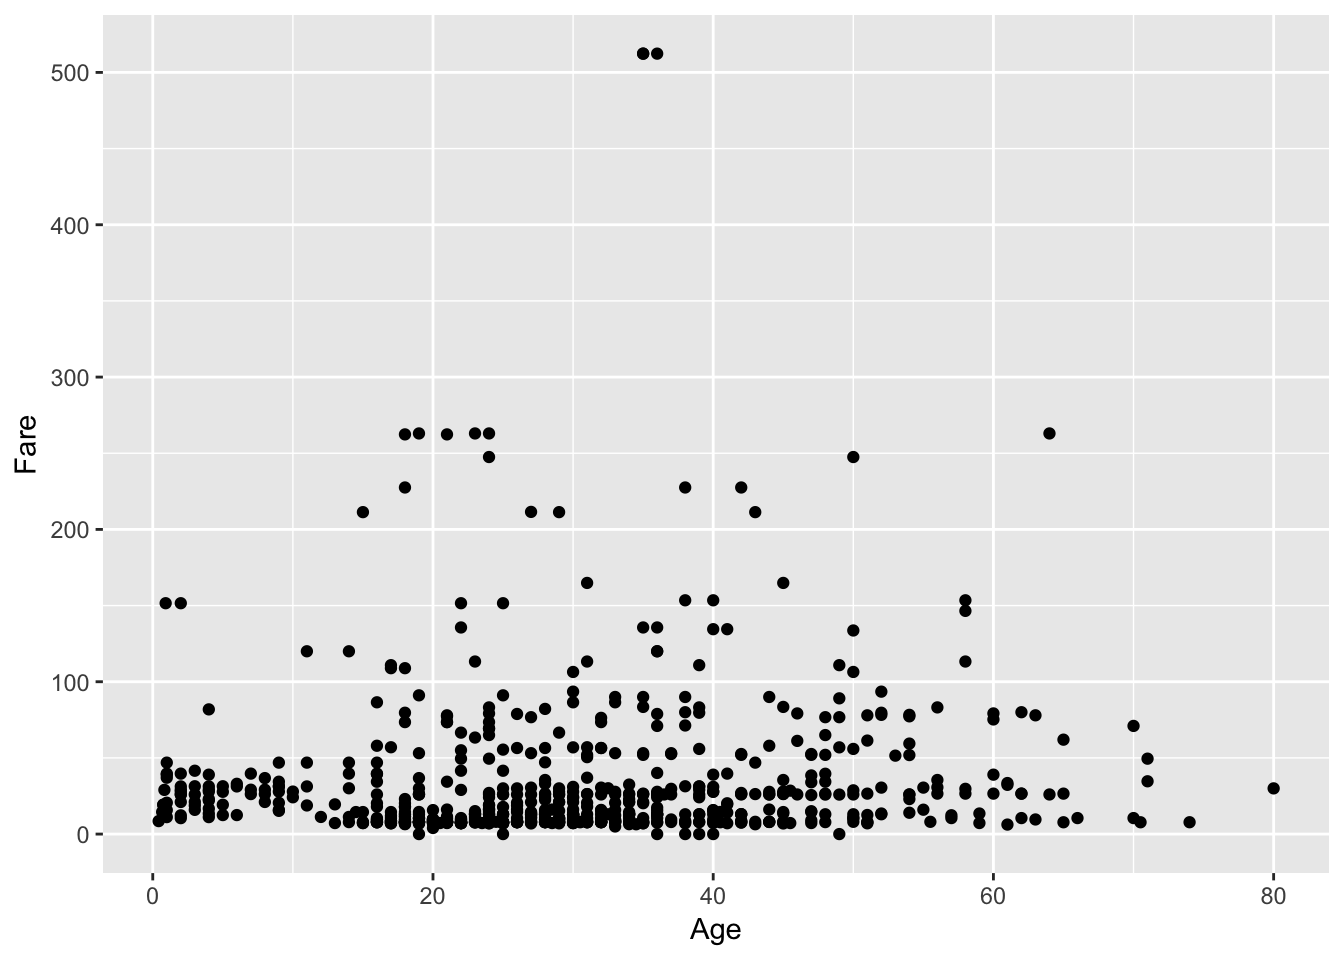
Anda mendapatkan banyak wawasan hanya dari satu plot ini! Anda melihat bahwa banyak orang yang membayar lebih juga berusia jauh lebih tua. Mungkin ada kenaikan tarif menurut usia... Selain itu, Anda langsung melihat dua pencilan di bagian atas plot, yang mungkin ingin Anda selidiki lebih lanjut!
Anda dapat membaca kode ggplot2 seperti kalimat, sama seperti kode dplyr Anda di atas: "Anda mengambil data titanic lalu memetakan Age ke sumbu x dan Fare ke sumbu y, menambahkan titik sebagai layer plot."
Mari ambil plot sebelumnya dan warnai setiap titik berdasarkan Sex, untuk melihat korelasi antara Sex, Age, dan Fare:
# Scatter plot of Age vs Fare colored by Sex
ggplot(passengers %>% drop_na(), aes(x = Age, y = Fare, color = Sex)) +
  geom_point()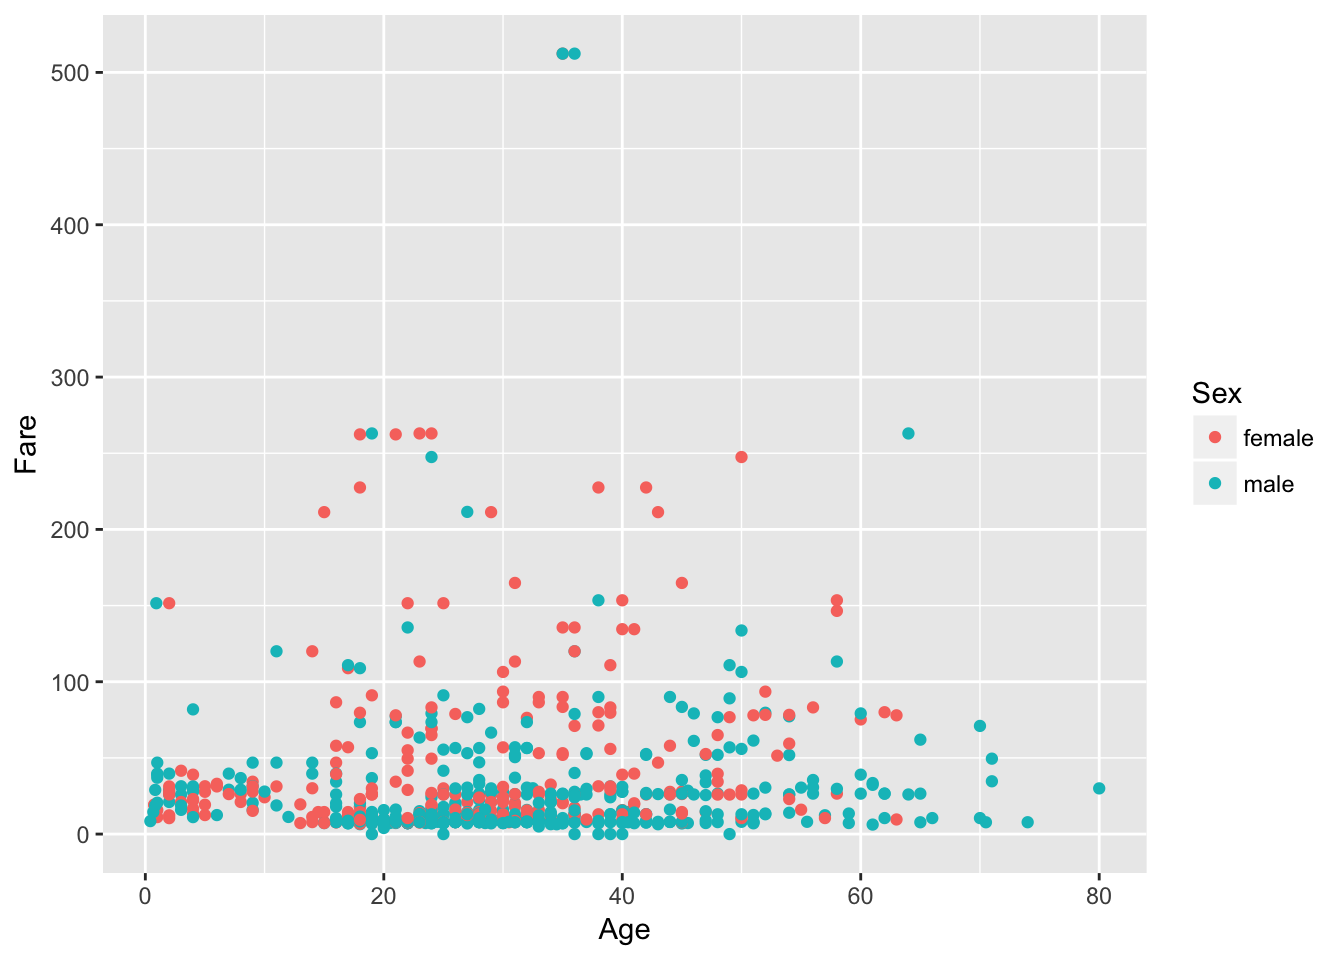
Anda melihat bahwa banyak orang di bagian bawah, yang membayar lebih sedikit, adalah laki-laki. Anda juga memiliki kelompok wanita di bagian atas plot yang sedikit lebih tua dan juga membayar lebih untuk naik ke Titanic.
Memvisualisasikan tiga variabel (dua numerik, Age dan Fare, dan satu kategori, Sex) dalam satu plot cukup keren, tetapi bagaimana jika Anda ingin menambahkan variabel Survived untuk melihat apakah ada tren yang terlihat? Anda dapat melakukannya dengan faceting, yaitu cara menghasilkan beberapa plot sekaligus:
# Scatter plot of Age vs Fare colored by Sex faceted by Survived
ggplot(passengers1, aes(x = Age, y = Fare, color = Sex)) +
  geom_point() +
  facet_grid(~Survived)

## Warning: Removed 177 rows containing missing values (geom_point).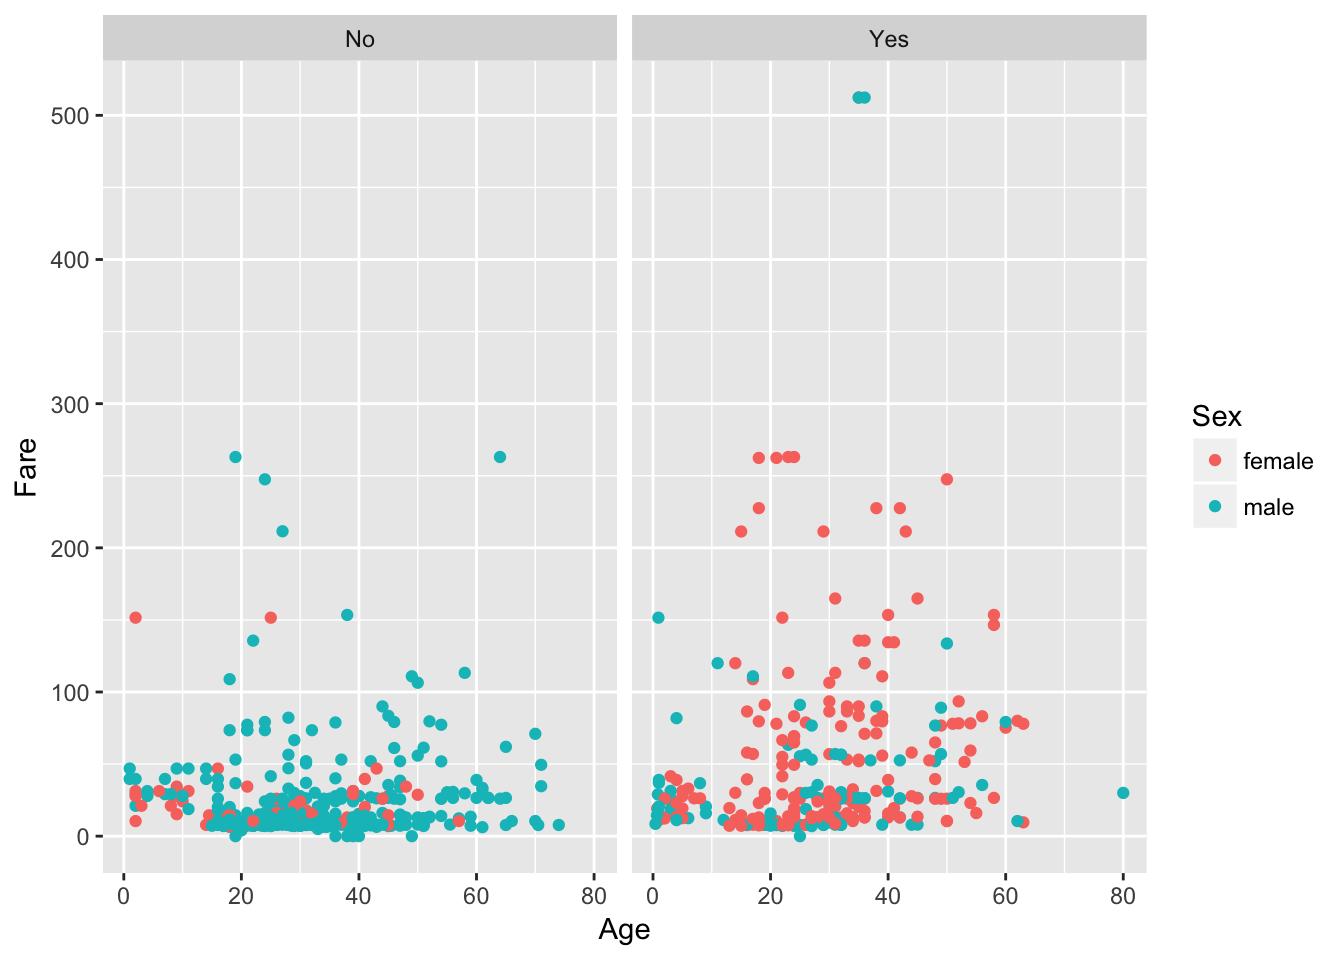
Tiba-tiba, Anda melihat bahwa banyak wanita yang Anda perhatikan di plot sebelumnya ternyata selamat, dan bahwa sebagian besar yang tidak selamat membayar kurang dari 50 unit. Tip: coba cari tahu sendiri satuan mata uangnya!
Sekarang mari kita ulang bar plot untuk Sex penumpang dan kali ini isi batangnya menurut Survived:
# Plot barplot of passenger Sex & fill according to Survival
ggplot(passengers1, aes(x = Sex, fill = Survived)) +
  geom_bar()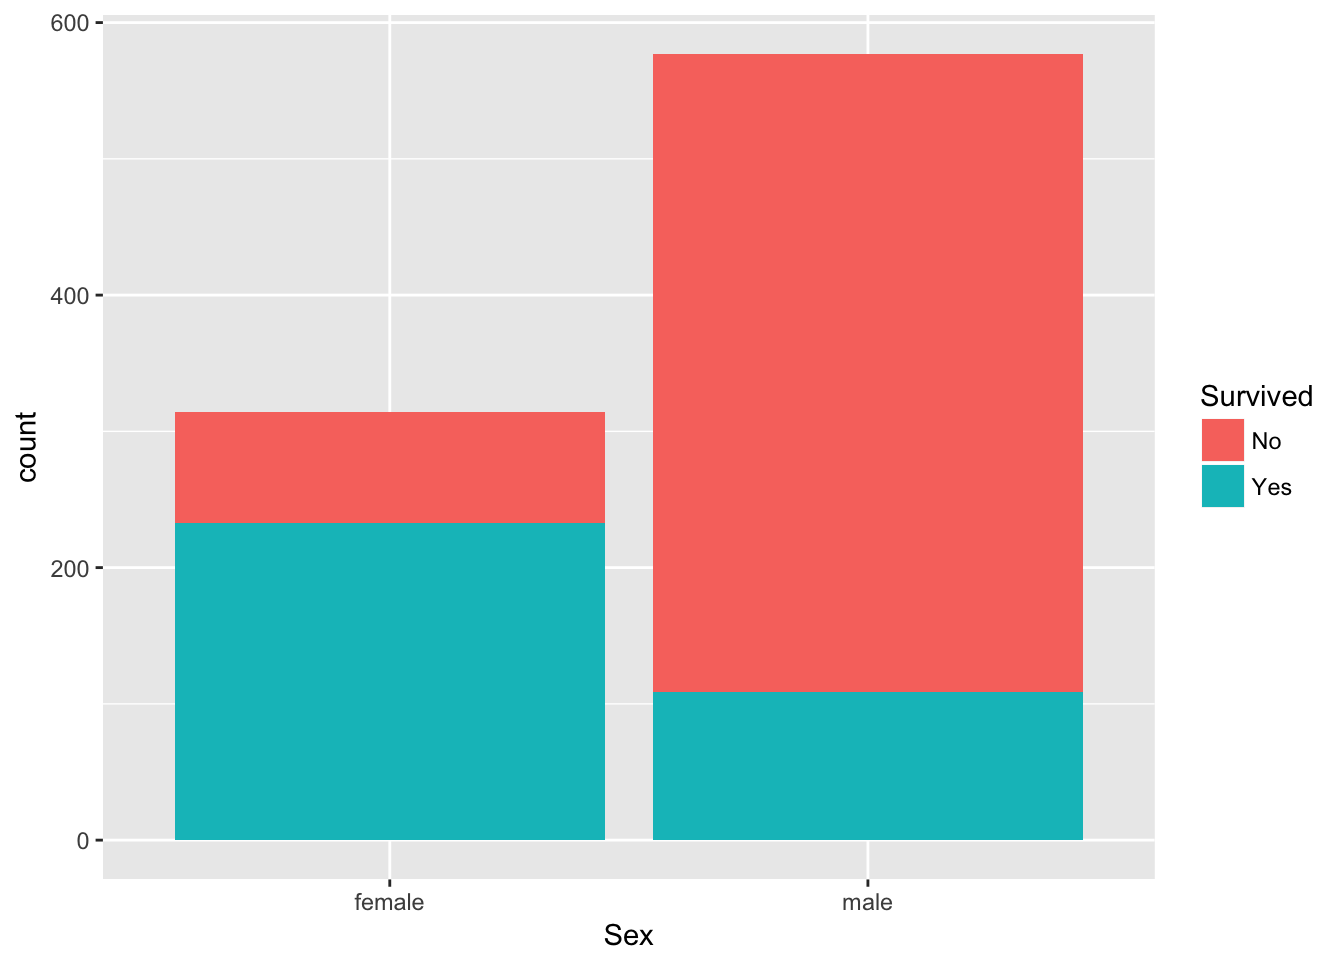
Anda melihat bahwa sebagian besar pria tidak selamat, sedangkan lebih dari dua pertiga wanita selamat!
Gunakan verba summarise() untuk mengetahui rerata tarif yang dibayar:
# Check out mean Fare
passengers %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 32.20421
Gunakan verba summarise() untuk mengetahui median tarif yang dibayar:
# Check out mean Fare
passengers %>%
  summarise(medianFare = median(Fare))

##   medianFare
## 1    14.4542
Anda juga dapat menggunakan verba filter() dan summarise() untuk mengetahui rerata tarif yang dibayar di antara pria:
# Check out mean Fare for men
passengers %>%
  filter(Sex == "male") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 25.52389
Gunakan verba filter() dan summarise() untuk mengetahui rerata tarif yang dibayar di antara wanita:
# Check out mean Fare for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare))

##   meanFare
## 1 44.47982
Gunakan verba filter() dan summarise() untuk mengetahui rerata tarif yang dibayar di antara wanita dan berapa banyak wanita yang selamat:
# Check out mean Fare & number of survivors for women
passengers %>%
  filter(Sex == "female") %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

##   meanFare numSurv
## 1 44.47982     233
Gunakan verba group_by() dan summarise() untuk mencari rerata tarif dan jumlah penyintas sebagai fungsi dari jenis kelamin:
# Check out mean Fare & number of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived))

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <int>
## 1 female     44.5     233
## 2 male       25.5     109
Gunakan verba group_by() dan summarise() untuk mencari rerata tarif dan proporsi penyintas sebagai fungsi dari jenis kelamin:
# Check out mean Fare & proportion of survivors grouped by Sex
passengers %>%
  group_by(Sex) %>%
  summarise(meanFare = mean(Fare), numSurv = sum(Survived)/n())

## # A tibble: 2 x 3
##   Sex    meanFare numSurv
##   <fct>     <dbl>   <dbl>
## 1 female     44.5   0.742
## 2 male 25.5 0.189Dalam tutorial ini, Anda telah beralih dari nol ke satu dengan dasar-dasar analisis data menggunakan tidyverse dan alat-alat rapi. Anda telah belajar bagaimana filter() data Anda, arrange() dan mutate() data tersebut, memplot dan summarise() menggunakan dplyr dan ggplot2, semuanya dengan menulis kode yang mencerminkan cara Anda berpikir dan berbicara tentang data. Selamat. Saya mendorong Anda untuk belajar lebih banyak dengan mengikuti kursus Introduction to Tidyverse oleh David Robinson dan menggunakan alat ini pada dataset lain yang menarik bagi Anda. Bagikan analisis ini kepada kami di twitter @DataCamp dan @hugobowne. Terima kasih telah membaca.
Pelajari lebih lanjut tentang R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



