Curso
Introducción a R
4 h
3.1M
Como científico de datos, tendrás que analizar la distribución de las variables de tu conjunto de datos. Normalmente se hace con histogramas: son muy útiles para ver el rango de valores de una variable, su dispersión y dónde se concentran los valores.
Este tutorial utiliza R. Si aún no dominas R, te recomiendo empezar por el curso gratuito Introduction to R en DataCamp.
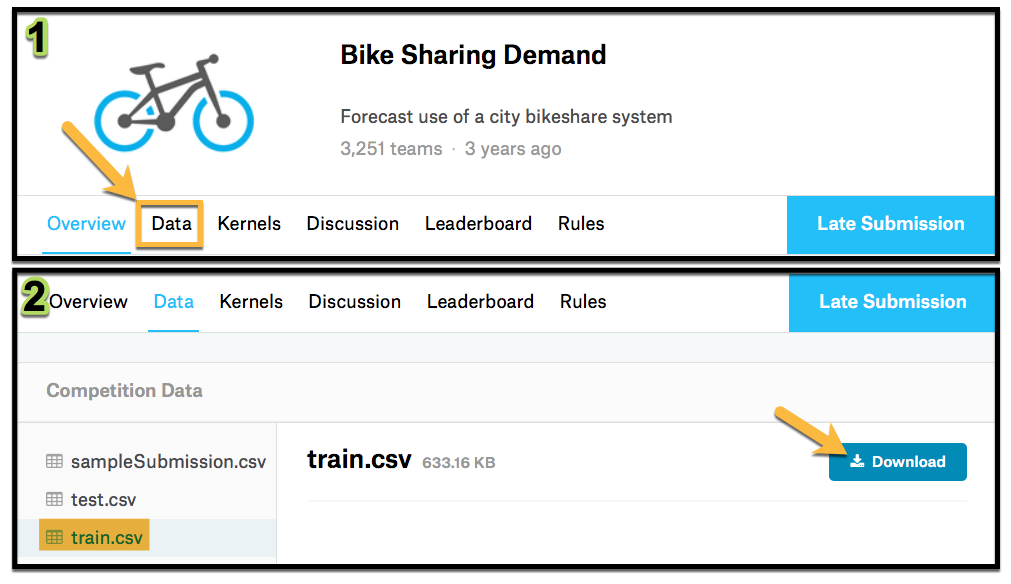
Para este tutorial vas a usar el Bike Sharing Demand Dataset de una competición de Kaggle.
Sigue el enlace y ve a la pestaña de datos; después, descarga el archivo train.csv.
Carga el conjunto de datos en R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Variable | Descripción |
|---|---|
| datetime | fecha y marca temporal por hora |
| season | 1 = primavera 2 = verano 3 = otoño 4 = invierno |
| holiday | si el día se considera festivo |
| workingday | si el día no es fin de semana ni festivo |
| weather | 1: Despejado, pocas nubes, parcialmente nublado 2: Neblina + nublado, neblina + nubes fragmentadas, neblina + pocas nubes, neblina 3: Nieve ligera, lluvia ligera + tormenta + nubes dispersas, lluvia ligera + nubes dispersas 4: Lluvia intensa + granizo + tormenta + neblina, nieve + niebla |
| temp | temperatura en grados Celsius |
| atemp | temperatura "sensación térmica" en grados Celsius |
| humidity | humedad relativa |
| windspeed | velocidad del viento |
| casual | número de alquileres iniciados por usuarios no registrados |
| registered | número de alquileres iniciados por usuarios registrados |
| count | número total de alquileres |
Vas a analizar la relación entre atemp y humidity por season, así que selecciónalas del conjunto de datos. Recuerda cargar el paquete dplyr.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Bien, ya puedes empezar a analizar los datos. Empieza por crear un histograma para cada variable por estación. Lo harás con la librería ggplot2, así que no te olvides de cargarla.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)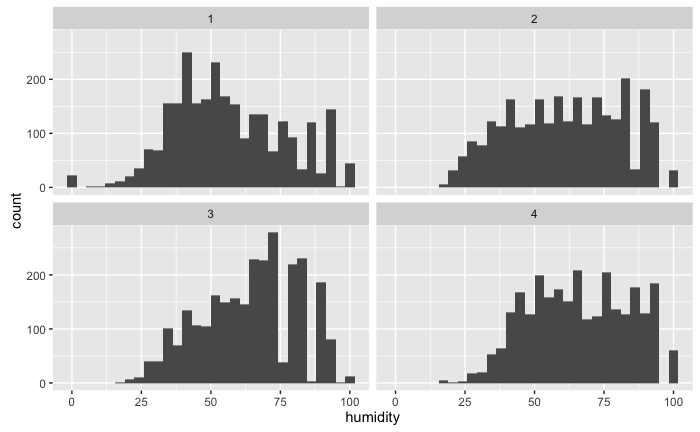
Con el histograma ves que la humedad es mayor en invierno (algo lógico), pero también te haces una idea de cómo se distribuye en cada estación.
Ahora añade la densidad, un rug de densidad y cambia los nombres de los faceted para mejorar la visualización.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")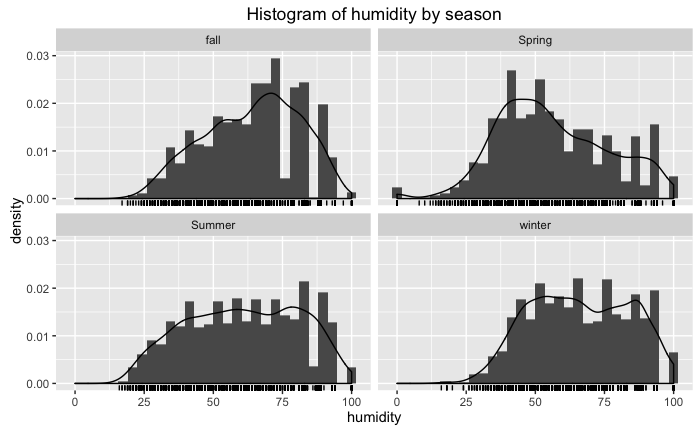
Ahora ya tienes una mejor idea de cómo se comporta la humedad. Haz lo mismo con atemp.
Reutiliza el código anterior y cambia la variable a atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")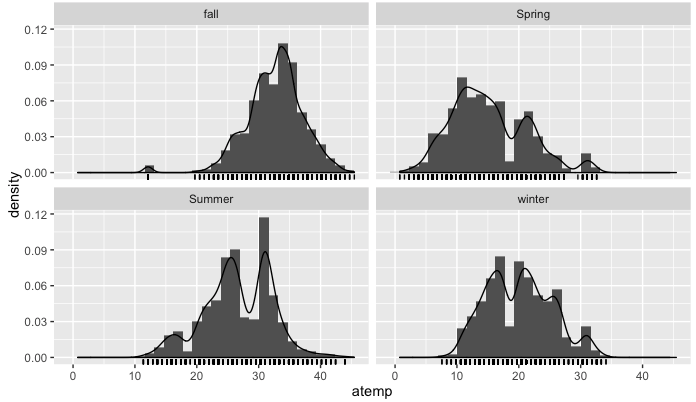
Bien, hasta aquí todo encaja con lo que esperarías en cada estación. En cada gráfico tienes una aproximación de la función de densidad de probabilidad.
Pero con estos gráficos es difícil ver cómo interactúan las variables entre sí. El primer problema es que tu histograma tendría que ser 3D, porque intentas encontrar la función de distribución para dos variables.
El objetivo es visualizar la distribución bivariante; para lograrlo primero debes ajustar una distribución bivariante a los datos. Lo harás con la librería MASS y la función kde2d. La función kde2d estima la distribución bivariante asumiendo normalidad para las variables aleatorias. Sus argumentos son los siguientes:
| entrada | descripción |
|---|---|
| x | datos de la coordenada x |
| y | datos de la coordenada y |
| n | número de puntos de malla por eje |
| lims | límites para x e y |
Ahora aplícalo al conjunto de datos filtrando por verano,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Nota: Al cargar la librería MASS, viene con una función
select. Esto entra en conflicto con la funciónselectde dplyr. Para evitarlo, cuando usesselectde dplyr añadedplyr::, es decir,dplyr::select(), para que funcione correctamente.
Ahora mira la clase y la estructura de bike_density
class(bike_density)
str(bike_density)
Es una lista con 3 valores: x, y y z. Los dos primeros contienen los valores de las variables y el tercero es una matriz con los valores de la fdp. Échale un vistazo a la densidad con la función contour:
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)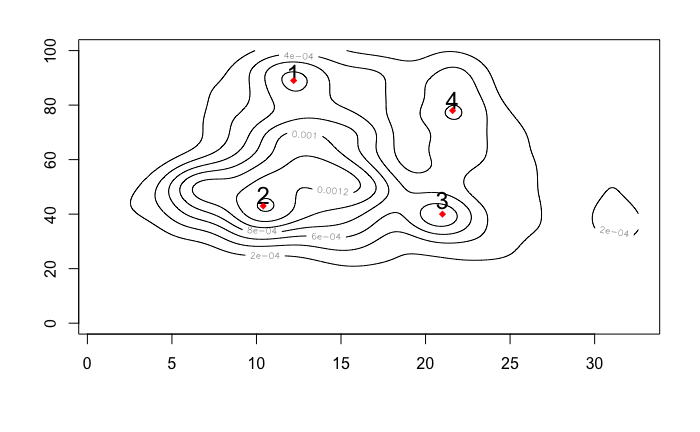
Al observarlo puedes identificar algunos puntos de acumulación, que se pueden entender como los valores más frecuentes para la combinación de ambas variables. Los valores de cada punto se resumen en la siguiente tabla:
| punto | atemp (°C) | humedad (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Para crear tu mapa de calor primero define la escala de colores que quieres usar; puedes hacerlo con la función colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale es un vector que va de negro a rojo usando códigos RGB en 1000 pasos.
Ahora dibuja el mapa de calor con la función image, que se utiliza para representar matrices.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
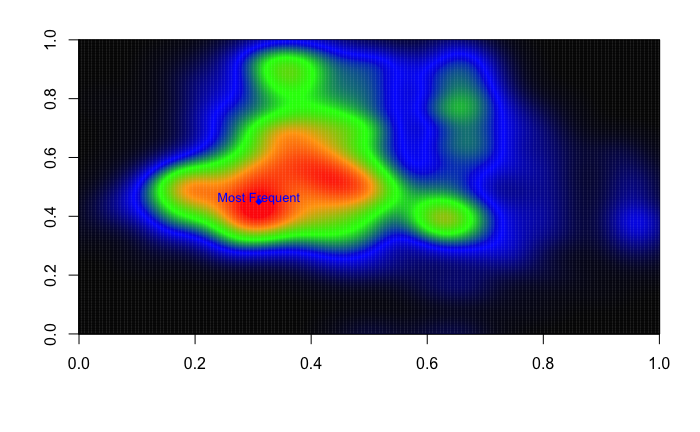
Como ves, esto aporta más información que el gráfico de contorno, porque ahora los colores indican cuán alto es el punto de acumulación. Puedes ver que los valores más frecuentes de humedad y atemp durante la primavera están alrededor del punto (10.4, 43).
Ya sabes crear un mapa de calor; ahora te toca a ti crear el tuyo. Empieza mirando las demás estaciones y su relación con otras variables.
Piénsalo: ¿cómo podrías usar esto para estimar cuántas bicicletas deberías ofrecer para distintos valores de las variables, sabiendo que los puntos más frecuentes tienen mayor probabilidad?
Si quieres seguir aprendiendo a crear visualizaciones con ggplot, echa un vistazo a nuestro curso Data Visualization with ggplot2.
Aprende más sobre R
Curso
Curso
Curso
Tutorial
Zoumana Keita
9 min
Tutorial
Łukasz Deryło
10 min
Tutorial
Kevin Babitz
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Eladio Montero Porras
15 min
Tutorial