Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Là một nhà khoa học dữ liệu, bạn sẽ cần phân tích phân phối của các đặc trưng trong tập dữ liệu của mình. Thông thường, điều này được thực hiện bằng biểu đồ tần suất (histogram); cách này rất hữu ích để thể hiện miền giá trị của biến, độ lệch và nơi các giá trị tập trung.
Hướng dẫn này sử dụng R. Nếu bạn chưa quen với R, tôi gợi ý bạn học khóa Introduction to R miễn phí trên DataCamp.
Trong hướng dẫn này, bạn sẽ sử dụng Bộ dữ liệu Bike Sharing Demand từ một cuộc thi trên kaggle.
Truy cập liên kết và vào thẻ dữ liệu, sau đó tải tệp train.csv.
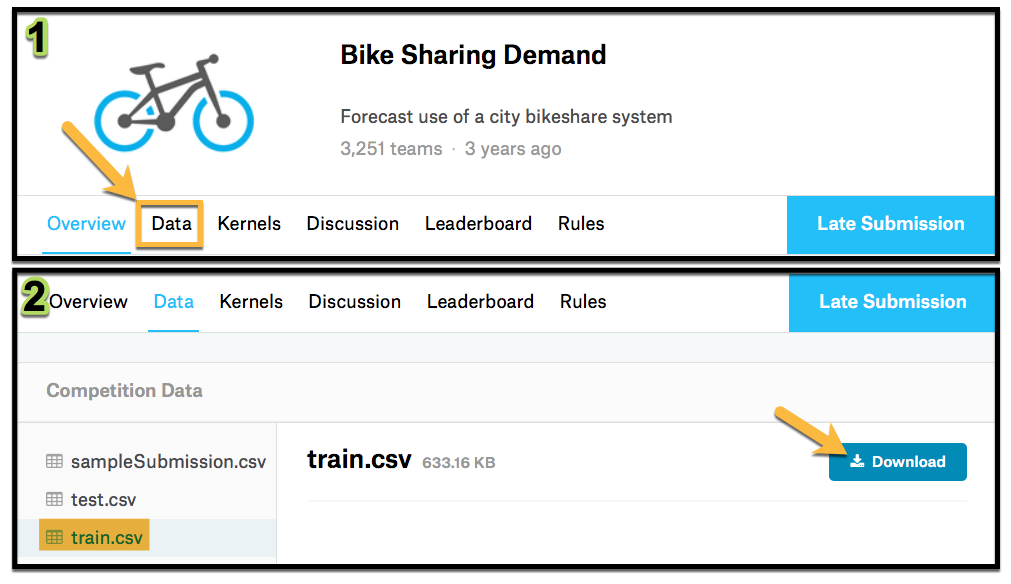
Nạp bộ dữ liệu vào R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Đặc trưng | Mô tả |
|---|---|
| datetime | ngày theo giờ + dấu thời gian |
| season | 1 = xuân 2 = hạ 3 = thu 4 = đông |
| holiday | ngày đó có được coi là ngày nghỉ lễ hay không |
| workingday | ngày đó không phải cuối tuần cũng không phải ngày nghỉ lễ |
| weather | 1: Quang mây, Ít mây, Có mây từng phần, Có mây từng phần 2: Sương mù + Nhiều mây, Sương mù + Mây đứt quãng, Sương mù + Ít mây, Sương mù 3: Tuyết nhẹ, Mưa nhẹ + Dông + Mây rải rác, Mưa nhẹ + Mây rải rác 4: Mưa to + Mưa đá + Dông + Sương mù, Tuyết + Sương mù |
| temp | nhiệt độ theo độ C |
| atemp | nhiệt độ "cảm nhận" theo độ C |
| humidity | độ ẩm tương đối |
| windspeed | tốc độ gió |
| casual | số lượt thuê từ người dùng chưa đăng ký |
| registered | số lượt thuê từ người dùng đã đăng ký |
| count | tổng số lượt thuê |
Bạn sẽ phân tích mối quan hệ giữa atemp và humidity theo season, vì vậy hãy chọn chúng từ bộ dữ liệu. Nhớ nạp gói dplyr.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Được rồi, giờ bạn đã sẵn sàng để bắt đầu phân tích dữ liệu. Hãy bắt đầu bằng cách tạo biểu đồ tần suất cho từng đặc trưng theo mùa. Bạn sẽ làm điều này bằng thư viện ggplot2 nên đừng quên nạp nó.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)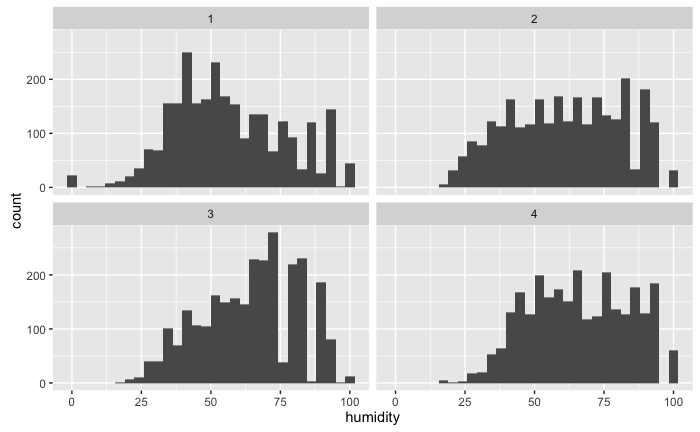
Với biểu đồ tần suất, bạn có thể thấy độ ẩm cao hơn vào mùa đông (điều này là hiển nhiên) nhưng đồng thời có được cảm nhận về cách nó phân bố trong từng mùa.
Bây giờ hãy thêm mật độ, thêm density rug và đổi tên các ô facet để hình ảnh trực quan trông đẹp hơn.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")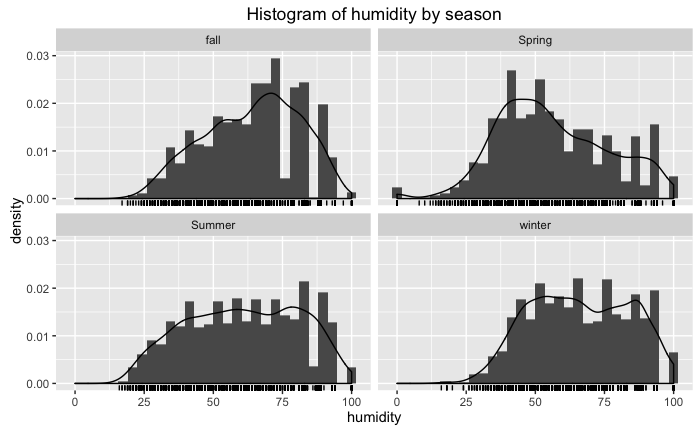
Giờ đây, bạn có cảm nhận tốt hơn về cách độ ẩm biến thiên; hãy làm tương tự với atemp.
Tái sử dụng đoạn mã trên và đổi biến thành atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")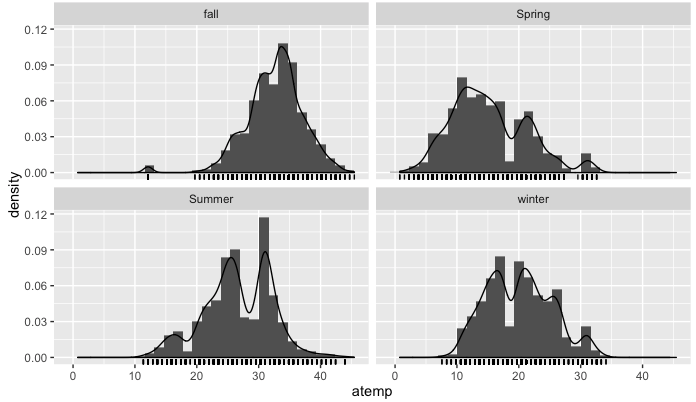
Ổn, đến đây mọi thứ diễn ra đúng như bạn kỳ vọng cho từng mùa. Trong mỗi biểu đồ, bạn có một xấp xỉ của hàm mật độ xác suất.
Nhưng dựa trên các biểu đồ này thì khó hình dung các đặc trưng tương tác với nhau như thế nào. Khó khăn đầu tiên là biểu đồ tần suất của bạn cần ở dạng 3D vì bạn đang cố tìm hàm phân phối cho hai đặc trưng.
Mục tiêu là trực quan hóa phân phối hai biến; để làm được điều này, trước tiên bạn cần khớp một phân phối hai biến cho dữ liệu. Việc này sẽ được thực hiện bằng thư viện MASS và hàm kde2d. Hàm kde2d sẽ ước lượng phân phối hai biến, giả định tính chuẩn cho các biến ngẫu nhiên. Các tham số đầu vào của hàm này như sau,
| đầu vào | mô tả |
|---|---|
| x | dữ liệu tọa độ x |
| y | dữ liệu tọa độ y |
| n | số điểm lưới cho mỗi trục |
| lims | giới hạn cho x và y |
Bây giờ áp dụng nó cho bộ dữ liệu, lọc theo mùa hè,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Lưu ý: Khi nạp thư viện MASS, nó đi kèm một hàm
select; điều này sẽ xung đột với hàmselectcủa dplyr, nên để khắc phục, khi dùngselectcủa dplyr bạn cần thêm tiền tốdplyr::nhưdplyr::select()để hoạt động đúng.
Bây giờ hãy xem lớp (class) và cấu trúc của bike_density
class(bike_density)
str(bike_density)
Đây là một list gồm 3 giá trị x, y và z. Hai giá trị đầu chứa các giá trị của đặc trưng và giá trị thứ ba là một ma trận với giá trị của pdf. Hãy xem mật độ bằng hàm contour,
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)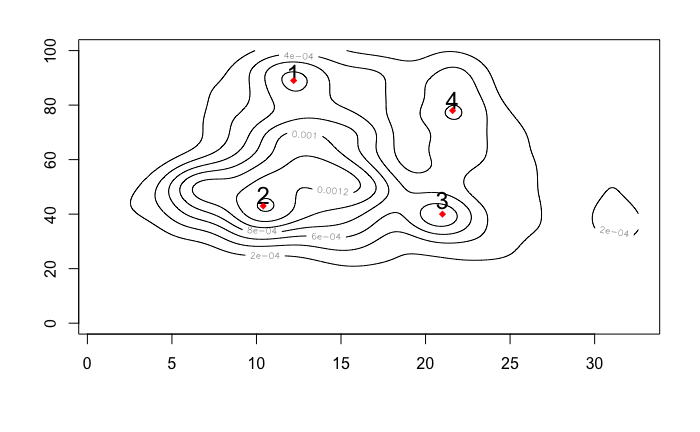
Nhìn vào đây bạn có thể nhận diện một số điểm tích tụ, có thể hiểu là các giá trị xuất hiện thường xuyên nhất cho tổ hợp của hai đặc trưng. Các giá trị cho mỗi điểm được tóm tắt trong bảng sau,
| điểm | atemp (°C) | hummidity (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Để tạo heatmap, trước hết bạn cần xác định thang màu muốn dùng; bạn có thể làm điều này bằng hàm colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale là một vector chuyển từ đen sang đỏ bằng mã RGB trong 1000 bước.
Bây giờ vẽ heat map của bạn bằng hàm image; hàm này dùng để vẽ các ma trận.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
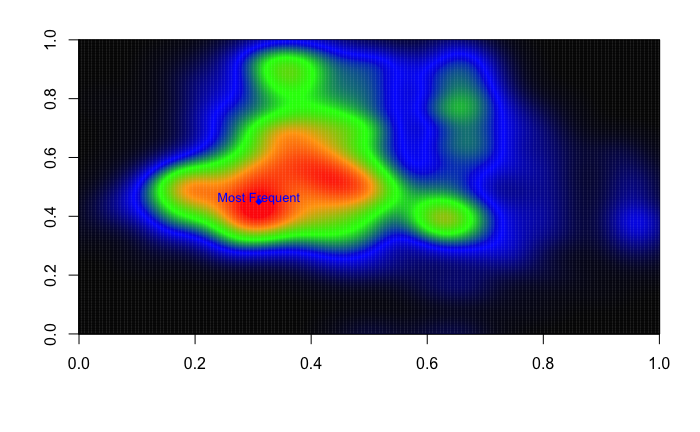
Như bạn thấy, điều này chứa nhiều thông tin hơn biểu đồ đường đồng mức (contour) vì giờ màu sắc cho biết mức độ cao thấp của điểm tích tụ. Bạn có thể thấy các giá trị xuất hiện thường xuyên nhất của độ ẩm và atemp trong mùa xuân nằm quanh điểm $(10.4,43)$
Giờ bạn đã biết cách tạo heat map, đến lượt bạn tự thực hành. Hãy bắt đầu bằng cách xem các mùa khác và mối liên hệ với các biến khác.
Hãy nghĩ về cách bạn có thể dùng điều này để rút ra insight về số lượng xe đạp cần cung cấp cho các giá trị khác nhau của biến, dựa trên thực tế rằng các điểm xuất hiện thường xuyên hơn có xác suất cao hơn.
Nếu bạn muốn tìm hiểu thêm về tạo trực quan hóa dữ liệu với ggplot, đừng quên xem khóa học Data Visualization with ggplot2 của chúng tôi.
Tìm hiểu thêm về R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
