Curso
Introdução ao R
4 h
3.1M
Como cientista de dados, você vai precisar analisar a distribuição das variáveis do seu conjunto de dados. Normalmente, isso é feito com histogramas — ótimo para mostrar a faixa de valores da variável, sua dispersão e onde os valores se concentram.
Este tutorial usa R. Se você ainda não está familiarizado com R, recomendo fazer nosso curso gratuito Introduction to R na DataCamp.
Para este tutorial, você vai usar o Bike Sharing Demand Dataset de uma competição do Kaggle.
Siga o link, vá até a aba de dados e baixe o arquivo train.csv.
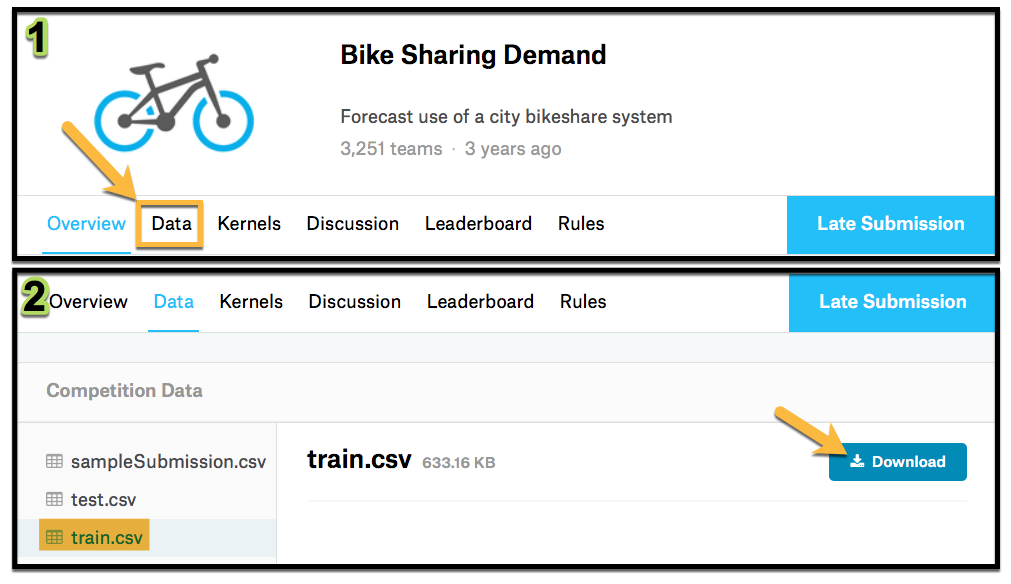
Carregue o dataset no R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Variável | Descrição |
|---|---|
| datetime | data + horário por hora (timestamp) |
| season | 1 = primavera 2 = verão 3 = outono 4 = inverno |
| holiday | indica se o dia é considerado feriado |
| workingday | indica se o dia não é fim de semana nem feriado |
| weather | 1: limpo, poucas nuvens, parcialmente nublado 2: névoa + nublado, névoa + nuvens dispersas, névoa + poucas nuvens, névoa 3: neve fraca, garoa/chuva fraca + trovoadas + nuvens dispersas, chuva fraca + nuvens dispersas 4: chuva forte + granizo + trovoadas + névoa, neve + neblina |
| temp | temperatura em Celsius |
| atemp | temperatura de sensação térmica em Celsius |
| humidity | umidade relativa |
| windspeed | velocidade do vento |
| casual | número de locações iniciadas por usuários não registrados |
| registered | número de locações iniciadas por usuários registrados |
| count | número total de locações |
Você vai analisar a relação entre atemp e humidity por season, então selecione essas colunas do dataset. Lembre de carregar o pacote dplyr.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Beleza, agora você está pronto para começar a análise. Comece criando um histograma para cada variável por estação. Vamos usar a biblioteca ggplot2, então não esqueça de carregá-la.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)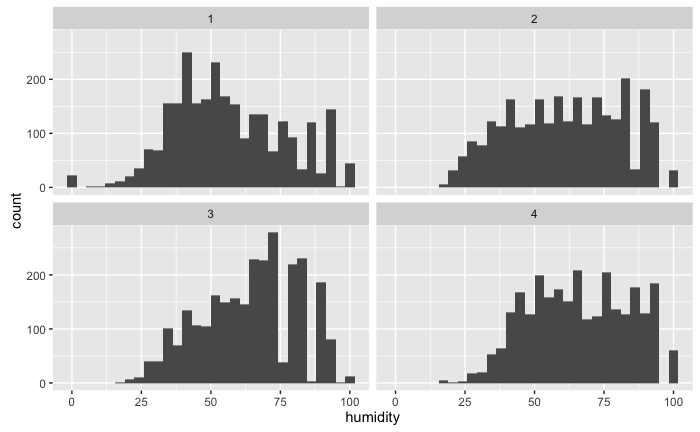
Com o histograma, dá para ver que há umidade mais alta no inverno (o que faz sentido), e você tem uma noção de como ela se distribui em cada estação.
Agora adicione a densidade, um rug de densidade e troque os nomes dos facets para deixar a visualização mais agradável.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")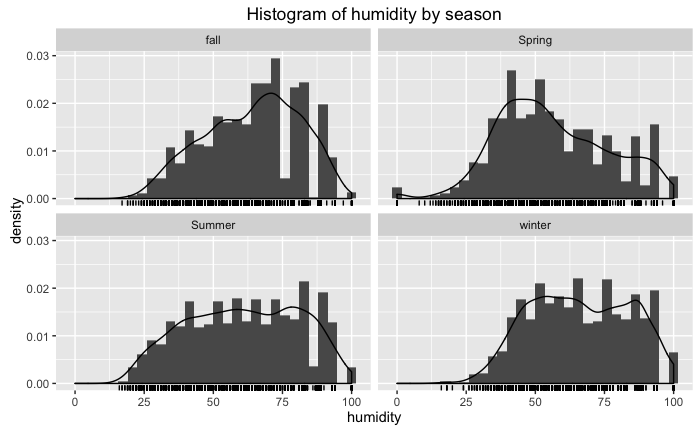
Agora dá para sentir melhor como a umidade se comporta. Faça o mesmo com atemp.
Reaproveite o código acima e troque a variável para atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")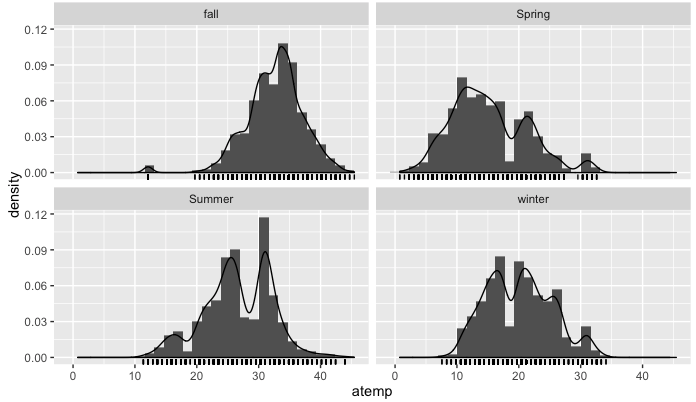
Até aqui, tudo certo — os resultados batem com o esperado para cada estação. Em cada gráfico, você tem uma aproximação da função de distribuição de probabilidade.
Mas é difícil, com base nesses gráficos, visualizar como as variáveis interagem entre si. O primeiro desafio é que seu histograma precisaria ser em 3D, já que você quer encontrar a função de distribuição para as duas variáveis ao mesmo tempo.
O objetivo é visualizar a distribuição bivariada. Para isso, primeiro é preciso ajustá-la aos dados. Vamos usar a biblioteca MASS e a função kde2d. A kde2d estima a distribuição bivariada, assumindo normalidade para as variáveis aleatórias. As entradas da função são:
| entrada | descrição |
|---|---|
| x | dados da coordenada x |
| y | dados da coordenada y |
| n | número de pontos da grade para cada eixo |
| lims | limites de x e y |
Agora aplique ao dataset filtrando para o verão,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Observação: ao carregar a biblioteca MASS, ela vem com uma função
select, o que conflita com aselectdo dplyr. Para resolver, quando usar aselectdo dplyr, adicionedplyr::, assim:dplyr::select(), para funcionar corretamente.
Agora veja a classe e a estrutura de bike_density
class(bike_density)
str(bike_density)
É uma lista com 3 valores: x, y e z. Os dois primeiros trazem os valores das variáveis e o terceiro é uma matriz com os valores da fdp. Dê uma olhada na densidade usando a função contour:
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)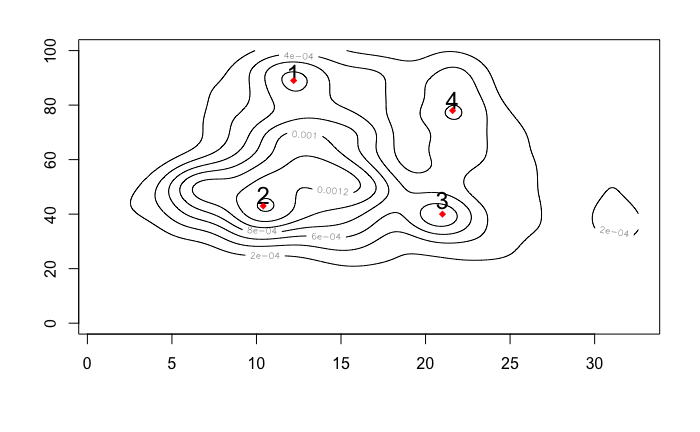
Observando o gráfico, dá para identificar alguns pontos de acúmulo, que podem ser entendidos como os valores mais frequentes para a combinação das duas variáveis. Os valores de cada ponto estão resumidos na tabela a seguir:
| ponto | atemp (°C) | umidade (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Para criar seu heatmap, primeiro defina a escala de cores que você quer usar. Você pode fazer isso com a função colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale é um vetor que vai do preto ao vermelho usando código RGB em 1000 passos.
Agora plote seu heatmap usando a função image, que é usada para plotar matrizes.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
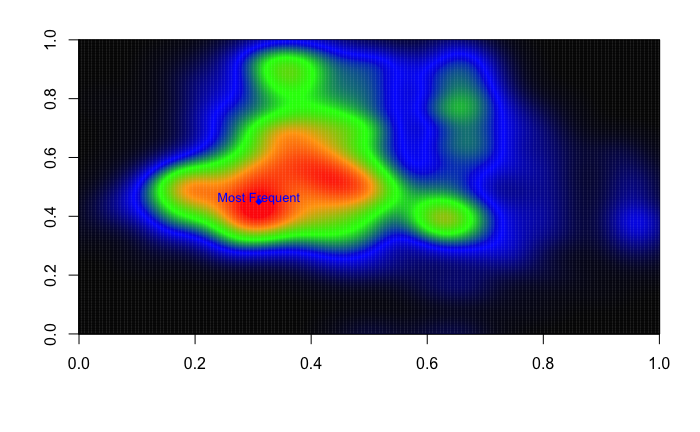
Como você pode ver, isso traz mais informação do que o gráfico de contorno, porque agora as cores indicam a intensidade dos pontos de acúmulo. Dá para ver que os valores mais frequentes de umidade e atemp durante a primavera ficam por volta do ponto (10,4; 43).
Agora que você sabe criar um heatmap, é sua vez de colocar em prática. Comece olhando para as outras estações e a relação com as demais variáveis.
Pense em como usar isso para estimar quantas bicicletas você deve disponibilizar para diferentes valores das variáveis, considerando que os pontos mais frequentes têm maior probabilidade.
Se quiser aprender mais sobre visualização de dados com ggplot, confira nosso curso Data Visualization with ggplot2.
Saiba mais sobre R
Curso
Curso
Curso
blog
Arun Nanda
15 min
Tutorial
Kevin Babitz
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Aditya Sharma
8 min
Tutorial
Tutorial
Somil Asthana
11 min