{count, plural, one {कोर्स} other {कोर्स}}
R परिचय
{hours} घंटा
3.1M
एक डेटा वैज्ञानिक के रूप में, आपको अपने डेटासेट में फीचर्स के वितरण का विश्लेषण करना होगा। आम तौर पर यह हिस्टोग्राम्स के माध्यम से किया जाता है; यह वैरिएबल के मान दायरे, उनके विचलन और जहाँ मान सघन हैं, दिखाने में बहुत उपयोगी है।
यह ट्यूटोरियल R का उपयोग करता है। यदि आप अभी R से परिचित नहीं हैं, तो मैं सुझाव दूंगा कि आप DataCamp पर हमारा निःशुल्क Introduction to R कोर्स करें।
इस ट्यूटोरियल के लिए, आप kaggle प्रतियोगिता के Bike Sharing Demand Dataset का उपयोग करेंगे।
लिंक फॉलो करें और डेटा टैब पर जाएँ, फिर train.csv फ़ाइल डाउनलोड करें।
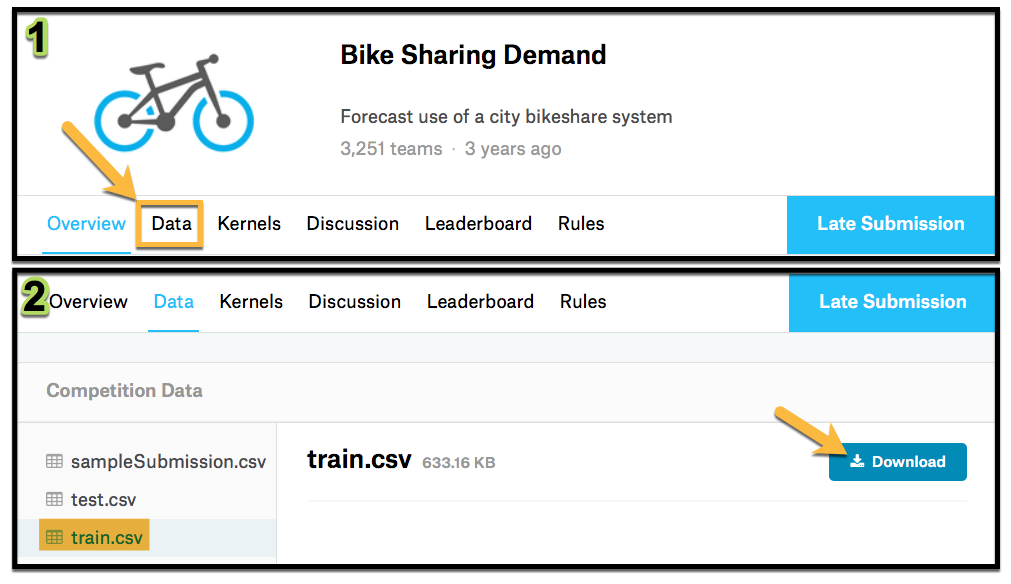
डेटासेट को R में लोड करें।
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| फीचर | वर्णन |
|---|---|
| datetime | घंटे के स्तर की दिनांक + टाइमस्टैम्प |
| season | 1 = वसंत 2 = ग्रीष्म 3 = पतझड़ 4 = शीत |
| holiday | क्या दिन अवकाश माना गया है |
| workingday | क्या दिन न तो सप्ताहांत है न ही अवकाश |
| weather | 1: साफ, हल्के बादल, आंशिक बादल, आंशिक बादल 2: धुंध + बादल, धुंध + बिखरे बादल, धुंध + हल्के बादल, धुंध 3: हल्की बर्फ, हल्की बारिश + गरज के साथ बिखरे बादल, हल्की बारिश + बिखरे बादल 4: तेज बारिश + बर्फ की गोलियां + गरज + धुंध, बर्फ + कुहासा |
| temp | सेल्सियस में तापमान |
| atemp | "महसूस होने वाला" तापमान (सेल्सियस) |
| humidity | सापेक्ष आर्द्रता |
| windspeed | पवन वेग |
| casual | गैर-पंजीकृत उपयोगकर्ताओं द्वारा आरंभ की गई किरायों की संख्या |
| registered | पंजीकृत उपयोगकर्ताओं द्वारा आरंभ की गई किरायों की संख्या |
| count | कुल किरायों की संख्या |
आप season के अनुसार atemp और humidity के बीच संबंध का विश्लेषण करने जा रहे हैं, इसलिए इन्हें डेटासेट से चुनें। dplyr पैकेज लोड करना न भूलें।
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)ठीक है, अब आप डेटा का विश्लेषण शुरू करने के लिए तैयार हैं। ggplot2 लाइब्रेरी का उपयोग करते हुए, प्रत्येक फीचर के लिए मौसम के अनुसार हिस्टोग्राम बनाएँ। इसे लोड करना न भूलें।
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)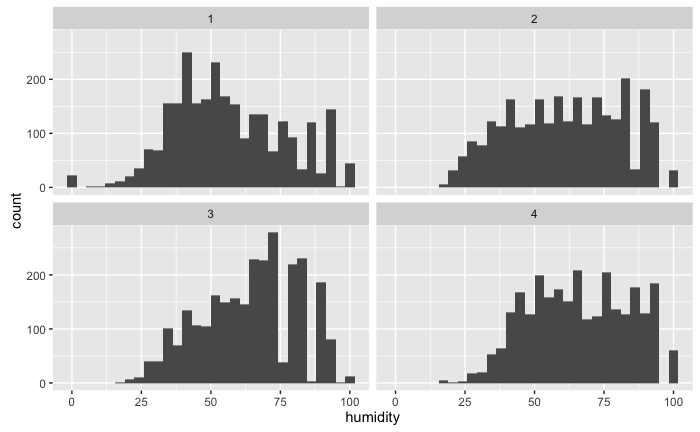
हिस्टोग्राम से आप देख सकते हैं कि सर्दियों के दौरान आर्द्रता अधिक होती है (जो स्वाभाविक है), और यह भी समझ आता है कि प्रत्येक मौसम में यह कैसे वितरित है।
अब डेंसिटी, एक डेंसिटी रग जोड़ें और फेसेट्स के नाम बदलें, ताकि विज़ुअलाइज़ेशन और बेहतर दिखे।
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")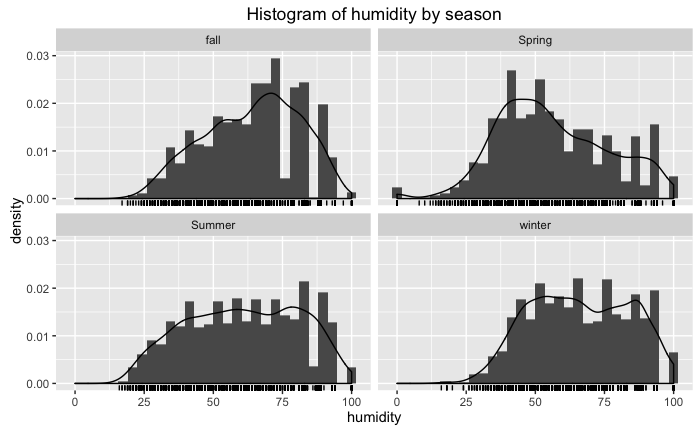
अब आपको आर्द्रता के व्यवहार का बेहतर अहसास मिलता है; यही काम atemp के साथ करें।
ऊपर के कोड का पुन: उपयोग करें और वैरिएबल को atemp में बदलें,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")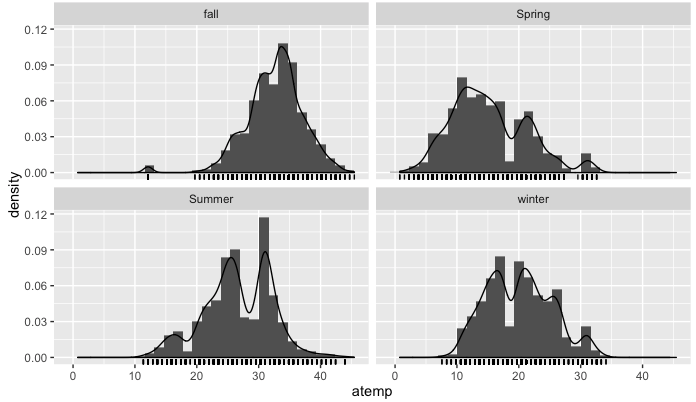
ठीक है, अब तक सब अच्छा है—हर मौसम के लिए सब कुछ अपेक्षा के अनुरूप दिख रहा है। प्रत्येक ग्राफ में आपके पास प्रायिकता वितरण फ़ंक्शन का एक अनुमान है।
लेकिन इन ग्राफ़्स के आधार पर यह देखना कठिन है कि फीचर्स एक-दूसरे के साथ कैसे इंटरेक्ट करते हैं। पहली मुश्किल यह है कि आपको 3D हिस्टोग्राम चाहिए, क्योंकि आप दो फीचर्स के लिए वितरण फ़ंक्शन ढूंढने की कोशिश कर रहे हैं।
लक्ष्य द्विवेरी वितरण का विज़ुअलाइज़ेशन करना है। ऐसा करने के लिए, पहले आपको डेटा पर द्विवेरी वितरण फिट करना होगा। यह MASS लाइब्रेरी और kde2d फ़ंक्शन का उपयोग करके किया जाएगा। kde2d फ़ंक्शन, यादृच्छिक चरों के लिए नार्मलिटी मानते हुए, द्विवेरी वितरण का अनुमान लगाएगा। इस फ़ंक्शन के इनपुट इस प्रकार हैं,
| इनपुट | वर्णन |
|---|---|
| x | x निर्देशांक डेटा |
| y | y निर्देशांक डेटा |
| n | प्रत्येक अक्ष के लिए ग्रिड पॉइंट्स की संख्या |
| lims | x और y के लिए सीमाएँ |
अब इसे डेटासेट पर लागू करें और summer के लिए फ़िल्टर करें,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
नोट: MASS लाइब्रेरी लोड करने पर इसके साथ एक
selectफ़ंक्शन आता है, जो dplyr केselectफ़ंक्शन से टकरा सकता है। इसे ठीक करने के लिए, dplyr काselectउपयोग करते समय उसमेंdplyr::जोड़ें, जैसेdplyr::select(), ताकि यह सही से काम करे।
अब bike_density की class और structure देखें
class(bike_density)
str(bike_density)
यह एक सूची (list) है जिसमें 3 मान x, y, और z हैं। पहले दो में फीचर्स के मान होते हैं और तीसरा एक मैट्रिक्स है जिसमें pdf का मान होता है। contour फ़ंक्शन का उपयोग करके डेंसिटी पर नज़र डालें,
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)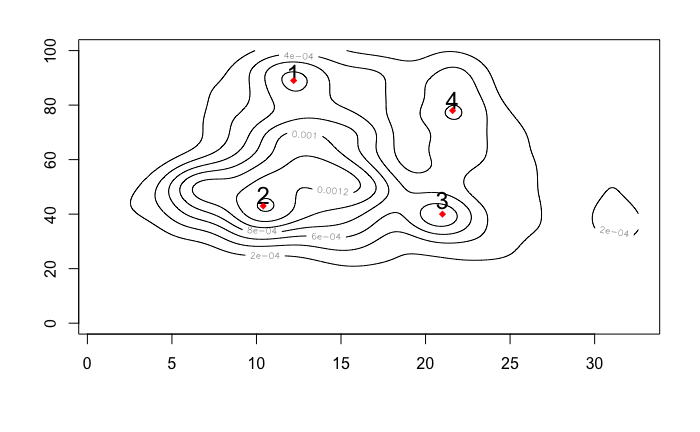
इसे देखते हुए आप कुछ संचित (accumulation) बिंदुओं की पहचान कर सकते हैं, जिन्हें दो फीचर्स के संयोजन के सबसे आवृत्त मानों के रूप में समझा जा सकता है। प्रत्येक बिंदु के मान निम्न तालिका में संक्षेपित हैं,
| बिंदु | atemp (°C) | humidity (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
अपना हीटमैप बनाने के लिए, पहले आपको वह रंग स्केल परिभाषित करना होगा जिसका आप उपयोग करना चाहते हैं; आप यह colorRampPalette फ़ंक्शन का उपयोग करके कर सकते हैं
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale एक वेक्टर है जो काले से लाल तक 1000 चरणों में RGB कोड का उपयोग करता है।
अब image फ़ंक्शन का उपयोग करके अपना हीटमैप प्लॉट करें; यह फ़ंक्शन मैट्रिक्स प्लॉट करने के लिए उपयोग होता है।
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
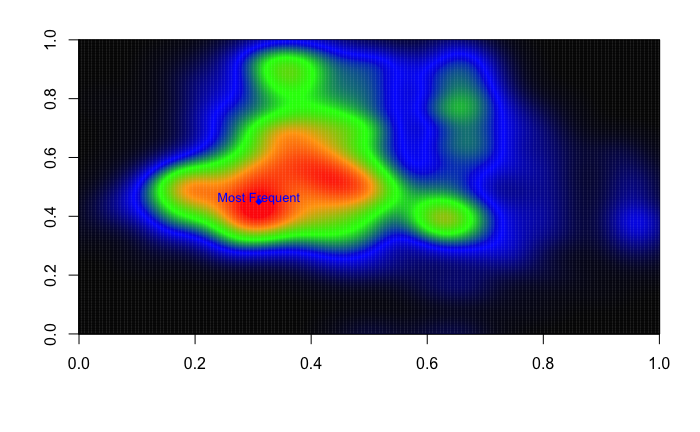
अब, जैसा कि आप देख सकते हैं, इसमें कंटूर प्लॉट से अधिक जानकारी है क्योंकि अब रंग यह बताते हैं कि संचित बिंदु कितना ऊँचा जाता है। आप देख सकते हैं कि वसंत के दौरान humidity और atemp के सबसे आवृत्त मान लगभग बिंदु $(10.4,43)$ के आसपास हैं।
अब आप जानते हैं कि हीटमैप कैसे बनाते हैं; अब आपकी बारी है अपना स्वयं का बनाने की। अन्य मौसमों और अन्य वैरिएबल्स के संबंध को देखकर शुरू करें।
सोचें कि आप इसका उपयोग कैसे कर सकते हैं यह समझने के लिए कि विभिन्न वैरिएबल मानों के लिए आपको कितनी बाइक्स उपलब्ध करानी चाहिए—यह जानते हुए कि सबसे आवृत्त बिंदुओं की प्रायिकता अधिक होती है।
यदि आप ggplot के साथ डेटा विज़ुअलाइज़ेशन के बारे में और सीखना चाहते हैं, तो हमारे Data Visualization with ggplot2 कोर्स पर ज़रूर नज़र डालें।
R के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}