Kurs
R’ye Giriş
4 sa
3.1M
Bir veri bilimci olarak veri kümenizindeki özelliklerin dağılımını analiz etmeniz gerekir. Genellikle bu, histogramlar kullanılarak yapılır; değişkenin değer aralığını, sapmasını ve değerlerin nerede yoğunlaştığını göstermek için oldukça kullanışlıdır.
Bu eğitim R kullanır. Eğer R ile henüz tanışmadıysanız, DataCamp’teki ücretsiz R’ye Giriş kursumuzu almanızı öneririm.
Bu eğitim için bir Kaggle yarışmasından Bike Sharing Demand Dataset veri kümesini kullanacaksınız.
Bağlantıyı takip edin ve data sekmesine gidin, ardından train.csv dosyasını indirin.
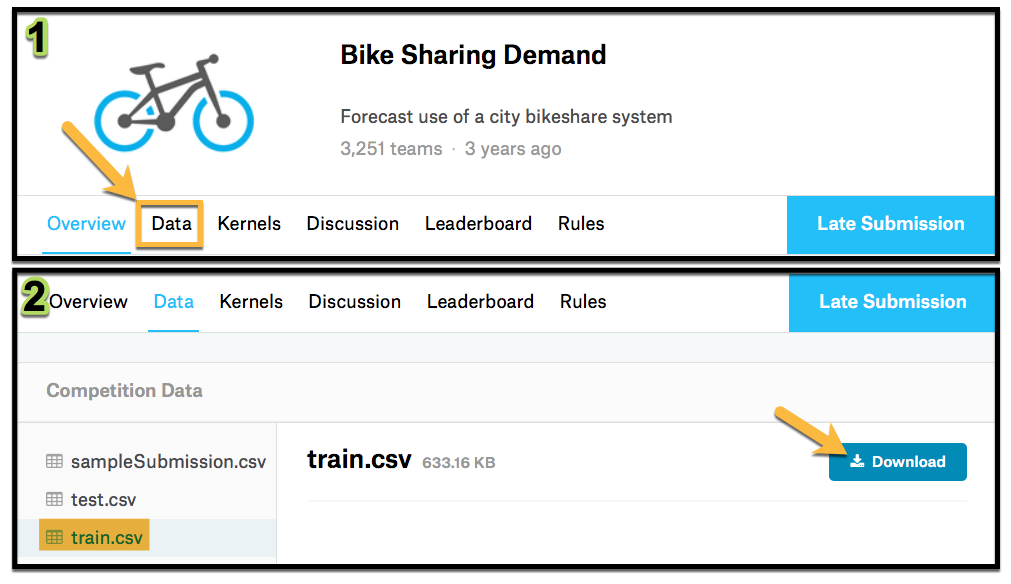
Veri kümesini R’ye yükleyin.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Özellik | Açıklama |
|---|---|
| datetime | saatlik tarih + zaman damgası |
| season | 1 = ilkbahar 2 = yaz 3 = sonbahar 4 = kış |
| holiday | günün resmi tatil olup olmadığı |
| workingday | günün hafta sonu ya da resmi tatil olmaması durumu |
| weather | 1: Açık, Az bulutlu, Parçalı bulutlu, Parçalı bulutlu 2: Sis + Bulutlu, Sis + Parçalı bulutlar, Sis + Az bulutlu, Sis 3: Hafif kar, Hafif yağmur + Gök gürültülü fırtına + Dağınık bulutlar, Hafif yağmur + Dağınık bulutlar 4: Sağanak yağmur + Buz tanecikleri + Gök gürültülü fırtına + Sis, Kar + Sis |
| temp | Santigrat cinsinden sıcaklık |
| atemp | hissedilen sıcaklık (°C) |
| humidity | bağıl nem |
| windspeed | rüzgar hızı |
| casual | kayıtlı olmayan kullanıcı kiralamalarının sayısı |
| registered | kayıtlı kullanıcı kiralamalarının sayısı |
| count | toplam kiralama sayısı |
season bazında atemp ve humidity arasındaki ilişkiyi analiz edeceksiniz, bu nedenle veri kümesinden bunları seçin. dplyr paketini yüklemeyi unutmayın.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Tamam, artık veriyi analiz etmeye hazırsınız; sezona göre her bir özellik için bir histogram oluşturmakla başlayın. Bunu ggplot2 kütüphanesini kullanarak yapacaksınız, bu yüzden yüklemeyi unutmayın.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)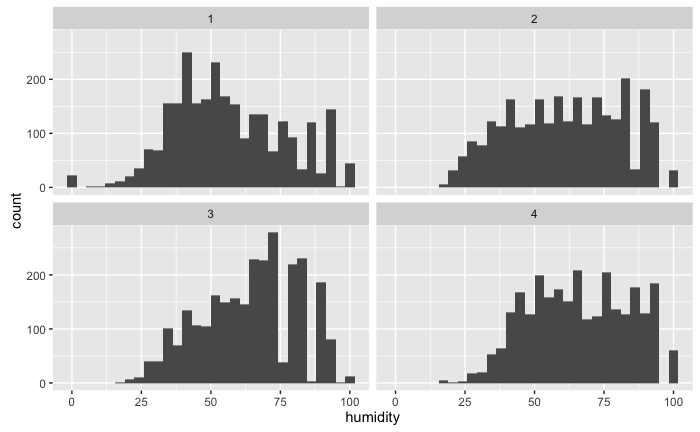
Histogram ile kış aylarında nemin daha yüksek olduğunu (ki bu beklenen bir durum) görebilirsiniz; ayrıca her mevsimde nasıl dağıldığına dair bir fikir edinebilirsiniz.
Şimdi yoğunluğu, bir yoğunluk halısını ekleyin ve bölme adlarını değiştirin; böylece görselleştirme daha iyi görünsün.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")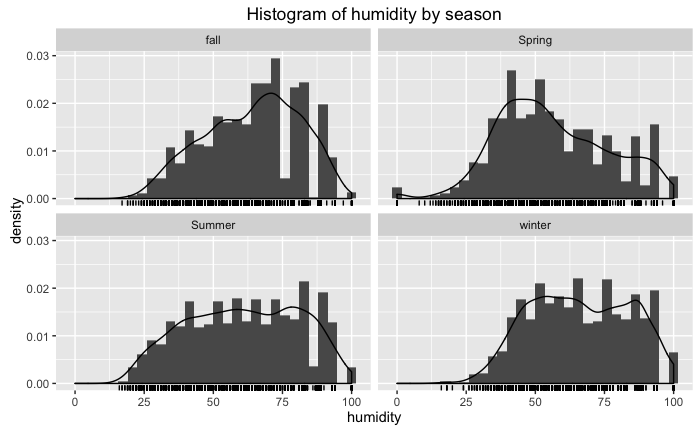
Bu, nemin nasıl davrandığına dair daha iyi bir his veriyor; aynı işlemi atemp için de yapın.
Yukarıdaki kodu yeniden kullanın ve değişkeni atemp olarak değiştirin,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")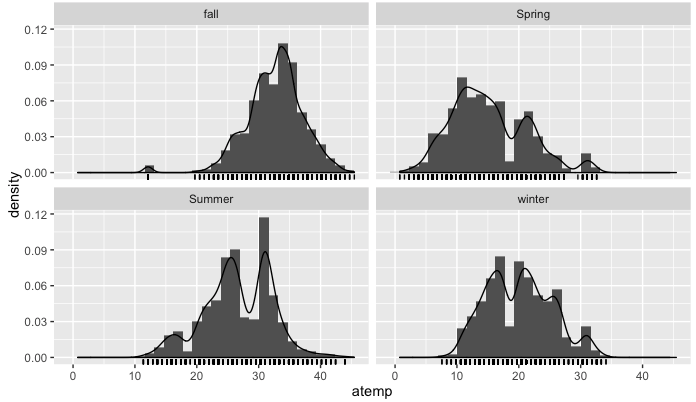
Buraya kadar her şey yolunda; her mevsim için beklediğiniz gibi. Her grafikte olasılık dağılım fonksiyonunun bir yaklaşımı bulunuyor.
Ancak bu grafiklere dayanarak özelliklerin birbirleriyle nasıl etkileştiğini görselleştirmek zor. Karşılaştığınız ilk zorluk, histogramınızın 3B olması gerektiği; çünkü iki özellik için dağılım fonksiyonunu bulmaya çalışıyorsunuz.
Amacınız iki değişkenli dağılımı görselleştirmek; bunu yapabilmek için önce veriye iki değişkenli bir dağılım uydurmanız gerekir. Bu işlem MASS kütüphanesi ve kde2d fonksiyonu kullanılarak yapılacak. kde2d fonksiyonu, rassal değişkenler için normallik varsayımı altında iki değişkenli dağılımı tahmin eder. Bu fonksiyonun girdileri aşağıdaki gibidir,
| girdi | açıklama |
|---|---|
| x | x koordinat verisi |
| y | y koordinat verisi |
| n | her eksen için ızgara noktası sayısı |
| lims | x ve y için sınırlar |
Şimdi bunu yaz ayları için filtreleyerek veri kümesine uygulayın,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Not: MASS kütüphanesini yüklediğinizde bir
selectfonksiyonu ile gelir; bu, dplyr’ınselectfonksiyonu ile çakışır. Bunu düzeltmek için dplyr’ınselectfonksiyonunu kullanırken başınadplyr::eklemelisiniz; örneğin doğru çalışması içindplyr::select()şeklinde.
Şimdi bike_density’nin sınıfına ve yapısına bakın
class(bike_density)
str(bike_density)
Bu, 3 değere (x, y ve z) sahip bir listedir. İlk ikisi özellik değerlerini içerir, üçüncüsü ise olasılık yoğunluk fonksiyonu (pdf) değerlerini içeren bir matristir. contour fonksiyonunu kullanarak yoğunluğa göz atın,
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)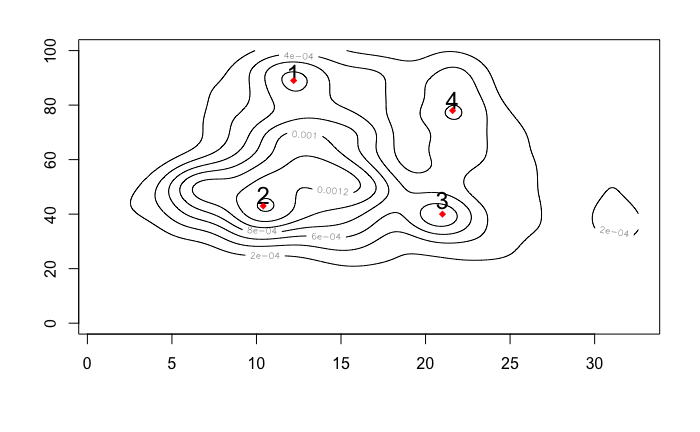
Buna bakarak, iki özelliğin birleşimi için en sık görülen değerlere karşılık gelebilecek bazı birikim noktalarını belirleyebilirsiniz. Her bir noktanın değerleri aşağıdaki tabloda özetlenmiştir,
| nokta | atemp (°C) | nem (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Isı haritanızı oluşturmak için önce kullanmak istediğiniz renk ölçeğini tanımlamanız gerekir; bunu colorRampPalette fonksiyonunu kullanarak yapabilirsiniz
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale, siyah ile kırmızı arasında RGB kodlarını kullanarak 1000 adımda ilerleyen bir vektördür.
Şimdi image fonksiyonunu kullanarak ısı haritanızı çizin; bu fonksiyon matrisleri çizmek için kullanılır.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
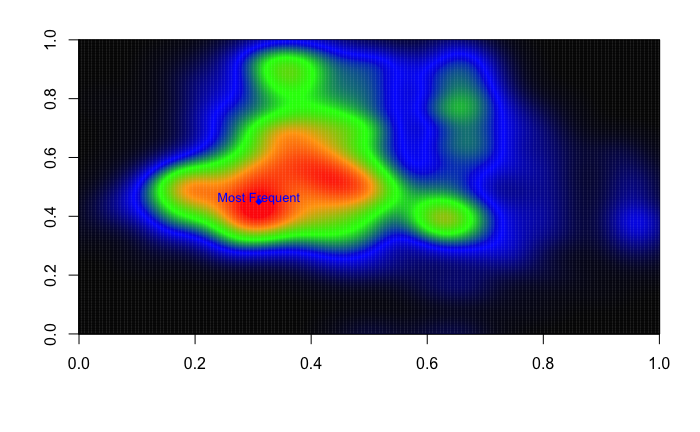
Gördüğünüz gibi bu, kontur grafiğinden daha fazla bilgi sunuyor; çünkü artık renkler birikim noktasının ne kadar yüksek olduğunu gösteriyor. İlkbahar sırasında nem ve atemp için en sık görülen değerlerin yaklaşık olarak (10.4, 43) noktasında olduğunu görebilirsiniz.
Artık bir ısı haritası oluşturmayı biliyorsunuz; sıra sizde. Diğer mevsimlere ve diğer değişkenlerle olan ilişkilere bakarak başlayın.
En sık görülen noktaların daha yüksek olasılığa sahip olduğu gerçeğine dayanarak, değişkenlerin farklı değerleri için kaç bisiklet tedarik etmeniz gerektiğine dair içgörü elde etmek için bunu nasıl kullanabileceğinizi düşünün.
ggplot ile veri görselleştirme hakkında daha fazla bilgi edinmek isterseniz, ggplot2 ile Veri Görselleştirme kursumuza göz atmayı unutmayın.
R hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




