Cursus
Introductie tot R
4 uur
3.1M
Als data scientist zul je de verdeling van de features in je dataset moeten analyseren. Meestal doe je dit met histogrammen; die zijn heel handig om het bereik van waarden, hun afwijking en waar waarden zich concentreren te laten zien.
Deze tutorial gebruikt R. Als je nog niet bekend bent met R, raad ik je aan om onze gratis cursus Introduction to R op DataCamp te volgen.
Voor deze tutorial gebruik je de Bike Sharing Demand-dataset uit een Kaggle-competitie.
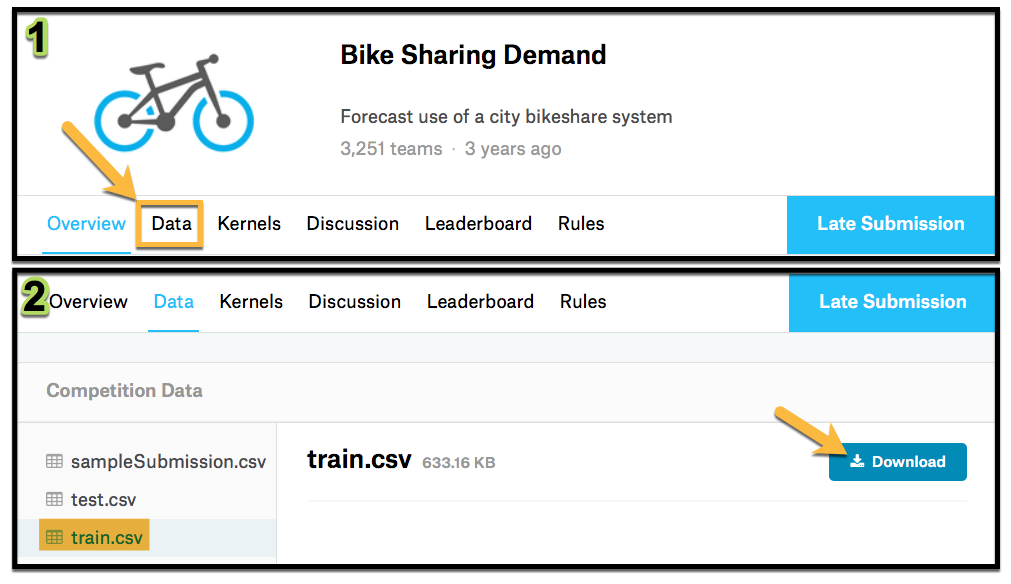
Volg de link en ga naar het tabblad Data, en download vervolgens het bestand train.csv.
Laad de dataset in R.
library(dplyr)
bike<- read.csv("train.csv",
                na.strings = FALSE,
                strip.white = TRUE)
glimpse(bike)| Feature | Beschrijving |
|---|---|
| datetime | uurdatum + timestamp |
| season | 1 = lente 2 = zomer 3 = herfst 4 = winter |
| holiday | of de dag als feestdag geldt |
| workingday | of de dag geen weekenddag en geen feestdag is |
| weather | 1: Helder, Weinig bewolking, Halfbewolkt, Halfbewolkt 2: Nevel + Bewolkt, Nevel + Gebroken bewolking, Nevel + Weinig bewolking, Nevel 3: Lichte sneeuw, Lichte regen + Onweer + Verspreide bewolking, Lichte regen + Verspreide bewolking 4: Hevige regen + IJspellets + Onweer + Nevel, Sneeuw + Mist |
| temp | temperatuur in graden Celsius |
| atemp | gevoelstemperatuur in graden Celsius |
| humidity | relatieve luchtvochtigheid |
| windspeed | windsnelheid |
| casual | aantal ritten gestart door niet-geregistreerde gebruikers |
| registered | aantal ritten gestart door geregistreerde gebruikers |
| count | totaal aantal ritten |
Je gaat de relatie tussen atemp en humidity per season analyseren, dus selecteer deze uit de dataset. Vergeet niet het pakket dplyr te laden.
bike_data<-
  bike %>%
  dplyr::select(season, atemp, humidity)
head(bike_data)Oké, je bent klaar om met de analyse te beginnen. Start met het maken van een histogram voor elk van de features per seizoen. Je gebruikt hiervoor de bibliotheek ggplot2, dus vergeet niet die te laden.
library(ggplot2)
bike_data %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30) +
  facet_wrap(~season,ncol = 2)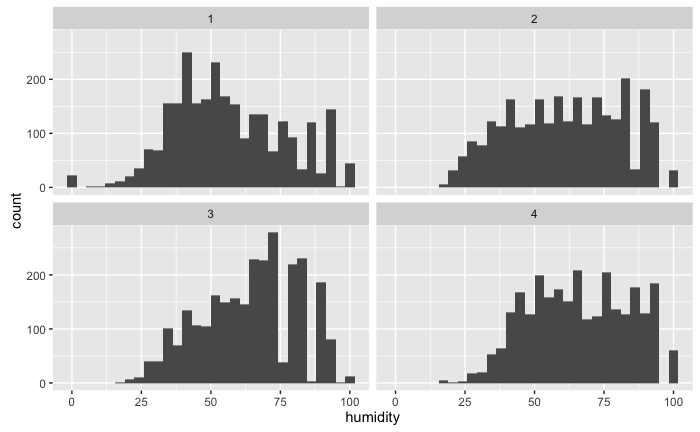
Met het histogram zie je dat de luchtvochtigheid in de winter hoger is (wat logisch is), maar je krijgt ook een beeld van hoe die in elk seizoen verdeeld is.
Voeg nu de dichtheidscurve toe, een density rug en verander de namen van de facetten, zodat de visualisatie er beter uitziet.
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=humidity) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of humidity by season")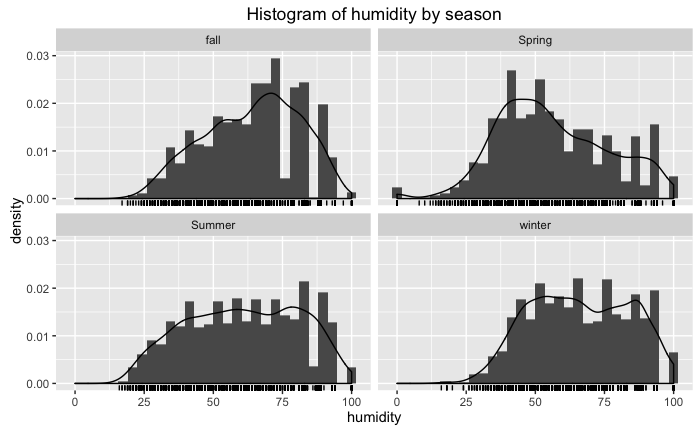
Dit geeft je nu een beter gevoel voor hoe de luchtvochtigheid zich gedraagt. Doe hetzelfde met atemp.
Herbruik de bovenstaande code en verander de variabele naar atemp,
bike_data %>%
  mutate(season_label = case_when(
    season == 1 ~ "Spring",
    season == 2 ~ "Summer",
    season == 3 ~ "fall",
    season == 4 ~ "winter")) %>%
  ggplot( aes(x=atemp) ) +
  geom_histogram(bins=30,aes(y = ..density..)) +
  geom_rug()+
  geom_density()+
  facet_wrap(~season_label,ncol = 2)+
  ggtitle("Histogram of atemp by season")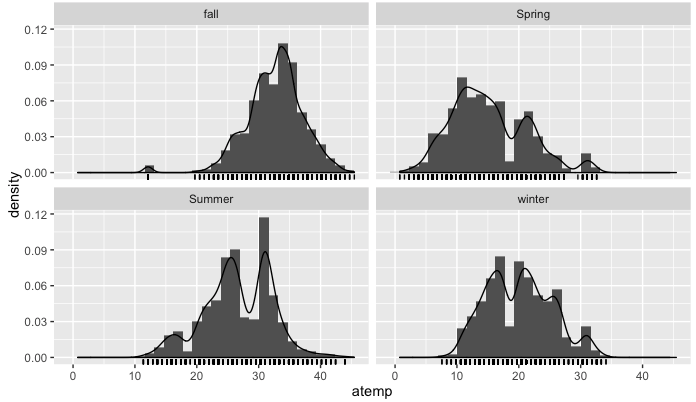
Oké, tot zover gaat alles zoals je voor elk seizoen zou verwachten. In elke grafiek heb je een benadering van de kansdichtheidsfunctie.
Maar op basis van deze grafieken is het lastig te zien hoe de features op elkaar inwerken. Het eerste probleem is dat je histogram eigenlijk 3D zou moeten zijn, omdat je de verdelingsfunctie voor twee features probeert te vinden.
Het doel is de bivariate verdeling te visualiseren. Om dat te kunnen doen, moet je eerst een bivariate verdeling op de data fitten. Dit doe je met de bibliotheek MASS en de functie kde2d. De functie kde2d schat de bivariate verdeling, waarbij normaliteit voor de toevalsvariabelen wordt aangenomen. De input van deze functie is als volgt,
| input | beschrijving |
|---|---|
| x | x-coördinaten |
| y | y-coördinaten |
| n | aantal rasterpunten per as |
| lims | grenzen voor x en y |
Pas dit nu toe op de dataset, gefilterd op zomer,
library(MASS)
bike_data_summer <- bike_data %>% filter(season==1)
bike_density <- kde2d(bike_data_summer$atemp,bike_data_summer$humidity, n=1000)
Let op: Bij het laden van de MASS-bibliotheek komt een functie
selectmee. Dit botst met de functieselectvan dplyr. Om dit op te lossen, moet je bij gebruik van de dplyr-functieselectdplyr::toevoegen, zoalsdplyr::select(), zodat het correct werkt.
Bekijk nu de class en de structuur van bike_density
class(bike_density)
str(bike_density)
Het is een lijst met 3 waarden: x, y en z. De eerste twee bevatten de featurewaarden en de derde is een matrix met de waarde van de pdf. Bekijk de dichtheid met de functie contour,
contour(bike_density)
text(12.2,92,"1",cex=1.5)
points(12.2,89,col="red",pch=18)
text(10.4,47,"2",cex=1.5)
points(10.4,43,col="red",pch=18)
text(21,45,"3",cex=1.5)
points(21,40,col="red",pch=18)
text(21.6,82,"4",cex=1.5)
points(21.6,78,col="red",pch=18)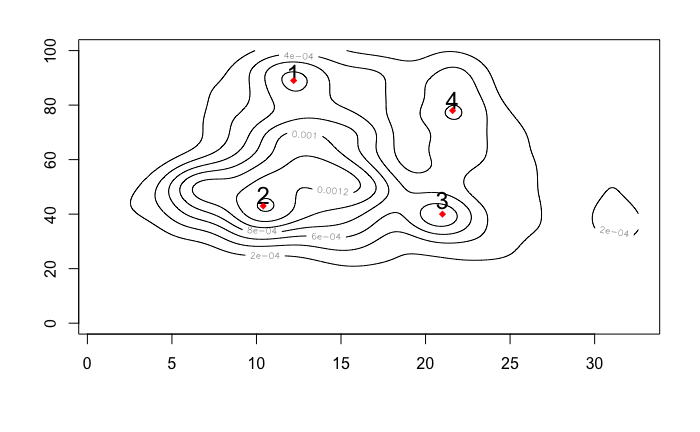
Hierin kun je enkele accumulatiepunten herkennen, die je kunt zien als de meest voorkomende waarden voor de combinatie van de twee features. De waarden voor elk punt zijn samengevat in de volgende tabel,
| punt | atemp (°C) | humidity (%) |
|---|---|---|
| 1 | 12.2 | 89 |
| 2 | 10.4 | 43 |
| 3 | 21 | 43 |
| 4 | 21.6 | 78 |
Om je heatmap te maken, moet je eerst de kleurenschaal definiëren die je wilt gebruiken. Dat kan met de functie colorRampPalette
hm_col_scale<-colorRampPalette(c("black","blue","green","orange","red"))(1000)
hm_col_scale is een vector die van zwart naar rood loopt met RGB-codes in 1000 stappen.
Plot nu je heatmap met de functie image; deze functie wordt gebruikt om matrices te plotten.
image(bike_density$z,
      col = hm_col_scale,
      zlim=c(min(bike_density$z), max(bike_density$z)))
text(0.31,0.46,"Most Frequent",col="blue",cex=0.8)
points(0.31,0.45,col="blue",pch=18)
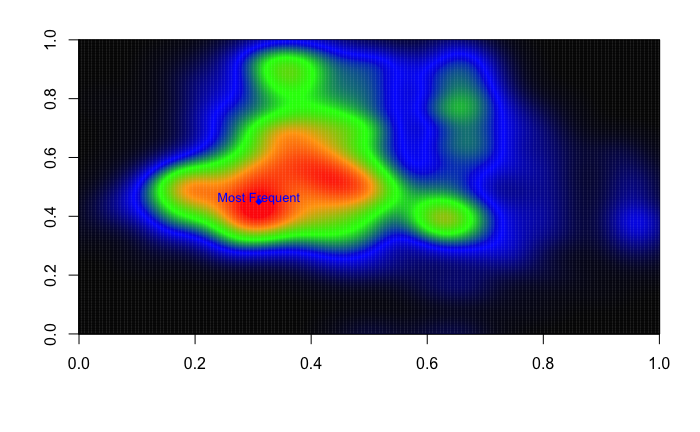
Zoals je ziet, bevat dit meer informatie dan de contourplot, omdat de kleuren nu aangeven hoe hoog het accumulatiepunt is. Je ziet dat de meest voorkomende waarden voor humidity en atemp in de lente rond het punt (10.4, 43) liggen.
Nu weet je hoe je een heatmap maakt; het is aan jou om er zelf een te maken. Kijk ook naar de andere seizoenen en de relatie met andere variabelen.
Denk na over hoe je dit kunt gebruiken om inzicht te krijgen in hoeveel fietsen je moet aanbieden voor verschillende waarden van de variabelen, gegeven dat de meest voorkomende punten een hogere kans hebben.
Wil je meer leren over het maken van datavisualisaties met ggplot? Bekijk dan zeker onze cursus Data Visualization with ggplot2.
Leer meer over R
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

