
Kursus
Pengantar Databricks
3 jam
48.1K
Databricks sudah lama menjadi favorit komunitas rekayasa data, dan kini semakin memperluas kemampuannya ke ranah kecerdasan buatan (AI) dan pembelajaran mesin (ML). Perkembangan ini berarti Anda kini dapat melatih model, melacak eksperimen, mendaftarkan model, dan mendeploy-nya ke endpoint Databricks—semua dalam satu platform terpadu. Integrasi ini menyederhanakan alur kerja dan menjadikan Databricks alat yang kuat bagi profesional data dan AI.
Jika Anda baru mengenal Databricks, pertimbangkan untuk mengikuti kursus Introduction to Databricks untuk mempelajari platform Databricks Lakehouse. Kursus ini akan membantu Anda memahami bagaimana Databricks dapat memodernisasi arsitektur data dan meningkatkan proses pengelolaan data.
Dalam tutorial ini, saya akan memandu Anda mendeploy versi terdistribusi dari model DeepSeek R1 di Databricks. DeepSeek R1 telah semakin populer, dan banyak perusahaan memilih untuk menjalankannya di infrastruktur cloud milik sendiri alih-alih mengirim data ke server eksternal.
Panduan ini akan membantu Anda menyiapkan akun Databricks, mendaftarkan model DeepSeek R1, mendeploy-nya menggunakan antarmuka pengguna, serta mengaksesnya melalui playground dan secara lokal menggunakan perintah CURL.
Untuk mempelajari lebih lanjut tentang DeepSeek R1—termasuk fitur, proses pengembangan, model distilled, harga, dan perbandingan dengan model AI lain seperti milik OpenAI—lihat blog DeepSeek-R1: Features, Comparison, Distilled Models & More.
Ada dua cara mudah untuk menggunakan Databricks. Anda dapat pergi ke GCP, AWS, atau Azure Marketplace dan berlangganan layanan Databricks. Atau, Anda dapat mendaftar akun Databricks mandiri, yang menyediakan sejumlah sumber daya komputasi tanpa perlu membuat cluster komputasi apa pun.
Berikut saya uraikan kedua caranya.
Jika Anda sudah memiliki akses ke GPU AWS, metode ini sangat direkomendasikan. Caranya sederhana dan tidak terlalu merepotkan.
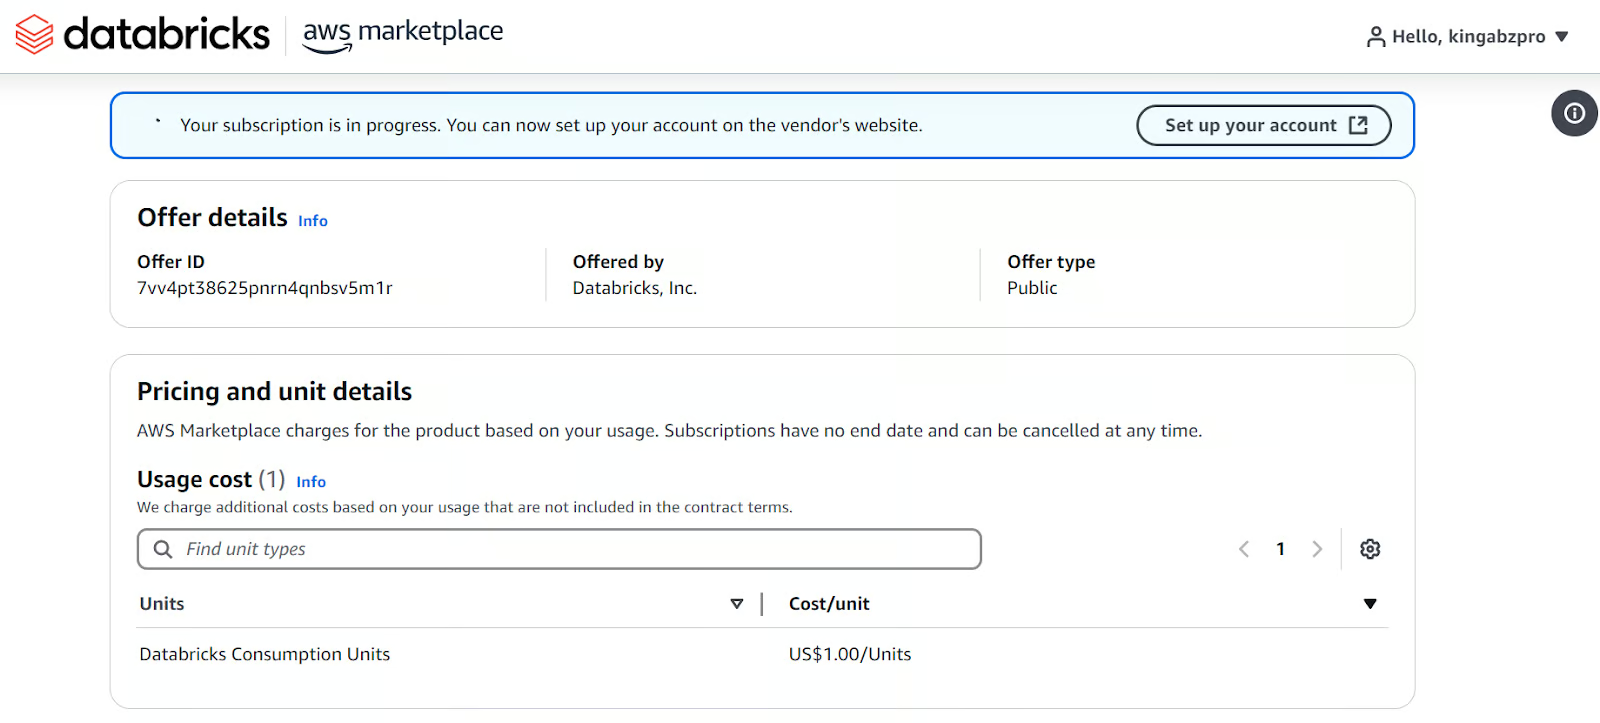
Menyiapkan Databricks di AWS marketplace.
Setelah selesai, sistem akan membuat workspace Databricks untuk Anda dengan berbagai opsi. Semua pembayaran akan dilakukan melalui penagihan AWS.
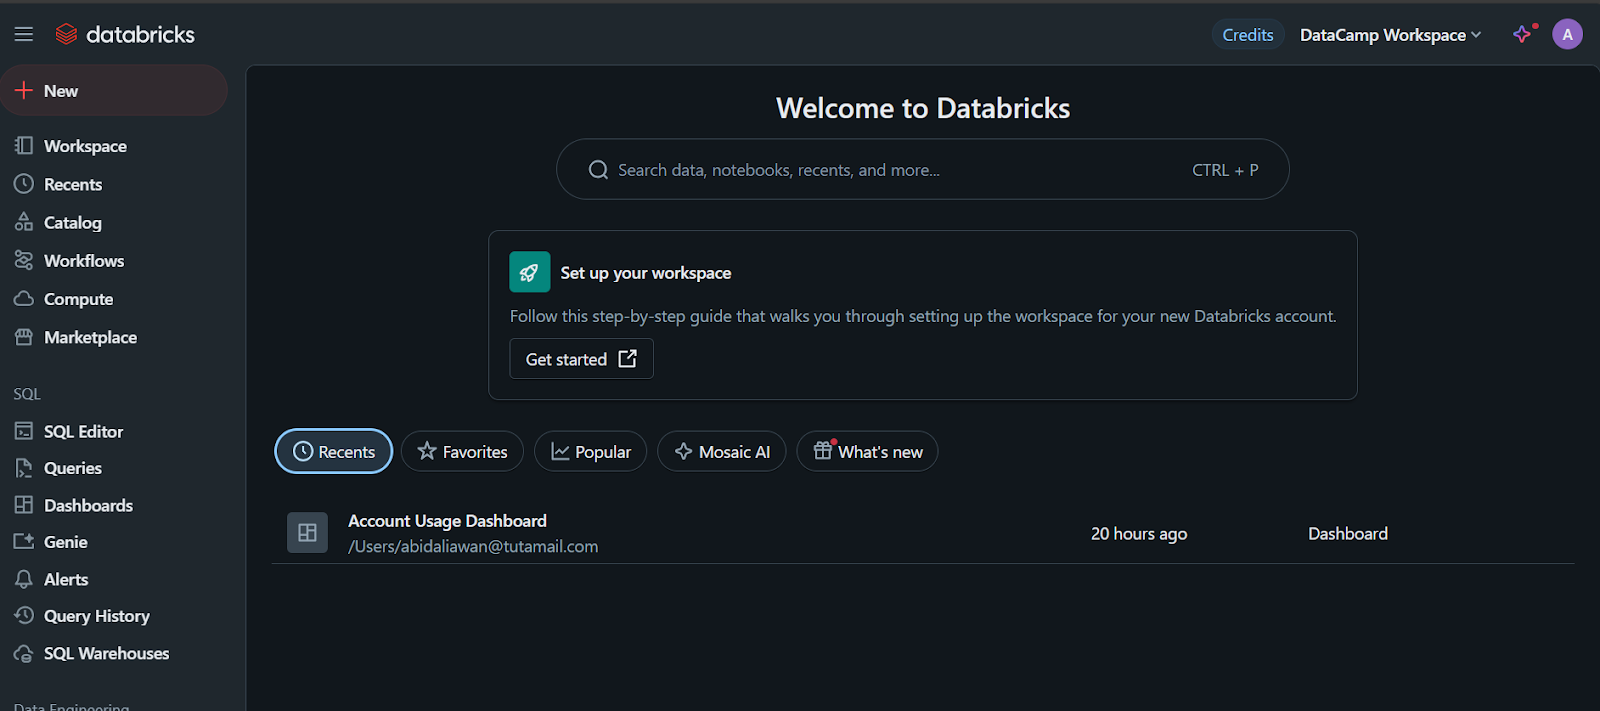
Saat Anda mengeklik tab “Compute”, Anda dapat membuat cluster komputasi sesuai pilihan Anda.
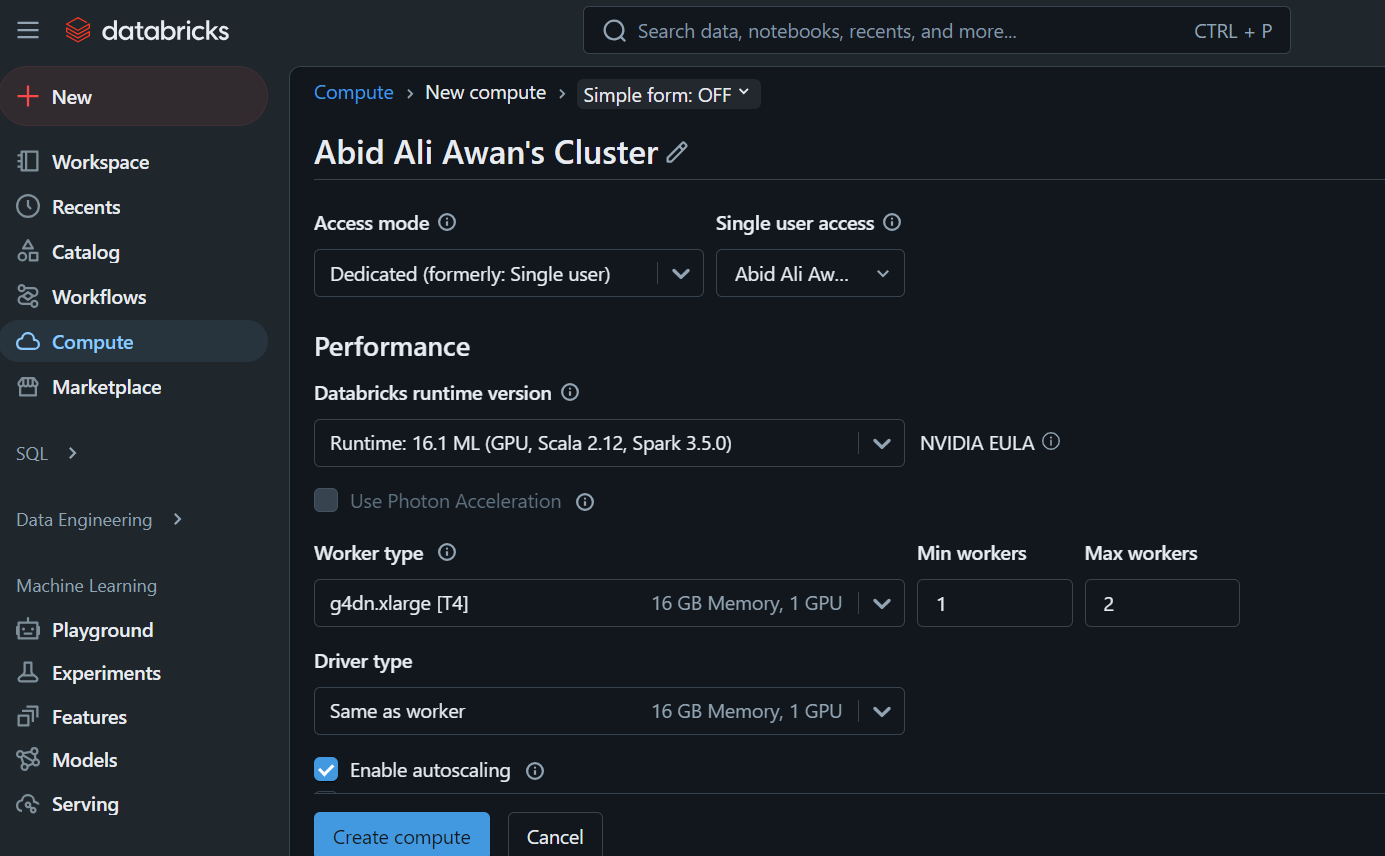
Cluster ini akan digunakan nanti di notebook dan untuk mendeploy model.
Jika Anda lebih suka menggunakan versi mandiri Databricks karena tidak memiliki akses ke GPU cloud atau alasan lain, ikuti langkah-langkah berikut:
Workspace dan seluruh pengaturan akan dibuatkan untuk Anda dalam beberapa detik.
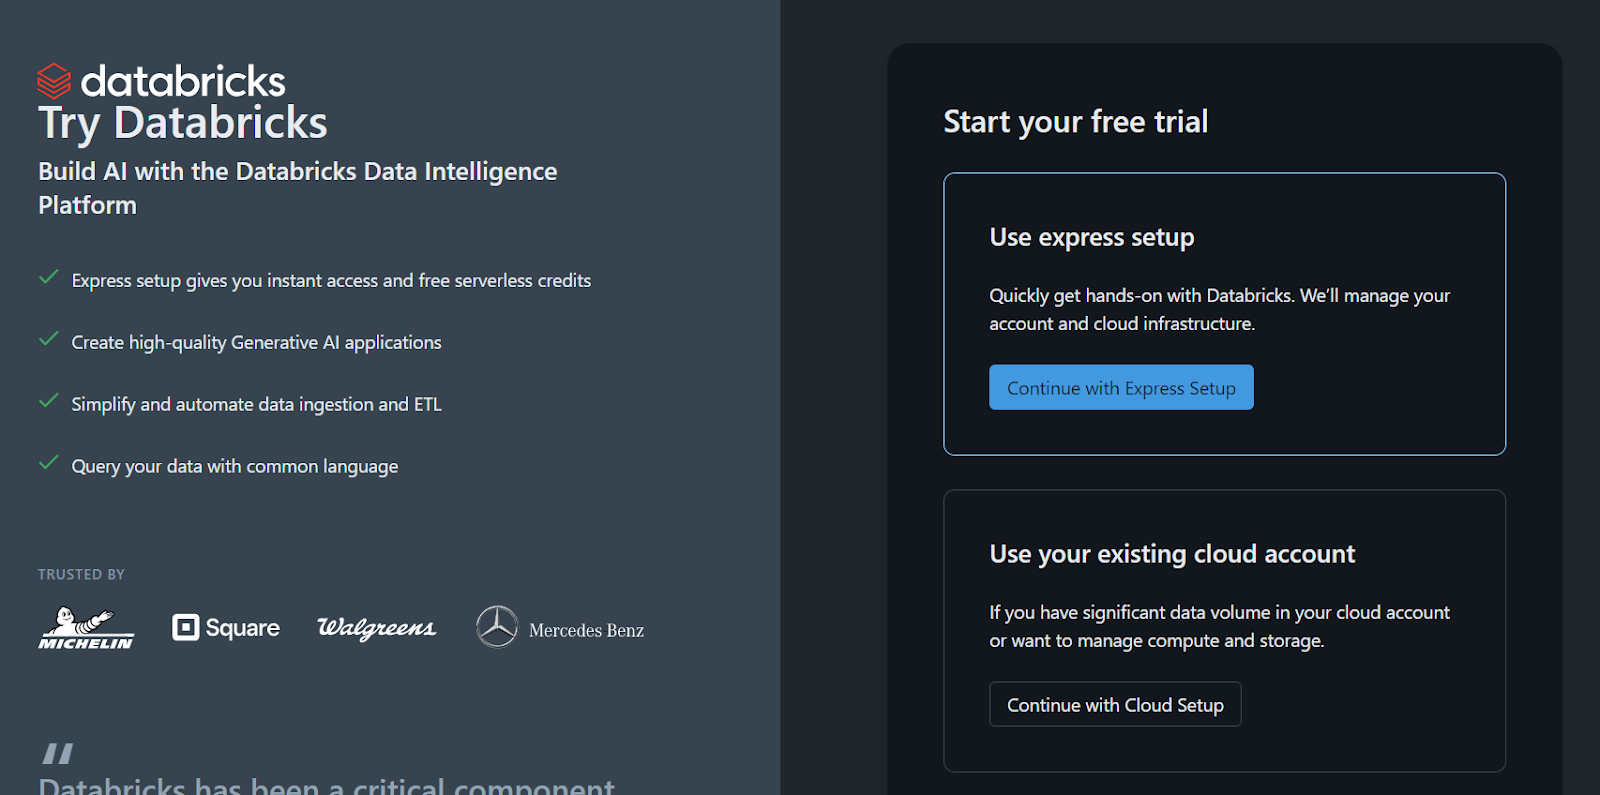
Daftar versi mandiri Databricks.
Harap dicatat ada satu kekurangan: Anda tidak dapat membuat cluster komputasi atau cluster GPU sendiri dengan metode ini. Anda hanya dapat mendaftarkan model menggunakan CPU di notebook, yang bisa jadi kerepotan yang mungkin ingin Anda hindari.
Jika Anda bekerja dengan DeepSeek R1 dalam lingkungan produksi atau riset, menggunakan CPU alih-alih GPU bisa membuat frustrasi karena penurunan kinerja, keterbatasan memori, dan potensi biaya. Pelajari lebih lanjut di artikel blog CPU vs GPU.
Langkah berikutnya adalah mendaftarkan model.
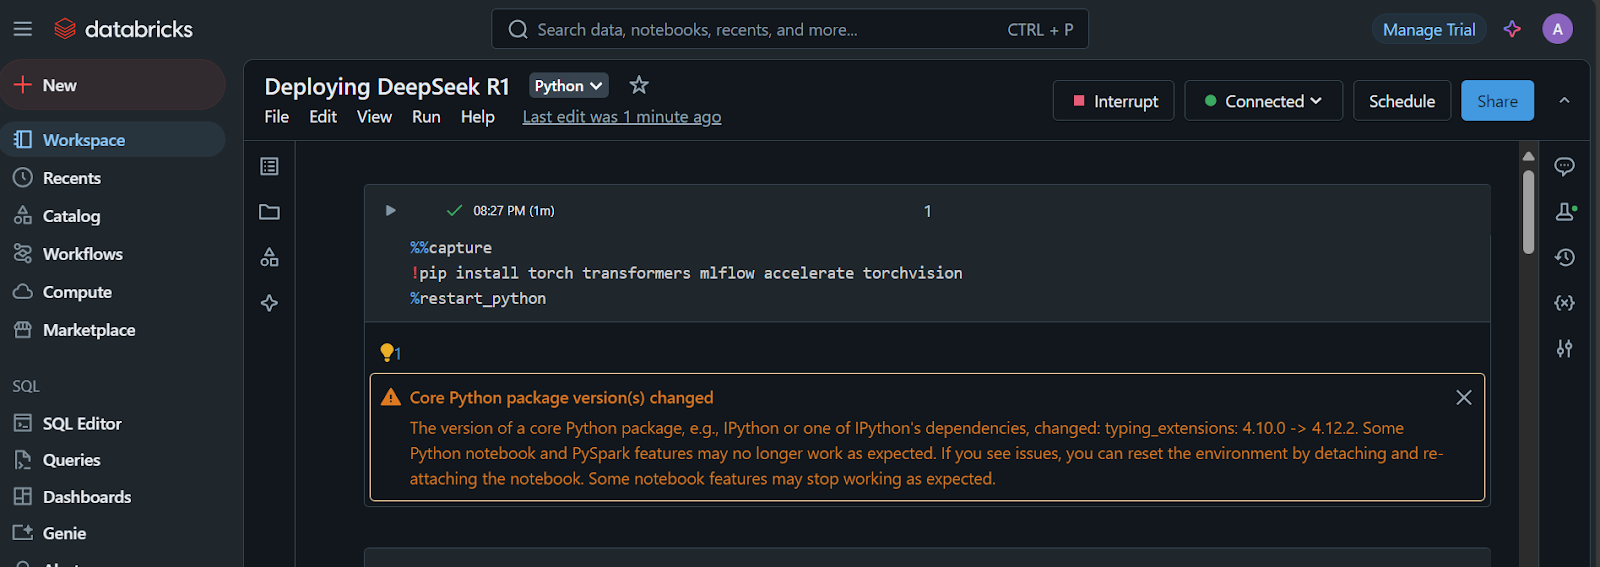
1. Instal paket Python yang diperlukan:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python
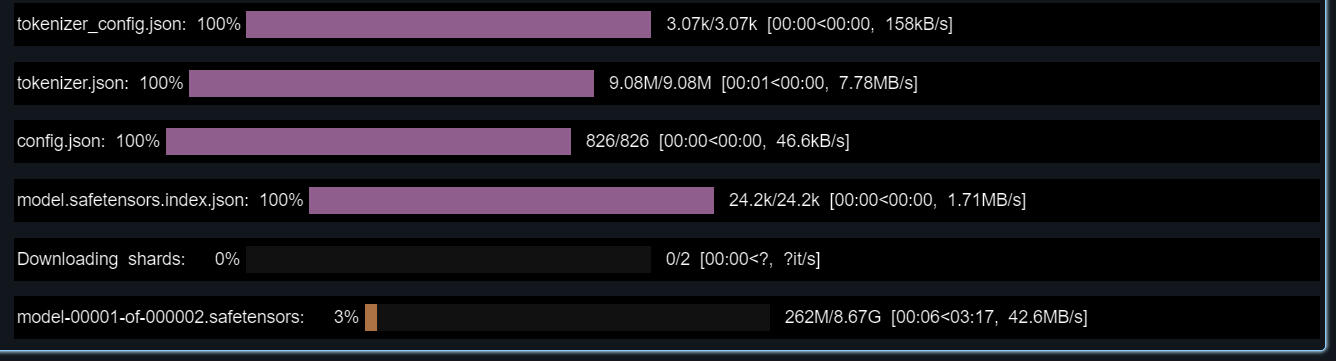
2. Muat token, konfigurasi, dan model dari repositori Hugging Face:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline


# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"


# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)


model = AutoModelForCausalLM.from_pretrained(
    model_name,
    config=config,
    torch_dtype=torch.float16
)
3. Uji model yang dimuat dengan memberinya contoh prompt.
Kita juga akan membuat signature yang akan ditambahkan saat pendaftaran model:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)


print(example_outputs)
Model seharusnya berfungsi dengan baik!
Output yang saya dapatkan adalah:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. Siapkan lingkungan conda dengan versi Python yang benar dan paket Python yang diperlukan.
Ini akan membantu kita membuat container yang memiliki semua alat yang diperlukan untuk menjalankan model:
conda_env = {
    "name": "mlflow-env",
    "channels": ["defaults", "conda-forge"],
    "dependencies": [
        "python=3.11",
        "pip",
        {
            "pip": [
                "mlflow",
                "transformers",
                "accelerate",
                "torch",
                "torchvision"
            ]
        }
    ]
}
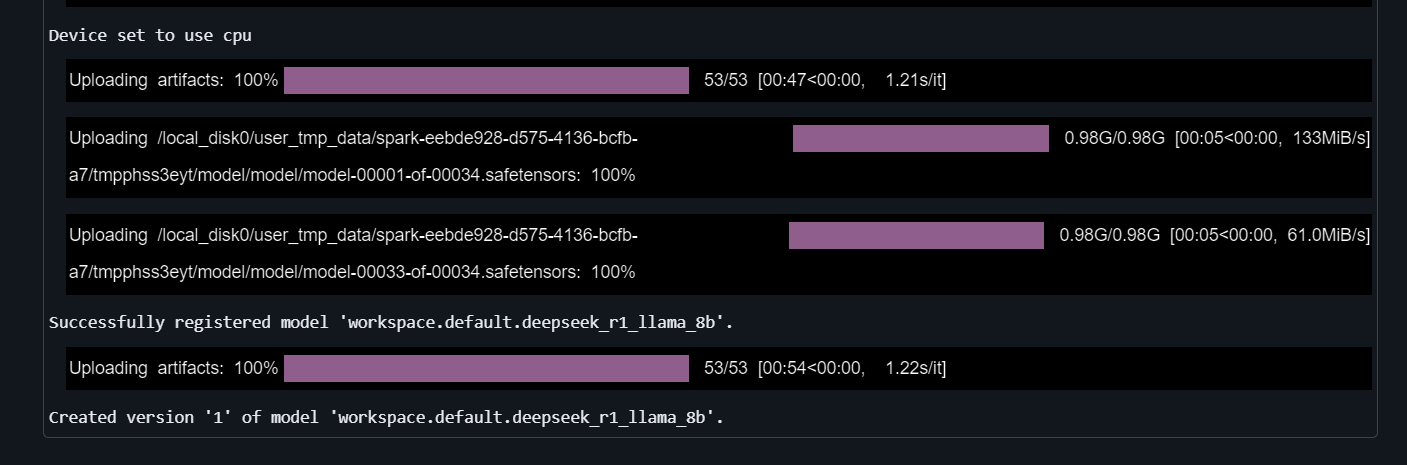
5. Daftarkan model
Berikan fungsi mlflow.transformers.log_model pipeline generasi teks, jalur artefak, signature, contoh input, nama model, serta lingkungan conda:
with mlflow.start_run() as run:
    mlflow.transformers.log_model(
        transformers_model=text_generator,
        artifact_path="deepseek_model",
        signature=signature,
        input_example=example_inputs,
        registered_model_name="deepseek_r1_llama_8b",
        conda_env=conda_env
    )
Pendaftaran model akan memakan waktu beberapa menit.
Pelajari kekuatan Databricks Lakehouse dan tingkatkan keterampilan rekayasa data serta machine learning Anda dengan mengikuti kursus Data Management in Databricks.
Saatnya mendeploy model!
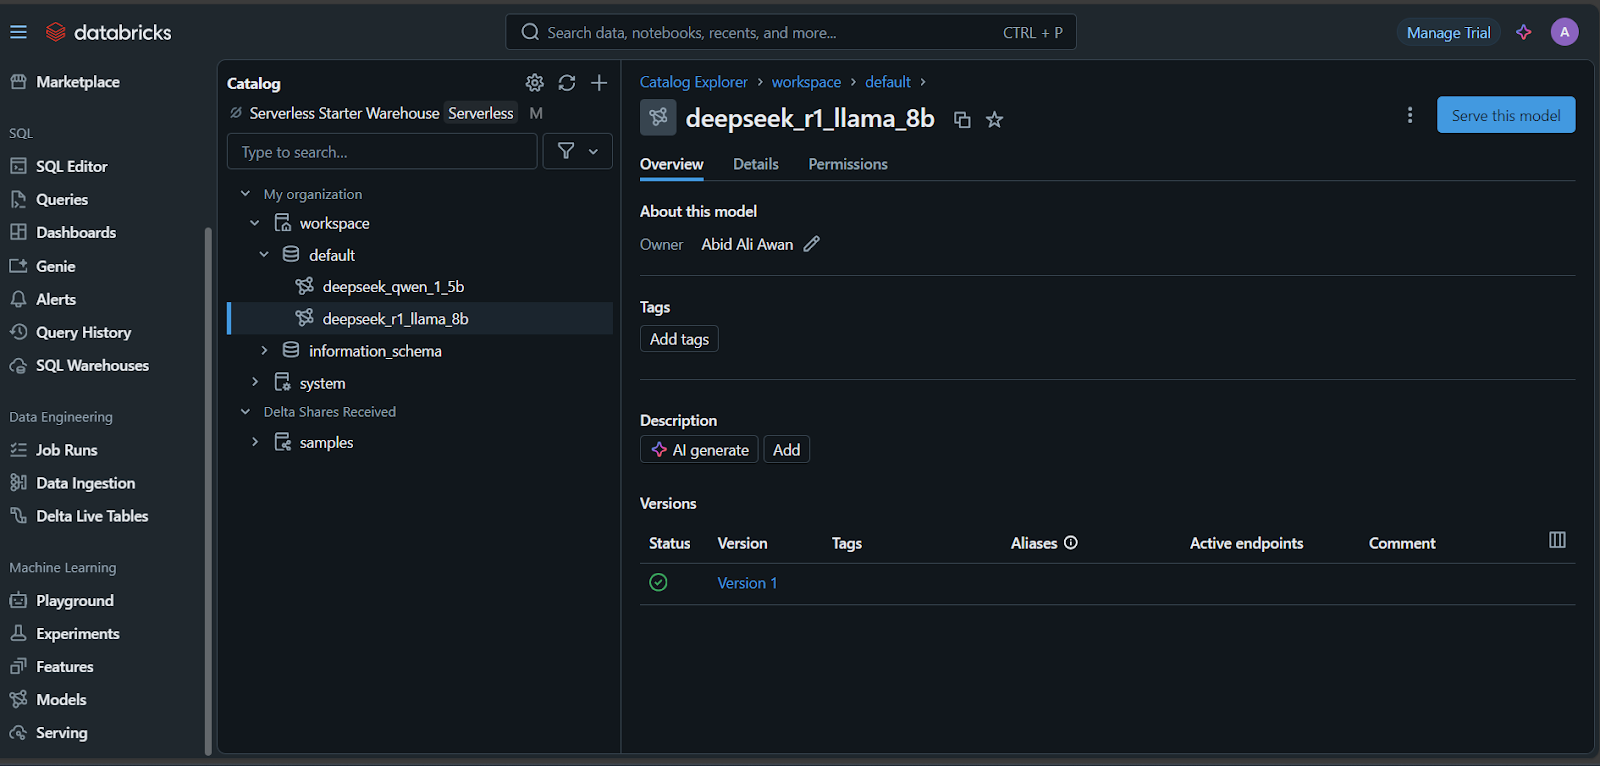
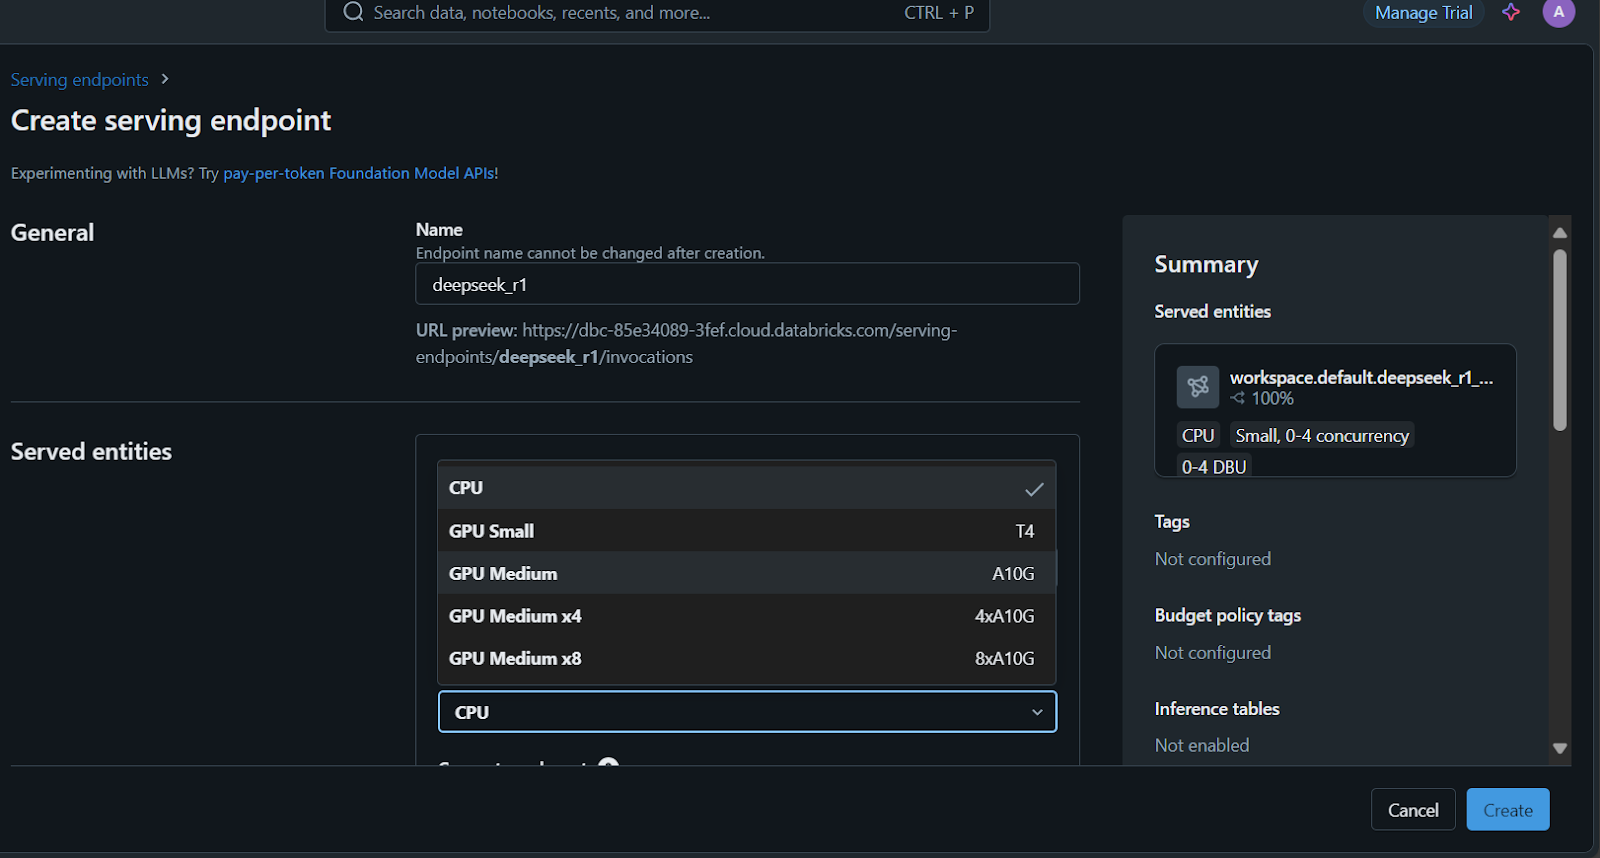
Menyiapkan serving endpoint akan memakan waktu beberapa menit. Status akan berubah menjadi hijau setelah selesai dan menampilkan “Ready”.
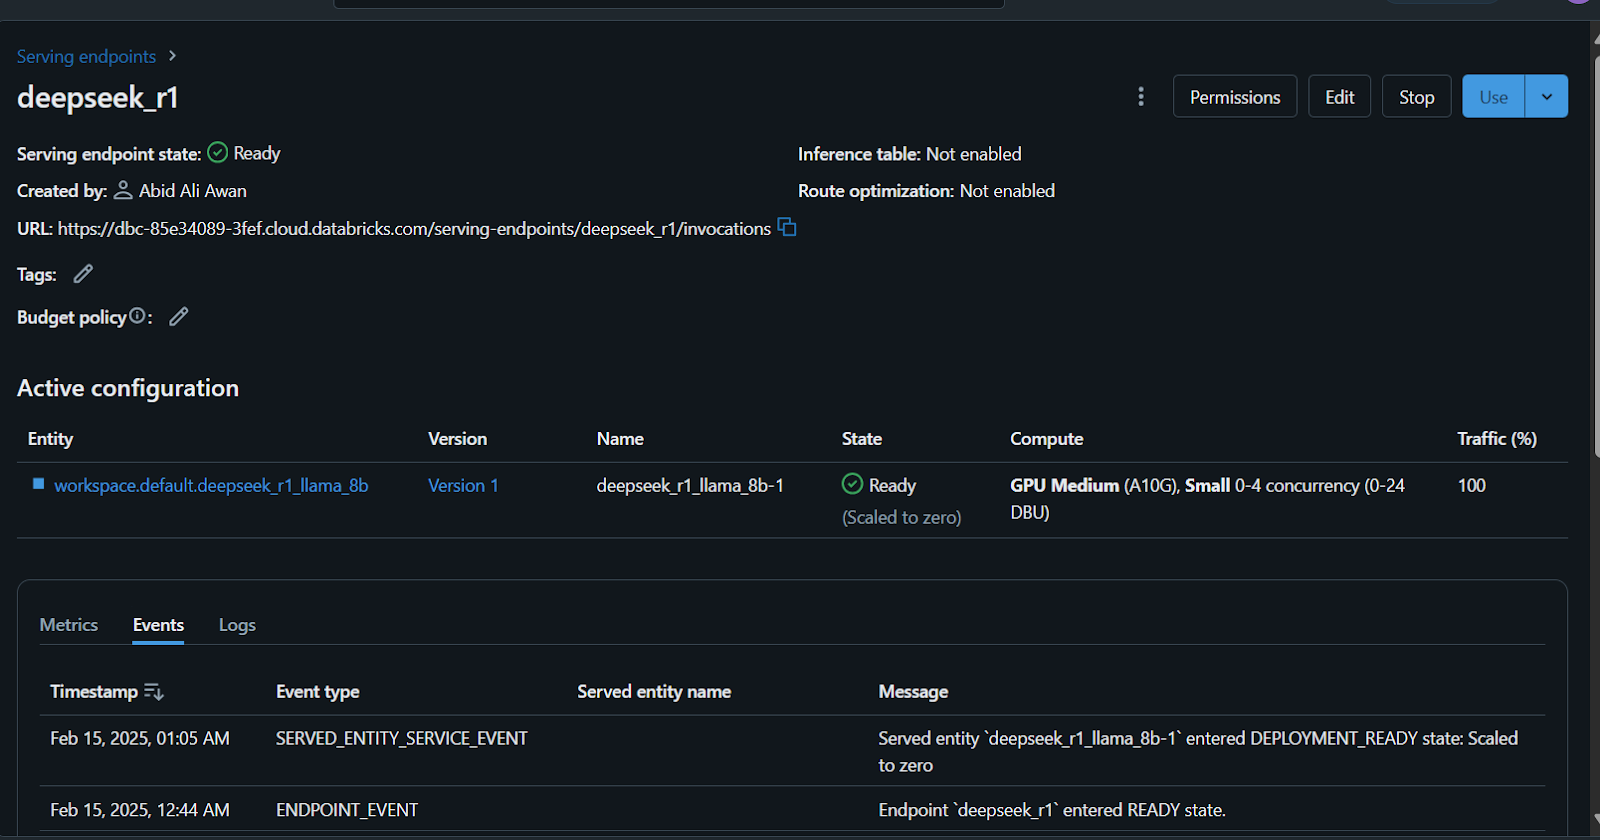
Selain itu, Anda dapat melakukan fine-tune DeepSeek R1 pada dataset kustom sebelum mendaftarkan model. Ikuti tutorial Fine-Tuning DeepSeek R1 untuk mempelajari semua yang perlu Anda ketahui tentang proses ini.
Ada banyak cara untuk mengakses atau menggunakan model ini.
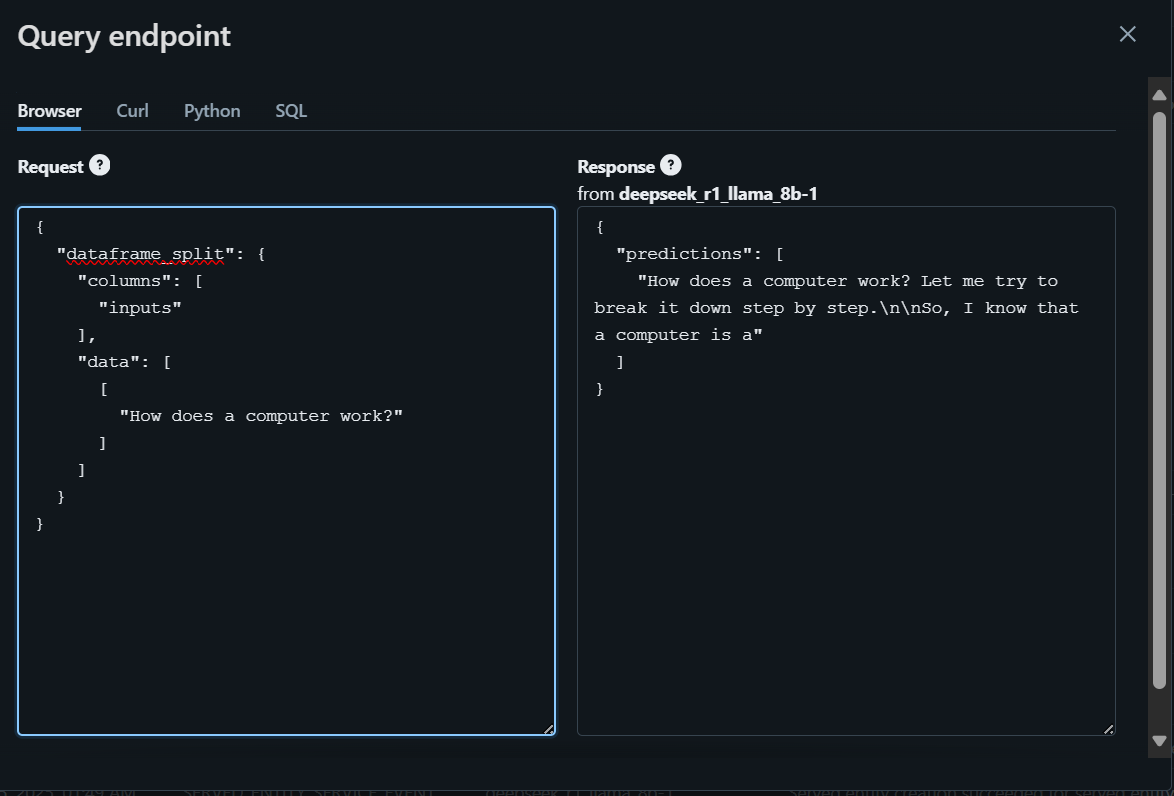
Untuk memulai, kita akan menulis pertanyaan melalui browser dan menghasilkan respons.
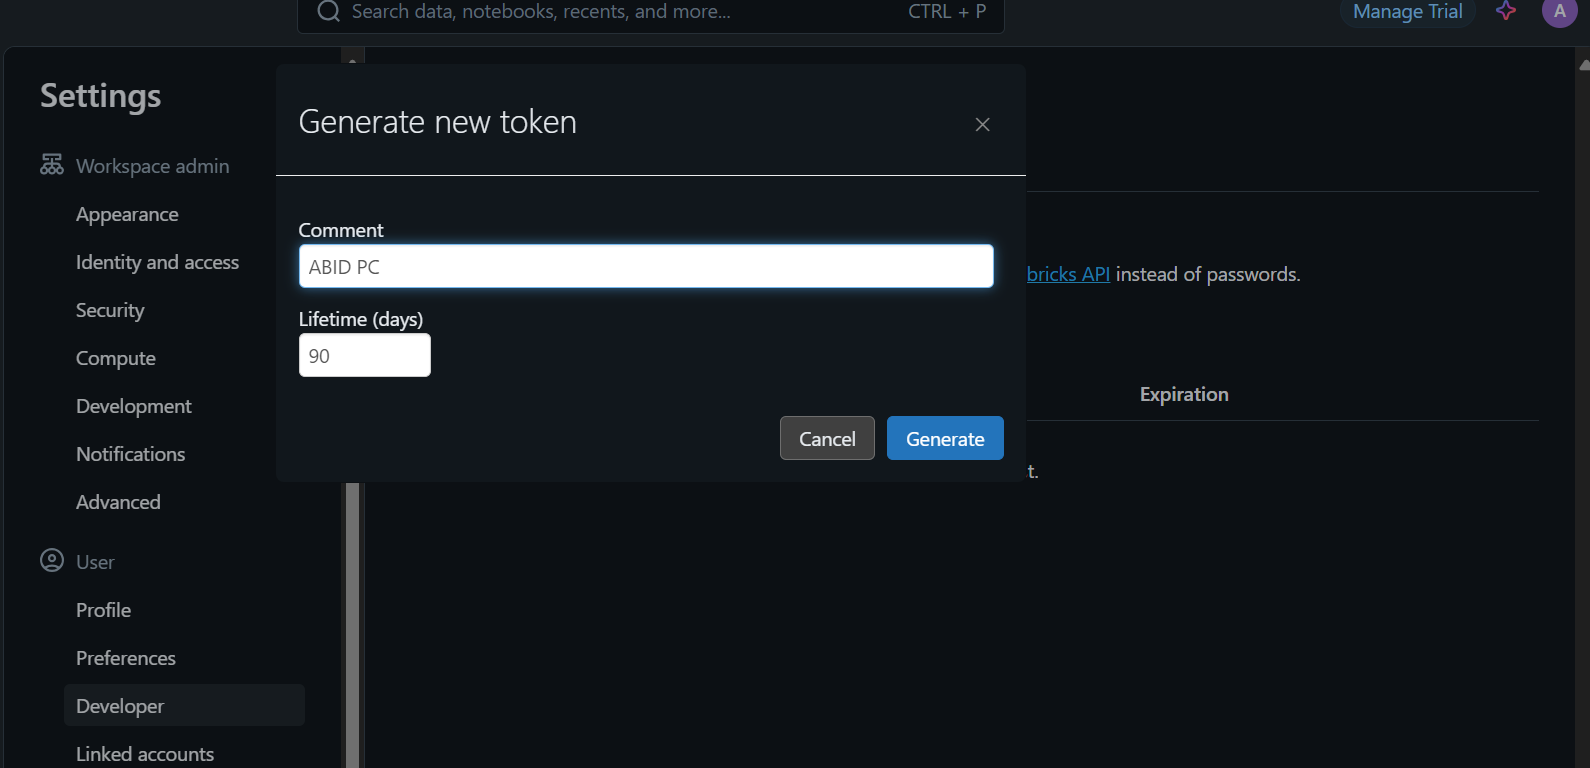
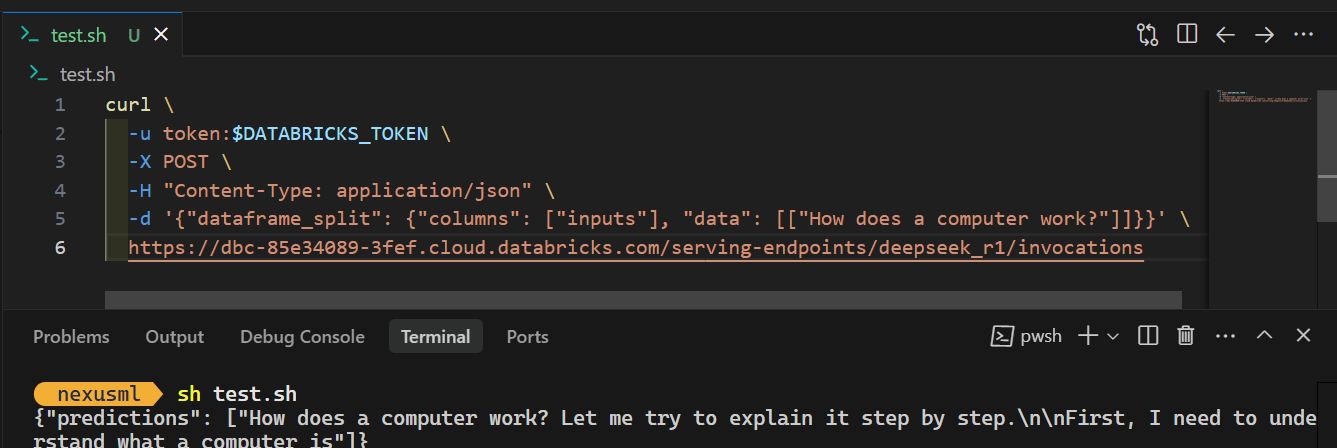
Untuk mengakses model secara lokal atau mengintegrasikannya ke aplikasi Anda, pertama-tama Anda perlu membuat kunci API Databricks.
curl \
  -u token:$DATABRICKS_TOKEN \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
  https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocations
Saat Anda menjalankan perintah tersebut, pembuatan respons akan memakan waktu beberapa detik. Sesederhana itu!
Lihat blog DeepSeek R1 vs V3 untuk mengetahui model bahasa besar terbaik dari DeepSeek.
Mendaftarkan dan mendeploy model DeepSeek R1 di Databricks itu mudah. Anda bahkan dapat mendaftarkan dan mendeploy model besar menggunakan cluster CPU atau mesin CPU lokal tanpa menimbulkan biaya apa pun. Namun, menjalankan model di CPU bisa lambat dan membutuhkan kesabaran, terutama saat membangun image docker.
Dalam tutorial ini, kita membahas seluruh proses deployment model langkah demi langkah. Kita mulai dengan menyiapkan Databricks dan mendaftarkan model DeepSeek Distilled R1 yang telah dilatih sebelumnya di Databricks Model Registry. Lalu, kita menggunakan dasbor Databricks untuk mendeploy model. Terakhir, kita menguji model yang telah dideploy dan menunjukkan cara menggunakannya secara lokal dengan perintah CURL sederhana.
Jika Anda baru dalam AI dan model bahasa besar, saya merekomendasikan untuk mengikuti kursus Introduction to LLMs in Python. Ini akan membantu Anda membangun fondasi yang kuat, memahami terminologi kunci, dan mulai bekerja dengan model tingkat lanjut seperti DeepSeek R1!
Pelajari lebih lanjut tentang Databricks dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



