
कोर्स
Databricks परिचय
3 घंटा
48K
Databricks डेटा इंजीनियरिंग समुदाय के बीच लंबे समय से पसंदीदा रहा है, और अब यह कृत्रिम बुद्धिमत्ता (AI) और मशीन लर्निंग (ML) के क्षेत्रों में अपनी क्षमताओं का लगातार विस्तार कर रहा है। इस विकास का अर्थ है कि अब आप एक ही एकीकृत प्लेटफ़ॉर्म में मॉडल ट्रेन कर सकते हैं, प्रयोग ट्रैक कर सकते हैं, मॉडल रजिस्टर कर सकते हैं, और उन्हें Databricks एंडपॉइंट्स पर डिप्लॉय कर सकते हैं। यह इंटीग्रेशन वर्कफ़्लो को सरल बनाता है और Databricks को डेटा और AI पेशेवरों दोनों के लिए एक शक्तिशाली टूल बनाता है।
यदि आप Databricks में नए हैं, तो Databricks Lakehouse प्लेटफ़ॉर्म के बारे में जानने के लिए Introduction to Databricks कोर्स करने पर विचार करें। यह कोर्स आपको समझने में मदद करेगा कि Databricks कैसे डेटा आर्किटेक्चर्स को आधुनिक बनाता है और डेटा प्रबंधन प्रक्रियाओं में सुधार करता है।
इस ट्यूटोरियल में, मैं आपको Databricks पर DeepSeek R1 मॉडल के डिस्ट्रिब्यूटेड संस्करण को डिप्लॉय करने की प्रक्रिया बताऊंगा। DeepSeek R1 तेजी से लोकप्रिय हो रहा है, और कई कंपनियां डेटा को बाहरी सर्वरों पर भेजने के बजाय इसे अपनी क्लाउड इंफ्रास्ट्रक्चर पर चलाना पसंद कर रही हैं।
यह गाइड आपको Databricks खाता सेट करने, DeepSeek R1 मॉडल रजिस्टर करने, यूज़र इंटरफ़ेस का उपयोग कर उसे डिप्लॉय करने, और प्लेग्राउंड व लोकली CURL कमांड के माध्यम से एक्सेस करने में मदद करेगा।
DeepSeek R1 के बारे में अधिक जानने के लिए—इसके फीचर्स, डेवलपमेंट प्रोसेस, डिस्ट्रिल्ड मॉडल्स, प्राइसिंग, और यह OpenAI जैसे अन्य AI मॉडलों की तुलना में कैसा है—DeepSeek-R1: Features, Comparison, Distilled Models & More ब्लॉग देखें।
Databricks का उपयोग करने के दो आसान तरीके हैं। आप GCP, AWS, या Azure Marketplace पर जाकर Databricks सेवा की सदस्यता ले सकते हैं। वैकल्पिक रूप से, आप एक स्टैंडअलोन Databricks खाता बना सकते हैं, जो बिना किसी कंप्यूटिंग क्लस्टर बनाए भी कुछ कम्प्यूटिंग संसाधन प्रदान करता है।
यहाँ, मैं दोनों तरीकों की रूपरेखा दे रहा हूँ।
यदि आपके पास पहले से AWS GPU की पहुँच है, तो यह तरीका अत्यधिक अनुशंसित है। यह सरल है और ज़्यादा झंझट नहीं है।
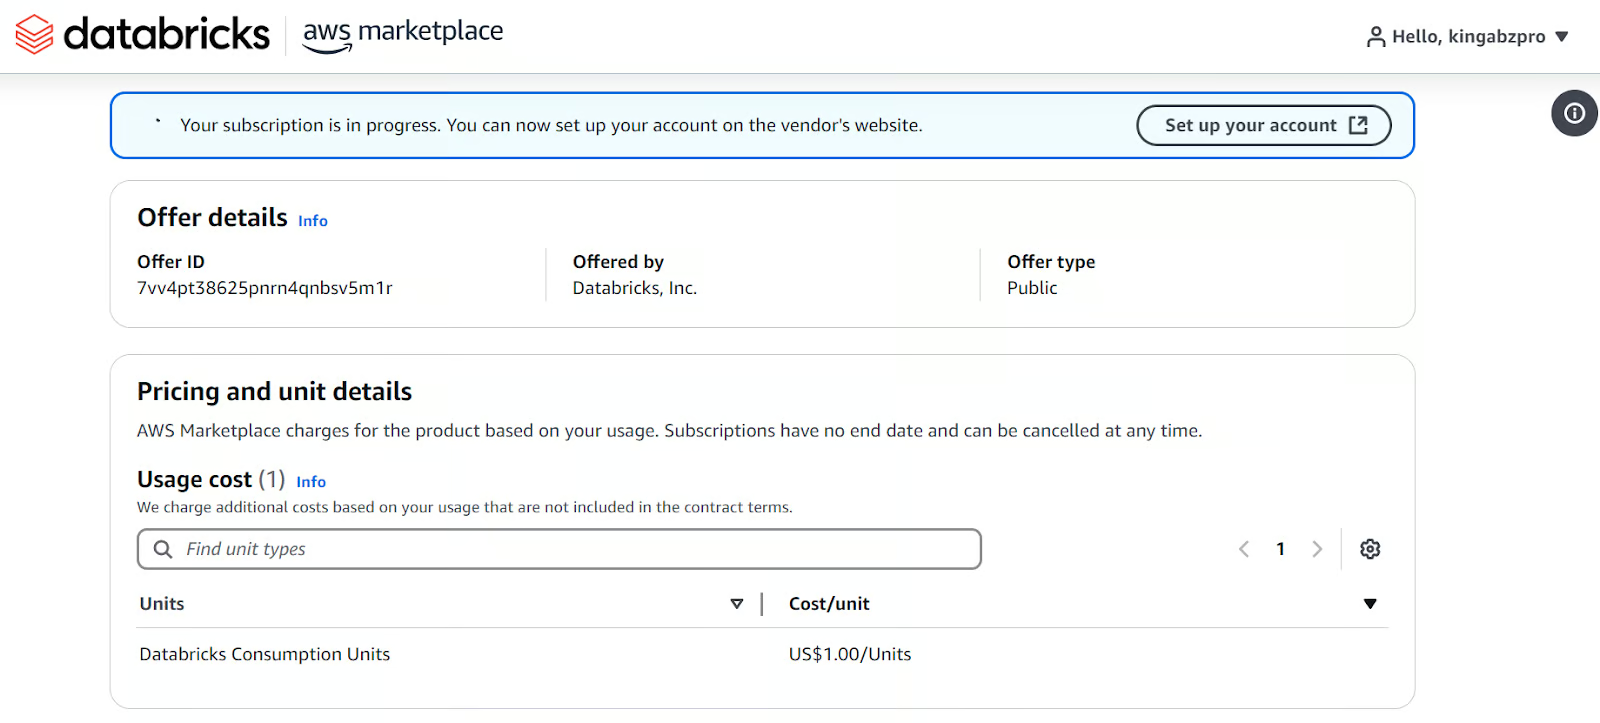
AWS मार्केटप्लेस पर Databricks सेट करना।
इसके बाद, यह आपके लिए विभिन्न विकल्पों के साथ एक Databricks वर्कस्पेस बना देगा। सभी भुगतान AWS बिलिंग के माध्यम से किए जाएंगे।
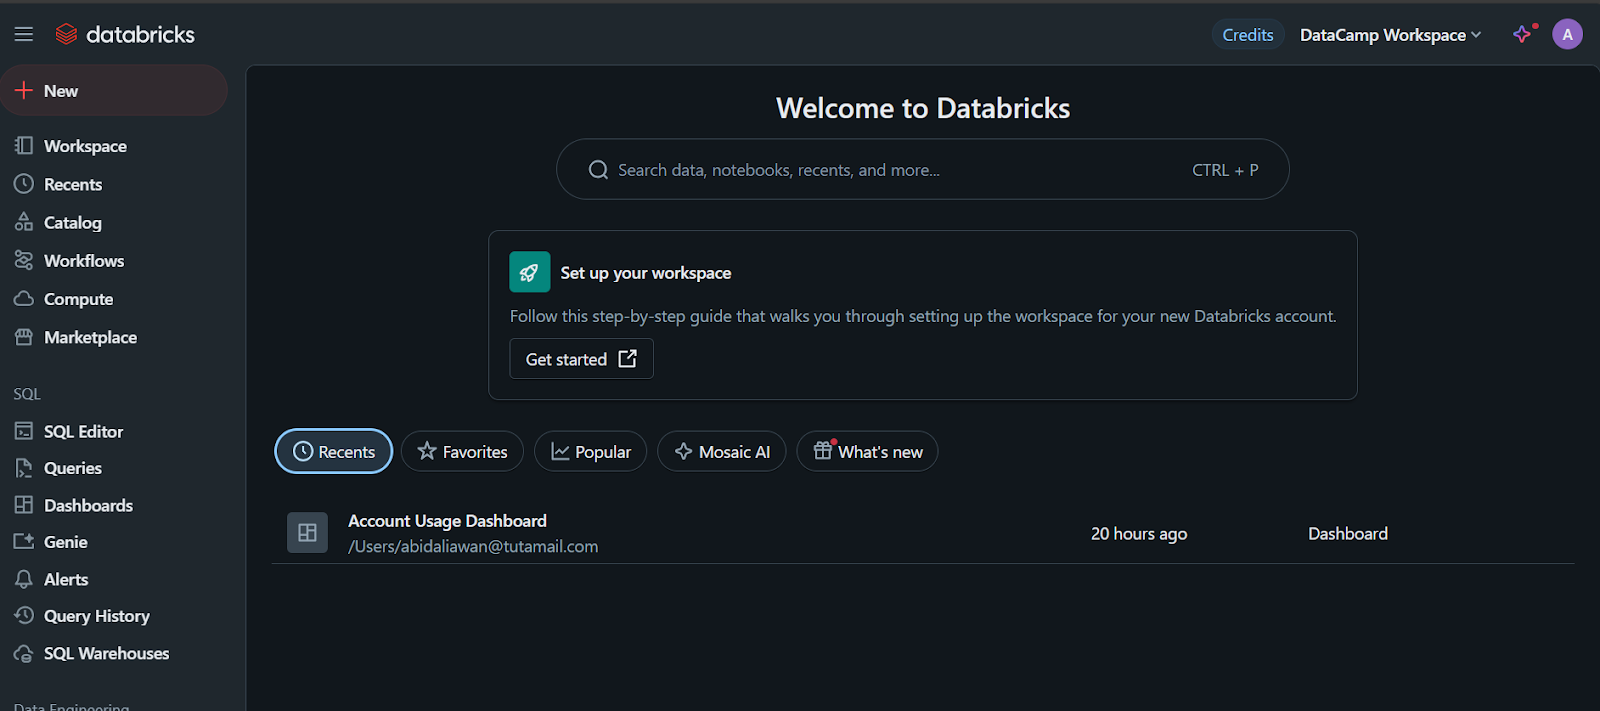
जब आप “Compute” टैब पर क्लिक करते हैं, तो आप अपनी पसंद का कंप्यूट क्लस्टर बना सकते हैं।
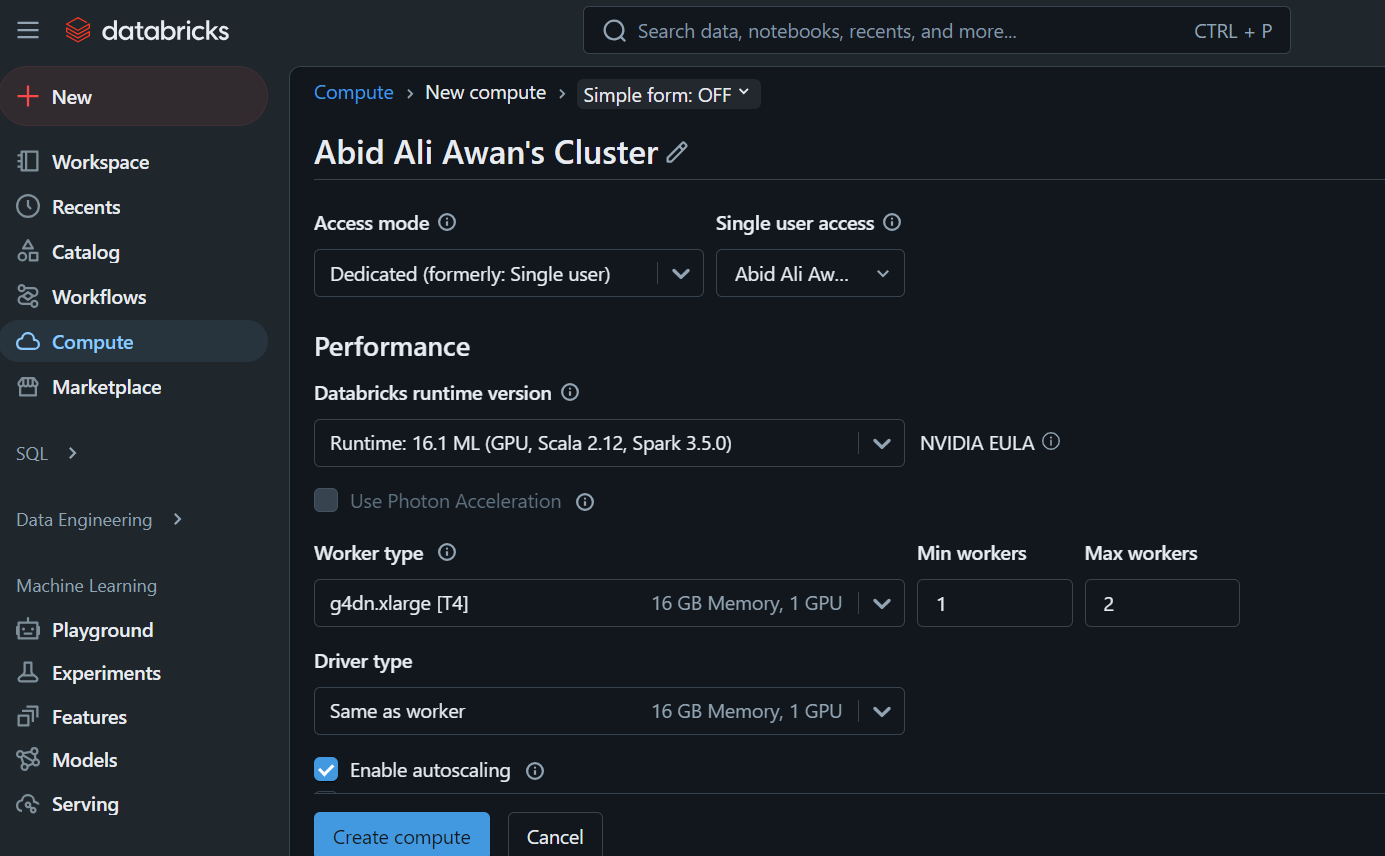
यह क्लस्टर आगे चलकर नोटबुक में और मॉडल डिप्लॉय करने के लिए उपयोग होगा।
यदि आप Databricks के स्टैंडअलोन संस्करण का उपयोग करना पसंद करते हैं क्योंकि आपके पास क्लाउड GPU की पहुंच नहीं है या किसी अन्य कारण से, तो इन चरणों का पालन करें:
कुछ ही सेकंड में आपके लिए वर्कस्पेस और सब कुछ सेट हो जाएगा।
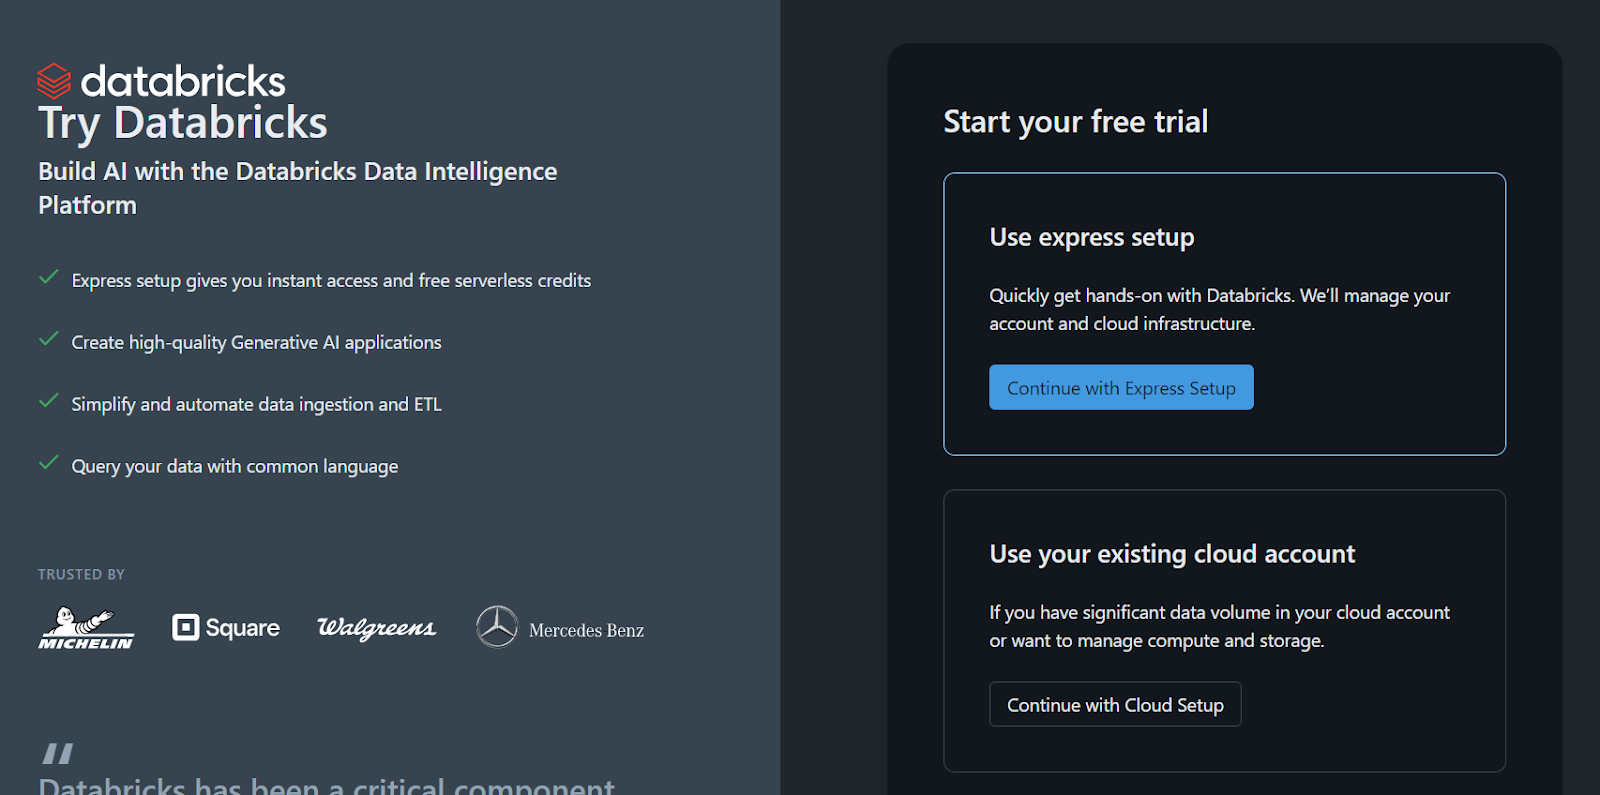
Databricks के स्टैंडअलोन संस्करण के लिए साइन अप करें।
कृपया ध्यान दें, एक कमी है: इस तरीके से आप अपना खुद का कंप्यूट क्लस्टर या GPU क्लस्टर नहीं बना सकते। आप केवल CPU का उपयोग करते हुए नोटबुक में मॉडल रजिस्टर कर सकते हैं, जो एक झंझट हो सकता है जिसे आप टालना चाहेंगे।
यदि आप प्रोडक्शन या शोध सेटिंग में DeepSeek R1 पर काम कर रहे हैं, तो GPU के बजाय CPU का उपयोग करना प्रदर्शन में कमी, मेमोरी सीमाओं और संभावित लागतों के कारण निराशाजनक हो सकता है। अधिक जानें इस CPU vs GPU ब्लॉग पोस्ट में।
अगला चरण मॉडल को रजिस्टर करना है।
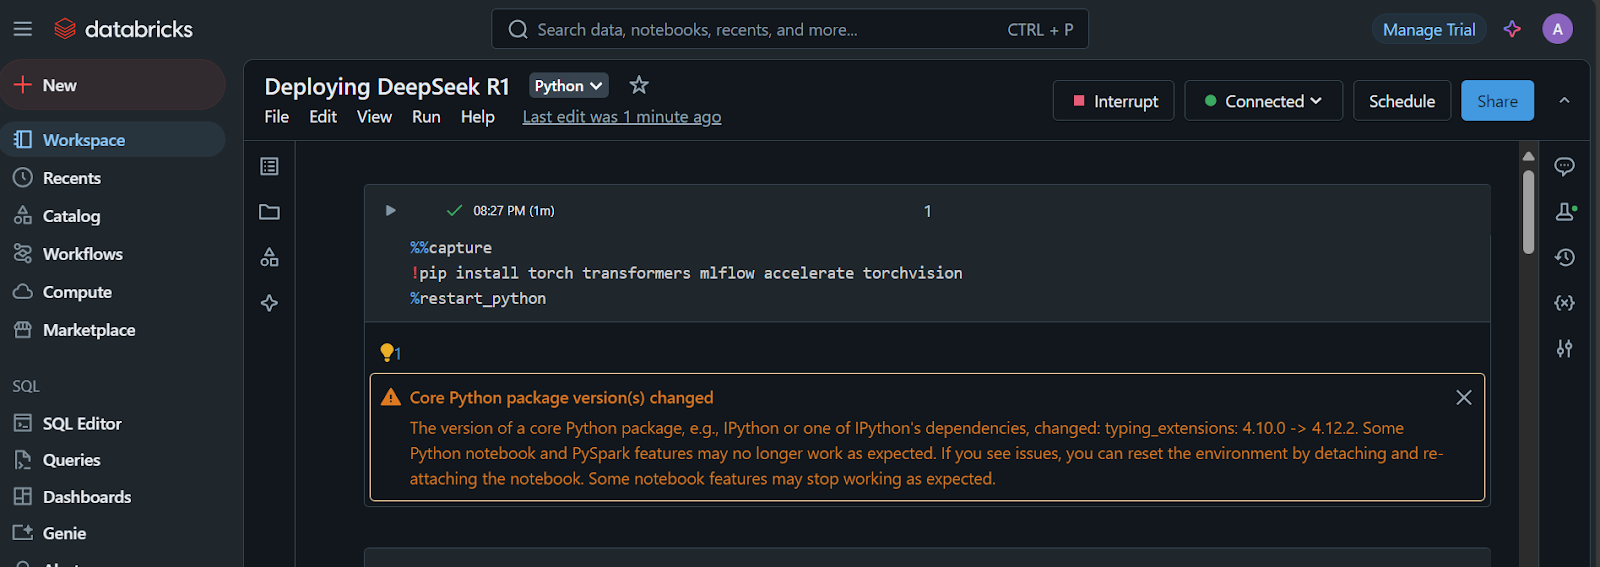
1. आवश्यक Python पैकेज इंस्टॉल करें:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python
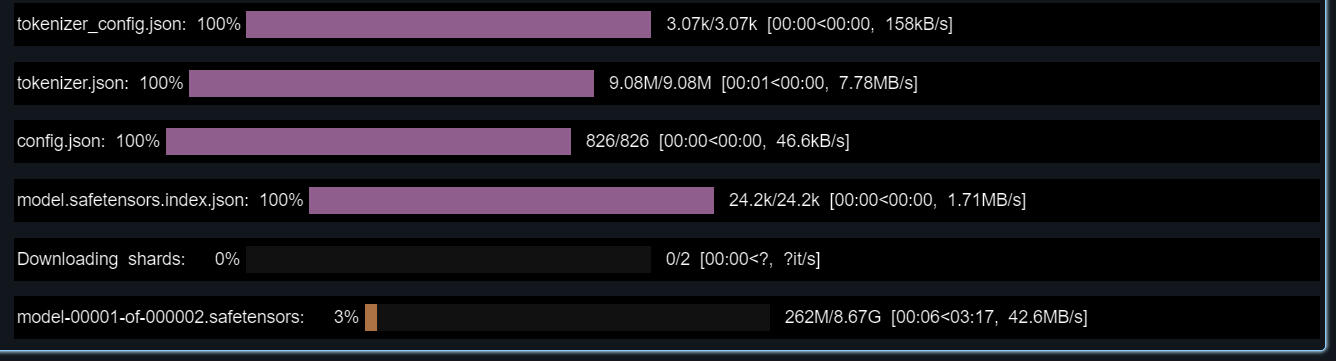
2. Hugging Face रिपॉज़िटरी से टोकन, कॉन्फ़िगरेशन और मॉडल लोड करें:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline


# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"


# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)


model = AutoModelForCausalLM.from_pretrained(
    model_name,
    config=config,
    torch_dtype=torch.float16
)
3. एक नमूना प्रॉम्प्ट देकर लोड किए गए मॉडल का परीक्षण करें।
हम एक सिग्नेचर भी बनाएँगे जिसे मॉडल रजिस्ट्रेशन के दौरान जोड़ेंगे:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)


print(example_outputs)
मॉडल को बेहतरीन तरह से काम करना चाहिए!
मेरे लिए जो आउटपुट आया वह यह है:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. सही Python संस्करण और आवश्यक पैकेजों के साथ conda वातावरण सेट करें।
यह हमें ऐसा कंटेनर बनाने में मदद करेगा जिसमें मॉडल चलाने के लिए सभी आवश्यक टूल हों:
conda_env = {
    "name": "mlflow-env",
    "channels": ["defaults", "conda-forge"],
    "dependencies": [
        "python=3.11",
        "pip",
        {
            "pip": [
                "mlflow",
                "transformers",
                "accelerate",
                "torch",
                "torchvision"
            ]
        }
    ]
}
5. मॉडल रजिस्टर करें
mlflow.transformers.log_model फ़ंक्शन को टेक्स्ट जनरेशन पाइपलाइन, आर्टिफैक्ट पाथ, सिग्नेचर, इनपुट उदाहरण, मॉडल नाम और conda वातावरण प्रदान करें:
with mlflow.start_run() as run:
    mlflow.transformers.log_model(
        transformers_model=text_generator,
        artifact_path="deepseek_model",
        signature=signature,
        input_example=example_inputs,
        registered_model_name="deepseek_r1_llama_8b",
        conda_env=conda_env
    )
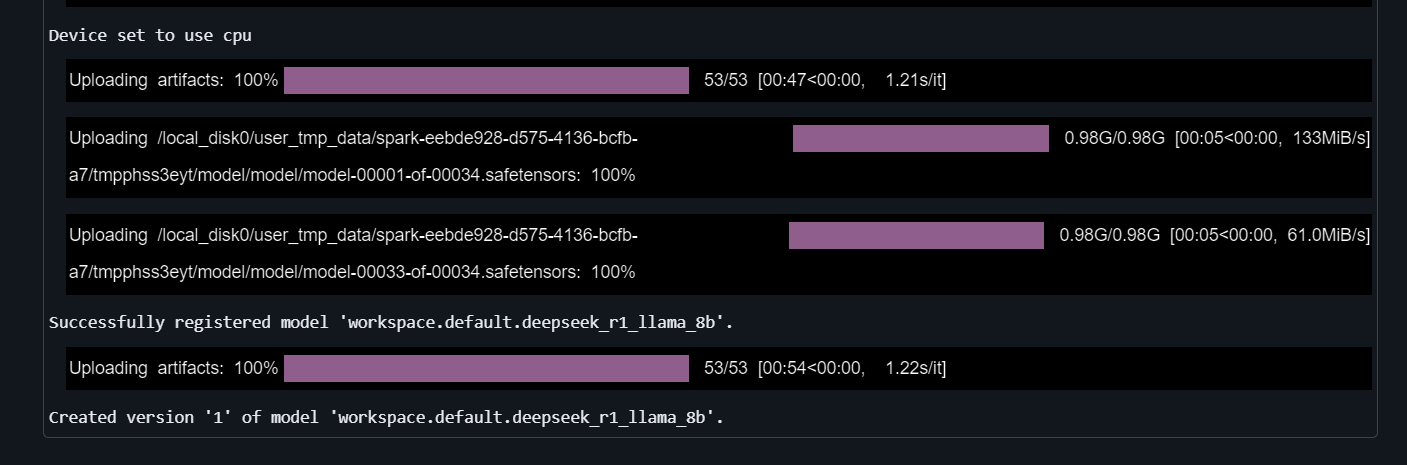
मॉडल को रजिस्टर होने में कुछ मिनट लगेंगे।
Databricks Lakehouse की शक्ति के बारे में जानें और अपने डेटा इंजीनियरिंग और मशीन लर्निंग कौशल को निखारें Data Management in Databricks कोर्स करके।
अब मॉडल डिप्लॉय करने का समय है!
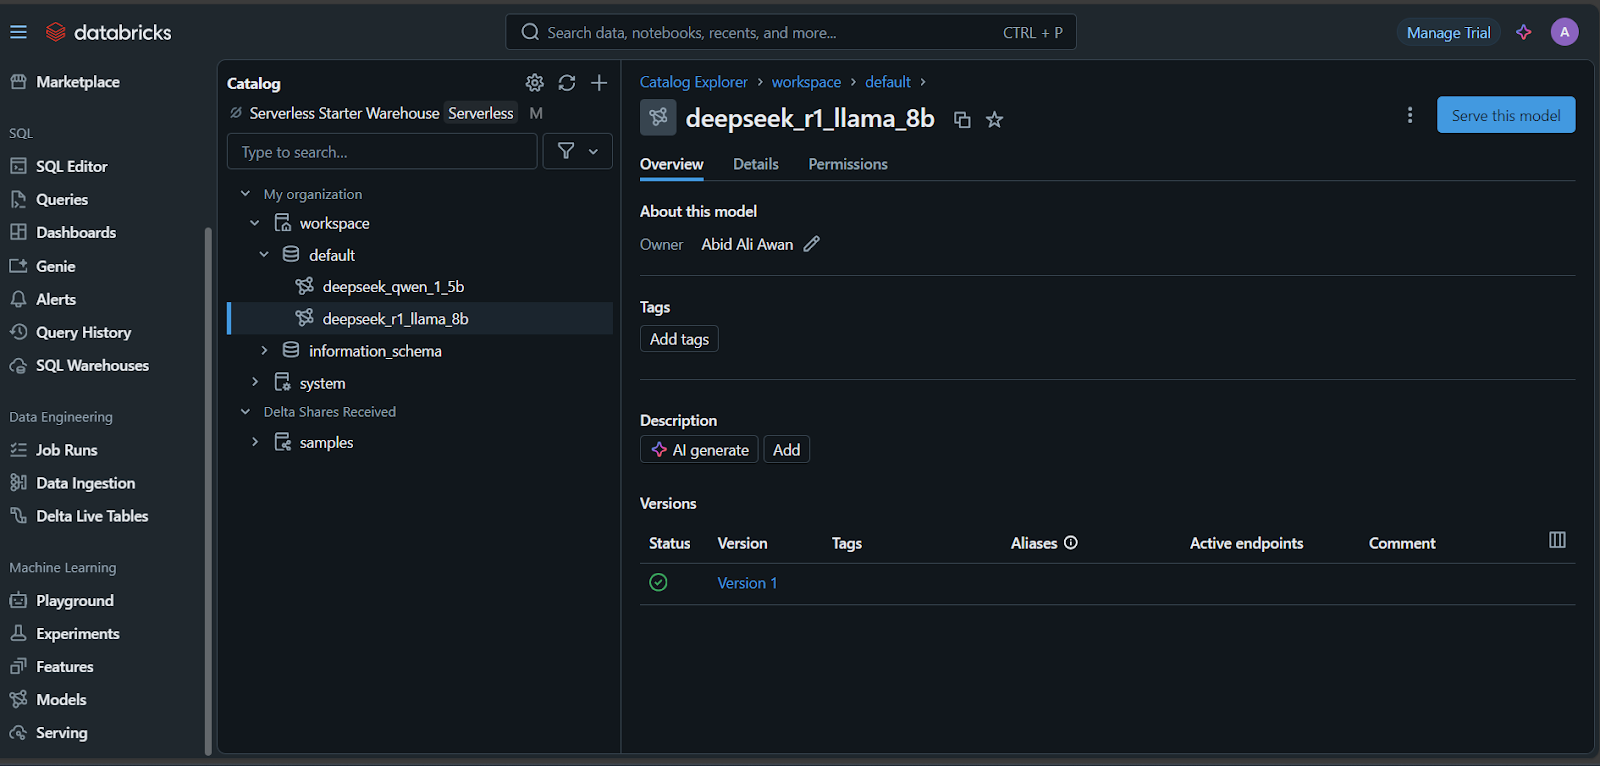
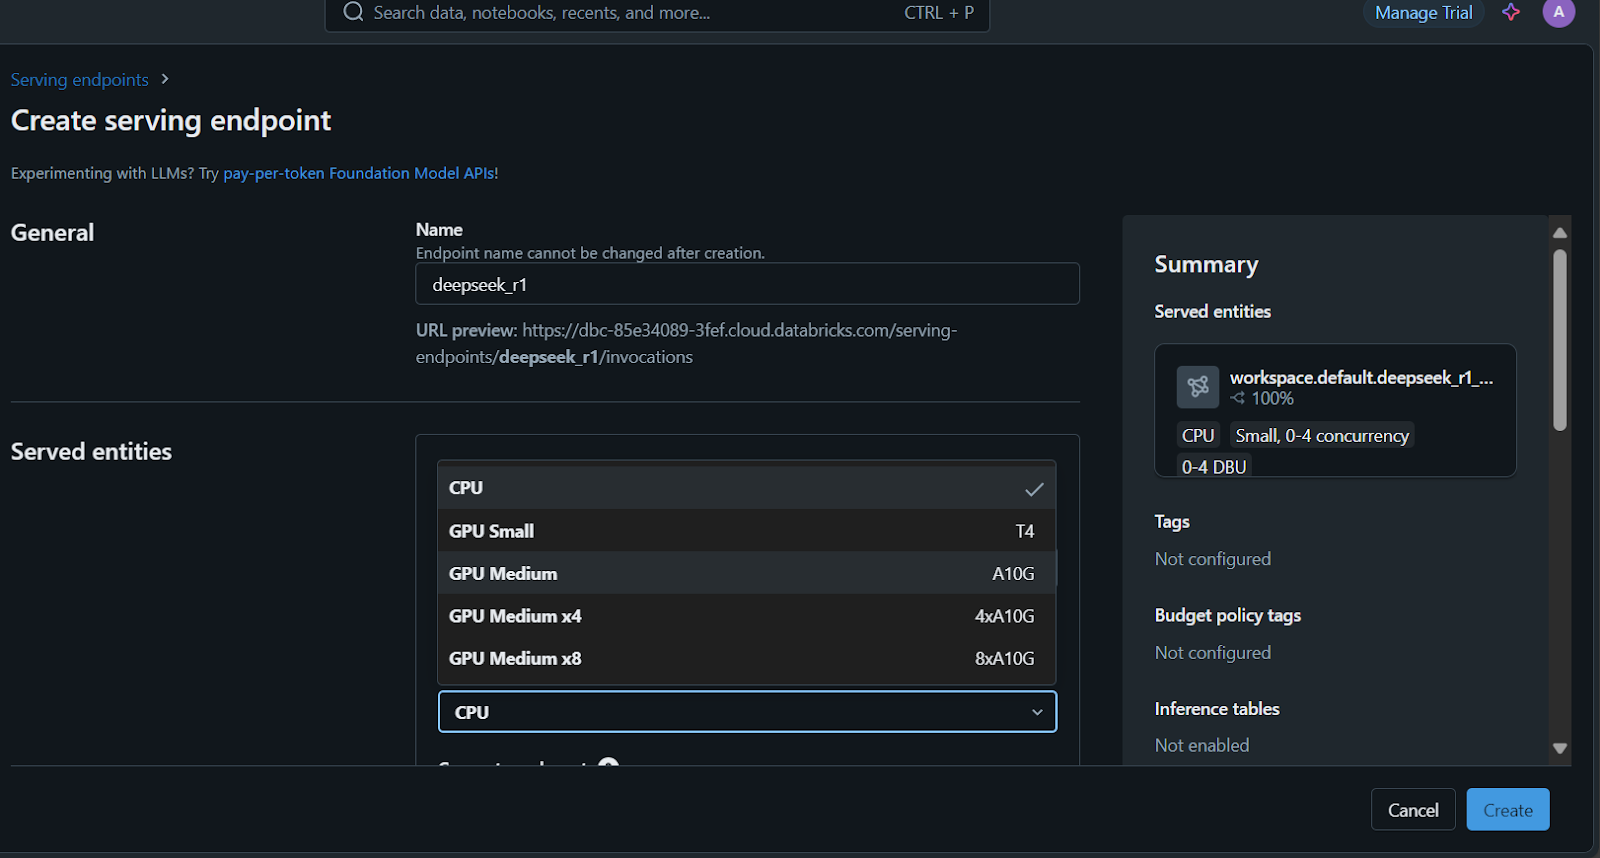
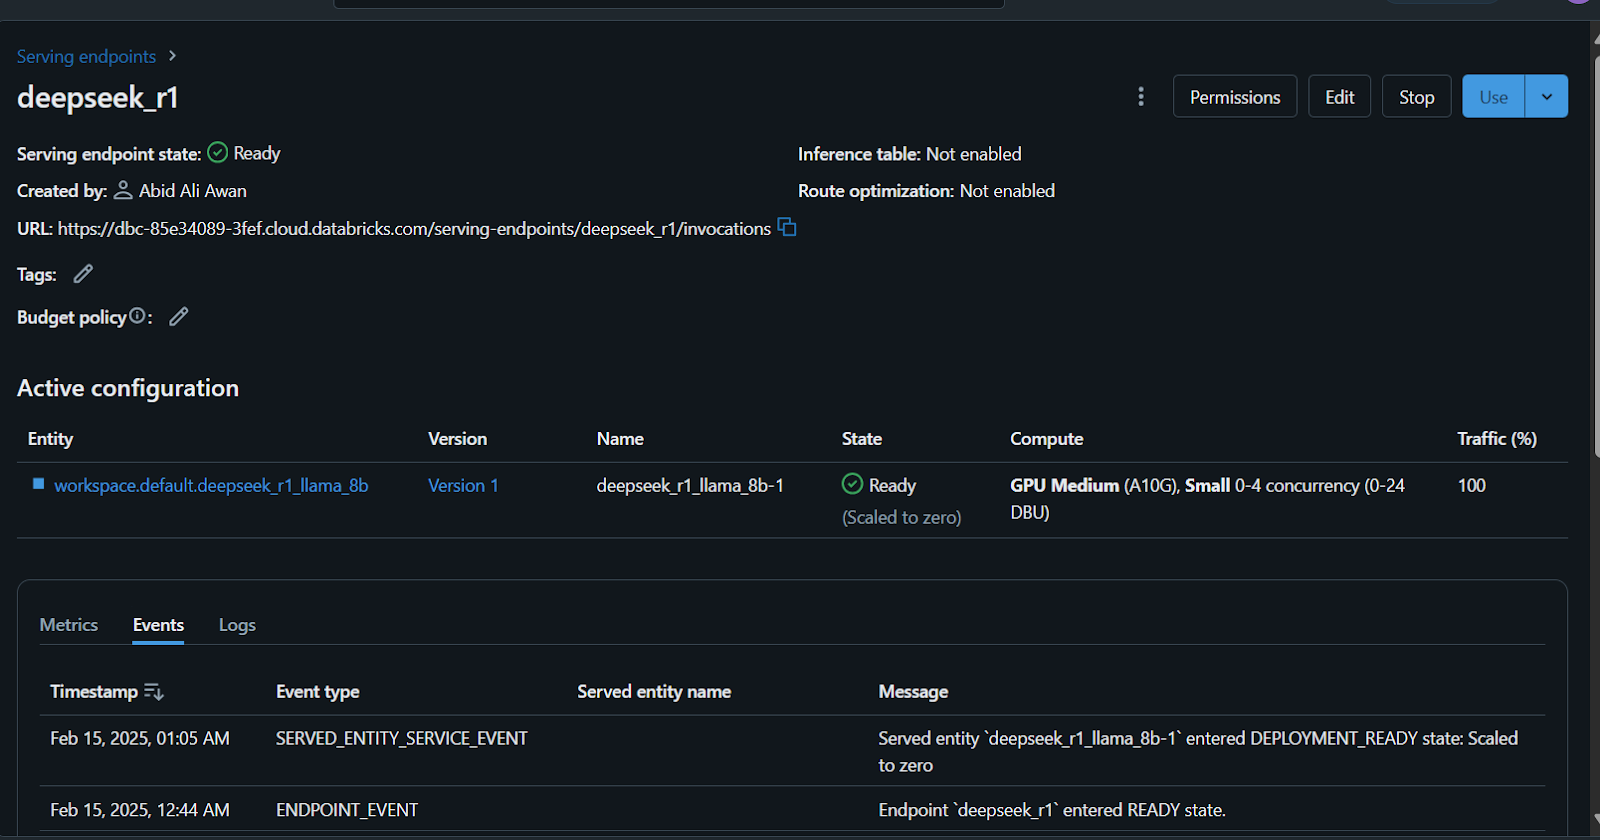
सर्विंग एंडपॉइंट सेट करने में कुछ मिनट लगेंगे। सेटअप पूरा होने पर स्टेटस हरा हो जाएगा और “Ready” दिखाएगा।
इसके अतिरिक्त, आप मॉडल रजिस्टर करने से पहले कस्टम डेटासेट पर DeepSeek R1 को फाइन-ट्यून कर सकते हैं। इस प्रक्रिया के बारे में सब कुछ जानने के लिए Fine-Tuning DeepSeek R1 ट्यूटोरियल देखें।
इस मॉडल तक पहुँचने या उपयोग करने के कई तरीके हैं।
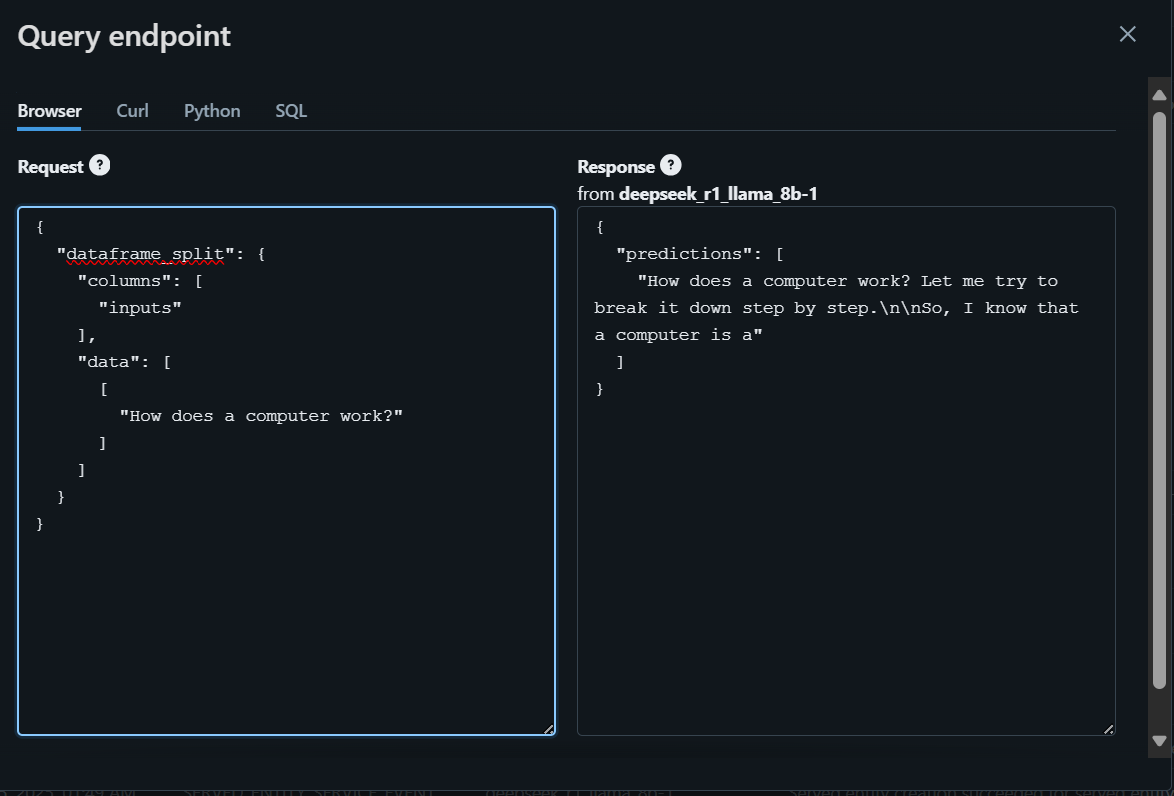
शुरुआत करने के लिए, हम ब्राउज़र का उपयोग करते हुए प्रश्न लिखेंगे और प्रतिक्रिया जेनरेट करेंगे।
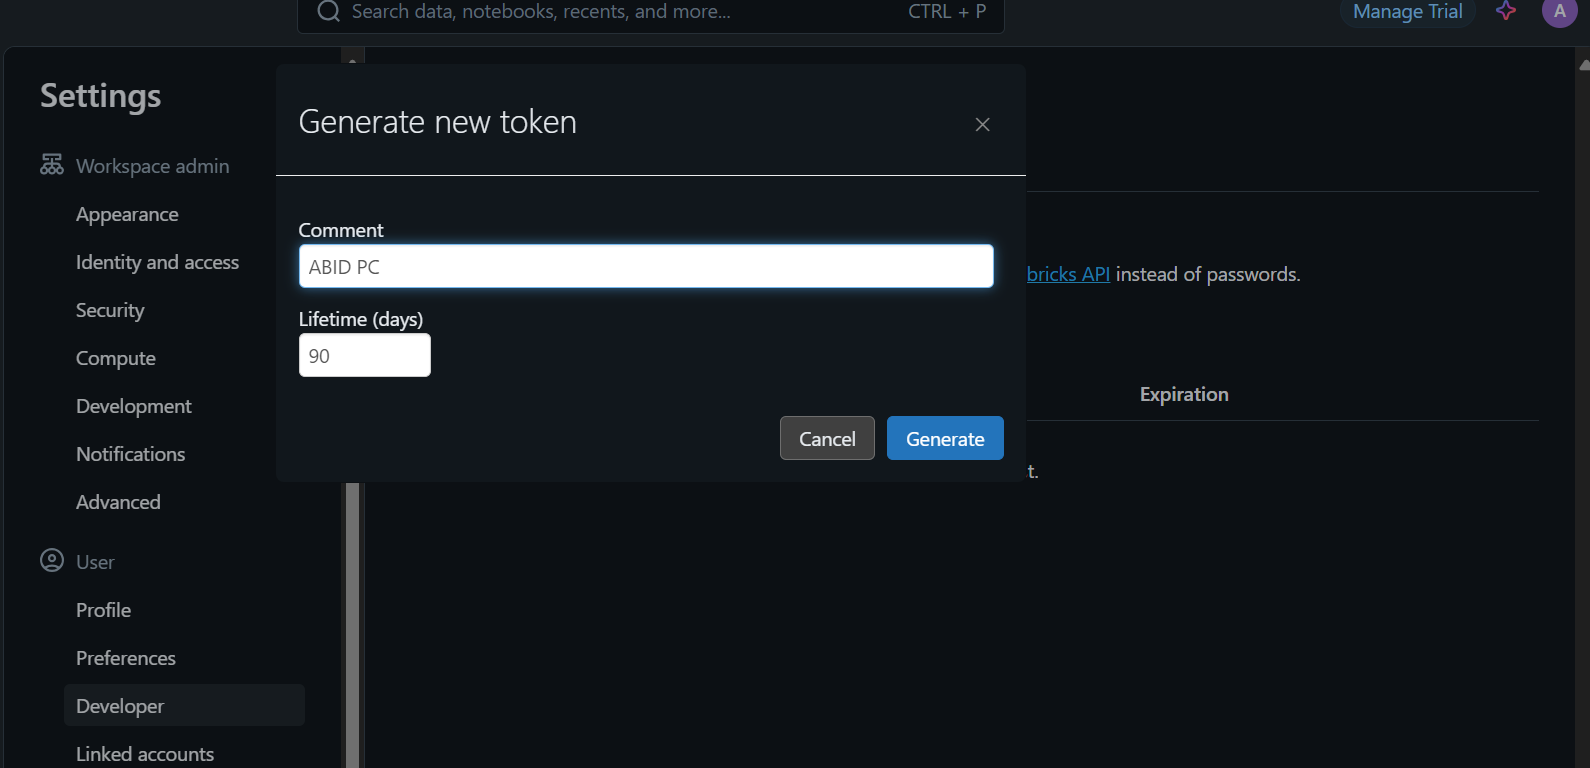
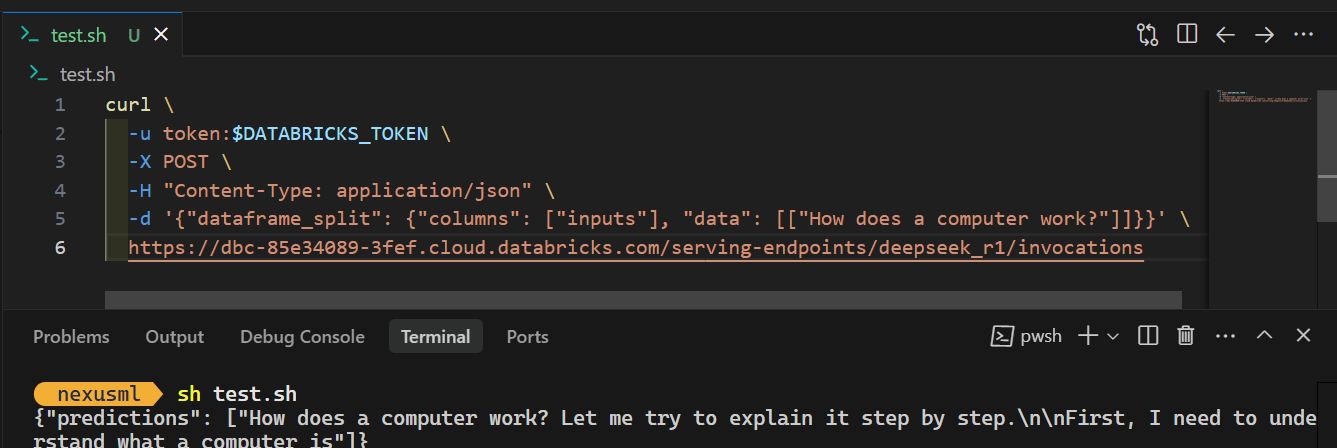
मॉडल को लोकली एक्सेस करने या अपनी एप्लिकेशन में इंटीग्रेट करने के लिए, आपको पहले Databricks API कुंजी जनरेट करनी होगी।
curl \
  -u token:$DATABRICKS_TOKEN \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
  https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocations
जब आप कमांड चलाते हैं, तो प्रतिक्रिया जेनरेट होने में कुछ सेकंड लगेंगे। इतना ही सरल!
DeepSeek के सर्वोत्तम बड़े भाषा मॉडलों के बारे में जानने के लिए DeepSeek R1 vs V3 ब्लॉग देखें।
Databricks पर DeepSeek R1 मॉडल को रजिस्टर और डिप्लॉय करना सीधा-सादा है। आप बड़े मॉडल को भी CPU क्लस्टर या लोकल CPU मशीन का उपयोग करके—बिना किसी लागत के—रजिस्टर और डिप्लॉय कर सकते हैं। हालांकि, CPU पर मॉडल चलाना धीमा हो सकता है और विशेषकर डॉकर इमेज बनाते समय धैर्य की ज़रूरत होती है।
इस ट्यूटोरियल में, हमने पूरे मॉडल डिप्लॉयमेंट प्रोसेस को चरणबद्ध तरीके से कवर किया। हमने Databricks सेटअप करने और Databricks Model Registry में प्री-ट्रेंड DeepSeek Distilled R1 मॉडल रजिस्टर करने से शुरुआत की। फिर, Databricks डैशबोर्ड का उपयोग कर मॉडल को डिप्लॉय किया। अंत में, डिप्लॉय किए गए मॉडल का परीक्षण किया और एक सरल CURL कमांड के साथ इसे लोकली उपयोग करने का तरीका दिखाया।
यदि आप AI और बड़े भाषा मॉडलों में नए हैं, तो मैं Introduction to LLMs in Python कोर्स करने की सलाह देता/देती हूँ। यह आपको ठोस बुनियाद देगा, प्रमुख शब्दावली समझने में मदद करेगा, और DeepSeek R1 जैसे उन्नत मॉडलों पर काम शुरू करने में सहायक होगा!
इन कोर्सेज़ के साथ Databricks के बारे में और जानें!
कोर्स
कोर्स
कोर्स