
Last chance! 50% off DataCamp Premium
Sale ends in
Databricks uzun süredir veri mühendisliği topluluğunun favorisi ve artık yeteneklerini yapay zeka (AI) ve makine öğrenimi (ML) alanlarına doğru istikrarlı bir şekilde genişletiyor. Bu evrim sayesinde modelleri eğitebilir, deneyleri takip edebilir, modelleri kaydedebilir ve hepsini aynı birleşik platformda Databricks uç noktalarına dağıtabilirsiniz. Bu entegrasyon iş akışlarını basitleştirir ve Databricks’i hem veri hem de AI profesyonelleri için güçlü bir araç haline getirir.
Databricks’e yeniyseniz, Databricks Lakehouse platformunu öğrenmek için Introduction to Databricks kursunu almayı düşünün. Bu kurs, Databricks’in veri mimarilerini nasıl modernize edebileceğini ve veri yönetim süreçlerini nasıl iyileştirebileceğini anlamanıza yardımcı olacaktır.
Bu eğitimde, Databricks üzerinde DeepSeek R1 modelinin dağıtık sürümünü dağıtma sürecini adım adım göstereceğim. DeepSeek R1 ciddi bir popülerlik kazanıyor; birçok şirket, verilerini harici sunuculara göndermek yerine modeli kendi bulut altyapılarında çalıştırmayı tercih ediyor.
Bu rehber, bir Databricks hesabı kurmanıza, DeepSeek R1 modelini kaydetmenize, kullanıcı arayüzünü kullanarak dağıtmanıza ve hem playground üzerinden hem de yerelde CURL komutuyla erişmenize yardımcı olacaktır.
Özellikleri, geliştirme süreci, damıtılmış modelleri, fiyatlandırması ve OpenAI’nin sundukları gibi diğer AI modelleriyle karşılaştırması dahil DeepSeek R1 hakkında daha fazla bilgi edinmek için DeepSeek-R1: Features, Comparison, Distilled Models & More blog yazısına göz atın.
Databricks’i kullanmanın iki kolay yolu vardır. GCP, AWS veya Azure Marketplace’e gidip Databricks hizmetine abone olabilirsiniz. Alternatif olarak, kendi hesap kümelerini oluşturmanız gerekmeksizin size bazı hesaplama kaynakları sağlayan bağımsız bir Databricks hesabına kaydolabilirsiniz.
Burada bu iki yolu özetliyorum.
Halihazırda bir AWS GPU erişiminiz varsa bu yöntem şiddetle önerilir. Basittir ve çok fazla zahmet gerektirmez.
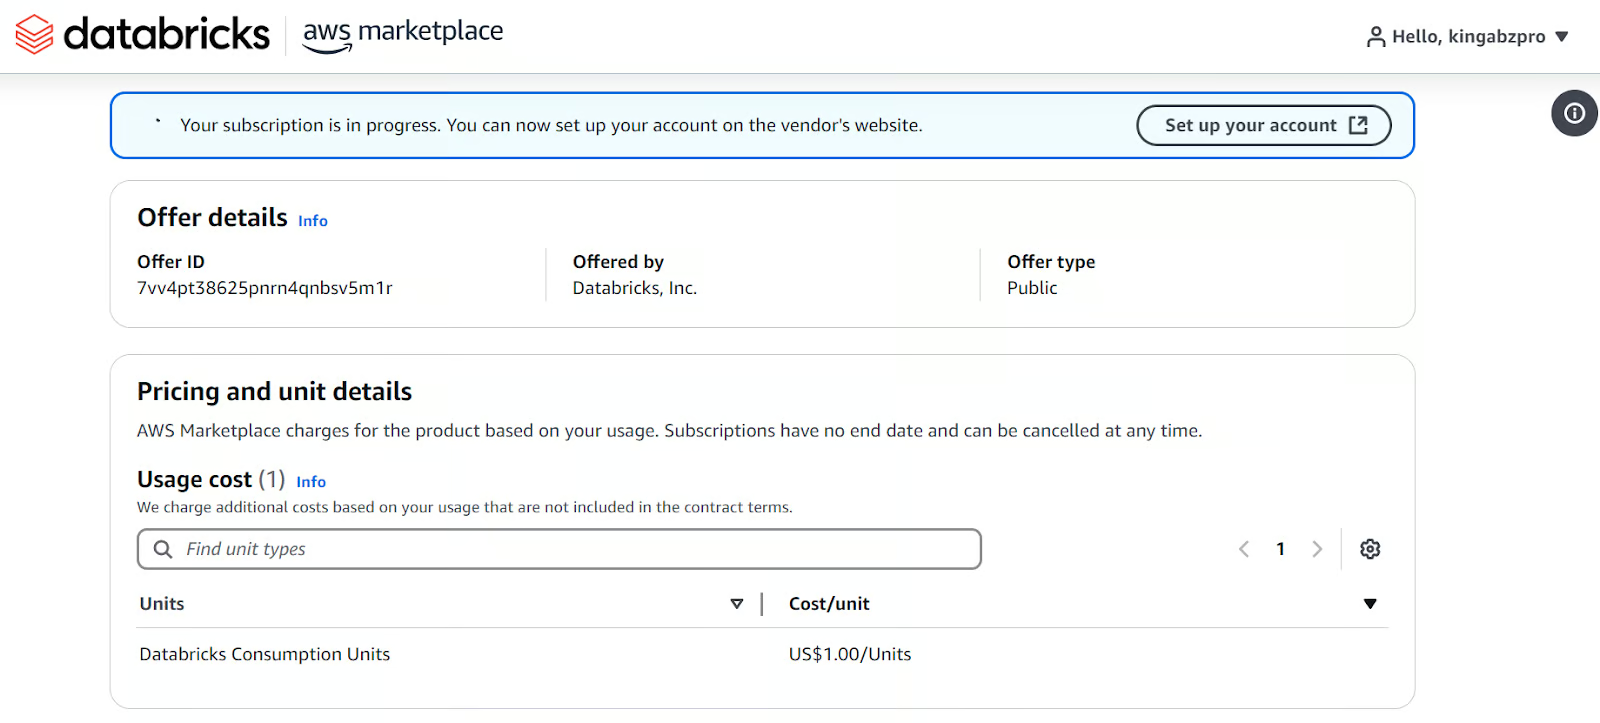
AWS Marketplace üzerinde Databricks kurulumu.
İşlemi tamamladığınızda, sizin için her türlü seçeneğiyle bir Databricks çalışma alanı oluşturulacaktır. Tüm ödemeler AWS faturalandırması üzerinden yapılacaktır.
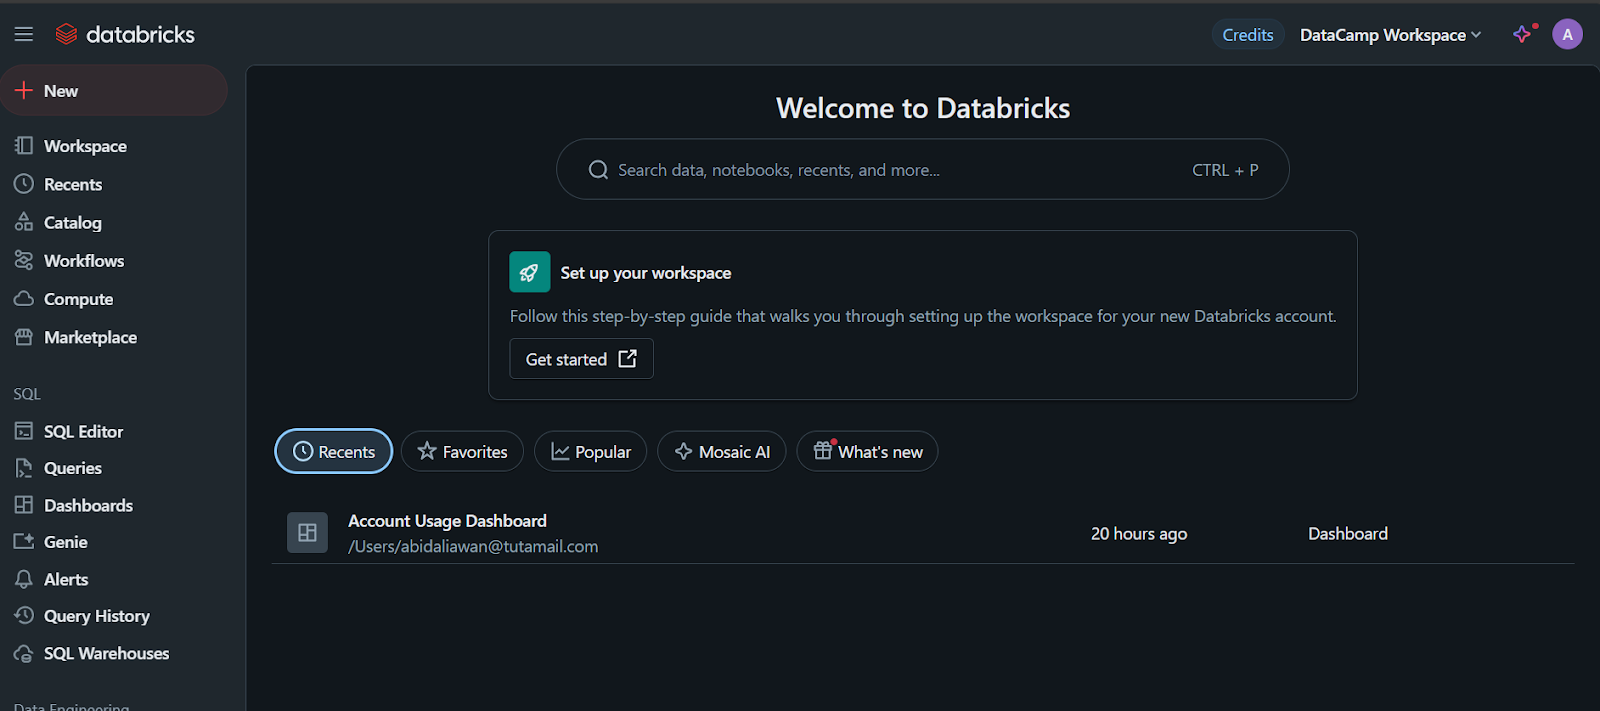
“Compute” sekmesine tıkladığınızda, dilediğiniz hesaplama kümesini oluşturabilirsiniz.
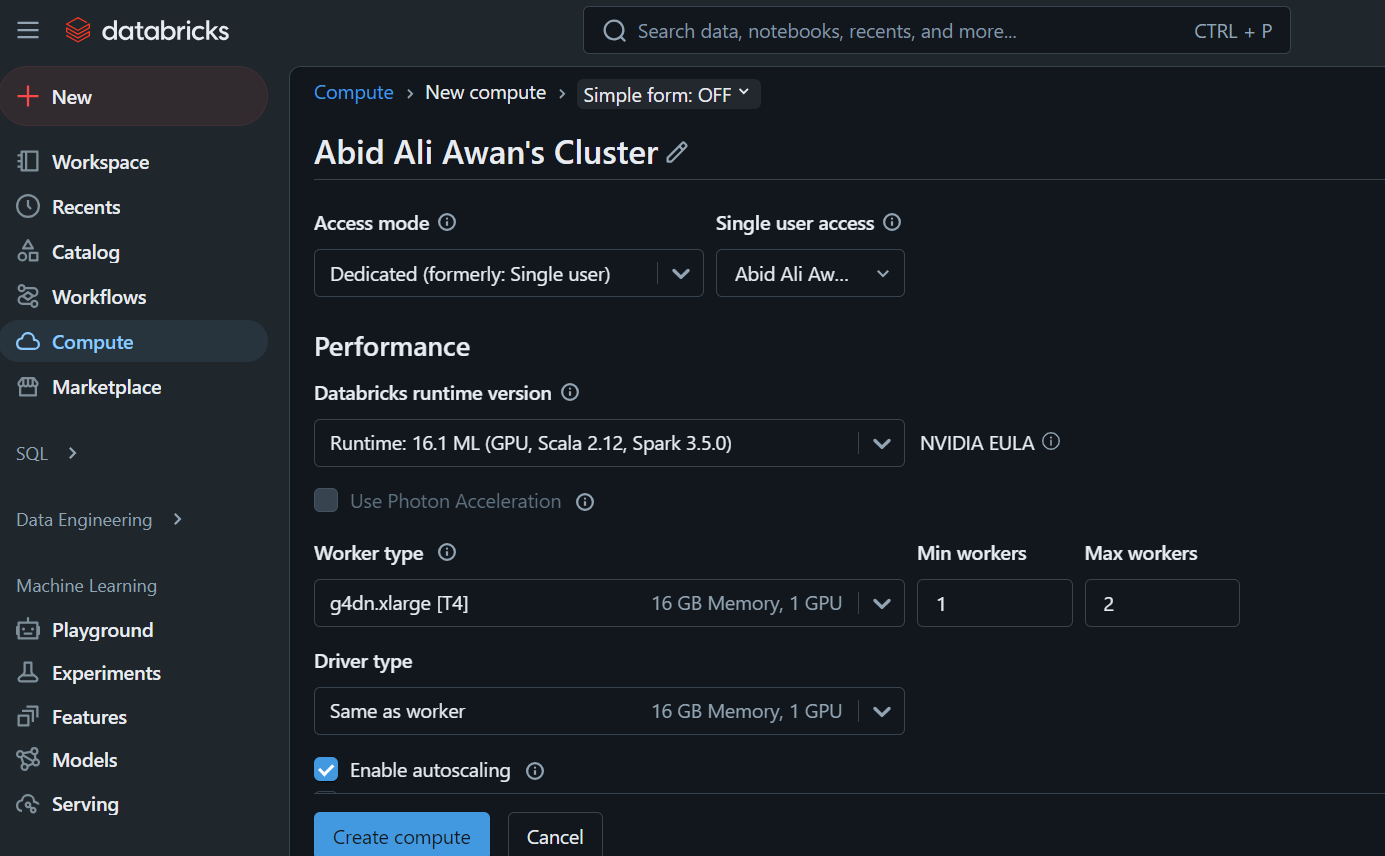
Bu küme, ileride bir not defterinde ve modeli dağıtmak için kullanılacaktır.
Eğer bir bulut GPU’suna erişiminiz olmadığı ya da başka bir nedenle Databricks’in bağımsız sürümünü kullanmayı tercih ediyorsanız, şu adımları izleyin:
Çalışma alanı ve diğer her şey birkaç saniye içinde sizin için kurulacaktır.
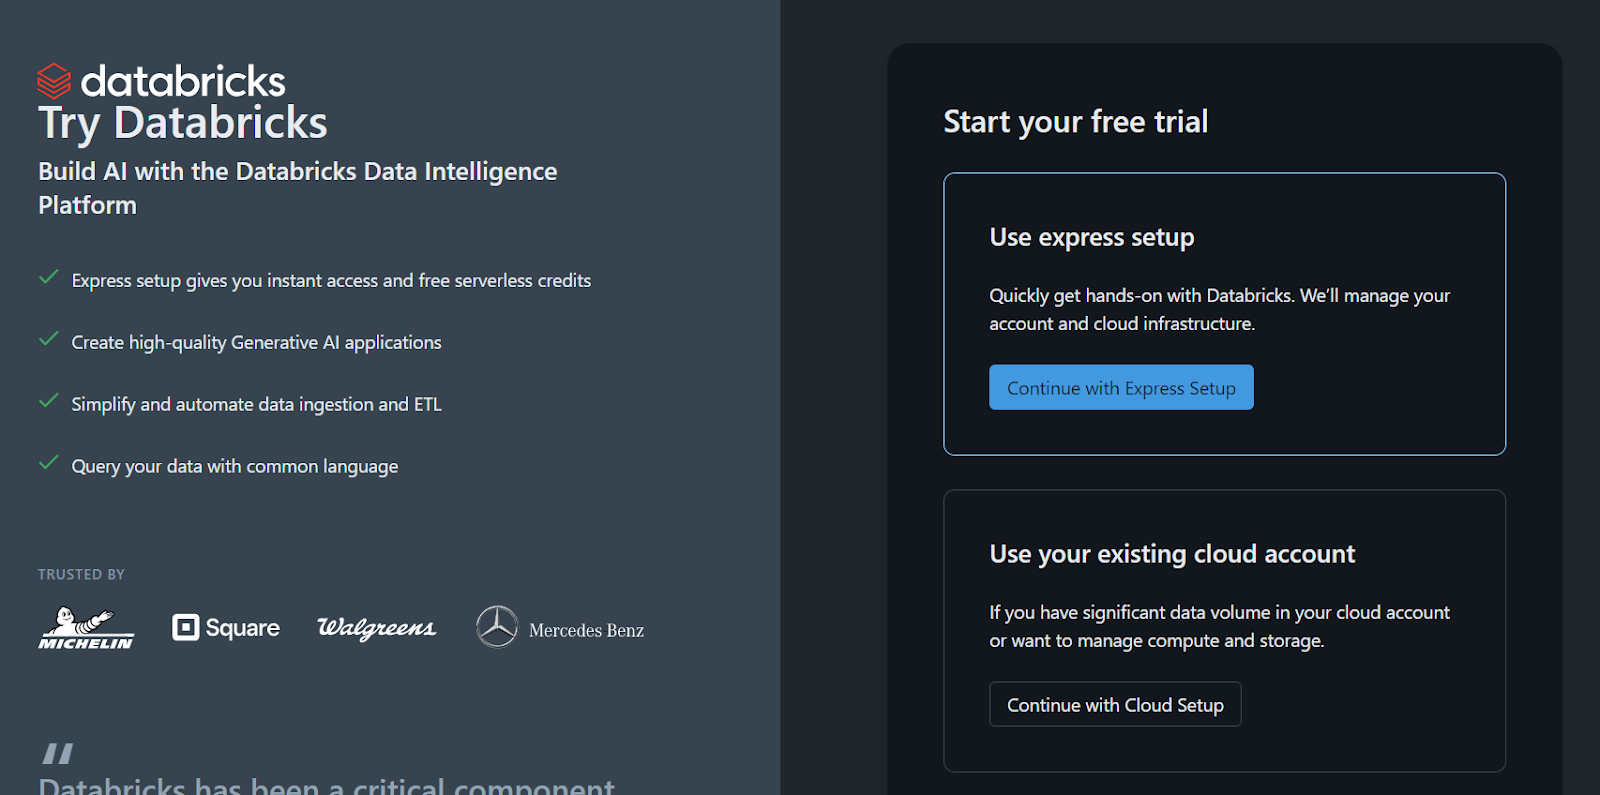
Databricks’in bağımsız sürümüne kaydolun.
Lütfen dikkat: küçük bir pürüz var: Bu yöntemle kendi hesaplama kümenizi veya GPU kümenizi oluşturamazsınız. Yalnızca bir not defterinde CPU kullanarak modeli kaydedebilirsiniz; bu da kaçınmak isteyebileceğiniz bir zahmet olabilir.
DeepSeek R1 ile üretim ya da araştırma ortamında çalışıyorsanız, GPU yerine CPU kullanmak performans düşüşü, bellek sınırlamaları ve potansiyel maliyetler nedeniyle can sıkıcı olabilir. Daha fazlası için CPU vs GPU blog yazısını okuyun.
Sıradaki adım modeli kaydetmektir.
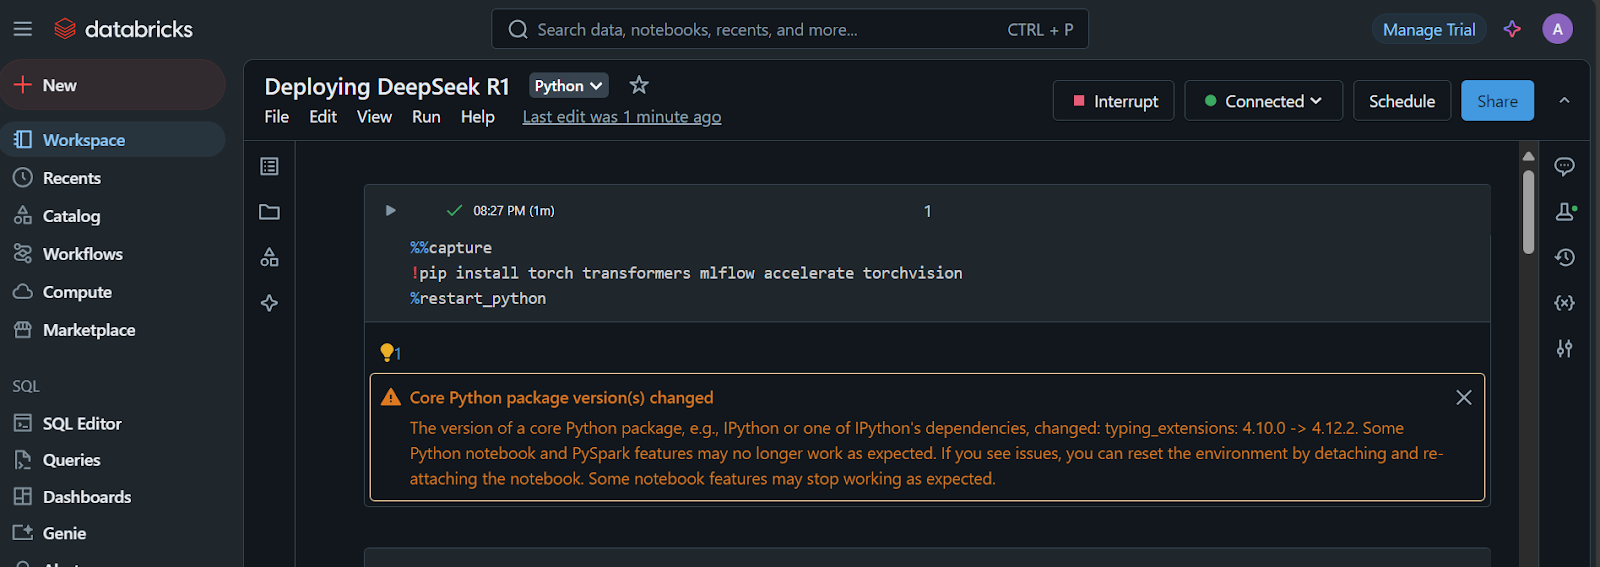
1. Gerekli Python paketlerini yükleyin:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python
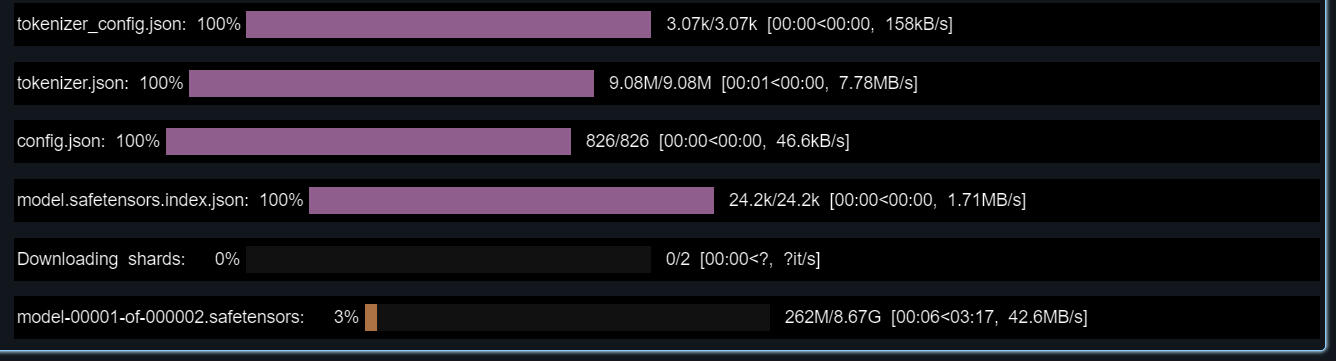
2. Hugging Face deposundan belirteçleri, yapılandırmaları ve modeli yükleyin:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline


# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"


# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)


model = AutoModelForCausalLM.from_pretrained(
    model_name,
    config=config,
    torch_dtype=torch.float16
)
3. Yüklenen modeli örnek bir istem vererek test edin.
Model kaydı sırasında ekleyeceğimiz bir imza da oluşturacağız:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)


print(example_outputs)
Model mükemmel şekilde çalışıyor olmalı!
Benim için gösterdiği çıktı şöyleydi:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. Doğru Python sürümü ve gerekli Python paketleriyle conda ortamını ayarlayın.
Bu, modeli çalıştırmak için gerekli tüm araçlara sahip kapsayıcıyı oluşturmamıza yardımcı olacaktır:
conda_env = {
    "name": "mlflow-env",
    "channels": ["defaults", "conda-forge"],
    "dependencies": [
        "python=3.11",
        "pip",
        {
            "pip": [
                "mlflow",
                "transformers",
                "accelerate",
                "torch",
                "torchvision"
            ]
        }
    ]
}
5. Modeli kaydedin
mlflow.transformers.log_model fonksiyonuna metin üretim hattını, artefakt yolunu, imzayı, örnek girdiyi, model adını ve conda ortamını verin:
with mlflow.start_run() as run:
    mlflow.transformers.log_model(
        transformers_model=text_generator,
        artifact_path="deepseek_model",
        signature=signature,
        input_example=example_inputs,
        registered_model_name="deepseek_r1_llama_8b",
        conda_env=conda_env
    )
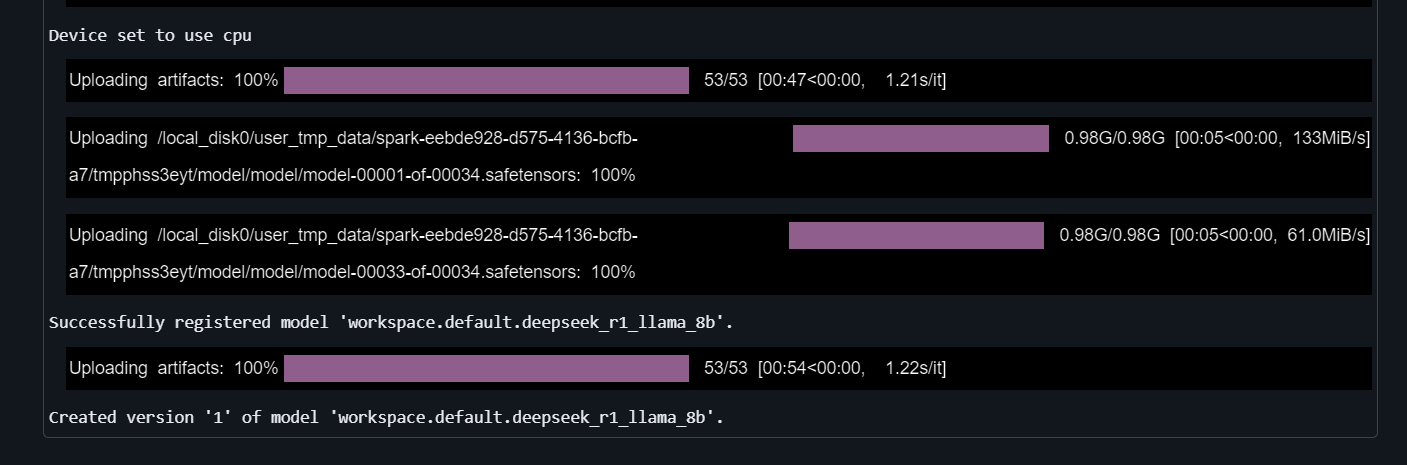
Modelin kaydedilmesi birkaç dakika sürecektir.
Databricks Lakehouse’un gücünü öğrenin ve veri mühendisliği ile makine öğrenimi becerilerinizi geliştirmek için Data Management in Databricks kursunu alın.
Modeli dağıtma zamanı!
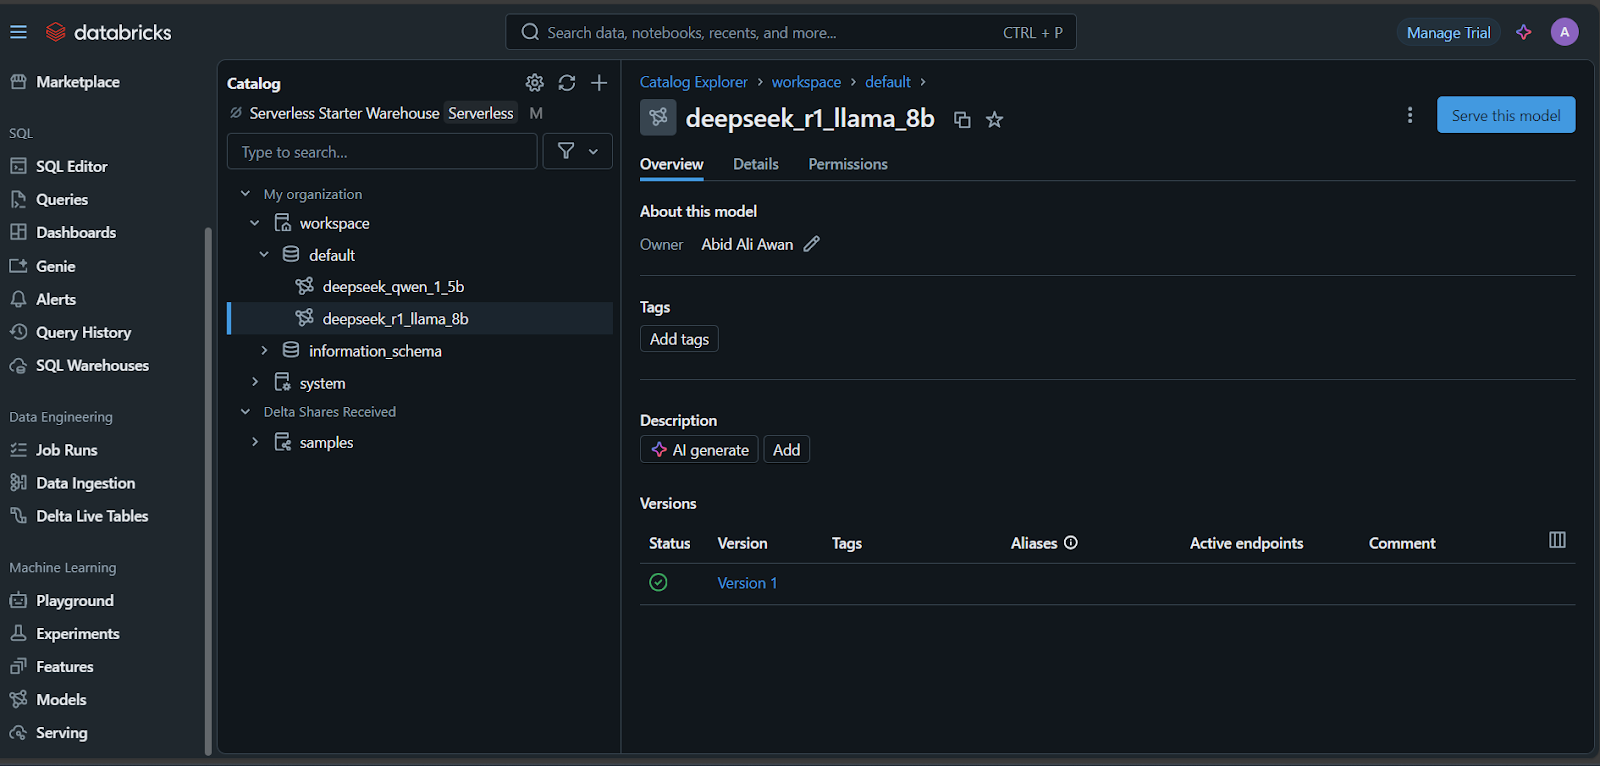
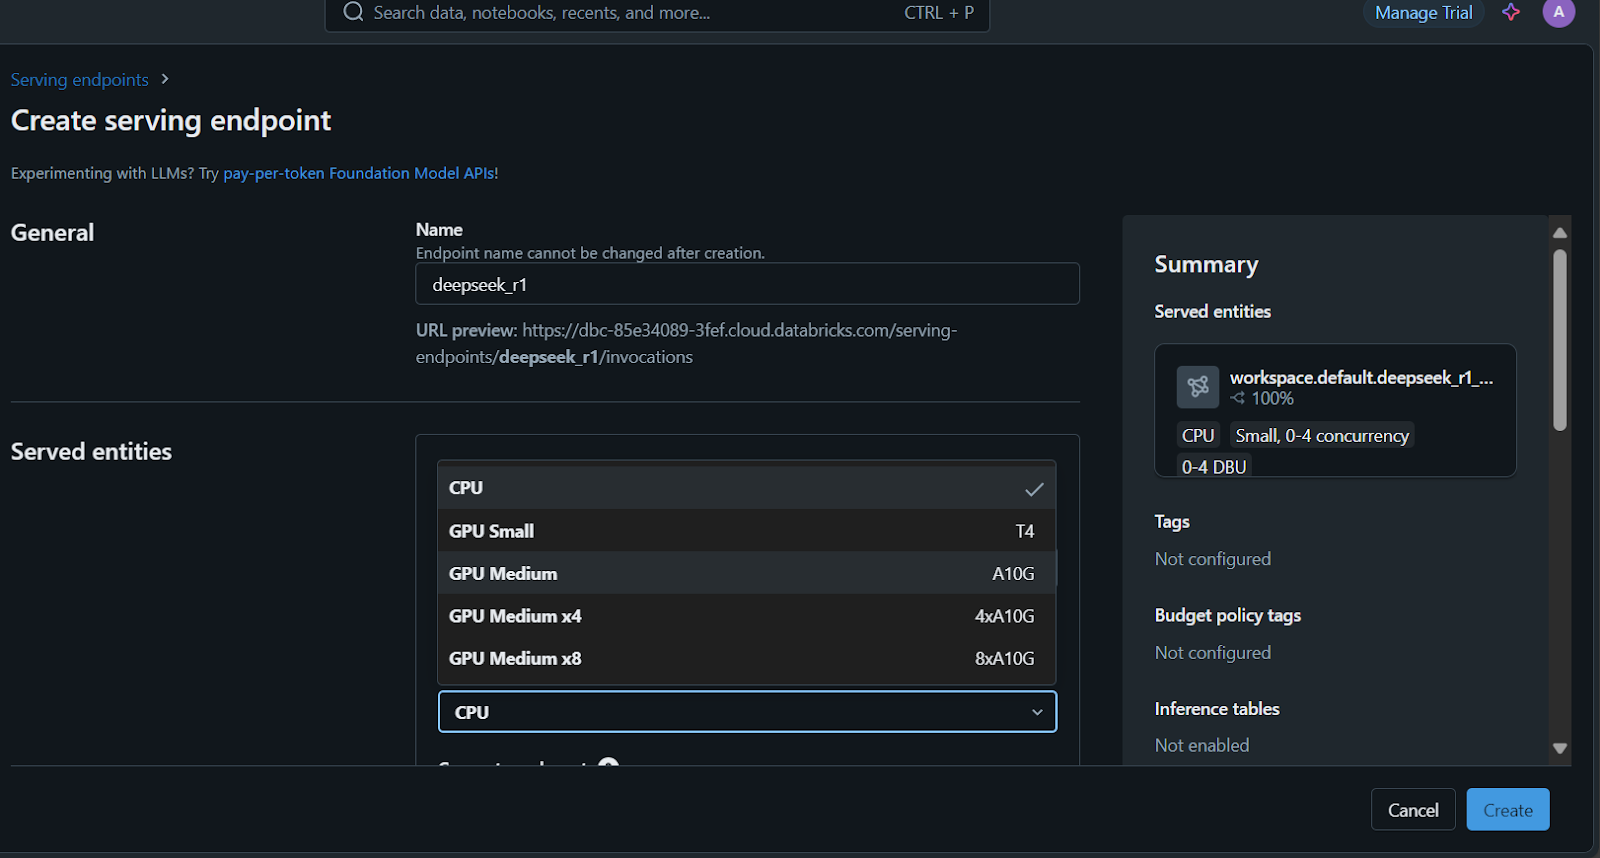
Sunum uç noktasının kurulması birkaç dakika sürecektir. Kurulum tamamlandığında durum yeşile döner ve “Ready” gösterilir.
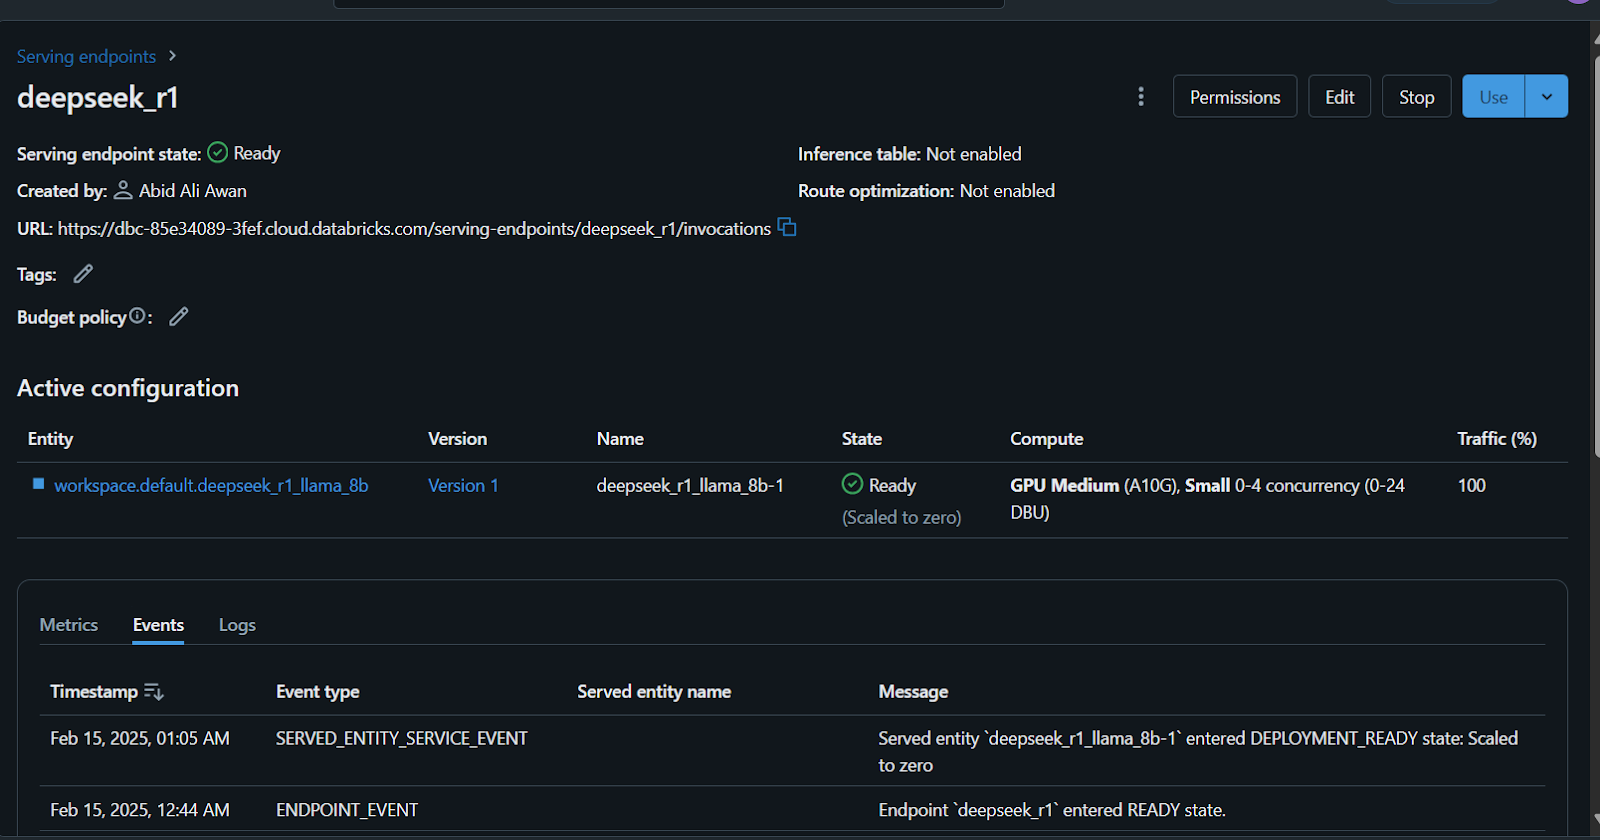
Ayrıca, modeli kaydetmeden önce DeepSeek R1’ı özel bir veri kümesi üzerinde ince ayar yapabilirsiniz. Bu sürecin tüm ayrıntılarını öğrenmek için Fine-Tuning DeepSeek R1 eğitimini izleyin.
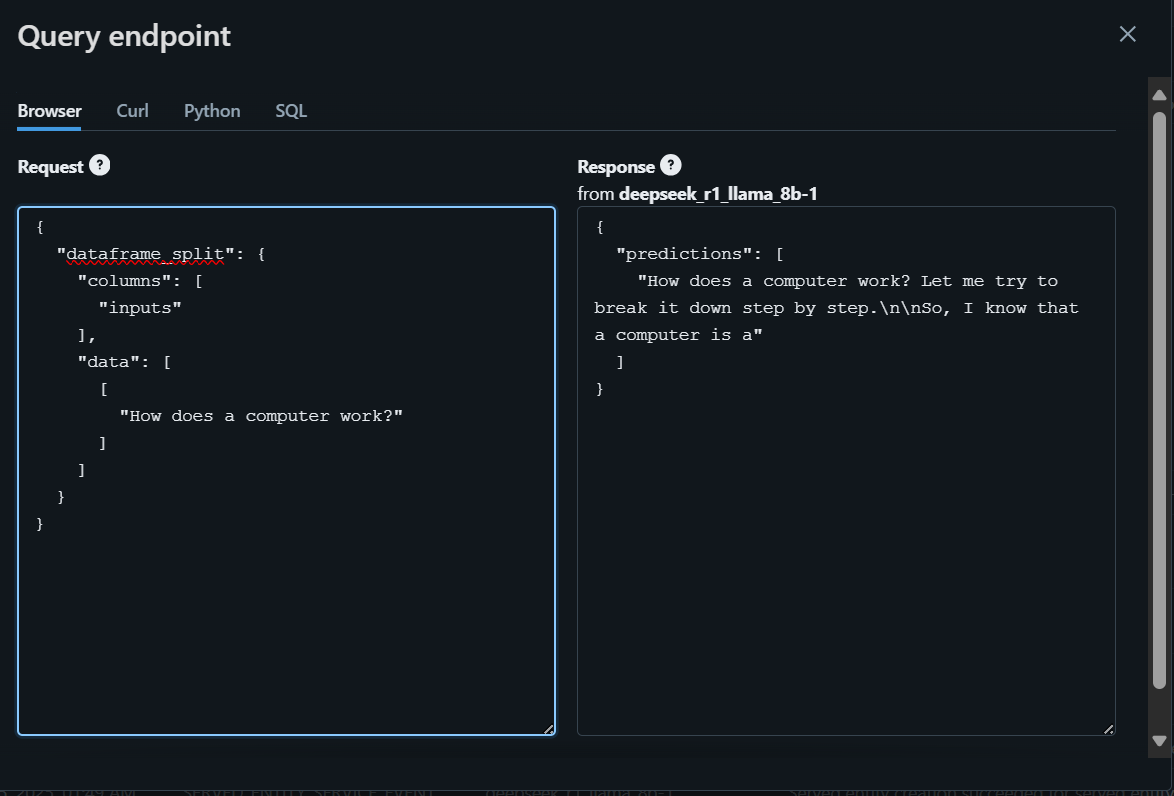
Bu modele erişmenin veya onu kullanmanın birçok yolu vardır.
Başlamak için, soruyu tarayıcıda yazıp yanıtı üretelim.
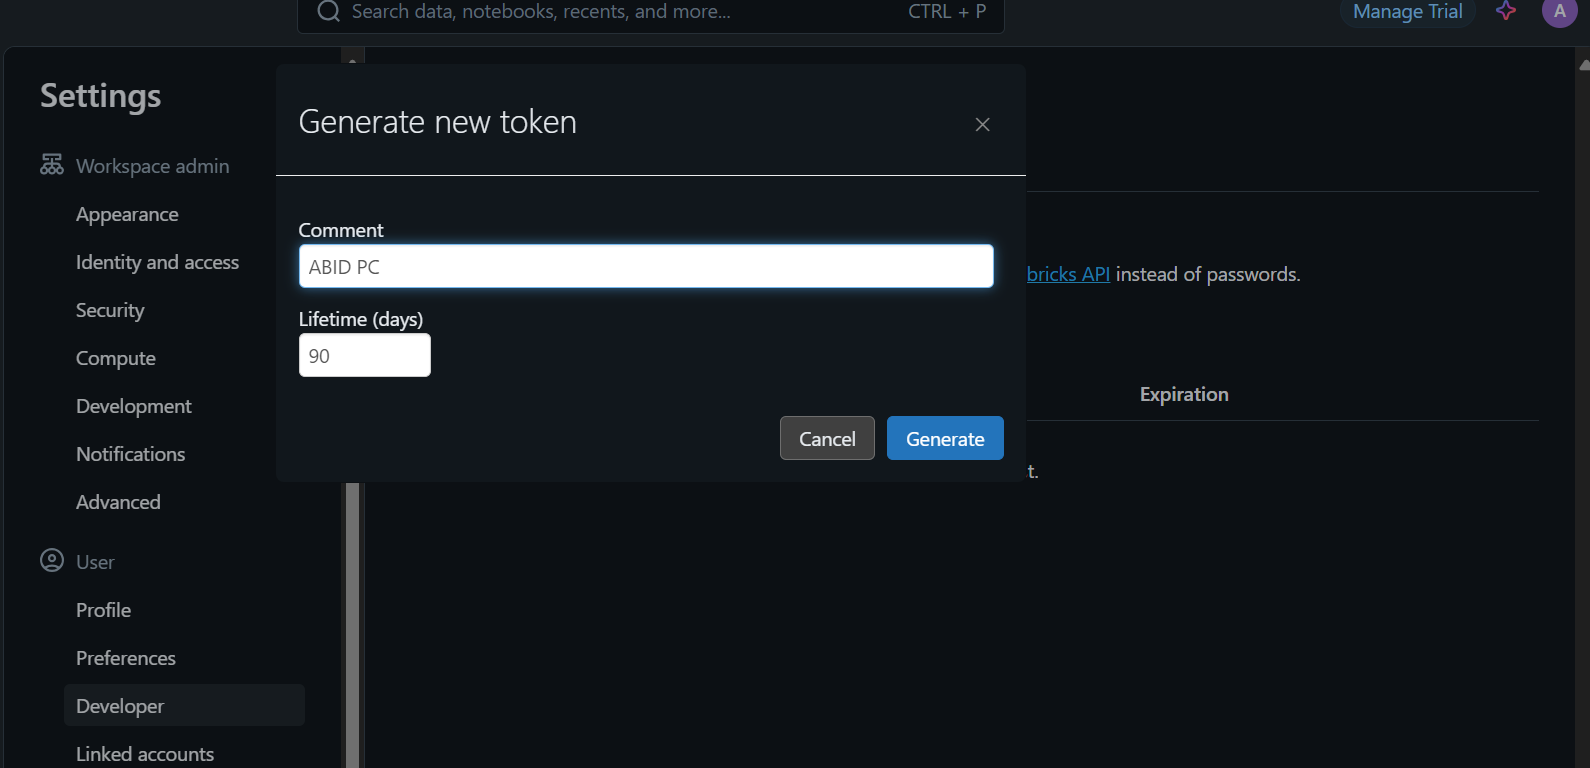
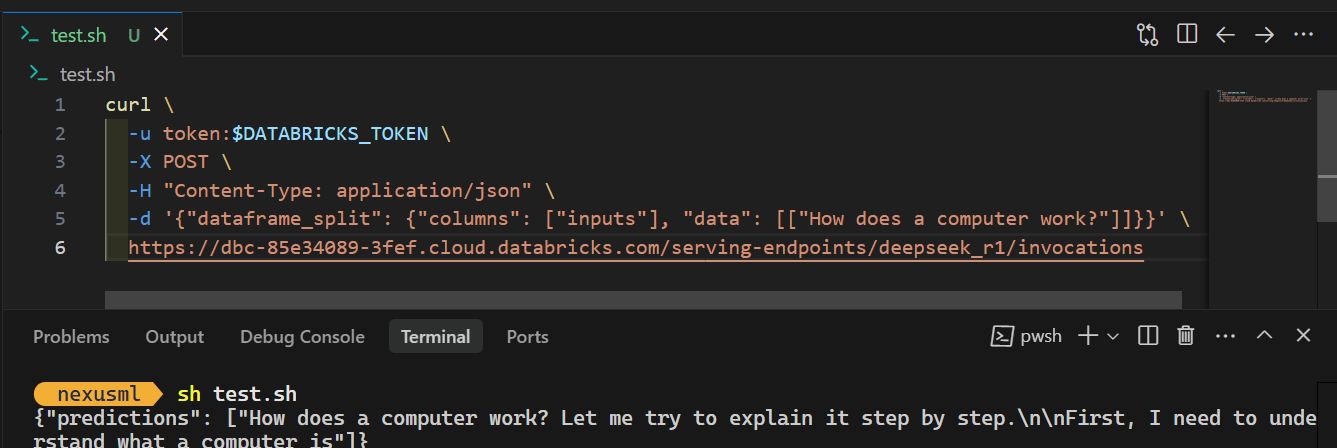
Modele yerelde erişmek veya uygulamanıza entegre etmek için önce bir Databricks API anahtarı üretmeniz gerekir.
curl \
  -u token:$DATABRICKS_TOKEN \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
  https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocations
Komutu çalıştırdığınızda, yanıtın üretilmesi birkaç saniye sürecektir. Bu kadar basit!
DeepSeek R1 vs V3 blog yazısına göz atarak DeepSeek’in sunduğu en iyi büyük dil modellerini öğrenin.
DeepSeek R1 modelini Databricks’te kaydetmek ve dağıtmak oldukça basittir. Büyük modeli dahi bir CPU kümesi ya da yerel bir CPU makine kullanarak, herhangi bir maliyete katlanmadan kaydedip dağıtabilirsiniz. Ancak modeli CPU üzerinde çalıştırmak yavaş olabilir ve özellikle docker imajını oluştururken sabır gerektirir.
Bu eğitimde, model dağıtım sürecinin tamamını adım adım ele aldık. Önce Databricks’i kurduk ve Databricks Model Registry’de önceden eğitilmiş DeepSeek Distilled R1 modelini kaydettik. Ardından Databricks panosunu kullanarak modeli dağıttık. Son olarak, dağıtılan modeli test ettik ve basit bir CURL komutuyla yerelde nasıl kullanılacağını gösterdik.
AI ve büyük dil modellerine yeniyseniz, Introduction to LLMs in Python kursunu almanızı öneririm. Bu, sağlam bir temel oluşturmanıza, temel terimleri anlamanıza ve DeepSeek R1 gibi ileri düzey modellerle çalışmaya başlamanıza yardımcı olacaktır!
Bu kurslarla Databricks hakkında daha fazlasını öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




