

在 Databricks 上注册 DeepSeek R1 模型
下一步是注册模型。
- 创建好工作区后,点击 “+ New” 按钮并选择 Notebook 以启动。
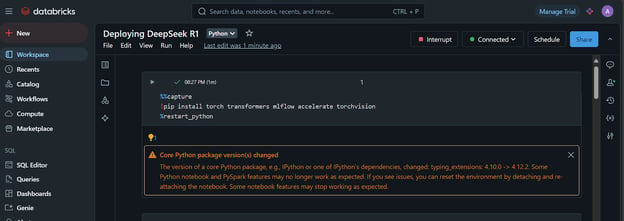
- 创建一个 Jupyter 单元并运行以下代码:
1. 安装所需的 Python 软件包:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python2. 从 Hugging Face 仓库加载 tokenizer、配置和模型:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline
# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"
# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
model_name,
config=config,
torch_dtype=torch.float16
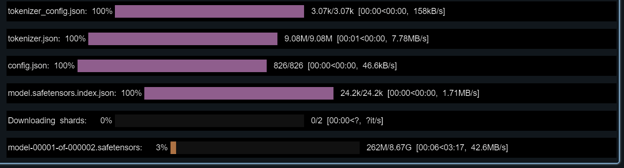
)
3. 通过提供示例提示测试已加载的模型。
我们还将创建一个签名,以便在模型注册时添加:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)
print(example_outputs)模型应当可以正常工作!
我这里的输出为:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. 使用正确的 Python 版本和所需包设置 conda 环境。
这将帮助我们创建包含运行模型所需全部工具的容器:
conda_env = {
"name": "mlflow-env",
"channels": ["defaults", "conda-forge"],
"dependencies": [
"python=3.11",
"pip",
{
"pip": [
"mlflow",
"transformers",
"accelerate",
"torch",
"torchvision"
]
}
]
}5. 注册模型
为 mlflow.transformers.log_model 函数提供文本生成管道、artifact 路径、签名、示例输入、模型名称和 conda 环境:
with mlflow.start_run() as run:
mlflow.transformers.log_model(
transformers_model=text_generator,
artifact_path="deepseek_model",
signature=signature,
input_example=example_inputs,
registered_model_name="deepseek_r1_llama_8b",
conda_env=conda_env
)注册模型需要几分钟时间。
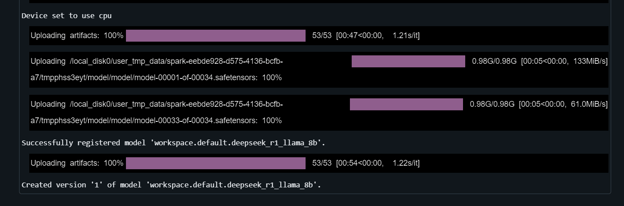
通过 学习 Data Management in Databricks 课程,了解 Databricks Lakehouse 的强大能力,提升您的数据工程与机器学习技能。
在 Databricks 上部署 Deepseek
现在开始部署模型!
- 模型注册完成后,点击 Databricks 仪表板左下角的 “Models” 选项卡。
- 选择您的模型并点击 “Serve this model” 按钮。
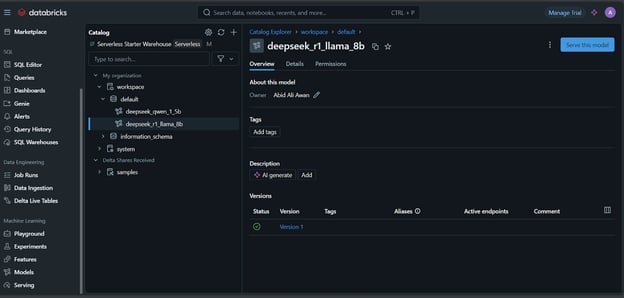
- 输入端点服务名称,选择计算选项并设置并发数,然后点击 “Create”。
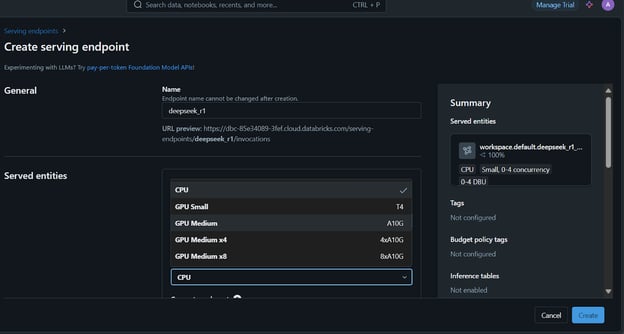
设置服务端点需要几分钟时间。完成后状态会变为绿色并显示 “Ready”。
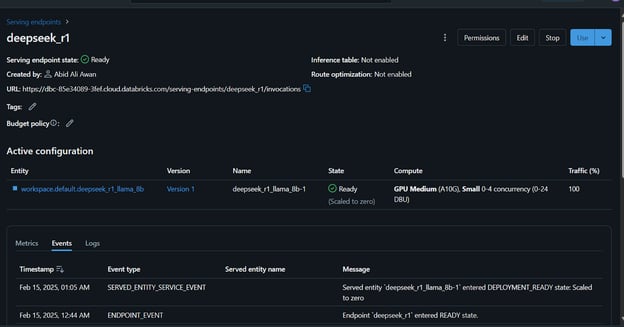
此外,您还可以在注册模型前,使用自定义数据集对 DeepSeek R1 进行微调。请参阅 Fine-Tuning DeepSeek R1 教程,了解该流程的全部细节。
访问已部署的模型
访问或使用该模型的方式有很多。
- 您可以在 Databricks playground 中输入问题,并在浏览器中生成响应。
- 此外,您还可以使用 CURL、Python requests 包或 SQL 命令来访问模型。
首先,我们将在浏览器中输入问题并生成响应。
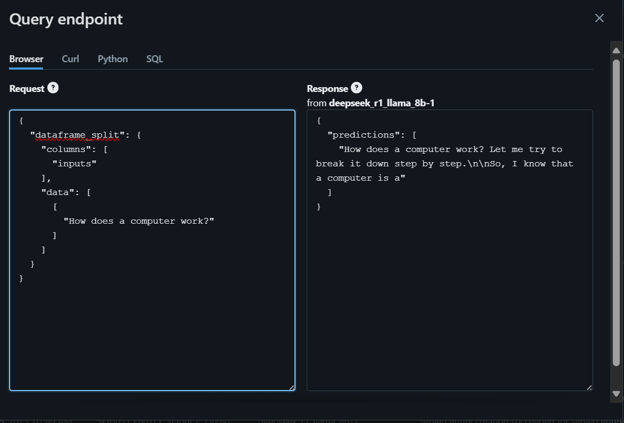
若要在本地访问模型或将其集成到您的应用中,您需要先生成一个 Databricks API 密钥。
- 前往设置。
- 点击 "Developer",然后生成一个新令牌。
- 复制该令牌并创建本地环境变量。
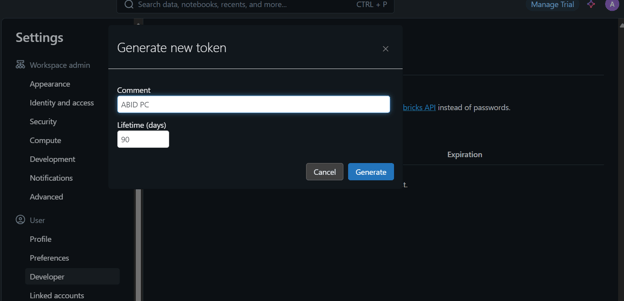
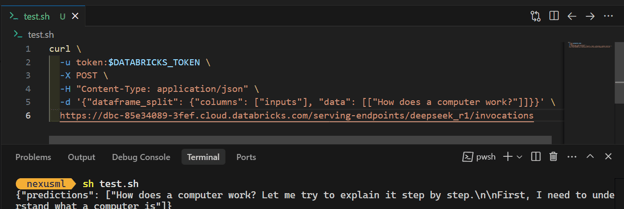
- 使用 CURL 命令,并提供 API 令牌,确保提示与服务器端点 URL 均为正确的 JSON 格式。示例如下:
curl \
-u token:$DATABRICKS_TOKEN \
-X POST \
-H "Content-Type: application/json" \
-d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocations运行命令后,生成响应需要几秒钟。就这么简单!
查看 DeepSeek R1 vs V3 博文,了解 DeepSeek 提供的最佳大语言模型。
总结
在 Databricks 上注册并部署 DeepSeek R1 模型相当直接。您甚至可以使用 CPU 集群或本地 CPU 机器来注册并部署大型模型,而且无需产生任何费用。不过,在 CPU 上运行模型会较慢,尤其是在构建 docker 镜像时,需要耐心等待。
本教程按步骤覆盖了完整的模型部署流程。我们首先完成 Databricks 的设置,并在 Databricks 模型注册表中注册了预训练的 DeepSeek Distilled R1 模型;随后,使用 Databricks 仪表板部署模型;最后,我们对已部署的模型进行了测试,并演示了如何通过一个简单的 CURL 命令在本地使用。
如果您刚接触 AI 和大语言模型,建议学习 Introduction to LLMs in Python 课程。这将帮助您夯实基础,理解关键术语,并开始上手 DeepSeek R1 等高级模型!

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
Databricks 长期以来深受数据工程社区青睐,如今正稳步扩展至人工智能(AI)和机器学习(ML)领域。借助这一演进,您现在可以在同一统一平台中完成模型训练、实验跟踪、模型注册,并将其部署到 Databricks 端点。这样的集成简化了工作流,使 Databricks 成为数据与 AI 专业人士的强大工具。
如果您刚接触 Databricks,建议先学习 Introduction to Databricks 课程,了解 Databricks Lakehouse 平台。本课程将帮助您理解 Databricks 如何实现数据架构现代化并改进数据管理流程。
在本教程中,我将带您在 Databricks 上部署 DeepSeek R1 模型的分布式版本。DeepSeek R1 日益流行,许多公司选择在自有云基础设施上运行该模型,而非将数据发送到外部服务器。
本指南将帮助您设置 Databricks 账户、注册 DeepSeek R1 模型,使用用户界面进行部署,并通过 playground 以及本地 CURL 命令进行访问。
如需进一步了解 DeepSeek R1 的功能、研发流程、蒸馏模型、定价,以及与 OpenAI 等其他 AI 模型的对比,请查看博文 DeepSeek-R1: Features, Comparison, Distilled Models & More。
设置 Databricks
使用 Databricks 有两种便捷方式。您可以前往 GCP、AWS 或 Azure Marketplace 订阅 Databricks 服务;或者,您也可以注册独立版 Databricks 账户,在无需创建任何计算集群的情况下,获得部分计算资源。
下面我将分别说明这两种方式。
与云服务商配合使用的 Databricks
如果您已经可以使用 AWS 的 GPU,强烈推荐此方法。流程简洁,几乎无需折腾。
在 AWS Marketplace 设置 Databricks。
完成后,系统会为您创建一个功能齐全的 Databricks 工作区。所有费用将通过 AWS 账单结算。
点击 “Compute” 选项卡,您可以创建所需的计算集群。
稍后我们会在 Notebook 中使用该集群,并据此部署模型。
独立版 Databricks
如果您更倾向于使用独立版 Databricks(例如无法使用云端 GPU 或出于其他原因),请按以下步骤操作:
几秒钟内,工作区及相关配置将自动完成。
注册 Databricks 独立版。
请注意,这里有一个限制:通过该方式无法创建您自己的计算集群或 GPU 集群。您只能在 Notebook 中使用 CPU 注册模型,这可能带来您不想面对的麻烦。
如果您在生产或研究环境中使用 DeepSeek R1,使用 CPU 而非 GPU 可能会因为性能下降、内存受限及潜在成本而令人沮丧。详情请参阅 CPU vs GPU 博文。