

Đăng ký mô hình DeepSeek R1 trên Databricks
Bước tiếp theo là đăng ký mô hình.
- Khi workspace đã được tạo, nhấp nút “+ New” và chọn notebook để mở.
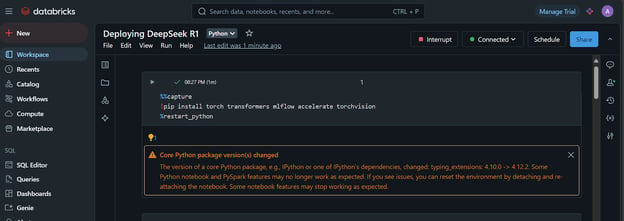
- Tạo một ô Jupyter và chạy đoạn mã sau:
1. Cài đặt các gói Python cần thiết:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python2. Tải tokenizer, cấu hình và mô hình từ kho Hugging Face:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline
# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"
# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
model_name,
config=config,
torch_dtype=torch.float16
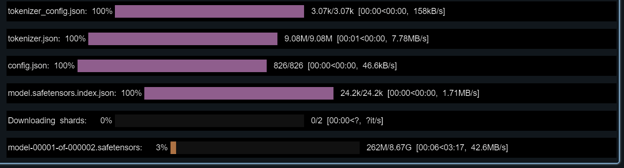
)
3. Kiểm tra mô hình đã tải bằng một prompt mẫu.
Chúng ta cũng sẽ tạo một chữ ký (signature) để thêm vào khi đăng ký mô hình:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)
print(example_outputs)Mô hình phải hoạt động hoàn hảo!
Kết quả mà tôi thấy là:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. Thiết lập môi trường conda với phiên bản Python phù hợp và các gói cần thiết.
Điều này sẽ giúp chúng ta tạo container có đầy đủ công cụ cần thiết để chạy mô hình:
conda_env = {
"name": "mlflow-env",
"channels": ["defaults", "conda-forge"],
"dependencies": [
"python=3.11",
"pip",
{
"pip": [
"mlflow",
"transformers",
"accelerate",
"torch",
"torchvision"
]
}
]
}5. Đăng ký mô hình
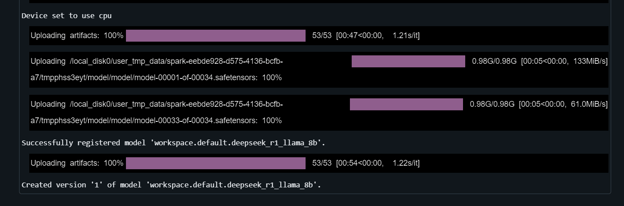
Cung cấp cho hàm mlflow.transformers.log_model pipeline sinh văn bản, đường dẫn artifact, chữ ký, ví dụ đầu vào, tên mô hình và môi trường conda:
with mlflow.start_run() as run:
mlflow.transformers.log_model(
transformers_model=text_generator,
artifact_path="deepseek_model",
signature=signature,
input_example=example_inputs,
registered_model_name="deepseek_r1_llama_8b",
conda_env=conda_env
)Việc đăng ký mô hình sẽ mất vài phút.
Tìm hiểu sức mạnh của Databricks Lakehouse và nâng cao kỹ năng kỹ thuật dữ liệu, học máy bằng cách học khóa Quản lý Dữ liệu trong Databricks.
Triển khai Deepseek trên Databricks
Đến lúc triển khai mô hình!
- Khi mô hình đã được đăng ký, nhấp vào thẻ “Models” ở góc dưới bên trái bảng điều khiển Databricks.
- Chọn mô hình của bạn và bấm nút “Serve this model”.
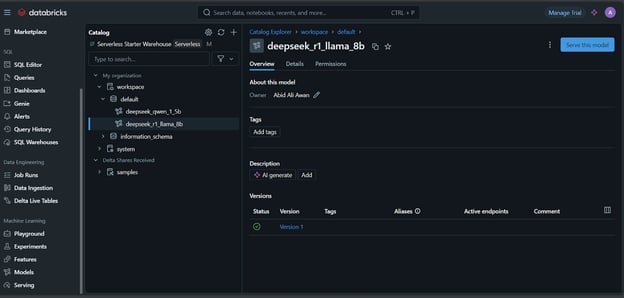
- Nhập tên endpoint phục vụ, chọn tùy chọn tính toán và đặt mức đồng thời trước khi nhấp “Create”.
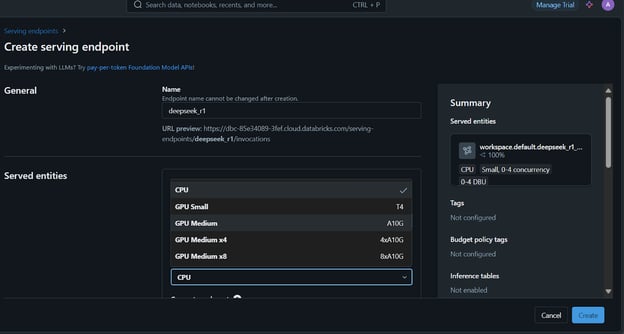
Việc thiết lập serving endpoint sẽ mất vài phút. Trạng thái sẽ chuyển sang màu xanh và hiển thị “Ready” khi hoàn tất.
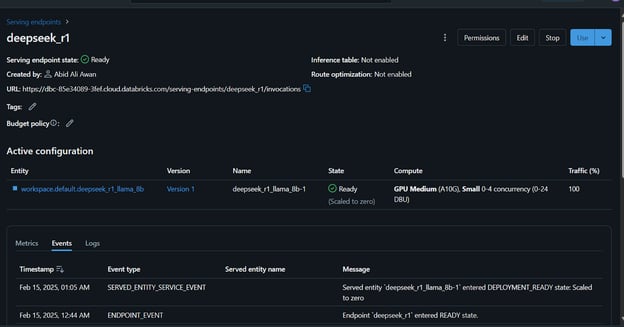
Ngoài ra, bạn có thể fine-tune DeepSeek R1 trên bộ dữ liệu tùy chỉnh trước khi đăng ký mô hình. Hãy theo dõi hướng dẫn Fine-Tuning DeepSeek R1 để học mọi thứ bạn cần về quy trình này.
Truy cập mô hình đã triển khai
Có nhiều cách để truy cập hoặc sử dụng mô hình này.
- Bạn có thể viết câu hỏi trong playground của Databricks, hệ thống sẽ tạo phản hồi ngay trên trình duyệt.
- Ngoài ra, bạn có thể truy cập mô hình bằng CURL, gói Python requests hoặc lệnh SQL.
Để bắt đầu, chúng ta sẽ viết câu hỏi trên trình duyệt và tạo phản hồi.
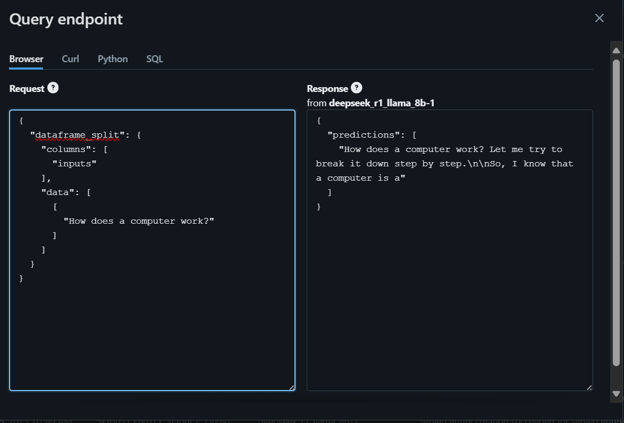
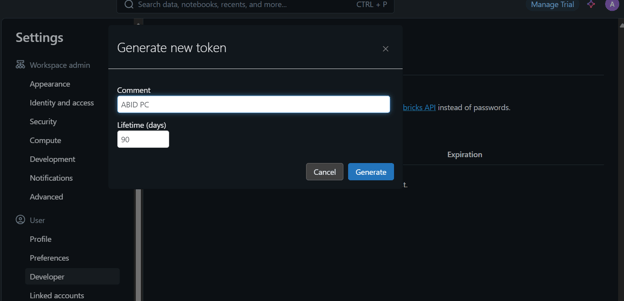
Để truy cập mô hình cục bộ hoặc tích hợp vào ứng dụng của bạn, trước hết bạn cần tạo khóa API Databricks.
- Vào phần cài đặt.
- Nhấp vào "Developer" rồi tạo token mới.
- Sao chép token này và tạo biến môi trường cục bộ.
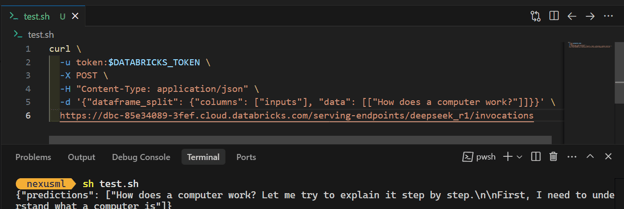
- Dùng lệnh CURL và cung cấp token API, đảm bảo prompt và URL endpoint máy chủ ở đúng định dạng JSON. Ví dụ:
curl \
-u token:$DATABRICKS_TOKEN \
-X POST \
-H "Content-Type: application/json" \
-d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocationsKhi bạn chạy lệnh, việc tạo phản hồi sẽ mất vài giây. Đơn giản vậy thôi!
Xem bài blog DeepSeek R1 vs V3 để tìm hiểu về các mô hình ngôn ngữ lớn tốt nhất từ DeepSeek.
Kết luận
Việc đăng ký và triển khai mô hình DeepSeek R1 trên Databricks khá đơn giản. Bạn thậm chí có thể đăng ký và triển khai mô hình lớn bằng cụm CPU hoặc máy CPU cục bộ mà không phát sinh chi phí. Tuy nhiên, chạy mô hình trên CPU có thể chậm và cần kiên nhẫn, đặc biệt khi dựng ảnh docker.
Trong hướng dẫn này, chúng ta đã đi qua toàn bộ quy trình triển khai mô hình theo từng bước. Bắt đầu bằng việc thiết lập Databricks và đăng ký mô hình DeepSeek Distilled R1 đã được huấn luyện sẵn trong Databricks Model Registry. Sau đó, chúng ta dùng bảng điều khiển Databricks để triển khai mô hình. Cuối cùng, chúng ta kiểm thử mô hình đã triển khai và minh họa cách dùng cục bộ với lệnh CURL đơn giản.
Nếu bạn mới làm quen với AI và các mô hình ngôn ngữ lớn, tôi khuyến nghị học khóa Giới thiệu về LLMs trong Python. Khóa học sẽ giúp bạn xây nền tảng vững chắc, hiểu thuật ngữ chính và bắt đầu làm việc với các mô hình nâng cao như DeepSeek R1!

Là một nhà khoa học dữ liệu được chứng nhận, tôi đam mê tận dụng công nghệ tiên tiến để tạo ra các ứng dụng học máy đổi mới. Với nền tảng vững chắc về nhận dạng giọng nói, phân tích và báo cáo dữ liệu, MLOps, AI hội thoại và NLP, tôi đã rèn giũa kỹ năng phát triển các hệ thống thông minh có thể tạo ra tác động thực sự. Bên cạnh chuyên môn kỹ thuật, tôi cũng là một người truyền đạt tốt, có khả năng chắt lọc các khái niệm phức tạp thành ngôn ngữ rõ ràng, súc tích. Nhờ đó, tôi trở thành một blogger được nhiều người quan tâm trong lĩnh vực khoa học dữ liệu, chia sẻ góc nhìn và kinh nghiệm với cộng đồng các chuyên gia dữ liệu ngày càng lớn. Hiện tại, tôi tập trung vào sáng tạo và biên tập nội dung, làm việc với các mô hình ngôn ngữ lớn để phát triển nội dung mạnh mẽ và hấp dẫn, giúp doanh nghiệp và cá nhân tận dụng tối đa dữ liệu của mình.


Databricks từ lâu đã được cộng đồng kỹ sư dữ liệu ưa chuộng và hiện đang mở rộng ổn định năng lực sang lĩnh vực trí tuệ nhân tạo (AI) và học máy (ML). Sự phát triển này cho phép bạn huấn luyện mô hình, theo dõi thử nghiệm, đăng ký mô hình và triển khai chúng lên các endpoint của Databricks—tất cả trong cùng một nền tảng thống nhất. Sự tích hợp này đơn giản hóa quy trình làm việc và biến Databricks trở thành công cụ mạnh mẽ cho cả chuyên gia dữ liệu và AI.
Nếu bạn mới làm quen với Databricks, hãy cân nhắc học khóa Giới thiệu về Databricks để tìm hiểu về nền tảng Databricks Lakehouse. Khóa học này sẽ giúp bạn hiểu cách Databricks hiện đại hóa kiến trúc dữ liệu và cải thiện quy trình quản lý dữ liệu.
Trong hướng dẫn này, tôi sẽ dẫn bạn triển khai phiên bản phân tán của mô hình DeepSeek R1 trên Databricks. DeepSeek R1 đang ngày càng phổ biến, với nhiều công ty chọn chạy nó trên hạ tầng đám mây của riêng họ thay vì gửi dữ liệu đến máy chủ bên ngoài.
Hướng dẫn này sẽ giúp bạn thiết lập tài khoản Databricks, đăng ký mô hình DeepSeek R1, triển khai bằng giao diện người dùng, và truy cập qua playground cũng như cục bộ bằng lệnh CURL.
Để tìm hiểu thêm về DeepSeek R1, bao gồm tính năng, quy trình phát triển, các mô hình chưng cất, giá thành và so sánh với các mô hình AI khác như của OpenAI, hãy xem bài blog DeepSeek-R1: Tính năng, So sánh, Mô hình Chưng cất & hơn thế nữa.
Thiết lập Databricks
Có hai cách đơn giản để sử dụng Databricks. Bạn có thể vào Marketplace của GCP, AWS hoặc Azure và đăng ký dịch vụ Databricks. Hoặc bạn có thể đăng ký tài khoản Databricks độc lập, cung cấp cho bạn một số tài nguyên tính toán mà không cần tạo bất kỳ cụm tính toán nào.
Dưới đây là hai cách.
Databricks với các nhà cung cấp đám mây
Nếu bạn đã có quyền truy cập GPU trên AWS, phương án này rất đáng khuyên. Đơn giản và không tốn nhiều công sức.
Thiết lập Databricks trên AWS Marketplace.
Sau khi hoàn tất, hệ thống sẽ tạo workspace Databricks với đầy đủ tùy chọn cho bạn. Mọi thanh toán sẽ được thực hiện qua hóa đơn AWS.
Khi bạn nhấp vào thẻ “Compute”, bạn có thể tạo cụm tính toán theo ý muốn.
Cụm này sẽ được sử dụng sau đó trong notebook và để triển khai mô hình.
Databricks độc lập
Nếu bạn muốn dùng phiên bản Databricks độc lập vì không có GPU đám mây hoặc vì lý do khác, hãy làm theo các bước sau:
Workspace và mọi thứ sẽ được thiết lập cho bạn trong vài giây.
Đăng ký phiên bản Databricks độc lập.
Lưu ý là có một điểm hạn chế: bạn không thể tự tạo cụm tính toán hoặc cụm GPU theo cách này. Bạn chỉ có thể đăng ký mô hình bằng CPU trong notebook, điều này có thể gây phiền toái mà bạn muốn tránh.
Nếu bạn làm việc với DeepSeek R1 trong môi trường sản xuất hoặc nghiên cứu, sử dụng CPU thay vì GPU có thể gây khó chịu do suy giảm hiệu năng, giới hạn bộ nhớ và chi phí tiềm ẩn. Tìm hiểu thêm trong bài CPU vs GPU.