
Cursus
Introductie tot Databricks
3 uur
47.7K
Databricks is al lange tijd populair binnen de data-engineeringcommunity en breidt zijn mogelijkheden nu gestaag uit naar kunstmatige intelligentie (AI) en machine learning (ML). Dankzij die ontwikkeling kun je nu modellen trainen, experimenten volgen, modellen registreren en ze naar Databricks-endpoints implementeren—allemaal binnen hetzelfde platform. Deze integratie vereenvoudigt je workflow en maakt Databricks een krachtige tool voor zowel data- als AI-professionals.
Ben je nieuw bij Databricks? Overweeg dan de cursus Introduction to Databricks om kennis te maken met het Databricks Lakehouse-platform. Deze cursus helpt je te begrijpen hoe Databricks data-architecturen kan moderniseren en databeheer kan verbeteren.
In deze tutorial laat ik je zien hoe je de gedistribueerde versie van het DeepSeek R1-model implementeert op Databricks. DeepSeek R1 wint snel aan populariteit; veel bedrijven kiezen ervoor om het op hun eigen cloudinfrastructuur te draaien in plaats van data naar externe servers te sturen.
In deze gids maak je een Databricks-account aan, registreer je het DeepSeek R1-model, implementeer je het via de gebruikersinterface en krijg je er toegang toe via de playground en lokaal met het CURL-commando.
Wil je meer weten over DeepSeek R1—zoals functies, ontwikkelproces, gedistilleerde modellen, prijzen en vergelijking met andere AI-modellen zoals die van OpenAI—bekijk dan de blog DeepSeek-R1: Features, Comparison, Distilled Models & More.
Er zijn twee makkelijke manieren om Databricks te gebruiken. Je kunt naar de Marketplace van GCP, AWS of Azure gaan en je abonneren op de Databricks-service. Of je meldt je aan voor een zelfstandige Databricks-account, waarmee je over wat compute-resources beschikt zonder dat je clusters hoeft aan te maken.
Hieronder licht ik beide manieren toe.
Als je al toegang hebt tot een AWS-GPU, is deze methode een aanrader. Het is eenvoudig en kost weinig moeite.
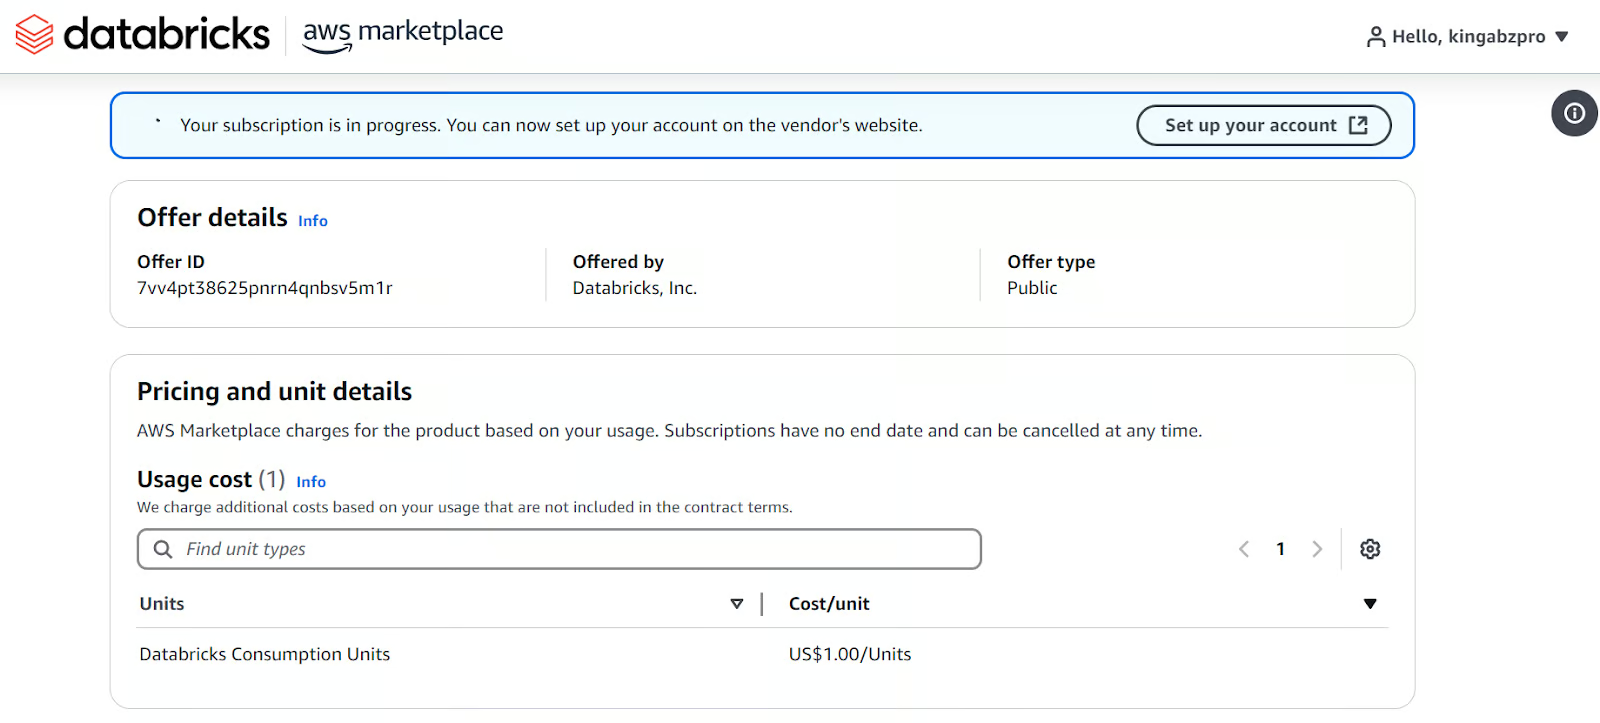
Databricks instellen op AWS Marketplace.
Als je klaar bent, wordt er een Databricks-werkruimte voor je aangemaakt met allerlei opties. Alle betalingen verlopen via AWS Billing.
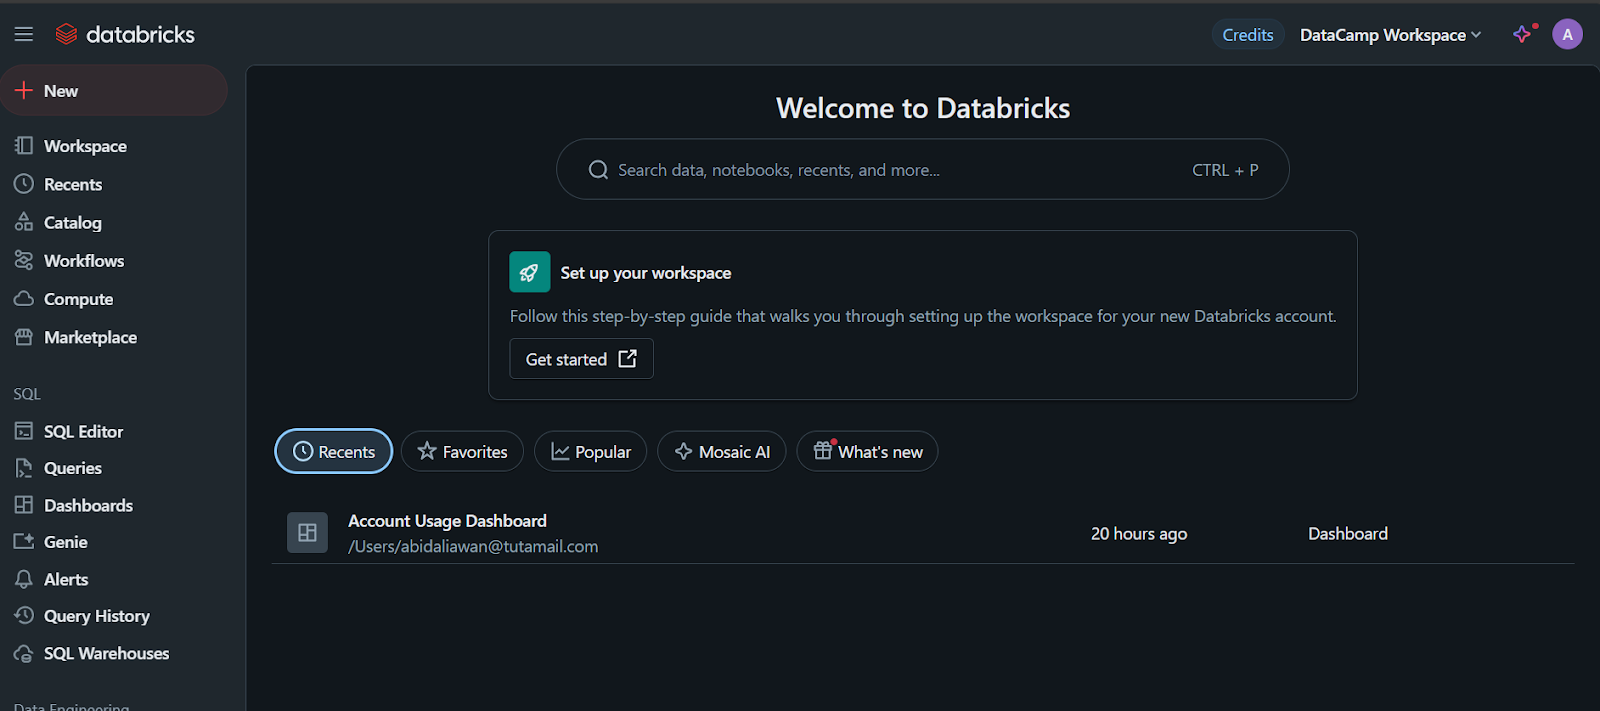
Als je op het tabblad “Compute” klikt, kun je de computecluster van je keuze aanmaken.
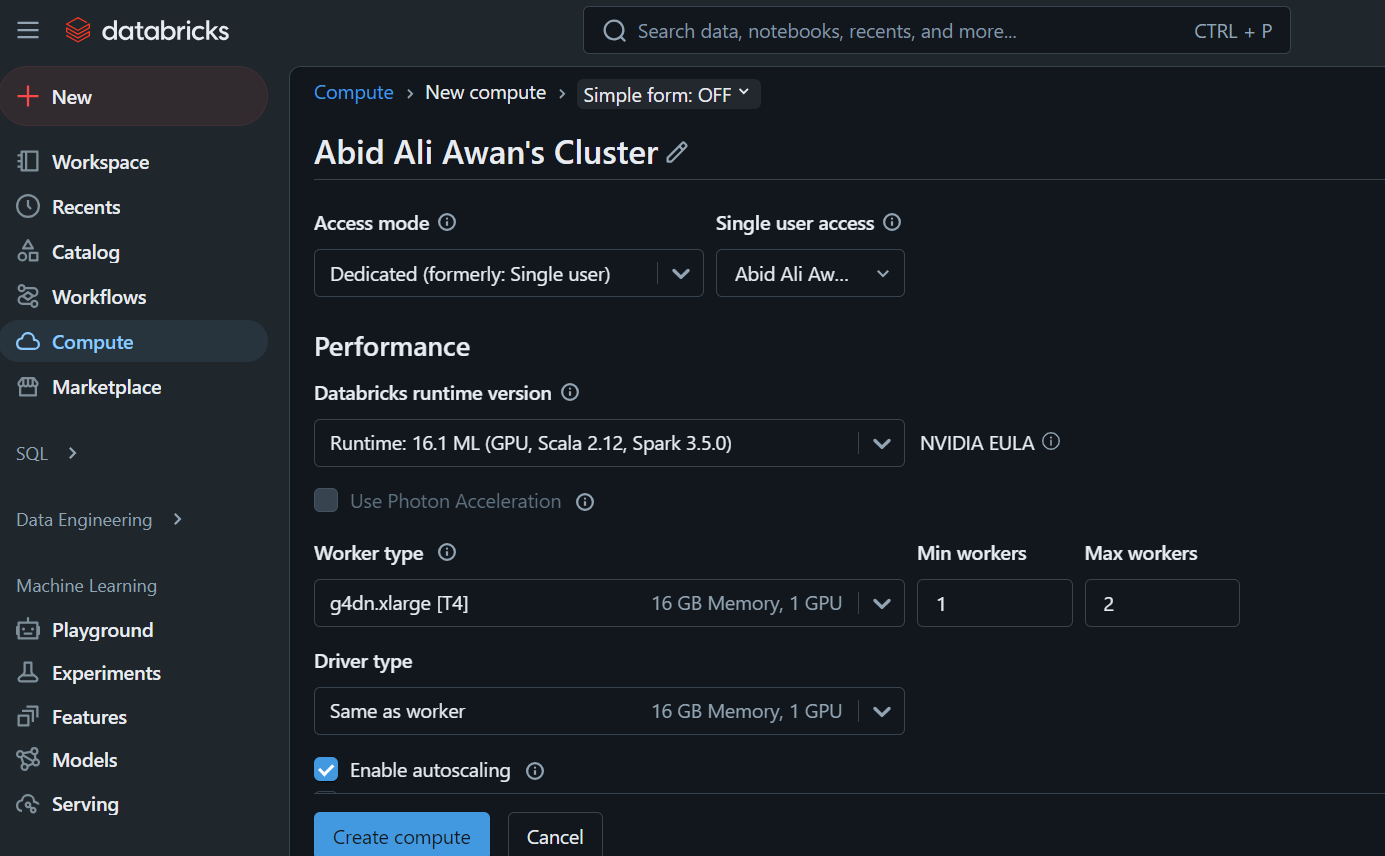
Deze cluster gebruiken we later in een notebook en voor de implementatie van het model.
Gebruik je liever de zelfstandige versie van Databricks omdat je geen toegang hebt tot een cloud-GPU of om een andere reden? Volg dan deze stappen:
De werkruimte en alles eromheen worden binnen enkele seconden voor je ingericht.
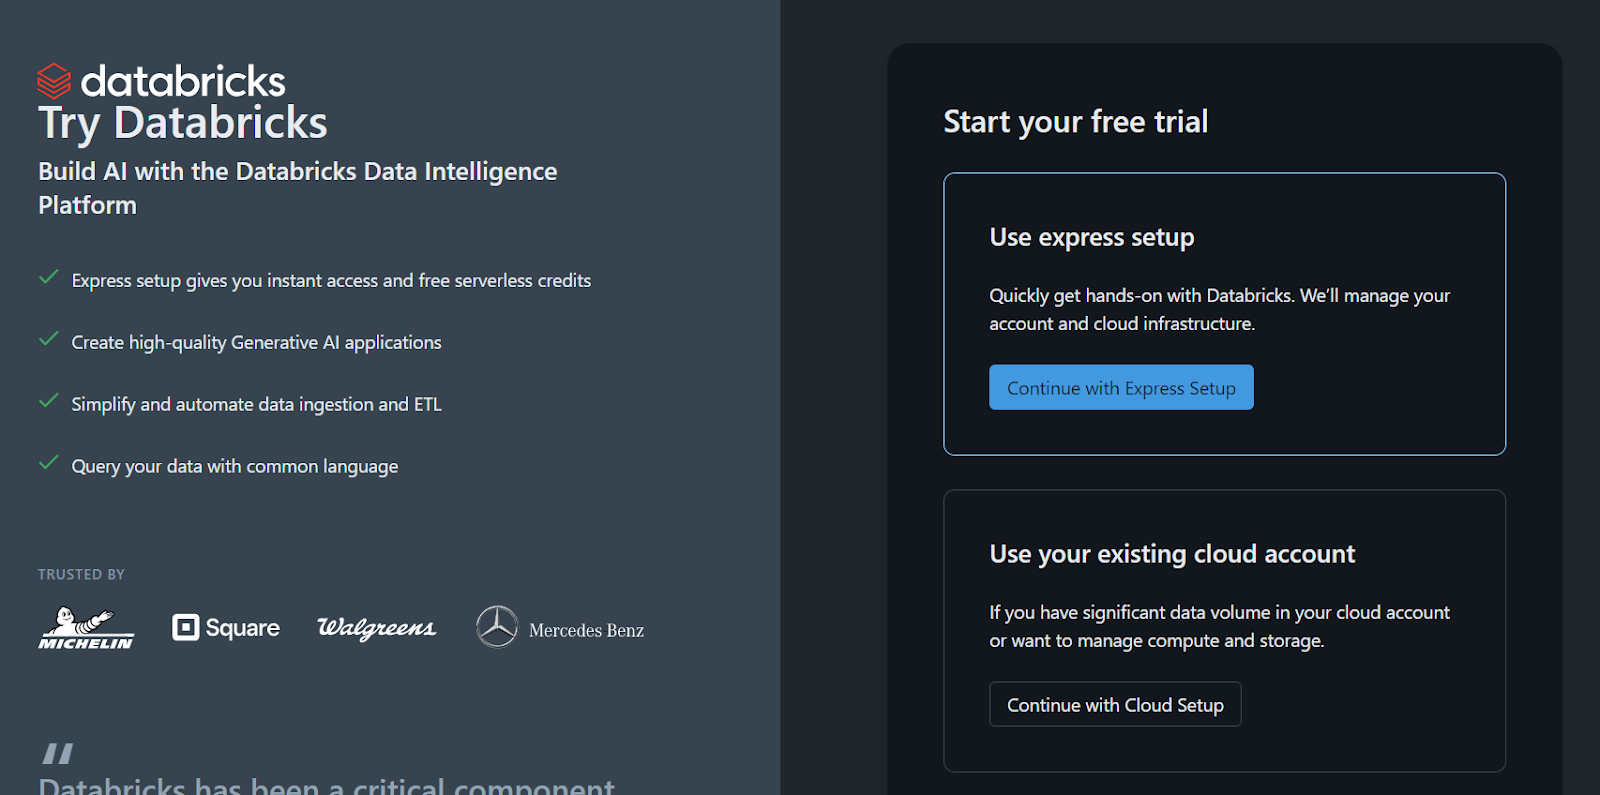
Meld je aan voor de zelfstandige versie van Databricks.
Let op: er is een addertje onder het gras: met deze methode kun je geen eigen compute- of GPU-cluster aanmaken. Je kunt het model alleen registreren met een CPU in een notebook—een gedoe dat je waarschijnlijk wilt vermijden.
Werk je met DeepSeek R1 in een productie- of onderzoekscontext, dan kan het gebruik van een CPU in plaats van een GPU frustrerend zijn vanwege prestatiedaling, geheugenbeperkingen en mogelijke kosten. Lees meer in de blog CPU vs GPU.
De volgende stap is het registreren van het model.
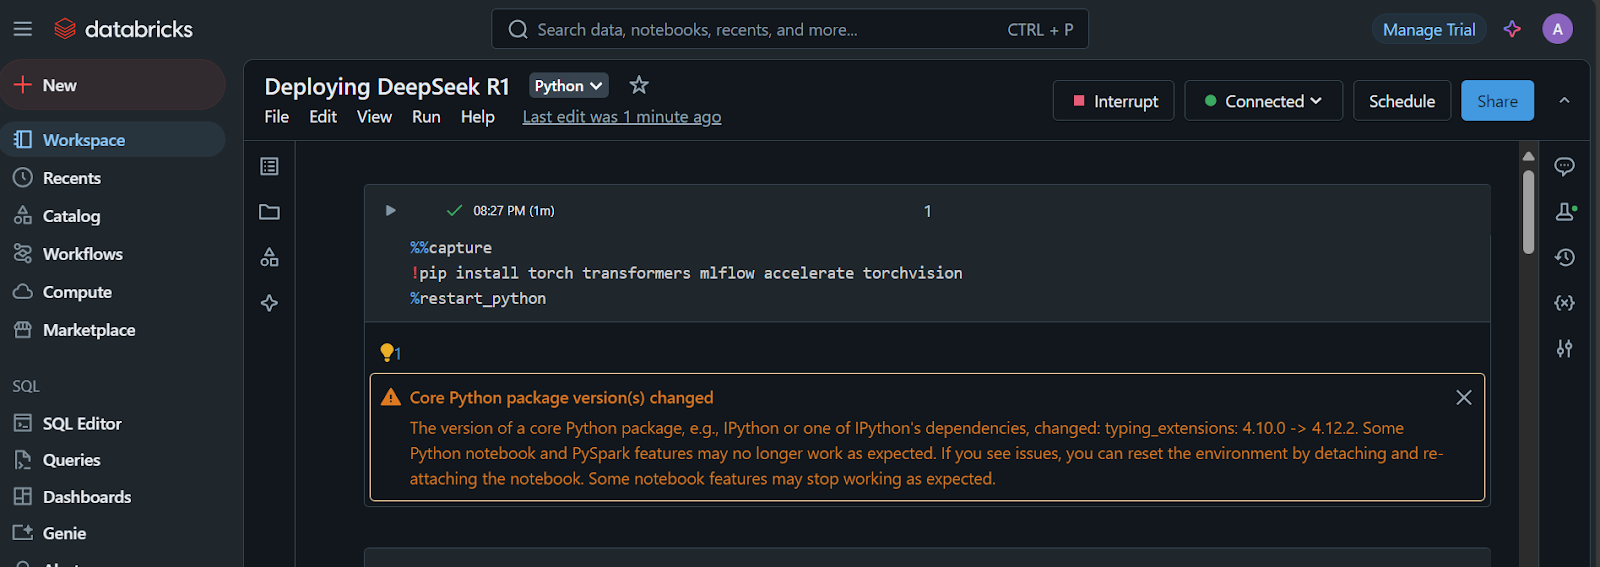
1. Installeer de benodigde Python-pakketten:
%%capture
!pip install torch transformers mlflow accelerate torchvision
%restart_python
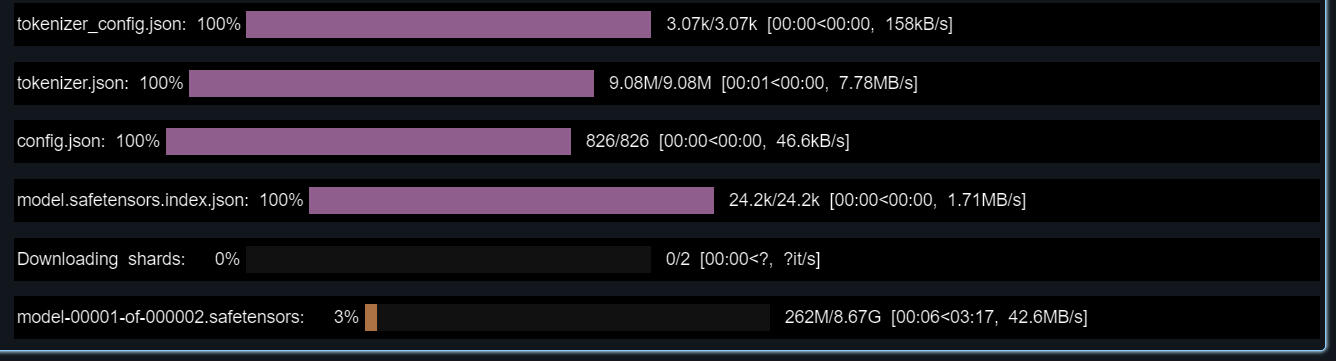
2. Laad de tokens, configuraties en het model uit de Hugging Face-repository:
import pandas as pd
import mlflow
import mlflow.transformers
import torch
from mlflow.models.signature import infer_signature
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoConfig, pipeline


# Specify the model from HuggingFace transformers
model_name = "deepseek-ai/DeepSeek-R1-Distill-Llama-8B"


# Load tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(model_name)
config = AutoConfig.from_pretrained(model_name)


model = AutoModelForCausalLM.from_pretrained(
    model_name,
    config=config,
    torch_dtype=torch.float16
)
3. Test het geladen model met een voorbeeldprompt.
We maken ook een signature die we toevoegen tijdens het registreren van het model:
text_generator = pipeline("text-generation", model=model, tokenizer=tokenizer)
example_prompt = "How does a computer work?"
example_inputs = pd.DataFrame({"inputs": [example_prompt]})
example_outputs = text_generator(example_prompt, max_length=200)
signature = infer_signature(example_inputs, example_outputs)


print(example_outputs)
Het model zou perfect moeten werken!
De output die ik kreeg is:
[{'generated_text': "How does a computer work? What is the computer? What is the computer used for? What is the computer used for in real life?\n\nI need to answer this question, but I need to do it step by step. I need to start with the very basic level and build up from there. I need to make sure I understand each concept before moving on. I need to use a lot of examples to explain each idea. I need to write my thoughts as if I'm explaining them to someone else, but I need to make sure I understand how to structure the answer properly.\n\nOkay, let's start with the basic level. What is a computer? It's an electronic device, right? And it has a central processing unit (CPU) that does the processing. But I think the central processing unit is more efficient, so maybe it's the CPU. Then, it has memory and storage. I remember that memory is like RAM and storage is like ROM. But wait, I think"}]4. Stel de conda-omgeving in met de juiste Python-versie en vereiste Python-pakketten.
Dit helpt ons een container te maken met alle benodigde tools om het model te draaien:
conda_env = {
    "name": "mlflow-env",
    "channels": ["defaults", "conda-forge"],
    "dependencies": [
        "python=3.11",
        "pip",
        {
            "pip": [
                "mlflow",
                "transformers",
                "accelerate",
                "torch",
                "torchvision"
            ]
        }
    ]
}
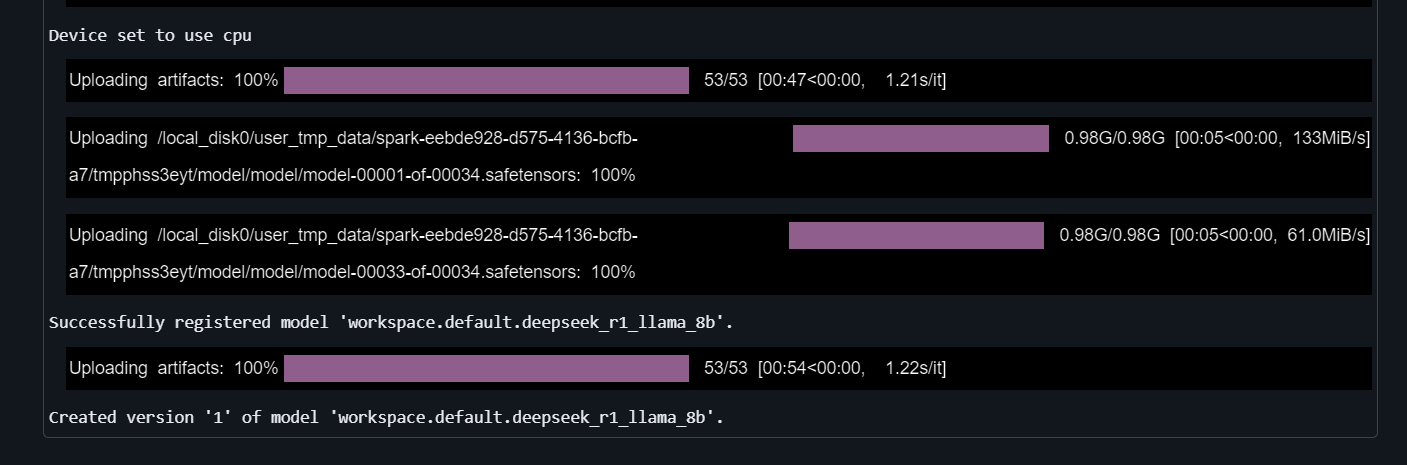
5. Registreer het model
Geef de functie mlflow.transformers.log_model de textgeneration-pipeline, het artifactpad, de signature, een voorbeeldinvoer, de modelnaam en de conda-omgeving mee:
with mlflow.start_run() as run:
    mlflow.transformers.log_model(
        transformers_model=text_generator,
        artifact_path="deepseek_model",
        signature=signature,
        input_example=example_inputs,
        registered_model_name="deepseek_r1_llama_8b",
        conda_env=conda_env
    )
Het registreren van het model duurt enkele minuten.
Leer meer over de kracht van Databricks Lakehouse en verbeter je data-engineering- en machinelearningvaardigheden door de cursus Data Management in Databricks te volgen.
Tijd om het model te implementeren!
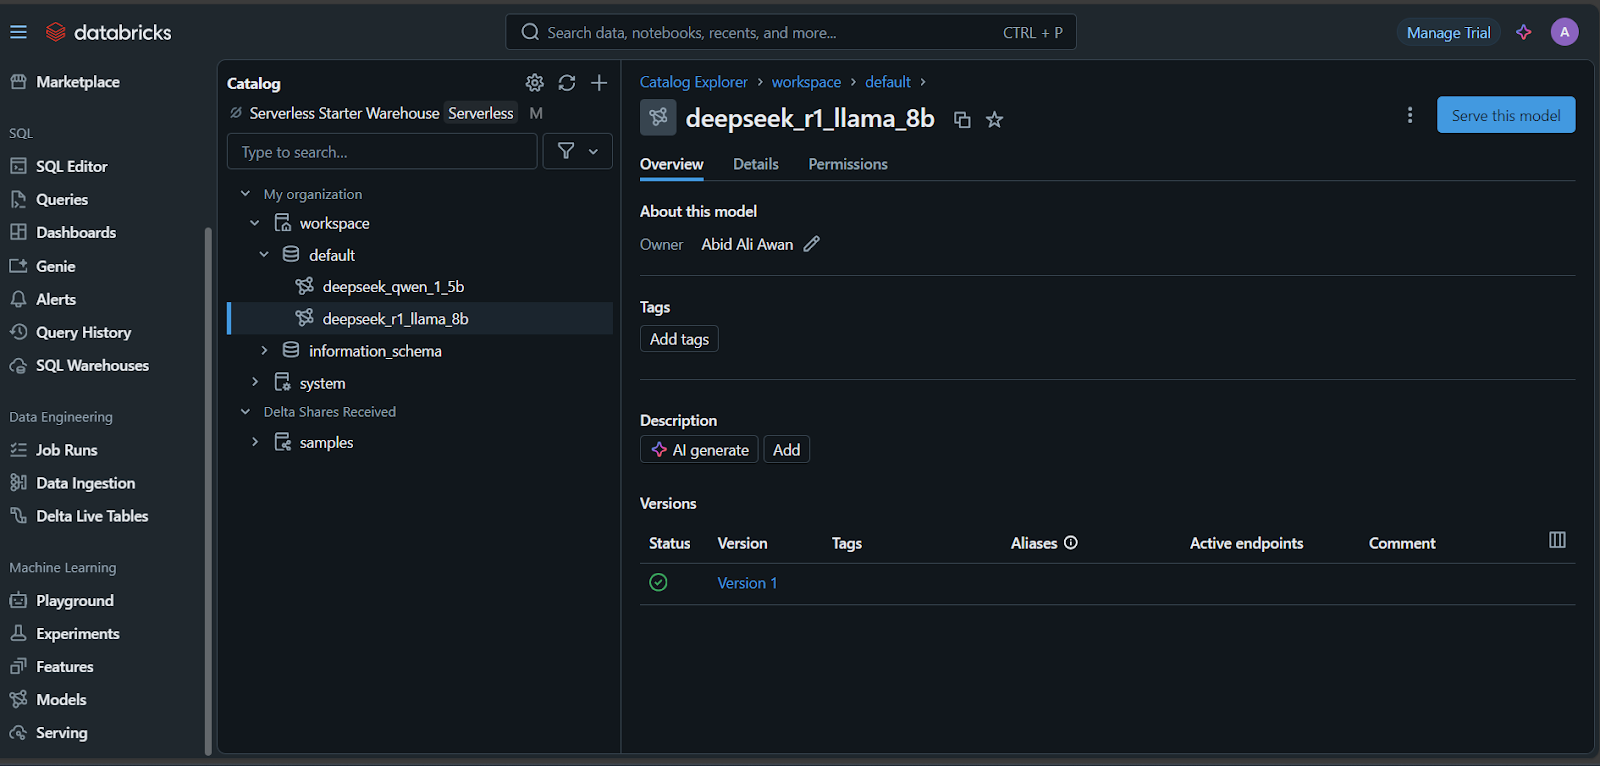
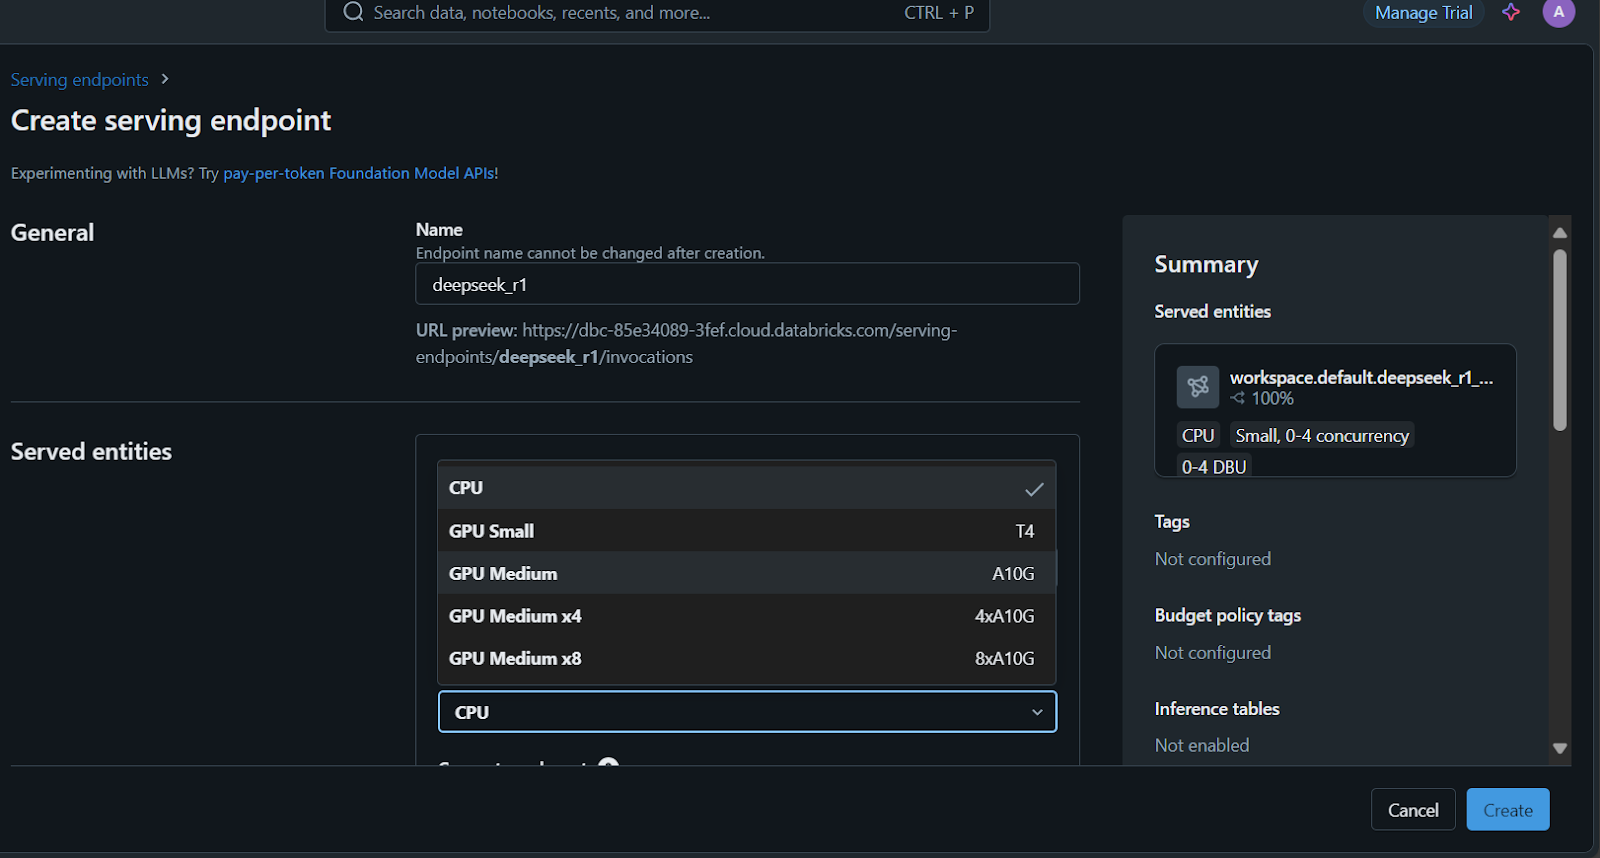
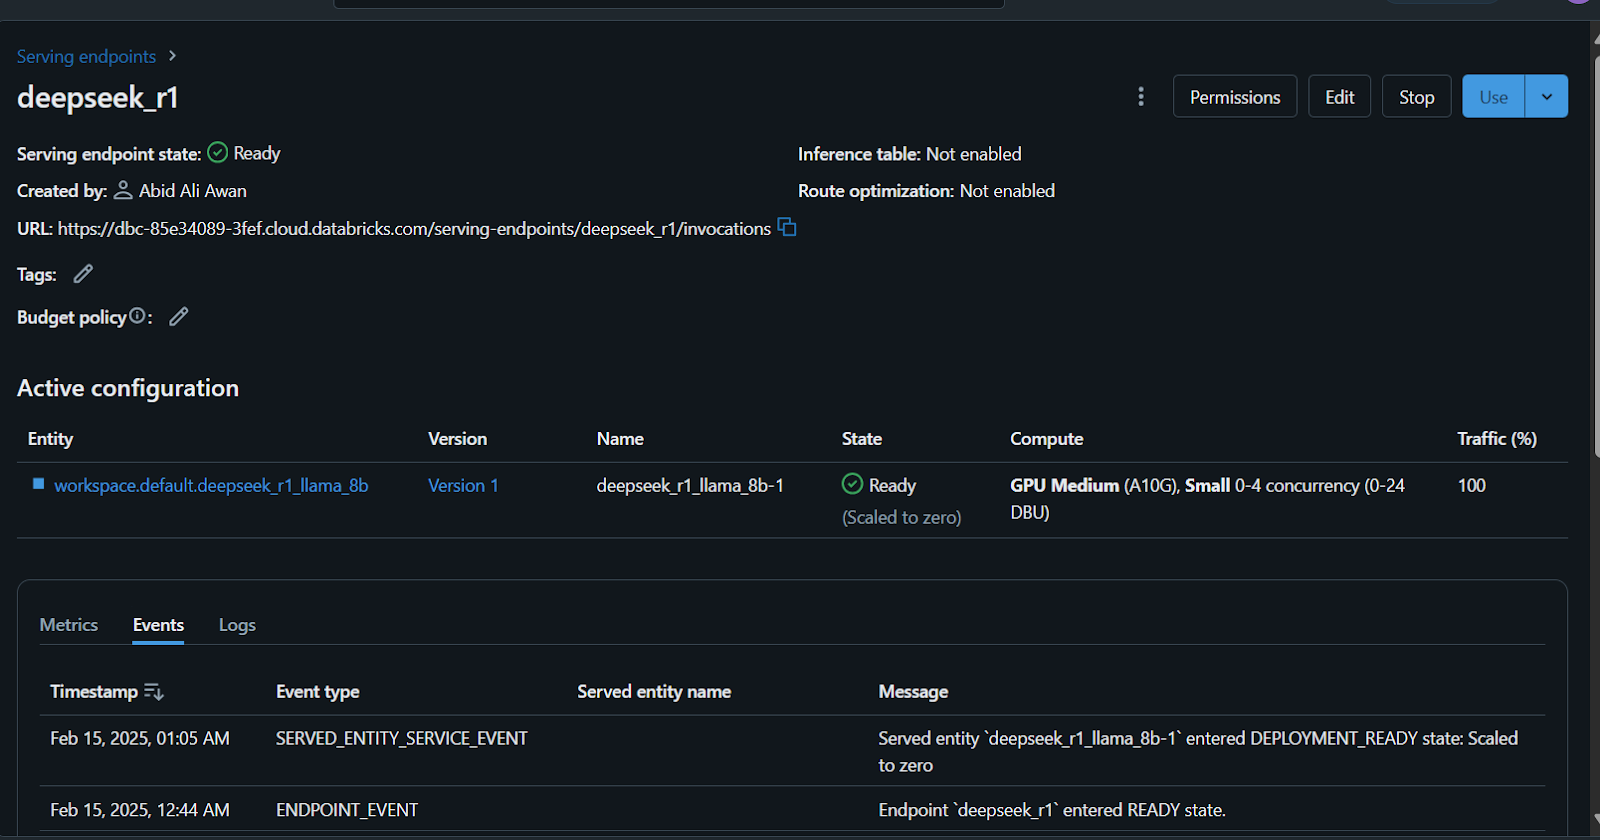
Het opzetten van het serving-endpoint duurt enkele minuten. De status kleurt groen en toont “Ready” zodra alles gereed is.
Je kunt DeepSeek R1 ook finetunen op een aangepaste dataset voordat je het model registreert. Volg de tutorial Fine-Tuning DeepSeek R1 om alles over dit proces te leren.
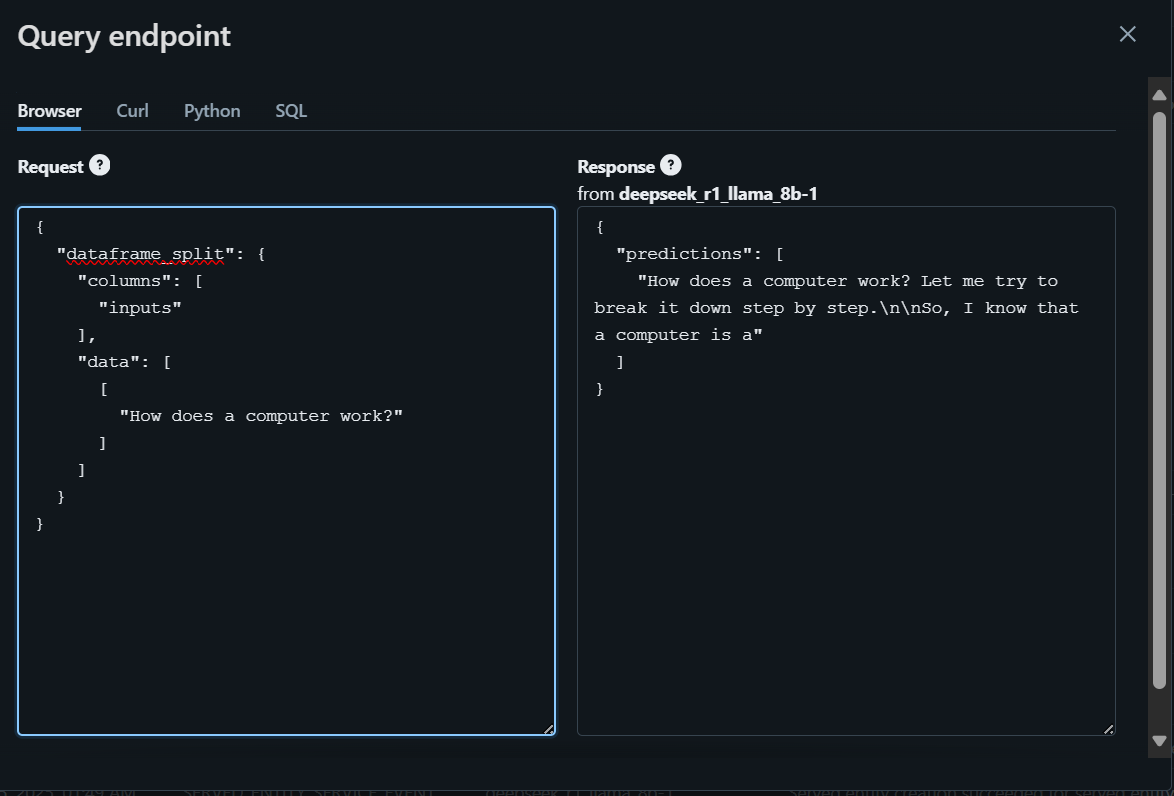
Er zijn veel manieren om dit model te gebruiken of te benaderen.
Om te beginnen stellen we de vraag via de browser en genereren we het antwoord.
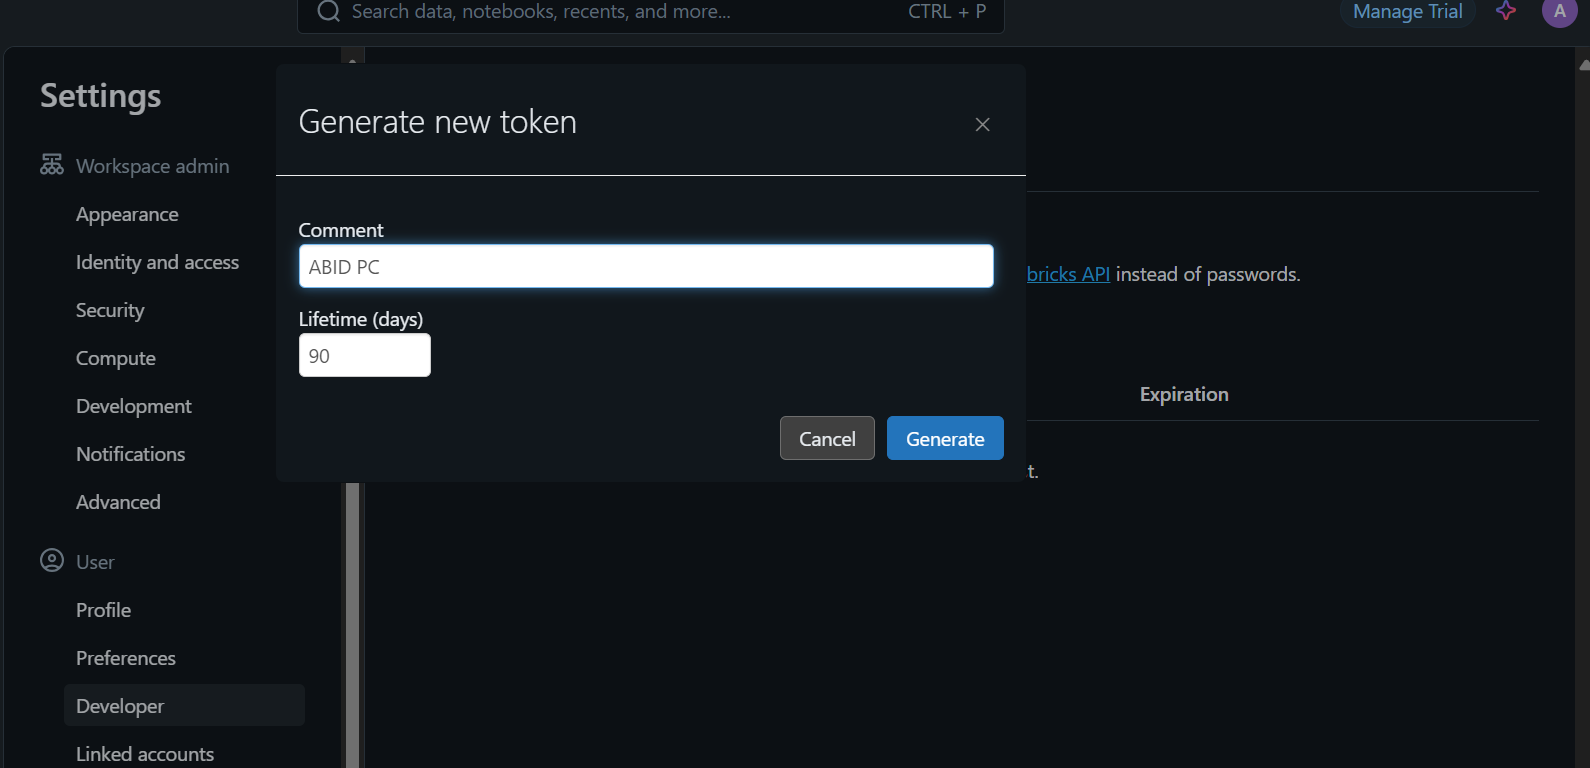
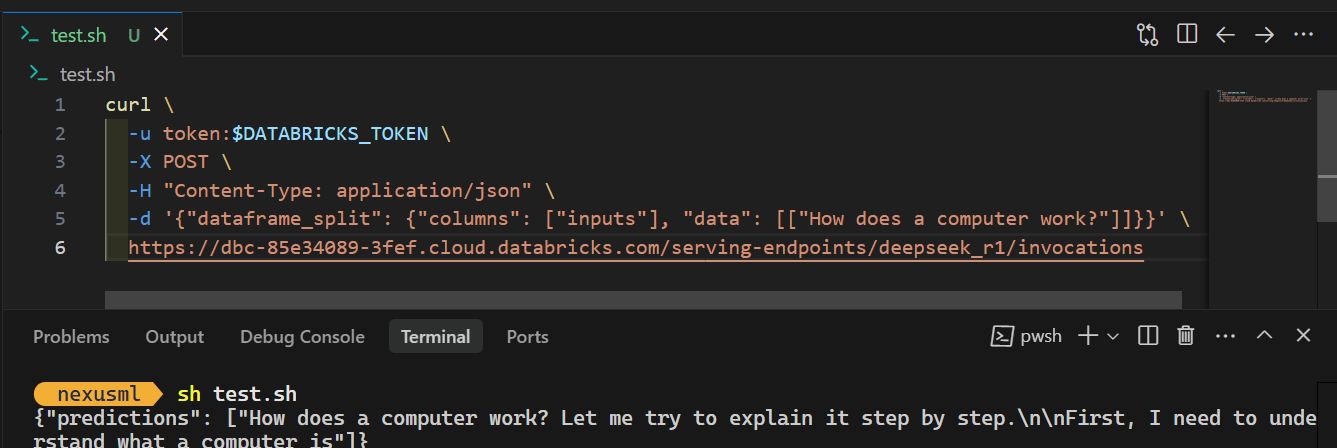
Wil je het model lokaal gebruiken of integreren in je applicatie, genereer dan eerst een Databricks API-sleutel.
curl \
  -u token:$DATABRICKS_TOKEN \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"dataframe_split": {"columns": ["inputs"], "data": [["How does a computer work?"]]}}' \
  https://dbc-85e34089.cloud.databricks.com/serving-endpoints/deepseek_r1/invocations
Zodra je het commando uitvoert, duurt het enkele seconden om het antwoord te genereren. Zo simpel is het!
Bekijk ook de blog DeepSeek R1 vs V3 om meer te leren over de beste grote taalmodellen van DeepSeek.
Het registreren en implementeren van het DeepSeek R1-model op Databricks is eenvoudig. Je kunt zelfs het grote model registreren en implementeren met een CPU-cluster of een lokale CPU-machine, zonder kosten te maken. Houd er wel rekening mee dat het draaien op een CPU traag kan zijn en geduld vergt, vooral bij het bouwen van de dockerimage.
In deze tutorial hebben we het volledige implementatieproces stap voor stap doorlopen. We begonnen met het instellen van Databricks en het registreren van het voorgetrainde DeepSeek Distilled R1-model in de Databricks Model Registry. Daarna hebben we via het Databricks-dashboard het model geïmplementeerd. Tot slot hebben we het geïmplementeerde model getest en laten zien hoe je het lokaal gebruikt met een eenvoudig CURL-commando.
Ben je nieuw in AI en grote taalmodellen? Volg dan de cursus Introduction to LLMs in Python. Zo leg je een sterke basis, leer je de belangrijkste termen kennen en kun je aan de slag met geavanceerde modellen zoals DeepSeek R1!
Leer meer over Databricks met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

