Kursus
Memahami Rekayasa Data
2 jam
378K
Seperti yang saya sebutkan, DuckDB berjalan di laptop Anda. Langkah pertama adalah memasangnya di sana.
Saya akan menunjukkan langkah instalasi untuk macOS, tetapi petunjuk untuk Windows dan Linux sudah dijelaskan dengan baik dan mudah diikuti.
Jika Anda menggunakan Mac, cara termudah memasang DuckDB adalah dengan Homebrew. Jalankan perintah shell berikut:
brew install duckdbDalam hitungan detik, Anda akan melihat keluaran seperti berikut:
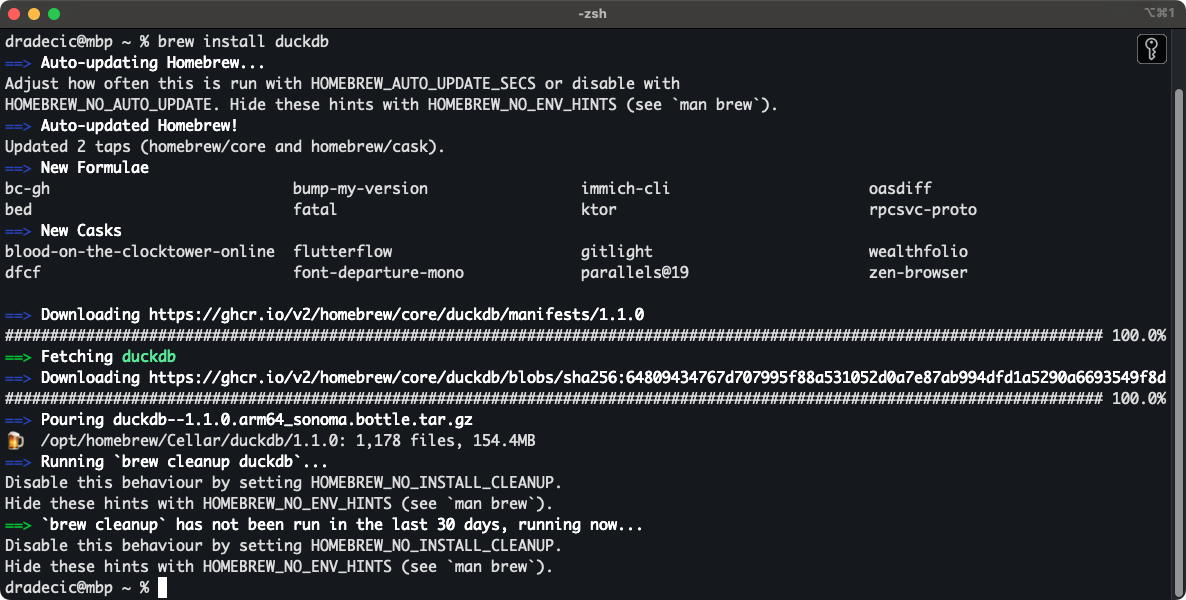
Menginstal DuckDB dengan Homebrew
Setelah terpasang, Anda dapat masuk ke shell DuckDB dengan perintah berikut:
duckdb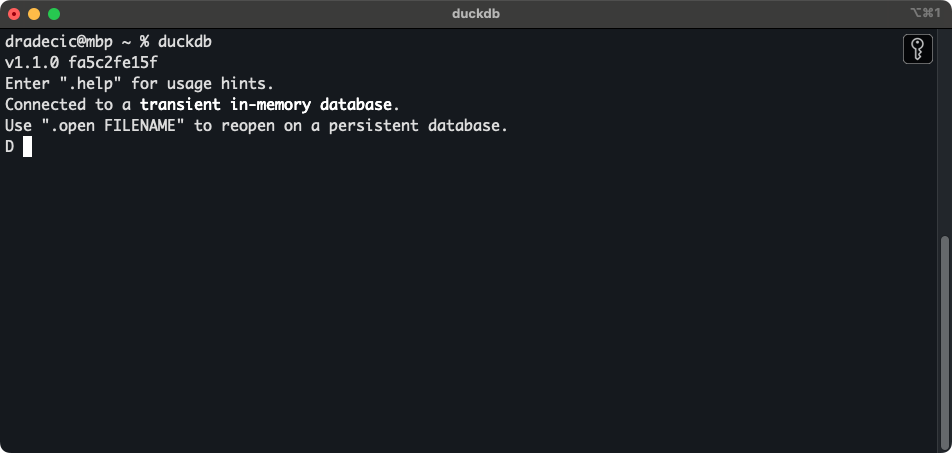
Shell DuckDB
Dari sini, dunia ada di tangan Anda!
Anda dapat menulis dan menjalankan kueri SQL langsung dari konsol. Misalnya, saya telah mengunduh data NYC Taxi enam bulan pertama tahun 2024. Jika Anda melakukan hal yang sama, gunakan cuplikan berikut untuk menampilkan jumlah baris dari satu file Parquet:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");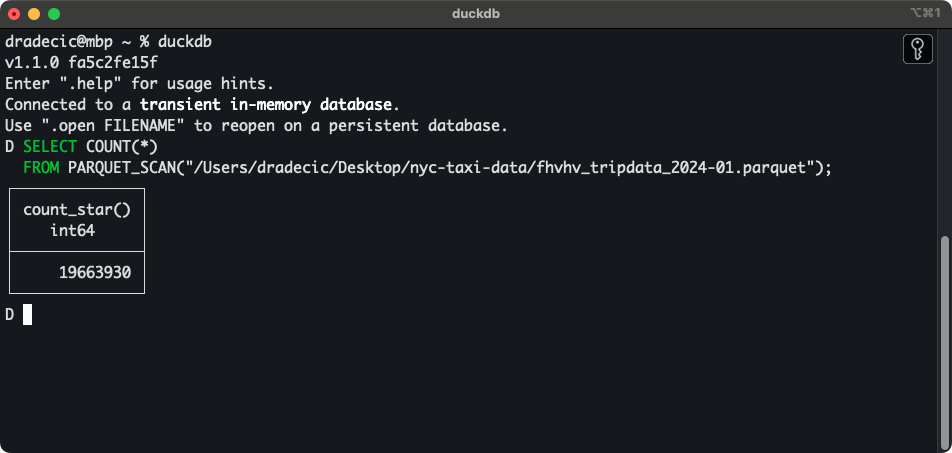
Jumlah baris file Parquet tunggal
Benar — itu hampir 20 juta baris dari satu file. Saya mengunduh 24 file.
Anda mungkin tidak ingin menjalankan DuckDB dari terminal, jadi berikutnya, saya akan memandu Anda menyambungkan DuckDB dengan Python.
Tujuan bagian ini adalah menunjukkan cara mengonfigurasi dan menjalankan DuckDB dalam bahasa paling populer untuk data engineering: Python.
Bahkan, DataCamp menawarkan jalur karier lengkap untuk data engineering dengan Python.
Python memiliki pustaka DuckDB khusus yang perlu Anda instal terlebih dahulu. Jalankan perintah berikut dari terminal, sebaiknya di lingkungan virtual:
pip install duckdbSekarang buat file Python baru dan tempelkan kode berikut:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Singkatnya, cuplikan kode ini memiliki fungsi yang mengambil jumlah baris dari satu file, dengan memberikan koneksi DuckDB yang valid dan path file.
Anda akan mendapatkan hasil berikut hampir seketika setelah menjalankan skrip:
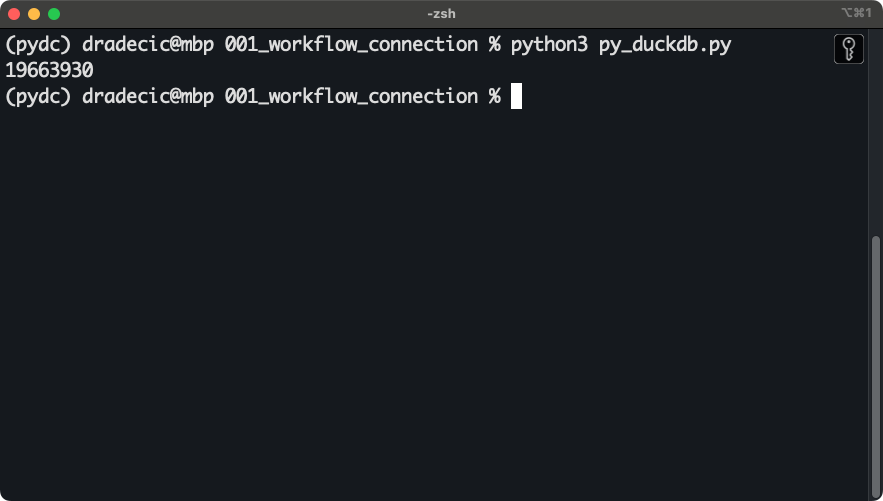
Koneksi DuckDB dan Python
Itu saja!
Selanjutnya, saya akan menunjukkan cara melakukan hal-hal hebat dengan Python dan DuckDB dengan sangat cepat!
Sebagai acuan, saya akan menjalankan kode pada bagian 2024 (Januari - Juni) dari Dataset NYC Taxi — khusus untuk kendaraan for-hire ber-volume tinggi. Itu berarti 6 file Parquet, berukuran sekitar 3GB ruang disk. Untuk perangkat keras, saya menggunakan MacBook Pro 16” M3 Pro dengan 12 core CPU dan 36GB unified memory.
Hasil Anda bisa berbeda, tetapi seharusnya masih berada di kisaran yang mirip.
Saya telah mengonversi 6 file ini ke dua format tambahan — CSV dan JSON. Anda dapat melihat berapa banyak ruang disk yang dibutuhkan masing-masing:
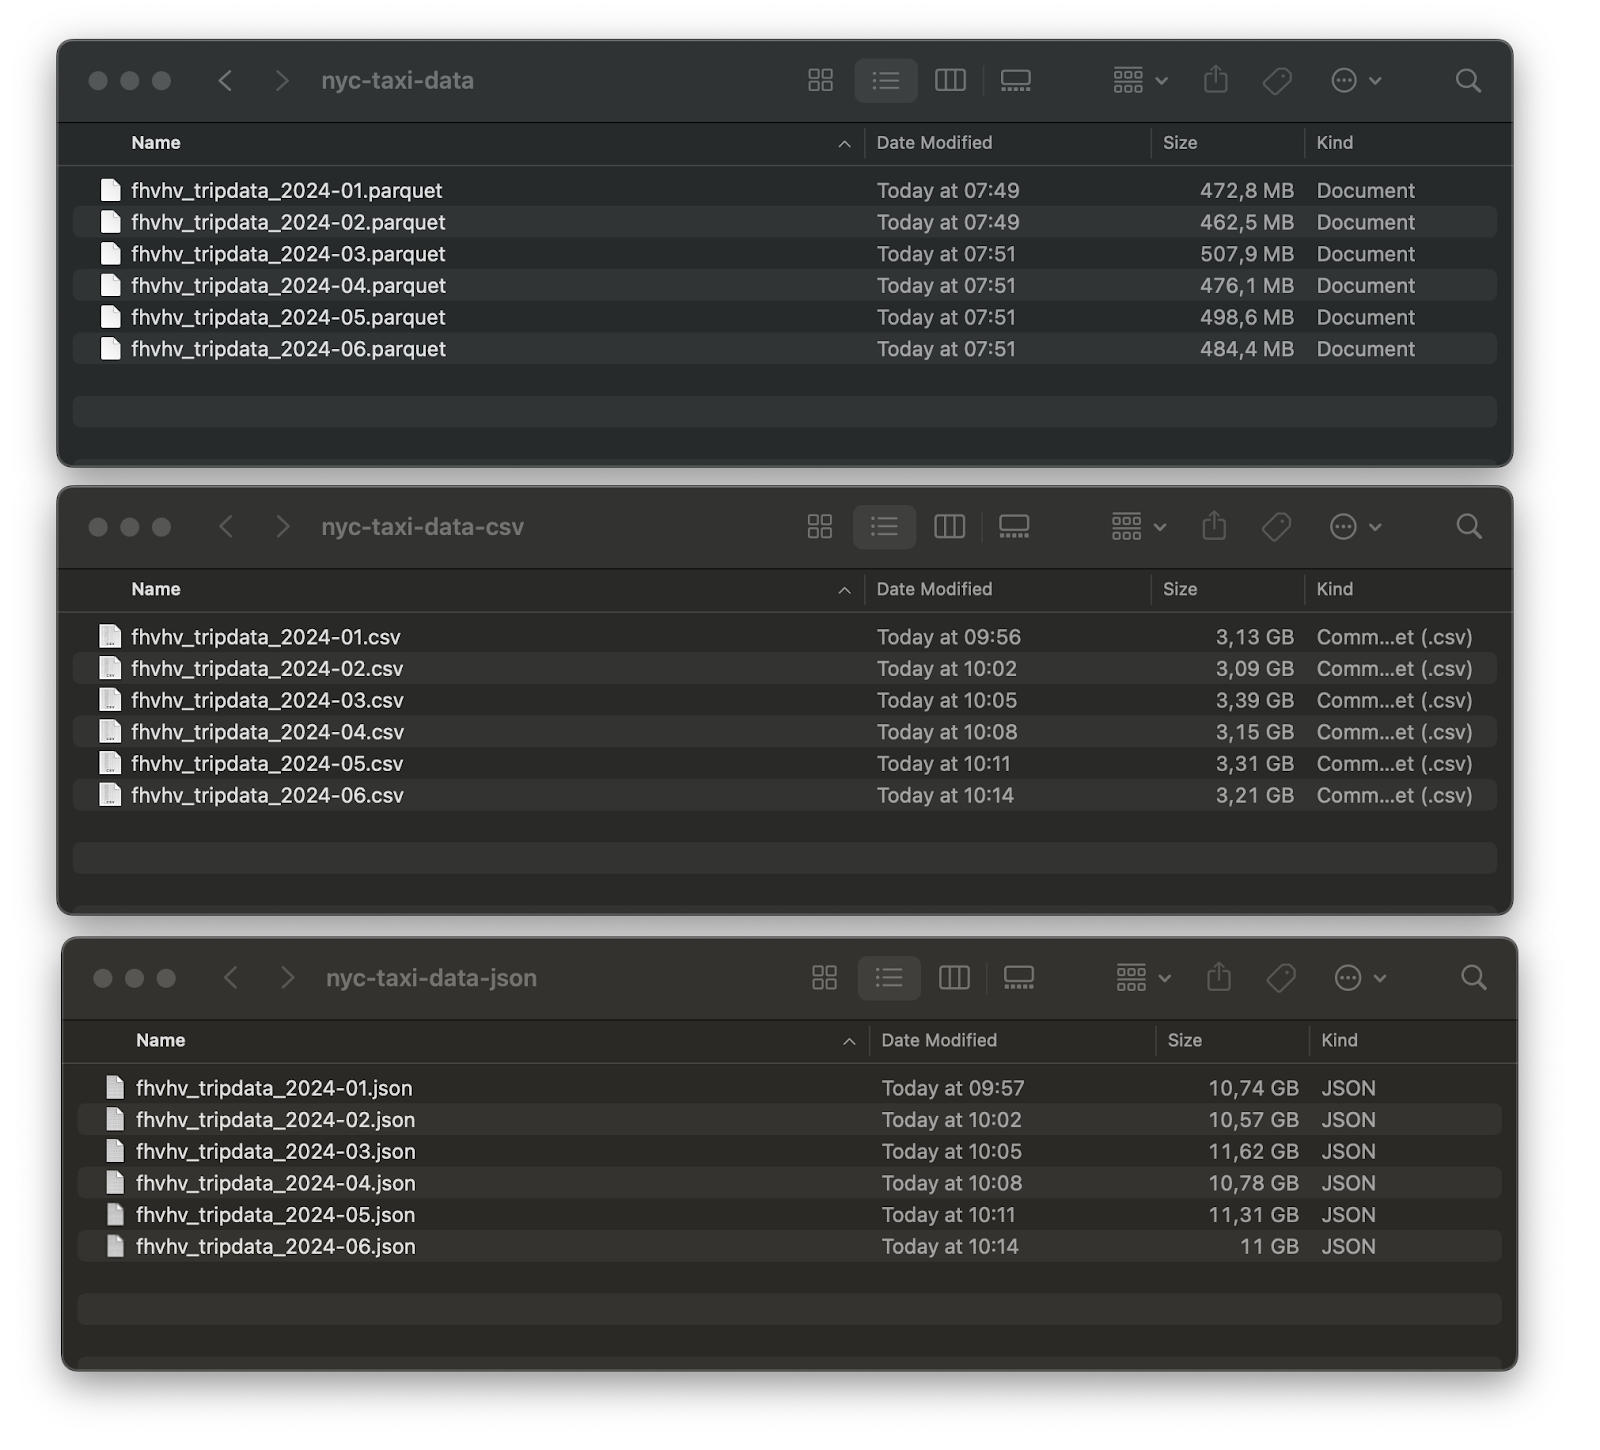
Perbandingan ukuran dataset
Total: 2,96GB untuk Parquet, 19,31GB untuk CSV, dan 66,04GB untuk JSON.
Perbedaannya besar! Jika tidak ada hal lain yang Anda ingat dari artikel hari ini, setidaknya ingatlah untuk selalu menggunakan format file Parquet saat menangani file besar. Ini akan menghemat waktu pemrosesan dan ruang disk.
DuckDB memiliki fungsi praktis yang dapat membaca beberapa file dengan format yang sama sekaligus (menggunakan pola glob). Saya akan menggunakannya untuk membaca keenamnya guna mendapatkan jumlah baris dan membandingkan runtime:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Hasilnya sudah ada — pemenangnya jelas hanya satu:
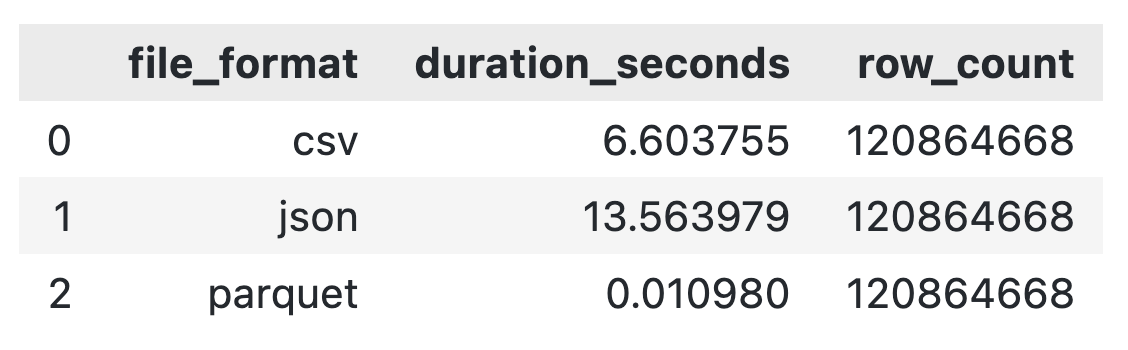
Perbandingan runtime pembacaan file
Berkat DuckDB, ketiganya cepat dan berakhir di tempat yang sama, tetapi jelas Parquet menang dengan faktor 600 dibanding CSV dan dengan faktor 1200 dibanding JSON.
Untuk alasan ini, saya hanya akan menggunakan Parquet untuk sisa artikel.
DuckDB memungkinkan Anda mengagregasikan data melalui SQL.
Tujuan saya di bagian ini adalah mengembangkan gagasan tersebut. Lebih tepatnya, saya akan menunjukkan cara menghitung statistik ringkasan pada level bulanan yang mencakup informasi tentang jumlah perjalanan, waktu perjalanan, jarak perjalanan, biaya perjalanan, dan bayaran pengemudi—semuanya dari 120 juta baris data.
Bagian terbaiknya: Hanya butuh dua detik!
Ini adalah kode yang saya gunakan di dalam skrip Python untuk mengagregasikan data dan mencetak hasilnya:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
Keluaran berisi hasil agregasi, tipe variabel untuk results, dan total runtime:
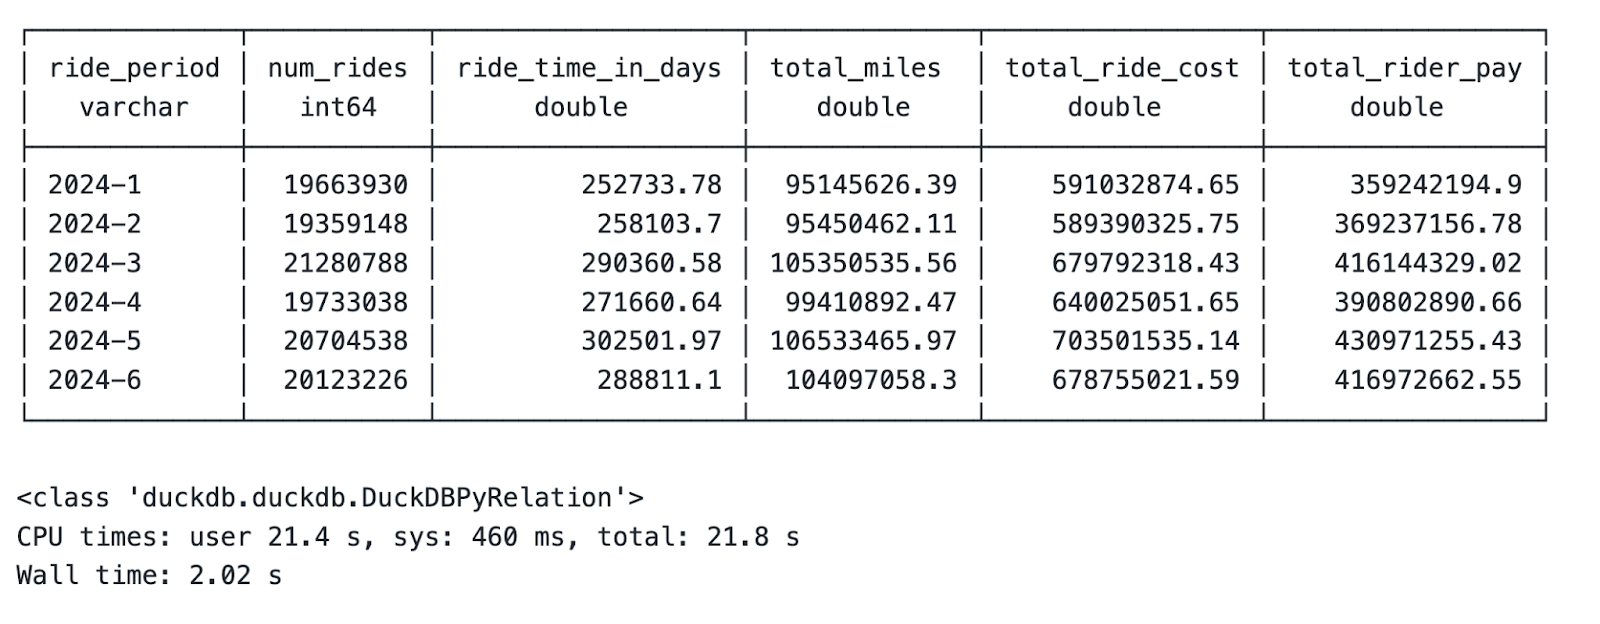
Agregasi statistik ringkasan bulanan
Renungkan sejenak: Itu 3GB data dengan lebih dari 120 juta baris, semuanya diagregasikan dalam 2 detik di laptop!
Satu-satunya masalah adalah tipe variabelnya agak kurang berguna untuk jangka panjang. Untungnya, ada solusi mudah.
Kelebihan menggunakan DuckDB bukan hanya cepat, tetapi juga terintegrasi baik dengan pustaka data frame favorit Anda: pandas.
Jika Anda memiliki himpunan hasil sementara seperti yang saya tunjukkan di atas, Anda hanya perlu memanggil metode .df() untuk mengonversinya menjadi DataFrame pandas:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df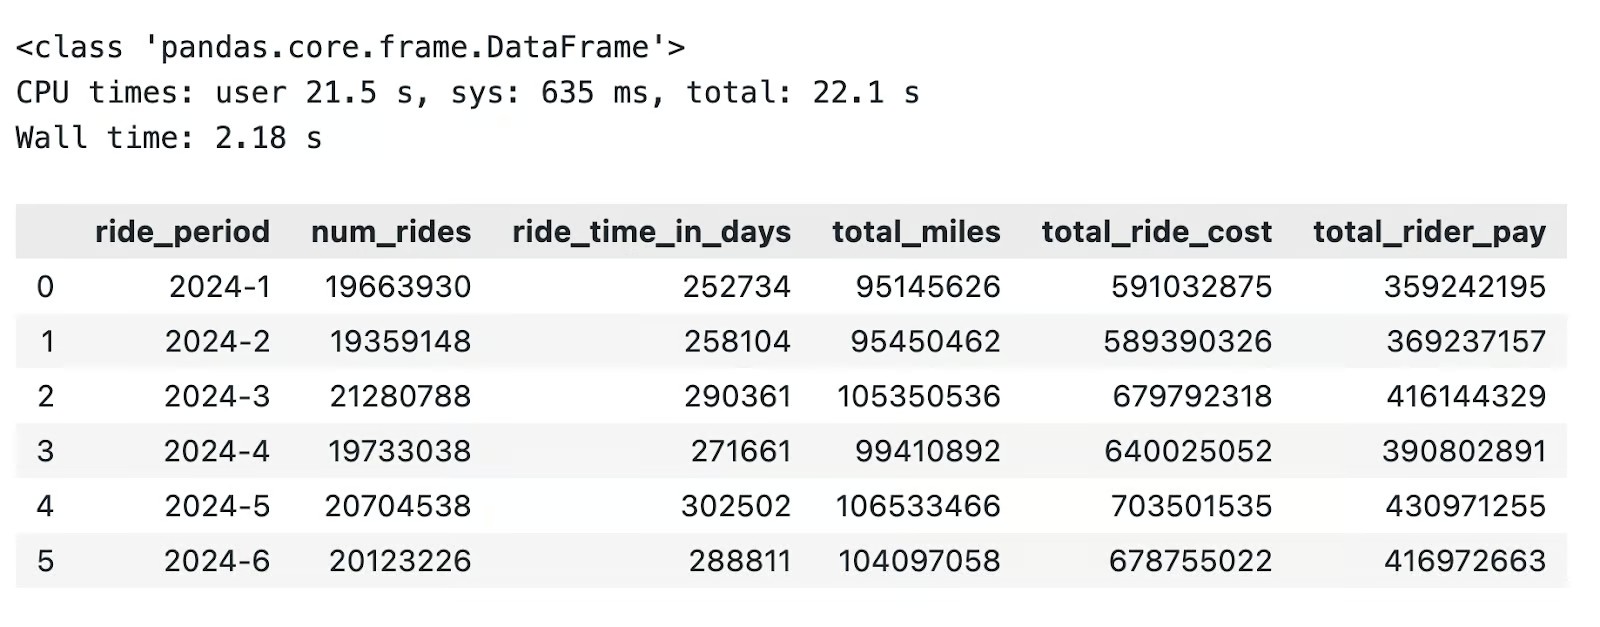
Konversi DuckDB ke pandas
Demikian pula, Anda dapat menggunakan DuckDB untuk melakukan perhitungan pada DataFrame pandas yang sudah dimuat ke memori.
Kuncinya adalah merujuk nama variabel setelah kata kunci FROM dalam kueri SQL DuckDB. Berikut contohnya:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res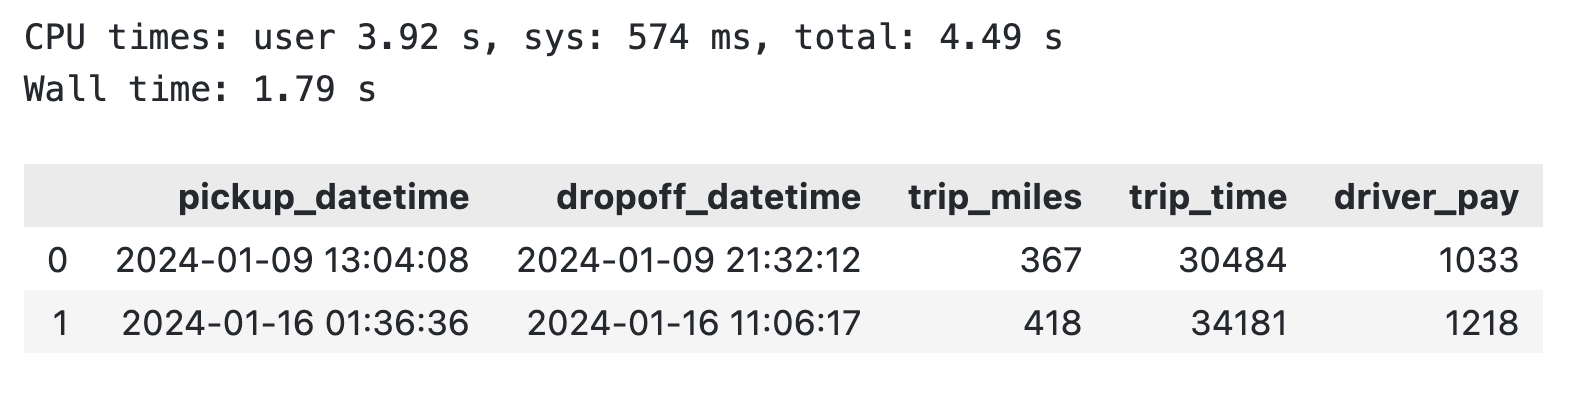
Kueri DuckDB pada DataFrame pandas yang sudah ada
Kesimpulannya, Anda dapat sama sekali menghindari pandas atau melakukan agregasi lebih cepat pada DataFrame pandas yang ada.
Berikutnya, saya akan menunjukkan beberapa fitur DuckDB tingkat lanjut.
Ada banyak hal tentang DuckDB yang tidak terlihat di permukaan.
Di bagian ini, saya akan memandu Anda melalui beberapa fitur DuckDB tingkat lanjut yang esensial bagi data engineer.
DuckDB memungkinkan Anda memperluas fungsionalitas bawaannya melalui ekstensi inti dan komunitas extensions. Saya sering menggunakan ekstensi untuk terhubung ke sistem penyimpanan cloud dan database serta bekerja dengan format file tambahan.
Anda dapat memasang ekstensi melalui konsol Python maupun DuckDB.
Pada cuplikan kode di bawah, saya menunjukkan cara memasang ekstensi httpfs yang diperlukan untuk terhubung ke AWS dan membaca data S3:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Anda tidak akan melihat keluaran apa pun jika tidak merantai metode .df() ke conn.execute(). Jika Anda melakukannya, Anda akan melihat pesan “Success” atau “Error”.
Sering kali, perusahaan Anda akan memberi akses ke data yang harus Anda masukkan ke pipeline. Biasanya data ini disimpan pada platform cloud yang skalabel, seperti AWS S3.
DuckDB memungkinkan Anda terhubung ke S3 (dan platform lain) secara langsung.
Saya sudah menunjukkan cara memasang ekstensi (httpfs), dan satu-satunya yang tersisa adalah mengonfigurasinya. AWS mengharuskan Anda memberikan informasi region, access key, dan secret access key.
Dengan asumsi Anda memiliki semuanya, jalankan perintah berikut melalui Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Bucket S3 saya berisi dua file dari dataset New York Taxi:
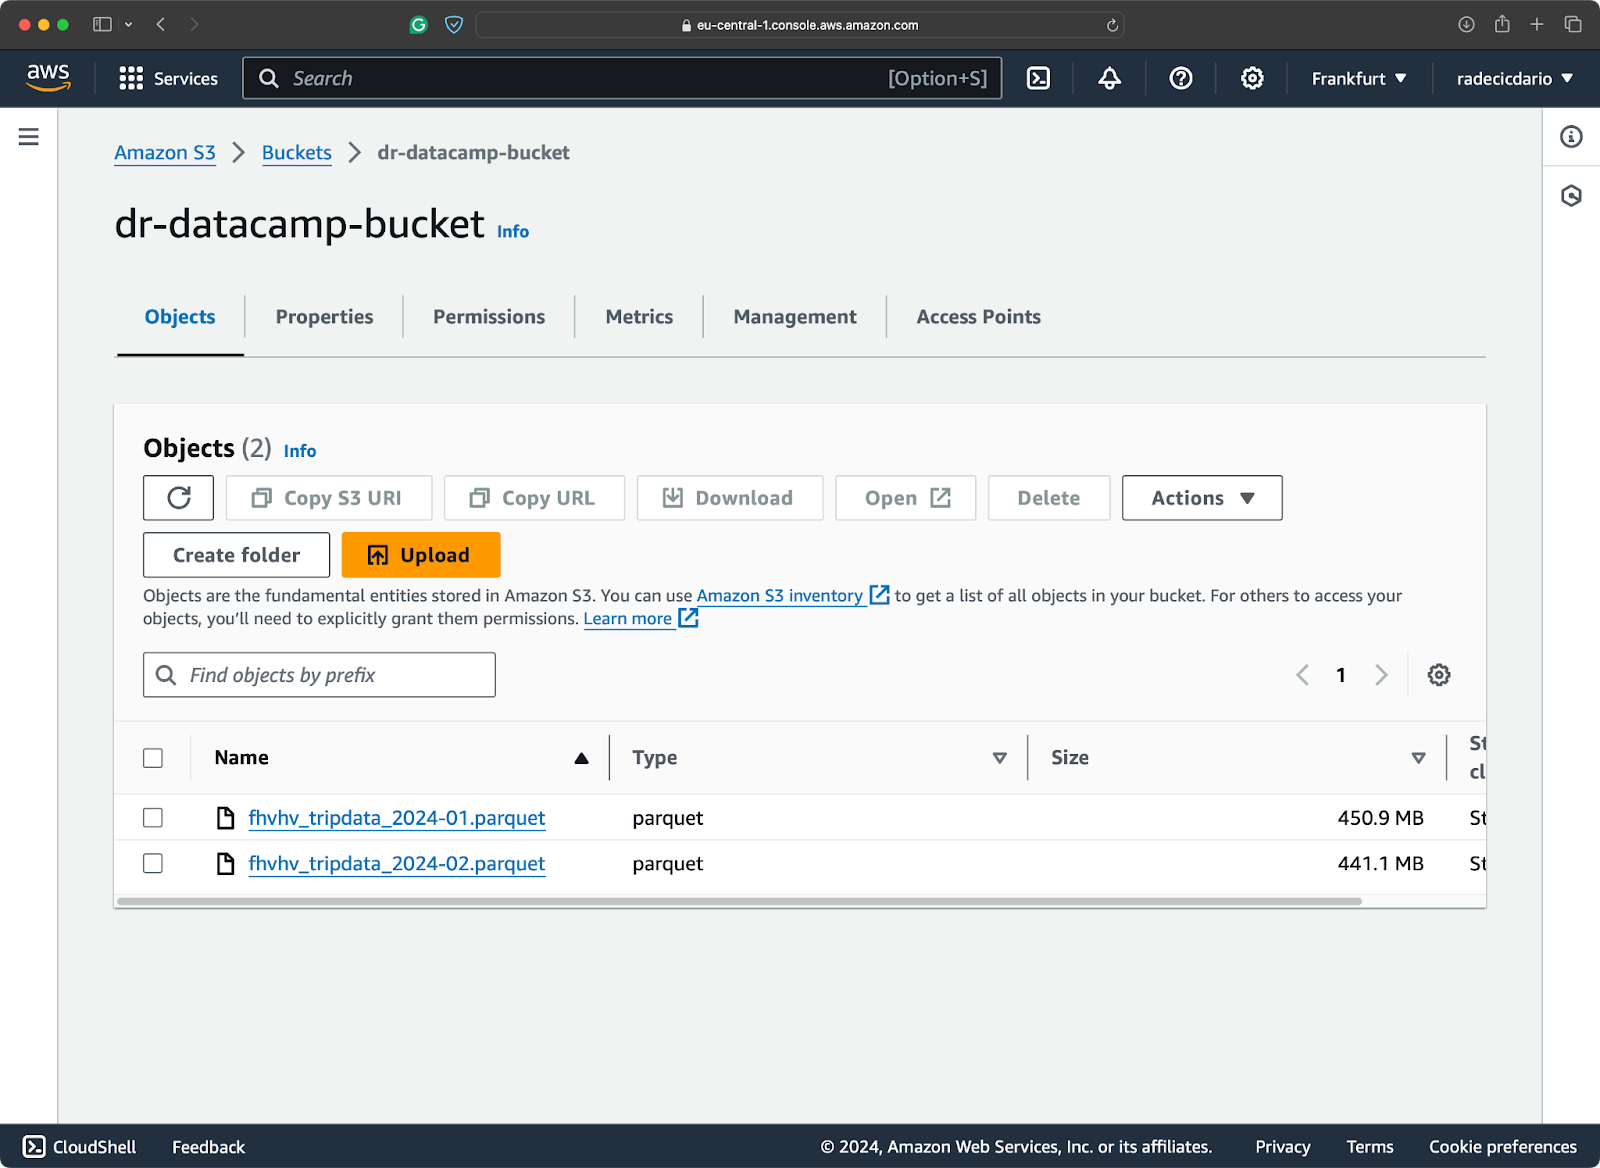
Isi bucket S3
Tidak perlu mengunduh file, karena Anda dapat memindainya langsung dari S3:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count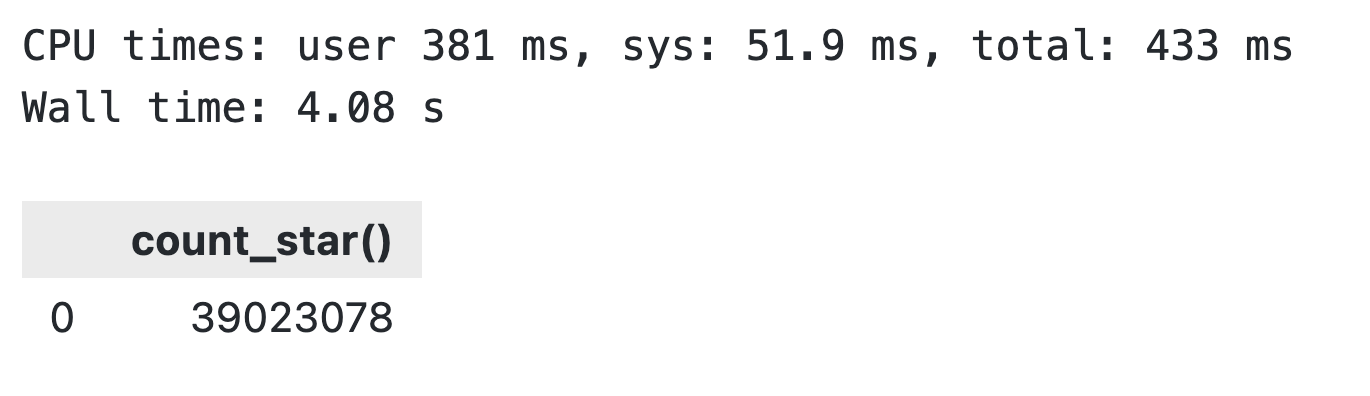
Hasil fetch DuckDB S3
Anda tidak salah baca: Hanya butuh 4 detik untuk menelusuri ~ 900MB data yang berada di bucket S3.
Dalam hal paralelisasi, DuckDB menerapkannya secara default berdasarkan row group: partisi data horizontal yang biasanya Anda temukan di Parquet. Satu row group dapat memiliki maksimum 122.880 baris.
Paralelisme di DuckDB dimulai saat Anda bekerja dengan lebih dari 122.880 baris.
DuckDB akan otomatis meluncurkan thread baru saat itu terjadi. Secara default, jumlah thread sama dengan jumlah core CPU. Namun Anda tetap bisa mengatur jumlah thread secara manual.
Di bagian ini, saya akan menunjukkan caranya dan dampak pasti dari jumlah thread yang berbeda pada beban kerja yang identik.
Untuk melihat jumlah thread saat ini, jalankan perintah berikut:
SELECT current_setting('threads') AS threads;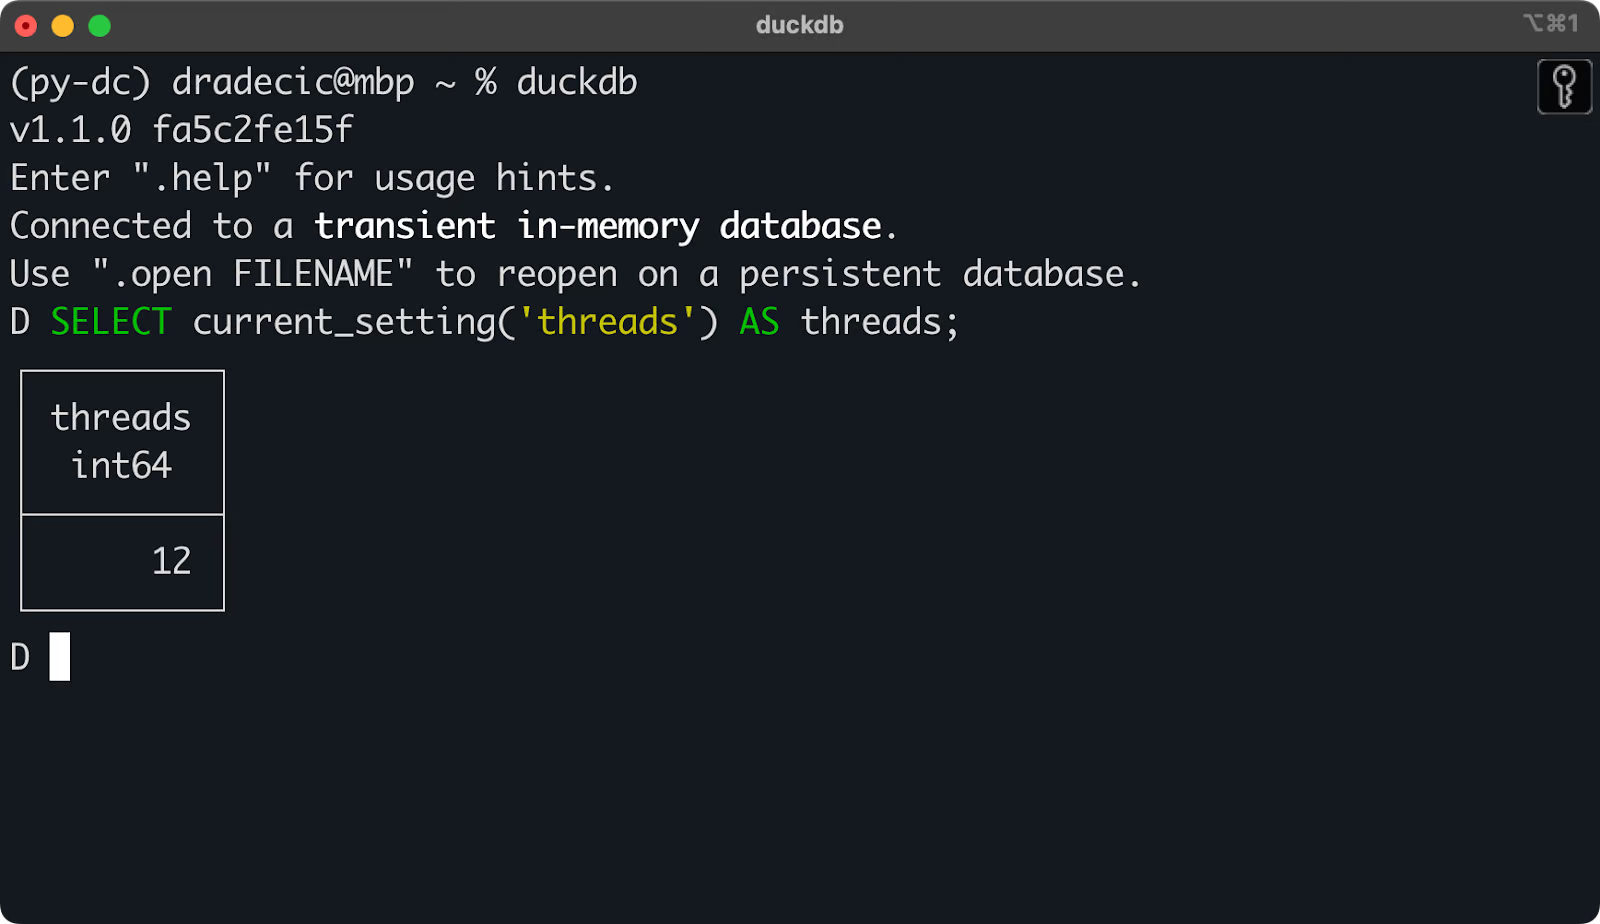
Jumlah thread saat ini yang digunakan oleh DuckDB
Anda bisa mendapatkan hasil yang sama melalui Python.
Anda akan ingin menjalankan perintah SET threads = N untuk mengubah jumlah thread.
Pada cuplikan kode berikut, saya akan menunjukkan cara menerapkan fungsi Python kustom yang menjalankan kueri DuckDB pada jumlah thread tertentu, mengonversinya menjadi DataFrame pandas, dan mengembalikan runtime (dan informasi lainnya). Kode di bawah fungsi menjalankannya pada rentang thread [1, 12]:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Anda akan melihat keluaran yang mirip dengan milik saya:
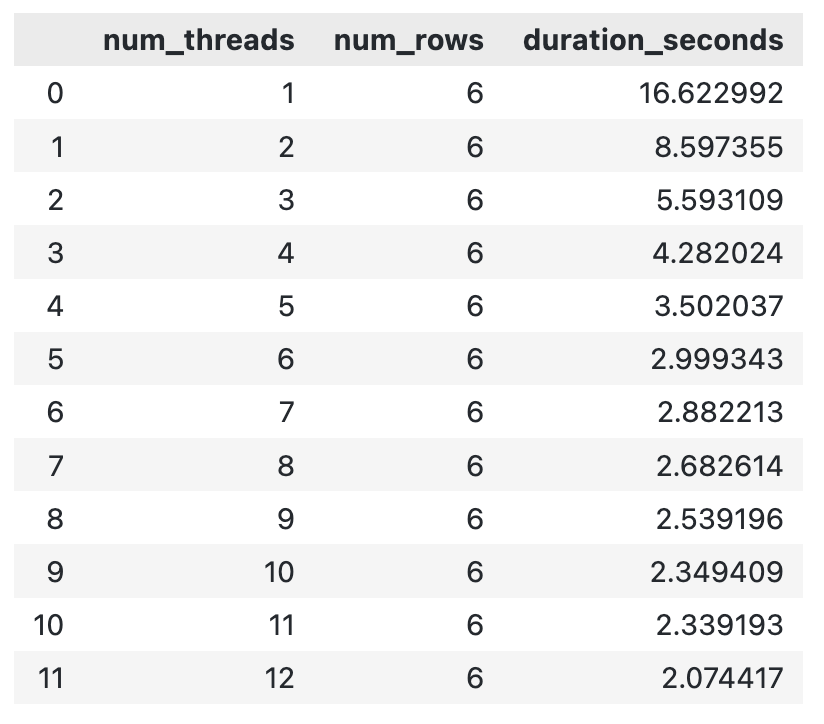
Runtime DuckDB untuk jumlah thread yang berbeda
Secara umum, semakin banyak thread yang Anda gunakan untuk suatu komputasi, semakin cepat selesai. Mungkin ada titik di mana overhead pembuatan thread baru justru meningkatkan total runtime, tetapi saya tidak menemukannya dalam rentang ini.
Di bagian ini, saya akan menunjukkan cara menulis pipeline data dari nol. Ini akan relatif sederhana: membaca data dari disk, melakukan agregasi, dan menulis hasilnya. Tujuan saya adalah menunjukkan seberapa besar performa yang bisa Anda dapatkan dengan beralih dari pandas ke DuckDB. Selain itu, kode Anda juga akan terlihat lebih bersih.
Ini bukan pengantar komprehensif ke proses ETL/ELT melainkan gambaran tingkat tinggi.
Pipeline data yang akan saya tunjukkan mencapai hal-hal berikut:
Setelah menjalankan kodenya, Anda akan mendapatkan hasil agregasi yang persis sama untuk kedua implementasi pipeline (mengabaikan sedikit perbedaan pembulatan):
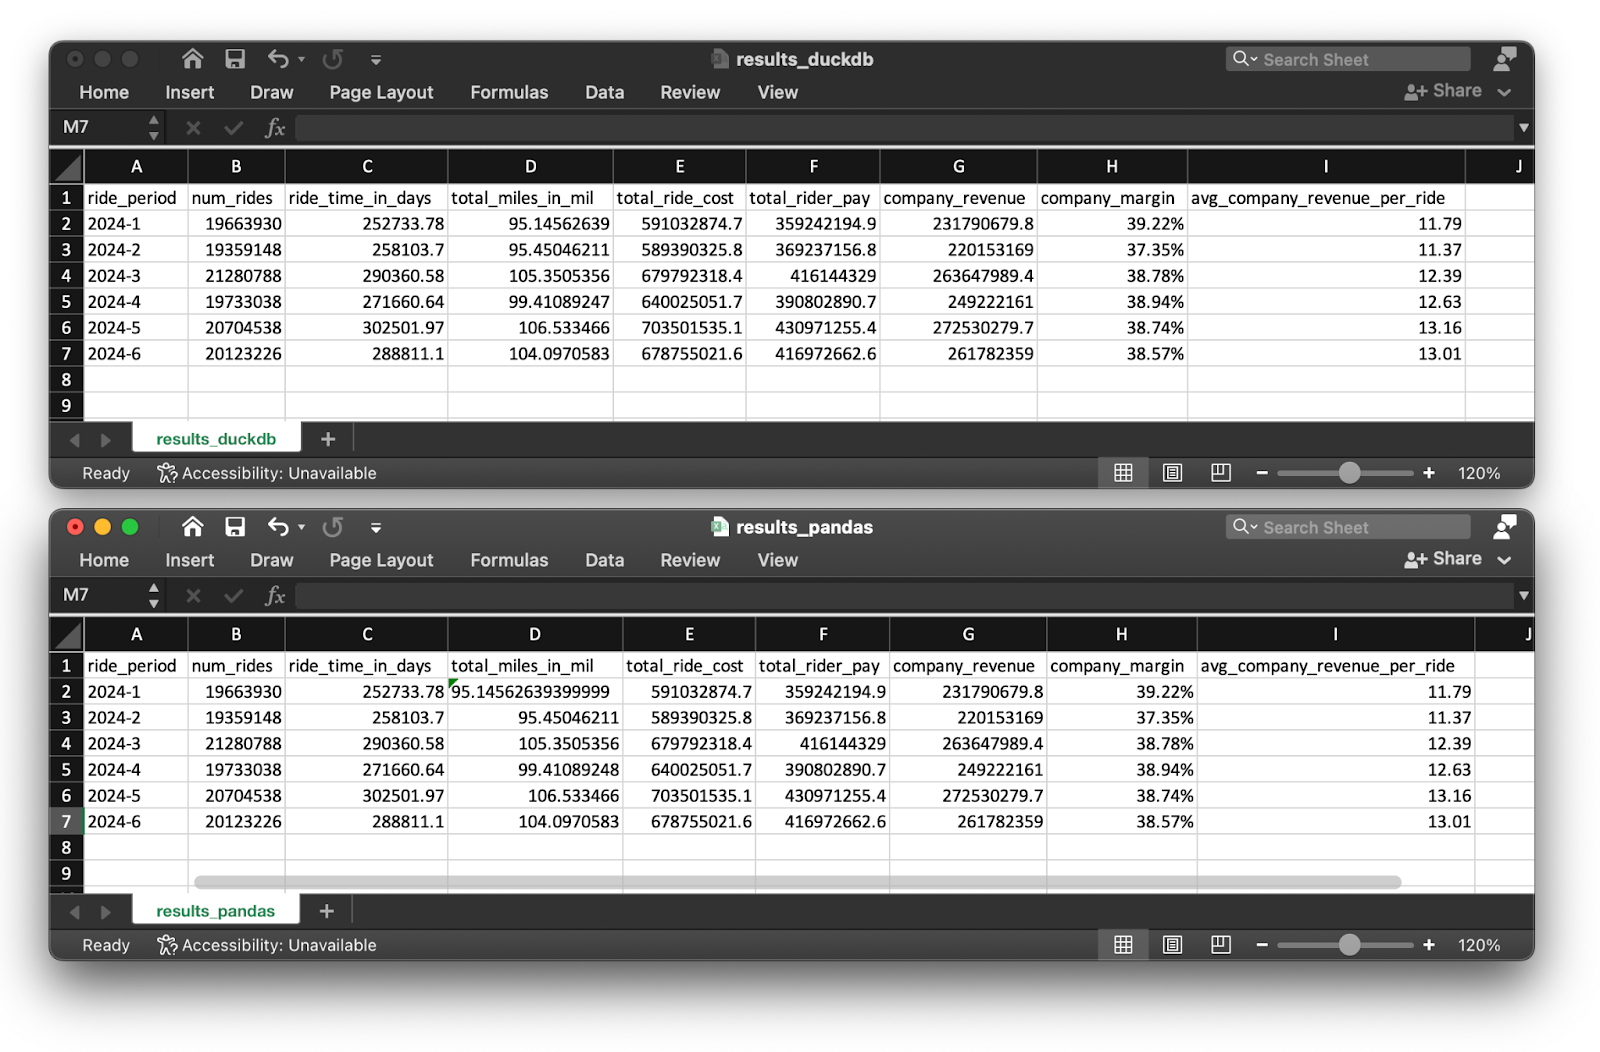
Hasil pipeline untuk DuckDB dan pandas
Pertama, mari kita bahas implementasi pipeline di pandas.
Apa pun yang saya coba, saya tidak bisa memproses keenam file Parquet sekaligus. Pesan peringatan sistem seperti ini muncul dalam hitungan detik:
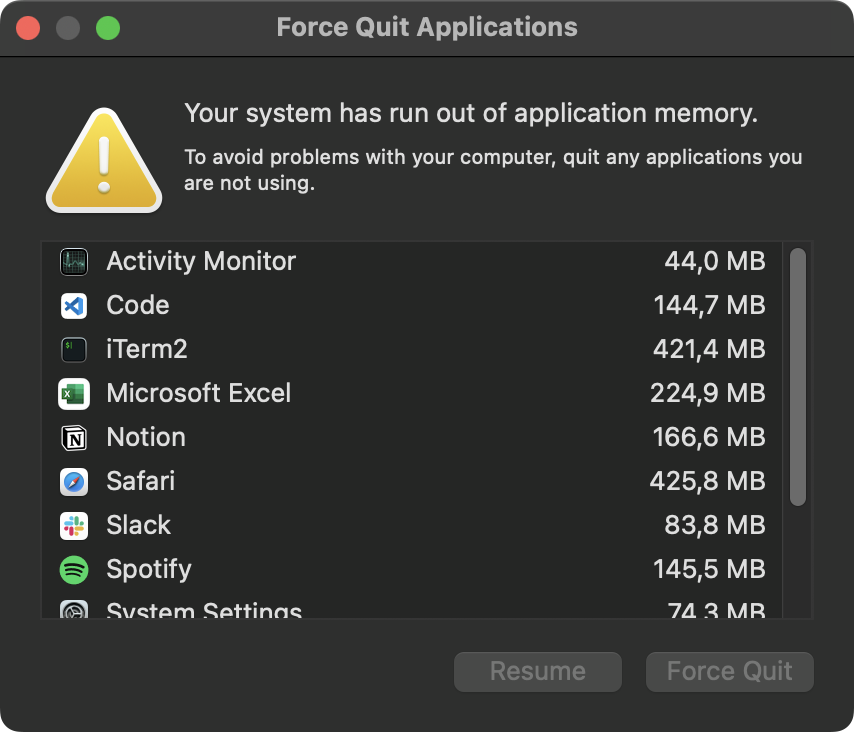
Galat memori sistem
Tampaknya 36GB memori tidak cukup untuk memproses 120 juta baris sekaligus. Akibatnya, skrip Python dihentikan:
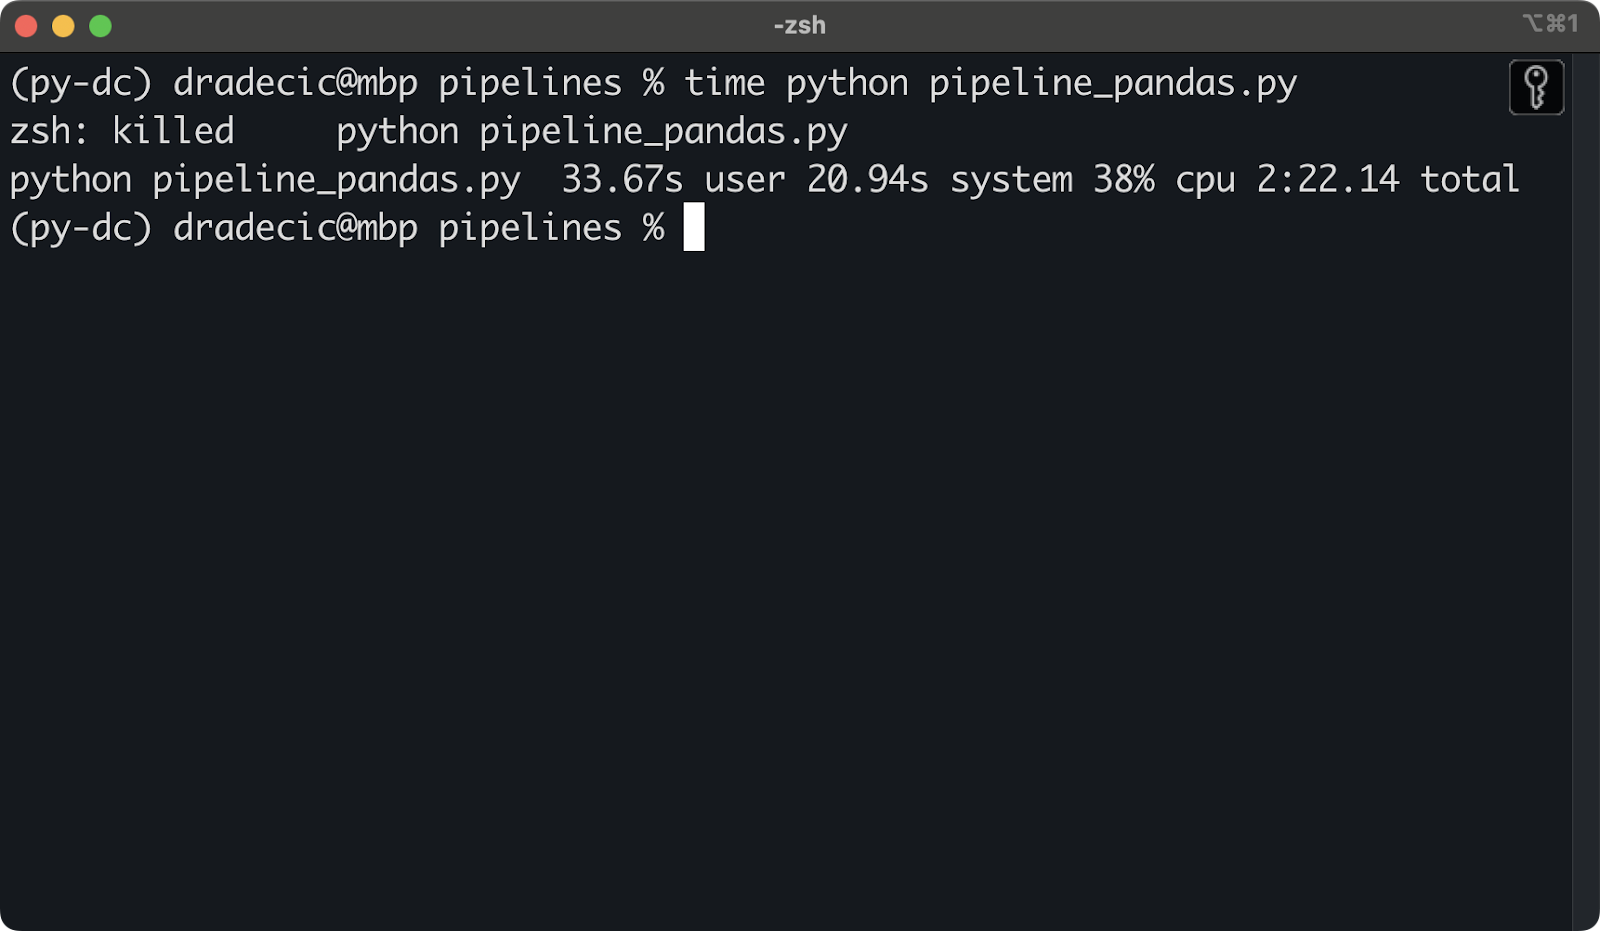
Skrip Python dihentikan karena memori tidak mencukupi
Untuk mengatasinya, saya harus memproses file Parquet secara berurutan. Berikut kode yang saya gunakan untuk pipeline data:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Implementasi pipeline di DuckDB semoga selesai tanpa masalah memori.
Anda sudah familier dengan sebagian besar kode DuckDB.
Satu-satunya hal baru adalah SELECT teratas, karena menghitung beberapa statistik tambahan. Sisanya saya biarkan apa adanya:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Berikutnya, saya akan menunjukkan perbedaan runtime-nya.
Setelah menjalankan kedua pipeline 5 kali dan merata-ratakan hasilnya, berikut runtime yang saya dapatkan:
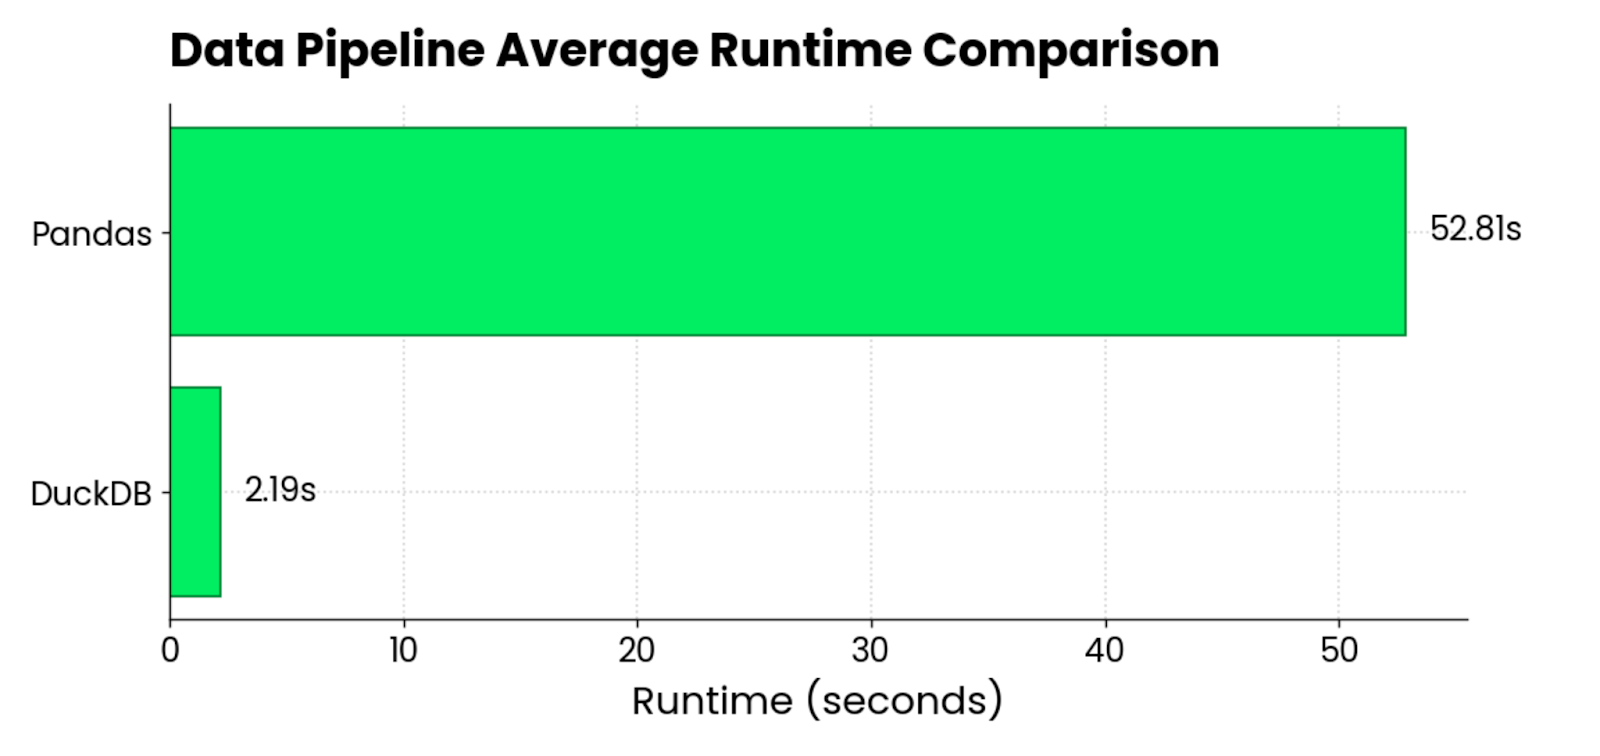
Bagan perbandingan runtime DuckDB vs. pandas
pandas rata-rata 24 kali lebih lambat daripada DuckDB saat memuat dan memproses sekitar 120 juta baris (~3GB), tersebar di 6 file Parquet.
Perbandingan ini tidak sepenuhnya adil, karena saya tidak bisa memproses semua file Parquet sekaligus dengan pandas. Meski begitu, hasilnya tetap relevan karena Anda akan menghadapi kesulitan yang sama di pekerjaan sehari-hari.
Jika satu pustaka tidak bisa melakukan yang Anda butuhkan, cobalah yang lain. Dan yang kemungkinan besar akan selesai paling cepat hampir setiap saat adalah DuckDB.
Sebelum membiarkan Anda mengeksplorasi DuckDB lebih jauh sendiri, saya ingin berbagi beberapa praktik terbaik umum dan terkait data engineering:
SELECT. Anda sebaiknya menghindarinya pada alur kerja yang bergantung pada pernyataan INSERT dan UPDATE yang sering. Jika demikian, gunakan SQLite sebagai gantinya.Sebagai kesimpulan, menurut saya Anda harus mencoba DuckDB jika Anda adalah data engineer yang bertanggung jawab membangun dan mengoptimalkan pipeline data.
Anda tidak rugi apa pun dan berpotensi mendapatkan banyak. Alat ini hampir pasti lebih cepat daripada apa pun yang ditawarkan Python. Ini berjalan sangat cepat di laptop Anda dan memungkinkan Anda menelusuri dataset yang jika tidak akan menimbulkan galat memori. Bahkan dapat terhubung ke platform penyimpanan cloud ketika Anda tidak ingin atau tidak diizinkan menyimpan data secara lokal.
Meski begitu, DuckDB bukan satu-satunya optimasi yang perlu Anda hadirkan. Anda harus selalu berusaha mengoptimalkan data yang masuk ke sistem Anda. Misalnya, meninggalkan CSV dan beralih ke Parquet akan menghemat waktu komputasi dan penyimpanan. Optimasi lain yang perlu Anda pertimbangkan adalah menerapkan prinsip arsitektur data modern ke dalam alur kerja dan pipeline Anda.
DuckDB hanyalah sebuah alat. Namun sangat kuat.
Pelajari lebih lanjut tentang data engineering dengan kursus-kursus ini!
Kursus
Program
Program
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



