Corso
Capire il Data Engineering
2 ore
377.9K
Come dicevo, DuckDB gira sul tuo laptop. La prima cosa da fare è installarlo.
Ti mostrerò i passaggi d’installazione per macOS, ma le istruzioni per Windows e Linux sono ben spiegate e facili da seguire.
Se hai un Mac, il modo più semplice per installare DuckDB è con Homebrew. Esegui il seguente comando da shell:
brew install duckdbIn pochi secondi vedrai un output simile al seguente:
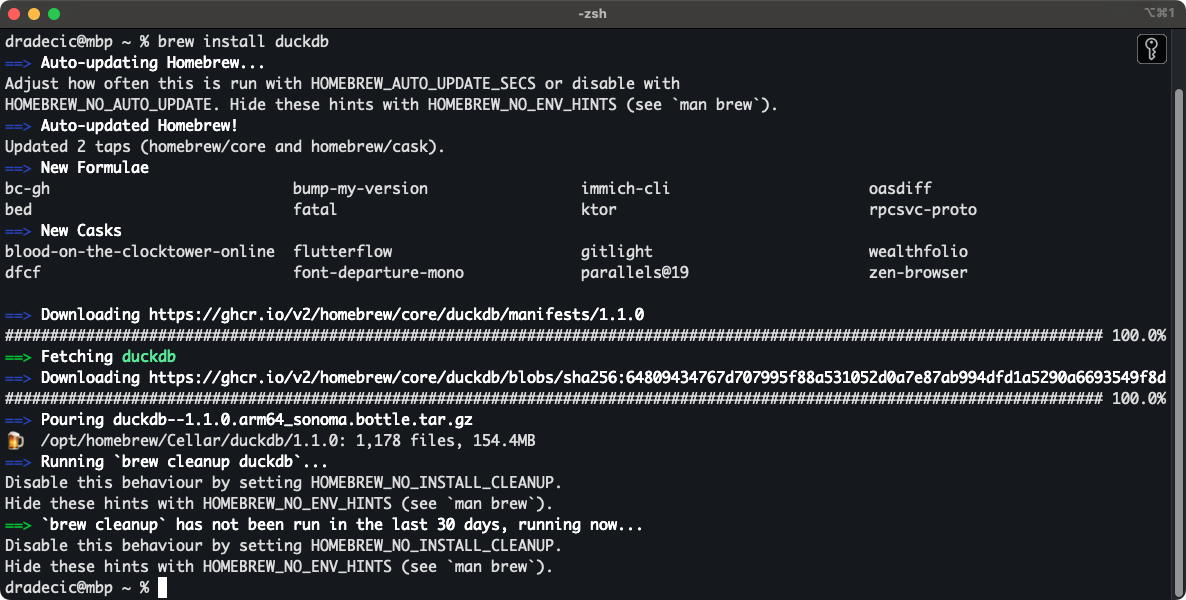
Installazione di DuckDB con Homebrew
Una volta installato, puoi entrare nella shell di DuckDB con il comando seguente:
duckdb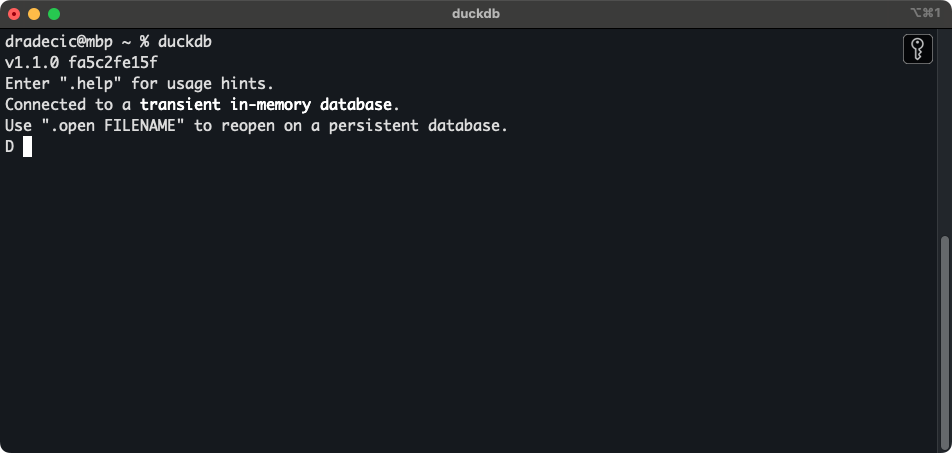
Shell DuckDB
Da qui, il mondo è tuo!
Puoi scrivere ed eseguire query SQL direttamente dalla console. Per esempio, ho scaricato i primi 6 mesi di NYC Taxi Data per il 2024. Se hai fatto lo stesso, usa il seguente snippet per mostrare il numero di righe di un singolo file Parquet:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");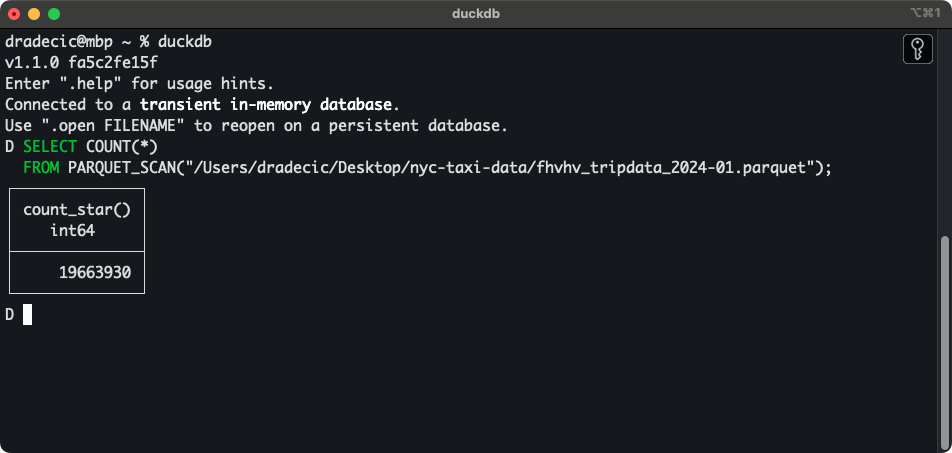
Conteggio righe di un singolo file Parquet
Già — sono quasi 20 milioni di righe da un singolo file. Ne ho scaricati 24.
Probabilmente non vuoi usare DuckDB dal terminale, quindi ora ti mostro come collegarlo a Python.
L’obiettivo di questa sezione è mostrarti come configurare ed eseguire DuckDB nel linguaggio più usato nel data engineering: Python.
Infatti, DataCamp offre un career track completo in data engineering in Python.
Python ha una libreria specifica per DuckDB che devi installare per prima. Esegui il seguente comando dal terminale, preferibilmente in un ambiente virtuale:
pip install duckdbOra crea un nuovo file Python e incolla il seguente codice:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
In breve, lo snippet contiene una funzione che recupera il numero di righe da un singolo file, dato una connessione valida a DuckDB e un percorso file.
Otterrai il seguente risultato quasi istantaneamente dopo l’esecuzione dello script:
Connessione DuckDB e Python
Tutto qui!
A breve ti mostro come fare cose incredibili con Python e DuckDB, a velocità fulminea!
Per riferimento, eseguirò il codice su una porzione 2024 (gennaio - giugno) del dataset NYC Taxi — specificamente per i veicoli a noleggio ad alto volume. Sono 6 file Parquet, per circa 3GB di spazio su disco. Come hardware, uso un MacBook Pro 16” M3 Pro con 12 core CPU e 36GB di memoria unificata.
I tuoi risultati possono variare, ma dovresti ottenere numeri simili.
Ho convertito questi 6 file in due formati aggiuntivi: CSV e JSON. Puoi vedere quanto spazio su disco occupa ciascuno:
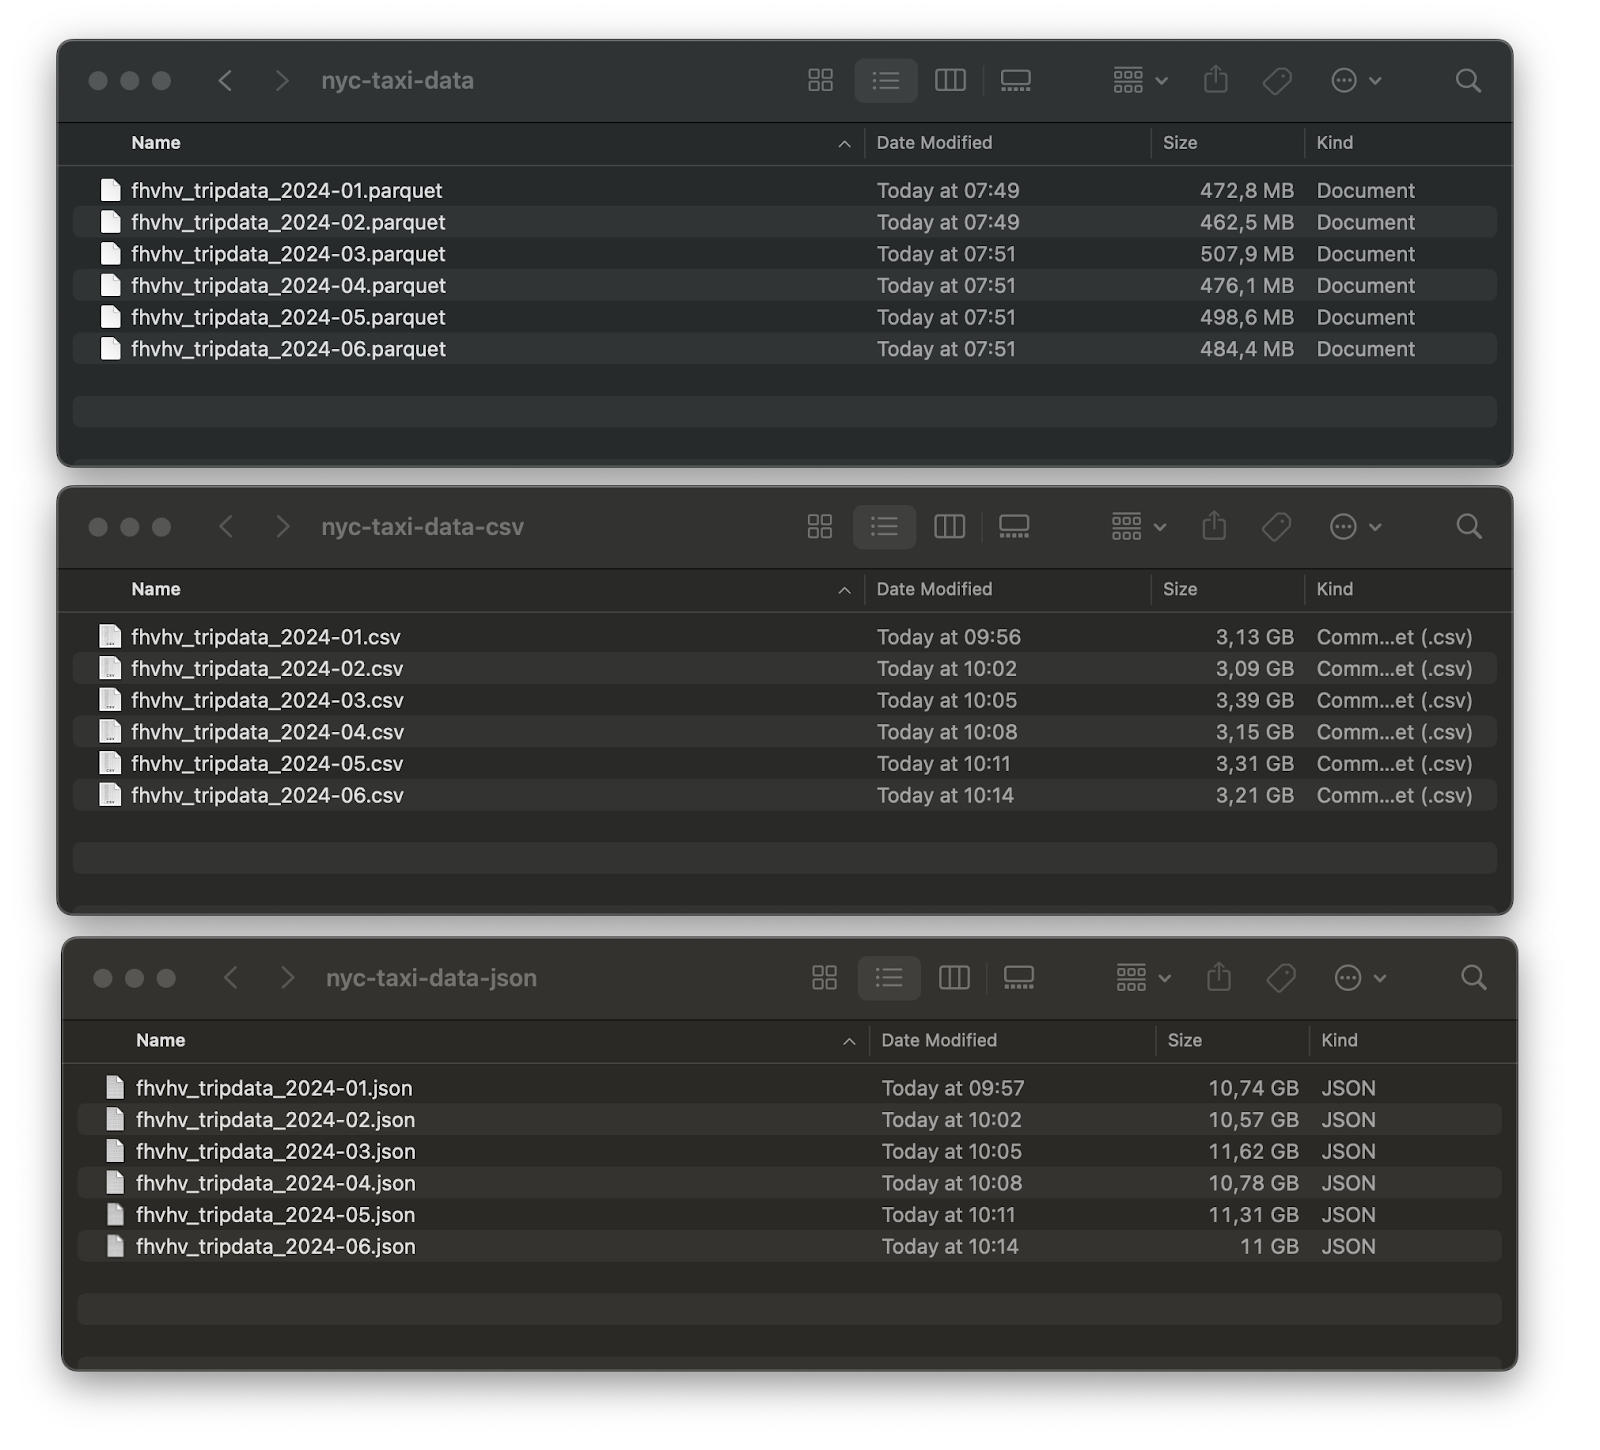
Confronto dimensione dataset
Totale: 2,96GB per Parquet, 19,31GB per CSV e 66,04GB per JSON.
Differenza enorme! Se non ricordi altro da questo articolo, ricorda almeno di usare sempre il formato Parquet quando lavori con file molto grandi. Ti farà risparmiare tempo di elaborazione e spazio su disco.
DuckDB ha funzioni comode per leggere più file dello stesso formato in una volta sola (usando un pattern glob). Le userò per leggere tutti e sei i file, ottenere il conteggio righe e confrontare i tempi di esecuzione:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
I risultati parlano chiaro: c’è un solo vincitore netto:
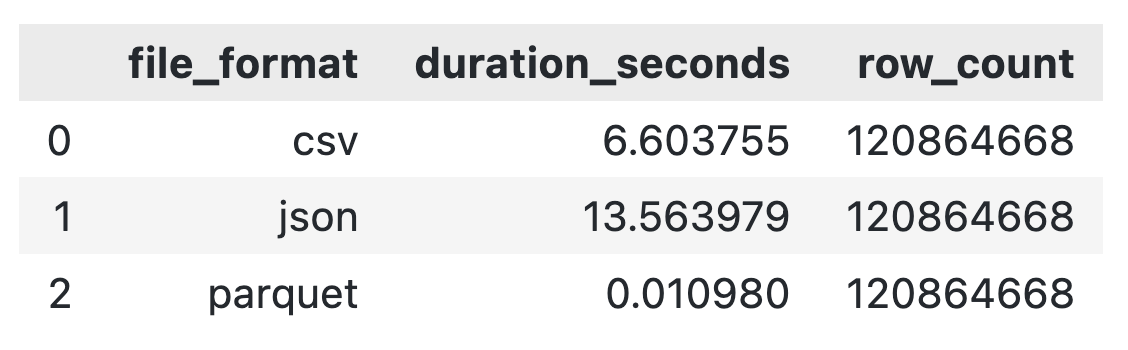
Confronto tempi di lettura file
Grazie a DuckDB, tutti e tre sono veloci e arrivano allo stesso risultato, ma è evidente che Parquet vince per un fattore 600 rispetto a CSV e per un fattore 1200 rispetto a JSON.
Per questo motivo, per il resto dell’articolo userò solo Parquet.
DuckDB ti permette di aggregare i dati tramite SQL.
L’obiettivo di questa sezione è approfondire l’idea. Più precisamente, ti mostrerò come calcolare statistiche riepilogative a livello mensile che includono numero di corse, tempo di corsa, distanza, costo e compenso del driver — tutto da 120 milioni di righe.
La parte migliore: ci vorranno solo due secondi!
Ecco il codice che ho usato in uno script Python per aggregare i dati e stamparne i risultati:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
L’output contiene i risultati dell’aggregazione, il tipo della variabile results e il tempo totale di esecuzione:
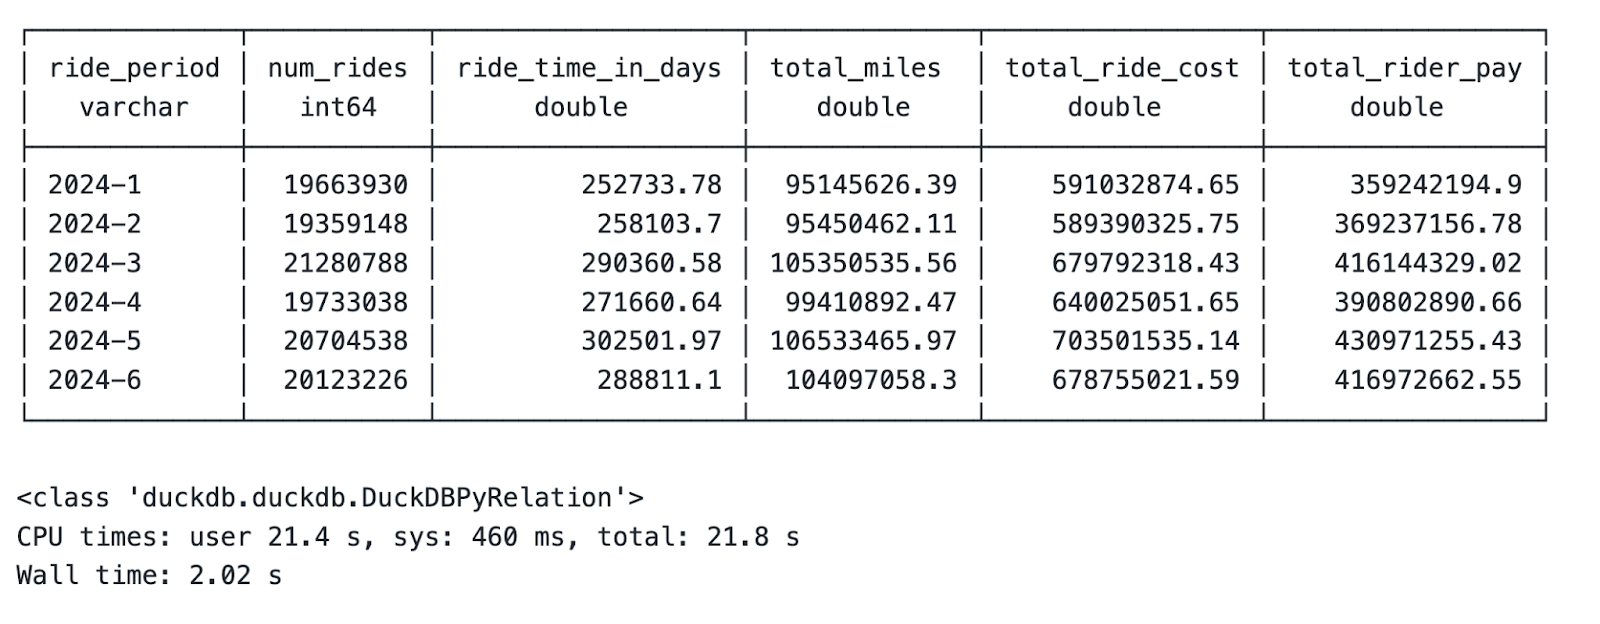
Aggregazione statistiche mensili
Pensaci: sono 3GB di dati per oltre 120 milioni di righe, tutto aggregato in 2 secondi su un laptop!
L’unico problema è che il tipo di variabile è poco utilizzabile nel lungo periodo. Per fortuna c’è una soluzione semplice.
Il vantaggio di usare DuckDB non è solo la velocità: si integra anche molto bene con la tua libreria di dataframe preferita, pandas.
Se hai un result set temporaneo come quello mostrato sopra, ti basta chiamare il metodo .df() per convertirlo in un DataFrame pandas:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df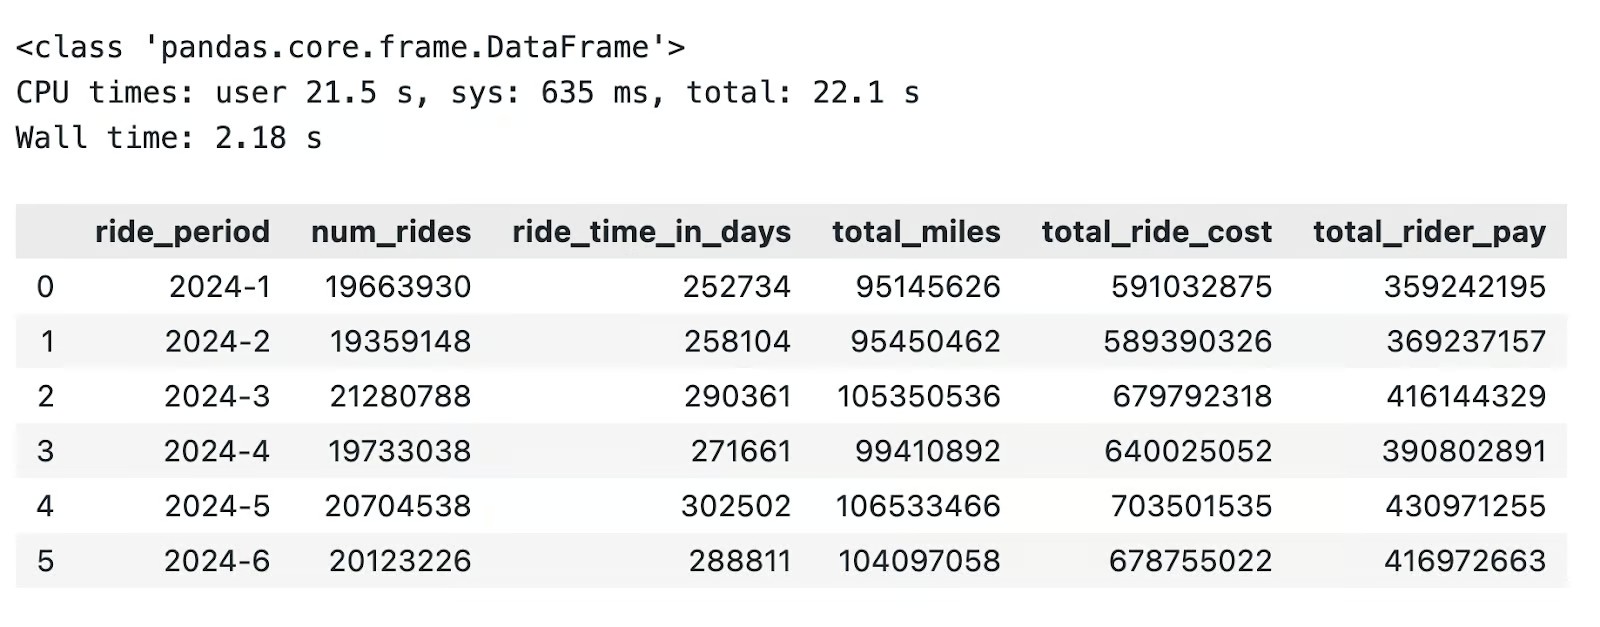
Conversione da DuckDB a pandas
Allo stesso modo, puoi usare DuckDB per eseguire calcoli su DataFrame pandas che sono già caricati in memoria.
Il trucco è referenziare il nome della variabile dopo la keyword FROM in una query SQL DuckDB. Ecco un esempio:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res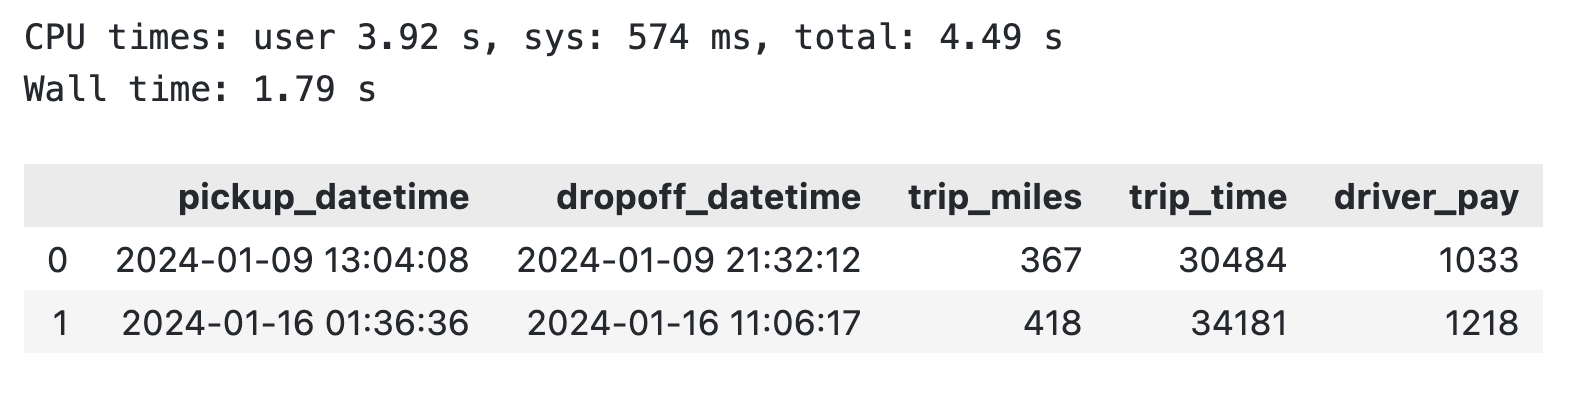
Query DuckDB su un DataFrame pandas esistente
In conclusione, puoi evitare del tutto pandas o eseguire aggregazioni più velocemente su DataFrame pandas esistenti.
A seguire, ti mostro un paio di funzionalità avanzate di DuckDB.
DuckDB offre molto più di quanto sembri a prima vista.
In questa sezione ti guiderò attraverso alcune funzionalità avanzate di DuckDB essenziali per i data engineer.
DuckDB ti consente di estenderne le funzionalità native tramite estensioni core e community extensions. Uso spesso le estensioni per connettermi a sistemi di storage e database nel cloud e per lavorare con formati di file aggiuntivi.
Puoi installare le estensioni sia dalla console Python che da quella di DuckDB.
Nel seguente snippet ti mostro come installare l’estensione httpfs necessaria per connettersi ad AWS e leggere dati da S3:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Non vedrai alcun output se non concateni il metodo .df() a conn.execute(). Se lo fai, vedrai un messaggio di “Success” o “Error”.
Spesso la tua azienda ti concederà l’accesso ai dati da includere nelle pipeline. Di solito sono archiviati su piattaforme cloud scalabili, come AWS S3.
DuckDB ti consente di connetterti direttamente a S3 (e ad altre piattaforme).
Ti ho già mostrato come installare l’estensione (httpfs); ora resta solo da configurarla. AWS richiede informazioni su regione, access key e secret access key.
Supponendo che tu abbia tutto, esegui il seguente comando tramite Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Il mio bucket S3 contiene due file del dataset New York Taxi:
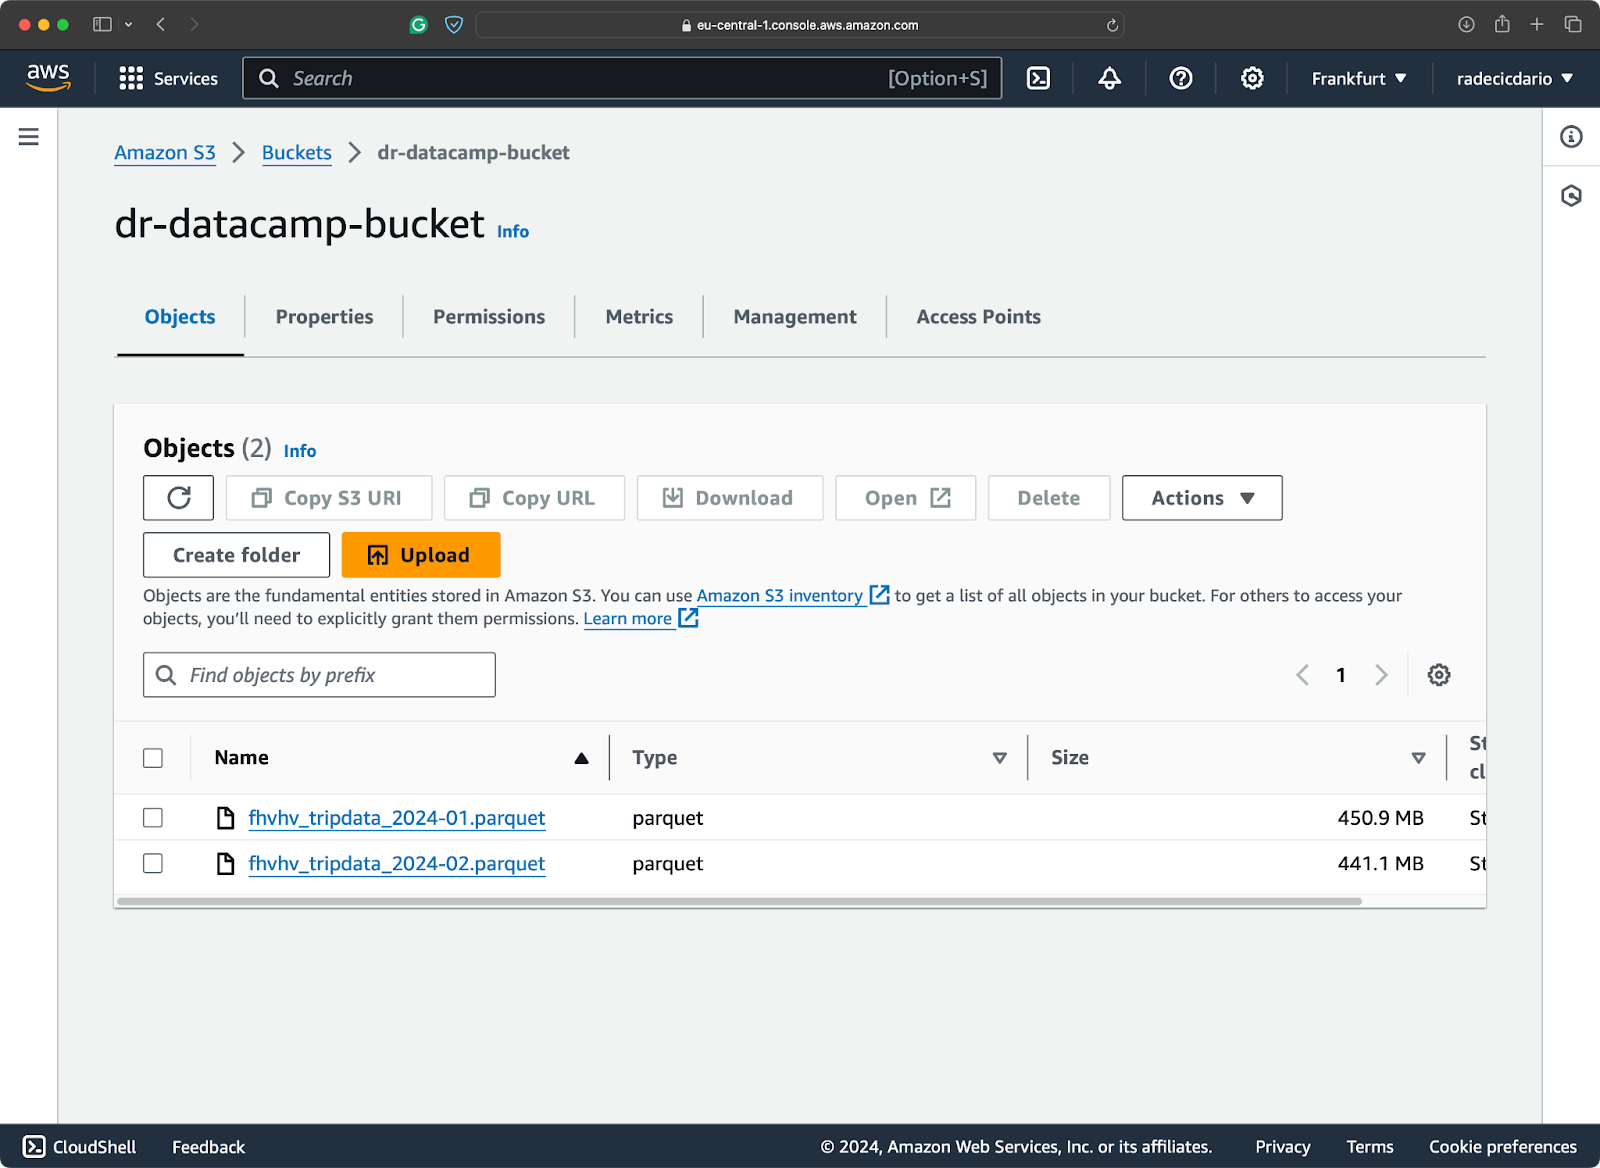
Contenuti del bucket S3
Non serve scaricare i file, perché puoi scansionarli direttamente da S3:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count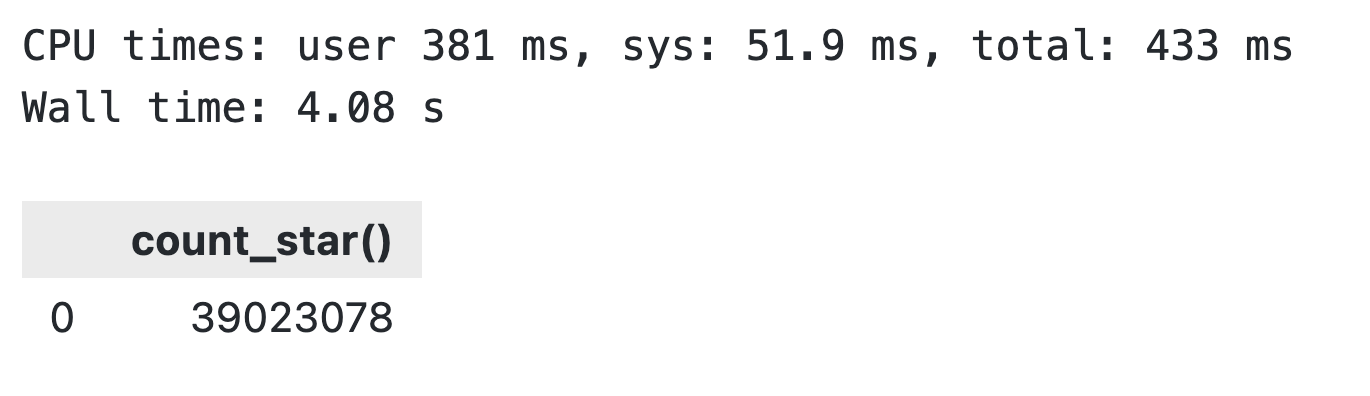
Risultati fetch S3 con DuckDB
Hai letto bene: ci sono voluti solo 4 secondi per passare in rassegna ~900MB di dati in un bucket S3.
Per quanto riguarda la parallelizzazione, DuckDB la implementa di default basandosi sui row group: partizioni orizzontali tipiche dei file Parquet. Un singolo row group può avere al massimo 122.880 righe.
Il parallelismo in DuckDB parte quando lavori con più di 122.880 righe.
DuckDB avvierà automaticamente nuovi thread quando ciò accade. Per impostazione predefinita, il numero di thread è uguale al numero di core CPU. Ma nulla ti impedisce di regolare manualmente i thread.
In questa sezione ti mostro come fare e l’impatto concreto di un numero diverso di thread sullo stesso carico di lavoro.
Per visualizzare il numero attuale di thread, esegui quanto segue:
SELECT current_setting('threads') AS threads;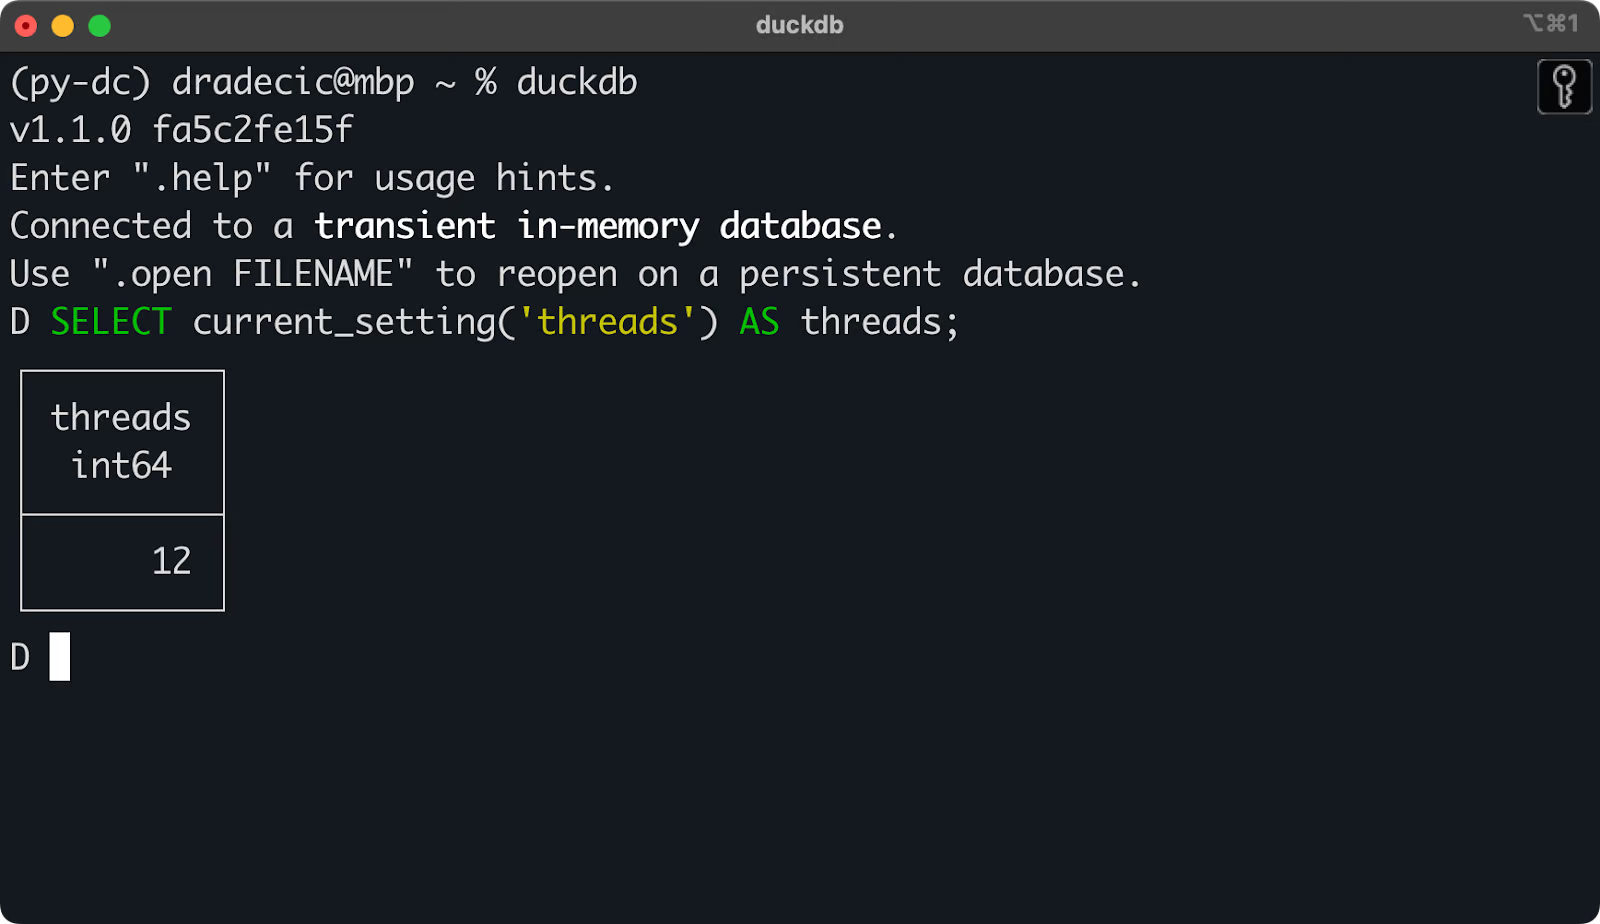
Numero corrente di thread usati da DuckDB
Puoi ottenere lo stesso risultato anche tramite Python.
Per cambiare il numero di thread, usa il comando SET threads = N.
Nel seguente snippet, ti mostro come implementare una funzione Python che esegue una query DuckDB con un certo numero di thread, la converte in un DataFrame pandas e ritorna il tempo di esecuzione (tra le altre cose). Il codice sotto la funzione la esegue con un intervallo di thread [1, 12]:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Dovresti vedere un output simile al mio:
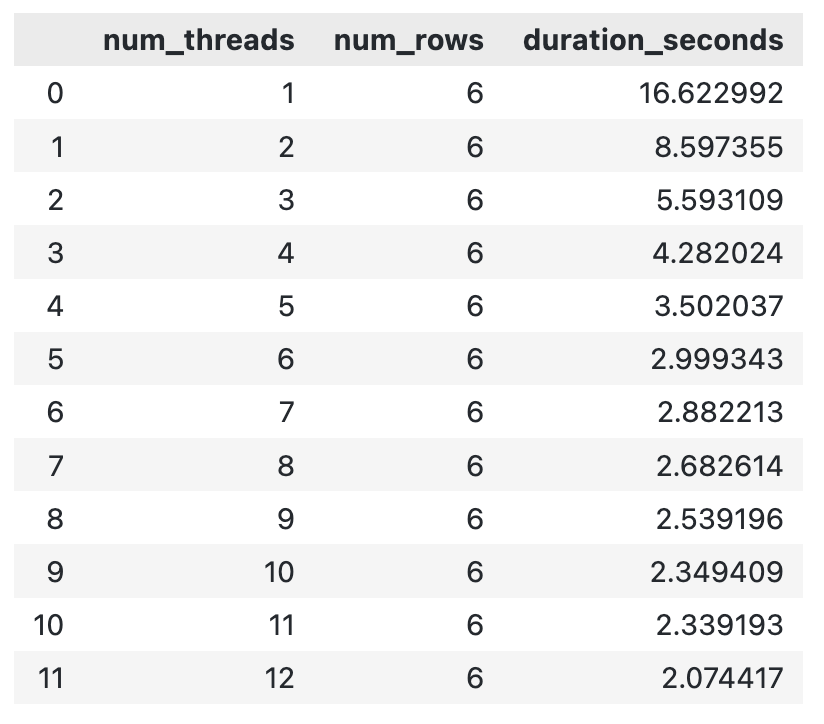
Tempi di DuckDB con numero di thread diversi
In generale, più thread assegni a un’elaborazione, più velocemente terminerà. Potrebbe esistere un punto in cui il overhead di creare un nuovo thread porta ad aumentare il tempo totale, ma non l’ho riscontrato in questo intervallo.
In questa sezione ti mostro come scrivere una pipeline dati da zero. Sarà relativamente semplice: lettura dei dati da disco, aggregazioni e scrittura dei risultati. Il mio obiettivo è mostrarti quante prestazioni puoi guadagnare passando da pandas a DuckDB. E non solo: il tuo codice risulterà anche più pulito.
Questa non è un’introduzione esaustiva ai processi ETL/ELT, ma una panoramica ad alto livello.
La pipeline che sto per mostrarti realizza quanto segue:
Dopo aver eseguito il codice, dovresti ottenere esattamente gli stessi risultati di aggregazione per entrambe le implementazioni della pipeline (a parte qualche differenza di arrotondamento):
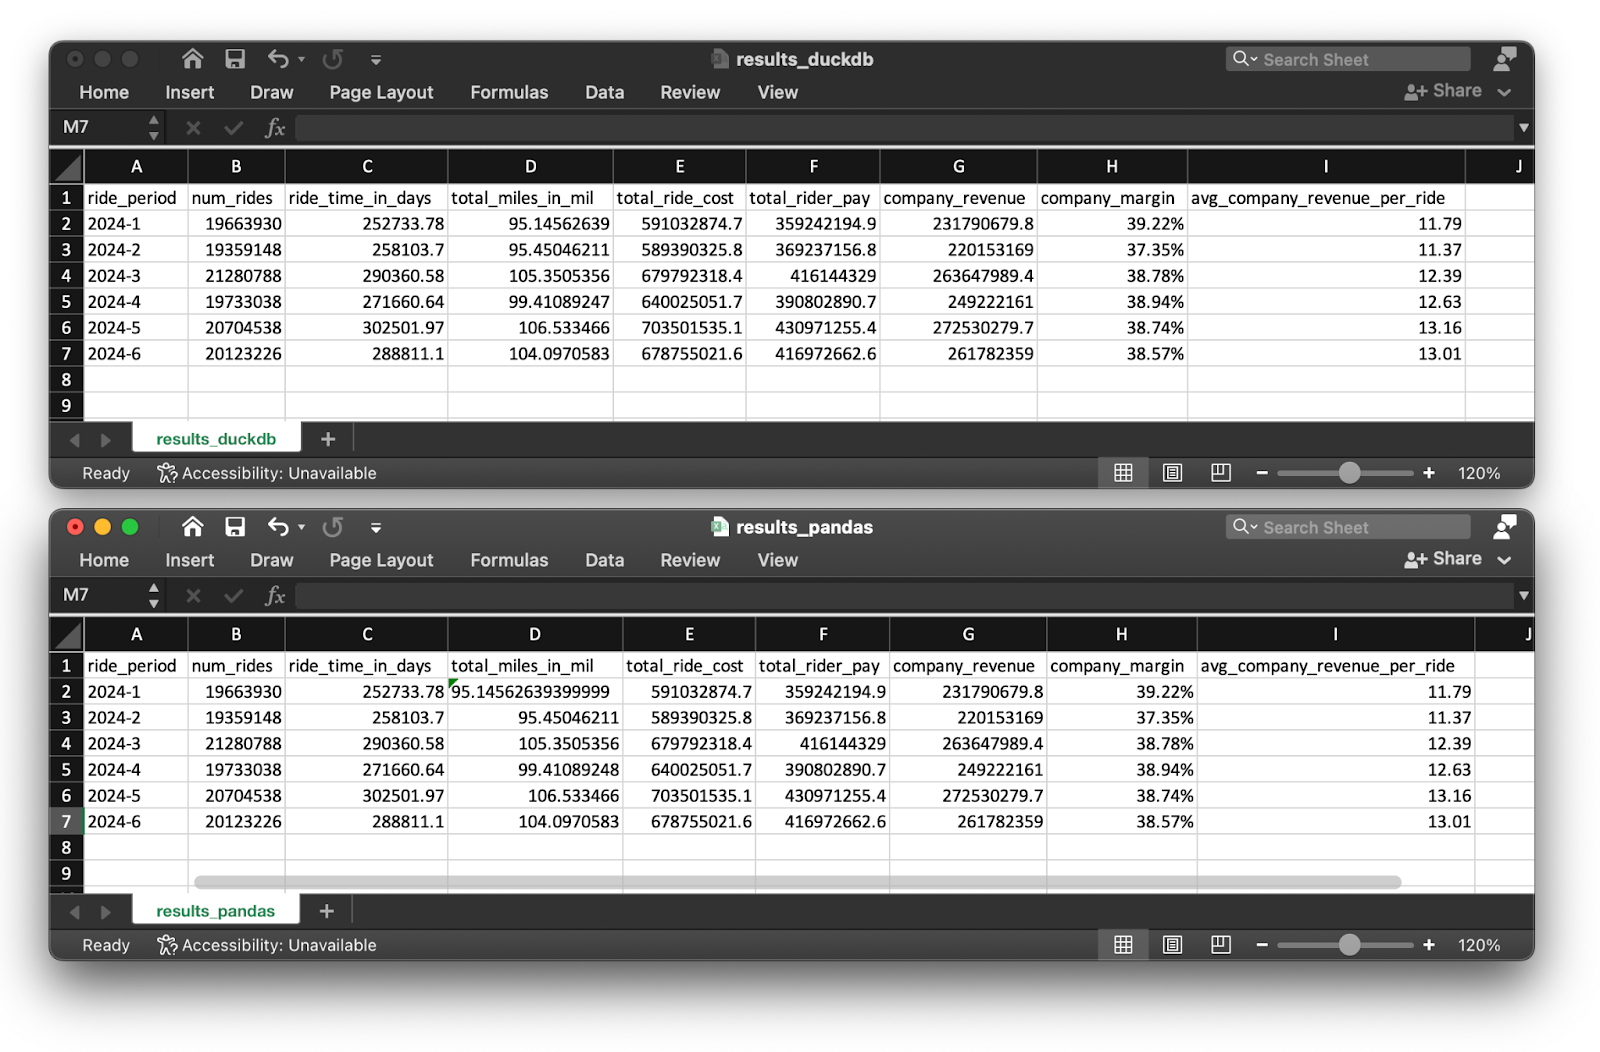
Risultati della pipeline per DuckDB e pandas
Per prima cosa, vediamo l’implementazione della pipeline in pandas.
Qualunque cosa abbia provato, non sono riuscito a processare tutti e 6 i file Parquet insieme. In pochi secondi comparivano avvisi di sistema come questo:
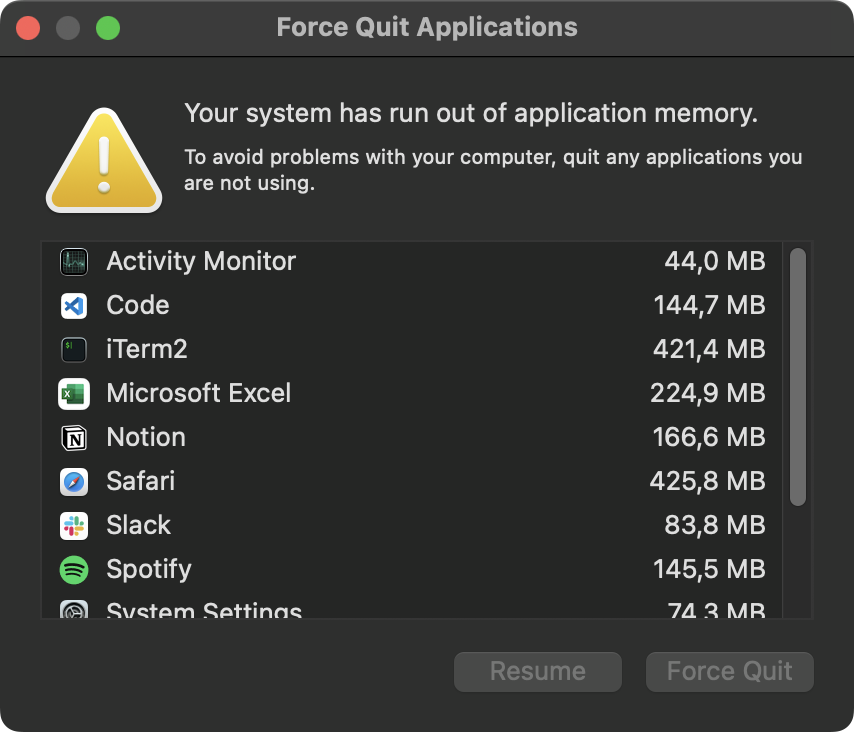
Errore di memoria di sistema
Sembra che 36GB di memoria non bastino per processare 120 milioni di righe in una volta sola. Di conseguenza, lo script Python è stato terminato:
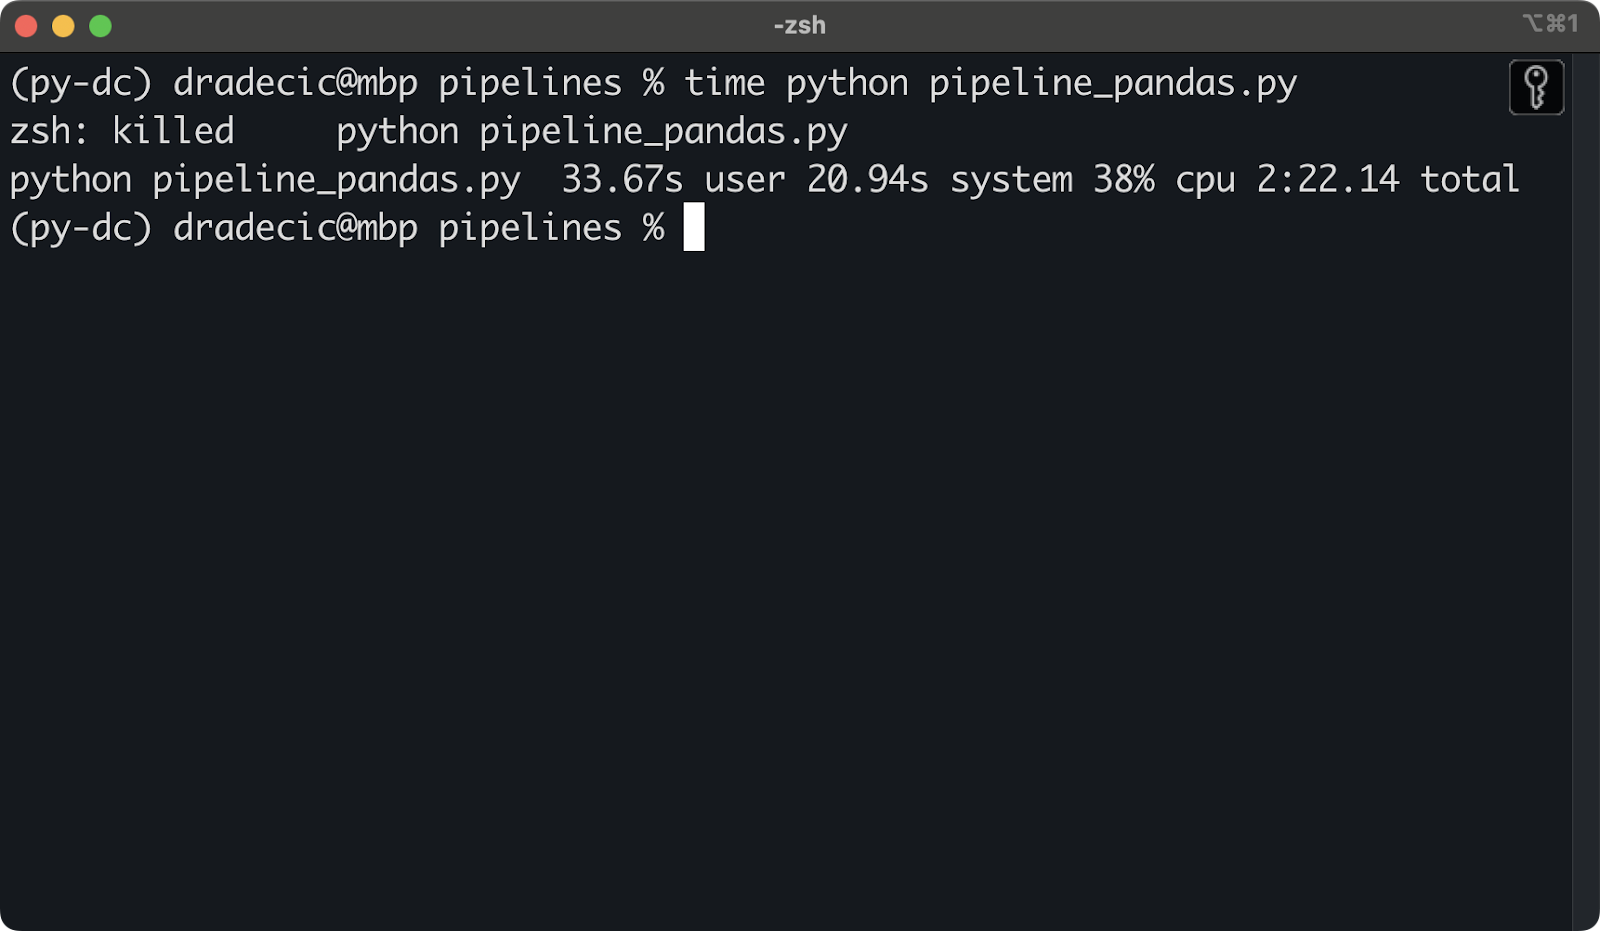
Script Python terminato per memoria insufficiente
Per rimediare, ho dovuto processare i file Parquet in sequenza. Ecco il codice che ho usato per la pipeline:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
L’implementazione della pipeline in DuckDB dovrebbe terminare senza problemi di memoria.
Gran parte del codice DuckDB ti è già familiare.
L’unica novità è il SELECT più esterno, che calcola alcune statistiche aggiuntive. Il resto è invariato:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
A seguire, i differenziali di tempo di esecuzione.
Dopo aver eseguito entrambe le pipeline 5 volte e fatto la media, questi sono i tempi di esecuzione che ho ottenuto:
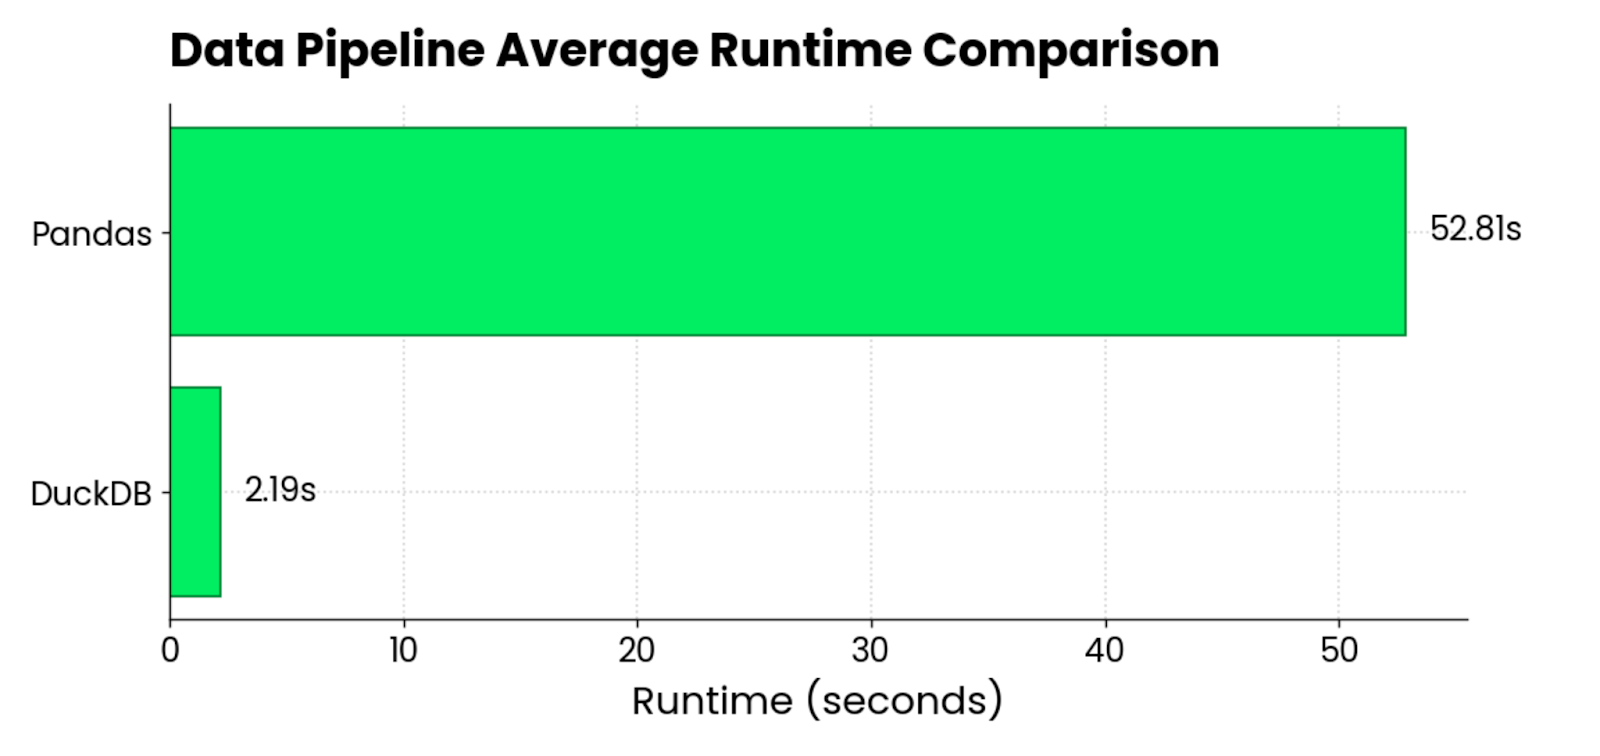
Grafico di confronto tempi: DuckDB vs. pandas
In media, pandas è risultato 24 volte più lento di DuckDB durante il caricamento e l’elaborazione di circa 120 milioni di righe (~3GB), distribuite su 6 file Parquet.
Il confronto non è del tutto equo, dato che non sono riuscito a processare tutti i file Parquet in una volta con pandas. Ciononostante, i risultati restano rilevanti, perché incontrerai le stesse difficoltà anche al lavoro.
Se una libreria non fa ciò di cui hai bisogno, provale un’altra. E quella che probabilmente finirà per prima, nella maggior parte dei casi, è DuckDB.
Prima di lasciarti esplorare DuckDB in autonomia, voglio condividere un paio di best practice generali e legate al data engineering:
SELECT. Evita di usarlo in workflow che si basano su INSERT e UPDATE frequenti. In quel caso, usa SQLite al posto.In conclusione, se sei un data engineer che si occupa di costruire e ottimizzare pipeline dati, penso che dovresti provare DuckDB.
Non hai nulla da perdere e tutto da guadagnare. Questo strumento è quasi garantito più veloce di qualsiasi cosa offra Python. È fulmineo sul tuo laptop e ti permette di gestire dataset che altrimenti genererebbero errori di memoria. Può persino connettersi a piattaforme di storage cloud quando non vuoi o non puoi archiviare dati in locale.
Detto ciò, DuckDB non dovrebbe essere l’unica ottimizzazione che porti sul tavolo. Dovresti sempre puntare a ottimizzare i dati in ingresso nel sistema. Per esempio, abbandonare i CSV a favore dei Parquet ti farà risparmiare tempo di calcolo e storage. Un’altra ottimizzazione da considerare è implementare i principi della moderna data architecture nei tuoi workflow e pipeline.
DuckDB è solo uno strumento. Ma uno molto potente.
Approfondisci il data engineering con questi corsi!
Corso
Programma
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



