

DuckDB के साथ शुरुआत कैसे करें
जैसा कि पहले कहा, DuckDB आपके लैपटॉप पर चलता है। पहला कदम इसे इंस्टॉल करना है।
मैं macOS के लिए इंस्टॉलेशन चरण दिखाऊँगा, लेकिन Windows और Linux के निर्देश भी अच्छी तरह समझाए गए हैं और आसानी से फ़ॉलो किए जा सकते हैं।
चरण 1: DuckDB इंस्टॉल करें
यदि आपके पास Mac है, तो DuckDB इंस्टॉल करने का सबसे आसान तरीका Homebrew है। निम्नलिखित शेल कमांड चलाएँ:
brew install duckdbकुछ ही सेकंड में आपको निम्नलिखित आउटपुट दिखेगा:
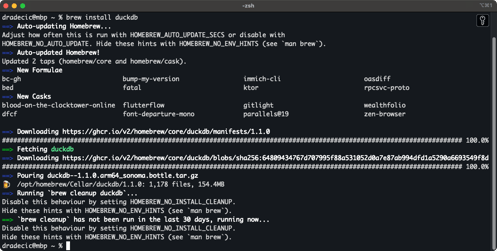
Homebrew के साथ DuckDB इंस्टॉल करना
इंस्टॉल होने के बाद, आप निम्नलिखित कमांड से DuckDB शेल में जा सकते हैं:
duckdb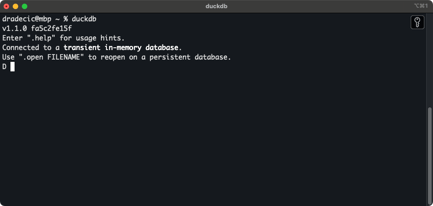
DuckDB शेल
अब दुनिया आपकी!
आप सीधे कंसोल से SQL क्वेरी लिख और चला सकते हैं। उदाहरण के लिए, मैंने 2024 के पहले 6 महीनों का NYC Taxi Data डाउनलोड किया है। यदि आपने भी किया है, तो किसी एक Parquet फ़ाइल की पंक्ति गणना दिखाने के लिए निम्न स्निपेट चलाएँ:
SELECT COUNT(*)
FROM PARQUET_SCAN("path-to-data.parquet");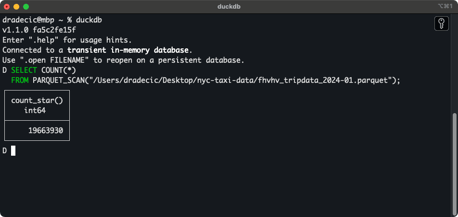
एकल Parquet फ़ाइल की पंक्ति गणना
हाँ—एक ही फ़ाइल से लगभग 2 करोड़ पंक्तियाँ। मैंने ऐसी 24 फ़ाइलें डाउनलोड की हैं।
आप शायद टर्मिनल से DuckDB नहीं चलाना चाहेंगे, इसलिए आगे मैं आपको DuckDB को Python से जोड़ने के चरण दिखाता हूँ।
चरण 2: DuckDB को अपने Python वर्कफ़्लो से जोड़ें
इस खंड का लक्ष्य आपको डेटा इंजीनियरिंग की सबसे लोकप्रिय भाषा—Python—में DuckDB को कॉन्फ़िगर और चलाना दिखाना है।
वास्तव में, DataCamp Python में डेटा इंजीनियरिंग पर एक संपूर्ण करियर ट्रैक प्रदान करता है।
Python के लिए DuckDB की एक विशेष लाइब्रेरी है जिसे पहले इंस्टॉल करना होगा। टर्मिनल से निम्न कमांड चलाएँ, बेहतर होगा कि वर्चुअल एन्वायरनमेंट में:
pip install duckdbअब एक नया Python फ़ाइल बनाएँ और निम्न कोड पेस्ट करें:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
query = f"""
SELECT COUNT(*)
FROM PARQUET_SCAN("{file_path}")
"""
return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
# In-memory database connection
conn = duckdb.connect()
# Path to a parquet file
file_path = "fhvhv_tripdata_2024-01.parquet"
# Get the row count
row_count = get_row_count_from_file(conn=conn, file_path=file_path)
print(row_count)संक्षेप में, इस कोड स्निपेट में एक फ़ंक्शन है जो वैध DuckDB कनेक्शन और फ़ाइल पथ मिलने पर किसी एक फ़ाइल से पंक्तियों की संख्या लौटाता है।
स्क्रिप्ट चलाने के बाद आपको लगभग तुरंत निम्न परिणाम मिल जाएगा:
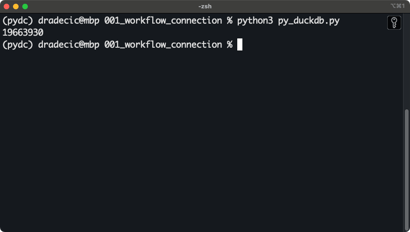
DuckDB और Python कनेक्शन
बस इतना ही!
अगले भाग में, मैं आपको दिखाऊँगा कि Python और DuckDB के साथ धमाकेदार गति से क्या-क्या कमाल कर सकते हैं!
DuckDB काम में: डेटा पाइपलाइनों की गति कैसे बढ़ाएँ
संदर्भ के लिए, मैं NYC Taxi Dataset के 2024 के हिस्से (जनवरी - जून) पर कोड चलाऊँगा—विशेष रूप से हाई-वॉल्यूम for-hire वाहनों पर। ये 6 Parquet फ़ाइलें हैं, जो लगभग 3GB डिस्क स्पेस लेती हैं। हार्डवेयर के लिए, मैं M3 Pro MacBook Pro 16” का उपयोग कर रहा हूँ, जिसमें 12 CPU कोर और 36GB यूनिफ़ाइड मेमोरी है।
आपके परिणाम अलग हो सकते हैं, लेकिन संख्याएँ मिलती-जुलती रहनी चाहिए।
विशाल डेटासेट्स को फटाफट पढ़ें
मैंने इन 6 फ़ाइलों को दो अतिरिक्त फ़ॉर्मैट—CSV और JSON—में बदला है। आप देख सकते हैं कि प्रत्येक कितना डिस्क स्पेस लेता है:
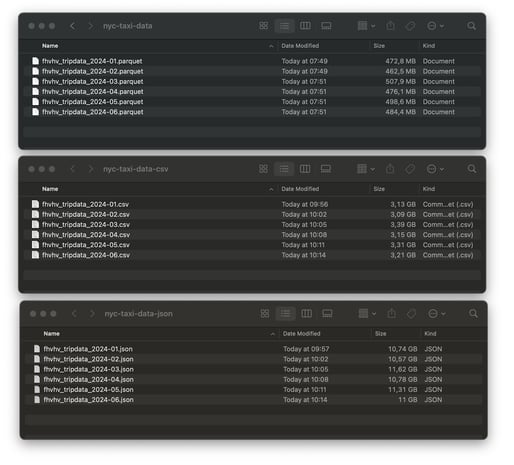
डेटासेट आकार तुलना
कुल: Parquet के लिए 2.96GB, CSV के लिए 19.31GB, और JSON के लिए 66.04GB।
बड़ा अंतर! अगर आज के लेख से कुछ और न लें, तो कम से कम यह याद रखें कि बड़े फ़ाइलों के लिए हमेशा Parquet फ़ॉर्मैट का उपयोग करें। यह आपको प्रोसेसिंग समय और डिस्क स्पेस दोनों बचाएगा।
DuckDB में आसानी से एक ही फ़ॉर्मैट की कई फ़ाइलें (glob पैटर्न से) एक साथ पढ़ने के फ़ंक्शंस हैं। मैं इन्हें सभी छह फ़ाइलों पर रो काउंट और रनटाइम तुलना के लिए उपयोग करूँगा:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
# Construct a DuckDB query based on the file_format
match file_format:
case "csv":
query = """
SELECT COUNT(*)
FROM READ_CSV("nyc-taxi-data-csv/*.csv")
"""
case "json":
query = """
SELECT COUNT(*)
FROM READ_JSON("nyc-taxi-data-json/*.json")
"""
case "parquet":
query = """
SELECT COUNT(*)
FROM READ_PARQUET("nyc-taxi-data/*.parquet")
"""
case _:
raise KeyError("Param file_format must be in [csv, json, parquet]")
# Open the database connection and measure the start time
time_start = datetime.now()
conn = duckdb.connect()
# Get the row count
row_count = conn.sql(query).fetchone()[0]
# Close the database connection and measure the finish time
conn.close()
time_end = datetime.now()
return {
"file_format": file_format,
"duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
"row_count": row_count
}
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)परिणाम आ गए—साफ़ तौर पर एक ही विजेता है:
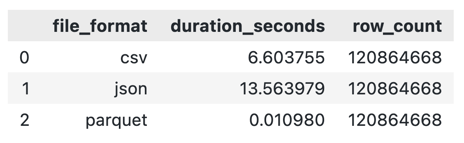
फ़ाइल पढ़ने के रनटाइम की तुलना
DuckDB की बदौलत तीनों तेज हैं और एक ही जगह पहुँचते हैं, लेकिन यह साफ़ है कि Parquet CSV के मुकाबले 600 गुना और JSON के मुकाबले 1200 गुना तेज है।
इसी वजह से, लेख के बाकी हिस्से में मैं केवल Parquet का उपयोग करूँगा।
SQL से डेटा क्वेरी करें
DuckDB आपको SQL के जरिए डेटा एग्रीगेट करने देता है।
इस खंड में मैं उसी विचार को आगे बढ़ाऊँगा। सटीक रूप से कहें तो, मैं आपको दिखाऊँगा कि 12 करोड़ पंक्तियों से मासिक स्तर पर सार-सांख्यिकी कैसे निकाली जाए—जिसमें राइड की संख्या, राइड समय, दूरी, लागत और ड्राइवर पे शामिल है।
सबसे अच्छी बात: इसमें केवल दो सेकंड लगेंगे!
यह वह कोड है जिसे मैंने Python स्क्रिप्ट में डेटा एग्रीगेट करने और परिणाम प्रिंट करने के लिए उपयोग किया:
conn = duckdb.connect()
query = """
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))आउटपुट में एग्रीगेशन के परिणाम, results के वेरिएबल टाइप, और कुल रनटाइम शामिल हैं:
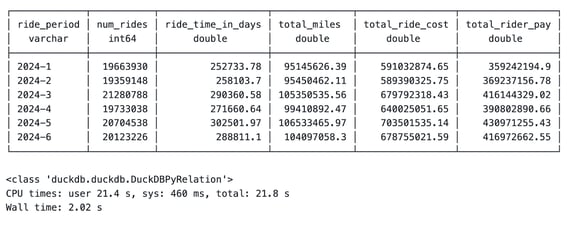
मासिक सार-सांख्यिकी एग्रीगेशन
सोचिए: 3GB डेटा और 12 करोड़ से अधिक पंक्तियाँ—सब कुछ लैपटॉप पर 2 सेकंड में एग्रीगेट!
एकमात्र समस्या यह है कि वेरिएबल टाइप लंबी अवधि में कुछ कम उपयोगी है। सौभाग्य से, इसका आसान समाधान है।
pandas और DataFrames के साथ इंटीग्रेशन
DuckDB का फायदा सिर्फ़ इसकी तेजी नहीं है, बल्कि यह आपकी पसंदीदा डेटा फ्रेम लाइब्रेरी pandas के साथ भी बढ़िया इंटीग्रेट होता है।
यदि आपके पास ऊपर दिखाए गए जैसा कोई अस्थायी रिज़ल्ट सेट है, तो उसे pandas DataFrame में बदलने के लिए बस उस पर .df() मेथड कॉल करें:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df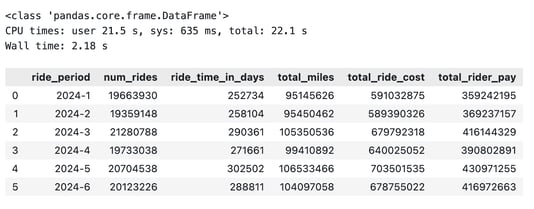
DuckDB से pandas में रूपांतरण
इसी तरह, आप पहले से मेमोरी में लोड pandas DataFrames पर DuckDB से कैलकुलेशन भी चला सकते हैं।
ट्रिक यह है कि DuckDB SQL क्वेरी में FROM के बाद वेरिएबल नाम रेफ़र करें। उदाहरण देखें:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
SELECT
pickup_datetime,
dropoff_datetime,
trip_miles,
trip_time,
driver_pay
FROM pandas_df
WHERE trip_miles >= 300
""").df()
duckdb_res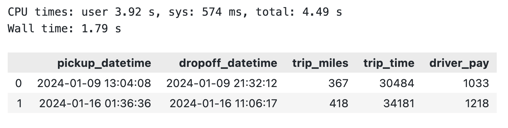
मौजूदा pandas DataFrame पर DuckDB क्वेरी
निष्कर्षतः, आप pandas को पूरी तरह बायपास कर सकते हैं या मौजूदा pandas DataFrames पर एग्रीगेशन तेज़ी से कर सकते हैं।
अब मैं आपको DuckDB की कुछ उन्नत विशेषताएँ दिखाऊँगा।
डेटा इंजीनियरों के लिए उन्नत DuckDB
DuckDB में दिखने से कहीं अधिक है।
इस खंड में, मैं आपको कुछ उन्नत DuckDB फीचर्स से परिचित कराऊँगा जो डेटा इंजीनियरों के लिए ज़रूरी हैं।
एक्सटेंशंस
DuckDB अपनी नैटिव क्षमताओं का विस्तार कोर और कोम्युनिटी एक्सटेंशंस के माध्यम से करने देता है। मैं अक्सर एक्सटेंशंस का उपयोग क्लाउड स्टोरेज सिस्टम्स और डेटाबेस से कनेक्ट होने तथा अतिरिक्त फ़ाइल फ़ॉर्मैट्स पर काम करने के लिए करता हूँ।
आप एक्सटेंशंस को Python और DuckDB—दोनों कंसोल्स से इंस्टॉल कर सकते हैं।
नीचे दिए कोड स्निपेट में, मैं दिखाता हूँ कि AWS से कनेक्ट होने और S3 डेटा पढ़ने के लिए आवश्यक httpfs एक्सटेंशन कैसे इंस्टॉल करें:
import duckdb
conn = duckdb.connect()
conn.execute("""
INSTALL httpfs;
LOAD httpfs;
""")यदि आप conn.execute() से .df() मेथड चेन नहीं करते, तो आउटपुट नहीं दिखेगा। यदि करते हैं, तो “Success” या “Error” संदेश दिखेगा।
क्लाउड स्टोरेज क्वेरी करना
अक्सर आपकी कंपनी आपको उस डेटा की पहुँच देती है जिसे आपको अपनी पाइपलाइनों में शामिल करना होता है। ये आमतौर पर AWS S3 जैसे स्केलेबल क्लाउड प्लेटफ़ॉर्म्स पर संग्रहीत होते हैं।
DuckDB आपको S3 (और अन्य प्लेटफ़ॉर्म्स) से सीधे कनेक्ट होने देता है।
मैंने पहले ही दिखाया कि एक्सटेंशन (httpfs) कैसे इंस्टॉल करें, अब बस इसे कॉन्फ़िगर करना है। AWS को क्षेत्र, एक्सेस की, और सीक्रेट एक्सेस की की जानकारी चाहिए।
मान लेते हैं कि आपके पास ये सब है, तो Python से निम्न कमांड चलाएँ:
conn.execute(""" CREATE SECRET aws_s3_secret (
TYPE S3,
KEY_ID '<your-access-key>',
SECRET '<your-secret-key>',
REGION '<your-region>'
);
""")मेरे S3 बकेट में New York Taxi डेटासेट की दो फ़ाइलें हैं:
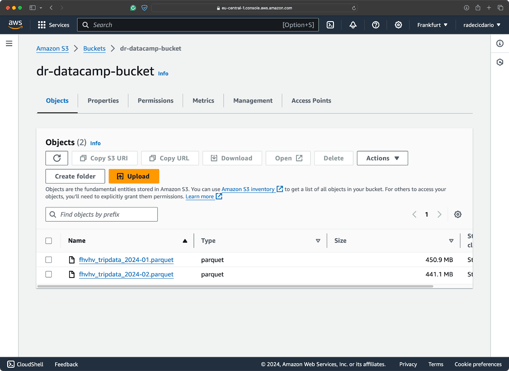
S3 बकेट की सामग्री
फ़ाइलें डाउनलोड करने की ज़रूरत नहीं, आप उन्हें सीधे S3 से स्कैन कर सकते हैं:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
SELECT COUNT(*)
FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count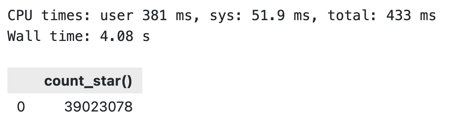
DuckDB S3 फ़ेच परिणाम
आपने सही पढ़ा: S3 बकेट में रखे ~ 900MB डेटा से गुजरने में सिर्फ़ 4 सेकंड लगे।
पैरेलल प्रोसेसिंग
पैरेललाइज़ेशन की बात आए तो, DuckDB इसे डिफ़ॉल्ट रूप से रो ग्रुप्स के आधार पर लागू करता है: क्षैतिज डेटा पार्टिशन जो आमतौर पर Parquet में मिलते हैं। एक रो ग्रुप में अधिकतम 122,880 पंक्तियाँ हो सकती हैं।
DuckDB में पैरेललिज़्म तब शुरू होता है जब आप 122,880 से अधिक पंक्तियों पर काम कर रहे होते हैं।
ऐसा होने पर DuckDB अपने-आप नए थ्रेड्स लॉन्च करेगा। डिफ़ॉल्ट रूप से थ्रेड्स की संख्या CPU कोर्स के बराबर होती है। लेकिन आप थ्रेड्स की संख्या के साथ मैन्युअली भी प्रयोग कर सकते हैं।
इस खंड में, मैं दिखाऊँगा कि इसे कैसे करें और समान वर्कलोड पर अलग-अलग थ्रेड्स की संख्या का क्या प्रभाव पड़ता है।
मौजूदा थ्रेड्स की संख्या देखने के लिए निम्न चलाएँ:
SELECT current_setting('threads') AS threads;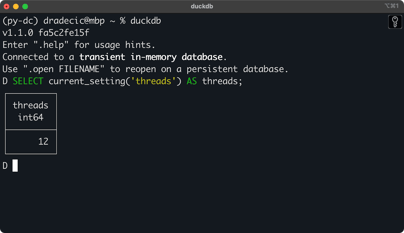
DuckDB द्वारा उपयोग किए जा रहे मौजूदा थ्रेड्स की संख्या
आप Python के जरिए भी यही परिणाम प्राप्त कर सकते हैं।
थ्रेड्स की संख्या बदलने के लिए आपको SET threads = N कमांड चलानी होगी।
अगले कोड स्निपेट में, मैं दिखाऊँगा कि कैसे एक कस्टम Python फ़ंक्शन लिखें जो दिए गए थ्रेड्स पर DuckDB क्वेरी चलाए, उसे pandas DataFrame में बदले और रनटाइम (अन्य चीज़ों के साथ) लौटाए। फ़ंक्शन के नीचे का कोड इसे [1, 12] थ्रेड्स की रेंज में चलाता है:
def thread_test(n_threads: int) -> dict:
# Open the database connection and measure the start time
time_start = datetime.now()
conn = duckdb.connect()
# Set the number of threads
conn.execute(f"SET threads = {n_threads};")
query = """
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
"""
# Convert to DataFrame
res = conn.sql(query).df()
# Close the database connection and measure the finish time
conn.close()
time_end = datetime.now()
return {
"num_threads": n_threads,
"num_rows": len(res),
"duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
}
thread_results = []
for n_threads in range(1, 13):
thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)आपको मेरा जैसा ही आउटपुट दिखना चाहिए:
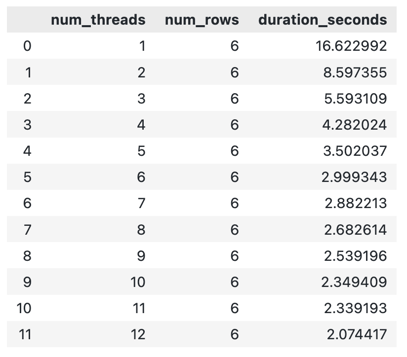
विभिन्न थ्रेड्स पर DuckDB रनटाइम
आम तौर पर, जितने अधिक थ्रेड्स किसी गणना पर लगाएँगे, उतनी जल्दी वह खत्म होगी। कभी-कभी ओवरहेड के कारण नए थ्रेड बनाने से कुल रनटाइम बढ़ भी सकता है, पर इस रेंज में मुझे ऐसा नहीं दिखा।
प्रदर्शन तुलना: DuckDB बनाम पारंपरिक तरीके
इस खंड में, मैं आपको शून्य से डेटा पाइपलाइन लिखना दिखाऊँगा। यह अपेक्षाकृत सरल होगी: डिस्क से डेटा पढ़ना, एग्रीगेशन करना, और परिणाम लिखना। मेरा लक्ष्य दिखाना है कि pandas से DuckDB पर स्विच करने से आप कितनी परफॉर्मेंस पा सकते हैं। इतना ही नहीं, आपका कोड भी अधिक स्वच्छ दिखेगा।
यह ETL/ELT प्रक्रियाओं का व्यापक परिचय नहीं, बल्कि उच्च-स्तरीय अवलोकन है।
डेटा पाइपलाइन के उद्देश्य
जो डेटा पाइपलाइन मैं दिखाने जा रहा हूँ, वह निम्नलिखित कार्य करती है:
- Extract: डिस्क से कई Parquet फ़ाइलें पढ़ती है (लगभग 12 करोड़ पंक्तियाँ)।
- Transform: मासिक सार-सांख्यिकी निकालती है, जैसे टैक्सी कंपनी का राजस्व, रेवेन्यू मार्जिन (राइड लागत और ड्राइवर पे का अंतर), और प्रति राइड औसत राजस्व। आप वे सामान्य सांख्यिकी भी देखेंगे जिन पर हमने पहले चर्चा की।
- Load: मासिक सांख्यिकी को स्थानीय रूप से CSV फ़ाइल में सहेजती है।
कोड चलाने के बाद, दोनों पाइपलाइन इम्प्लीमेंटेशंस के लिए आपको बिल्कुल समान एग्रीगेशन परिणाम मिलने चाहिए (कुछ राउंडिंग अंतर को छोड़कर):
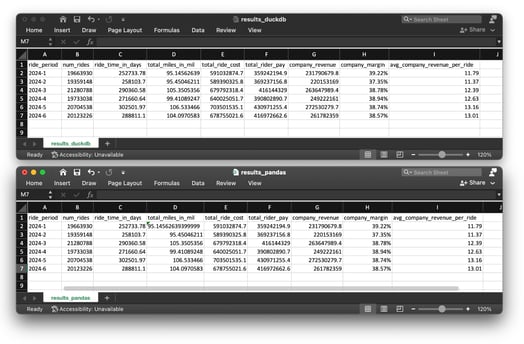
DuckDB और pandas के लिए पाइपलाइन परिणाम
सबसे पहले, pandas में पाइपलाइन इम्प्लीमेंटेशन देखते हैं।
कोड: Python और pandas
मैंने चाहे जो किया, सभी 6 Parquet फ़ाइलें एक साथ प्रोसेस नहीं हो पाईं। कुछ ही सेकंड में ऐसे सिस्टम चेतावनी संदेश दिखे:
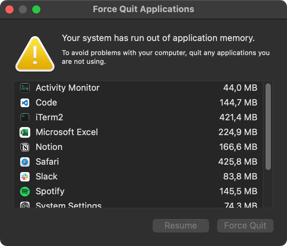
सिस्टम मेमोरी त्रुटि
लगता है 36GB मेमोरी एक साथ 12 करोड़ पंक्तियाँ प्रोसेस करने के लिए पर्याप्त नहीं है। नतीजतन, Python स्क्रिप्ट किल हो गई:
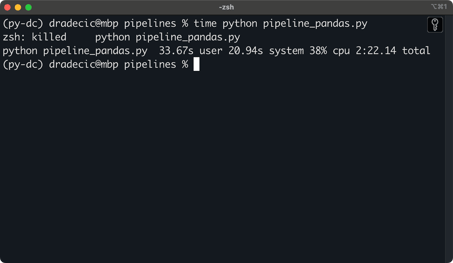
अपर्याप्त मेमोरी के कारण Python स्क्रिप्ट किल हुई
इसे टालने के लिए, मुझे Parquet फ़ाइलों को क्रमवार प्रोसेस करना पड़ा। डेटा पाइपलाइन के लिए मैंने यह कोड उपयोग किया:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
# Read a single Parquet file
df = pd.read_parquet(file_path)
# Extract ride year and month
df["ride_year"] = df["pickup_datetime"].dt.year
df["ride_month"] = df["pickup_datetime"].dt.month
# Remove data points that don"t fit in the time period
df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
# Combine ride year and month
df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
# Calculate total ride cost
df["total_ride_cost"] = (
df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
)
# Aggregations
summary = df.groupby("ride_period").agg(
num_rides=("pickup_datetime", "count"),
ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
total_miles=("trip_miles", "sum"),
total_ride_cost=("total_ride_cost", "sum"),
total_rider_pay=("driver_pay", "sum")
).reset_index()
# Additional attributes
summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
# Remove columns that aren't needed anymore
summary.drop(["total_miles"], axis=1, inplace=True)
return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
# Read data from multiple Parquet files
files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]
df = pd.DataFrame()
for file in files:
print(file)
file_stats = calculate_monthly_stats_per_file(file_path=file)
# Check if df is empty
if df.empty:
df = file_stats
else:
# Concat row-wise
df = pd.concat([df, file_stats], axis=0)
# Sort the dataset
df = df.sort_values(by="ride_period")
# Change column order
cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
"total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
return df[cols]
if __name__ == "__main__":
data_dir = "nyc-taxi-data"
output_dir = "pipeline_results"
output_file_name = "results_pandas.csv"
# Run the pipeline
monthly_stats = calculate_monthly_stats(file_dir=data_dir)
# Save to CSV
monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)DuckDB में पाइपलाइन इम्प्लीमेंटेशन उम्मीद है बिना किसी मेमोरी समस्या के पूरा होगा।
कोड: DuckDB
आप पहले ही DuckDB कोड का बड़ा हिस्सा देख चुके हैं।
नया सिर्फ़ ऊपर का SELECT है, जो कुछ अतिरिक्त सांख्यिकी निकालता है। बाकी सब वैसा ही छोड़ा है:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
query = f"""
SELECT
ride_period,
num_rides,
ride_time_in_days,
total_miles / 1000000 AS total_miles_in_mil,
total_ride_cost,
total_rider_pay,
ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
FROM (
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("{file_dir}/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
)
"""
conn = duckdb.connect()
df = conn.sql(query).df()
conn.close()
return df
if __name__ == "__main__":
data_dir = "nyc-taxi-data"
output_dir = "pipeline_results"
output_file_name = "results_duckdb.csv"
# Run the pipeline
monthly_stats = calculate_monthly_stats(file_dir=data_dir)
# Save to CSV
monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)अब मैं रनटाइम अंतर दिखाता हूँ।
प्रदर्शन तुलना के परिणाम
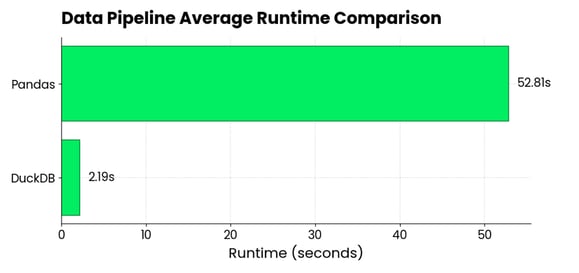
दोनों पाइपलाइनों को 5 बार चलाकर औसत लेने पर मुझे ये रनटाइम मिले:
DuckDB बनाम pandas रनटाइम तुलना चार्ट
औसतन, लगभग 12 करोड़ पंक्तियाँ (~3GB), 6 Parquet फ़ाइलों में फैली—लोड और प्रोसेस करने पर pandas DuckDB से 24 गुना धीमा था।
तुलना पूरी तरह निष्पक्ष नहीं, क्योंकि मैं pandas से सभी Parquet फ़ाइलें एक साथ प्रोसेस नहीं कर पाया। फिर भी, परिणाम प्रासंगिक हैं, क्योंकि नौकरी में आपको भी यही दिक्कतें मिलेंगी।
यदि एक लाइब्रेरी आपकी ज़रूरत नहीं पूरी करती, तो दूसरी आज़माएँ। और ज़्यादातर मामलों में सबसे तेज़ खत्म करने वाली DuckDB ही होगी।
डेटा पाइपलाइनों में DuckDB उपयोग के सर्वश्रेष्ठ अभ्यास
आपको DuckDB आगे स्वयं खोजने देने से पहले, मैं कुछ सामान्य और डेटा-इंजीनियरिंग-संबंधी सर्वोत्तम अभ्यास साझा करना चाहता हूँ:
- हमेशा पहले DuckDB के बिल्ट-इन फ़ंक्शंस आज़माएँ: आप अपनी Python फ़ंक्शंस को यूजर-डिफ़ाइंड फ़ंक्शंस के ज़रिए DuckDB में ला सकते हैं, जिससे DuckDB की लचीलापन नए आयाम पर चला जाता है। प्रोग्रामिंग का एक सामान्य सिद्धांत है—पहिया फिर से न बनाएँ। यानी, जो सुविधा पहले से मौजूद है, उसे शून्य से इम्प्लीमेंट न करें।
- पहले फ़ाइल फ़ॉर्मैट्स अनुकूलित करें: भले ही DuckDB बॉक्स से बाहर उल्लेखनीय परफॉर्मेंस देता है, इसका मतलब नहीं कि आप ऑप्टिमाइज़ेशन यहीं रोक दें। आपने देखा कि CSV पढ़ते समय DuckDB Parquet की तुलना में कितना धीमा (600 गुना तक) हो सकता है। Parquet हमेशा तेज़ पढ़ा जाएगा और कम डिस्क स्पेस लेगा। डबल फ़ायदा।
- DuckDB को ट्रांजैक्शनल प्रयोजन के लिए न उपयोग करें: DuckDB एक OLAP डेटाबेस है (ऑनलाइन एनालिटिकल प्रोसेसिंग), यानी यह
SELECTस्टेटमेंट्स के लिए अनुकूलित है। आपको इसे उन वर्कफ़्लोज़ में उपयोग करने से बचना चाहिए जो बार-बारINSERTऔरUPDATEपर निर्भर हैं। यदि ऐसा है, तो SQLite का उपयोग करें। - Jupyter Notebooks में DuckDB के नैटिव सपोर्ट का लाभ लें: Jupyter Lab/Notebook उपयोगकर्ता DuckDB क्वेरीज़ सीधे चला सकते हैं, बिना विशेष Python फ़ंक्शंस का उपयोग किए। यह डेटा को तेज़ी से एक्सप्लोर करने और नोटबुक्स को साफ़ रखने का बढ़िया तरीका है।
- हमेशा याद रखें कि DuckDB concurrency को कैसे संभालता है: आप DuckDB को ऐसे कॉन्फ़िगर कर सकते हैं कि एक प्रक्रिया डेटाबेस में पढ़ और लिख सके, या ऐसे कि कई प्रक्रियाएँ उससे पढ़ सकें, पर लिख न सकें। पहला विकल्प RAM में डेटा कैश करने देता है जिससे विश्लेषणात्मक क्वेरी तेज़ होती हैं। सिद्धांततः कई प्रक्रियाएँ एक ही डेटाबेस फ़ाइल में लिख सकती हैं, लेकिन ऐसा करने के लिए आपको क्रॉस-प्रोसेस म्यूटेक्स लॉक्स और डेटाबेस को खोलने/बंद करने की लॉजिक खुद लागू करनी होगी।
- आप क्लाउड में भी DuckDB का उपयोग कर सकते हैं: MotherDuck प्रोजेक्ट एक सहयोगात्मक डेटा वेयरहाउस है जो DuckDB की शक्ति को क्लाउड में लाता और बढ़ाता है। डेटा इंजीनियरों के लिए यह खोजने लायक रास्ता हो सकता है।
समापन
अंत में, यदि आप डेटा पाइपलाइनों के निर्माण और अनुकूलन के ज़िम्मेदार डेटा इंजीनियर हैं, तो मेरा मानना है कि आपको DuckDB ज़रूर आज़माना चाहिए।
आपको खोना कुछ नहीं, पाना सब कुछ है। यह चीज़ लगभग गारंटी से तेज़ है जितना कुछ भी Python ऑफ़र करता है। यह आपके लैपटॉप पर बिजली-सी गति से चलता है और आपको उन डेटासेट्स से गुजरने देता है जो अन्यथा मेमोरी त्रुटियाँ देते। यह तब भी क्लाउड स्टोरेज प्लेटफ़ॉर्म्स से कनेक्ट हो सकता है जब आप डेटा लोकल में नहीं रखना चाहते या रखने की अनुमति नहीं।
यह कहते हुए भी, DuckDB आपका एकमात्र ऑप्टिमाइज़ेशन नहीं होना चाहिए। हमेशा उस डेटा को भी अनुकूलित करें जो आपकी प्रणाली में आ रहा है। उदाहरण के लिए, CSV छोड़कर Parquet अपनाने से कम्प्यूट समय और स्टोरेज—दोनों बचते हैं। एक अन्य ऑप्टिमाइज़ेशन है—आधुनिक डेटा आर्किटेक्चर के सिद्धांत अपने वर्कफ्लो और पाइपलाइनों में लागू करें।
DuckDB सिर्फ़ एक टूल है। लेकिन बेहद शक्तिशाली।
FAQs
क्या DuckDB का उपयोग मुफ्त है?
हाँ, DuckDB एक ओपन-सोर्स प्रोजेक्ट है। आप इसे डाउनलोड कर सकते हैं, संशोधित कर सकते हैं, और GitHub के माध्यम से योगदान भी कर सकते हैं।
DuckDB SQLite से कैसे अलग है?
DuckDB जटिल SQL क्वेरीज़ (यानी SELECT स्टेटमेंट्स) के जरिए विश्लेषणात्मक वर्कलोड्स के लिए अनुकूलित है, जबकि SQLite ट्रांजैक्शनल प्रोसेसिंग (यानी INSERT और UPDATE स्टेटमेंट्स) के लिए बेहतर है।
क्या DuckDB एक NoSQL डेटाबेस है?
नहीं, DuckDB एक इन-प्रोसेस SQL OLAP (ऑनलाइन एनालिटिकल प्रोसेसिंग) डेटाबेस मैनेजमेंट सिस्टम है।
क्या DuckDB pandas से तेज़ है?
लगभग हर परिस्थिति में, DuckDB pandas से तेज़ होगा—अक्सर कम से कम एक ऑर्डर-ऑफ़-मैग्निट्यूड तक। यह आपको उन डेटासेट्स पर भी काम करने देगा जो pandas में मेमोरी त्रुटियाँ उठाते।
क्या DuckDB कोई विशेष SQL डायलेक्ट उपयोग करता है?
नहीं, यदि आपको बुनियादी SQL ज्ञान है तो आप बिल्कुल घर जैसा महसूस करेंगे। DuckDB काफ़ी हद तक PostgreSQL डायलेक्ट की परंपराओं का पालन करता है, पर यदि आप किसी अन्य डेटाबेस वेंडर के आदी हैं, तब भी सीखने की कर्व लगभग नहीं है।

कितनी बार किसी मैनेजर ने आपसे पूछा है कि आपकी पाइपलाइन चलने में कितना समय लेती है, और आपको जवाब देने में झिझक हुई है?
आप अकेले नहीं हैं। Python की सुविधा की कहीं न कहीं कीमत चुकानी पड़ती है। आमतौर पर वह कीमत रनटाइम गति होती है। पाइपलाइनें लिखना आसान होता है लेकिन स्केल करना मुश्किल—और प्रोजेक्ट आवश्यकताओं के बढ़ने के साथ वे अधिक समय लेने लगती हैं।
लेकिन हो सकता है bottleneck आपका कोड न हो। हो सकता है pandas से आप और प्रदर्शन नहीं निचोड़ सकें। संभव है कि किसी अलग डेटा प्रोसेसिंग इंजन पर स्विच करने से रनटाइम घंटों से मिनटों में आ जाए।
यहीं DuckDB काम आता है।
इस लेख में, मैं आपको बताऊँगा कि DuckDB वास्तव में क्या है और यह डेटा इंजीनियरों के लिए क्यों मायने रखता है। आप व्यावहारिक उदाहरणों के साथ DuckDB का उपयोग करना सीखेंगे और देखेंगे कि यह Python की सबसे लोकप्रिय डेटा प्रोसेसिंग लाइब्रेरीज़ से कितना तेज है।
DuckDB क्या है, और क्या यह डेटा इंजीनियरों के लिए अगली बड़ी चीज़ है?
DuckDB एक ओपन-सोर्स, एंबेडेड, इन-प्रोसेस, रिलेशनल OLAP DBMS है।
सरल भाषा में कहें तो इसे मेमोरी में चलने वाले एक विश्लेषणात्मक कॉलमनर डेटाबेस के रूप में सोचें। एक विश्लेषणात्मक डेटाबेस होने के नाते, यह
SELECTस्टेटमेंट्स के लिए अनुकूलित है, न किINSERTऔरUPDATEके लिए। यह SQLite जैसा है, पर उल्टा।DuckDB लगभग 5 साल से मौजूद है, लेकिन पहला “स्थिर” रिलीज़ जून 2024 में—इस लेखन के समय से 3 महीने पहले—घोषित किया गया। लेकिन नएपन से धोखा न खाएँ—DuckDB को बहुतों ने आजमाया-परखा है और जहाँ भी गति अहम होती है, वहाँ इसे लगभग हमेशा सिफारिश किया जाता है।
अपनी डेटा पाइपलाइनों के लिए DuckDB क्यों चुनें
यदि आप एक डेटा इंजीनियर हैं, तो DuckDB का उपयोग करने के कुछ ठोस फायदे ये हैं:
polars) से भी तेज है।इन्हीं कारणों से (और आगे आप और भी देखेंगे), मुझे लगता है कि DuckDB डेटा इंजीनियरों के लिए अगली बड़ी छलाँग है।