Kurs
Veri Mühendisliğini Anlamak
2 sa
378K
Daha önce söylediğim gibi, DuckDB dizüstü bilgisayarınızda çalışır. İlk iş onu oraya kurmaktır.
Kurulum adımlarını macOS için göstereceğim, ancak Windows ve Linux için olan talimatlar da iyi açıklanmış ve kolay takip edilir.
Bir Mac’iniz varsa, DuckDB’yi kurmanın en kolay yolu Homebrew kullanmaktır. Aşağıdaki kabuk komutunu çalıştırın:
brew install duckdbBirkaç saniye içinde aşağıdaki çıktıyı göreceksiniz:
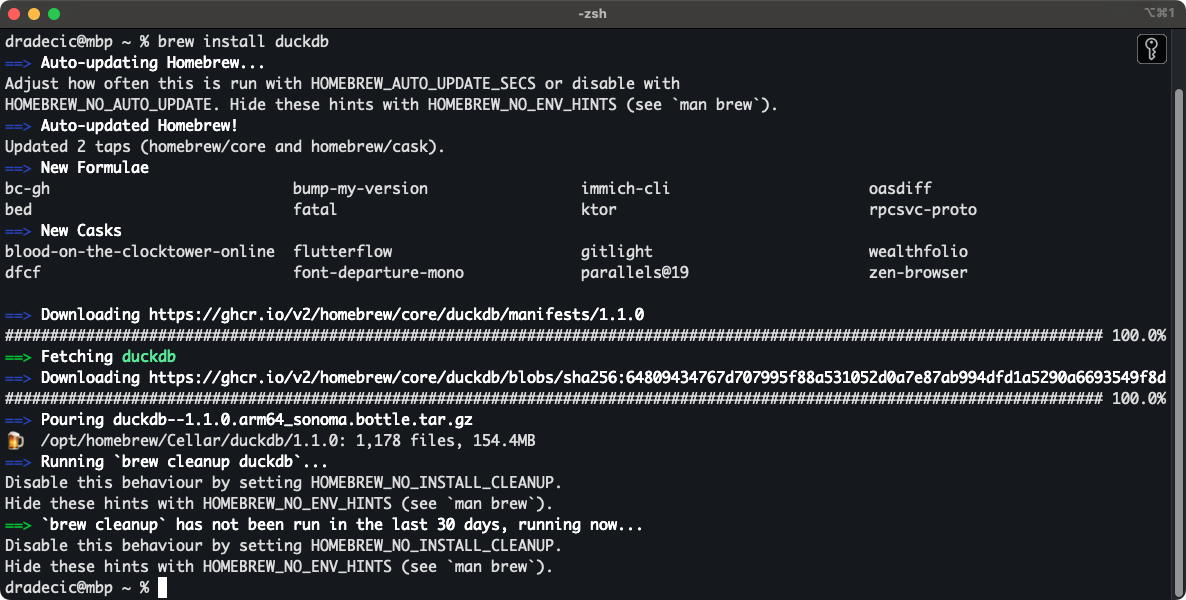
Homebrew ile DuckDB kurulumu
Kurulduktan sonra, aşağıdaki komutla DuckDB kabuğuna girebilirsiniz:
duckdb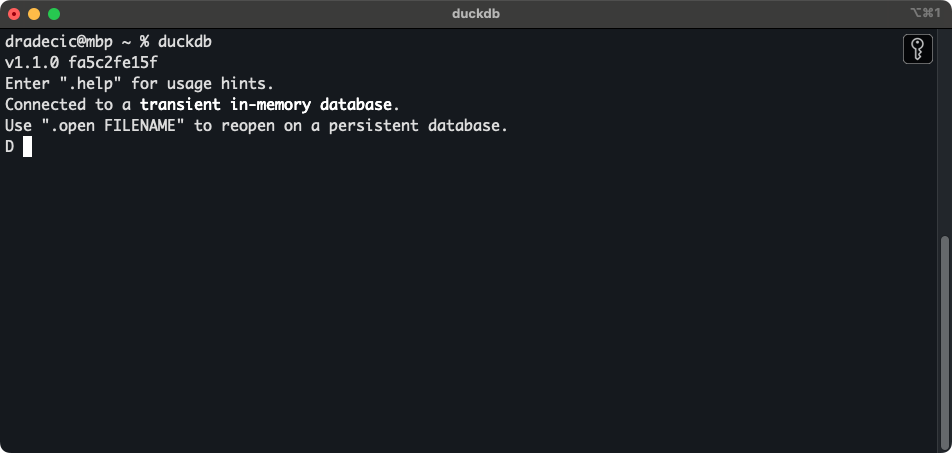
DuckDB kabuğu
Buradan sonrası artık sizin maharetinize kalmış!
SQL sorgularını doğrudan konsoldan yazıp çalıştırabilirsiniz. Örneğin, 2024’ün ilk 6 ayına ait NYC Taxi Data’yı indirdim. Siz de aynı şeyi yaptıysanız, tek bir Parquet dosyasının satır sayısını göstermek için aşağıdaki parçacığı kullanın:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");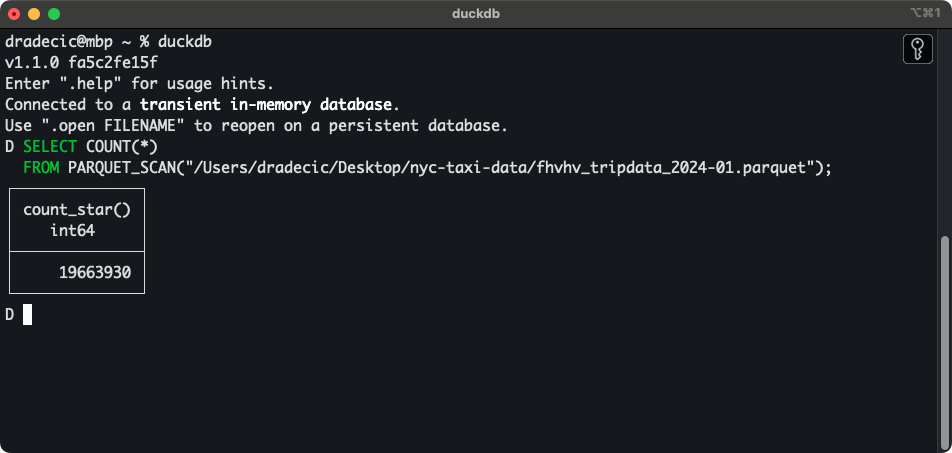
Tek Parquet dosyası satır sayıları
Evet - tek bir dosyadan neredeyse 20 milyon satır. Ben bunlardan 24 tane indirdim.
Muhtemelen DuckDB’yi terminalden çalıştırmak istemezsiniz; bu yüzden sırada DuckDB’yi Python ile bağlama adımlarını göstereceğim.
Bu bölümün amacı, DuckDB’yi veri mühendisliğinin en popüler dili olan Python’da nasıl yapılandırıp çalıştıracağınızı göstermek.
Hatta DataCamp, Python ile veri mühendisliği üzerine eksiksiz bir kariyer yolu sunuyor.
Python’ın önce kurmanız gereken özel bir DuckDB kütüphanesi vardır. Tercihen sanal bir ortamda, terminalden aşağıdakini çalıştırın:
pip install duckdbŞimdi yeni bir Python dosyası oluşturup aşağıdaki kodu yapıştırın:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Kısaca, bu kod parçasında geçerli bir DuckDB bağlantısı ve dosya yolu verildiğinde tek bir dosyadaki satır sayısını getiren bir fonksiyon bulunur.
Betik çalıştırıldıktan sonra çıktıyı neredeyse anında alacaksınız:
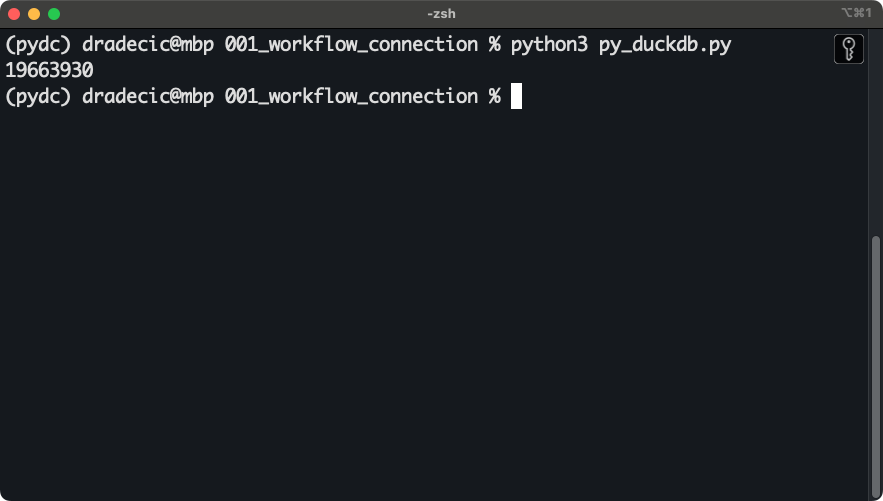
DuckDB ve Python bağlantısı
Hepsi bu!
Sırada, Python ve DuckDB ile nasıl inanılmaz şeyleri ışık hızında yapabileceğinizi göstereceğim!
Referans olması için, kodu NYC Taxi Dataset ’in 2024 (Ocak - Haziran) bölümünde, yüksek hacimli kiralık araçlar için çalıştıracağım. Bu 6 Parquet dosyası ve yaklaşık 3GB disk alanı kaplıyor. Donanım olarak 12 CPU çekirdekli ve 36GB birleşik belleğe sahip 16" M3 Pro MacBook Pro kullanıyorum.
Sizin sonuçlarınız değişebilir, ama yine de benzer sayılara ulaşmalısınız.
Bu 6 dosyayı iki ek formata - CSV ve JSON - dönüştürdüm. Her birinin ne kadar disk alanı kapladığını görebilirsiniz:
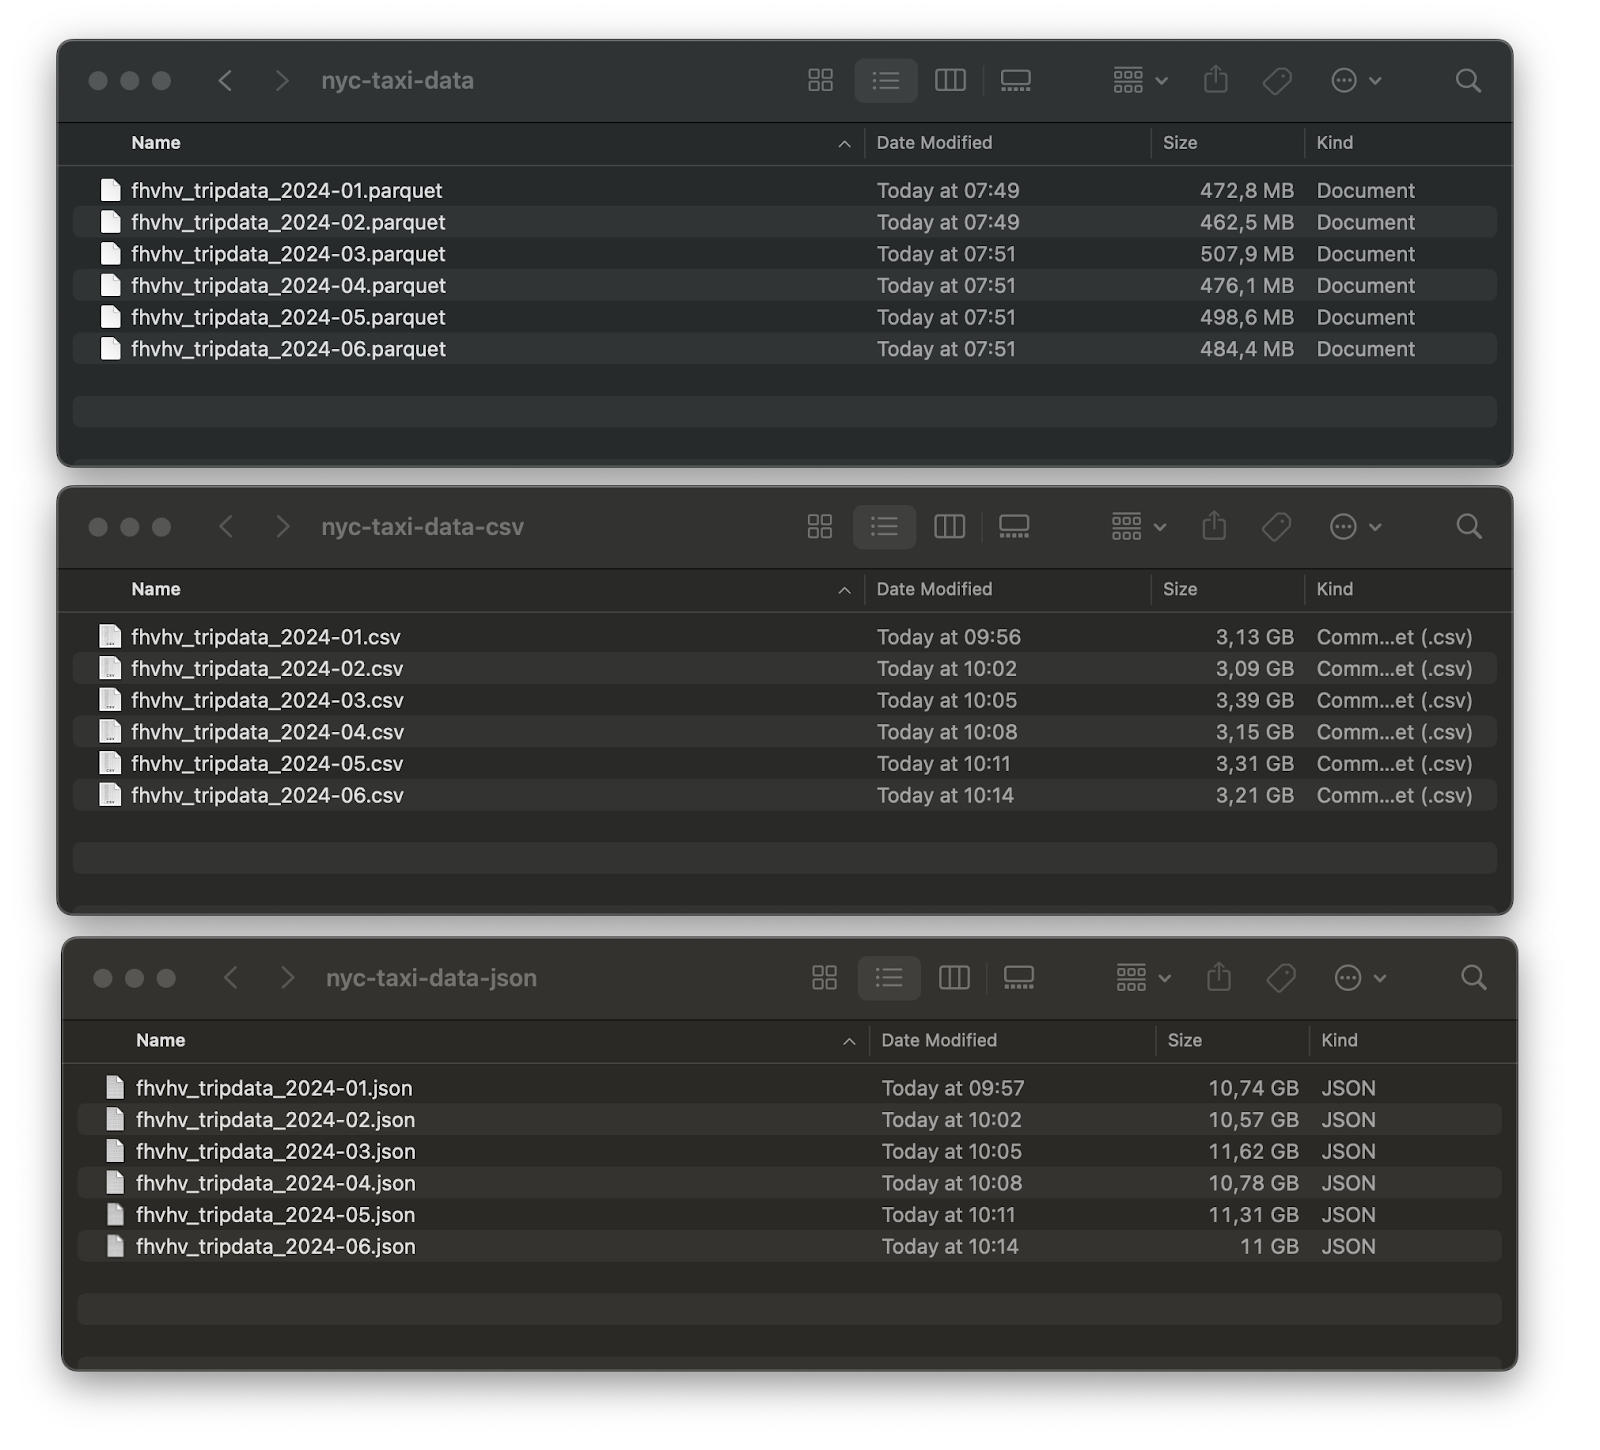
Veri kümesi boyutu karşılaştırması
Toplam: Parquet için 2,96GB, CSV için 19,31GB ve JSON için 66,04GB.
Muazzam fark! Bugünkü yazıdan başka bir şey almazsanız bile, şunu unutmayın: büyük dosyalarla çalışırken her zaman Parquet dosya formatını kullanın. Hem işlem süresinden hem de disk alanından tasarruf sağlayacaktır.
DuckDB, aynı formatta birden fazla dosyayı (glob deseni kullanarak) bir kerede okuyabilen kullanışlı fonksiyonlara sahiptir. Altısını birden okuyup satır sayısını alacak ve çalışma sürelerini karşılaştıracağım:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Sonuçlar geldi - yalnızca tek bir net kazanan var:
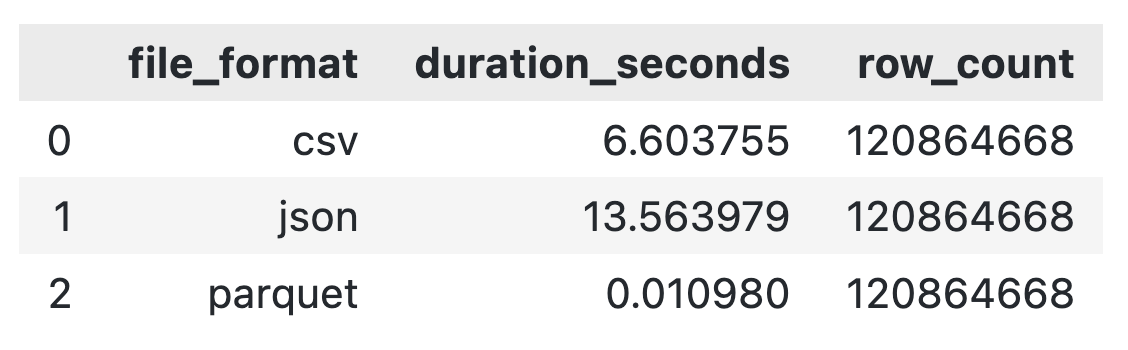
Dosya okuma çalışma süresi karşılaştırması
DuckDB sayesinde üçü de hızlı ve aynı noktada buluşuyor, ancak Parquet’in CSV’ye kıyasla 600 kat, JSON’a kıyasla ise 1200 kat kazandığı açık.
Bu nedenle, yazının geri kalanında yalnızca Parquet kullanacağım.
DuckDB, veriyi SQL ile birleştirmenize olanak tanır.
Bu bölümde amacım bu fikri genişletmek. Daha açık olmak gerekirse, 120 milyon satırdan oluşan bir veriden aylık düzeyde özet istatistikleri - yolculuk sayısı, yolculuk süresi, mesafe, maliyet ve sürücü ödemesi bilgilerini - nasıl hesaplayacağınızı göstereceğim.
En iyi yanı: Sadece iki saniye sürecek!
Aşağıda, veriyi birleştirmek ve sonuçları yazdırmak için bir Python betiğinde kullandığım kod yer alıyor:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
Çıktı; birleştirme sonuçlarını, results değişkeninin türünü ve toplam çalışma süresini içerir:
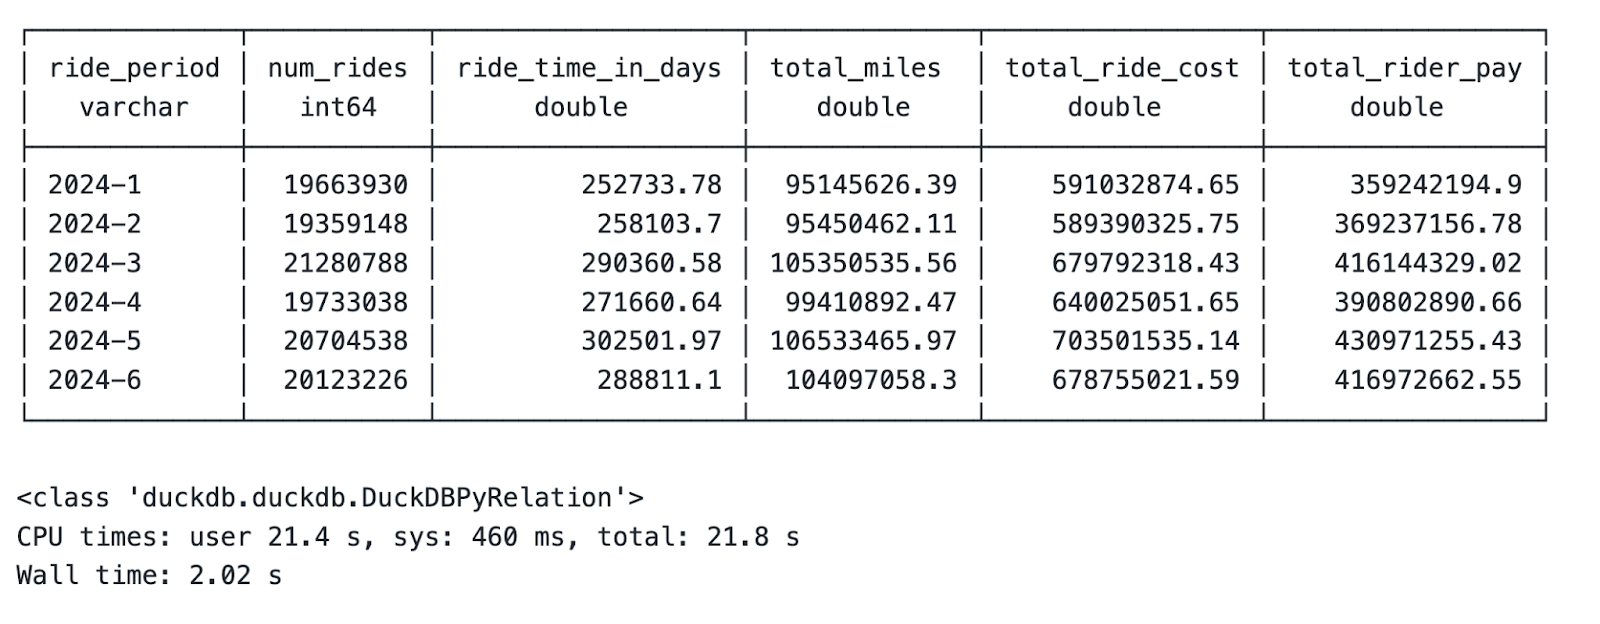
Aylık özet istatistiklerin birleştirilmesi
Şunu bir sindirin: 120 milyondan fazla satıra yayılan 3GB veri, bir dizüstü bilgisayarda 2 saniyede birleştirildi!
Tek sorun, değişken türünün uzun vadede pek kullanışlı olmaması. Neyse ki kolay bir çözüm var.
DuckDB’yi kullanmanın artısı sadece hızlı olması değil, aynı zamanda favori veri çerçevesi kütüphaneniz olan pandas ile de iyi entegre olmasıdır.
Yukarıda gösterdiğime benzer geçici bir sonuç kümeniz varsa, onu bir pandas DataFrame’ine dönüştürmek için yalnızca .df() metodunu çağırmanız yeterlidir:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df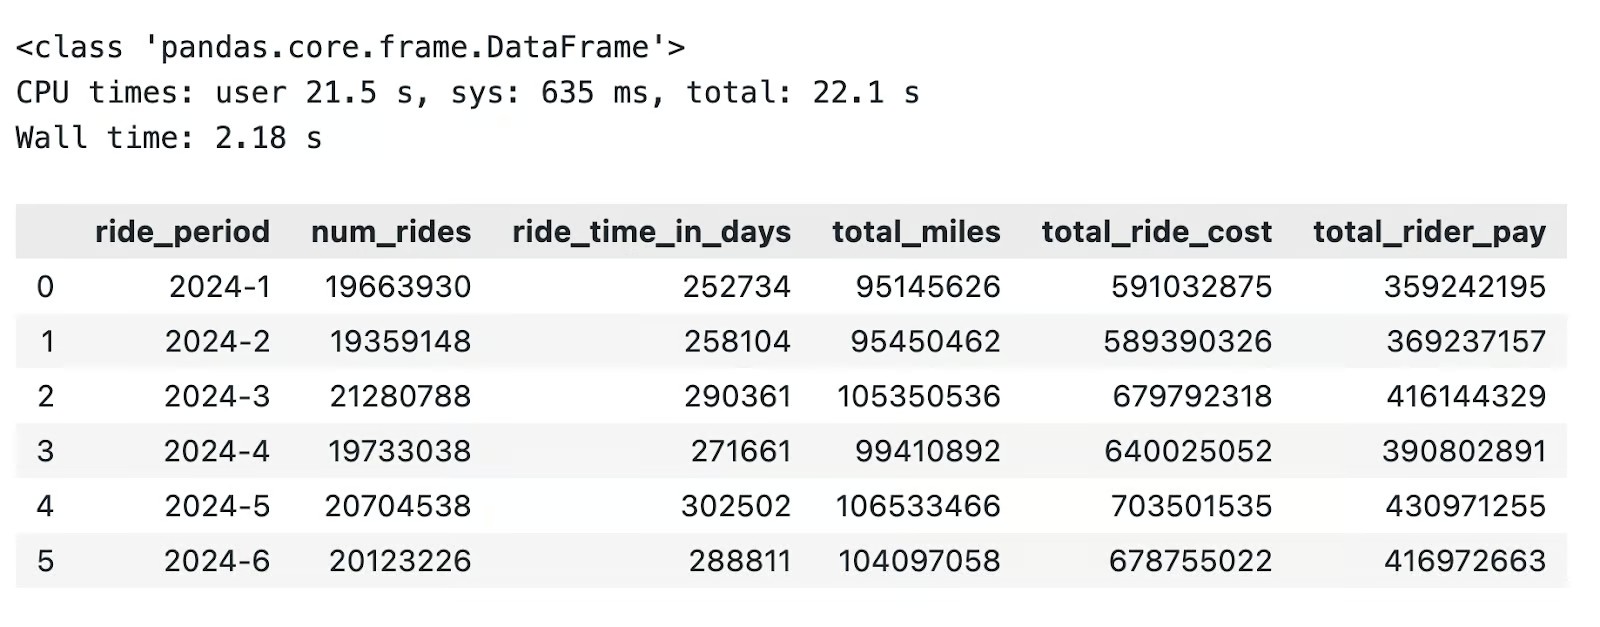
DuckDB'den pandas'a dönüştürme
Benzer şekilde, DuckDB’yi, halen belleğe yüklenmiş pandas DataFrame’lerinde hesaplamalar yapmak için kullanabilirsiniz.
Püf noktası, DuckDB SQL sorgusunda FROM ifadesinden sonra değişken adını referans etmektir. İşte bir örnek:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res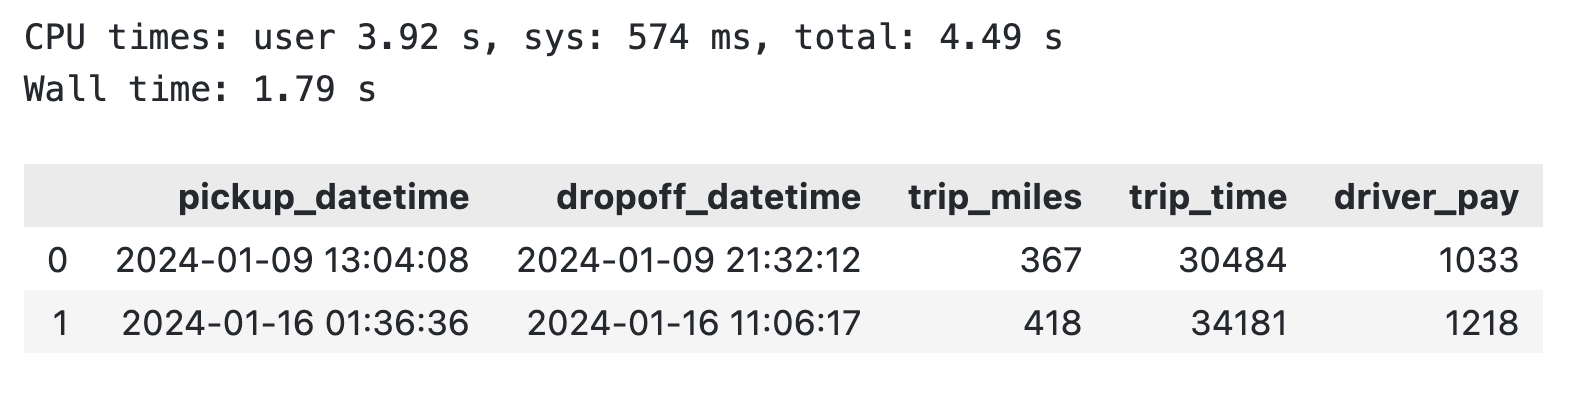
Mevcut bir pandas DataFrame üzerinde DuckDB sorgusu
pandas’ı tamamen devre dışı bırakabilir veya mevcut pandas DataFrame’leri üzerinde birleştirmeleri daha hızlı gerçekleştirebilirsiniz.
Sırada, birkaç gelişmiş DuckDB özelliğini göstereceğim.
DuckDB, göründüğünden çok daha fazlasını sunar.
Bu bölümde, veri mühendisleri için hayati öneme sahip birkaç ileri düzey DuckDB özelliğini anlatacağım.
DuckDB, yerel işlevselliğini çekirdek ve topluluk eklentileri aracılığıyla genişletmenize olanak tanır. Bulut depolama sistemlerine ve veritabanlarına bağlanmak ve ek dosya formatlarıyla çalışmak için eklentileri sıkça kullanıyorum.
Eklentileri hem Python hem de DuckDB konsollarından kurabilirsiniz.
Aşağıdaki kod parçasında, AWS’ye bağlanmak ve S3 verisini okumak için gerekli olan httpfs eklentisinin nasıl kurulacağını gösteriyorum:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")conn.execute()’a .df() metodunu zincirlemezseniz herhangi bir çıktı görmezsiniz. Zincirlerseniz “Success” veya “Error” mesajı görürsünüz.
Çoğu zaman, boru hatlarınıza dahil etmeniz gereken verilere şirketiniz erişim verir. Bunlar genellikle AWS S3 gibi ölçeklenebilir bulut platformlarında depolanır.
DuckDB, S3’e (ve diğer platformlara) doğrudan bağlanmanıza olanak tanır.
Eklentinin (httpfs) nasıl kurulacağını zaten gösterdim; geriye yalnızca yapılandırmak kalıyor. AWS, bölgeniz, erişim anahtarınız ve gizli erişim anahtarınız hakkında bilgi vermenizi ister.
Bunların hepsine sahip olduğunuzu varsayarak, aşağıdaki komutu Python üzerinden çalıştırın:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
S3 kovamda New York Taxi veri kümesinden iki dosya bulunuyor:
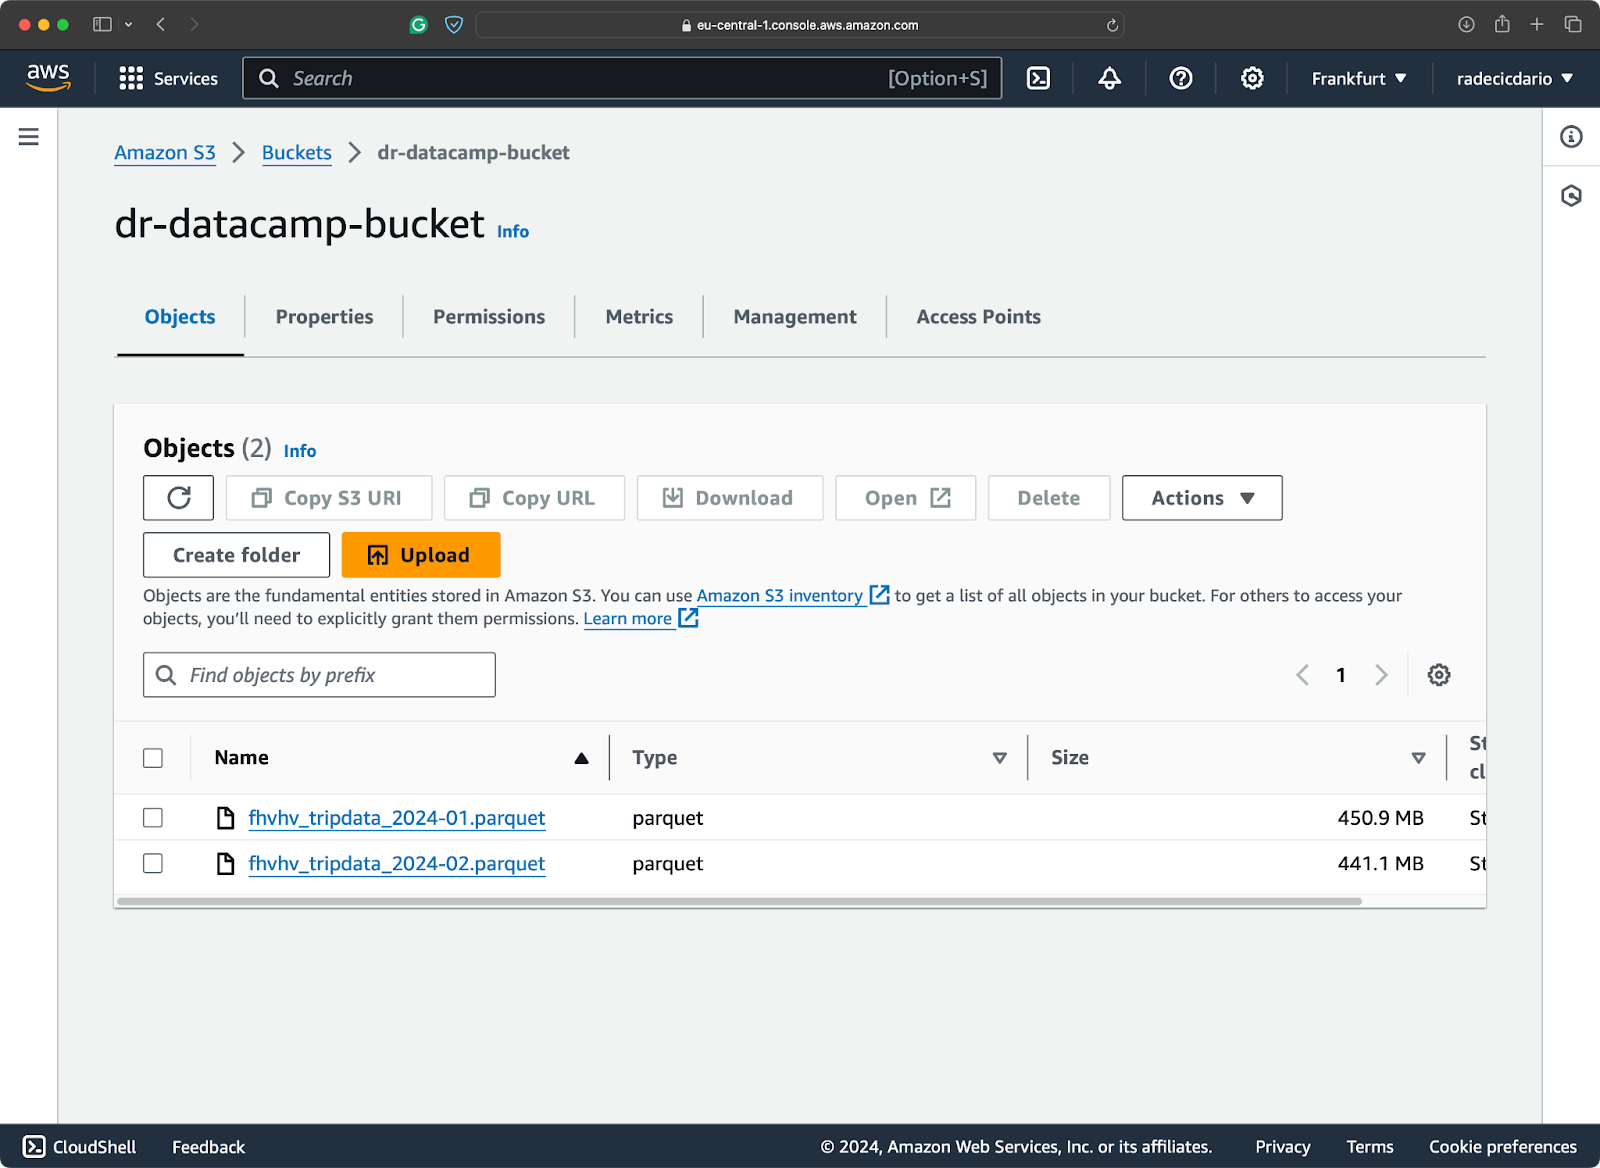
S3 kova içeriği
Dosyaları indirmenize gerek yok; S3’ten doğrudan tarayabilirsiniz:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count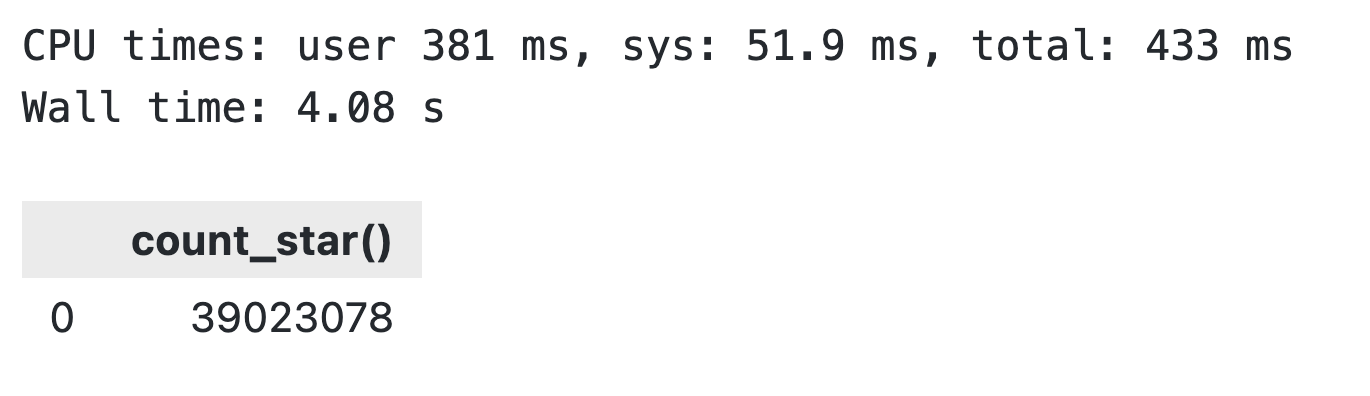
DuckDB S3 okuma sonuçları
Doğru okuyorsunuz: S3 kovasında duran ~ 900MB veriyi taramak yalnızca 4 saniye sürdü.
Paralelleştirme söz konusu olduğunda, DuckDB bunu varsayılan olarak satır gruplarına göre uygular: Parquet’te tipik olarak bulunan yatay veri bölümleri. Tek bir satır grubu en fazla 122.880 satır içerebilir.
DuckDB’de paralellik, 122.880 satırdan fazlasıyla çalışmaya başladığınızda devreye girer.
Bu gerçekleştiğinde DuckDB otomatik olarak yeni iş parçacıkları başlatır. Varsayılan olarak, iş parçacığı sayısı CPU çekirdeği sayısına eşittir. Ancak bu, iş parçacığı sayısıyla manuel olarak oynamanıza engel değildir.
Bu bölümde, bunu nasıl yapacağınızı ve aynı iş yükünde farklı iş parçacığı sayısının tam etkisini göstereceğim.
Geçerli iş parçacığı sayısını görüntülemek için şunu çalıştırın:
SELECT current_setting('threads') AS threads;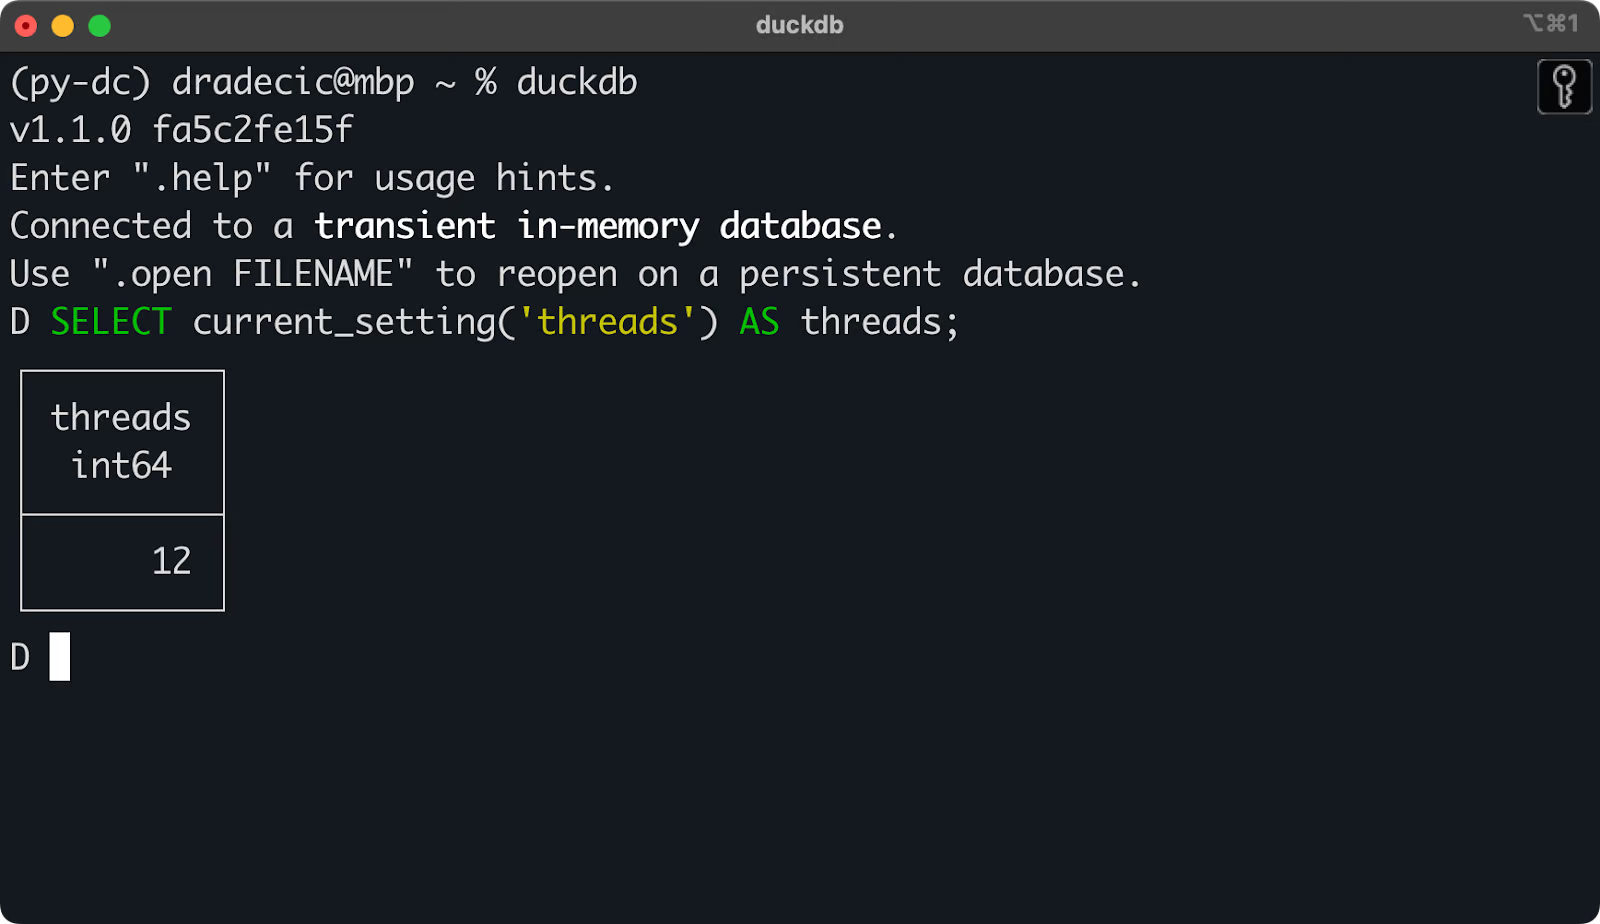
DuckDB tarafından kullanılan geçerli iş parçacığı sayısı
Aynı sonucu Python üzerinden de alabilirsiniz.
İş parçacığı sayısını değiştirmek için SET threads = N komutunu çalıştırmak isteyeceksiniz.
Aşağıdaki kod parçasında, DuckDB sorgusunu verilen sayıda iş parçacığıyla çalıştıran, sonucu bir pandas DataFrame’ine dönüştüren ve çalışma süresini (diğer şeylerin yanı sıra) döndüren özel bir Python fonksiyonunun nasıl uygulanacağını gösteriyorum. Fonksiyonun altındaki kod, onu [1, 12] iş parçacığı aralığında çalıştırır:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Benimkine benzer bir çıktı görmelisiniz:
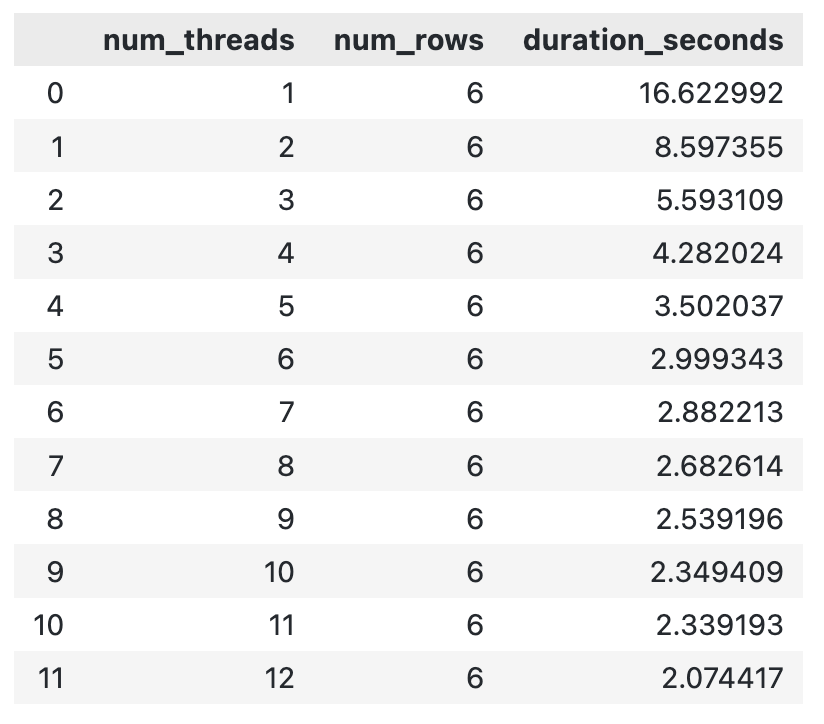
Farklı iş parçacığı sayıları için DuckDB çalışma süresi
Genel olarak, bir hesaplamaya ne kadar çok iş parçacığı atarsanız o kadar hızlı tamamlanır. Yeni bir iş parçacığı oluşturma ek yükünün toplam çalışma süresini artırdığı bir nokta olabilir, ancak bu aralıkta böyle bir durumla karşılaşmadım.
Bu bölümde sıfırdan nasıl bir veri boru hattı yazacağınızı göstereceğim. Oldukça basit olacak: diskten veri okumak, birleştirmeler yapmak ve sonuçları yazmak. Amacım, pandas’tan DuckDB’ye geçerek ne kadar performans kazanabileceğinizi göstermek. Üstelik kodunuz daha temiz görünecek.
Bu, ETL/ELT süreçlerine kapsamlı bir giriş değil, üst düzey bir genel bakıştır.
Göreceğiniz veri boru hattı şunları gerçekleştirir:
Kodu çalıştırdıktan sonra, her iki boru hattı uygulaması için de (bazı yuvarlama farklılıkları hariç) tam olarak aynı birleştirme sonuçlarını elde etmelisiniz:
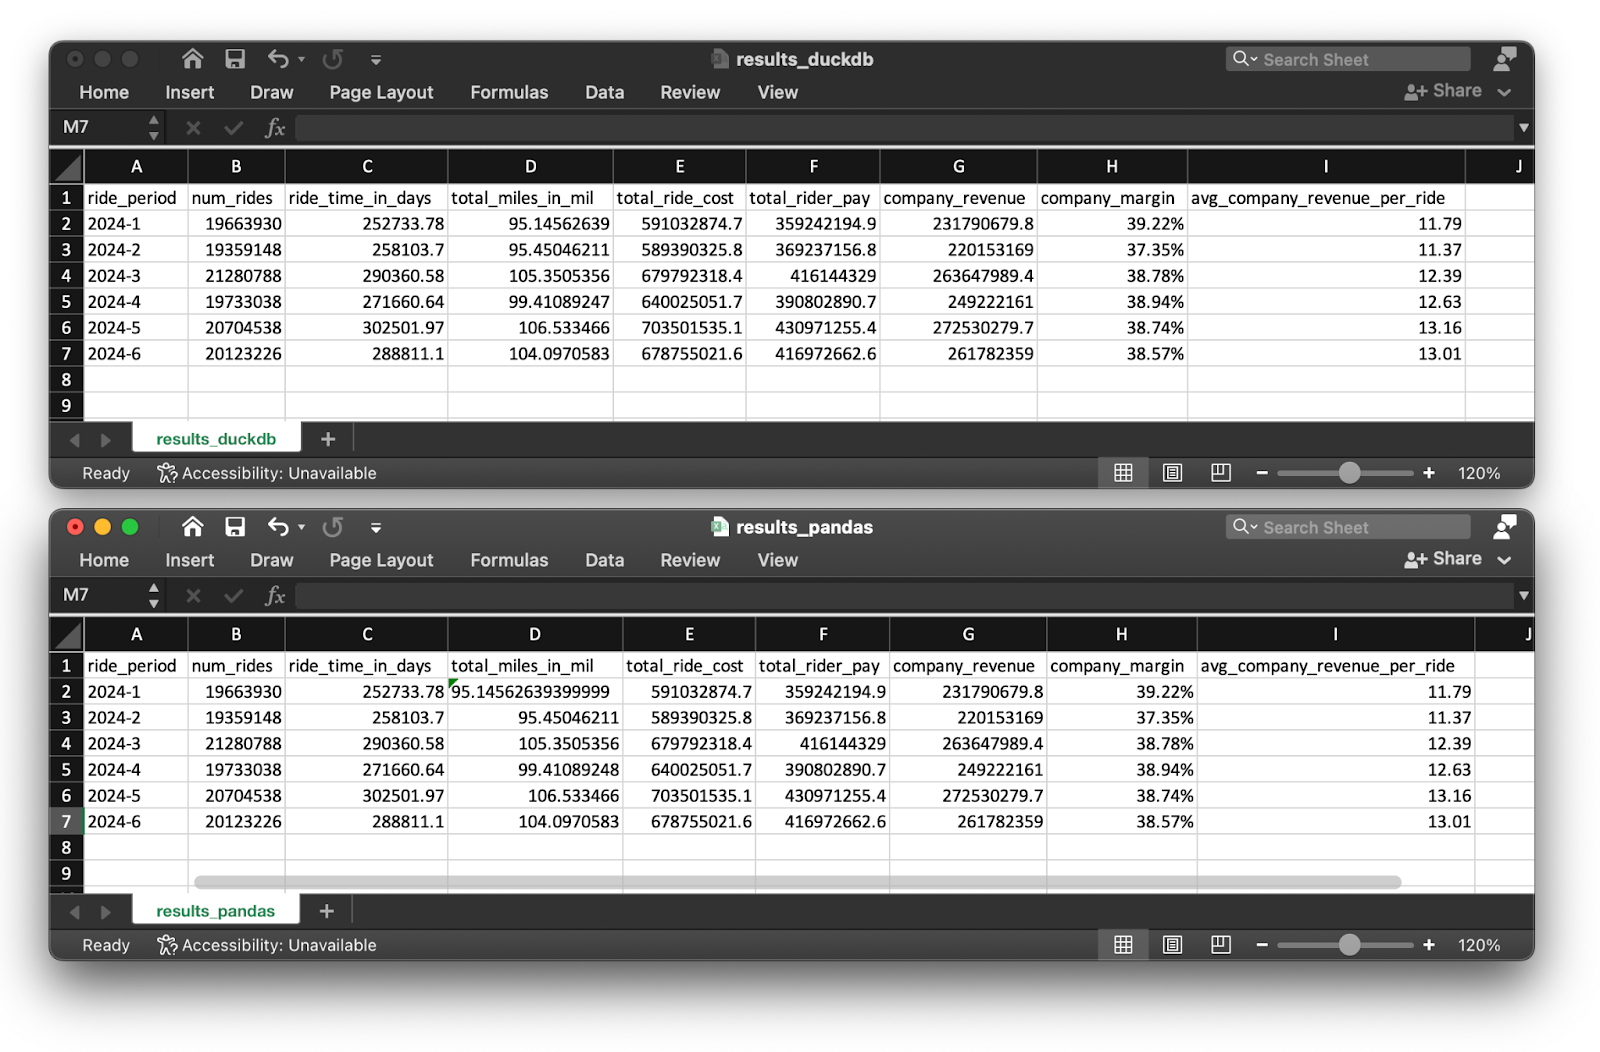
DuckDB ve pandas için boru hattı sonuçları
Önce, pandas ile boru hattı uygulamasını inceleyelim.
Ne yaparsam yapayım, 6 Parquet dosyasının hepsini bir anda işleyemedim. Birkaç saniye içinde şu tür sistem uyarı mesajları görüntülendi:
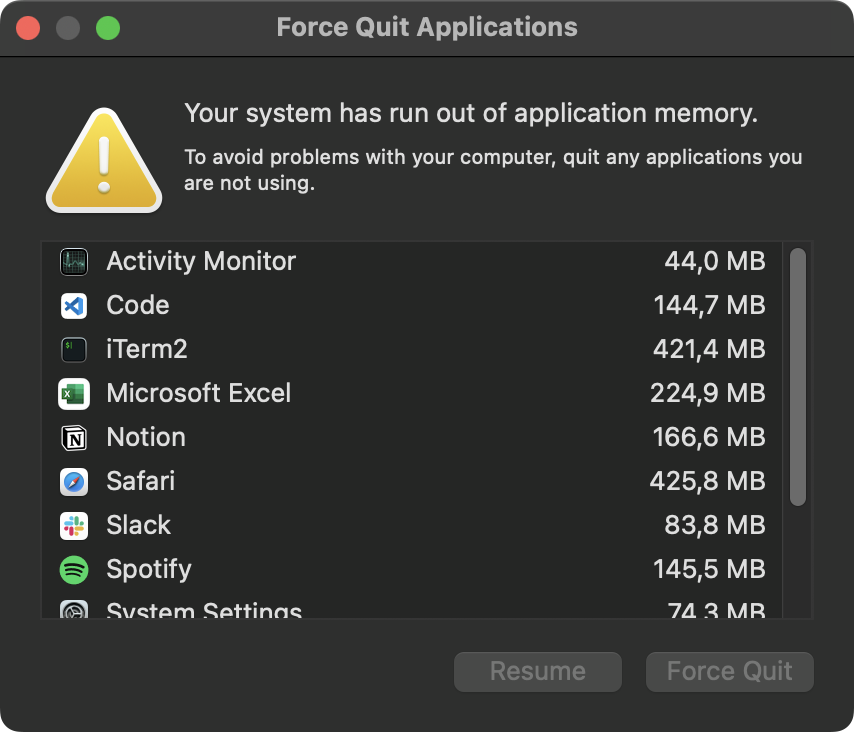
Sistem bellek hatası
Görünüşe göre 36GB bellek, 120 milyon satırı bir seferde işlemek için yeterli değil. Sonuç olarak Python betiği sonlandırıldı:
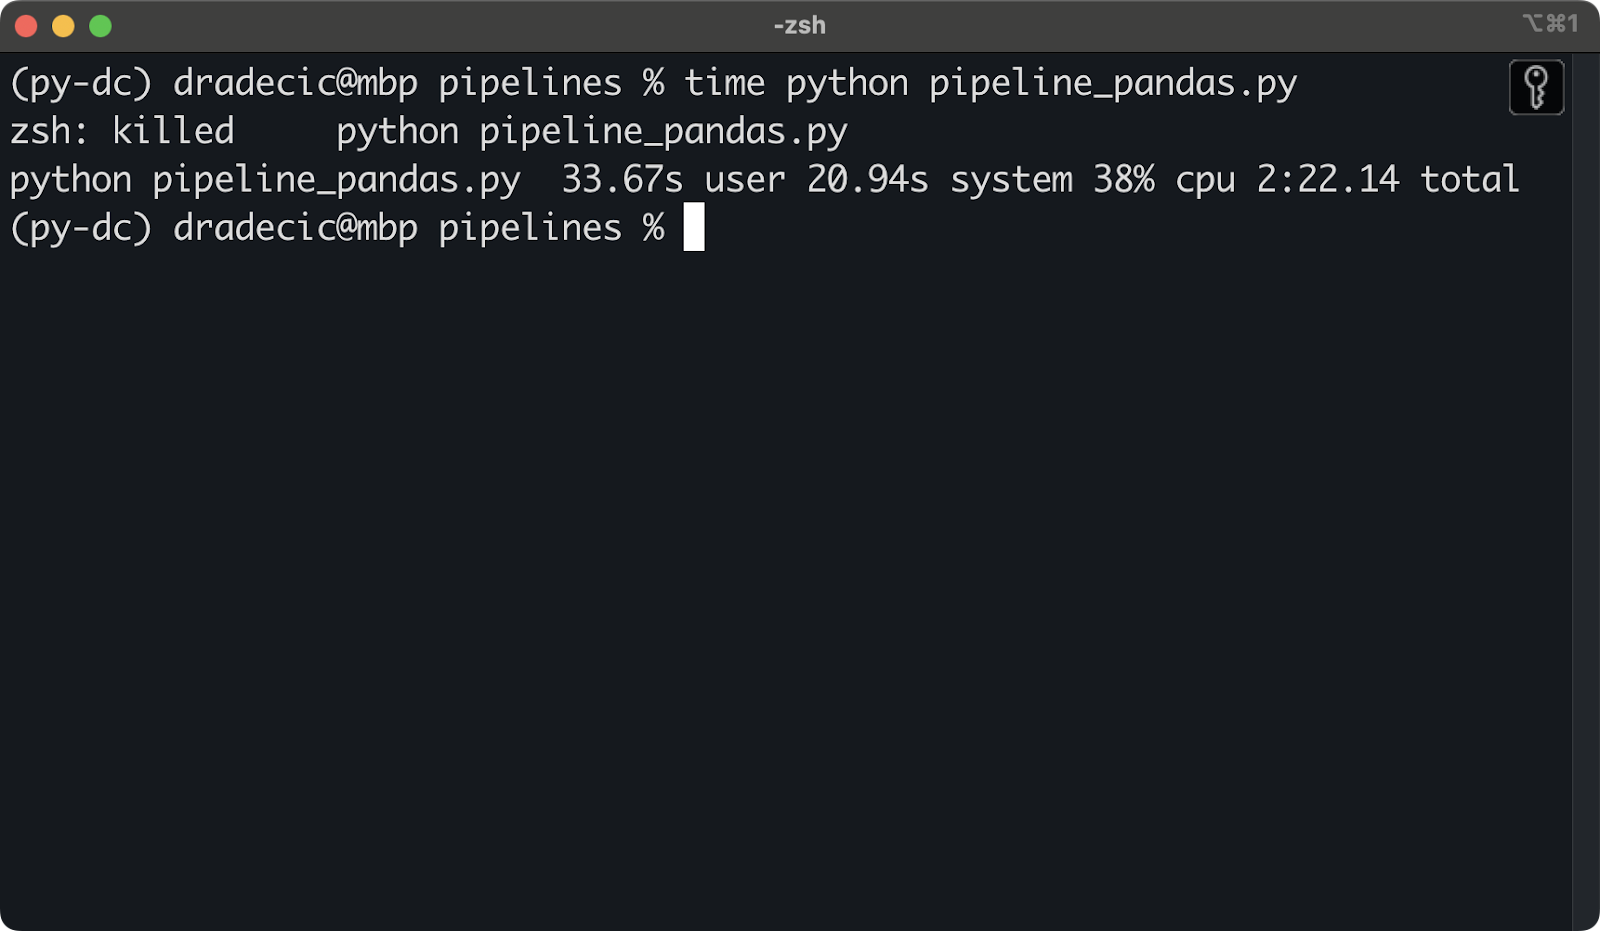
Yetersiz bellek nedeniyle sonlandırılan Python betiği
Bunu azaltmak için, Parquet dosyalarını sıralı olarak işlemek zorunda kaldım. Veri boru hattı için kullandığım kod şuydu:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
DuckDB ile boru hattı uygulaması umarım bellek sorunları olmadan tamamlanacaktır.
DuckDB kodunun büyük kısmına zaten aşinasınız.
Yeni olan tek şey, birkaç ek istatistiği hesaplayan en üstteki SELECT. Diğer her şeyi değiştirmedim:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Sırada, çalışma süresi farklarını göstereceğim.
Her iki boru hattını da 5 kez çalıştırıp sonuçların ortalamasını aldıktan sonra elde ettiğim çalışma süreleri şunlar:
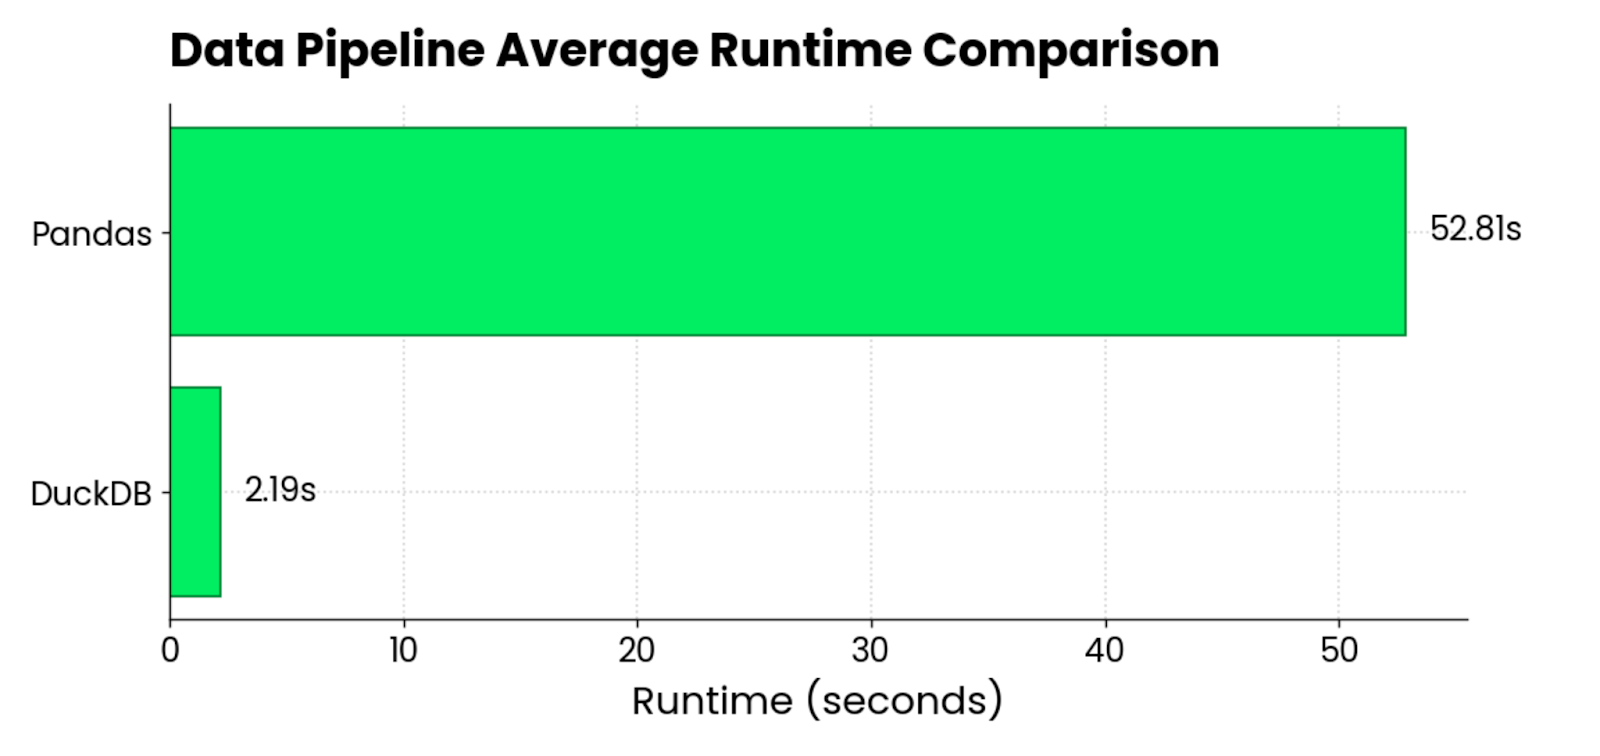
DuckDB vs. pandas çalışma süresi karşılaştırma grafiği
pandas, ortalama olarak DuckDB’den 24 kat daha yavaştı; 6 Parquet dosyasına yayılan yaklaşık 120 milyon satırı (~3GB) yüklerken ve işlerken.
Karşılaştırma tamamen adil değil; çünkü pandas ile tüm Parquet dosyalarını bir kerede işleyemedim. Yine de sonuçlar geçerli, çünkü iş yerinde benzer zorluklarla karşılaşacaksınız.
Bir kütüphane ihtiyacınızı karşılamıyorsa, başka birini deneyin. Ve çoğu zaman en hızlı bitirecek olan muhtemelen DuckDB olacaktır.
Sizi DuckDB’yi kendi başınıza daha fazla keşfetmeye bırakmadan önce, birkaç genel ve veri mühendisliğiyle ilgili en iyi uygulamayı paylaşmak istiyorum:
SELECT ifadeleri için optimize edilmiştir. Sık INSERT ve UPDATE ifadelerine dayanan iş akışlarında kullanmaktan kaçınmalısınız. Böyle bir durumda, SQLite kullanın.Sonuç olarak, veri boru hatları kurmak ve optimize etmekten sorumlu bir veri mühendisiyseniz DuckDB’yi denemeniz gerektiğini düşünüyorum.
Kaybedecek hiçbir şeyiniz yok, kazanacak çok şeyiniz var. Şu var ki, neredeyse kesin olarak Python’ın sunduğu her şeyden daha hızlıdır. Dizüstü bilgisayarınızda inanılmaz hızlı çalışır ve aksi halde bellek hatasına yol açacak veri kümelerini işlemenize olanak tanır. Veriyi yerelde saklamak istemediğiniz veya buna izin verilmediği durumlarda bulut depolama platformlarına da bağlanabilir.
Bununla birlikte, masaya getireceğiniz tek optimizasyon DuckDB olmamalıdır. Sisteminize giren veriyi her zaman optimize etmeye çalışın. Örneğin, CSV yerine Parquet kullanmak hem işlem süresinden hem depolamadan tasarruf sağlar. Düşünmeniz gereken bir diğer optimizasyon ise modern veri mimarisi ilkelerini iş akışlarınıza ve boru hatlarınıza uygulamaktır.
DuckDB sadece bir araç. Ama çok güçlü bir araç.
Bu kurslarla veri mühendisliği hakkında daha fazlasını öğrenin!
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




