

如何开始使用 DuckDB
正如前文所述,DuckDB 运行在您的笔记本电脑上。第一步就是把它装到本地。
我将演示 macOS 的安装步骤,但Windows 和Linux 的说明同样清晰易懂。
步骤 1:安装 DuckDB
如果您使用 Mac,安装 DuckDB 最简单的方法是通过Homebrew。运行以下 Shell 命令:
brew install duckdb几秒钟内您就会看到如下输出:
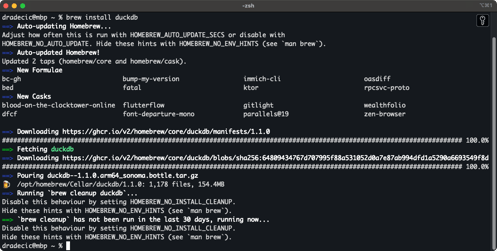
使用 Homebrew 安装 DuckDB
安装完成后,您可以通过以下命令进入 DuckDB Shell:
duckdb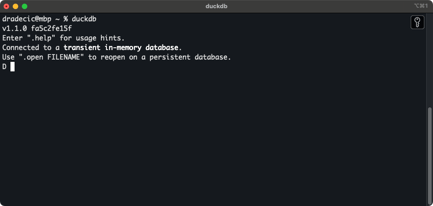
DuckDB shell
从这里开始,世界任您遨游!
您可以直接在控制台编写并运行 SQL 查询。例如,我已下载 2024 年前 6 个月的 纽约出租车数据。如果您也做了同样的准备,可使用以下片段显示单个 Parquet 文件的行数:
SELECT COUNT(*)
FROM PARQUET_SCAN("path-to-data.parquet");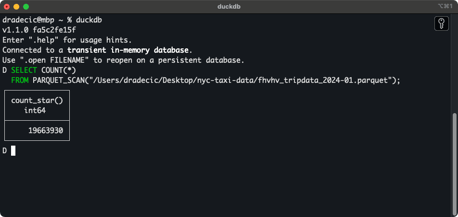
单个 Parquet 文件的行数
没错——将近 2000 万行来自一个文件。我一共下载了 24 个这样的文件。
您大概不想在终端里用 DuckDB,所以下一步我将带您把 DuckDB 连接到 Python。
步骤 2:将 DuckDB 接入您的 Python 工作流
本节的目标是向您展示如何在数据工程最常用的语言——Python 中配置并运行 DuckDB。
事实上,DataCamp 提供了完整的Python 数据工程职业路径。
Python 有一个专用的 DuckDB 库,您需要先安装它。请在终端中运行以下命令,最好在虚拟环境中进行:
pip install duckdb现在创建一个新的 Python 文件并粘贴以下代码:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
query = f"""
SELECT COUNT(*)
FROM PARQUET_SCAN("{file_path}")
"""
return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
# In-memory database connection
conn = duckdb.connect()
# Path to a parquet file
file_path = "fhvhv_tripdata_2024-01.parquet"
# Get the row count
row_count = get_row_count_from_file(conn=conn, file_path=file_path)
print(row_count)简而言之,该代码片段包含一个函数,给定有效的 DuckDB 连接与文件路径,从单个文件中获取行数。
运行脚本后,您几乎会立即得到如下结果:
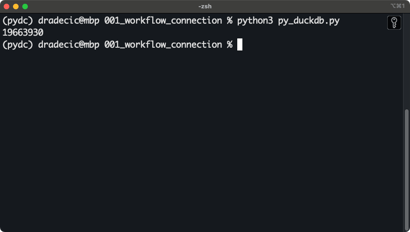
DuckDB 与 Python 连接
就是这样!
接下来,我将展示如何用 Python 和 DuckDB 以飞快的速度完成精彩操作!
DuckDB 实战:如何为数据管道提速
作为参照,我将基于 NYC Taxi 数据集 2024 年的部分(1 月至 6 月)运行代码——具体为高客流的预约车辆数据。一共有6 个 Parquet 文件,约占用 3GB 磁盘空间。硬件方面,我使用的是 16 英寸 M3 Pro MacBook Pro,12 核 CPU、36GB 统一内存。
您的结果可能略有不同,但应当相差不大。
眨眼之间读取海量数据集
我将这 6 个文件另外转换成了两种格式——CSV 和 JSON。您可以看到它们各自占用的磁盘空间:
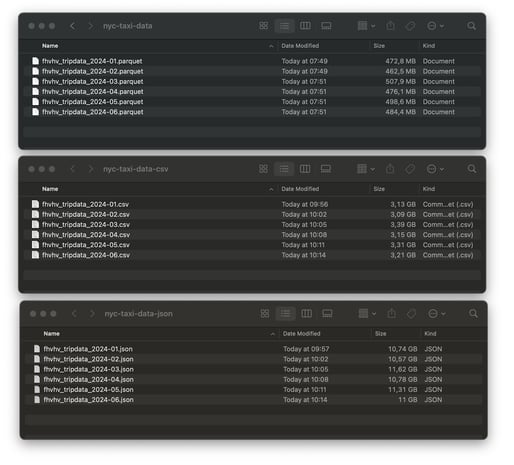
数据集大小对比
总计: Parquet 为 2.96GB,CSV 为 19.31GB,JSON 为 66.04GB。
差异巨大!即便您今天只记住一件事,也请记住:处理大文件时务必优先使用 Parquet 格式。它能同时节省处理时间和磁盘空间。
DuckDB 提供了便捷函数,可使用通配模式一次性读取多个相同格式的文件。我将用它读取全部六个文件获取行数,并比较运行时间:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
# Construct a DuckDB query based on the file_format
match file_format:
case "csv":
query = """
SELECT COUNT(*)
FROM READ_CSV("nyc-taxi-data-csv/*.csv")
"""
case "json":
query = """
SELECT COUNT(*)
FROM READ_JSON("nyc-taxi-data-json/*.json")
"""
case "parquet":
query = """
SELECT COUNT(*)
FROM READ_PARQUET("nyc-taxi-data/*.parquet")
"""
case _:
raise KeyError("Param file_format must be in [csv, json, parquet]")
# Open the database connection and measure the start time
time_start = datetime.now()
conn = duckdb.connect()
# Get the row count
row_count = conn.sql(query).fetchone()[0]
# Close the database connection and measure the finish time
conn.close()
time_end = datetime.now()
return {
"file_format": file_format,
"duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
"row_count": row_count
}
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)结果出来了——胜者只有一个:
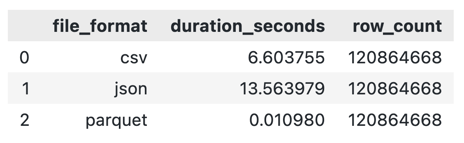
文件读取运行时对比
得益于 DuckDB,三种格式的读取都很快,并能抵达同一终点,但很明显,Parquet 相比 CSV 胜出600 倍,相比 JSON 胜出1200 倍。
因此,本文余下部分我将只使用 Parquet。
用 SQL 查询数据
DuckDB 允许您通过 SQL 聚合数据。
本节的目标是进一步扩展这一思路。更具体地,我将展示如何在月度层面计算汇总统计,包括出行次数、出行时长、出行距离、出行成本和司机收入——全部来自 1.2 亿行数据。
最棒的是:这只需要两秒!
下面是我在 Python 脚本中用于聚合数据并打印结果的代码:
conn = duckdb.connect()
query = """
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))输出包含聚合结果、results 的变量类型以及总运行时间:
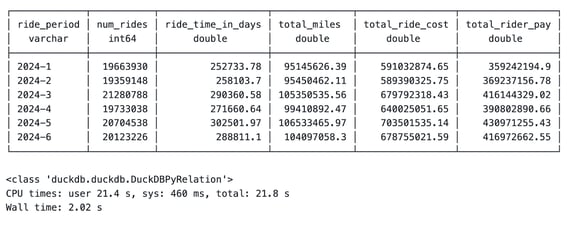
按月汇总统计聚合
细想一下:3GB、逾 1.2 亿行的数据,在一台笔记本上 2 秒就完成了聚合!
唯一的问题是这种变量类型长期来看不太好用。幸运的是,很容易解决。
与 pandas 和 DataFrame 集成
使用 DuckDB 的好处不仅在于快,还在于它能与您最喜欢的数据框库 pandas 良好集成。
如果您有类似上文的临时结果集,只需在其上调用 .df() 方法即可将其转换为 pandas 的 DataFrame:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df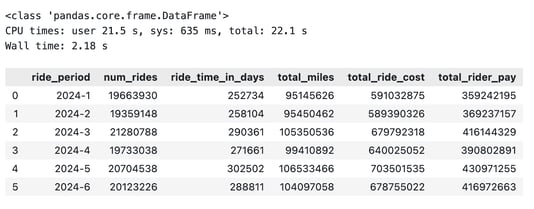
DuckDB 转 pandas
同样,您也可以使用 DuckDB 对已经加载到内存中的 pandas DataFrame 执行计算。
诀窍是在 DuckDB SQL 查询中,在 FROM 关键字后直接引用变量名。示例如下:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
SELECT
pickup_datetime,
dropoff_datetime,
trip_miles,
trip_time,
driver_pay
FROM pandas_df
WHERE trip_miles >= 300
""").df()
duckdb_res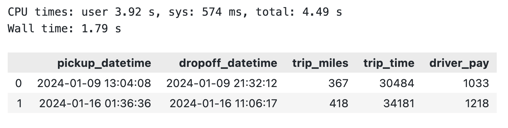
在已有的 pandas DataFrame 上运行 DuckDB 查询
总之,您既可以完全避开 pandas,也可以在已有的 pandas DataFrame 上更快完成聚合。
接下来,我将展示几项 DuckDB 的高级功能。
数据工程师的 DuckDB 进阶用法
DuckDB 远不止表面看到的那些。
本节我将带您了解几项对数据工程师至关重要的 DuckDB 高级功能。
扩展
DuckDB 允许您通过官方与社区扩展来增强其原生功能。我经常使用扩展连接云存储系统和数据库,并处理更多文件格式。
您可以在 Python 和 DuckDB 控制台中安装扩展。
在下面的代码片段中,我将演示如何安装用于连接 AWS 并读取 S3 数据所需的 httpfs 扩展:
import duckdb
conn = duckdb.connect()
conn.execute("""
INSTALL httpfs;
LOAD httpfs;
""")如果不在 conn.execute() 后链上 .df() 方法,您不会看到任何输出;若链上,则会看到 “Success” 或 “Error” 信息。
云存储查询
多数情况下,公司会授予您需纳入管道的数据访问权限。这些数据通常存储在可扩展的云平台上,如 AWS S3。
DuckDB 允许您直接连接 S3(及其他平台)。
我已经演示了如何安装扩展(httpfs),剩下的就是进行配置。AWS 要求您提供区域、访问密钥和密钥的相关信息。
假设您已具备这些信息,请通过 Python 运行以下命令:
conn.execute(""" CREATE SECRET aws_s3_secret (
TYPE S3,
KEY_ID '<your-access-key>',
SECRET '<your-secret-key>',
REGION '<your-region>'
);
""")我的 S3 存储桶中包含纽约出租车数据集的两个文件:
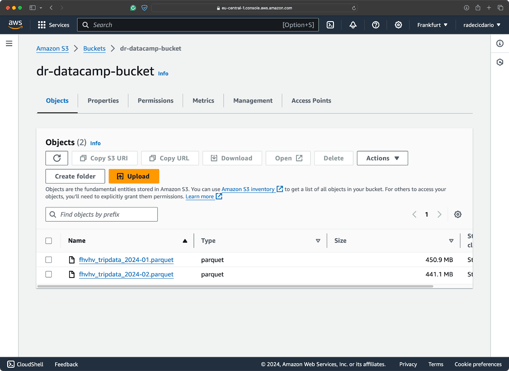
S3 存储桶内容
无需下载文件,您可以直接在 S3 上扫描:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
SELECT COUNT(*)
FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count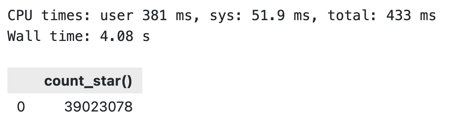
DuckDB S3 获取结果
没看错:只用了 4 秒就处理了 S3 存储桶中约 900MB 的数据。
并行处理
在并行化方面,DuckDB 默认基于行组实现:即您在 Parquet 中常见的横向数据分区。单个行组最多可包含 122,880 行。
当处理超过 122,880 行时,DuckDB 就会启用并行。
发生这种情况时,DuckDB 会自动启动新线程。默认情况下,线程数等于 CPU 内核数。但您也可以手动调整线程数。
本节我将展示如何设置,以及不同线程数对同一工作负载的具体影响。
要查看当前线程数,请运行:
SELECT current_setting('threads') AS threads;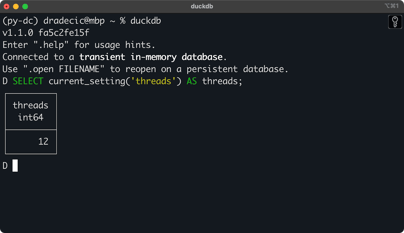
DuckDB 当前使用的线程数
您也可以通过 Python 获取相同结果。
要更改线程数,您需要运行 SET threads = N 命令。
在下面的代码片段中,我将实现一个自定义的 Python 函数,用给定的线程数运行 DuckDB 查询,将结果转换为 pandas DataFrame,并返回运行时间(及其他信息)。函数下方的代码会在 [1, 12] 线程范围内运行它:
def thread_test(n_threads: int) -> dict:
# Open the database connection and measure the start time
time_start = datetime.now()
conn = duckdb.connect()
# Set the number of threads
conn.execute(f"SET threads = {n_threads};")
query = """
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
"""
# Convert to DataFrame
res = conn.sql(query).df()
# Close the database connection and measure the finish time
conn.close()
time_end = datetime.now()
return {
"num_threads": n_threads,
"num_rows": len(res),
"duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
}
thread_results = []
for n_threads in range(1, 13):
thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)您应能看到与我类似的输出:
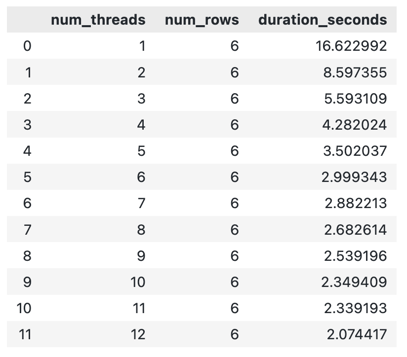
不同线程数下 DuckDB 运行时间
总体而言,线程越多,计算完成得越快。创建新线程带来的开销可能会在某个点导致总运行时间上升,但在这个范围内我没有遇到。
性能对比:DuckDB vs 传统方法
本节我将从零开始为您演示如何编写一个数据管道。它相对简单:从磁盘读取数据、执行聚合并写出结果。我的目标是展示通过从 pandas 切换到 DuckDB,您能获得多少性能提升。不仅如此,您的代码也会更简洁。
这不是ETL/ELT 过程的全面介绍,而是一个高层概览。
数据管道目标
我将展示的数据管道实现以下目标:
- 抽取(Extract): 从磁盘读取多个 Parquet 文件(约 1.2 亿行)。
- 转换(Transform):计算月度汇总统计,如出租车公司的营收、营收毛利(出行成本与司机收入之差)、单次平均营收。您还将看到本文前面讨论过的更常见的统计指标。
- 加载(Load): 将月度统计结果本地保存为 CSV 文件。
运行代码后,您应能在两种管道实现中得到完全相同的聚合结果(不计入少量四舍五入差异):
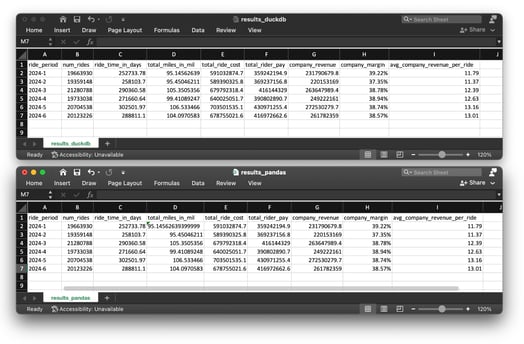
DuckDB 和 pandas 的管道结果
首先,让我们看一下 pandas 的管道实现。
代码:Python 与 pandas
无论我如何尝试,都无法一次性处理 6 个 Parquet 文件。几秒钟内就出现了类似这样的系统告警:
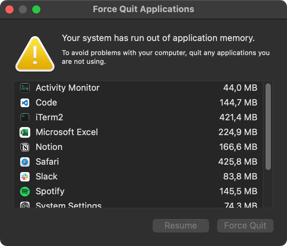
系统内存错误
看起来 36GB 内存仍不足以一次性处理 1.2 亿行。结果是 Python 脚本被系统终止:
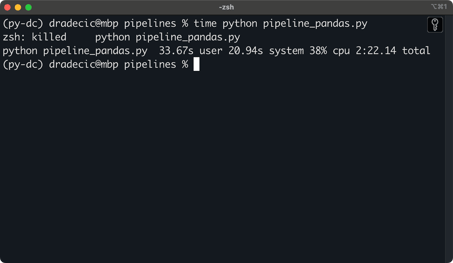
因内存不足而被终止的 Python 脚本
为了解决这个问题,我不得不按顺序处理 Parquet 文件。以下是我用于数据管道的代码:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
# Read a single Parquet file
df = pd.read_parquet(file_path)
# Extract ride year and month
df["ride_year"] = df["pickup_datetime"].dt.year
df["ride_month"] = df["pickup_datetime"].dt.month
# Remove data points that don"t fit in the time period
df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
# Combine ride year and month
df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
# Calculate total ride cost
df["total_ride_cost"] = (
df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
)
# Aggregations
summary = df.groupby("ride_period").agg(
num_rides=("pickup_datetime", "count"),
ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
total_miles=("trip_miles", "sum"),
total_ride_cost=("total_ride_cost", "sum"),
total_rider_pay=("driver_pay", "sum")
).reset_index()
# Additional attributes
summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
# Remove columns that aren't needed anymore
summary.drop(["total_miles"], axis=1, inplace=True)
return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
# Read data from multiple Parquet files
files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]
df = pd.DataFrame()
for file in files:
print(file)
file_stats = calculate_monthly_stats_per_file(file_path=file)
# Check if df is empty
if df.empty:
df = file_stats
else:
# Concat row-wise
df = pd.concat([df, file_stats], axis=0)
# Sort the dataset
df = df.sort_values(by="ride_period")
# Change column order
cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
"total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
return df[cols]
if __name__ == "__main__":
data_dir = "nyc-taxi-data"
output_dir = "pipeline_results"
output_file_name = "results_pandas.csv"
# Run the pipeline
monthly_stats = calculate_monthly_stats(file_dir=data_dir)
# Save to CSV
monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)DuckDB 的管道实现预计不会出现内存问题。
代码:DuckDB
您已经熟悉了 DuckDB 代码的大部分内容。
唯一的新内容是顶部的 SELECT,它计算了几项额外统计。其余保持不变:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
query = f"""
SELECT
ride_period,
num_rides,
ride_time_in_days,
total_miles / 1000000 AS total_miles_in_mil,
total_ride_cost,
total_rider_pay,
ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
FROM (
SELECT
ride_year || '-' || ride_month AS ride_period,
COUNT(*) AS num_rides,
ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
ROUND(SUM(trip_miles), 2) AS total_miles,
ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
ROUND(SUM(driver_pay), 2) AS total_rider_pay
FROM (
SELECT
DATE_PART('year', pickup_datetime) AS ride_year,
DATE_PART('month', pickup_datetime) AS ride_month,
trip_time,
trip_miles,
base_passenger_fare,
tolls,
bcf,
sales_tax,
congestion_surcharge,
airport_fee,
tips,
driver_pay
FROM PARQUET_SCAN("{file_dir}/*.parquet")
WHERE
ride_year = 2024
AND ride_month >= 1
AND ride_month <= 6
)
GROUP BY ride_period
ORDER BY ride_period
)
"""
conn = duckdb.connect()
df = conn.sql(query).df()
conn.close()
return df
if __name__ == "__main__":
data_dir = "nyc-taxi-data"
output_dir = "pipeline_results"
output_file_name = "results_duckdb.csv"
# Run the pipeline
monthly_stats = calculate_monthly_stats(file_dir=data_dir)
# Save to CSV
monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)接下来,我将展示运行时间的差异。
性能对比结果
将两种管道各运行 5 次并取平均后,我得到如下运行时间:
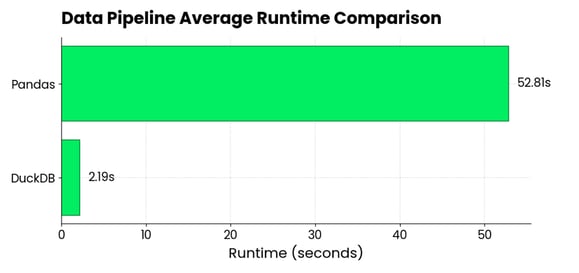
DuckDB vs. pandas 运行时间对比图
pandas 平均比 DuckDB慢 24 倍,在加载和处理约 1.2 亿行(约 3GB)、分布于 6 个 Parquet 文件的数据时尤为明显。
这个对比并不完全公平,因为我无法用 pandas 一次性处理全部 Parquet 文件。尽管如此,结果依然具有参考意义,因为您在工作中也会遇到类似困难。
如果一个库无法满足需求,就试试另一个。而多数情况下,最快完成任务的很可能是 DuckDB。
在数据管道中使用 DuckDB 的最佳实践
在您自行进一步探索 DuckDB 之前,我想分享几条通用且与数据工程相关的最佳实践:
- 优先尝试使用 DuckDB 的内置函数: 您可以通过用户自定义函数将 Python 函数引入 DuckDB,这将把 DuckDB 的灵活性提升到全新维度。编程的一条通用最佳实践是不必重复造轮子。换句话说,若已有现成功能,就不要从零实现。
- 先优化文件格式: 尽管 DuckDB 开箱即用就能带来显著性能收益,但这并不意味着可以就此停止优化。您已看到 DuckDB 在读取 CSV 时会慢很多(最多 600 倍)相比读取 Parquet。后者永远更快、更省空间,可谓双赢。
- 不要将 DuckDB 用于事务型目的: DuckDB 是 OLAP 数据库(联机分析处理),意味着它针对
SELECT语句优化。依赖频繁INSERT与UPDATE的工作流应避免使用它。如果是这种情况,请用 SQLite 代替。 - 利用 Jupyter Notebook 对 DuckDB 的原生支持: Jupyter Lab/Notebook 用户可直接运行 DuckDB 查询,无须通过特定的 Python 函数。这是更快探索数据并保持笔记本整洁的好方法。
- 时刻牢记 DuckDB 如何处理并发: 您可将 DuckDB 配置为允许一个进程对数据库读写,或配置为允许多个进程读取但不允许写入。前者允许将数据缓存到内存,以加速分析查询。理论上多个进程也能写入同一数据库文件,但为实现这一点,您需要自行实现跨进程互斥锁以及手动打开/关闭数据库的逻辑。
- 您也可以在云端使用 DuckDB: MotherDuck 项目是一个协作型数据仓库,将 DuckDB 的能力带到云端并进一步扩展。对于数据工程师而言,可能是值得探索的方向。
总结
总之,如果您负责构建与优化数据管道,我认为您应该试试 DuckDB。
您不会有损失,只会有收获。它几乎必然比任何 Python 方案更快。它能在您的笔记本上以极快速度运行,处理那些否则会导致内存错误的数据集。在您不想或不被允许本地存储数据的情况下,它也能连接云存储平台。
话虽如此,DuckDB 不应成为您唯一的优化手段。应始终努力优化进入系统的数据。例如,弃用 CSV 改用 Parquet,既省算力又省存储。另一个值得考虑的优化是将 现代数据架构 的原理引入您的工作流和管道。
DuckDB 只是一个工具,但却是非常强大的工具。
FAQs
DuckDB 是否可免费使用?
是的,DuckDB 是一个开源项目。您可以下载、修改,甚至通过 GitHub 进行贡献。
DuckDB 与 SQLite 有何不同?
DuckDB 针对通过复杂 SQL 查询的分析型工作负载进行优化(可理解为 SELECT 语句),而 SQLite 更适用于事务型处理(可理解为 INSERT 和 UPDATE 语句)。
DuckDB 是 NoSQL 数据库吗?
不是。DuckDB 是一款进程内的 SQL OLAP(联机分析处理)数据库管理系统。
DuckDB 是否比 pandas 更快?
在几乎所有场景中,DuckDB 都会比 pandas 更快,通常至少快一个数量级。它还允许您处理在 pandas 中会引发内存错误的数据集。
DuckDB 是否使用特殊的 SQL 方言?
不会。如果您具备基础的 SQL 知识,就会很容易上手。DuckDB 与 PostgreSQL 方言的约定高度一致,但即使您习惯于其他数据库厂商的语法,几乎也没有学习曲线。

有多少次当经理问您管道运行需要多长时间时,您都不好意思作答?
您并不孤单。Python 的便利性总要在某处付出代价,而往往就是在运行时速度上。管道写起来很快,但难以扩展,随着项目需求增长,运行时间常常越来越长。
但也许瓶颈并不在您的代码。也许 pandas 已经很难再挤出更多性能。也许换一种数据处理引擎,就能把运行时间从数小时降到几分钟。
这正是 DuckDB 大显身手的地方。
本文将为您准确解释什么是 DuckDB,以及它为何对数据工程师至关重要。您将通过上手示例学习如何使用 DuckDB,并看看它相较于 Python 最流行的数据处理库究竟快了多少。
什么是 DuckDB?它会成为数据工程师的下一个大事件吗?
DuckDB 是一款开源、嵌入式、进程内的关系型 OLAP 数据库管理系统(DBMS)。
通俗地说,它是一种在内存中运行的分析型列式数据库。作为分析型数据库,它针对
SELECT语句而非INSERT和UPDATE做了优化。它就像 SQLite,但方向相反。DuckDB 已经问世约5 年,但首个“稳定”版本是在2024 年 6 月发布——写作时距今 3 个月。不过别被“新”所迷惑——DuckDB 已被众多用户验证,在速度至关重要时几乎总是被推荐的工具。
为何在数据管道中选择 DuckDB
如果您是数据工程师,在数据管道中使用 DuckDB 有以下几项实打实的好处:
polars)还要快。基于这些原因(以及后文提到的更多原因),我认为 DuckDB 将成为数据工程师的下一次重大飞跃。