Curso
Introdução à Engenharia de Dados
2 h
372.4K
Como eu disse, o DuckDB roda no seu notebook. Primeiro passo: instalar.
Vou mostrar os passos no macOS, mas as instruções para Windows e Linux são bem explicadas e fáceis de seguir.
Se você usa Mac, o jeito mais simples é via Homebrew. Rode o comando abaixo no terminal:
brew install duckdbEm segundos você verá algo como:
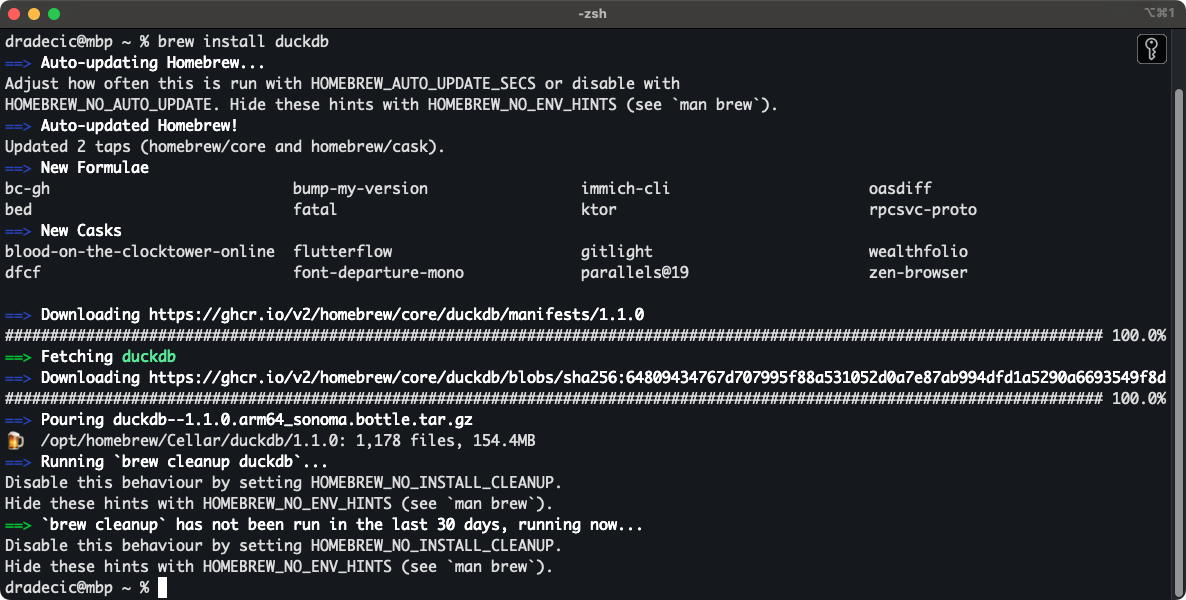
Instalando o DuckDB com Homebrew
Depois de instalado, entre no shell do DuckDB com:
duckdb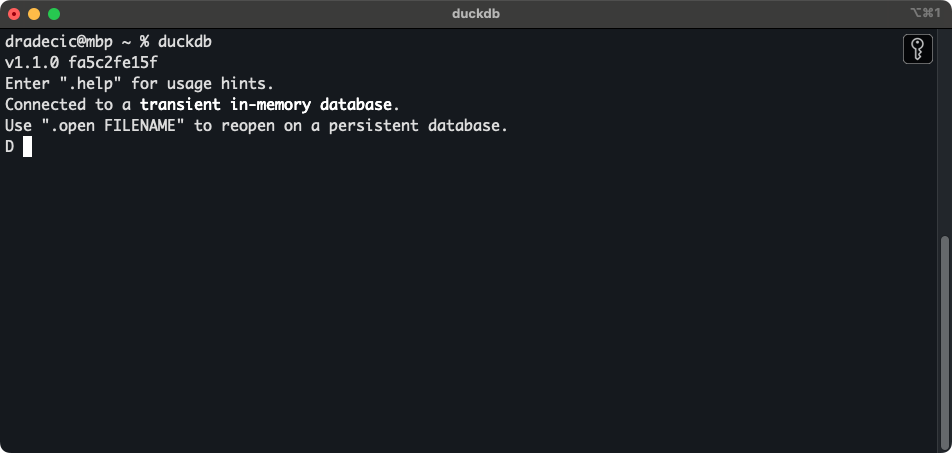
Shell do DuckDB
A partir daqui, a casa é sua!
Você pode escrever e executar consultas SQL direto no console. Por exemplo, baixei os primeiros 6 meses de NYC Taxi Data de 2024. Se você fez o mesmo, use o snippet abaixo para exibir a contagem de linhas de um único arquivo Parquet:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");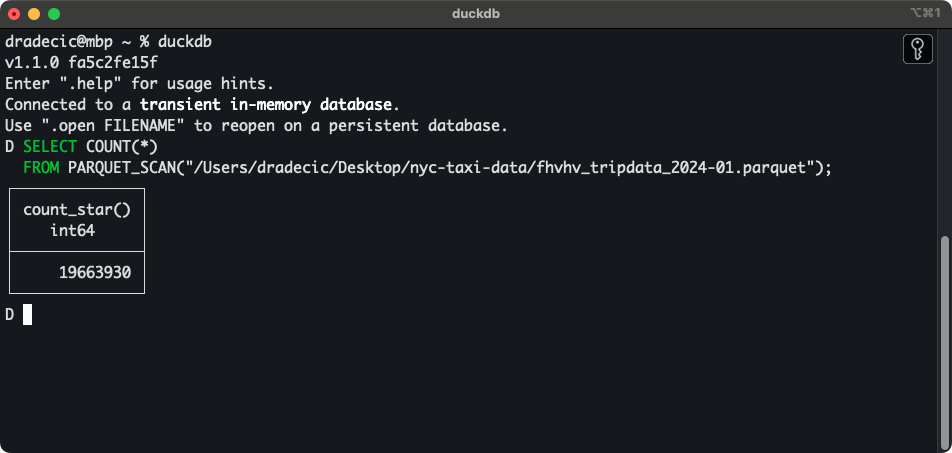
Contagem de linhas de um único arquivo Parquet
Pois é — são quase 20 milhões de linhas em um único arquivo. Eu baixei 24 deles.
Provavelmente você não vai querer rodar o DuckDB pelo terminal, então, a seguir, mostro como conectá-lo ao Python.
O objetivo desta seção é mostrar como configurar e rodar o DuckDB na linguagem mais popular de data engineering: Python.
Inclusive, a DataCamp oferece uma trilha completa de carreira em data engineering em Python.
O Python tem uma biblioteca específica do DuckDB que você precisa instalar primeiro. Rode no terminal, de preferência em um ambiente virtual:
pip install duckdbAgora crie um novo arquivo Python e cole o código abaixo:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Resumindo, o snippet tem uma função que retorna a contagem de linhas de um arquivo, dado uma conexão válida do DuckDB e o caminho do arquivo.
Ao rodar o script, o resultado aparece quase instantaneamente:
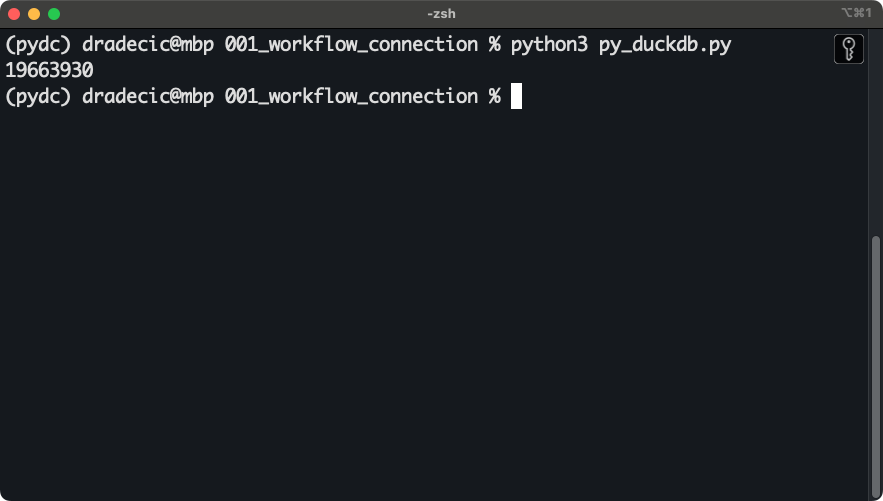
Conexão DuckDB e Python
É isso!
A seguir, vou te mostrar como fazer coisas incríveis com Python e DuckDB — voando baixo!
Para referência, vou rodar o código em uma parte de 2024 (janeiro a junho) do NYC Taxi Dataset — especificamente para veículos de alto volume sob demanda. São 6 arquivos Parquet, ocupando cerca de 3 GB em disco. No hardware, uso um MacBook Pro 16” M3 Pro com 12 núcleos de CPU e 36 GB de memória unificada.
Seu resultado pode variar, mas os números devem ficar próximos.
Converti esses 6 arquivos para mais dois formatos — CSV e JSON. Veja quanto espaço em disco cada um ocupa:
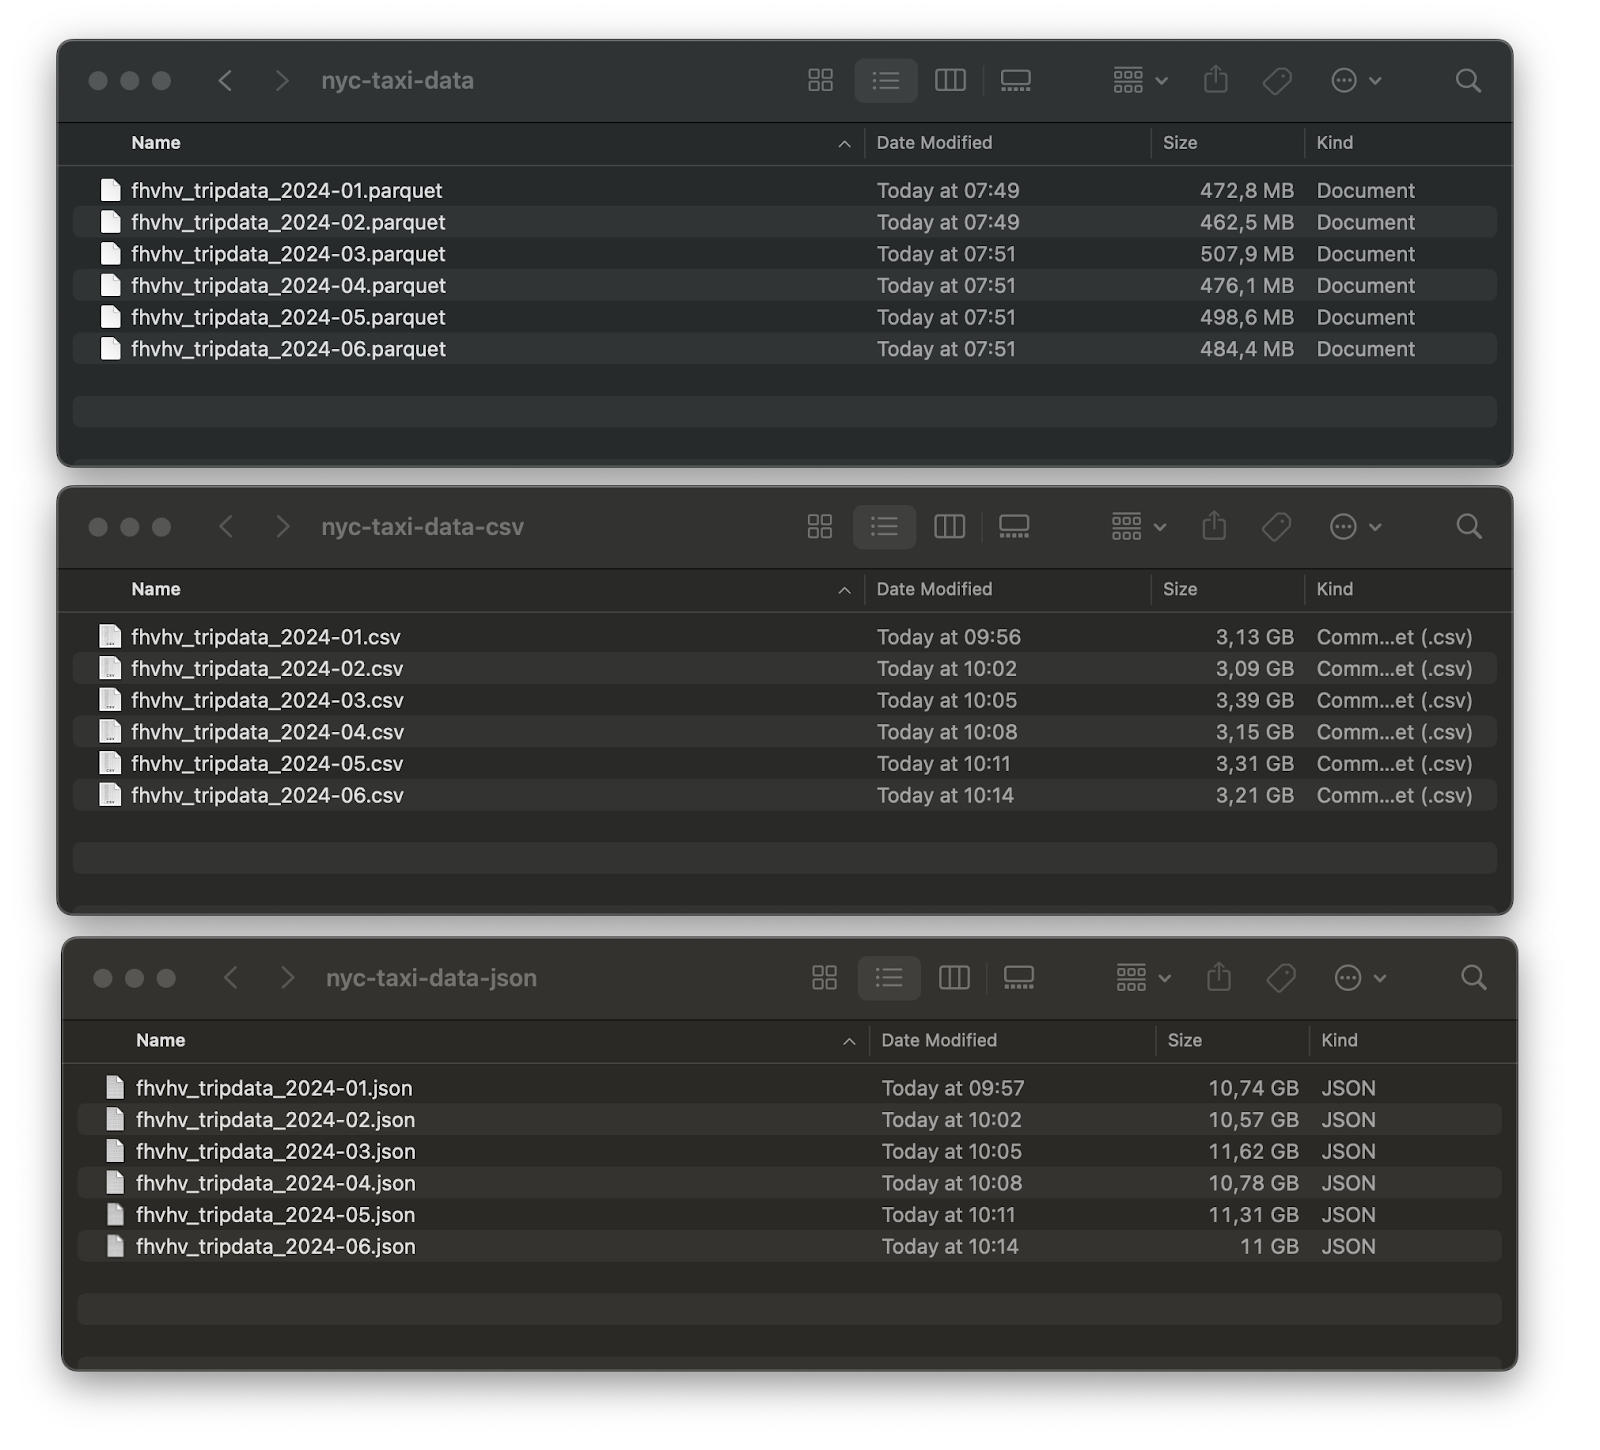
Comparação do tamanho do dataset
Total: 2,96 GB em Parquet, 19,31 GB em CSV e 66,04 GB em JSON.
Diferença enorme! Se você não guardar mais nada deste artigo, lembre-se de sempre usar o formato Parquet ao lidar com arquivos grandes. Você economiza tempo de processamento e espaço em disco.
O DuckDB tem funções práticas para ler vários arquivos do mesmo formato de uma vez (usando padrão glob). Vou usá-las para ler os seis, obter a contagem de linhas e comparar o tempo de execução:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Saiu o resultado — existe um vencedor claro:
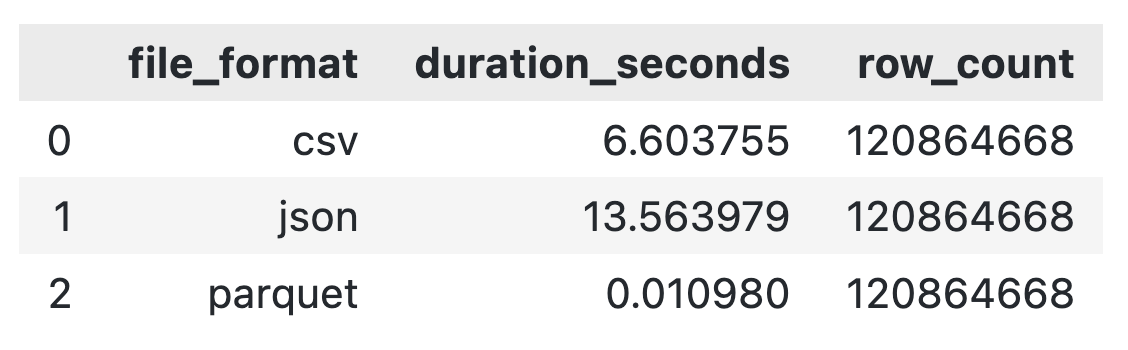
Comparação do tempo de leitura de arquivos
Graças ao DuckDB, os três são rápidos e chegam no mesmo lugar, mas é nítido que Parquet vence por um fator de 600 em relação ao CSV e por um fator de 1200 em relação ao JSON.
Por isso, no restante do artigo vou usar apenas Parquet.
O DuckDB permite agregar dados via SQL.
Meu objetivo aqui é expandir essa ideia. Mais precisamente, vou mostrar como calcular estatísticas mensais com número de corridas, tempo, distância, custo e pagamento ao motorista — tudo a partir de 120 milhões de linhas.
O melhor: leva só dois segundos!
Este é o código que usei em um script Python para agregar os dados e imprimir os resultados:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
A saída traz os resultados da agregação, o tipo da variável results e o tempo total de execução:
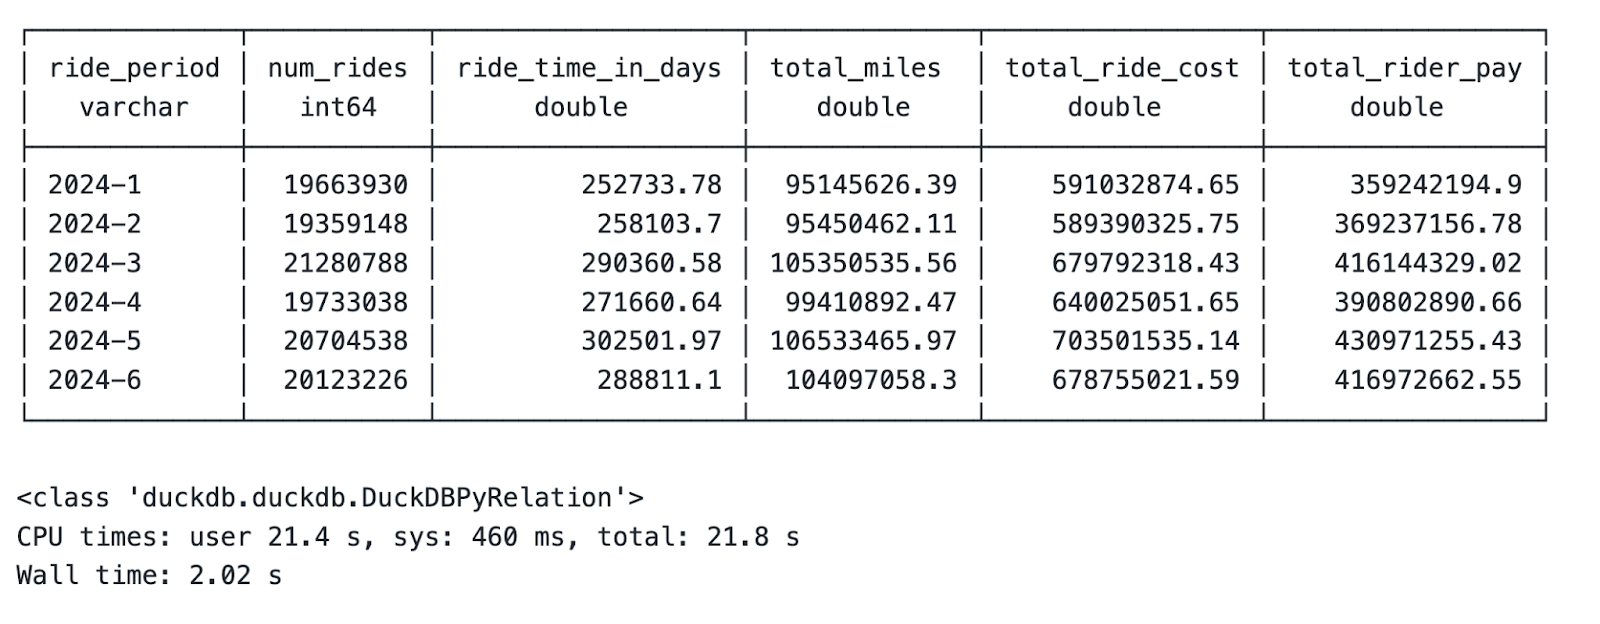
Agregação de estatísticas mensais
Pensa nisso: são 3 GB e mais de 120 milhões de linhas, tudo agregado em 2 segundos em um notebook!
O único porém é que o tipo de variável não é muito prático a longo prazo. Felizmente, há um ajuste simples.
A vantagem do DuckDB não é só ser rápido: ele também se integra muito bem com sua biblioteca favorita de data frames: pandas.
Se você tem um conjunto de resultados temporário como o que mostrei, basta chamar o método .df() para convertê-lo em um DataFrame do pandas:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df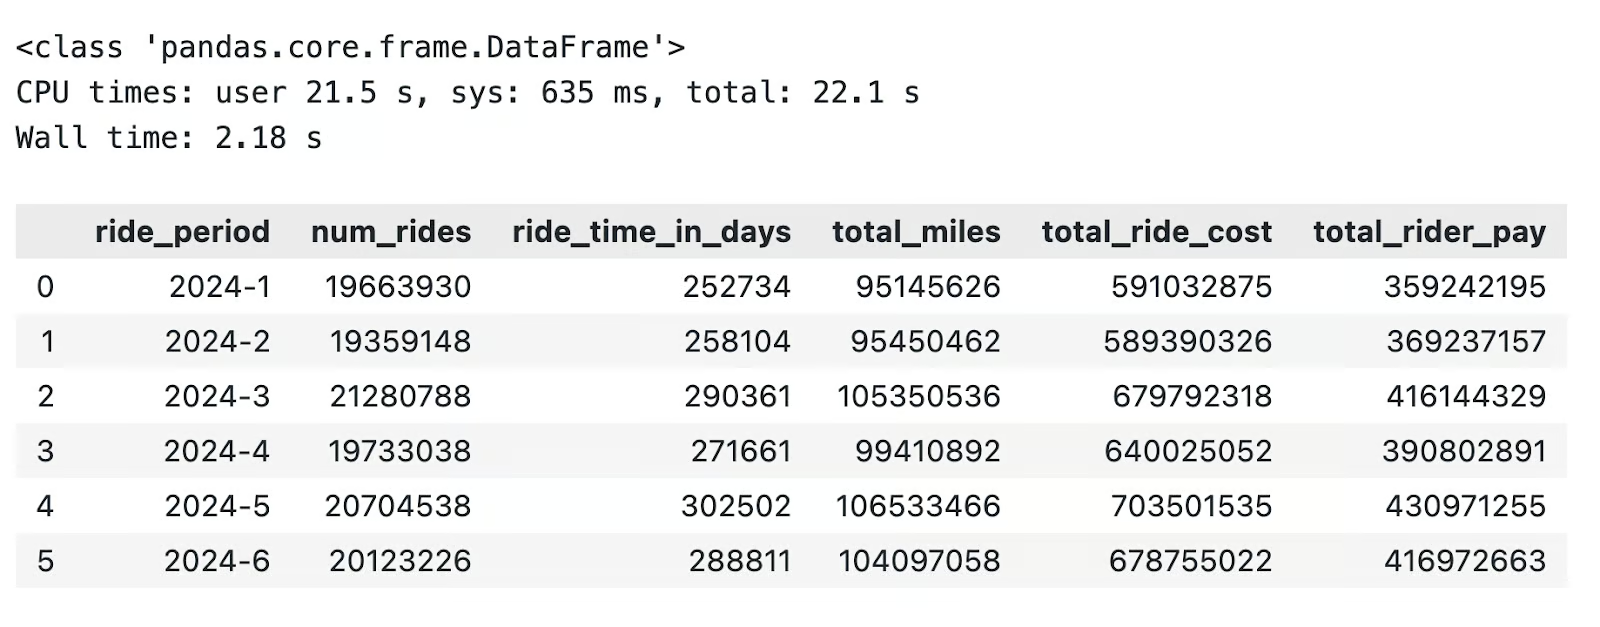
Conversão de DuckDB para pandas
Da mesma forma, você pode usar o DuckDB para calcular em DataFrames do pandas que já estão em memória.
O truque é referenciar o nome da variável após a palavra-chave FROM em uma consulta SQL do DuckDB. Exemplo:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res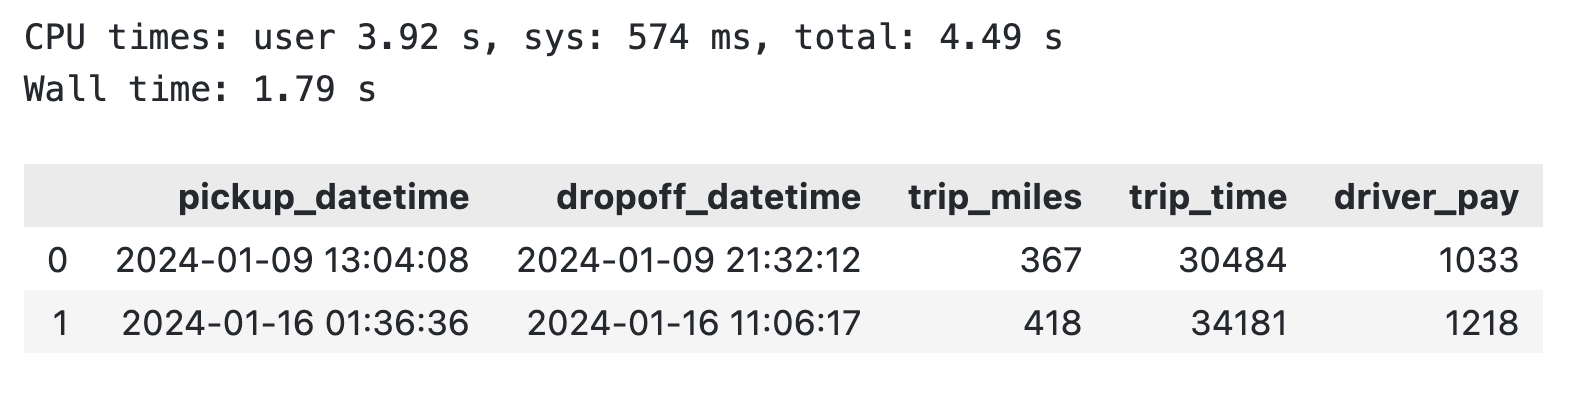
Consulta DuckDB em um DataFrame do pandas existente
Em resumo, você pode prescindir do pandas ou acelerar agregações em DataFrames existentes.
A seguir, mostro alguns recursos avançados do DuckDB.
Há muito mais no DuckDB do que parece à primeira vista.
Nesta seção, vou apresentar alguns recursos avançados do DuckDB que são essenciais para data engineers.
O DuckDB permite estender sua funcionalidade nativa com extensões core e da comunidade extensions. Eu uso extensões o tempo todo para conectar a sistemas de storage em nuvem e bancos de dados e para trabalhar com formatos adicionais de arquivos.
Você pode instalar extensões tanto pelo console do Python quanto pelo do DuckDB.
No snippet abaixo, mostro como instalar a extensão httpfs, necessária para conectar à AWS e ler dados do S3:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Você não verá saída se não encadear o método .df() ao conn.execute(). Se fizer isso, verá uma mensagem de “Success” ou “Error”.
Com frequência, sua empresa vai te dar acesso aos dados que precisam entrar no pipeline. Normalmente, eles ficam em plataformas escaláveis na nuvem, como AWS S3.
O DuckDB permite conectar ao S3 (e outras plataformas) diretamente.
Já mostrei como instalar a extensão (httpfs); agora basta configurá-la. A AWS exige informar região, access key e secret access key.
Supondo que você tenha tudo isso, rode o comando abaixo pelo Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Meu bucket S3 contém dois arquivos do dataset de táxis de Nova York:
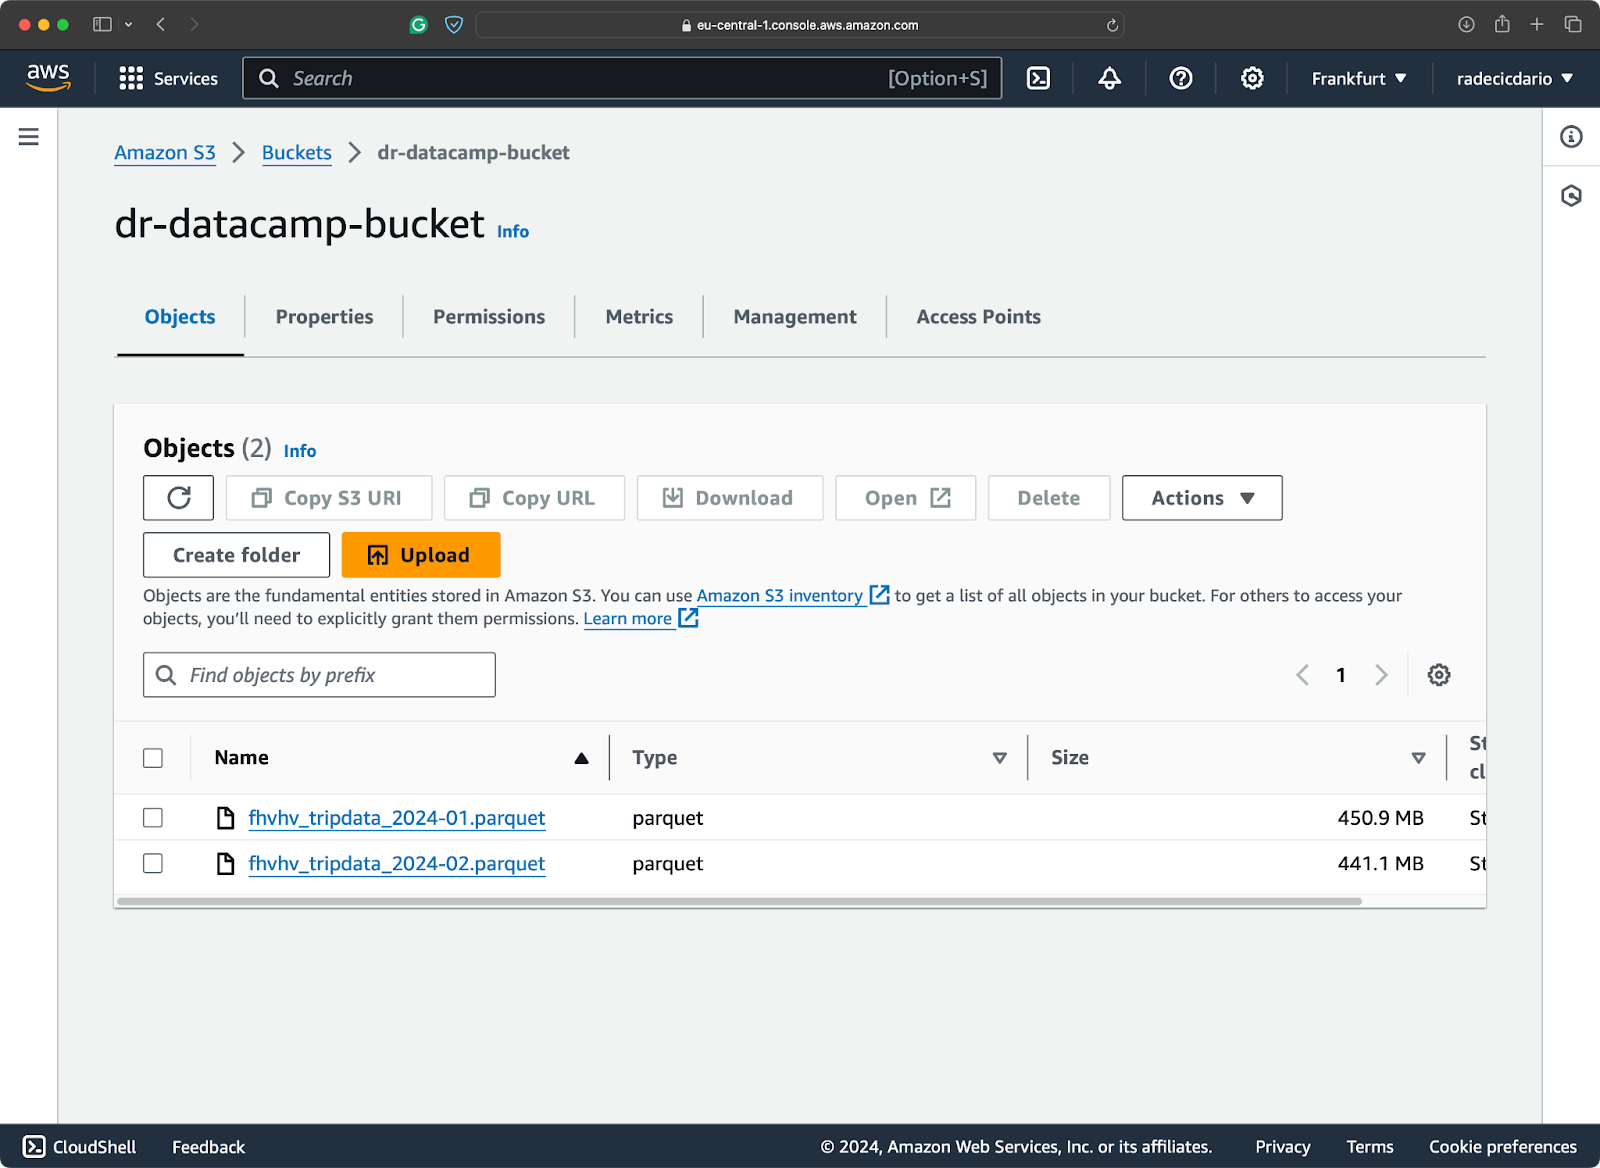
Conteúdo do bucket S3
Não é preciso baixar os arquivos — você pode escaneá-los direto do S3:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count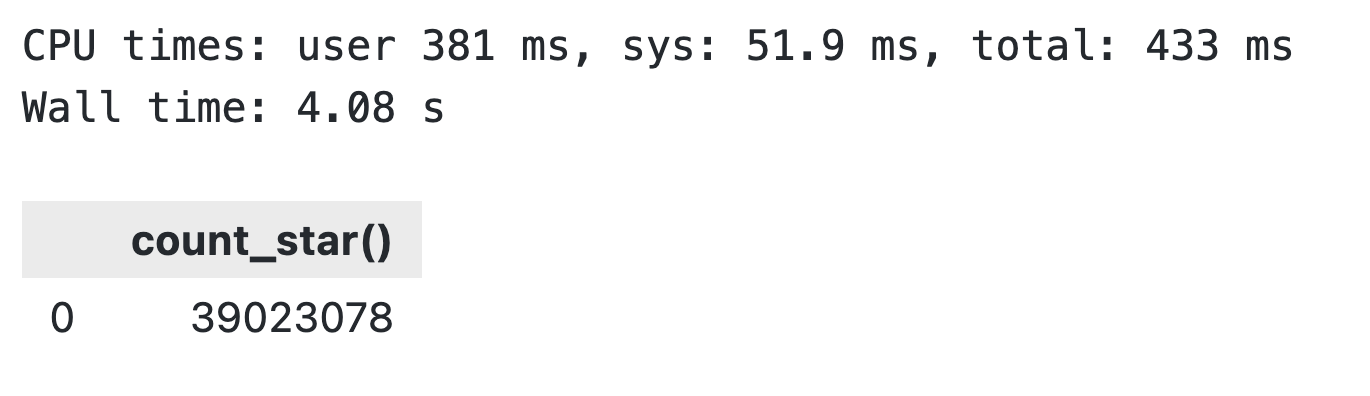
Resultados de leitura do S3 com DuckDB
Você leu certo: levou apenas 4 segundos para varrer ~900 MB de dados no bucket S3.
Falando de paralelismo, o DuckDB já implementa por padrão com base em row groups: partições horizontais típicas do Parquet. Um row group pode ter no máximo 122.880 linhas.
O paralelismo no DuckDB começa quando você trabalha com mais de 122.880 linhas.
O DuckDB vai lançar novas threads automaticamente nesse caso. Por padrão, o número de threads é igual ao número de núcleos da CPU. Ainda assim, você pode ajustar manualmente.
Aqui vou mostrar como fazer isso e o impacto de diferentes números de threads na mesma carga de trabalho.
Para ver o número atual de threads, rode:
SELECT current_setting('threads') AS threads;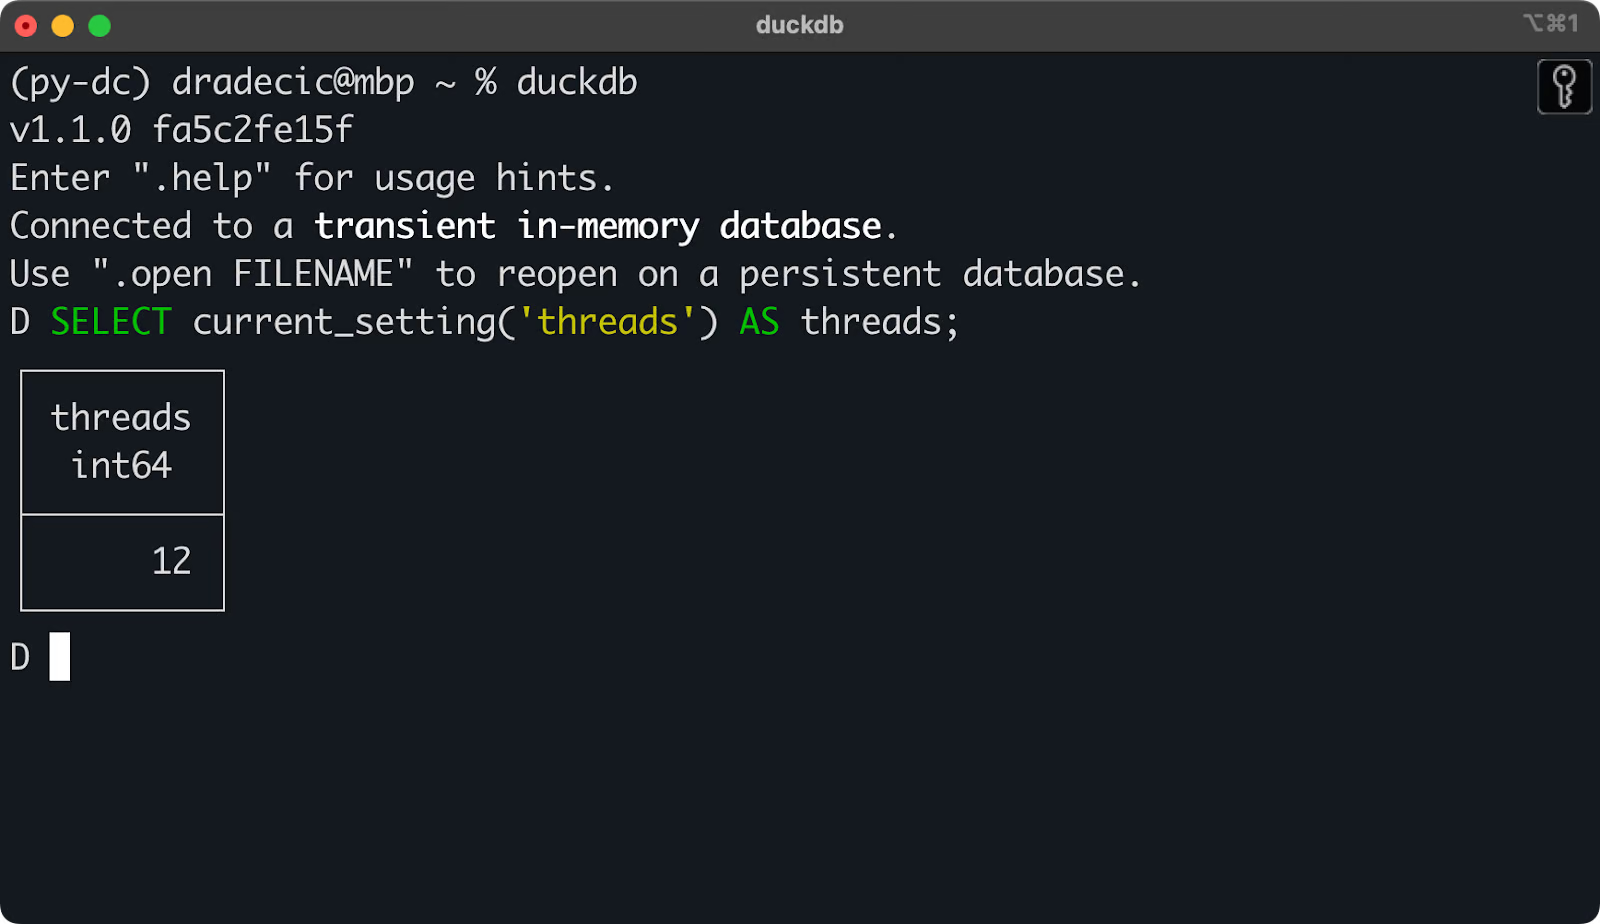
Número atual de threads usado pelo DuckDB
Você pode obter o mesmo resultado pelo Python.
Para mudar o número de threads, execute SET threads = N.
No snippet a seguir, implementei uma função Python que roda uma consulta DuckDB com um número definido de threads, converte para DataFrame do pandas e retorna o tempo de execução (entre outras infos). O código abaixo da função testa de 1 a 12 threads:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Você deve ver algo semelhante a isto:
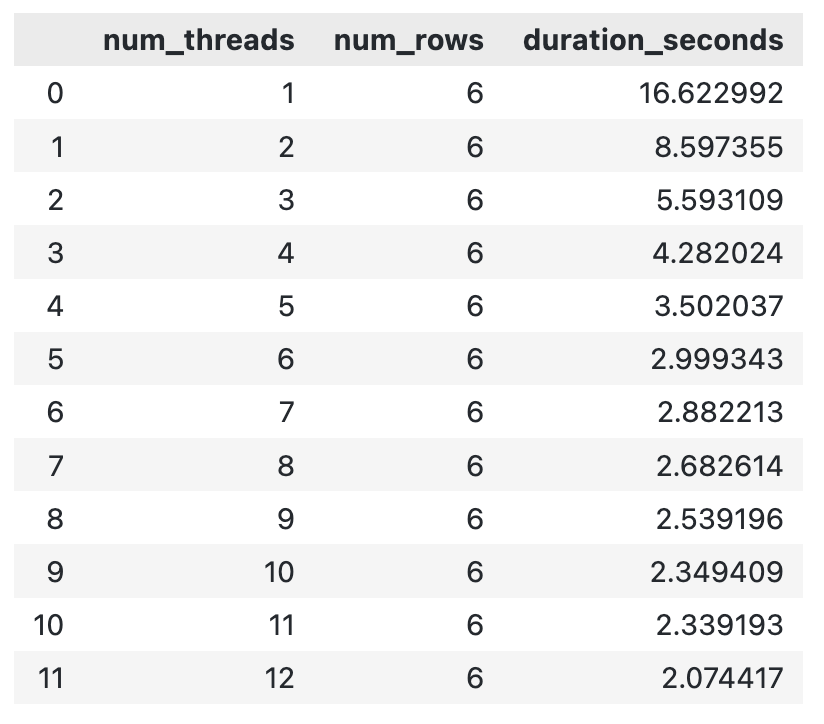
Tempo de execução do DuckDB com diferentes números de threads
Em geral, quanto mais threads você dedicar, mais rápido termina. Pode haver um ponto em que a sobrecarga de criar novas threads aumente o tempo total, mas eu não encontrei esse limite nesse intervalo.
Aqui vou mostrar como escrever um pipeline do zero. Bem simples: ler dados do disco, fazer agregações e salvar os resultados. A ideia é mostrar o ganho de performance ao trocar o pandas pelo DuckDB. De quebra, seu código também fica mais limpo.
Isto não é uma introdução completa a processos ETL/ELT, mas um panorama geral.
O pipeline que vou apresentar faz o seguinte:
Após rodar o código, você deve obter exatamente os mesmos resultados de agregação nas duas implementações (desconsiderando pequenas diferenças de arredondamento):
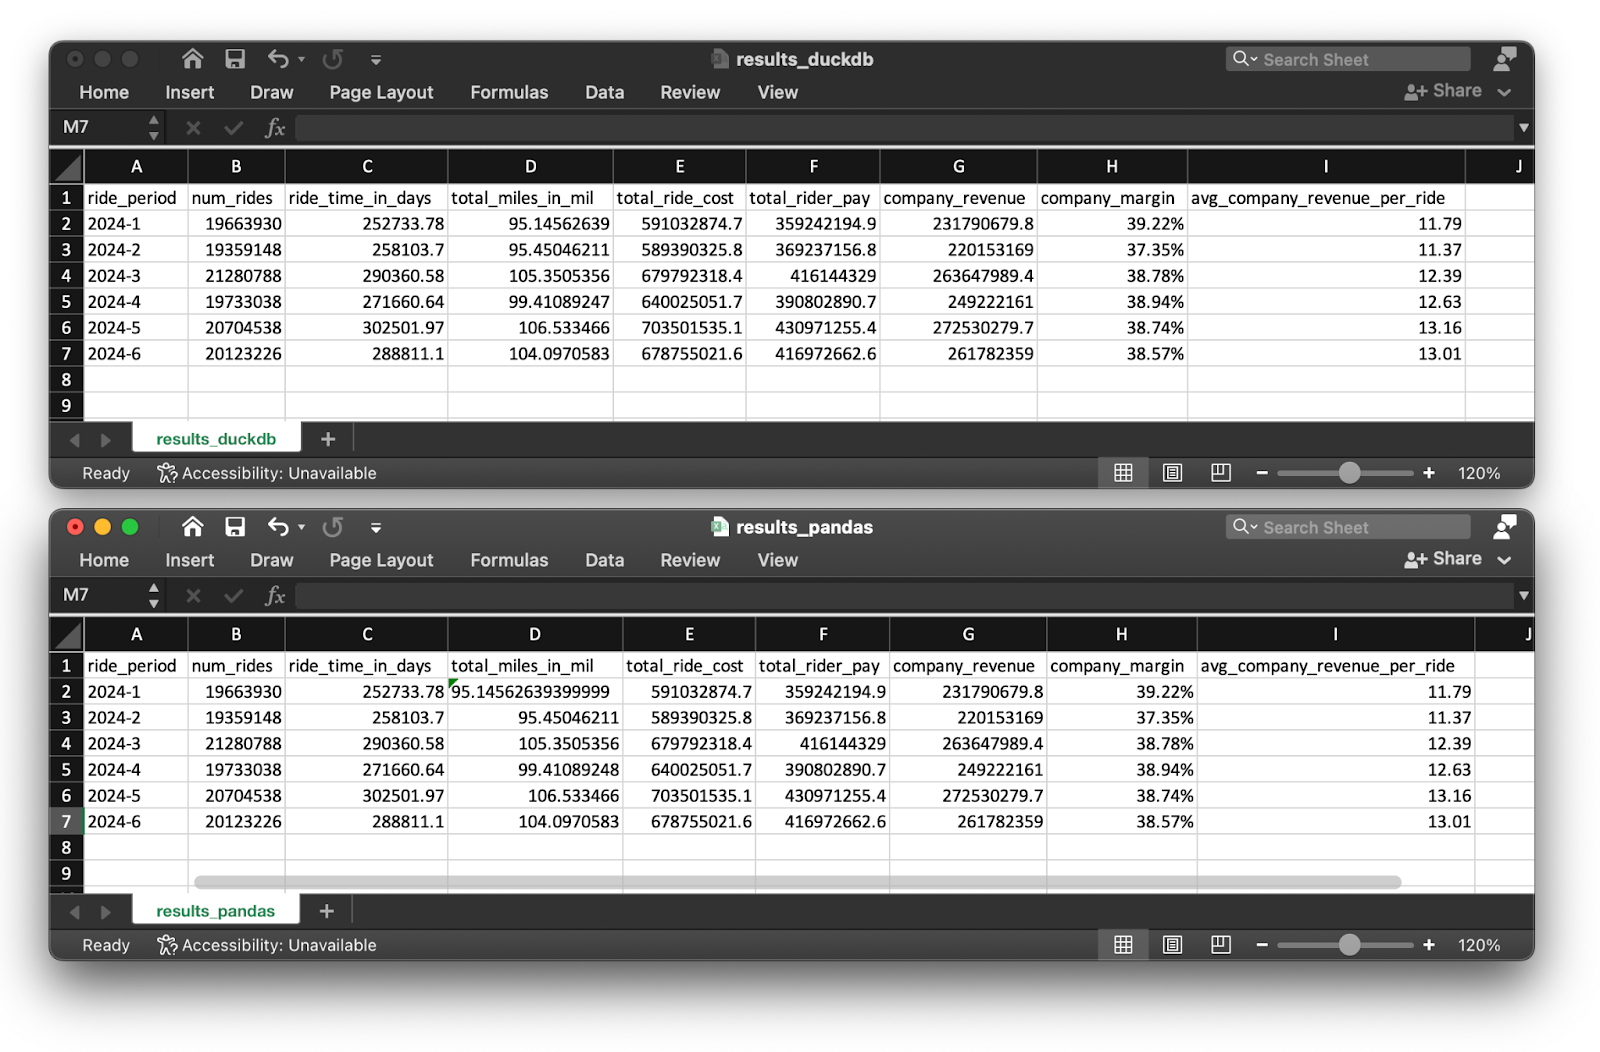
Resultados do pipeline com DuckDB e pandas
Primeiro, vamos ver a implementação em pandas.
Não importa o que eu tentasse, não consegui processar os 6 arquivos Parquet de uma vez. Mensagens como esta apareciam em segundos:
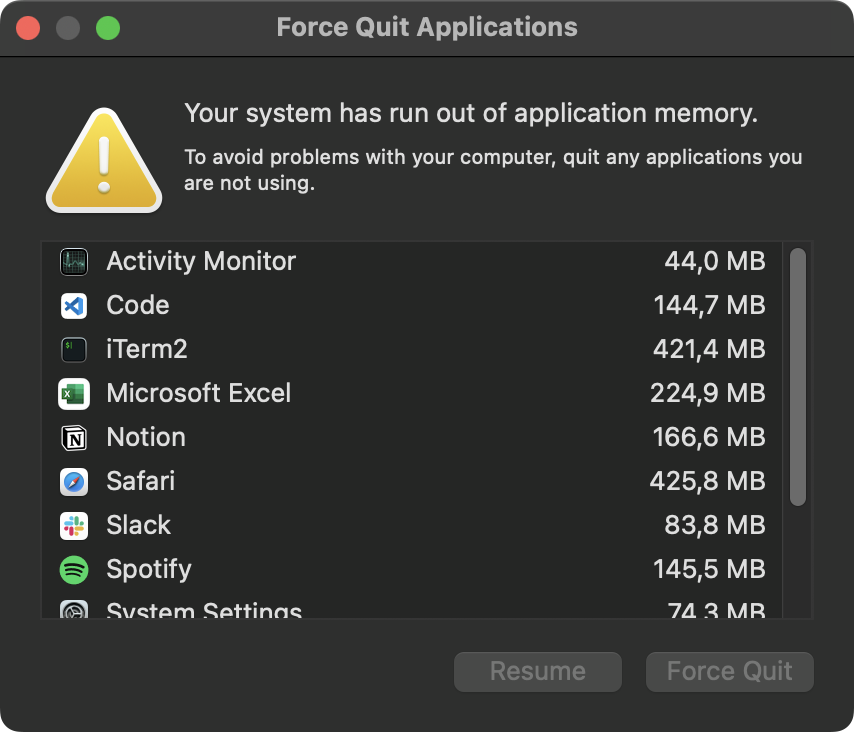
Erro de memória do sistema
Parece que 36 GB de memória não bastam para 120 milhões de linhas de uma vez. Resultado: o script Python foi encerrado à força:
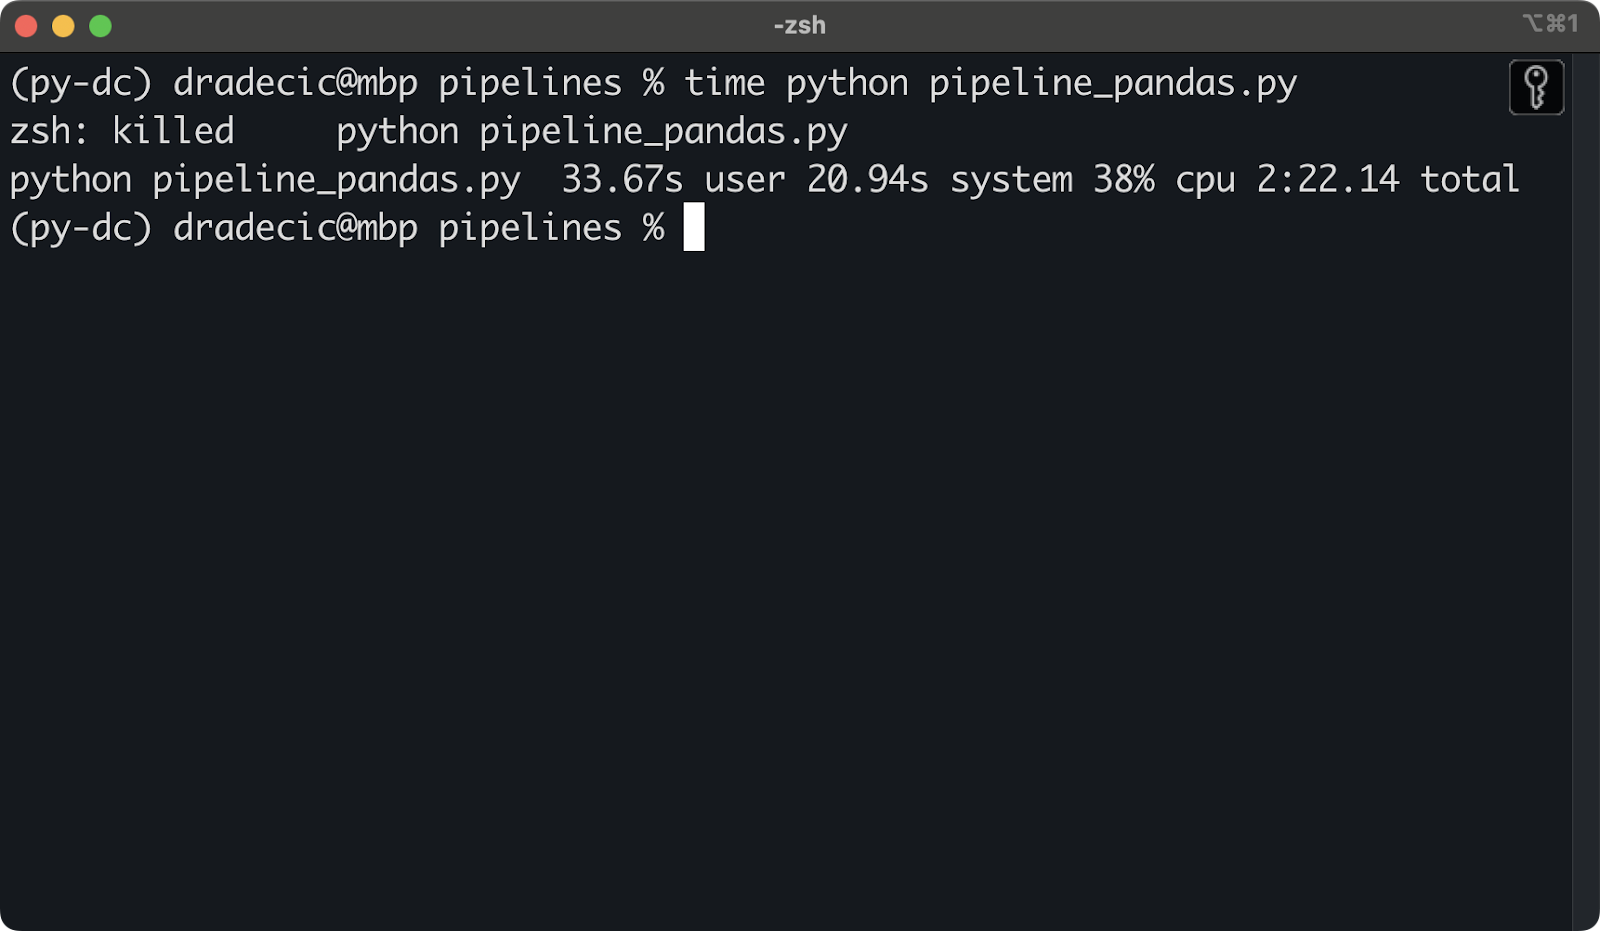
Script Python encerrado por falta de memória
Para contornar, tive que processar os arquivos Parquet sequencialmente. Este é o código que usei no pipeline:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
A implementação com DuckDB deve terminar sem problemas de memória.
Você já conhece a maior parte do código em DuckDB.
A única novidade é o SELECT do topo, que calcula algumas estatísticas adicionais. O resto permanece igual:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
A seguir, mostro as diferenças de tempo de execução.
Depois de rodar os dois pipelines 5 vezes e tirar a média, estes foram os tempos:
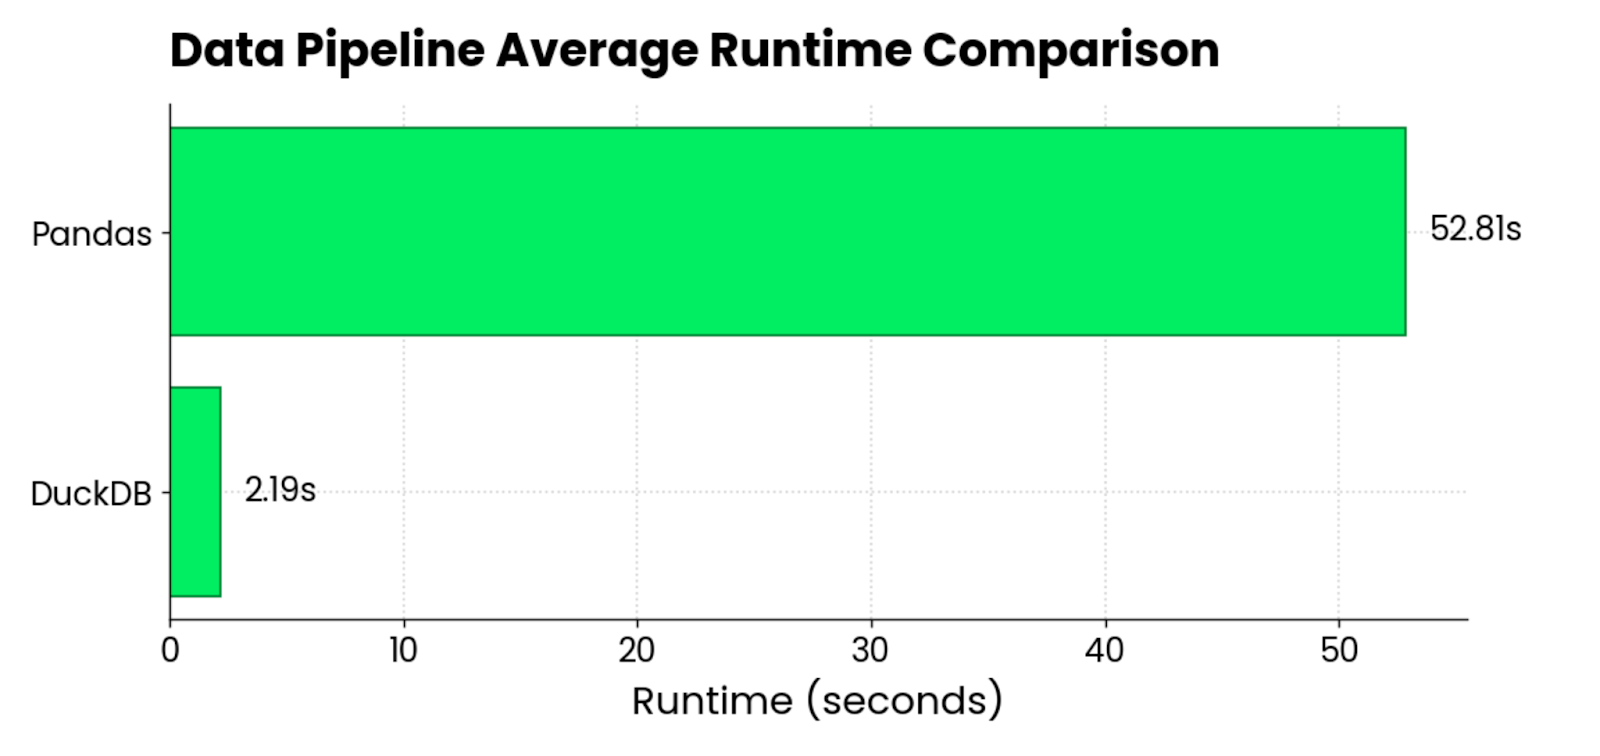
DuckDB vs. pandas — comparação de tempos
Em média, o pandas foi 24 vezes mais lento que o DuckDB ao carregar e processar cerca de 120 milhões de linhas (~3 GB) distribuídas em 6 arquivos Parquet.
A comparação não é 100% justa, já que não consegui processar todos os arquivos de uma vez no pandas. Ainda assim, os resultados são relevantes — você enfrentará dificuldades parecidas no trabalho.
Se uma biblioteca não entrega o que você precisa, tente outra. E, na maioria das vezes, a que vai terminar mais rápido é o DuckDB.
Antes de você explorar o DuckDB por conta própria, quero compartilhar algumas boas práticas gerais e específicas de data engineering:
SELECT. Evite usá-lo em fluxos que dependem de INSERT e UPDATE frequentes. Nesse caso, use SQLite em seu lugar.Para concluir, se você é data engineer responsável por construir e otimizar pipelines, deveria experimentar o DuckDB.
Você não tem nada a perder e muito a ganhar. A ferramenta tem uma grande chance de ser mais rápida do que qualquer alternativa em Python. Roda muito rápido no seu notebook e permite trabalhar com datasets que, de outra forma, gerariam erros de memória. E ainda se conecta a storages em nuvem quando você não quer ou não pode armazenar dados localmente.
Dito isso, o DuckDB não deve ser a única otimização que você leva para a mesa. Sempre busque otimizar os dados que entram no seu sistema. Por exemplo, trocar CSV por Parquet economiza tempo de computação e armazenamento. Outra frente é aplicar os princípios da arquitetura moderna de dados aos seus fluxos e pipelines.
DuckDB é só uma ferramenta. Mas uma ferramenta muito poderosa.
Nossos programas de certificação ajudam você a se destacar e a provar que suas habilidades estão prontas para o trabalho para possíveis empregadores.

Aprenda mais sobre data engineering com estes cursos!
Curso
Programa
Programa
blog
Kurtis Pykes
7 min
blog
Tutorial
Abid Ali Awan
13 min
Tutorial
Joleen Bothma
9 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
10 min