Cursus
Data Engineering begrijpen
2 uur
377.9K
Zoals gezegd draait DuckDB gewoon op je laptop. De eerste stap is het installeren.
Ik laat je de installatiestappen voor macOS zien, maar de instructies voor Windows en Linux zijn duidelijk en makkelijk te volgen.
Heb je een Mac, dan is de makkelijkste manier om DuckDB te installeren via Homebrew. Voer de volgende shellopdracht uit:
brew install duckdbBinnen een paar seconden zie je ongeveer dit als output:
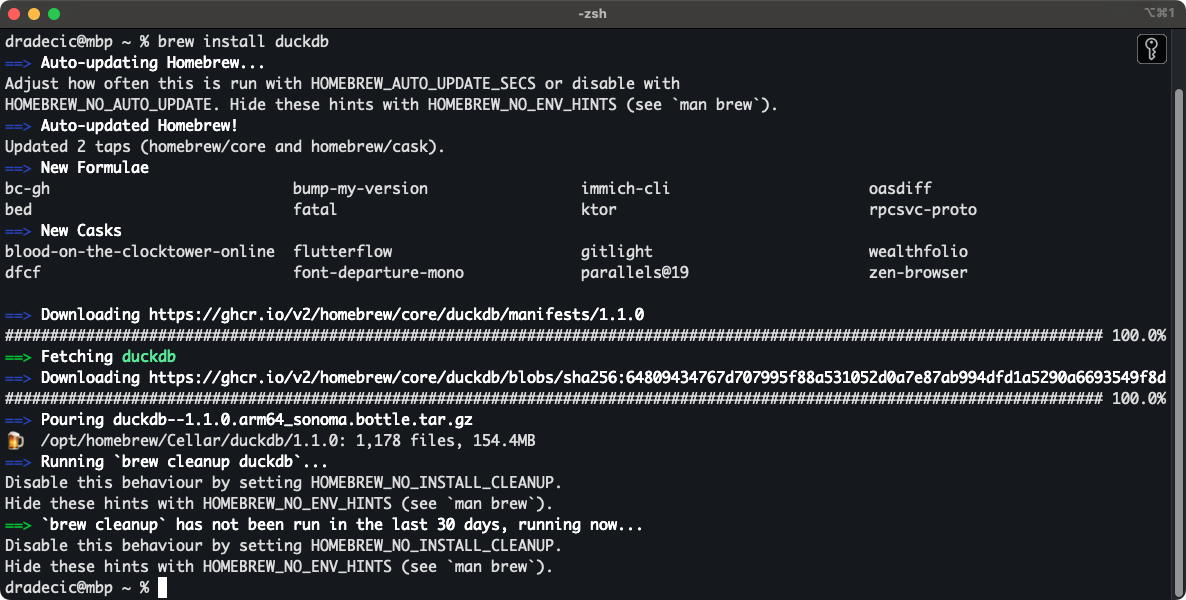
DuckDB installeren met Homebrew
Na installatie kun je de DuckDB-shell openen met de volgende opdracht:
duckdb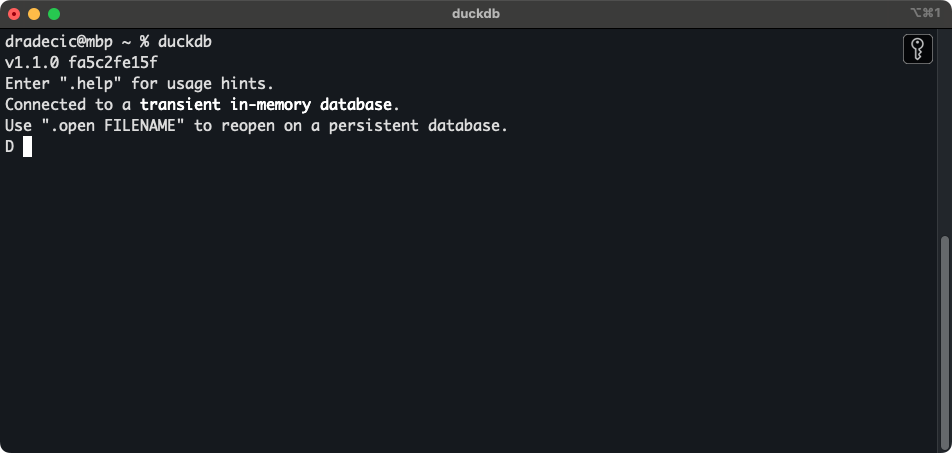
DuckDB-shell
Vanaf hier ligt de wereld aan je voeten!
Je kunt direct vanuit de console SQL-queries schrijven en draaien. Ik heb bijvoorbeeld de eerste 6 maanden van de NYC Taxi Data voor 2024 gedownload. Als jij dat ook hebt gedaan, gebruik dan het volgende fragment om het aantal rijen van een enkele Parquet-file te tonen:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");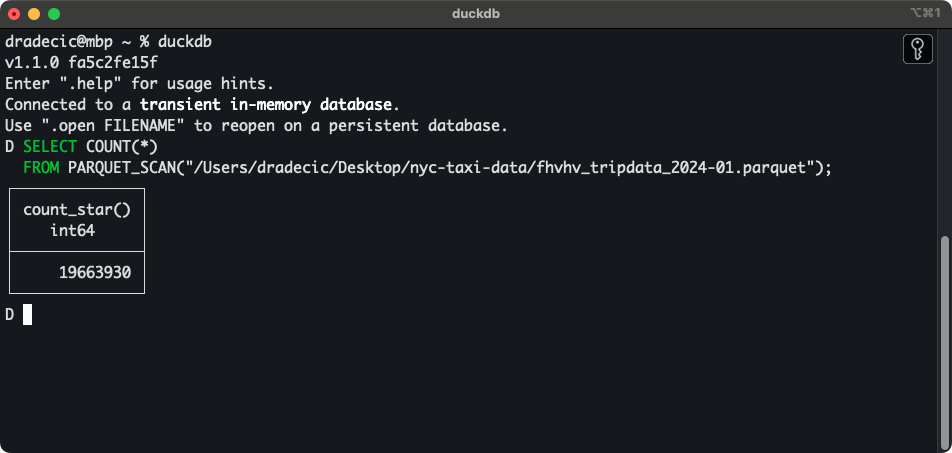
Rijtellingen voor een enkele Parquet-file
Yep - dat zijn bijna 20 miljoen rijen uit een enkel bestand. Ik heb er 24 gedownload.
Waarschijnlijk wil je DuckDB niet vanuit de terminal draaien, dus laat ik je hierna zien hoe je DuckDB aan Python koppelt.
Het doel van deze sectie is om te laten zien hoe je DuckDB configureert en draait in de populairste taal voor data engineering: Python.
DataCamp biedt zelfs een complete carrièretrack in data engineering in Python.
Python heeft een specifieke DuckDB-bibliotheek die je eerst moet installeren. Voer het volgende uit in de terminal, bij voorkeur in een virtuele omgeving:
pip install duckdbMaak nu een nieuw Python-bestand en plak de volgende code:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Kort gezegd: het codefragment bevat een functie die het aantal rijen uit een enkel bestand ophaalt, gegeven een geldige DuckDB-verbinding en een bestandspad.
Na het draaien van het script krijg je vrijwel direct de volgende output terug:
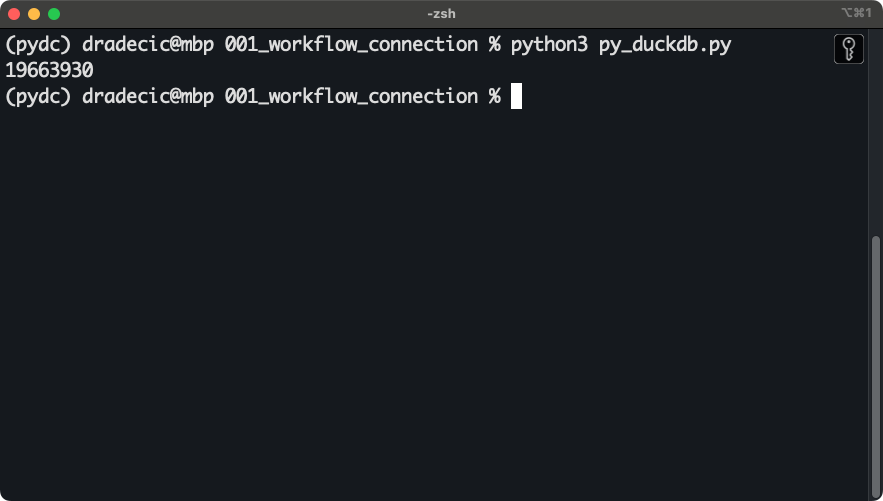
DuckDB- en Python-verbinding
Dat is alles!
Straks laat ik je zien hoe je met Python en DuckDB bliksemsnel geweldige dingen doet!
Ter referentie draai ik de code op het 2024-deel (januari - juni) van de NYC Taxi Dataset - specifiek voor high-volume for-hire voertuigen. Dat zijn 6 Parquet-bestanden, goed voor ongeveer 3GB schijfruimte. Qua hardware gebruik ik een M3 Pro MacBook Pro 16” met 12 CPU-cores en 36GB unified memory.
Jouw resultaten kunnen variëren, maar je zou nog steeds vergelijkbare cijfers moeten zien.
Ik heb deze 6 bestanden naar twee extra formaten geconverteerd - CSV en JSON. Je ziet hoeveel schijfruimte elk ervan inneemt:
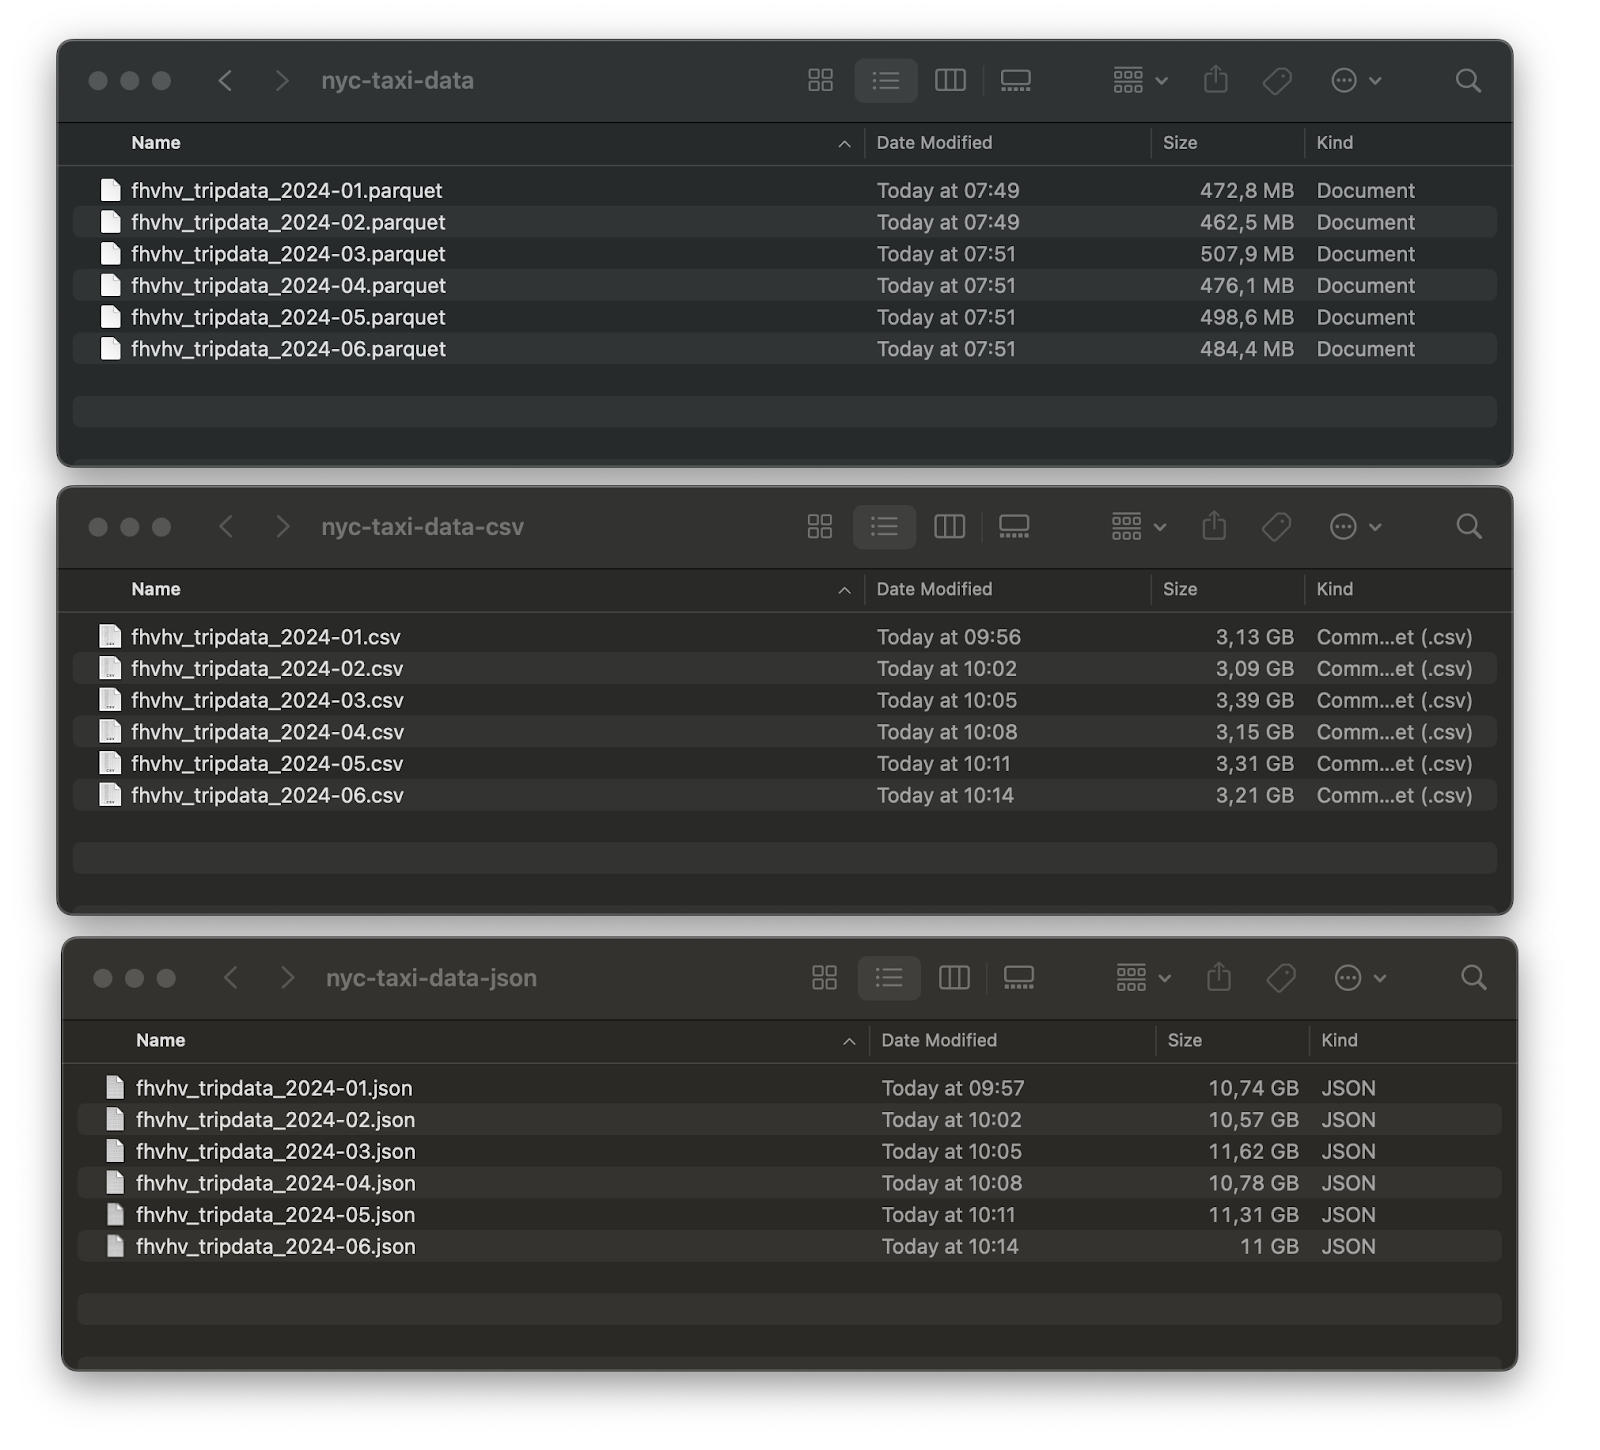
Vergelijking datasetgrootte
Totaal: 2,96GB voor Parquet, 19,31GB voor CSV en 66,04GB voor JSON.
Groot verschil! Als je verder niks meeneemt uit dit artikel, onthoud dan in elk geval om bij grote bestanden altijd het Parquet-bestandsformaat te gebruiken. Dat bespaart je zowel verwerkingstijd als schijfruimte.
DuckDB heeft handige functies die meerdere bestanden van hetzelfde formaat tegelijk kunnen lezen (met een globpatroon). Ik gebruik die om alle zes te lezen, het aantal rijen op te halen en de runtime te vergelijken:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
De resultaten zijn binnen - er is maar één duidelijke winnaar:
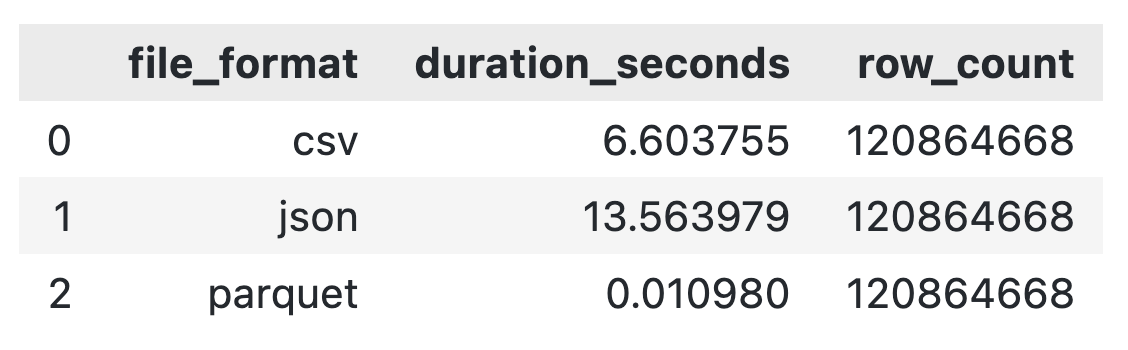
Vergelijking leestijden van bestanden
Dankzij DuckDB zijn alle drie snel en kom je op hetzelfde punt uit, maar het is duidelijk dat Parquet wint met een factor 600 vergeleken met CSV en een factor 1200 vergeleken met JSON.
Daarom gebruik ik voor de rest van het artikel alleen Parquet.
Met DuckDB kun je data aggregeren via SQL.
Mijn doel hier is om daarop voort te bouwen. Concreter: ik laat je zien hoe je maandelijkse samenvattende statistieken berekent met informatie over het aantal ritten, ritduur, afstand, ritkosten en chauffeurspay—allemaal op basis van 120 miljoen rijen aan data.
Het beste: het kost maar twee seconden!
Dit is de code die ik in een Python-script gebruikte om te aggregeren en de resultaten te printen:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
De output bevat de aggregatieresultaten, het variabeletype van results en de totale runtime:
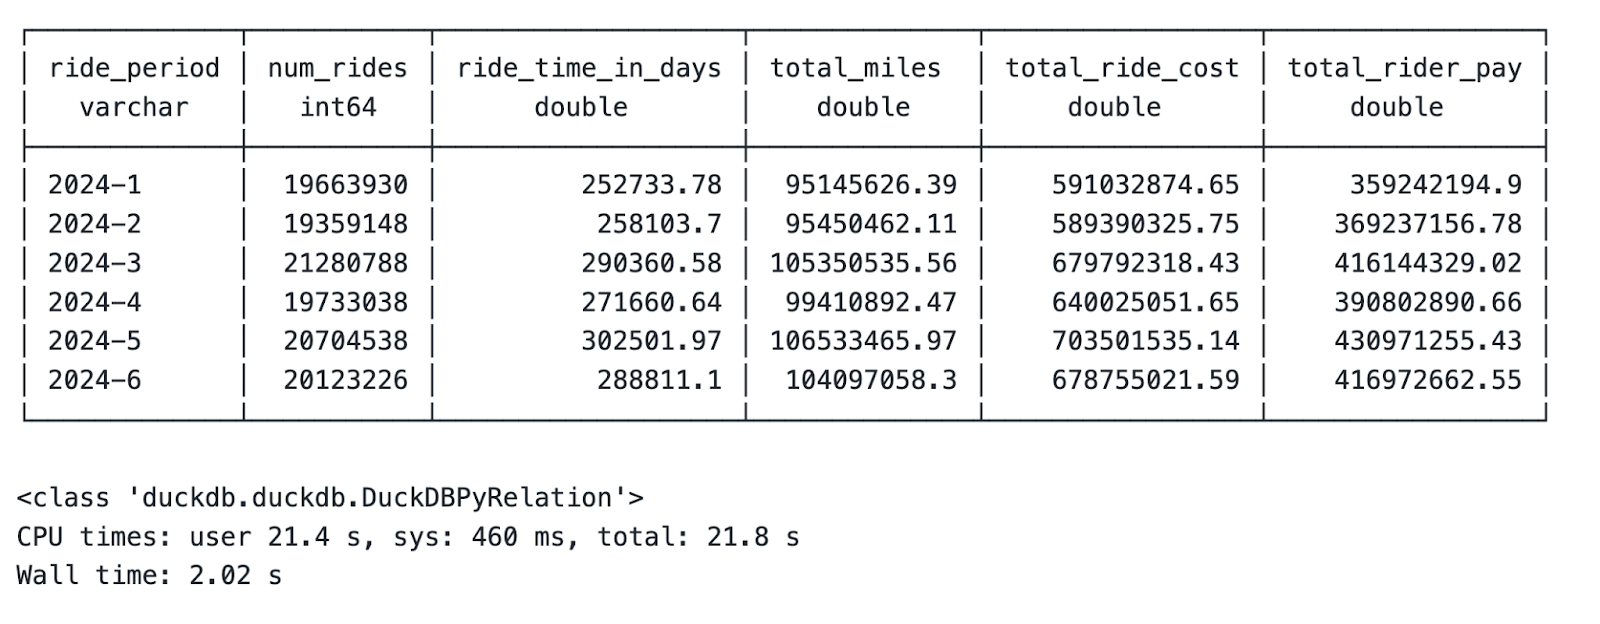
Aggregatie maandelijkse samenvattende statistieken
Laat het even inzinken: dat is 3GB aan data over 120 miljoen rijen, geaggregeerd in 2 seconden op een laptop!
Het enige probleem is dat het variabeletype op de lange termijn onhandig is. Gelukkig is er een makkelijke oplossing.
Het voordeel van DuckDB is niet alleen de snelheid, maar ook de goede integratie met je favoriete dataframe-bibliotheek: pandas.
Heb je een tijdelijke resultset zoals hierboven, dan hoef je alleen de methode .df() aan te roepen om deze om te zetten naar een pandas-DataFrame:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df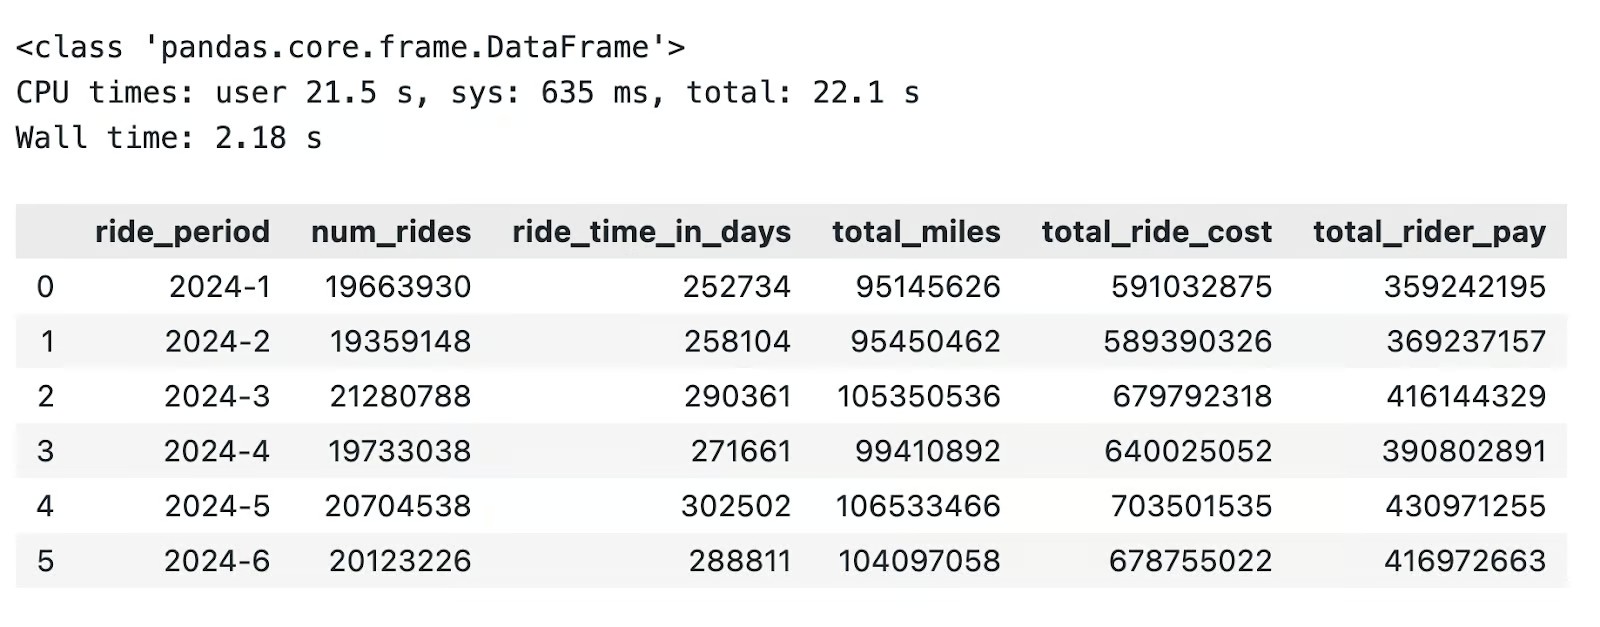
Conversie van DuckDB naar pandas
Op dezelfde manier kun je DuckDB gebruiken om berekeningen uit te voeren op pandas-DataFrames die al in het geheugen geladen zijn.
De truc is de variabelenaam te refereren na het FROM-keyword in een DuckDB-SQL-query. Hier is een voorbeeld:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res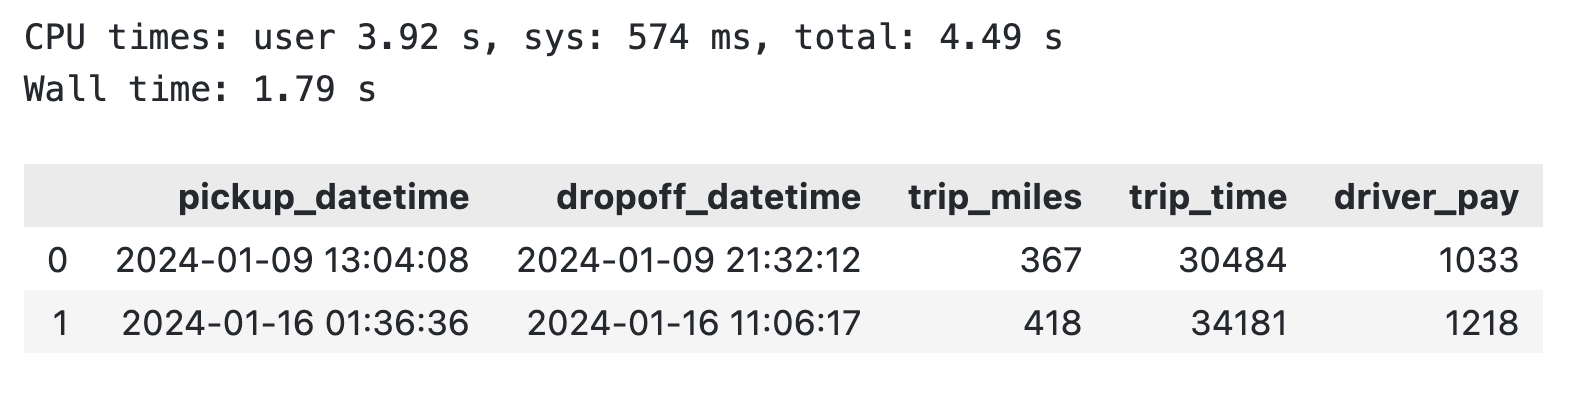
DuckDB-query op een bestaand pandas-DataFrame
Kortom, je kunt pandas helemaal vermijden of sneller aggregaties uitvoeren op bestaande pandas-DataFrames.
Hierna laat ik een paar geavanceerde DuckDB-features zien.
DuckDB heeft meer in huis dan je op het eerste gezicht denkt.
In deze sectie neem ik je mee langs een paar geavanceerde DuckDB-features die essentieel zijn voor data engineers.
Met DuckDB kun je de native functionaliteit uitbreiden via core- en community-extensies. Ik gebruik extensies vaak om te verbinden met cloudopslagsystemen en databases en om met extra bestandsformaten te werken.
Je kunt extensies installeren via zowel de Python- als de DuckDB-console.
In onderstaand codefragment laat ik zien hoe je de extensie httpfs installeert die nodig is om met AWS te verbinden en S3-data te lezen:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Je ziet geen output als je de methode .df() niet koppelt aan conn.execute(). Doe je dat wel, dan zie je een “Success”- of “Error”-bericht.
Vaak krijg je van je bedrijf toegang tot data die je in je pijplijnen moet opnemen. Die staan meestal op schaalbare cloudplatforms, zoals AWS S3.
DuckDB laat je rechtstreeks verbinden met S3 (en andere platforms).
Ik heb je al laten zien hoe je de extensie (httpfs) installeert; het enige wat nog rest is de configuratie. AWS vereist dat je informatie opgeeft over je regio, access key en secret access key.
Stel dat je die allemaal hebt, voer dan de volgende opdracht uit via Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Mijn S3-bucket bevat twee van de bestanden uit de New York Taxi-dataset:
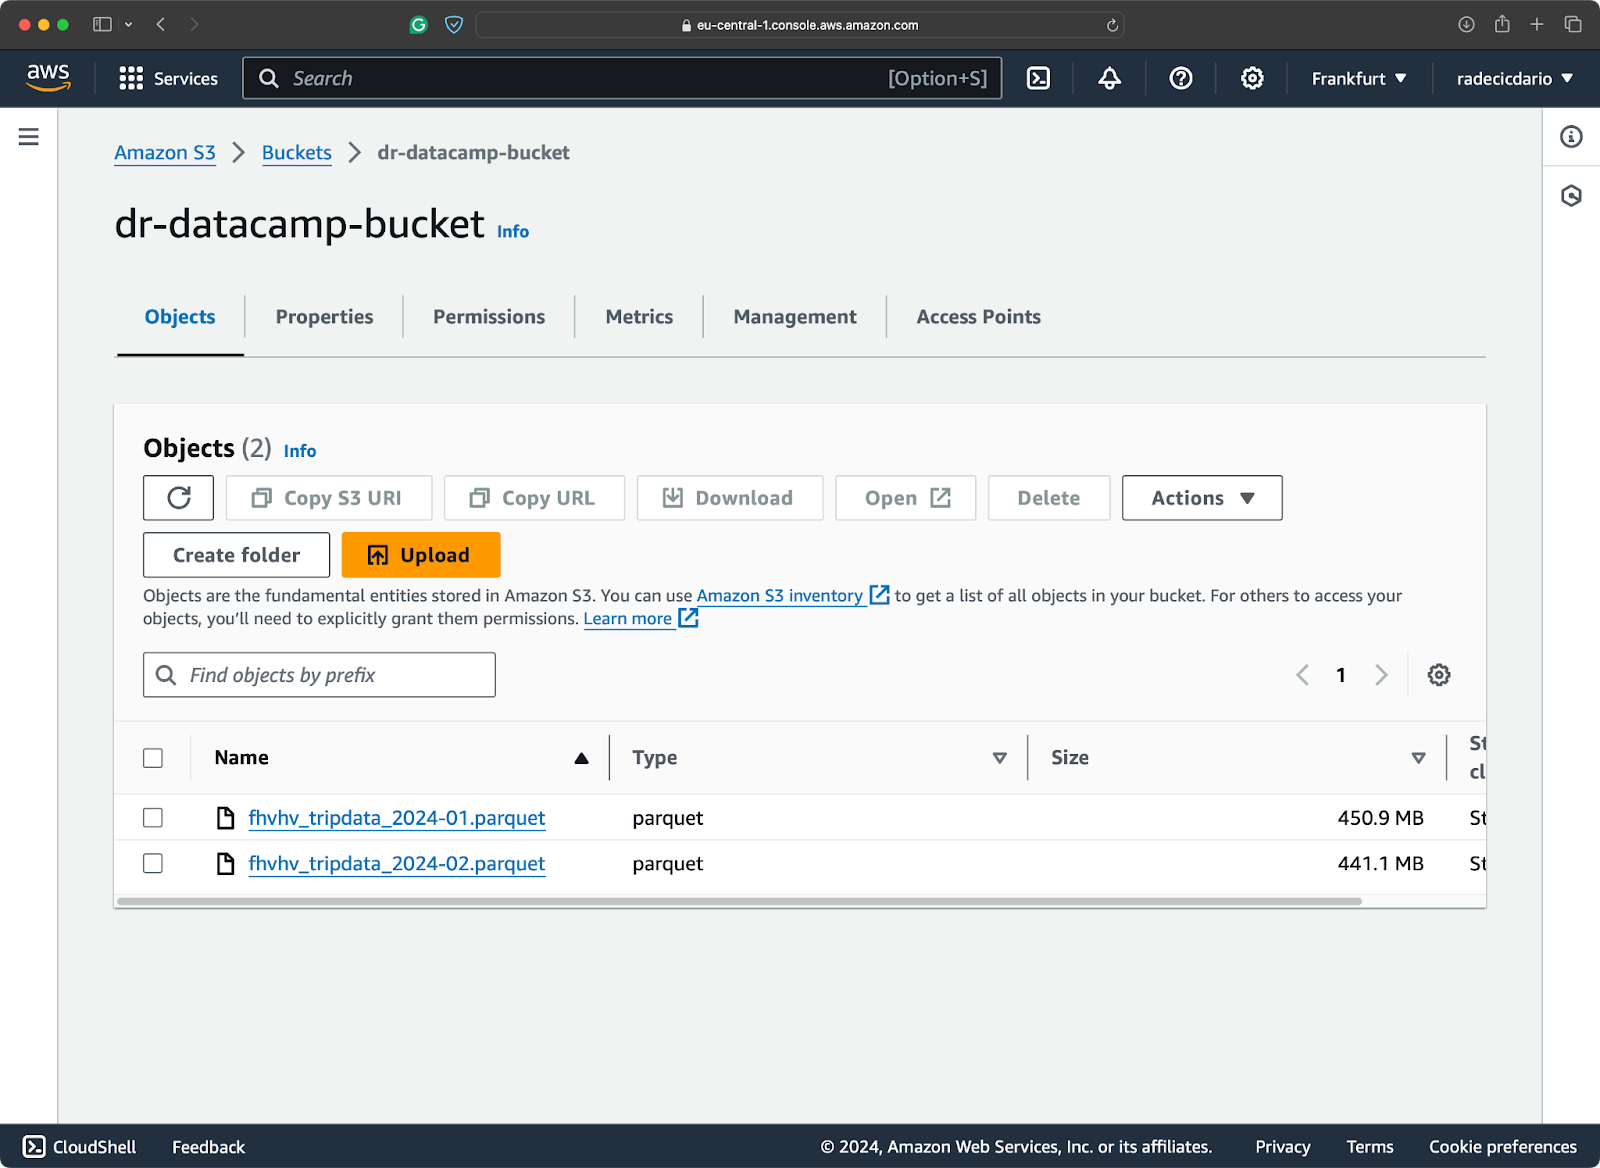
Inhoud S3-bucket
Je hoeft de bestanden niet te downloaden, want je kunt ze rechtstreeks vanuit S3 scannen:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count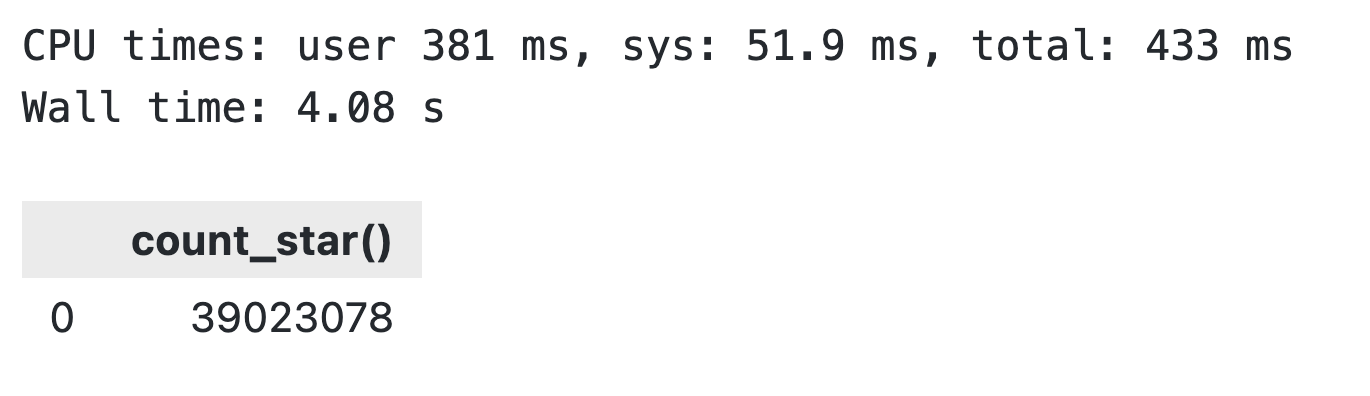
DuckDB S3-resultaten ophalen
Je leest het goed: het kostte slechts 4 seconden om ~ 900MB aan data in een S3-bucket door te nemen.
Wat parallelisatie betreft, implementeert DuckDB dit standaard op basis van row groups: horizontale datapartities die je typisch in Parquet vindt. Een enkele row group kan maximaal 122.880 rijen bevatten.
Parallelisme in DuckDB start zodra je met meer dan 122.880 rijen werkt.
DuckDB zal dan automatisch nieuwe threads starten. Standaard staat het aantal threads gelijk aan het aantal CPU-cores. Maar je kunt zelf ook spelen met het aantal threads.
In deze sectie laat ik zien hoe je dat doet en wat het effect is van een ander aantal threads op een identieke workload.
Om het huidige aantal threads te bekijken, voer je het volgende uit:
SELECT current_setting('threads') AS threads;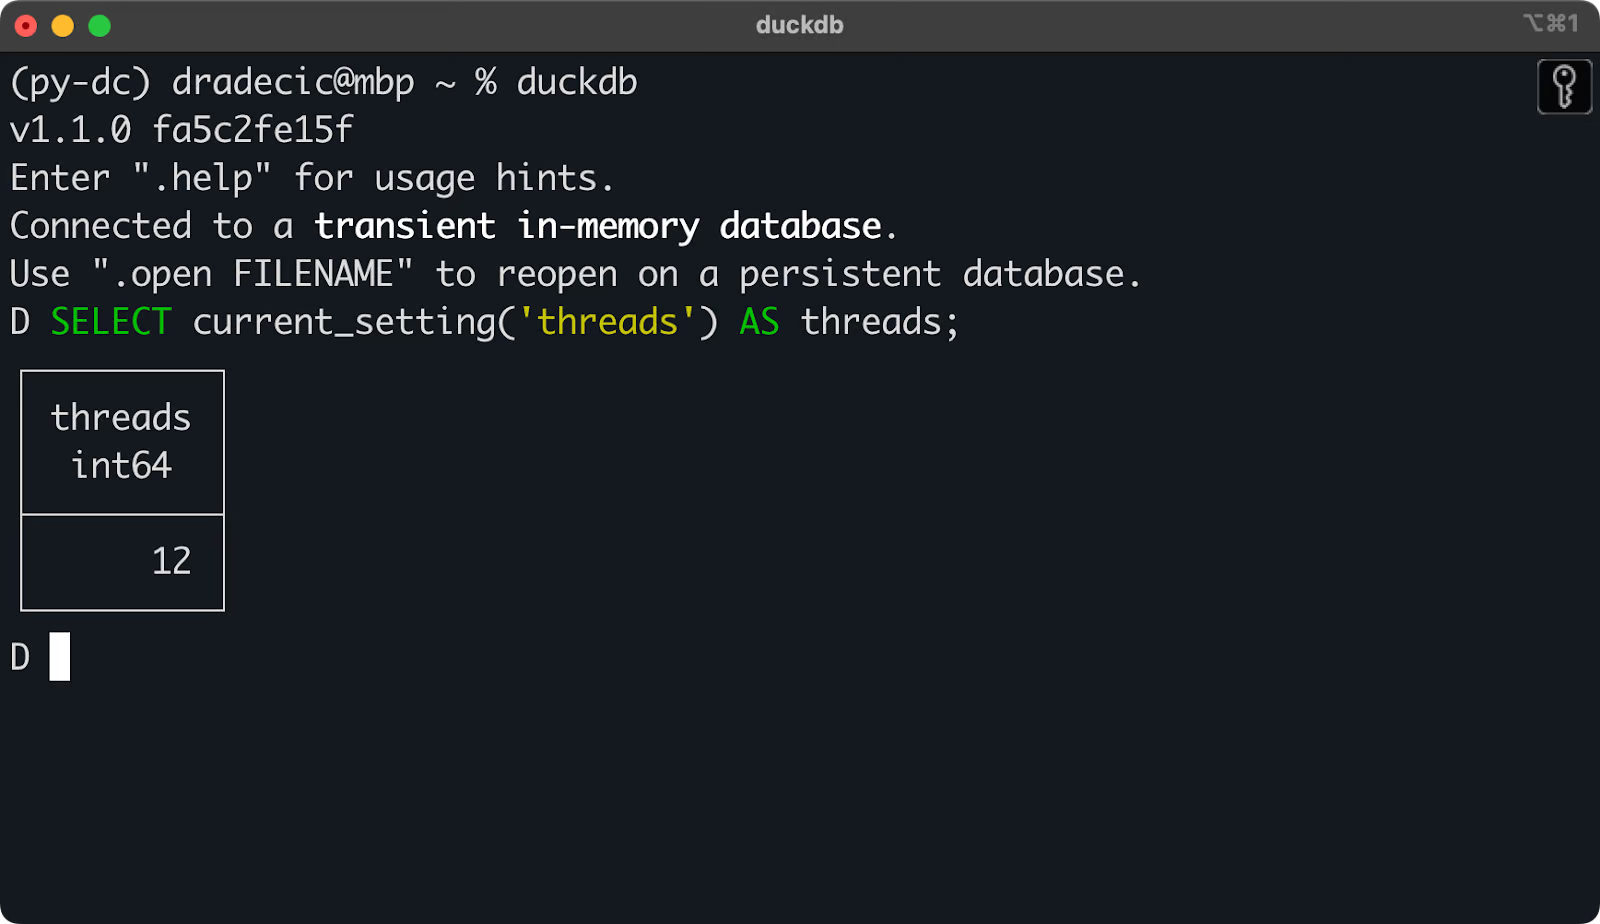
Het huidige aantal threads dat DuckDB gebruikt
Je kunt dezelfde resultaten ook via Python krijgen.
Je wilt het commando SET threads = N draaien om het aantal threads te wijzigen.
In het onderstaande fragment laat ik zien hoe je een eigen Python-functie bouwt die een DuckDB-query draait op een opgegeven aantal threads, deze omzet naar een pandas-DataFrame en de runtime teruggeeft (naast andere zaken). De code onder de functie draait deze in het bereik [1, 12] threads:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Je zou een vergelijkbare output moeten zien als ik:
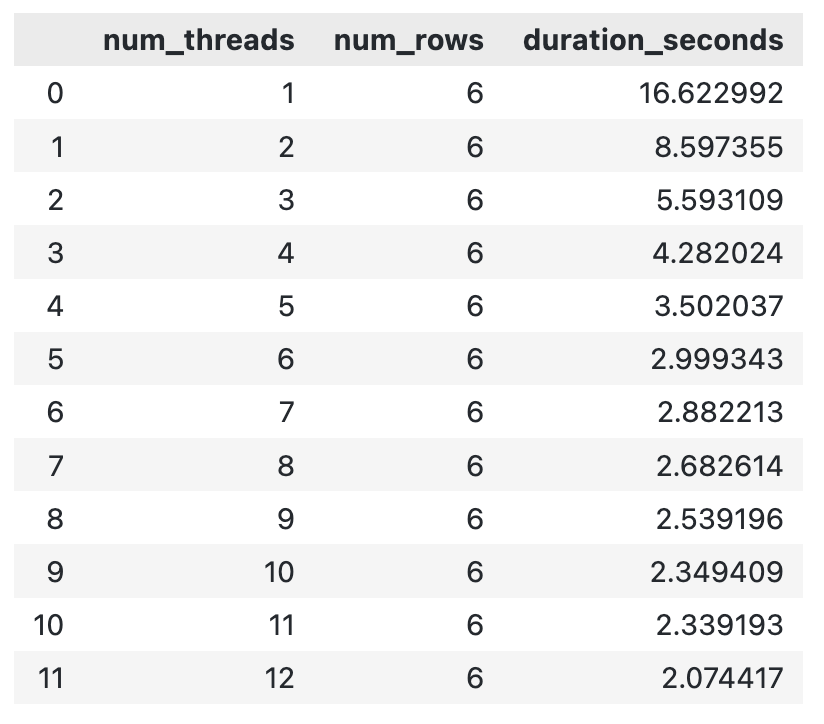
DuckDB-runtime voor verschillend aantal threads
In het algemeen geldt: hoe meer threads je op een berekening zet, hoe sneller deze klaar is. Er kan een punt zijn waarop de overhead van het aanmaken van een nieuwe thread leidt tot een toename van de totale runtime, maar binnen dit bereik kwam ik dat niet tegen.
In deze sectie laat ik je zien hoe je vanaf nul een datapijplijn schrijft. Die blijft relatief simpel: data lezen van schijf, aggregaties uitvoeren en de resultaten wegschrijven. Mijn doel is te laten zien hoeveel performance je wint door over te stappen van pandas naar DuckDB. Bovendien ziet je code er ook schoner uit.
Dit is geen uitgebreide introductie tot ETL/ELT-processen, maar een high-level overzicht.
De pijplijn die ik je zo laat zien doet het volgende:
Na het draaien van de code moet je voor beide implementaties exact dezelfde aggregatieresultaten krijgen (los van wat afrondingsverschillen):
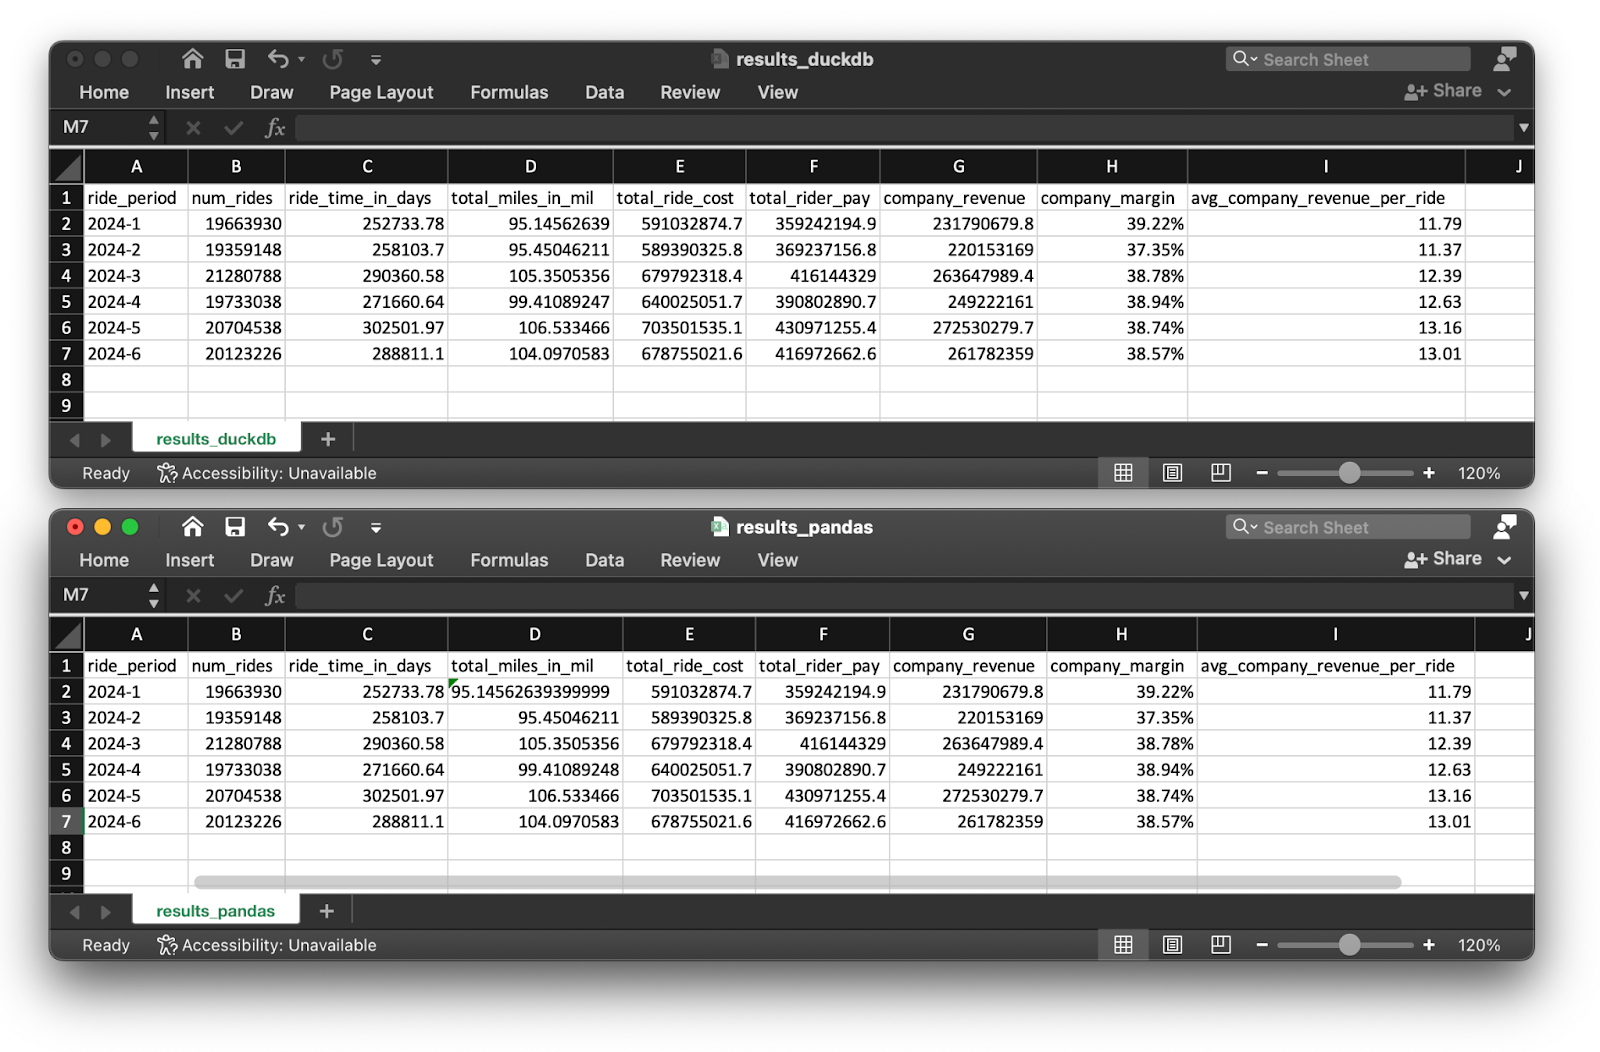
Pijplijnresultaten voor DuckDB en pandas
Laten we eerst de implementatie in pandas doornemen.
Wat ik ook probeerde, ik kon niet alle 6 Parquet-bestanden in één keer verwerken. Binnen een paar seconden verschenen systeemwaarschuwingen als deze:
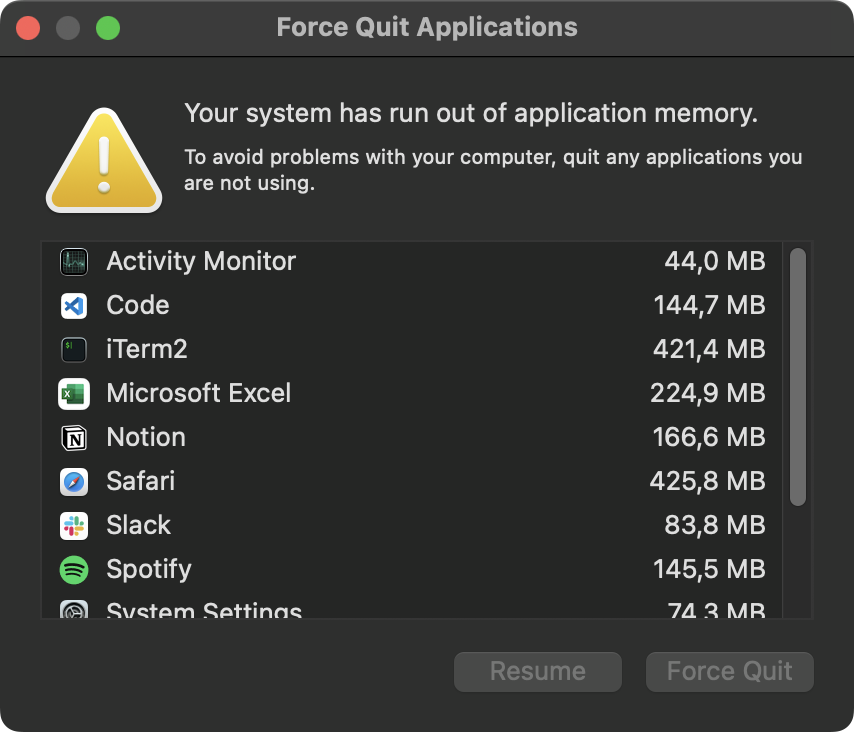
Systeemgeheugenfout
Blijkbaar is 36GB geheugen niet genoeg om 120 miljoen rijen in één keer te verwerken. Het Python-script werd daarom afgebroken:
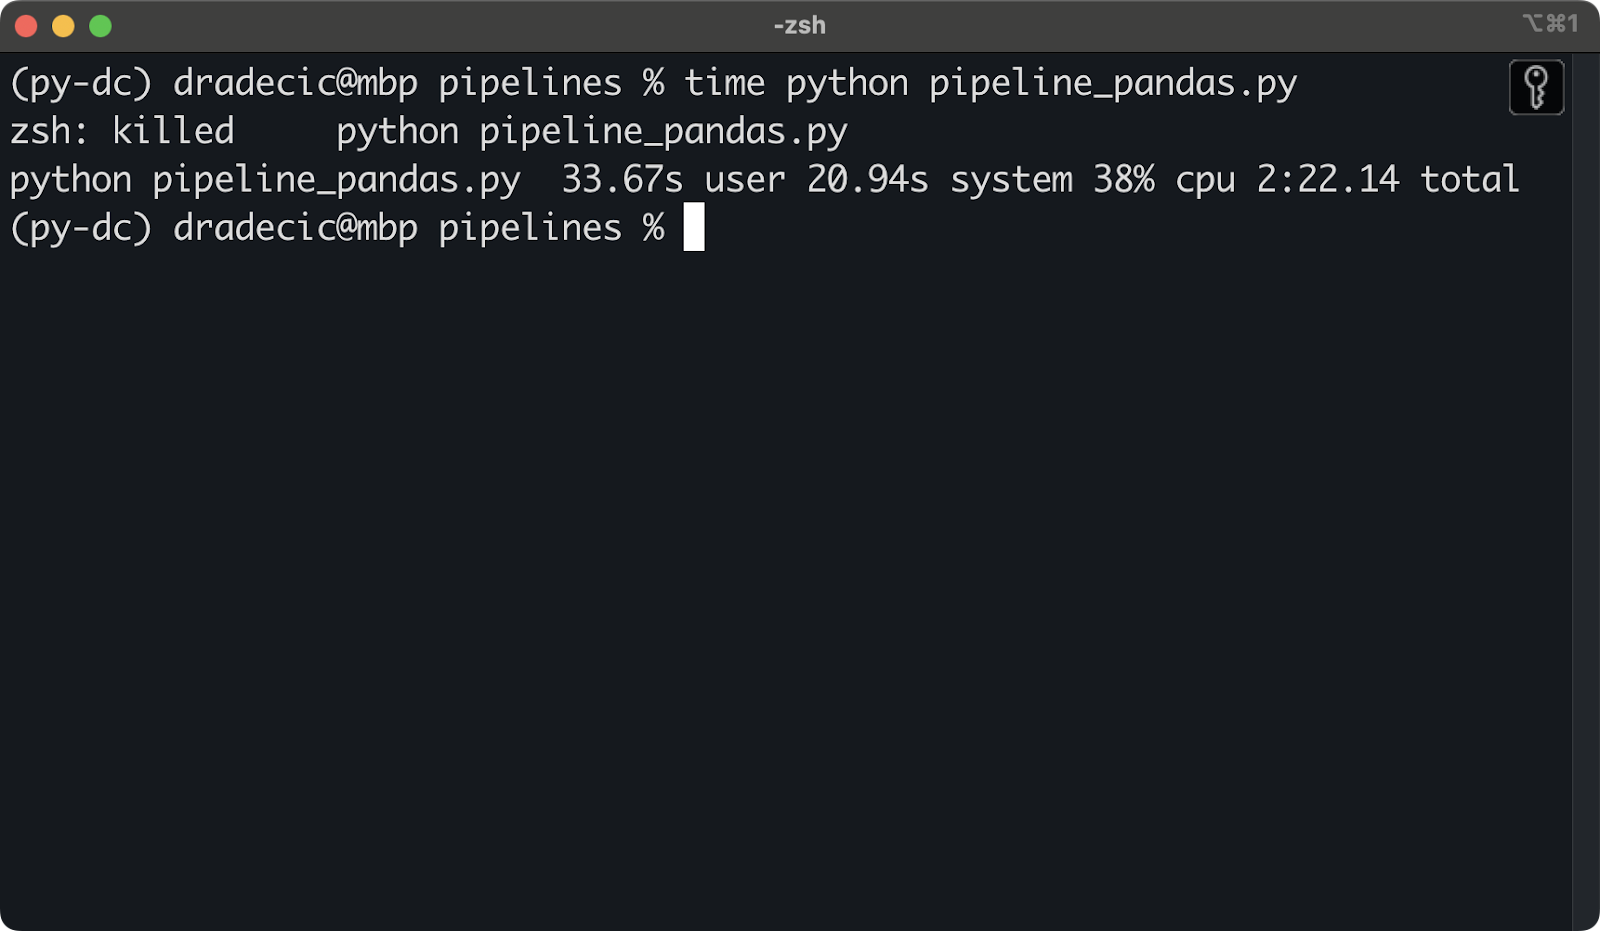
Python-script beëindigd wegens onvoldoende geheugen
Om dit te omzeilen moest ik Parquet-bestanden sequentieel verwerken. Dit is de code die ik gebruikte voor de pijplijn:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
De implementatie in DuckDB zou hopelijk zonder geheugenproblemen afronden.
Met het grootste deel van de DuckDB-code ben je al bekend.
Nieuw is alleen de bovenste SELECT, die een paar extra statistieken berekent. De rest heb ik ongewijzigd gelaten:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Hierna laat ik de verschillen in runtime zien.
Na beide pijplijnen 5 keer te hebben gedraaid en de resultaten gemiddeld te hebben, kreeg ik deze runtimes:
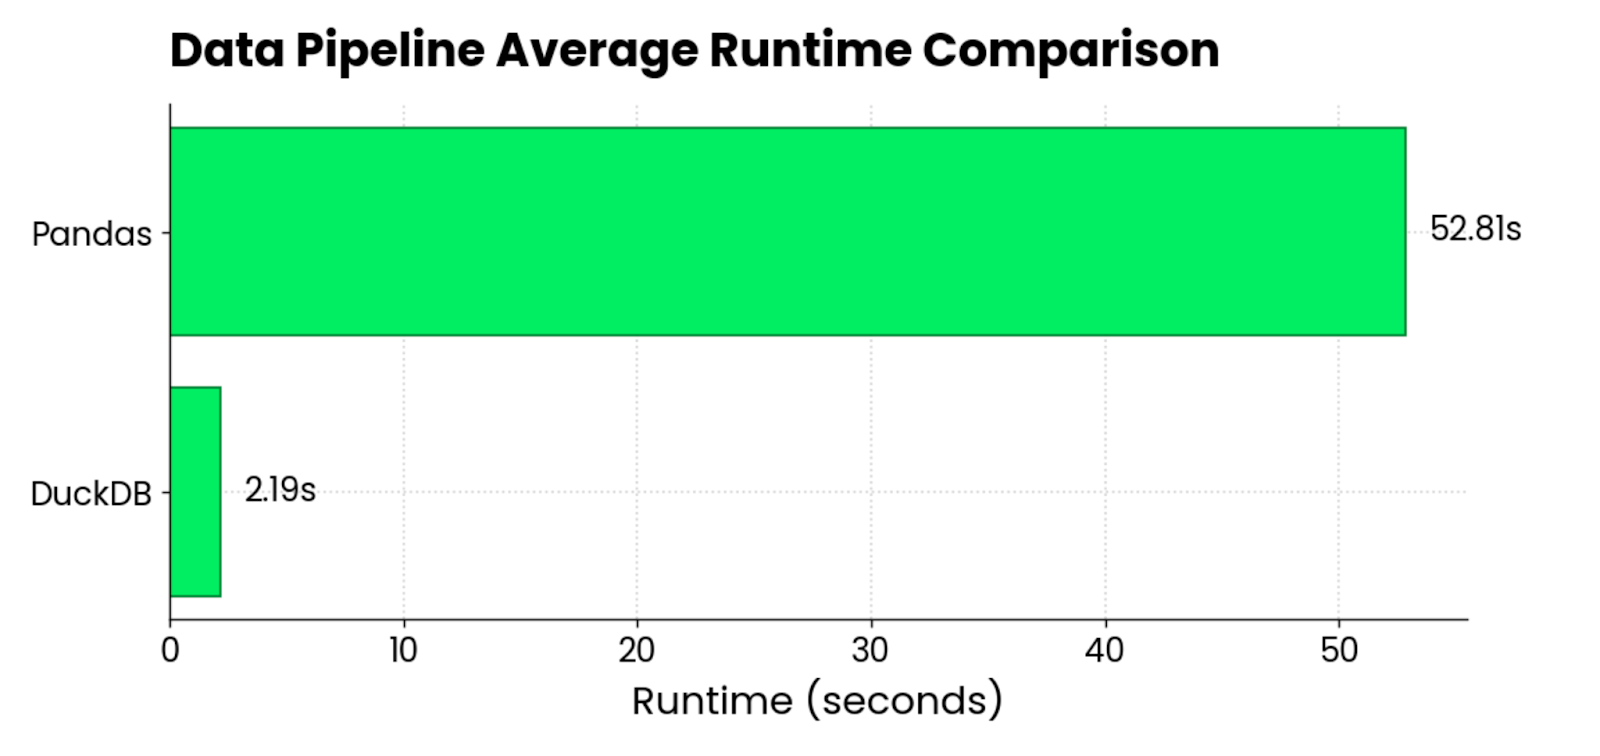
DuckDB vs. pandas - vergelijking runtimes
pandas was gemiddeld 24 keer trager dan DuckDB bij het laden en verwerken van zo'n 120 miljoen rijen (~3GB), verspreid over 6 Parquet-bestanden.
De vergelijking is niet helemaal eerlijk, aangezien ik met pandas niet alle Parquet-bestanden in één keer kon verwerken. Toch zijn de resultaten relevant, want je zult dezelfde problemen in je werk tegenkomen.
Als één bibliotheek niet kan wat je nodig hebt, probeer dan een andere. En diegene die het meestal het snelst af heeft, is DuckDB.
Voordat je DuckDB verder zelf gaat verkennen, wil ik nog een paar algemene en data-engineering-gerelateerde best practices delen:
SELECT-statements. Vermijd gebruik in workflows die leunen op frequente INSERT- en UPDATE-statements. Is dat het geval, gebruik dan SQLite in plaats daarvan.Kortom: als je als data engineer verantwoordelijk bent voor het bouwen en optimaliseren van datapijplijnen, moet je DuckDB zeker proberen.
Je hebt niets te verliezen en alles te winnen. Het is vrijwel gegarandeerd sneller dan wat Python te bieden heeft. Het draait razendsnel op je laptop en laat je datasets verwerken die anders tot geheugenfouten zouden leiden. Het kan zelfs verbinden met cloudopslagplatforms in gevallen waarin je data niet lokaal wilt of mag opslaan.
Dat gezegd hebbende, DuckDB zou niet de enige optimalisatie moeten zijn die je inbrengt. Streef er altijd naar om de data die je systeem ingaat te optimaliseren. Door bijvoorbeeld CSV te verruilen voor Parquet bespaar je zowel rekentijd als opslag. Een andere optimalisatie om te overwegen is om de principes van moderne data-architectuur in je workflows en pijplijnen te implementeren.
DuckDB is slechts een tool. Maar wel een hele krachtige.
Leer meer over data engineering met deze cursussen!
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

