Kurs
Grundlagen von Data Engineering
2 Std.
372.4K
Wie gesagt, DuckDB läuft auf deinem Laptop. Der erste Schritt ist also die Installation.
Ich zeige dir die Schritte für macOS, aber die Anleitungen für Windows und Linux sind ebenfalls klar und leicht zu befolgen.
Auf dem Mac installierst du DuckDB am einfachsten mit Homebrew. Führe folgenden Shell‑Befehl aus:
brew install duckdbNach wenigen Sekunden solltest du diese Ausgabe sehen:
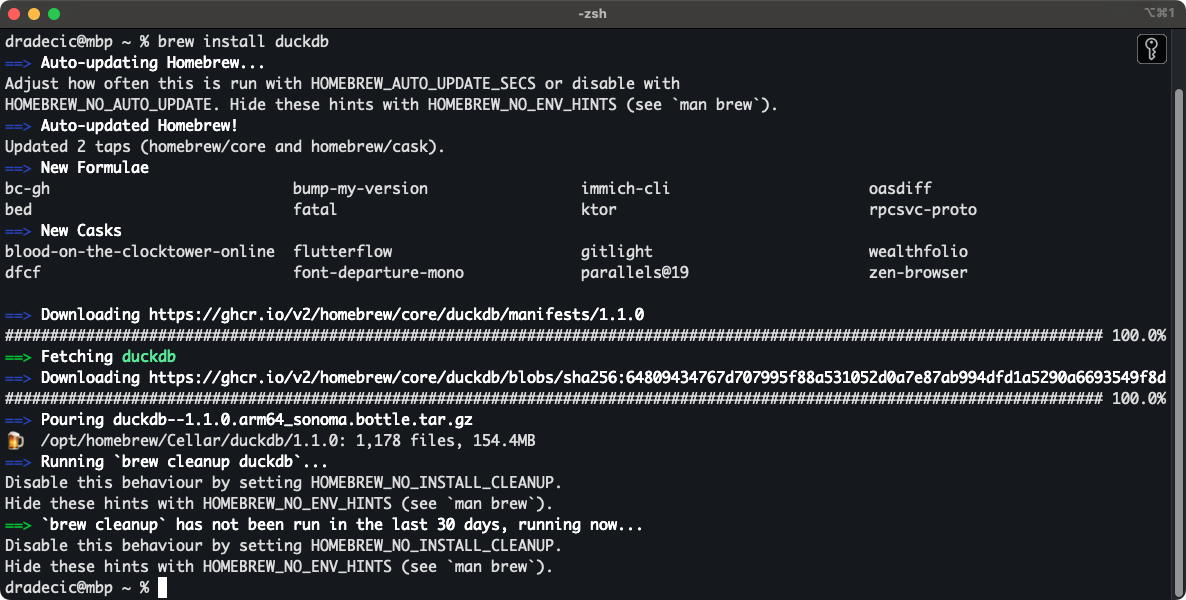
Installing DuckDB with Homebrew
Nach der Installation öffnest du die DuckDB‑Shell mit:
duckdb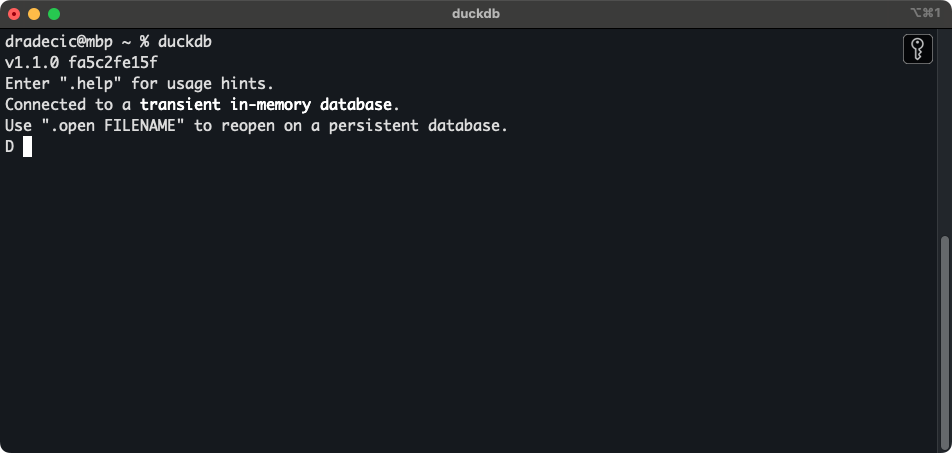
DuckDB shell
Ab hier stehen dir alle Türen offen!
Du kannst SQL‑Abfragen direkt in der Konsole schreiben und ausführen. Ich habe beispielsweise die ersten 6 Monate der NYC Taxi Data für 2024 heruntergeladen. Wenn du dasselbe getan hast, zeigt dir dieses Snippet die Zeilenanzahl einer einzelnen Parquet‑Datei:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");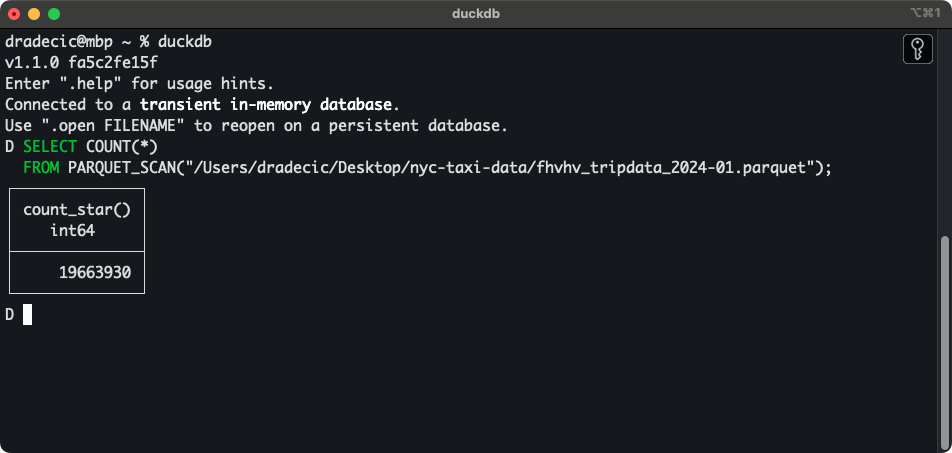
Single Parquet file row counts
Ja – fast 20 Millionen Zeilen in nur einer Datei. Ich habe 24 davon geladen.
Vermutlich willst du DuckDB nicht dauerhaft im Terminal nutzen. Als Nächstes zeige ich dir daher, wie du DuckDB mit Python verbindest.
Ziel dieses Abschnitts ist zu zeigen, wie du DuckDB in der beliebtesten Sprache des Data Engineerings konfigurierst und nutzt: Python.
Tatsächlich bietet DataCamp einen kompletten Karriere‑Lernpfad für Data Engineering mit Python an.
Für Python gibt es eine eigene DuckDB‑Bibliothek, die du zuerst installieren musst. Führe Folgendes im Terminal aus, am besten in einer virtuellen Umgebung:
pip install duckdbErstelle nun eine neue Python‑Datei und füge diesen Code ein:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Kurz gesagt: Die Funktion ermittelt mit einer gültigen DuckDB‑Verbindung und einem Dateipfad die Zeilenanzahl einer Datei.
Nach dem Ausführen des Skripts erhältst du das Ergebnis nahezu instantan:
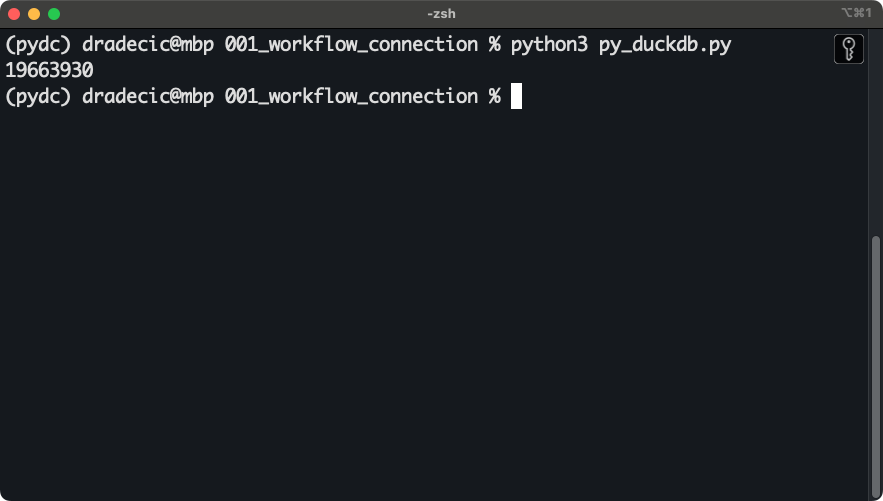
DuckDB and Python connection
Das war’s!
Als Nächstes zeige ich dir, was du mit Python und DuckDB in Lichtgeschwindigkeit anstellen kannst!
Zur Einordnung: Ich führe den Code auf dem 2024‑Ausschnitt (Januar–Juni) des NYC Taxi Datasets aus – konkret für High‑Volume For‑Hire‑Vehicles. Das sind 6 Parquet‑Dateien mit ca. 3 GB Speicherbedarf. Als Hardware nutze ich ein M3 Pro MacBook Pro 16" mit 12 CPU‑Kernen und 36 GB Unified Memory.
Deine Zahlen können abweichen, sollten aber in ähnlichen Bereichen liegen.
Ich habe die 6 Dateien zusätzlich in CSV und JSON konvertiert. So viel Speicher brauchen die Formate jeweils:
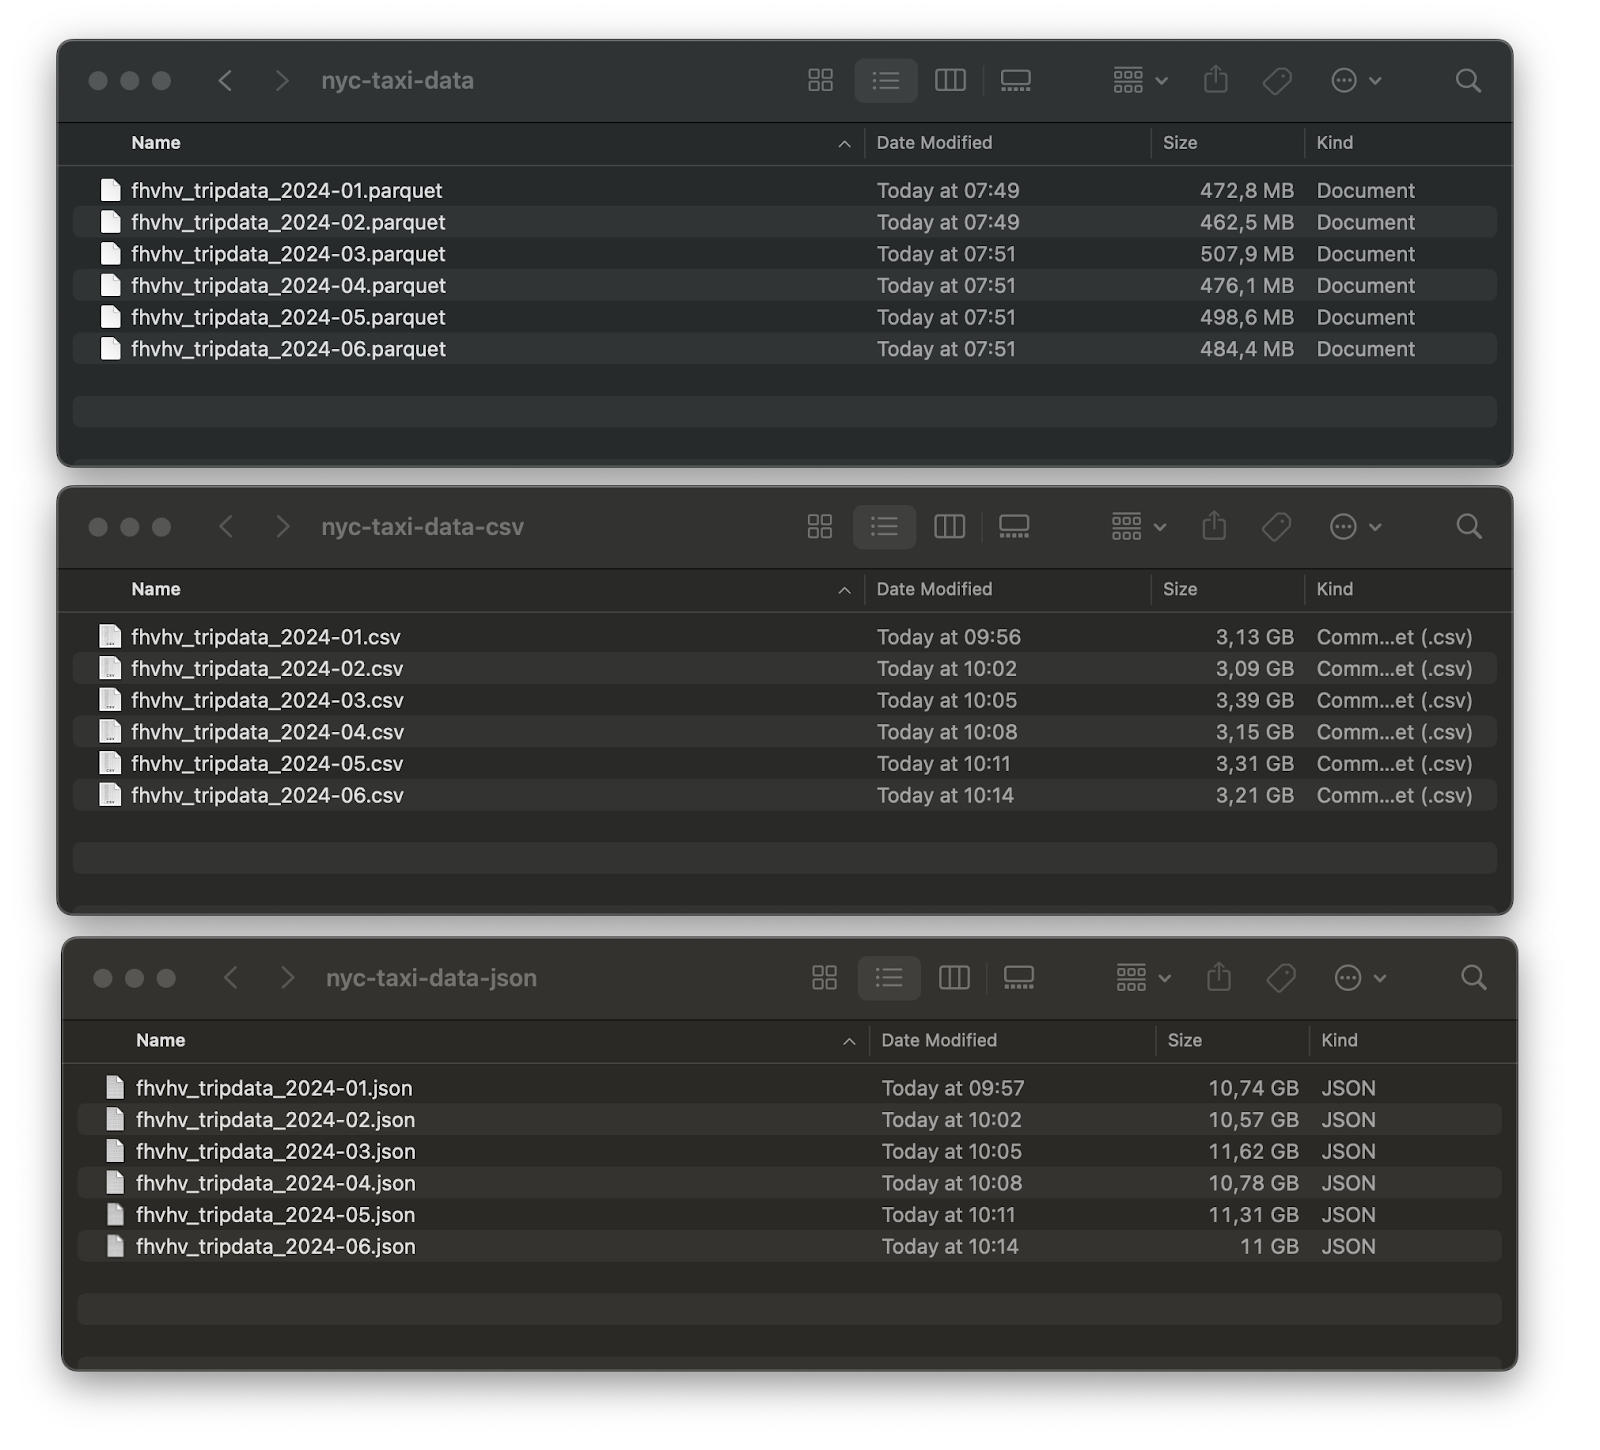
Dataset size comparison
Gesamt: 2,96 GB für Parquet, 19,31 GB für CSV und 66,04 GB für JSON.
Ein gewaltiger Unterschied! Wenn du aus diesem Artikel nur eines mitnimmst, dann: Nutze bei großen Dateien immer das Parquet‑Format. Das spart Rechenzeit und Speicherplatz.
DuckDB bietet bequeme Funktionen, um mehrere Dateien desselben Formats auf einmal (per Glob‑Pattern) zu lesen. Ich nutze das, um alle sechs einzulesen, die Zeilen zu zählen und die Laufzeit zu vergleichen:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Die Ergebnisse sind eindeutig – es gibt nur einen klaren Sieger:
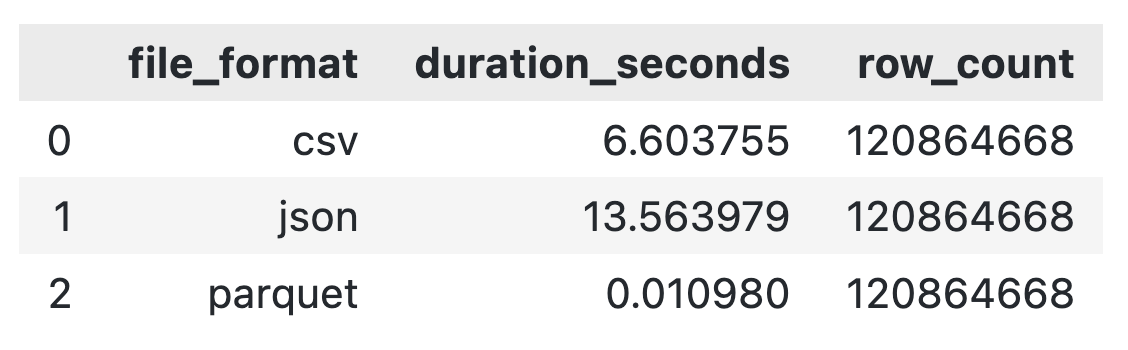
File reading runtime comparison
Dank DuckDB sind alle drei schnell und landen am selben Ziel, aber Parquet gewinnt klar mit einem Faktor 600 gegenüber CSV und einem Faktor 1200 gegenüber JSON.
Deshalb nutze ich im weiteren Verlauf ausschließlich Parquet.
Mit DuckDB aggregierst du Daten per SQL.
Ich führe die Idee hier weiter aus. Konkret zeige ich dir, wie du Monatsstatistiken berechnest – Anzahl Fahrten, Fahrtzeit, Strecke, Kosten und Fahrerlohn – und das auf Basis von 120 Millionen Zeilen.
Das Beste daran: Es dauert nur zwei Sekunden!
Das ist der Code im Python‑Skript, der aggregiert und die Ergebnisse ausgibt:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
Die Ausgabe zeigt die Aggregationsergebnisse, den Variablentyp von results und die Gesamtlaufzeit:
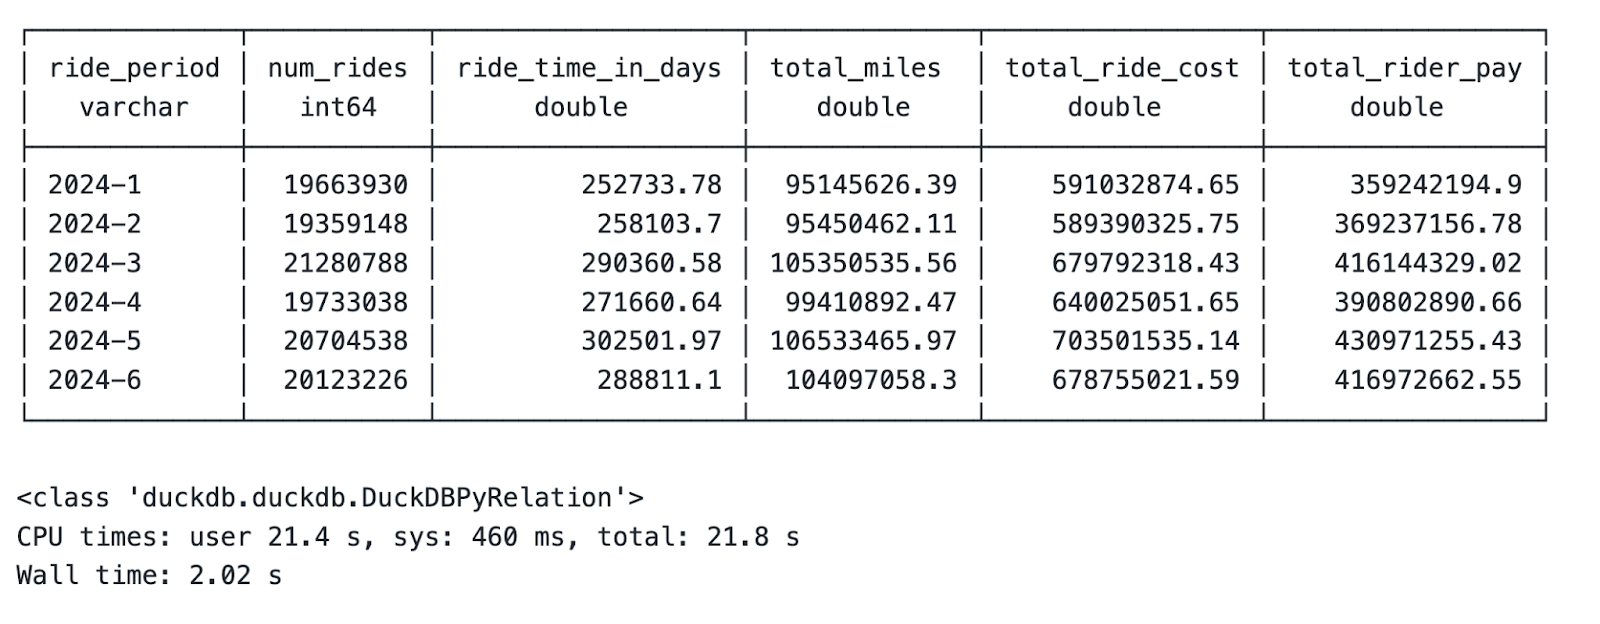
Monthly summary statistics aggregation
Lass dir das auf der Zunge zergehen: 3 GB Daten mit über 120 Millionen Zeilen, in 2 Sekunden auf einem Laptop aggregiert!
Einzig der Variablentyp ist langfristig unpraktisch. Zum Glück ist das leicht zu beheben.
Der Vorteil von DuckDB ist nicht nur die Geschwindigkeit, sondern auch die gute Integration mit deiner Lieblings‑Data‑Frames‑Library: pandas.
Wenn du ein temporäres Resultset wie oben hast, reicht ein Aufruf der Methode .df(), um es in einen pandas‑DataFrame zu konvertieren:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df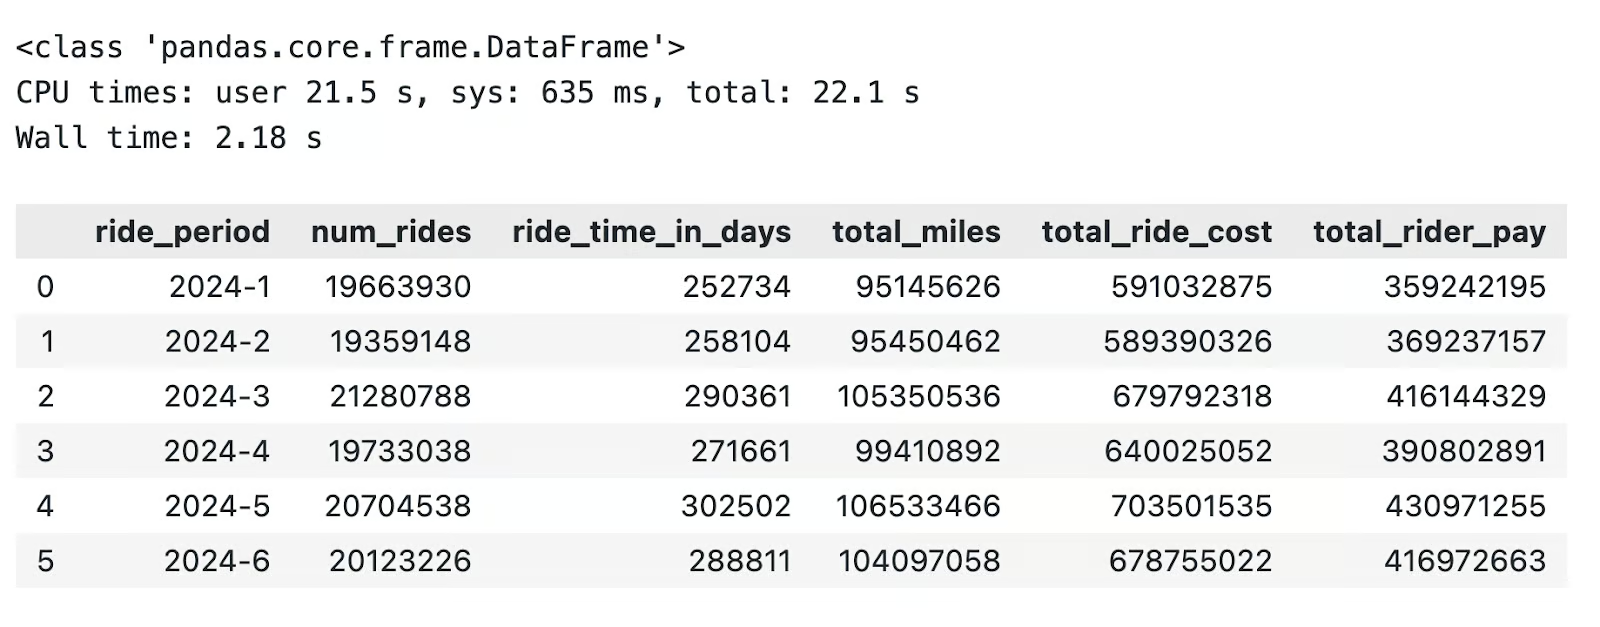
DuckDB to pandas conversion
Ebenso kannst du DuckDB nutzen, um Berechnungen auf pandas‑DataFrames durchzuführen, die bereits im Speicher liegen.
Der Trick: Verweise im DuckDB‑SQL‑Query nach dem FROM‑Keyword einfach auf den Variablennamen. Hier ein Beispiel:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res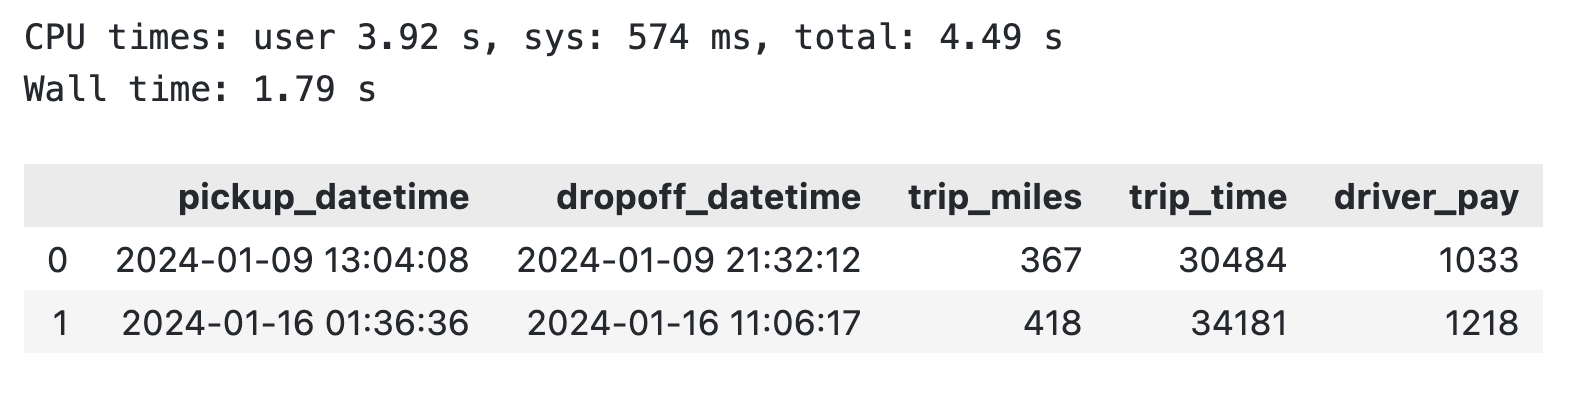
DuckDB query on an existing pandas DataFrame
Unterm Strich kannst du pandas komplett umgehen – oder Aggregationen auf bestehenden DataFrames deutlich schneller ausführen.
Als Nächstes zeige ich dir ein paar fortgeschrittene DuckDB‑Features.
DuckDB kann mehr, als man auf den ersten Blick sieht.
In diesem Abschnitt führe ich dich durch einige erweiterte Funktionen, die für Data Engineers essenziell sind.
DuckDB lässt sich über Core‑ und Community‑Erweiterungen funktional erweitern. Ich nutze Extensions regelmäßig, um Cloud‑Speicher und Datenbanken anzubinden und zusätzliche Dateiformate zu verarbeiten.
Installieren kannst du Erweiterungen sowohl in Python als auch in der DuckDB‑Konsole.
Im folgenden Snippet siehst du, wie du die httpfs-Erweiterung installierst, die für die Anbindung an AWS und das Lesen von S3‑Daten benötigt wird:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Ohne angehängte .df()‑Methode an conn.execute() siehst du keine Ausgabe. Mit .df() bekommst du eine „Success“‑ oder „Error“‑Meldung.
In der Praxis bekommst du meist Zugriff auf Daten, die du in deine Pipelines integrieren sollst. Diese liegen üblicherweise auf skalierbaren Cloud‑Plattformen wie AWS S3.
DuckDB kann S3 (und andere Plattformen) direkt anbinden.
Wie du die Erweiterung (httpfs) installierst, habe ich gezeigt. Jetzt musst du sie nur noch konfigurieren. Für AWS brauchst du Region, Access Key und Secret Access Key.
Wenn du alles parat hast, führe folgenden Befehl über Python aus:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Mein S3‑Bucket enthält zwei Dateien aus dem New‑York‑Taxi‑Datensatz:
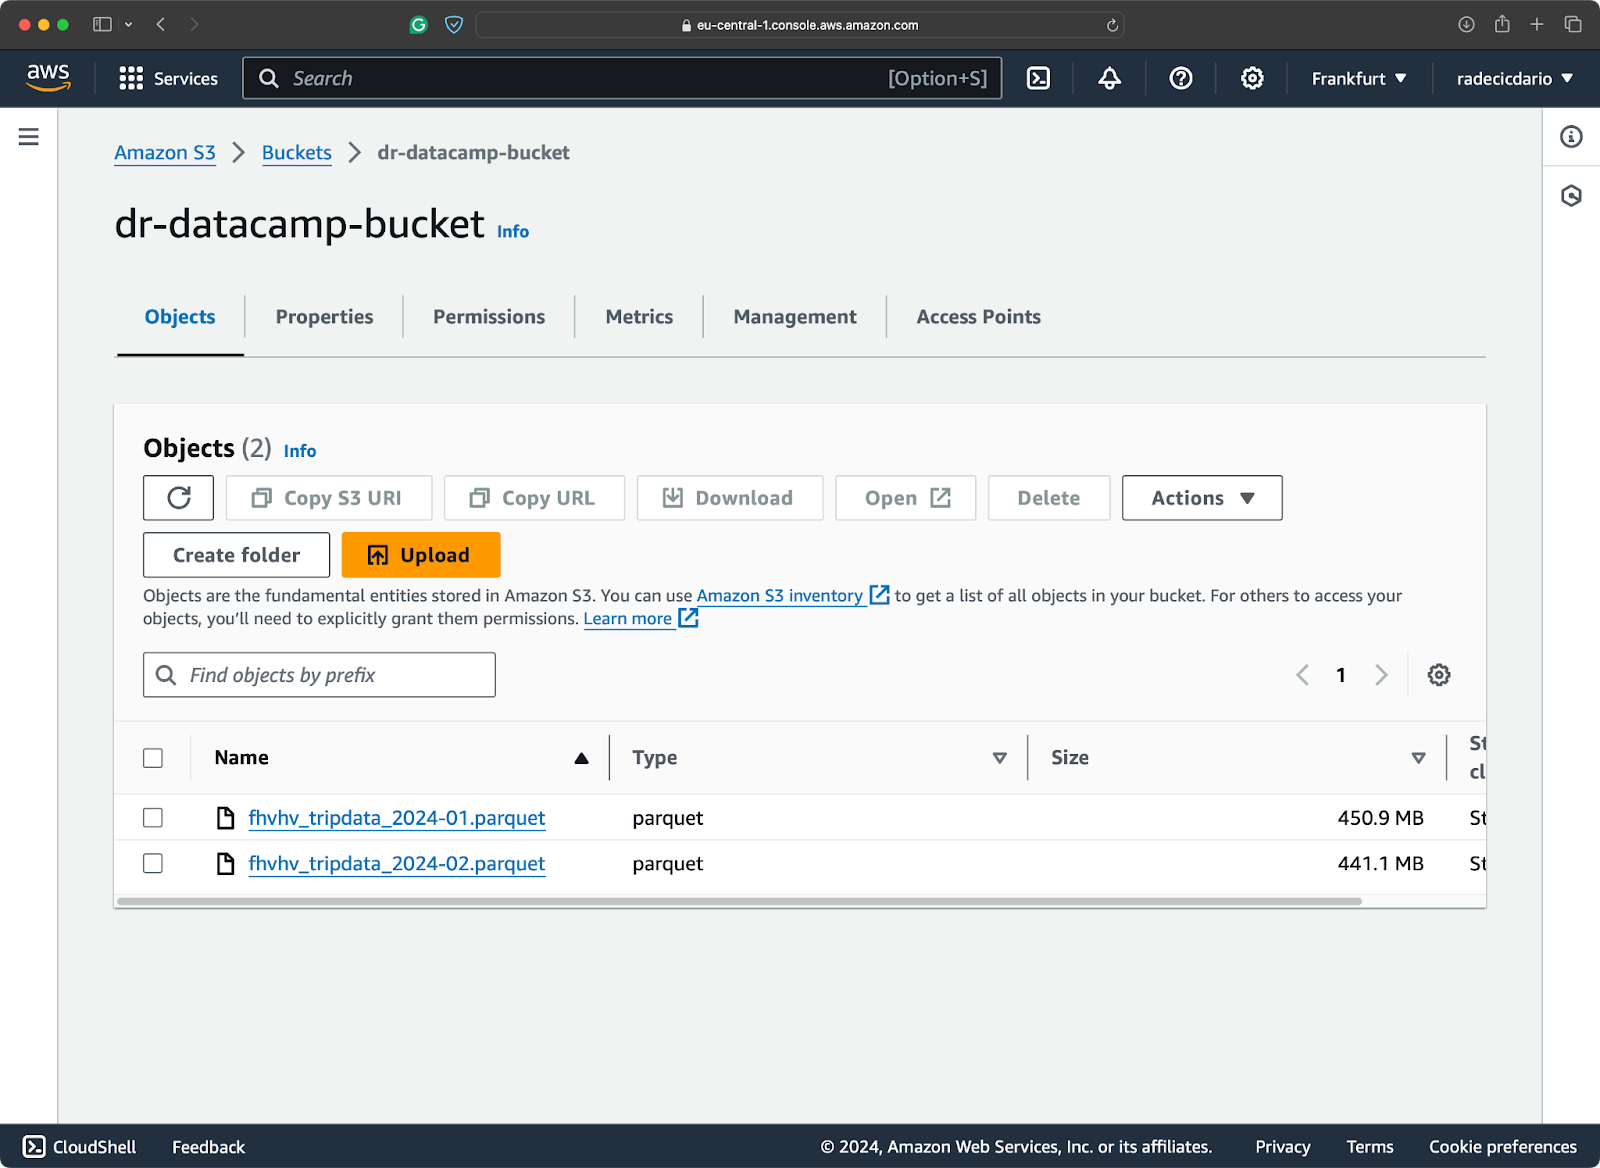
S3 bucket contents
Du musst die Dateien nicht herunterladen – du kannst sie direkt aus S3 scannen:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count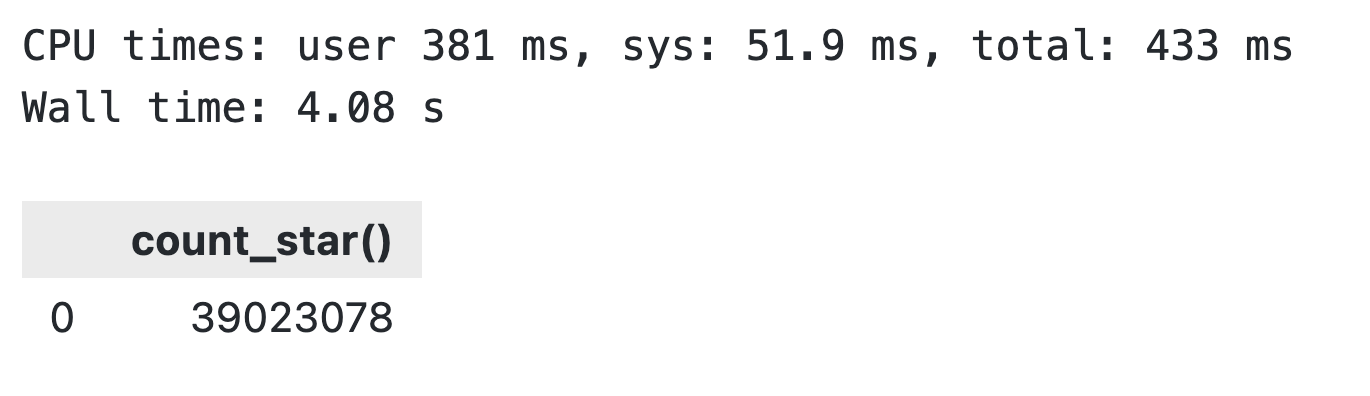
DuckDB S3 fetch results
Du liest richtig: Es brauchte nur 4 Sekunden für knapp 900 MB Daten in einem S3‑Bucket.
Parallelisierung ist in DuckDB standardmäßig aktiviert und basiert auf Row Groups – horizontalen Datenpartitionen, wie man sie typischerweise in Parquet findet. Eine Row Group hat maximal 122.880 Zeilen.
Parallelität in DuckDB startet also ab mehr als 122.880 Zeilen.
DuckDB startet dann automatisch weitere Threads. Standardmäßig entspricht deren Anzahl der Zahl der CPU‑Kerne. Du kannst aber auch manuell mit der Thread‑Zahl spielen.
Ich zeige dir gleich, wie das geht und welchen Effekt unterschiedliche Thread‑Zahlen auf eine identische Aufgabe haben.
Die aktuelle Thread‑Zahl siehst du mit:
SELECT current_setting('threads') AS threads;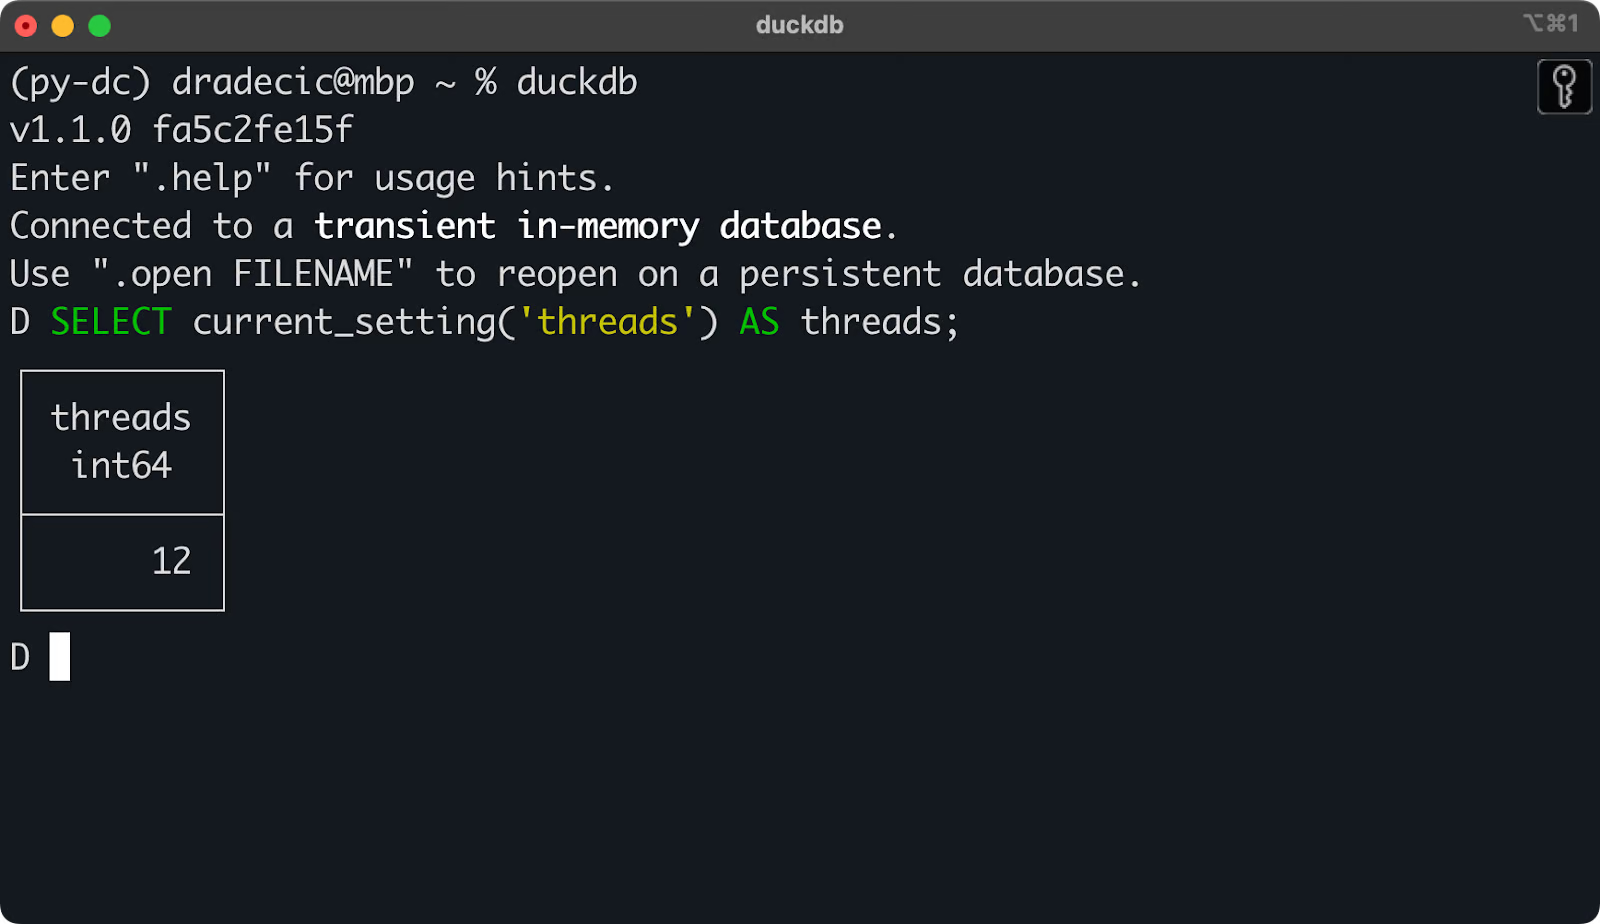
The current number of threads used by DuckDB
Dasselbe kannst du auch aus Python heraus abfragen.
Zum Ändern der Thread‑Zahl nutzt du den Befehl SET threads = N.
Im folgenden Code implementiere ich eine Python‑Funktion, die eine DuckDB‑Abfrage mit einer vorgegebenen Thread‑Zahl ausführt, in einen pandas‑DataFrame konvertiert und die Laufzeit (u. a.) zurückgibt. Der Code darunter führt sie für einen Bereich von 1 bis 12 Threads aus:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Du solltest eine ähnliche Ausgabe sehen wie ich:
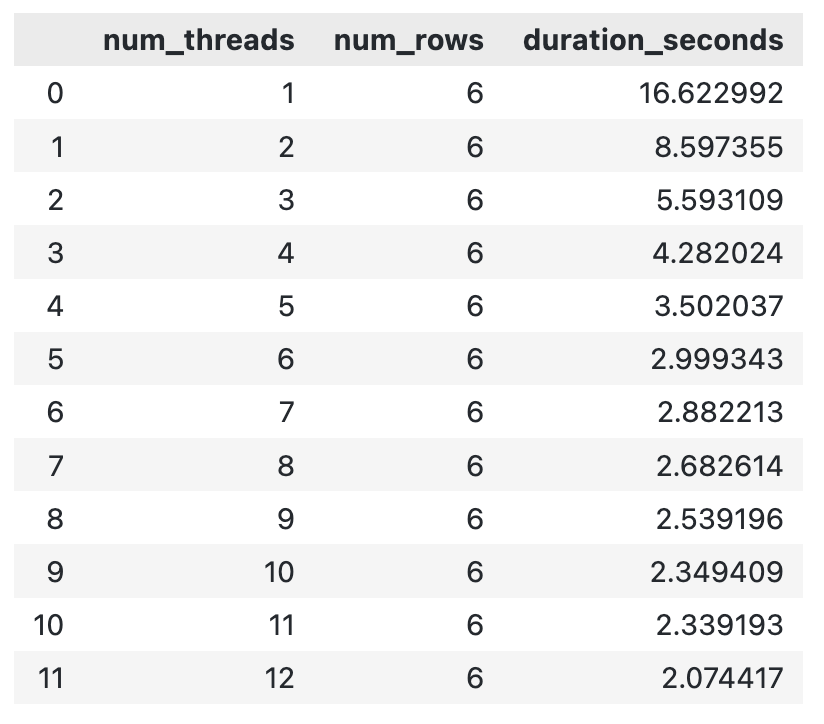
DuckDB runtime for different number of threads
Grundsätzlich gilt: Je mehr Threads du einer Berechnung gibst, desto schneller ist sie fertig. Ab einem Punkt kann der Overhead neuer Threads die Gesamtlaufzeit wieder erhöhen – in diesem Bereich war das aber nicht der Fall.
Ich zeige dir jetzt, wie du eine Datenpipeline von Grund auf schreibst. Sie ist bewusst einfach: Daten von der Platte lesen, aggregieren und Ergebnisse schreiben. Mein Ziel ist zu zeigen, wie viel Performance du durch den Wechsel von pandas zu DuckDB gewinnen kannst – und dass dein Code nebenbei sauberer wird.
Das ist kein vollständiger Einstieg in ETL/ELT‑Prozesse, sondern ein Überblick.
Die Pipeline, die ich dir gleich zeige, leistet Folgendes:
Nach dem Ausführen solltest du bei beiden Implementierungen identische Aggregationsergebnisse sehen (Rundungsdifferenzen ausgenommen):
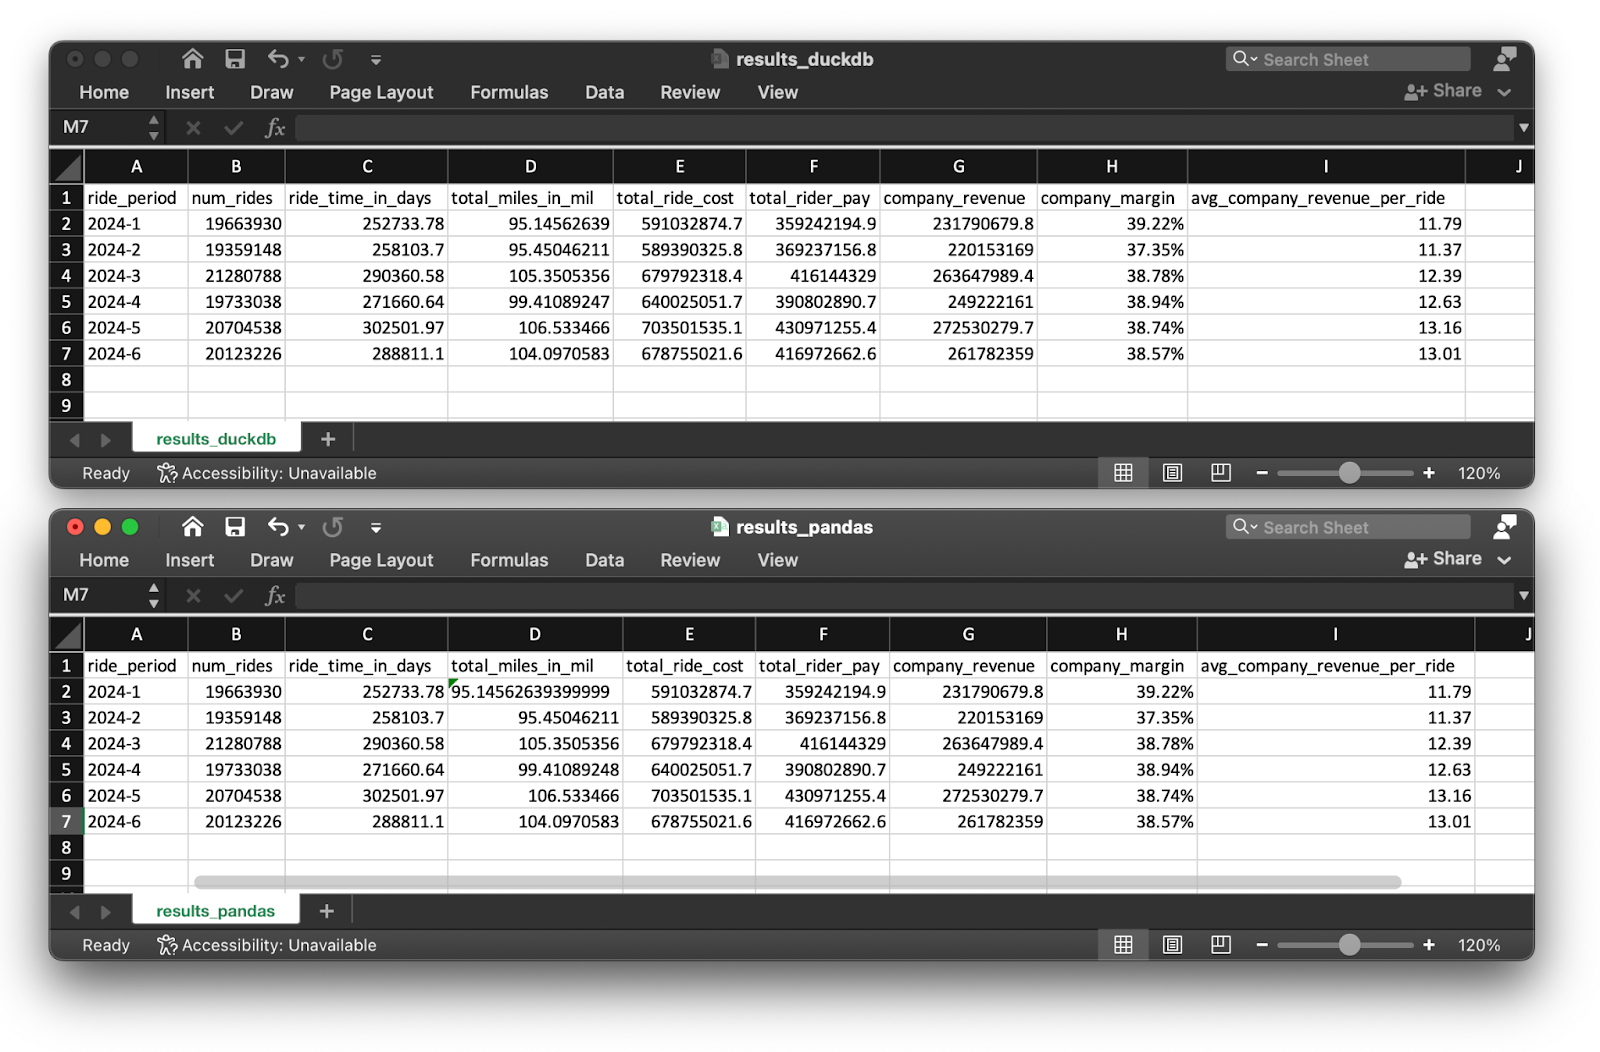
Pipeline results for DuckDB and pandas
Zuerst gehen wir die Implementierung mit pandas durch.
Egal was ich versucht habe: Alle 6 Parquet‑Dateien auf einmal ließen sich nicht verarbeiten. Systemwarnungen wie diese erschienen nach wenigen Sekunden:
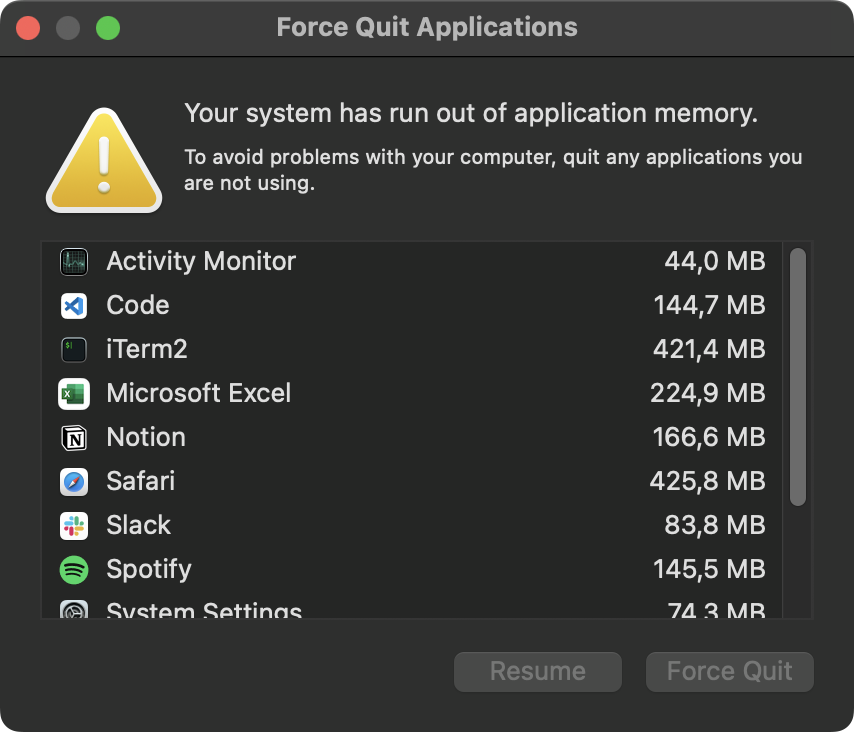
System memory error
Offenbar reichen 36 GB RAM nicht, um 120 Millionen Zeilen auf einmal zu verarbeiten. Das Python‑Skript wurde beendet:
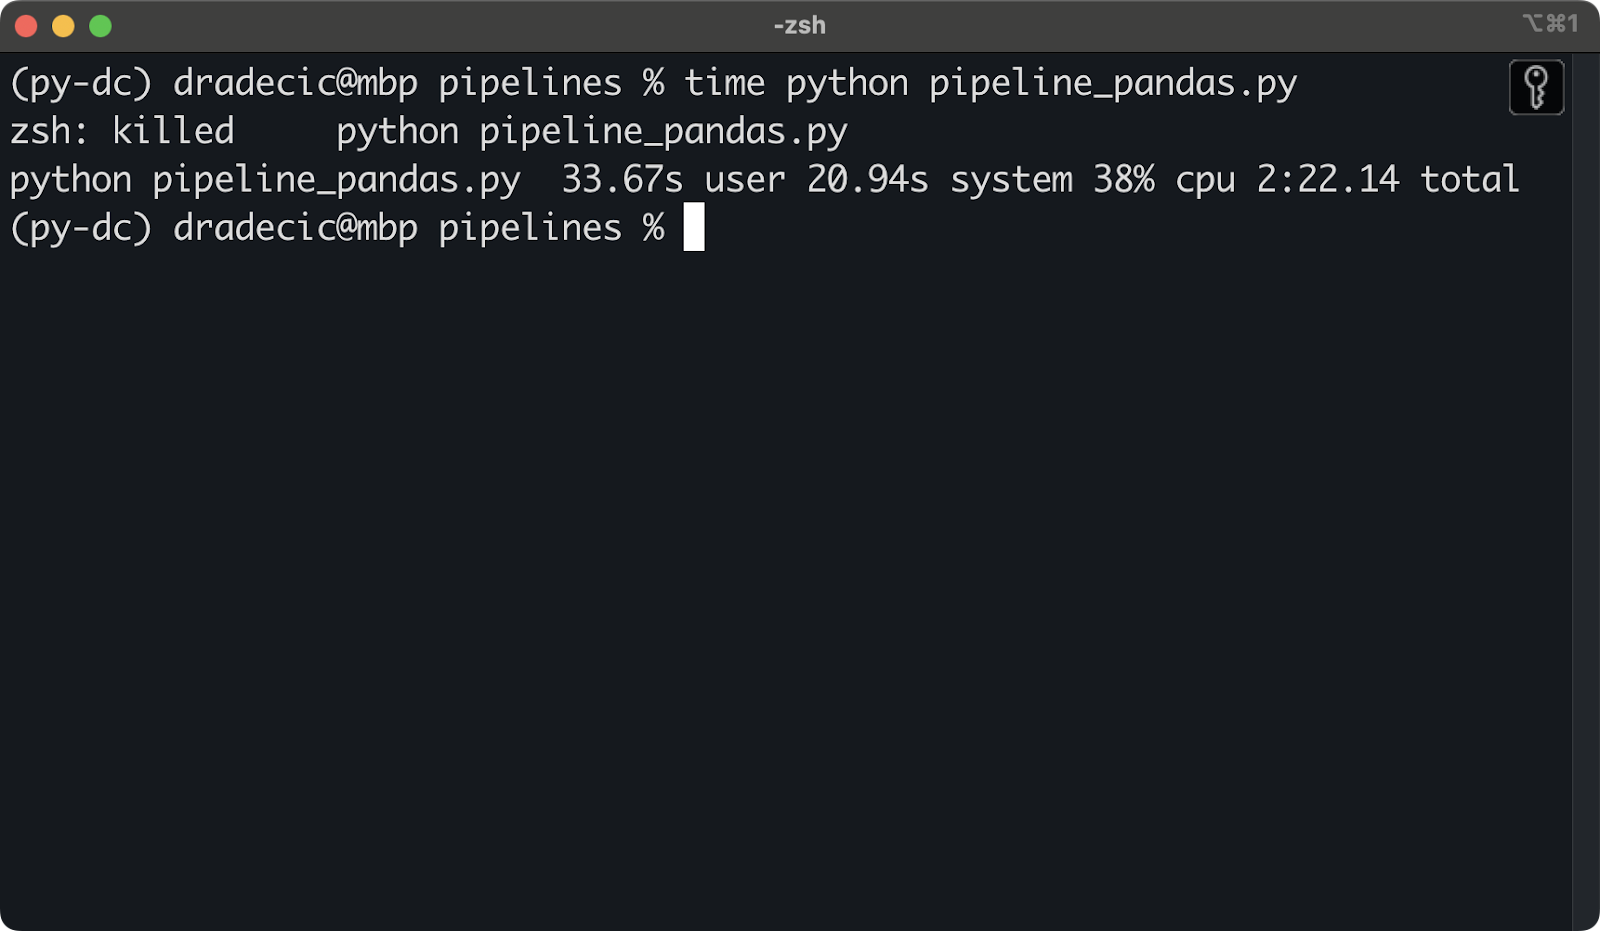
Killed Python script due to insufficient memory
Zur Abhilfe musste ich die Parquet‑Dateien nacheinander verarbeiten. Hier ist der Code für die Pipeline:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Die Implementierung mit DuckDB sollte ohne Memory‑Probleme durchlaufen.
Mit dem Großteil des DuckDB‑Codes bist du bereits vertraut.
Neu ist nur das oberste SELECT, das ein paar zusätzliche Kennzahlen berechnet. Der Rest bleibt unverändert:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Als Nächstes zeige ich dir die Laufzeitunterschiede.
Nach je 5 Durchläufen beider Pipelines und gemittelten Werten ergaben sich diese Laufzeiten:
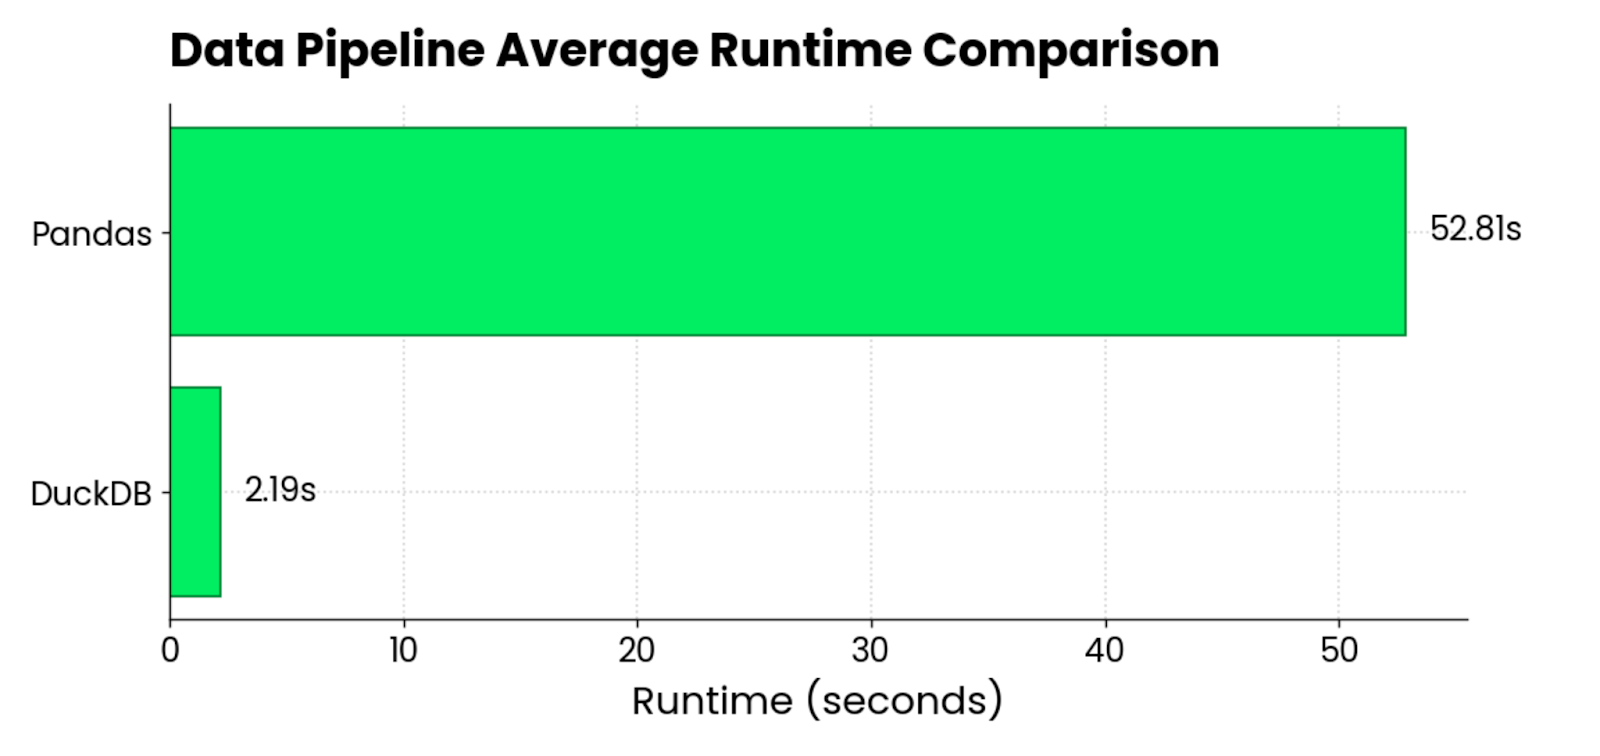
DuckDB vs. pandas runtime comparison chart
Im Schnitt war pandas 24‑mal langsamer als DuckDB beim Laden und Verarbeiten von rund 120 Millionen Zeilen (~3 GB) über 6 Parquet‑Dateien.
Der Vergleich ist nicht ganz fair, da ich mit pandas nicht alle Parquet‑Dateien auf einmal verarbeiten konnte. Dennoch ist das Ergebnis relevant – solche Hürden wirst du im Job ebenfalls sehen.
Wenn eine Bibliothek nicht liefert, probiere eine andere. Und die, die in den meisten Fällen am schnellsten fertig wird, ist DuckDB.
Bevor du DuckDB weiter auf eigene Faust erkundest, hier einige allgemeine und data‑engineering‑bezogene Best Practices:
SELECT optimiert. Vermeide Workflows mit häufigen INSERT‑ und UPDATE‑Statements. In solchen Fällen ist SQLite die bessere Wahl.Mein Fazit: Wenn du als Data Engineer Datenpipelines baust und optimierst, solltest du DuckDB ausprobieren.
Du hast nichts zu verlieren und alles zu gewinnen. Das Tool ist nahezu garantiert schneller als alles, was Python von Haus aus bietet. Es läuft blitzschnell auf deinem Laptop und verarbeitet Datensätze, die sonst zu Memory‑Errors führen würden. Und es verbindet sich mit Cloud‑Speichern, wenn du Daten nicht lokal ablegen willst oder darfst.
Dennoch gilt: DuckDB ist nicht die einzige Optimierung, die du angehen solltest. Optimiere immer zuerst die Eingangsdaten. CSV zugunsten von Parquet zu streichen spart Rechenzeit und Speicher. Außerdem lohnt es sich, die Prinzipien einer modernen Datenarchitektur in deine Workflows und Pipelines zu integrieren.
DuckDB ist nur ein Werkzeug. Aber ein sehr mächtiges.
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Vertiefe dein Data‑Engineering‑Wissen mit diesen Kursen!
Kurs
Lernpfad
Lernpfad