Cours
Présentation de l’ingénierie des données
2 h
372.5K
Comme indiqué plus haut, DuckDB tourne en local sur votre machine. La première étape consiste donc à l'installer.
Je vais détailler l'installation sur macOS, mais les instructions pour Windows et Linux sont claires et faciles à suivre.
Sur Mac, la façon la plus simple d'installer DuckDB est via Homebrew. Exécutez la commande suivante dans votre terminal:
brew install duckdbVous verrez s'afficher le résultat en quelques secondes:
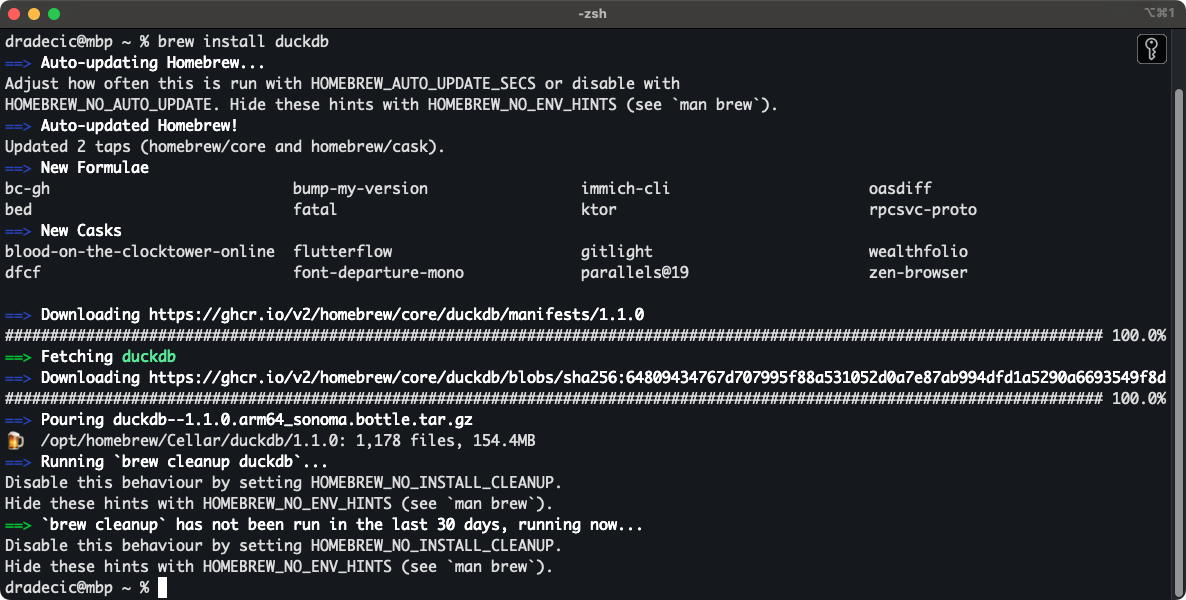
Installation de DuckDB avec Homebrew
Une fois installé, ouvrez la console DuckDB avec la commande suivante:
duckdb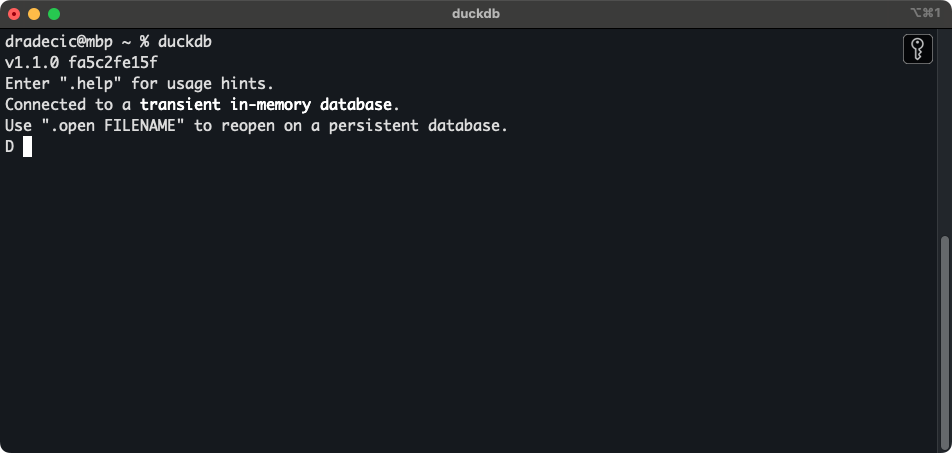
Shell DuckDB
La voie est libre!
Vous pouvez écrire et exécuter des requêtes SQL directement depuis la console. Par exemple, j'ai téléchargé les 6 premiers mois de données NYC Taxi pour 2024. Si vous avez fait de même, utilisez l'extrait suivant pour afficher le nombre de lignes d'un fichier Parquet:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");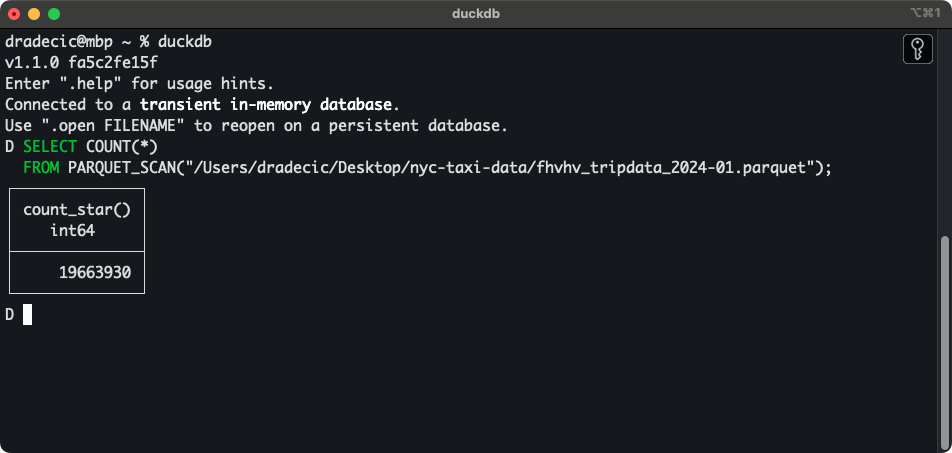
Nombre de lignes d'un fichier Parquet
Oui: presque 20 millions de lignes pour un seul fichier. J'en ai téléchargé 24.
Vous ne souhaitez sans doute pas piloter DuckDB depuis le terminal, passons donc à la connexion à Python.
L'objectif ici est de vous montrer comment configurer et exécuter DuckDB dans le langage phare de l'ingénierie des données: Python.
DataCamp propose d'ailleurs un parcours métier complet en data engineering en Python.
Python dispose d'une bibliothèque DuckDB spécifique à installer au préalable. Exécutez la commande suivante dans le terminal, de préférence dans un environnement virtuel:
pip install duckdbCréez ensuite un fichier Python et collez le code suivant:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
En résumé, cette fonction renvoie le nombre de lignes d'un fichier, à partir d'une connexion DuckDB valide et d'un chemin de fichier.
Vous obtiendrez le résultat quasi instantanément après exécution du script:
Connexion DuckDB et Python
Et c'est tout!
La suite: des démonstrations bluffantes en Python et DuckDB, à toute vitesse!
Pour référence, j'exécute le code sur une portion 2024 (janvier – juin) du jeu de données NYC Taxi — spécifiquement pour les véhicules à forte activité (for-hire). Cela représente 6 fichiers Parquet, soit environ 3 Go sur disque. Côté matériel, j'utilise un MacBook Pro 16” M3 Pro avec 12 cœurs CPU et 36 Go de mémoire unifiée.
Vos résultats peuvent varier, mais vous devriez obtenir des ordres de grandeur similaires.
J'ai converti ces 6 fichiers en deux formats supplémentaires: CSV et JSON. Voici l'espace disque occupé par chacun:
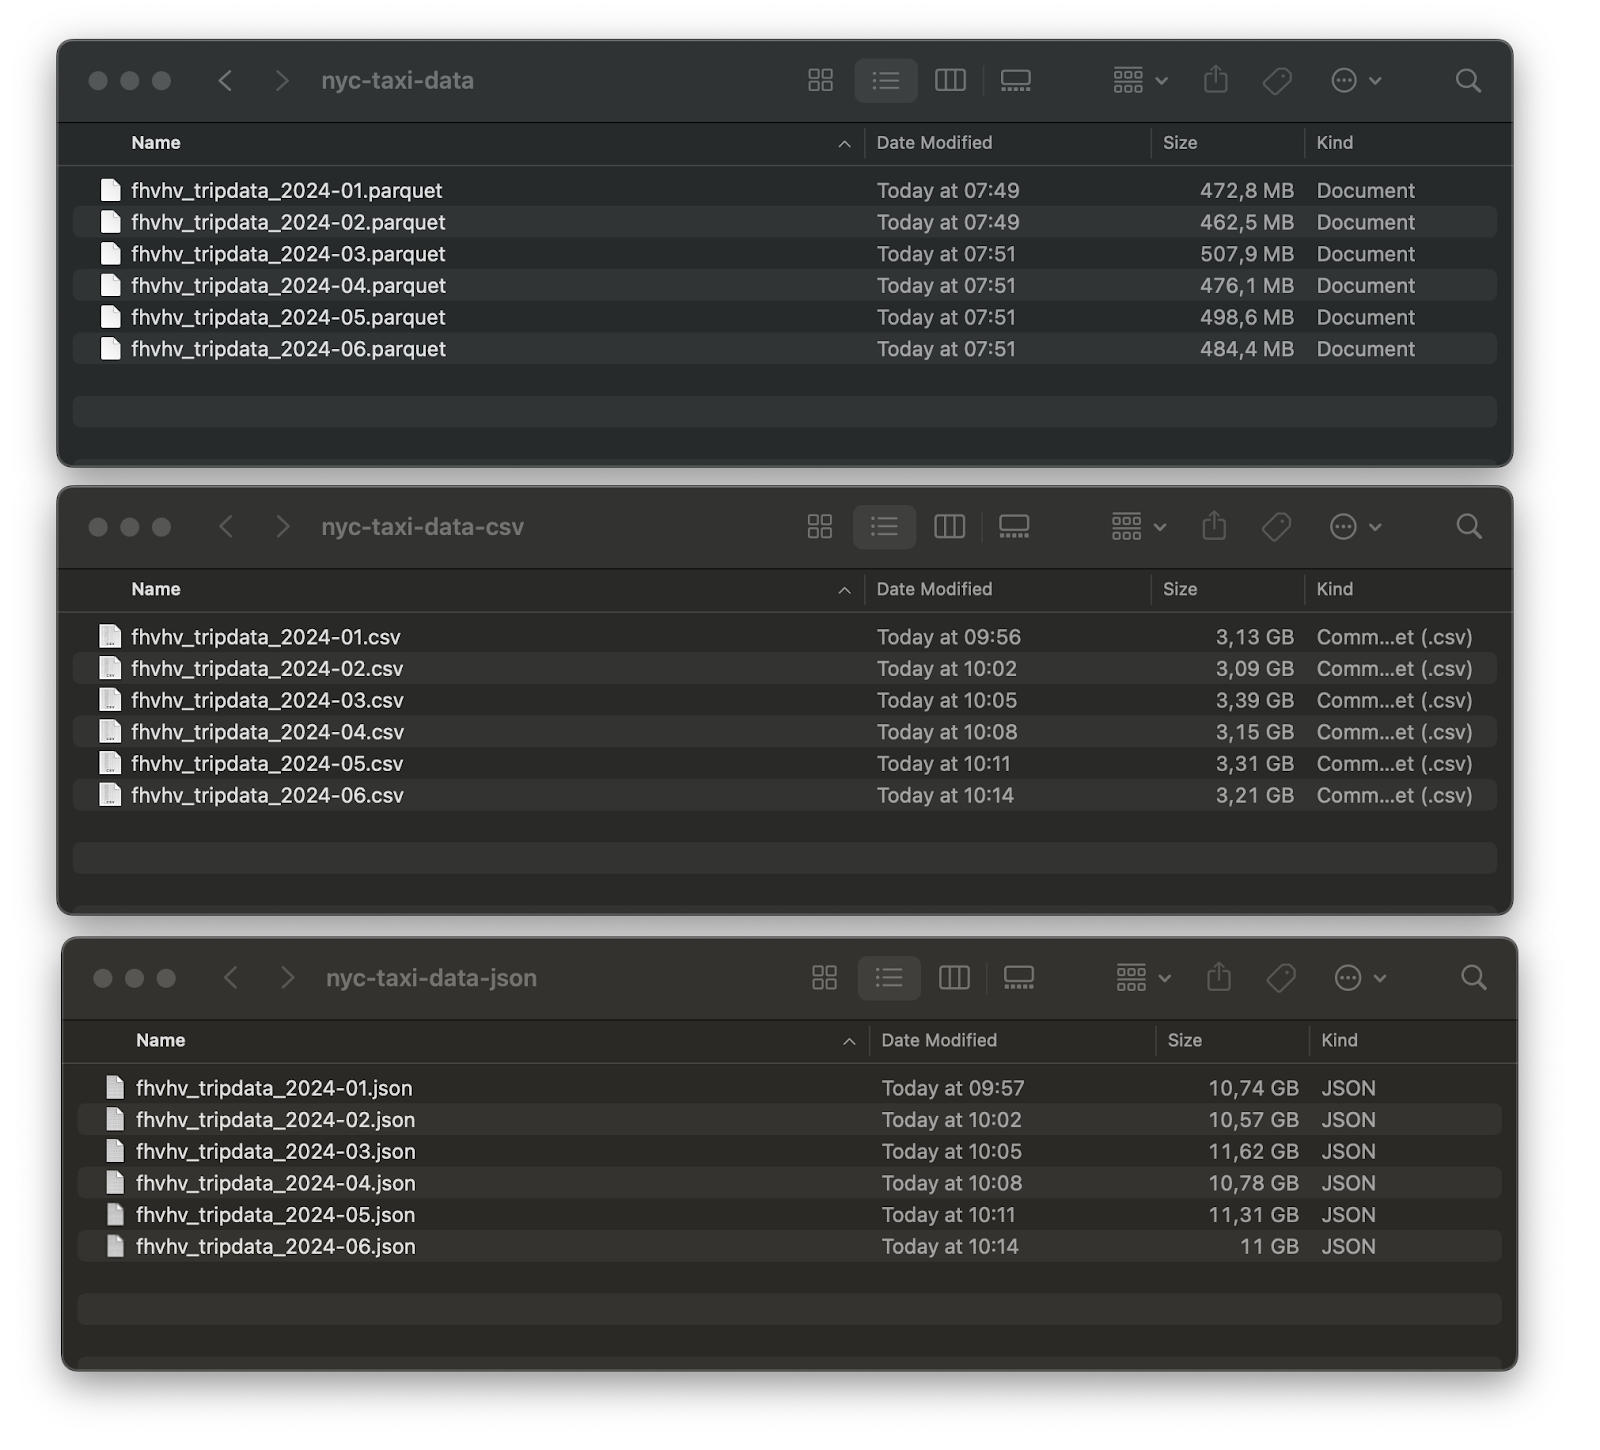
Comparaison de la taille des jeux de données
Total: 2,96 Go pour Parquet, 19,31 Go pour CSV et 66,04 Go pour JSON.
Différence énorme! Si vous ne deviez retenir qu'une chose aujourd'hui, souvenez-vous d'utiliser autant que possible le format Parquet pour les gros volumes. Vous y gagnerez en temps de traitement et en espace disque.
DuckDB fournit des fonctions pratiques pour lire plusieurs fichiers d'un même format en une seule fois (via un glob pattern). Je vais les utiliser pour lire les six, compter les lignes et comparer les temps d'exécution:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Les résultats sont sans appel:
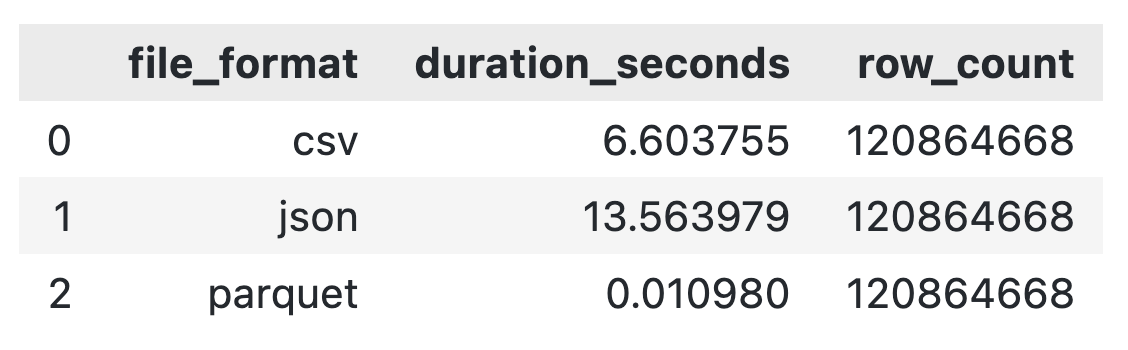
Comparaison des temps de lecture de fichiers
Grâce à DuckDB, les trois formats se lisent vite et aboutissent au même résultat, mais Parquet s'impose avec un facteur 600 face au CSV et un facteur 1200 face au JSON.
Pour la suite de l'article, je n'utiliserai donc que Parquet.
DuckDB permet d'agréger des données en SQL.
Mon objectif ici est d'aller plus loin: calculer des statistiques de synthèse au niveau mensuel — nombre de courses, durée, distance, coût et rémunération des chauffeurs — sur 120 millions de lignes.
Le mieux: cela prend deux secondes!
Voici le code utilisé dans un script Python pour agréger et afficher les résultats:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
La sortie affiche les résultats d'agrégation, le type de la variable results et le temps total d'exécution:
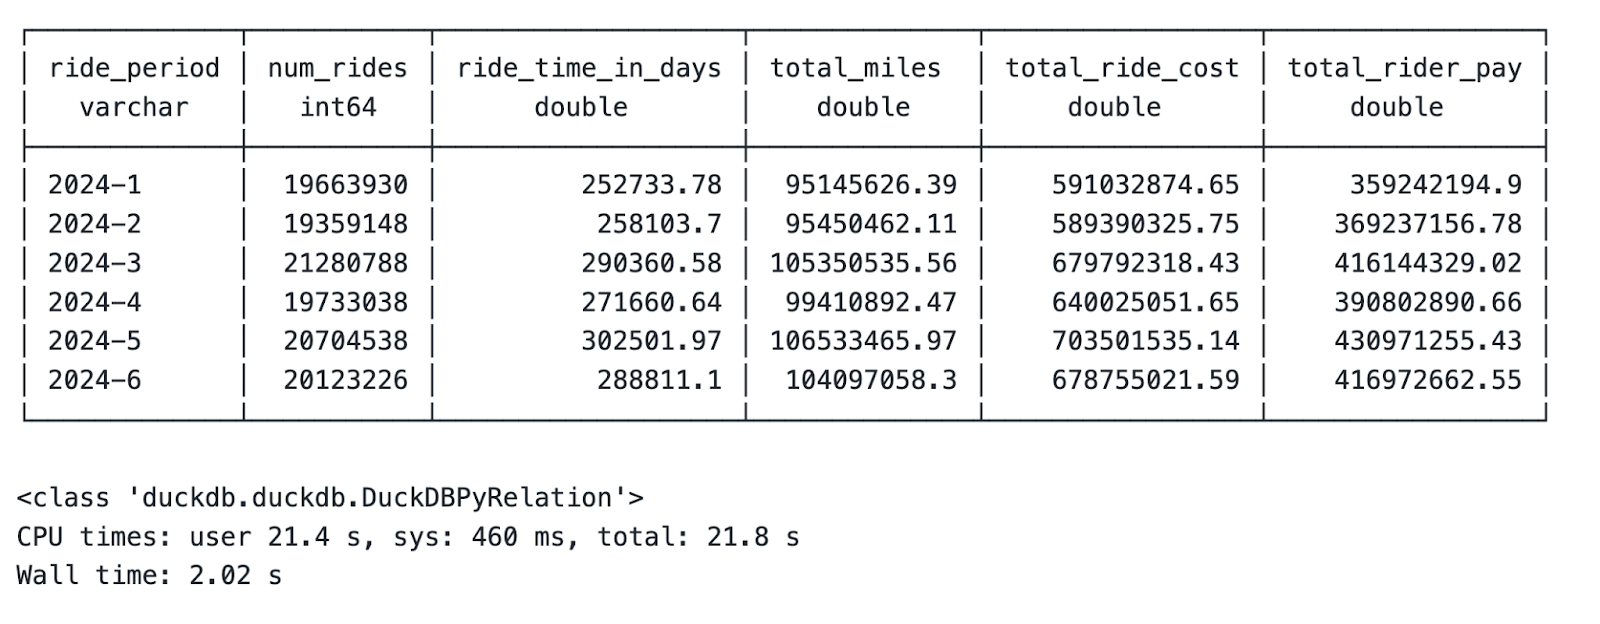
Agrégation mensuelle des statistiques de synthèse
Réfléchissez: 3 Go de données et plus de 120 millions de lignes, agrégés en 2 secondes sur un ordinateur portable!
Seul bémol: le type de retour est peu exploitable sur la durée. Heureusement, la correction est simple.
L'intérêt de DuckDB n'est pas seulement sa vitesse: il s'intègre aussi très bien à votre bibliothèque de DataFrames préférée: pandas.
Si vous avez un résultat temporaire comme ci-dessus, il suffit d'appeler la méthode .df() pour le convertir en DataFrame pandas:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df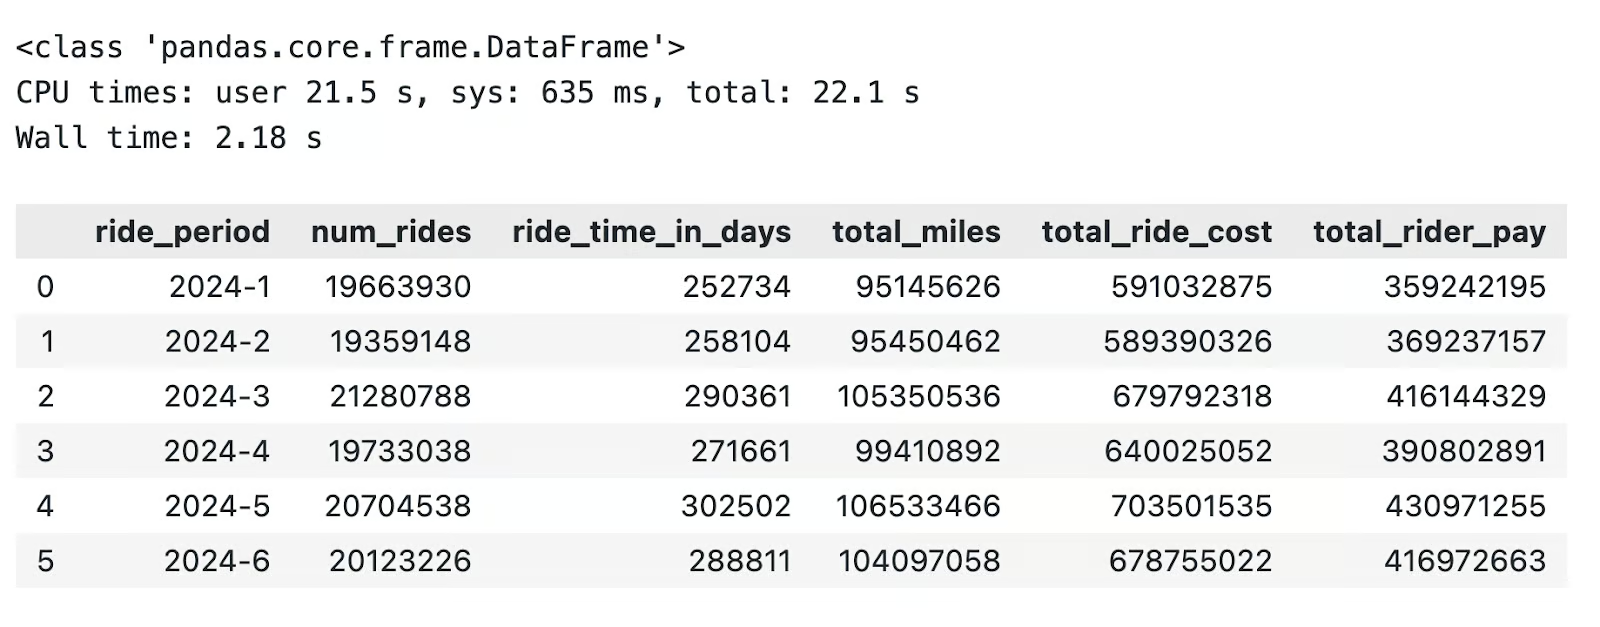
Conversion de DuckDB vers pandas
De même, vous pouvez utiliser DuckDB pour effectuer des calculs sur des DataFrames pandas déjà chargés en mémoire.
L'astuce consiste à référencer le nom de variable après le mot-clé FROM dans une requête SQL DuckDB. Exemple:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res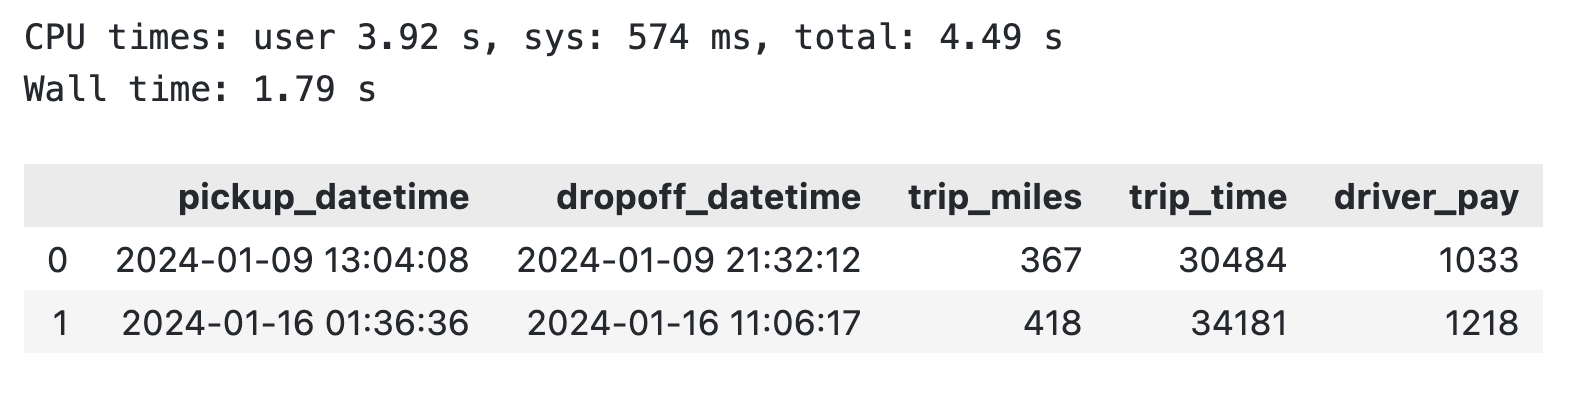
Requête DuckDB sur un DataFrame pandas existant
En bref, vous pouvez vous passer de pandas ou réaliser des agrégations plus rapides sur des DataFrames existants.
Passons à des fonctionnalités avancées de DuckDB.
DuckDB recèle bien plus qu'il n'y paraît.
Dans cette section, je vous présente quelques fonctionnalités avancées essentielles aux data engineers.
DuckDB vous permet d'étendre ses capacités natives via des extensions cœur et communautaires (extensions). Je les utilise régulièrement pour me connecter à des stockages cloud et des bases de données, et pour gérer des formats supplémentaires.
Vous pouvez installer des extensions depuis la console Python comme depuis la console DuckDB.
Dans l'extrait ci-dessous, voici comment installer l'extension httpfs nécessaire pour se connecter à AWS et lire des données S3:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Vous ne verrez aucun résultat si vous n'enchaînez pas avec .df() sur conn.execute(). Dans ce cas, vous verrez un message « Success » ou « Error ».
Dans la plupart des cas, votre entreprise vous donne accès aux données à intégrer à vos pipelines. Elles sont généralement stockées sur des plateformes cloud scalables, comme AWS S3.
DuckDB se connecte directement à S3 (et d'autres plateformes).
Vous savez déjà installer l'extension (httpfs), il ne reste qu'à la configurer. AWS exige votre région, une access key et une secret access key.
Avec ces éléments, exécutez la commande suivante via Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Mon bucket S3 contient deux fichiers du jeu de données New York Taxi:
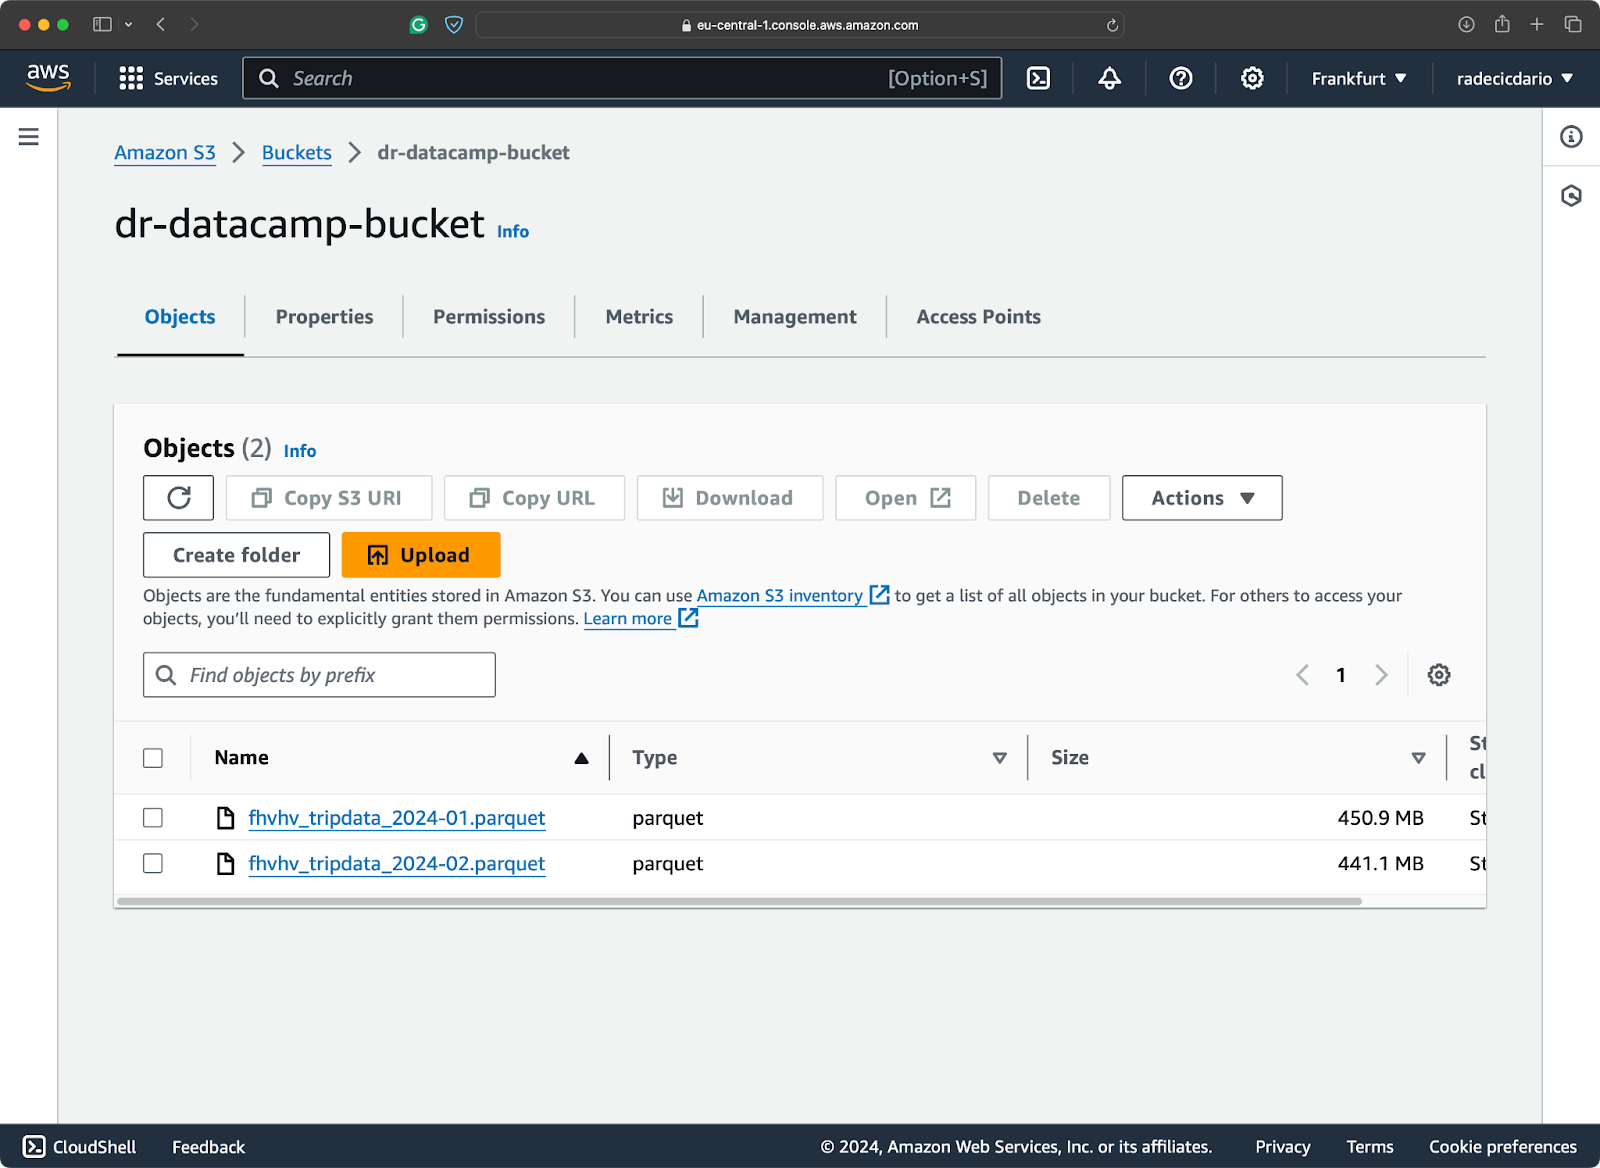
Contenu du bucket S3
Inutile de télécharger les fichiers: vous pouvez les scanner directement depuis S3:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count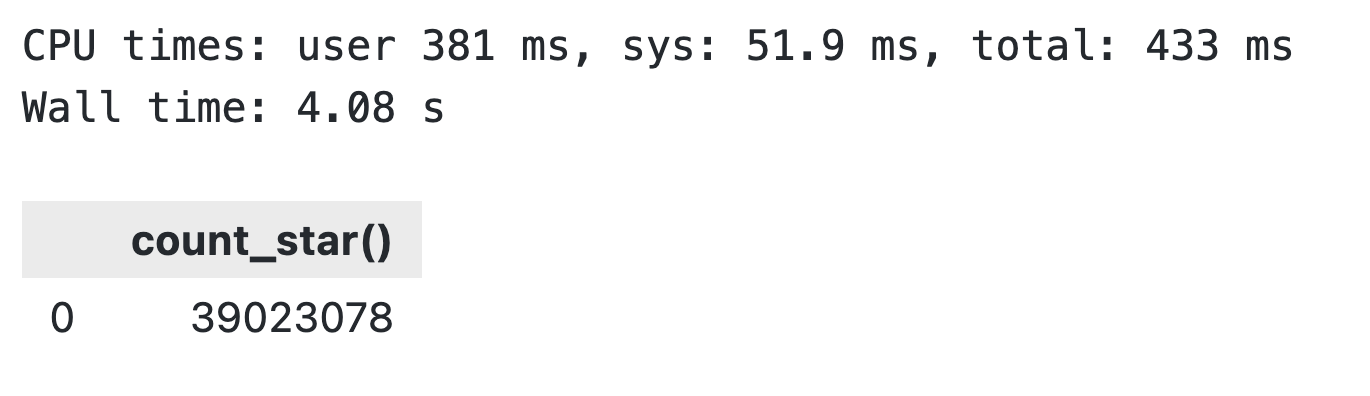
Résultats de lecture S3 avec DuckDB
Vous avez bien lu: il n'a fallu que 4 secondes pour traiter ∼ 900 Mo de données dans un bucket S3.
Côté parallélisation, DuckDB l'active par défaut à l'échelle des row groups: des partitions horizontales typiques de Parquet. Un row group peut contenir jusqu'à 122 880 lignes.
Le parallélisme dans DuckDB démarre au-delà de 122 880 lignes.
DuckDB lance automatiquement de nouveaux threads dans ce cas. Par défaut, leur nombre égale celui des cœurs CPU. Mais vous pouvez évidemment ajuster ce paramètre manuellement.
Je vais vous montrer comment procéder et l'impact du nombre de threads sur une charge identique.
Pour connaître le paramétrage actuel, exécutez:
SELECT current_setting('threads') AS threads;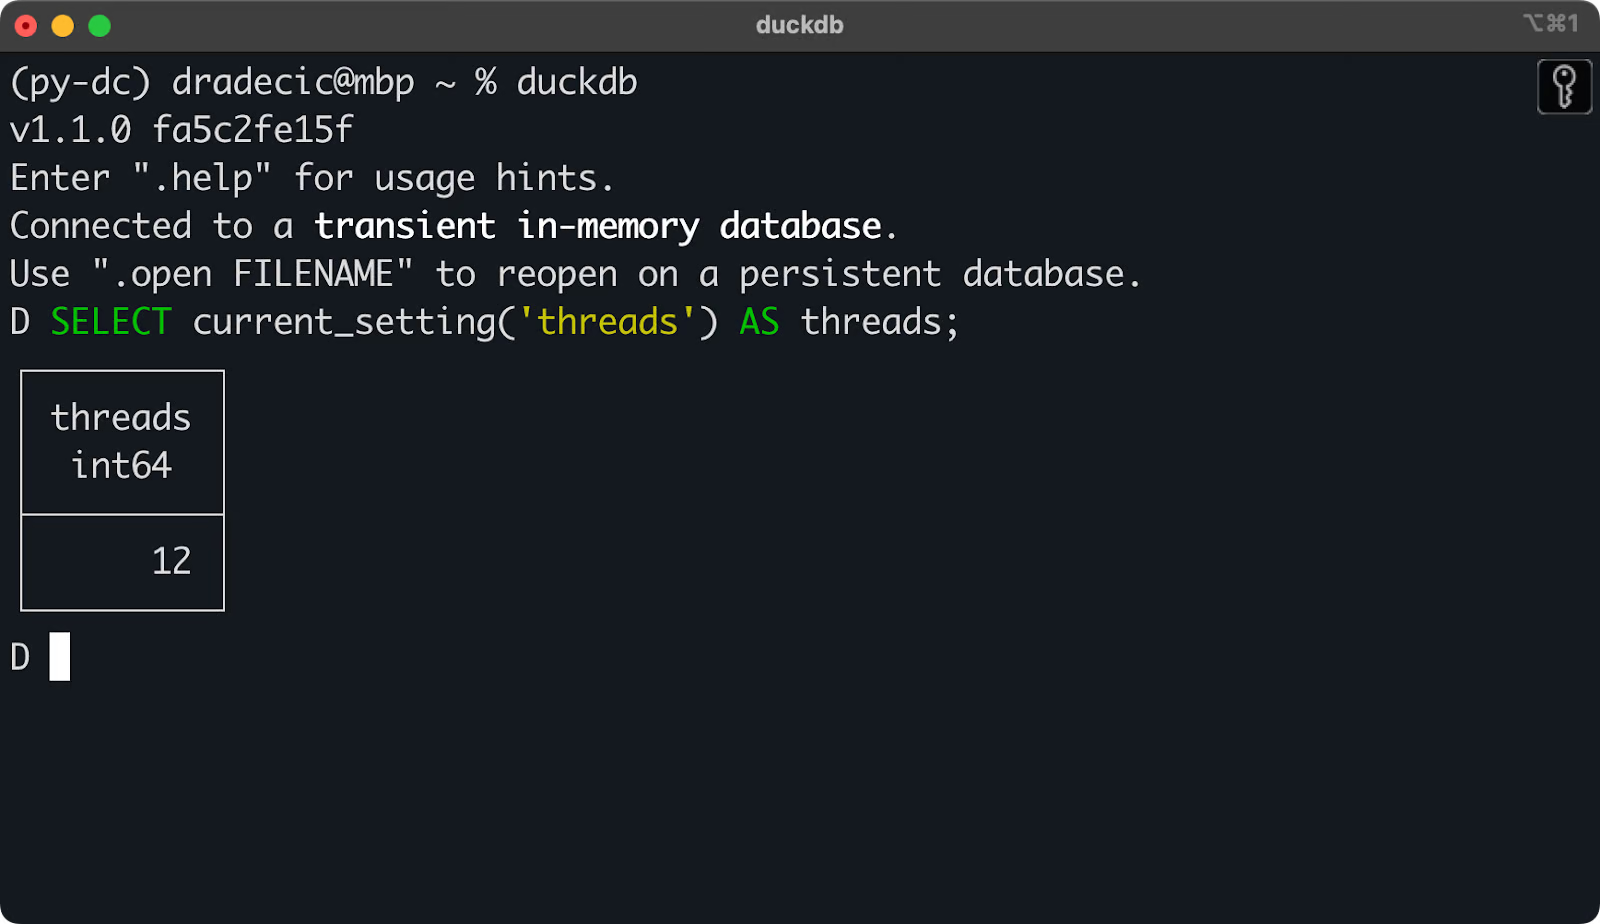
Nombre actuel de threads utilisés par DuckDB
Vous pouvez obtenir le même résultat depuis Python.
Pour modifier le nombre de threads, utilisez SET threads = N.
Dans le code suivant, je définis une fonction Python qui exécute une requête DuckDB avec un nombre de threads donné, convertit le résultat en DataFrame pandas et renvoie le temps d'exécution (entre autres). Le code sous la fonction la lance pour un intervalle de 1 à 12 threads:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Vous devriez obtenir un résultat similaire au mien:
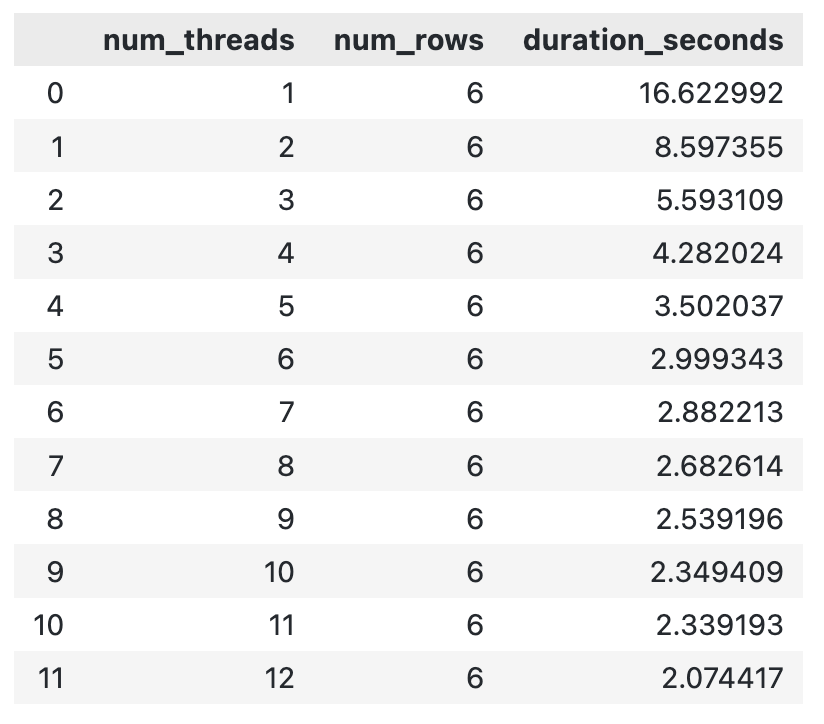
Temps d'exécution DuckDB selon le nombre de threads
De manière générale, plus vous allouez de threads, plus le calcul finit vite. Il peut exister un surcoût à créer de nouveaux threads qui allonge le temps total, mais je ne l'ai pas rencontré dans cette plage.
Je vais maintenant écrire un pipeline de données de A à Z. Simple: lecture disque, agrégations et écriture des résultats. L'objectif est de montrer le gain obtenu en passant de pandas à DuckDB. Et votre code sera aussi plus lisible.
Ce n'est pas une introduction exhaustive aux processus ETL/ELT, mais un survol.
Le pipeline que je vais vous montrer réalise:
Après exécution, vous devriez obtenir exactement les mêmes agrégations pour les deux implémentations (hors différences d'arrondi) :
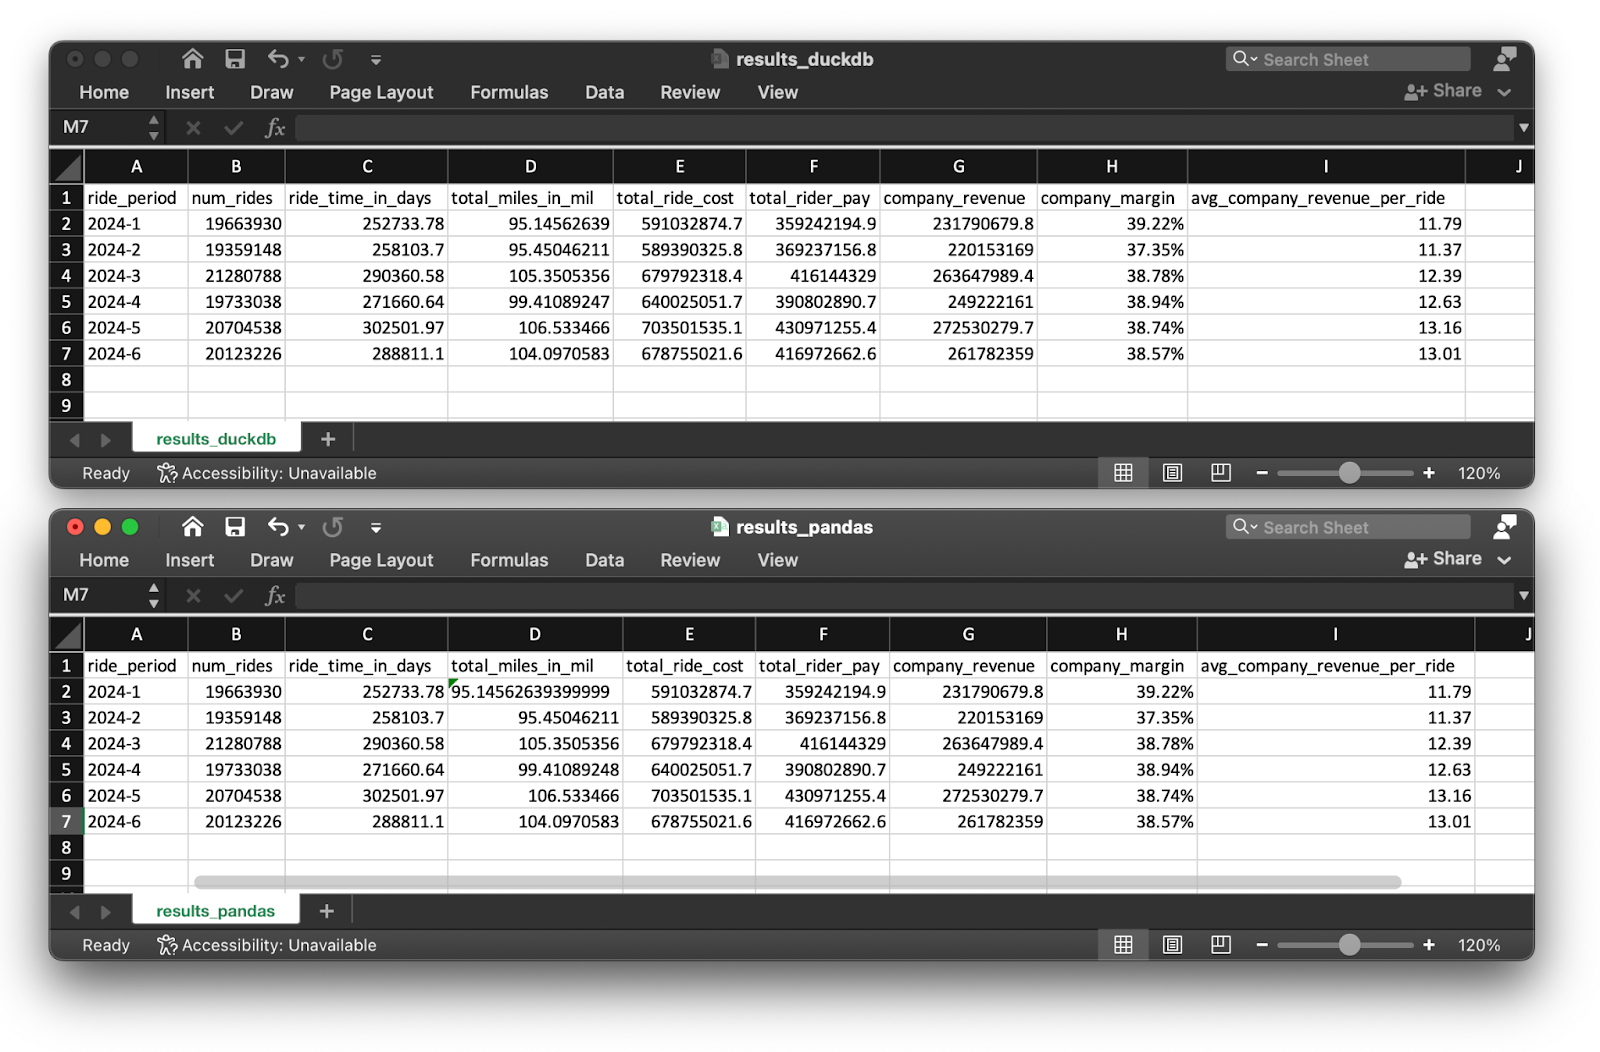
Résultats du pipeline pour DuckDB et pandas
Commençons par l'implémentation en pandas.
Quelle que soit l'approche, je n'ai pas pu traiter les 6 fichiers Parquet en une fois. Des avertissements système comme celui-ci apparaissaient en quelques secondes:
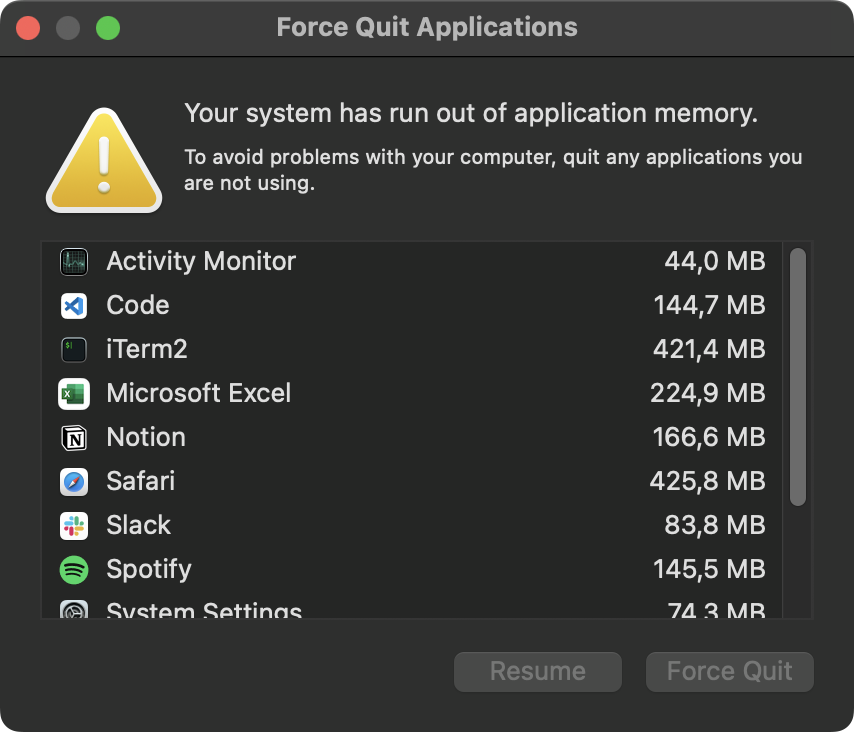
Erreur de mémoire système
Apparemment, 36 Go de mémoire ne suffisent pas pour 120 millions de lignes d'un coup. Le script Python a donc été stoppé:
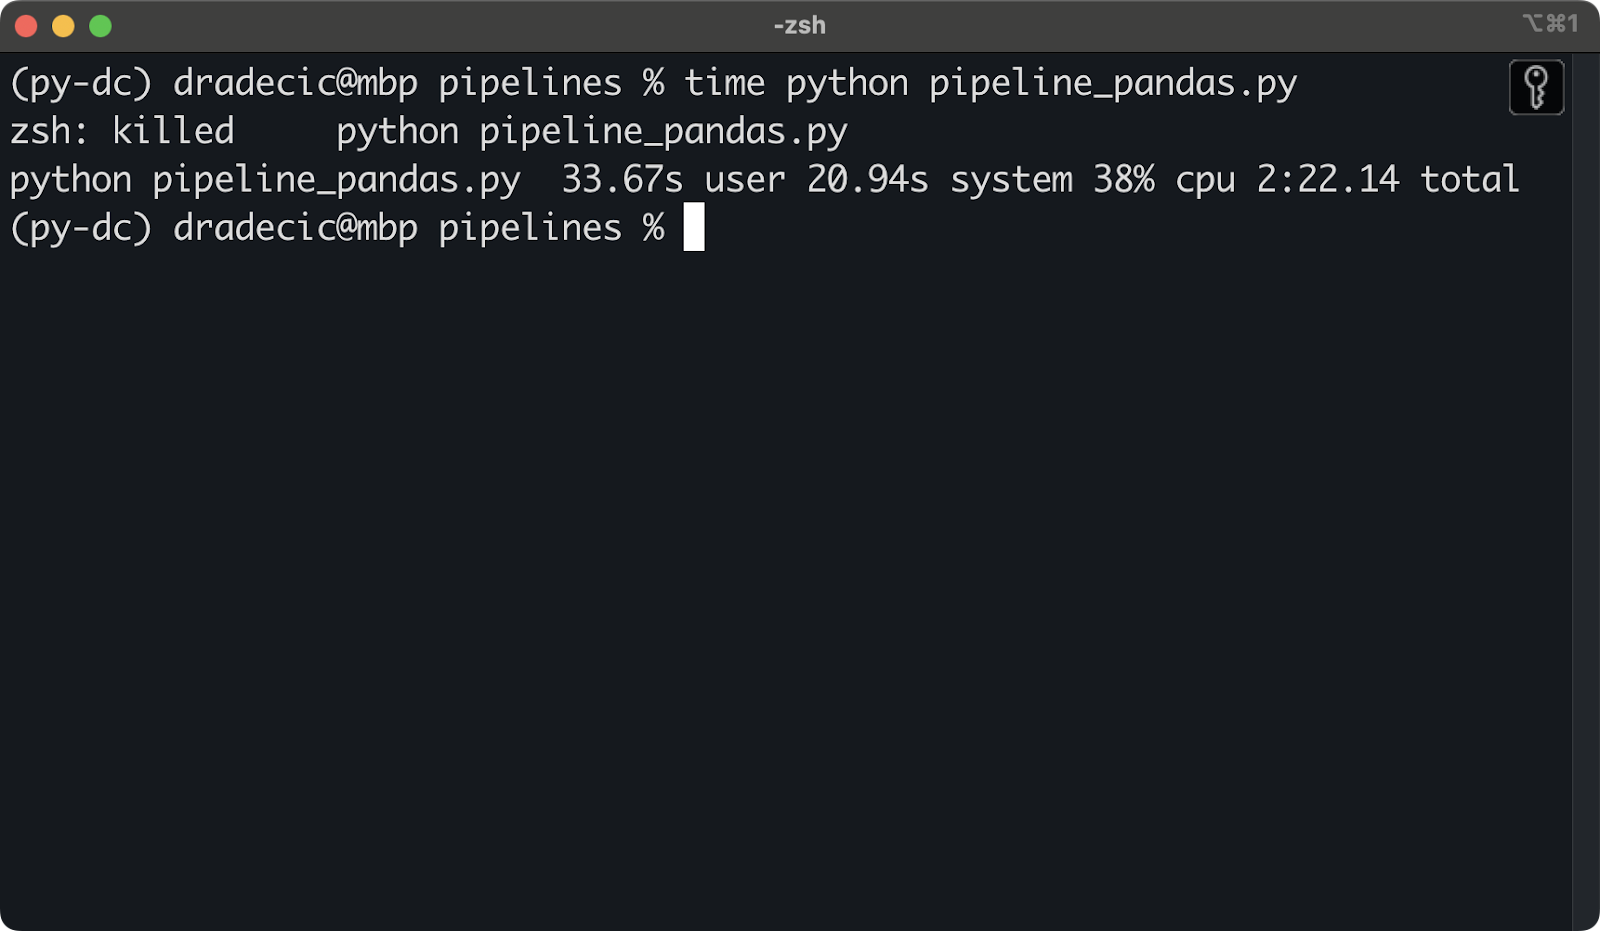
Script Python interrompu par manque de mémoire
Pour contourner le problème, j'ai traité les fichiers Parquet séquentiellement. Voici le code du pipeline:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
L'implémentation DuckDB devrait, elle, se terminer sans souci de mémoire.
Vous connaissez déjà la plus grande partie du code DuckDB.
La seule nouveauté est le SELECT le plus externe, qui calcule des statistiques additionnelles. Le reste est inchangé:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Voyons maintenant les différences de temps d'exécution.
Après 5 exécutions de chaque pipeline et moyennage, voici les temps obtenus:
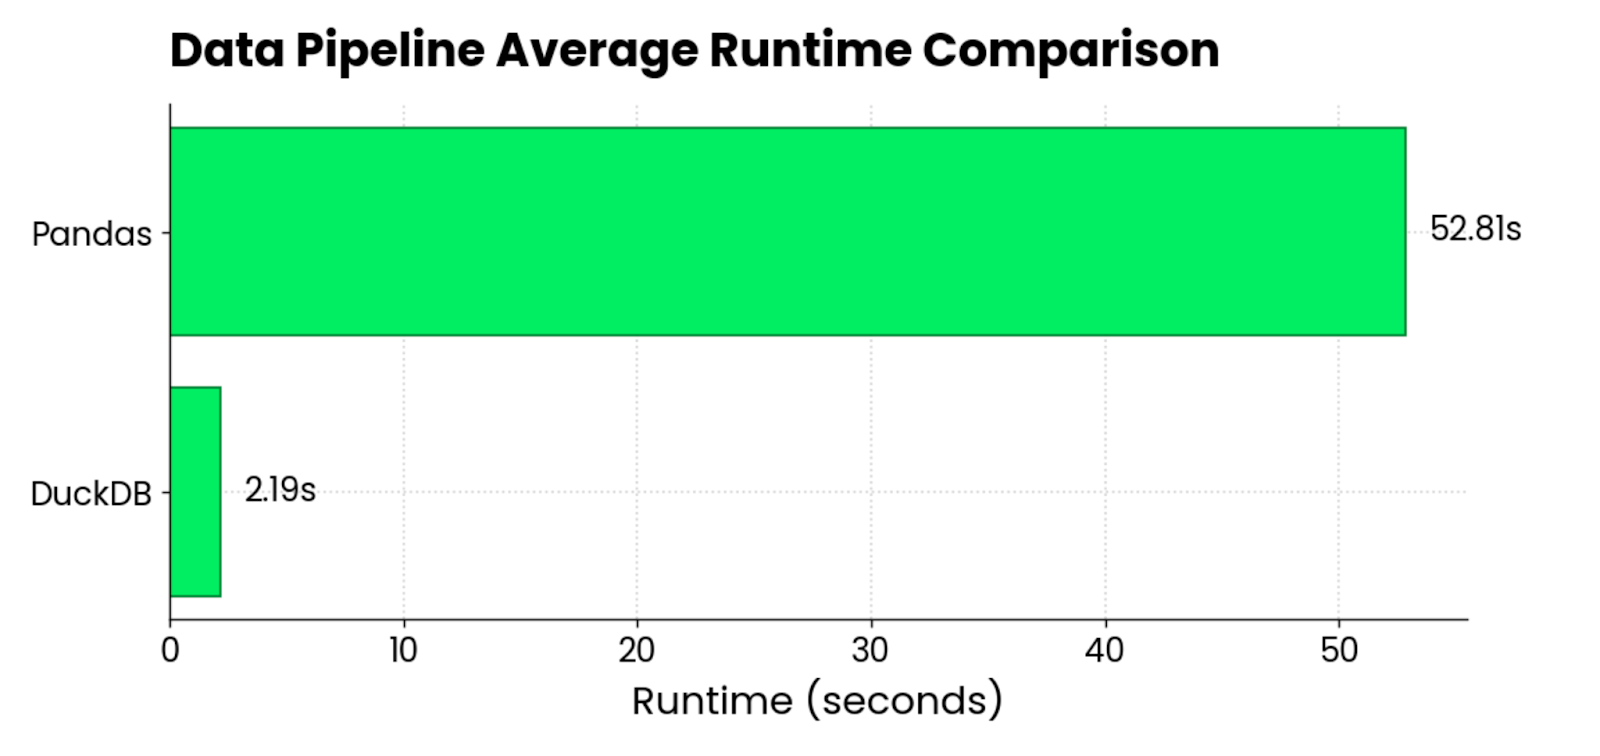
Comparaison des temps d'exécution DuckDB vs pandas
En moyenne, pandas est 24 fois plus lent que DuckDB pour charger et traiter environ 120 millions de lignes (∼ 3 Go) réparties sur 6 fichiers Parquet.
La comparaison n'est pas totalement équitable, puisque je n'ai pas pu traiter tous les fichiers en une fois avec pandas. Néanmoins, cela reflète bien la réalité rencontrée au quotidien.
Si une bibliothèque ne permet pas d'atteindre votre objectif, essayez-en une autre. Et la plus rapide dans la majorité des cas sera DuckDB.
Avant de vous laisser explorer DuckDB par vous-même, voici quelques bonnes pratiques génériques et spécifiques à l'ingénierie des données:
SELECT. Évitez-la pour des workflows avec des INSERT et UPDATE fréquents. Dans ce cas, préférez SQLite.En résumé, si vous êtes data engineer en charge de construire et optimiser des pipelines, vous devriez essayer DuckDB.
Vous n'avez rien à perdre et tout à gagner. C'est quasi garanti plus rapide que n'importe quelle bibliothèque Python. Cela tourne à toute vitesse sur votre ordinateur et permet de traiter des jeux de données qui feraient planter votre mémoire autrement. Et vous pouvez même vous connecter aux stockages cloud si vous ne souhaitez pas (ou ne pouvez pas) stocker localement.
Cela dit, DuckDB ne doit pas être votre unique levier d'optimisation. Optimisez toujours les données en entrée. Par exemple, abandonner CSV au profit de Parquet économise à la fois du calcul et du stockage. Vous pouvez aussi intégrer les principes de la modern data architecture dans vos workflows et pipelines.
DuckDB n'est qu'un outil. Mais un outil très puissant.
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Approfondissez l'ingénierie des données avec ces cours!
Cours
Cursus
Cursus