Khóa học
Tìm hiểu Data Engineering
2 giờ
377.9K
Như đã nói, DuckDB chạy trên laptop của bạn. Việc đầu tiên là cài đặt nó.
Tôi sẽ minh họa bước cài đặt trên macOS, nhưng hướng dẫn cho Windows và Linux cũng rất rõ ràng và dễ làm theo.
Nếu bạn dùng Mac, cách dễ nhất để cài DuckDB là qua Homebrew. Chạy lệnh sau trong shell:
brew install duckdbBạn sẽ thấy đầu ra như sau chỉ sau vài giây:
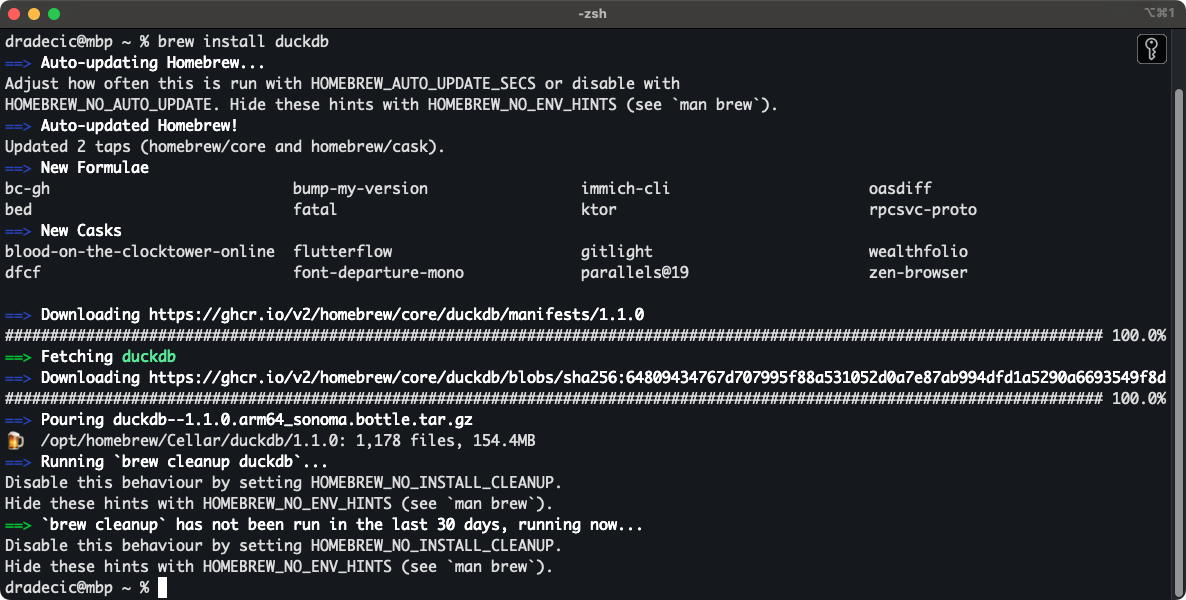
Cài đặt DuckDB bằng Homebrew
Sau khi cài xong, bạn có thể vào shell của DuckDB với lệnh sau:
duckdb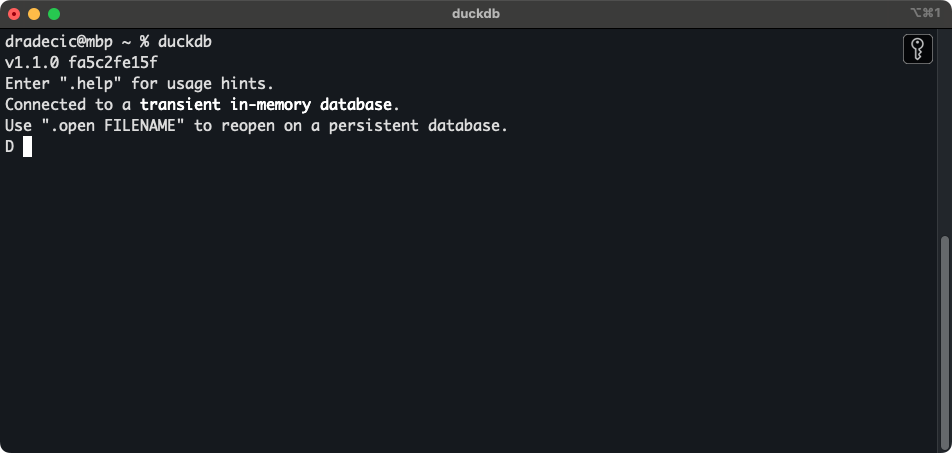
DuckDB shell
Từ đây, bạn có thể làm mọi thứ!
Bạn có thể viết và chạy truy vấn SQL trực tiếp từ console. Ví dụ, tôi đã tải 6 tháng đầu của Dữ liệu Taxi NYC cho năm 2024. Nếu bạn cũng làm vậy, dùng đoạn sau để hiển thị số dòng của một tệp Parquet:
SELECT COUNT(*)
  FROM PARQUET_SCAN("path-to-data.parquet");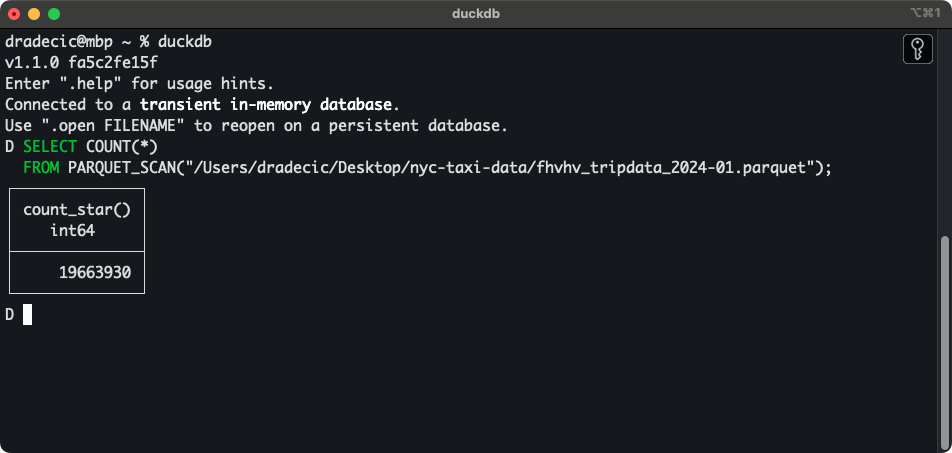
Số dòng của một tệp Parquet
Đúng vậy - gần 20 triệu dòng trong một tệp. Tôi đã tải 24 tệp như vậy.
Có lẽ bạn không muốn chạy DuckDB từ terminal, nên tiếp theo tôi sẽ hướng dẫn cách kết nối DuckDB với Python.
Mục tiêu phần này là chỉ cho bạn cách cấu hình và chạy DuckDB trong ngôn ngữ phổ biến nhất của kỹ sư dữ liệu: Python.
Thực tế, DataCamp có lộ trình nghề nghiệp hoàn chỉnh về kỹ sư dữ liệu với Python.
Python có thư viện DuckDB riêng cần cài trước. Chạy lệnh sau từ terminal, tốt nhất trong môi trường ảo:
pip install duckdbGiờ hãy tạo file Python mới và dán đoạn mã sau:
import duckdb
# Function to get the count from a single file
def get_row_count_from_file(conn: duckdb.DuckDBPyConnection, file_path: str) -> int:
    query = f"""
        SELECT COUNT(*)
        FROM PARQUET_SCAN("{file_path}")
    """
    return conn.sql(query).fetchone()[0]
if __name__ == "__main__":
    # In-memory database connection
    conn = duckdb.connect()
    # Path to a parquet file
    file_path = "fhvhv_tripdata_2024-01.parquet"
    # Get the row count
    row_count = get_row_count_from_file(conn=conn, file_path=file_path)
    print(row_count)
Tóm lại, đoạn code có một hàm lấy số dòng từ một tệp, khi có kết nối DuckDB hợp lệ và đường dẫn tệp.
Bạn sẽ nhận kết quả gần như tức thì sau khi chạy script:
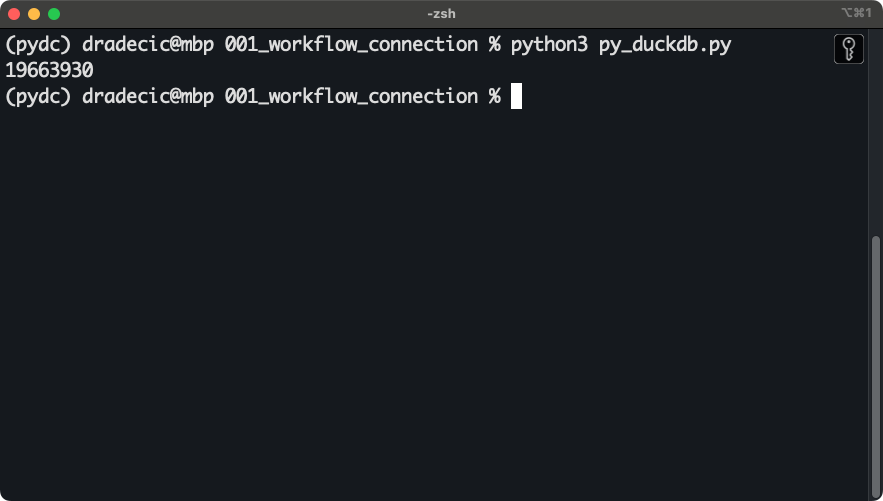
Kết nối DuckDB và Python
Vậy là xong!
Tiếp theo, tôi sẽ chỉ bạn cách làm những việc tuyệt vời với Python và DuckDB cực nhanh!
Để tham chiếu, tôi sẽ chạy code trên phần dữ liệu 2024 (tháng 1 - 6) của Bộ dữ liệu Taxi NYC - cụ thể là xe thuê theo hợp đồng có khối lượng lớn. Đó là 6 tệp Parquet, chiếm khoảng 3GB dung lượng đĩa. Về phần cứng, tôi dùng MacBook Pro 16” M3 Pro với 12 nhân CPU và 36GB bộ nhớ hợp nhất.
Kết quả của bạn có thể khác, nhưng vẫn nên ra số liệu tương tự.
Tôi đã chuyển 6 tệp này sang hai định dạng bổ sung - CSV và JSON. Bạn có thể thấy mỗi định dạng tốn bao nhiêu dung lượng đĩa:
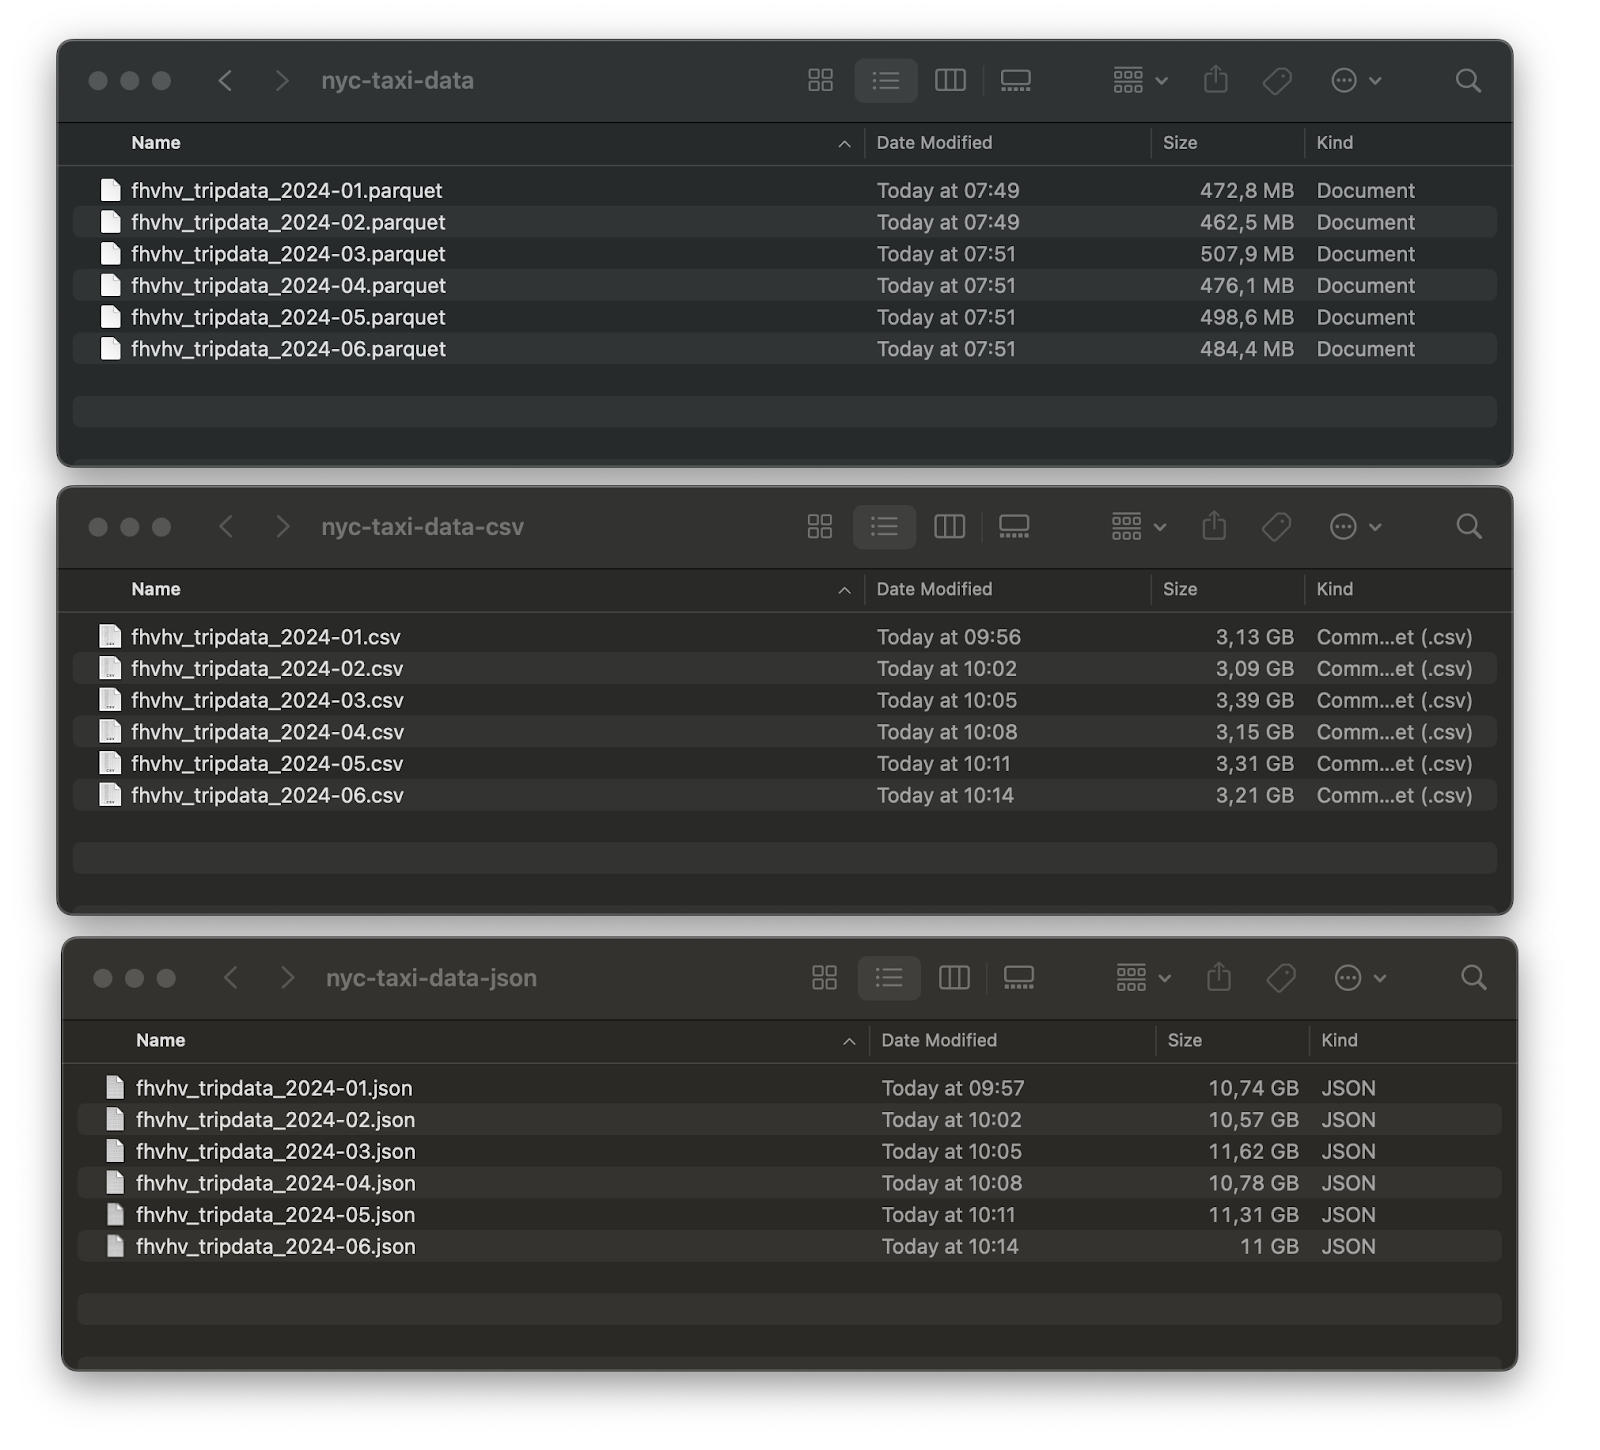
So sánh kích thước tập dữ liệu
Tổng: 2,96GB với Parquet, 19,31GB với CSV, và 66,04GB với JSON.
Khác biệt quá lớn! Nếu không nhớ gì khác từ bài hôm nay, thì hãy nhớ luôn dùng định dạng Parquet khi xử lý tệp lớn. Nó sẽ tiết kiệm cả thời gian xử lý và dung lượng đĩa.
DuckDB có các hàm tiện lợi có thể đọc nhiều tệp cùng định dạng đồng thời (dùng glob pattern). Tôi sẽ dùng để đọc cả sáu tệp nhằm lấy số dòng và so sánh thời gian chạy:
import duckdb
import pandas as pd
from datetime import datetime
def get_row_count_and_measure_time(file_format: str) -> str:
    # Construct a DuckDB query based on the file_format
    match file_format:
        case "csv":
            query = """
            SELECT COUNT(*)
            FROM READ_CSV("nyc-taxi-data-csv/*.csv")
            """
        case "json":
            query = """
            SELECT COUNT(*)
            FROM READ_JSON("nyc-taxi-data-json/*.json")
            """
        case "parquet":
            query = """
                SELECT COUNT(*)
                FROM READ_PARQUET("nyc-taxi-data/*.parquet")
            """
        case _:
            raise KeyError("Param file_format must be in [csv, json, parquet]")
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Get the row count
    row_count = conn.sql(query).fetchone()[0]
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "file_format": file_format,
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000,
        "row_count": row_count
    }
# Run the function
file_format_results = []
for file_format in ["csv", "json", "parquet"]:
    file_format_results.append(get_row_count_and_measure_time(file_format=file_format))
pd.DataFrame(file_format_results)
Kết quả đã có - chỉ có một kẻ chiến thắng rõ ràng:
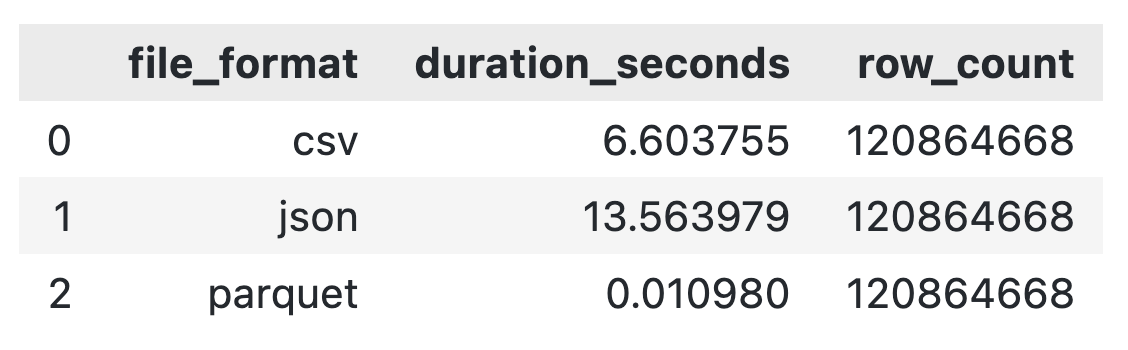
So sánh thời gian đọc tệp
Nhờ DuckDB, cả ba đều nhanh và cho cùng kết quả, nhưng rõ ràng Parquet thắng với hệ số 600 so với CSV và hệ số 1200 so với JSON.
Vì lý do này, phần còn lại của bài tôi chỉ dùng Parquet.
DuckDB cho phép bạn tổng hợp dữ liệu bằng SQL.
Mục tiêu phần này là khai triển ý tưởng đó. Cụ thể hơn, tôi sẽ chỉ cách tính thống kê tổng hợp theo tháng gồm số chuyến, thời gian chuyến, quãng đường, chi phí chuyến và tiền trả cho tài xế — tất cả từ 120 triệu dòng dữ liệu.
Điều tuyệt nhất: Chỉ mất hai giây!
Đây là đoạn code tôi dùng trong một script Python để tổng hợp dữ liệu và in kết quả:
conn = duckdb.connect()
query = """
    SELECT
        ride_year || '-' || ride_month AS ride_period,
        COUNT(*) AS num_rides,
        ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
        ROUND(SUM(trip_miles), 2) AS total_miles,
        ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
        ROUND(SUM(driver_pay), 2) AS total_rider_pay
    FROM (
        SELECT
            DATE_PART('year', pickup_datetime) AS ride_year,
            DATE_PART('month', pickup_datetime) AS ride_month,
            trip_time,
            trip_miles,
            base_passenger_fare,
            tolls,
            bcf,
            sales_tax,
            congestion_surcharge,
            airport_fee,
            tips,
            driver_pay
        FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
        WHERE
            ride_year = 2024
        AND ride_month >= 1
        AND ride_month <= 6
    )
    GROUP BY ride_period
    ORDER BY ride_period
"""
# Aggregate data, print it, and show the data type
results = conn.sql(query)
results.show()
print(type(results))
Đầu ra gồm kết quả tổng hợp, kiểu biến của results, và tổng thời gian chạy:
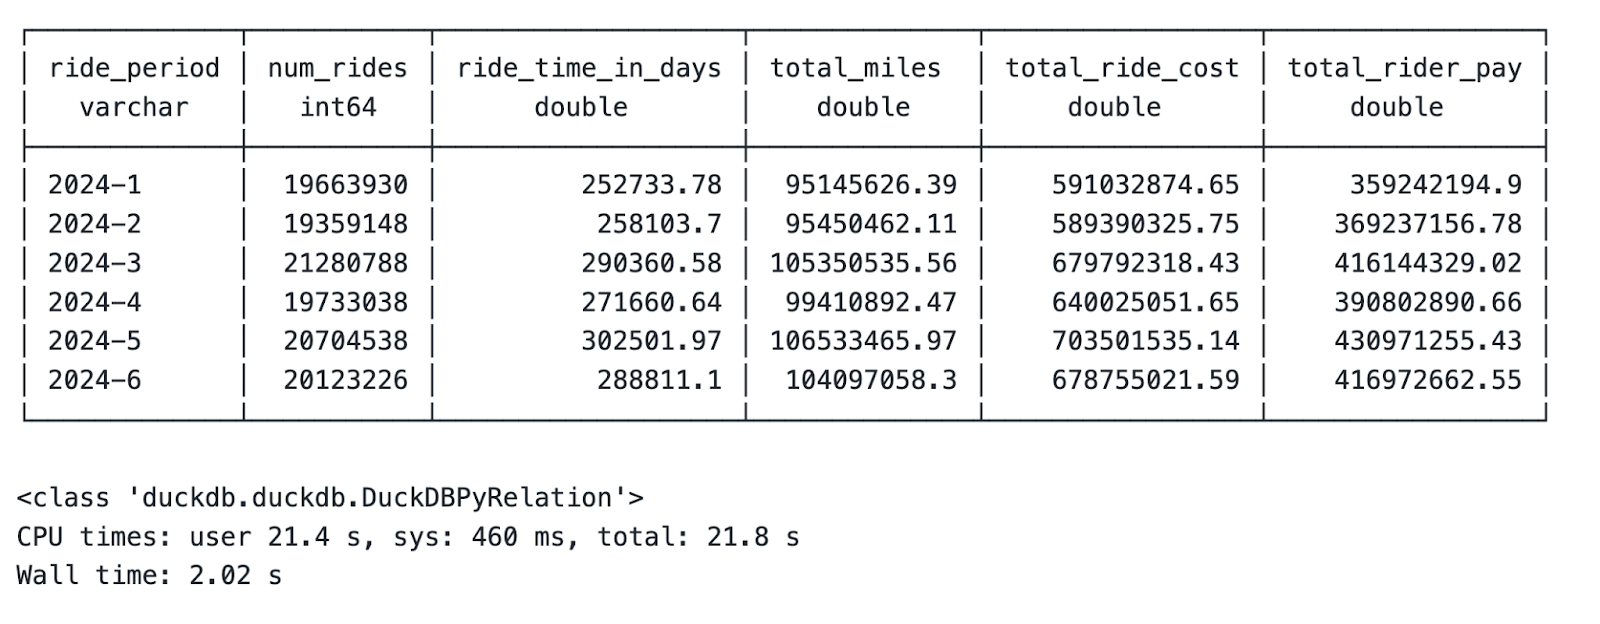
Tổng hợp thống kê theo tháng
Hãy ngẫm xem: 3GB dữ liệu với hơn 120 triệu dòng, tất cả được tổng hợp trong 2 giây trên laptop!
Vấn đề duy nhất là kiểu biến hơi khó dùng về lâu dài. May mắn, có cách khắc phục dễ dàng.
Ưu điểm của DuckDB không chỉ là nhanh, mà còn tích hợp tốt với thư viện dataframe ưa thích của bạn: pandas.
Nếu bạn có một tập kết quả tạm thời như trên, bạn chỉ cần gọi phương thức .df() để chuyển nó thành DataFrame của pandas:
# Convert to Pandas DataFrame
results_df = results.df()
# Print the type and contents
print(type(results_df))
results_df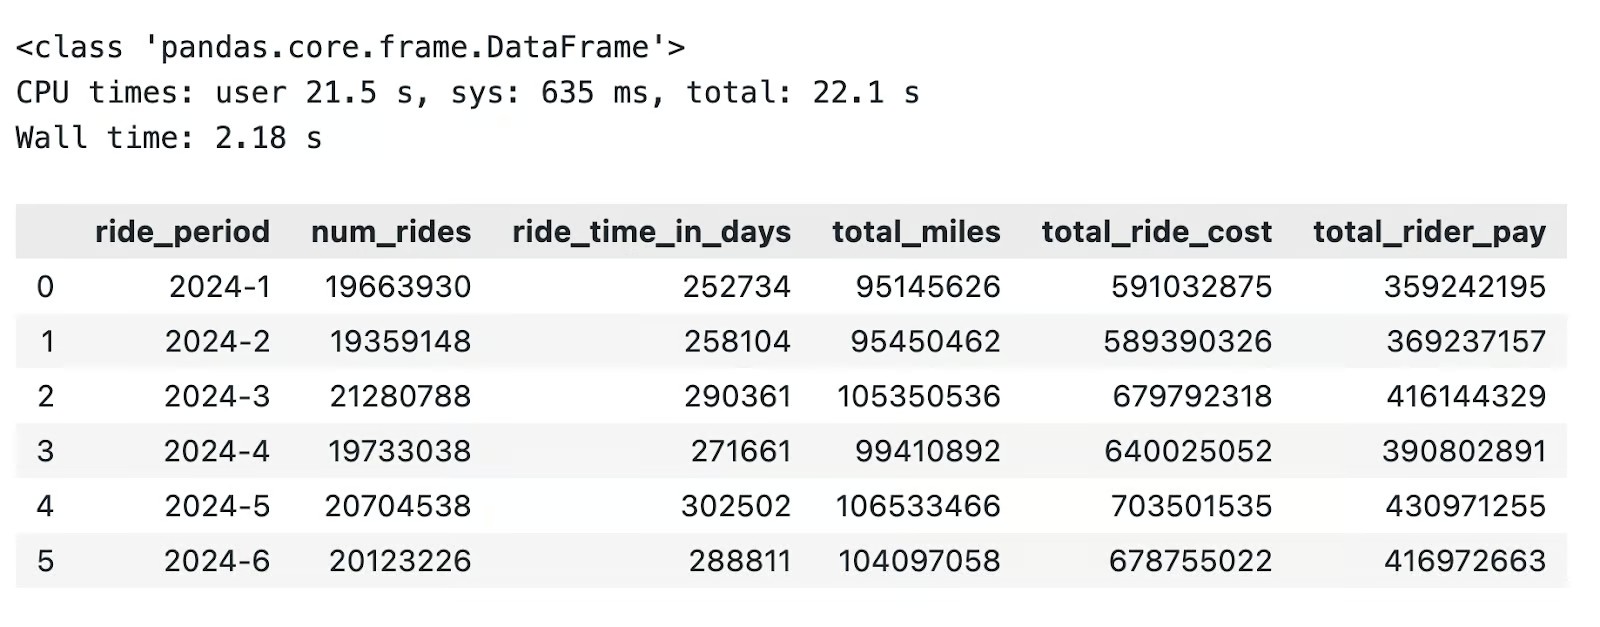
Chuyển DuckDB sang pandas
Tương tự, bạn có thể dùng DuckDB để tính toán trên các pandas DataFrame đã nạp vào bộ nhớ.
Mấu chốt là tham chiếu tên biến sau từ khóa FROM trong truy vấn SQL DuckDB. Ví dụ:
# Pandas DataFrame
pandas_df = pd.read_parquet("nyc-taxi-data/fhvhv_tripdata_2024-01.parquet")
# Run SQL queries through DuckDB
duckdb_res = duckdb.sql("""
    SELECT
        pickup_datetime,
        dropoff_datetime,
        trip_miles,
        trip_time,
        driver_pay
    FROM pandas_df
    WHERE trip_miles >= 300
""").df()
duckdb_res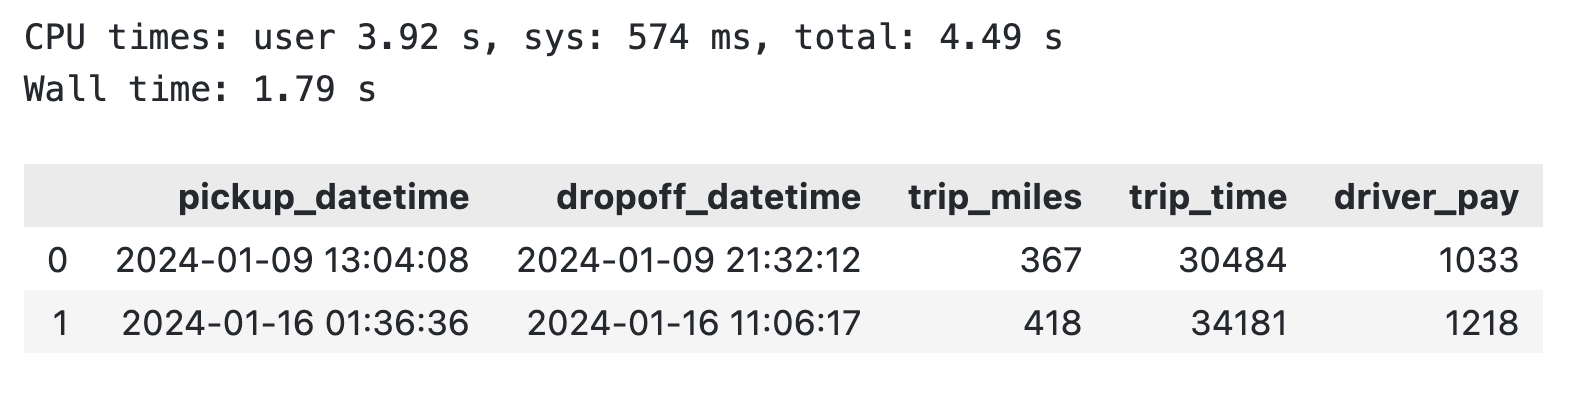
Truy vấn DuckDB trên pandas DataFrame hiện có
Tóm lại, bạn có thể bỏ qua pandas hoàn toàn hoặc thực hiện tổng hợp nhanh hơn trên các pandas DataFrame hiện có.
Tiếp theo, tôi sẽ giới thiệu một vài tính năng DuckDB nâng cao.
DuckDB còn nhiều điều thú vị hơn bạn thấy ban đầu.
Trong phần này, tôi sẽ hướng dẫn một vài tính năng nâng cao của DuckDB thiết yếu với kỹ sư dữ liệu.
DuckDB cho phép bạn mở rộng chức năng gốc thông qua phần mở rộng cốt lõi và cộng đồng extensions. Tôi thường xuyên dùng extensions để kết nối hệ thống lưu trữ đám mây và cơ sở dữ liệu, cũng như làm việc với định dạng tệp bổ sung.
Bạn có thể cài extensions cả từ Python lẫn console DuckDB.
Trong đoạn dưới, tôi minh họa cách cài extension httpfs cần thiết để kết nối AWS và đọc dữ liệu S3:
import duckdb
conn = duckdb.connect()
conn.execute("""
    INSTALL httpfs;
    LOAD httpfs;
""")
Bạn sẽ không thấy đầu ra nếu không nối thêm phương thức .df() vào conn.execute(). Nếu có, bạn sẽ thấy thông báo “Success” hoặc “Error”.
Thường thì công ty sẽ cấp quyền truy cập dữ liệu bạn cần đưa vào pipeline. Các dữ liệu này thường lưu trên các nền tảng đám mây có khả năng mở rộng, như AWS S3.
DuckDB cho phép bạn kết nối trực tiếp S3 (và các nền tảng khác).
Tôi đã chỉ cách cài extension (httpfs), việc còn lại là cấu hình. AWS yêu cầu bạn cung cấp vùng, access key và secret access key.
Giả sử bạn có đủ, hãy chạy lệnh sau qua Python:
conn.execute("""    CREATE SECRET aws_s3_secret (
        TYPE S3,
        KEY_ID '<your-access-key>',
        SECRET '<your-secret-key>',
        REGION '<your-region>'
    );
""")
Bucket S3 của tôi chứa hai tệp từ bộ dữ liệu Taxi New York:
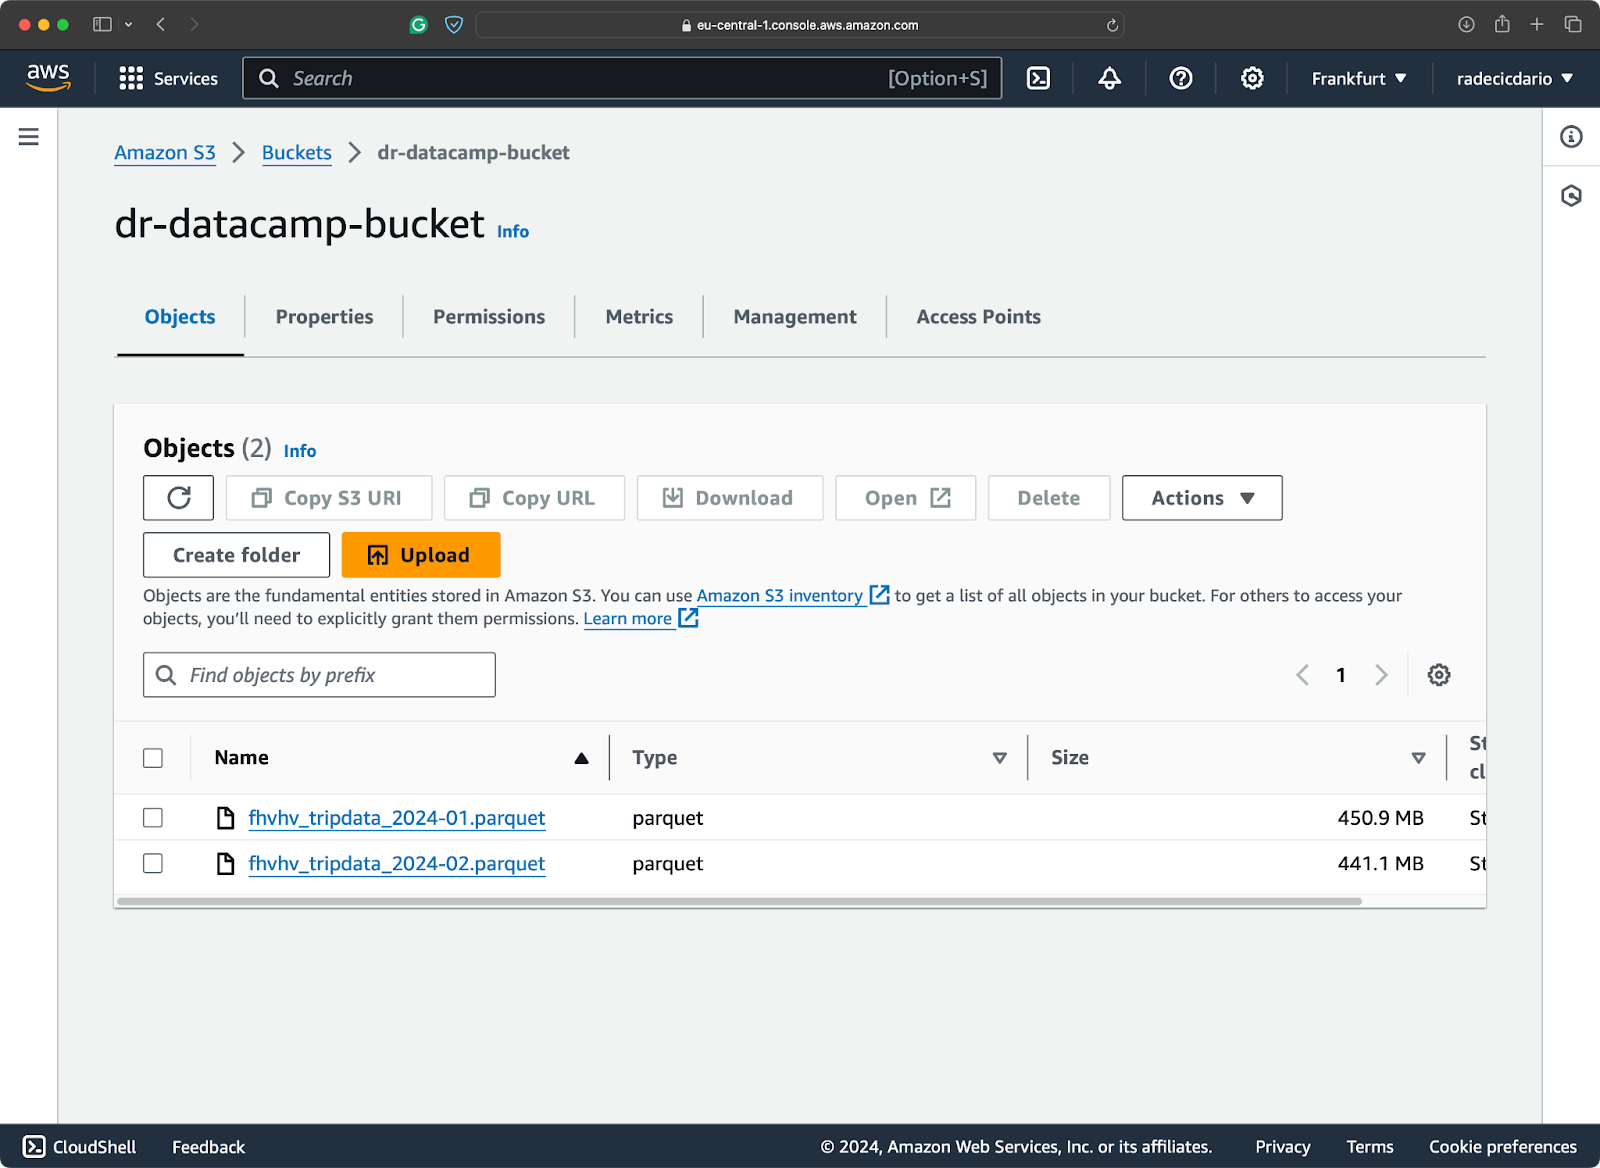
Nội dung bucket S3
Không cần tải tệp về, vì bạn có thể quét trực tiếp từ S3:
import duckdb
conn = duckdb.connect()
aws_count = conn.execute("""
    SELECT COUNT(*)
    FROM PARQUET_SCAN('s3://<your-bucket-name>/*.parquet');
""").df()
aws_count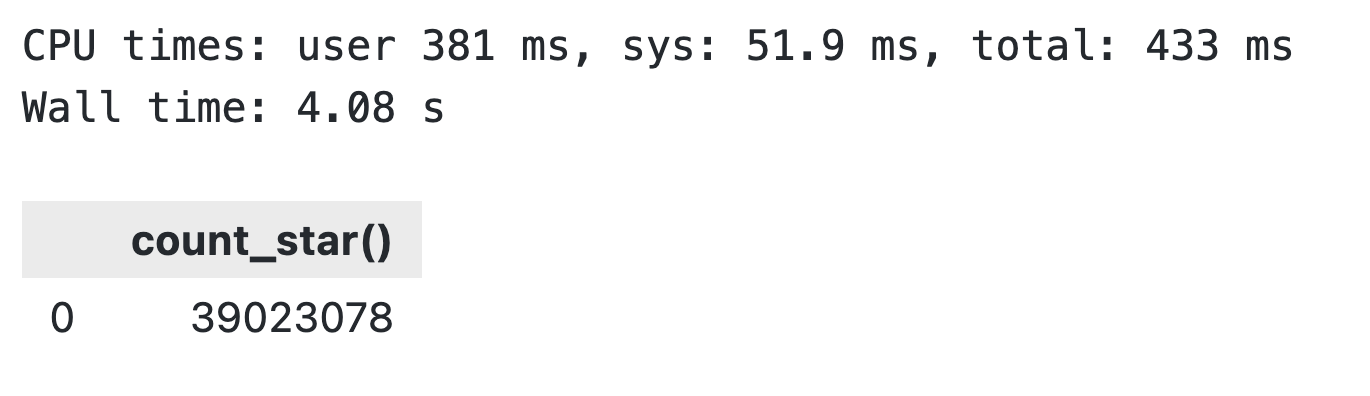
Kết quả truy xuất S3 bằng DuckDB
Bạn không nhìn nhầm đâu: Chỉ mất 4 giây để duyệt ~900MB dữ liệu trong một bucket S3.
Về song song hóa, DuckDB triển khai mặc định dựa trên row group: các phân vùng dữ liệu ngang thường thấy trong Parquet. Một row group có tối đa 122.880 dòng.
Tính song song trong DuckDB bắt đầu khi bạn làm việc với hơn 122.880 dòng.
DuckDB sẽ tự động khởi chạy thread mới khi điều này xảy ra. Mặc định, số thread bằng số lõi CPU. Nhưng bạn vẫn có thể tự điều chỉnh số thread.
Trong phần này, tôi sẽ chỉ cách thực hiện và tác động cụ thể của số thread khác nhau lên cùng một khối lượng công việc.
Để xem số thread hiện tại, chạy lệnh sau:
SELECT current_setting('threads') AS threads;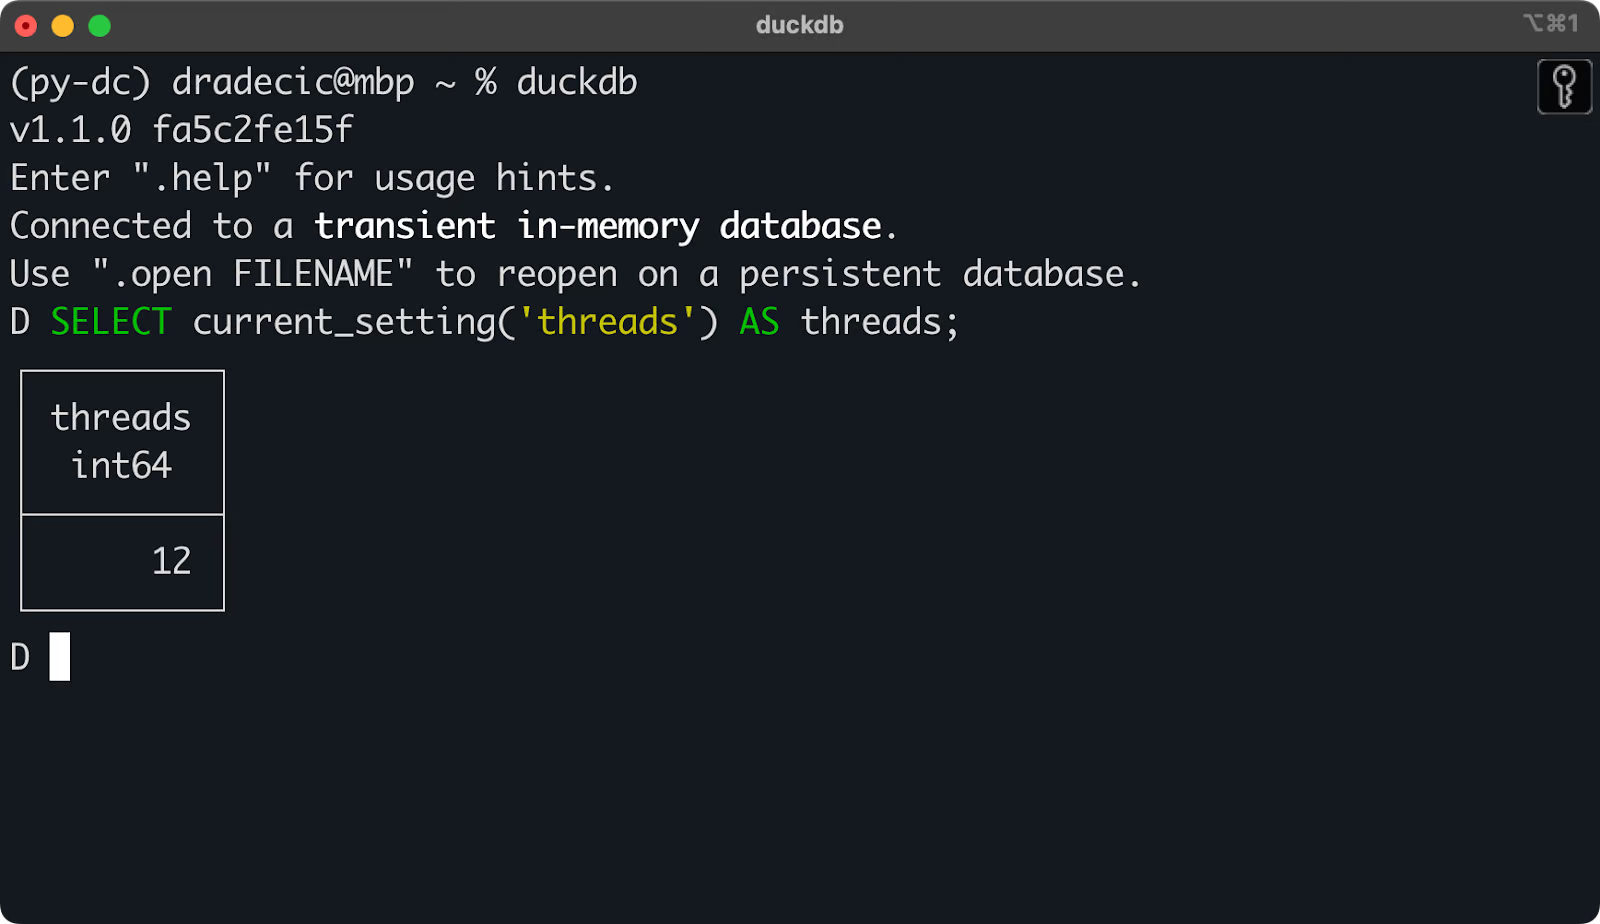
Số thread hiện tại DuckDB đang dùng
Bạn có thể lấy kết quả tương tự qua Python.
Bạn sẽ muốn chạy lệnh SET threads = N để đổi số thread.
Trong đoạn dưới, tôi cho thấy cách viết một hàm Python tùy chỉnh chạy truy vấn DuckDB với số thread cho trước, chuyển kết quả sang pandas DataFrame, và trả về thời gian chạy (cùng thông tin khác). Đoạn code bên dưới hàm sẽ chạy nó trong khoảng [1, 12] thread:
def thread_test(n_threads: int) -> dict:
    # Open the database connection and measure the start time
    time_start = datetime.now()
    conn = duckdb.connect()
    # Set the number of threads
    conn.execute(f"SET threads = {n_threads};")
    query = """
        SELECT
            ride_year || '-' || ride_month AS ride_period,
            COUNT(*) AS num_rides,
            ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
            ROUND(SUM(trip_miles), 2) AS total_miles,
            ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
            ROUND(SUM(driver_pay), 2) AS total_rider_pay
        FROM (
            SELECT
                DATE_PART('year', pickup_datetime) AS ride_year,
                DATE_PART('month', pickup_datetime) AS ride_month,
                trip_time,
                trip_miles,
                base_passenger_fare,
                tolls,
                bcf,
                sales_tax,
                congestion_surcharge,
                airport_fee,
                tips,
                driver_pay
            FROM PARQUET_SCAN("nyc-taxi-data/*.parquet")
            WHERE
                ride_year = 2024
            AND ride_month >= 1
            AND ride_month <= 6
        )
        GROUP BY ride_period
        ORDER BY ride_period
    """
    # Convert to DataFrame
    res = conn.sql(query).df()
    # Close the database connection and measure the finish time
    conn.close()
    time_end = datetime.now()
    return {
        "num_threads": n_threads,
        "num_rows": len(res),
        "duration_seconds": (time_end - time_start).seconds + ((time_end - time_start).microseconds) / 1000000
    }
thread_results = []
for n_threads in range(1, 13):
    thread_results.append(thread_test(n_threads=n_threads))
pd.DataFrame(thread_results)
Bạn sẽ thấy đầu ra tương tự của tôi:
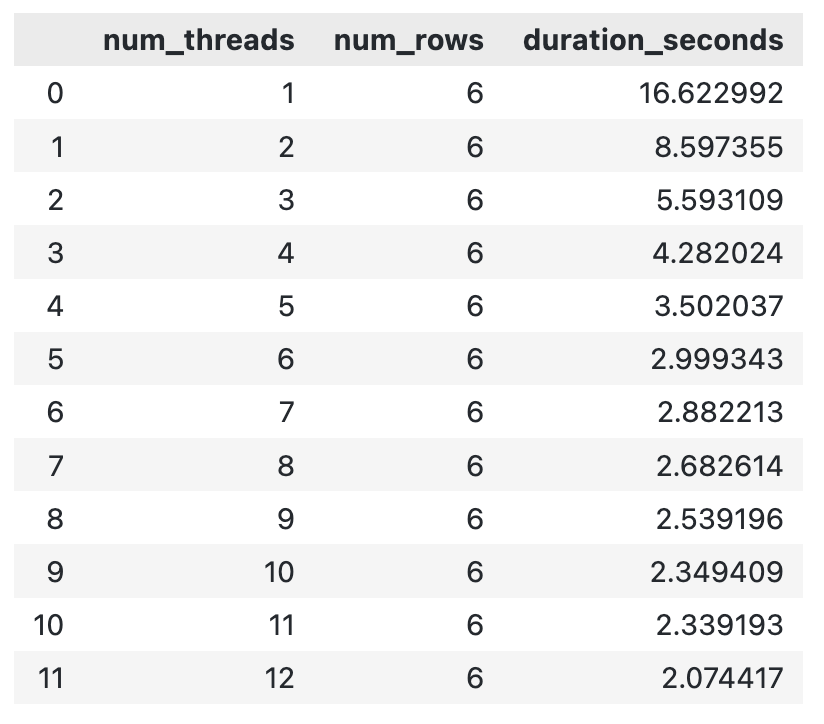
Thời gian chạy DuckDB với số thread khác nhau
Nói chung, càng nhiều thread cho một phép tính, nó càng hoàn thành nhanh. Có thể đến một ngưỡng mà chi phí overhead tạo thread mới sẽ làm tăng tổng thời gian, nhưng tôi chưa gặp trong khoảng này.
Trong phần này, tôi sẽ chỉ bạn cách viết một pipeline dữ liệu từ đầu. Nó khá đơn giản: đọc dữ liệu từ đĩa, thực hiện tổng hợp, và ghi kết quả. Mục tiêu là cho thấy bạn có thể cải thiện hiệu năng bao nhiêu khi chuyển từ pandas sang DuckDB. Không chỉ vậy, code của bạn cũng sẽ gọn gàng hơn.
Đây không phải phần giới thiệu toàn diện về quy trình ETL/ELT mà là cái nhìn tổng quan.
Pipeline tôi sắp trình bày thực hiện các việc sau:
Sau khi chạy code, bạn sẽ thu được kết quả tổng hợp giống hệt nhau cho cả hai cách triển khai pipeline (không tính một số khác biệt do làm tròn):
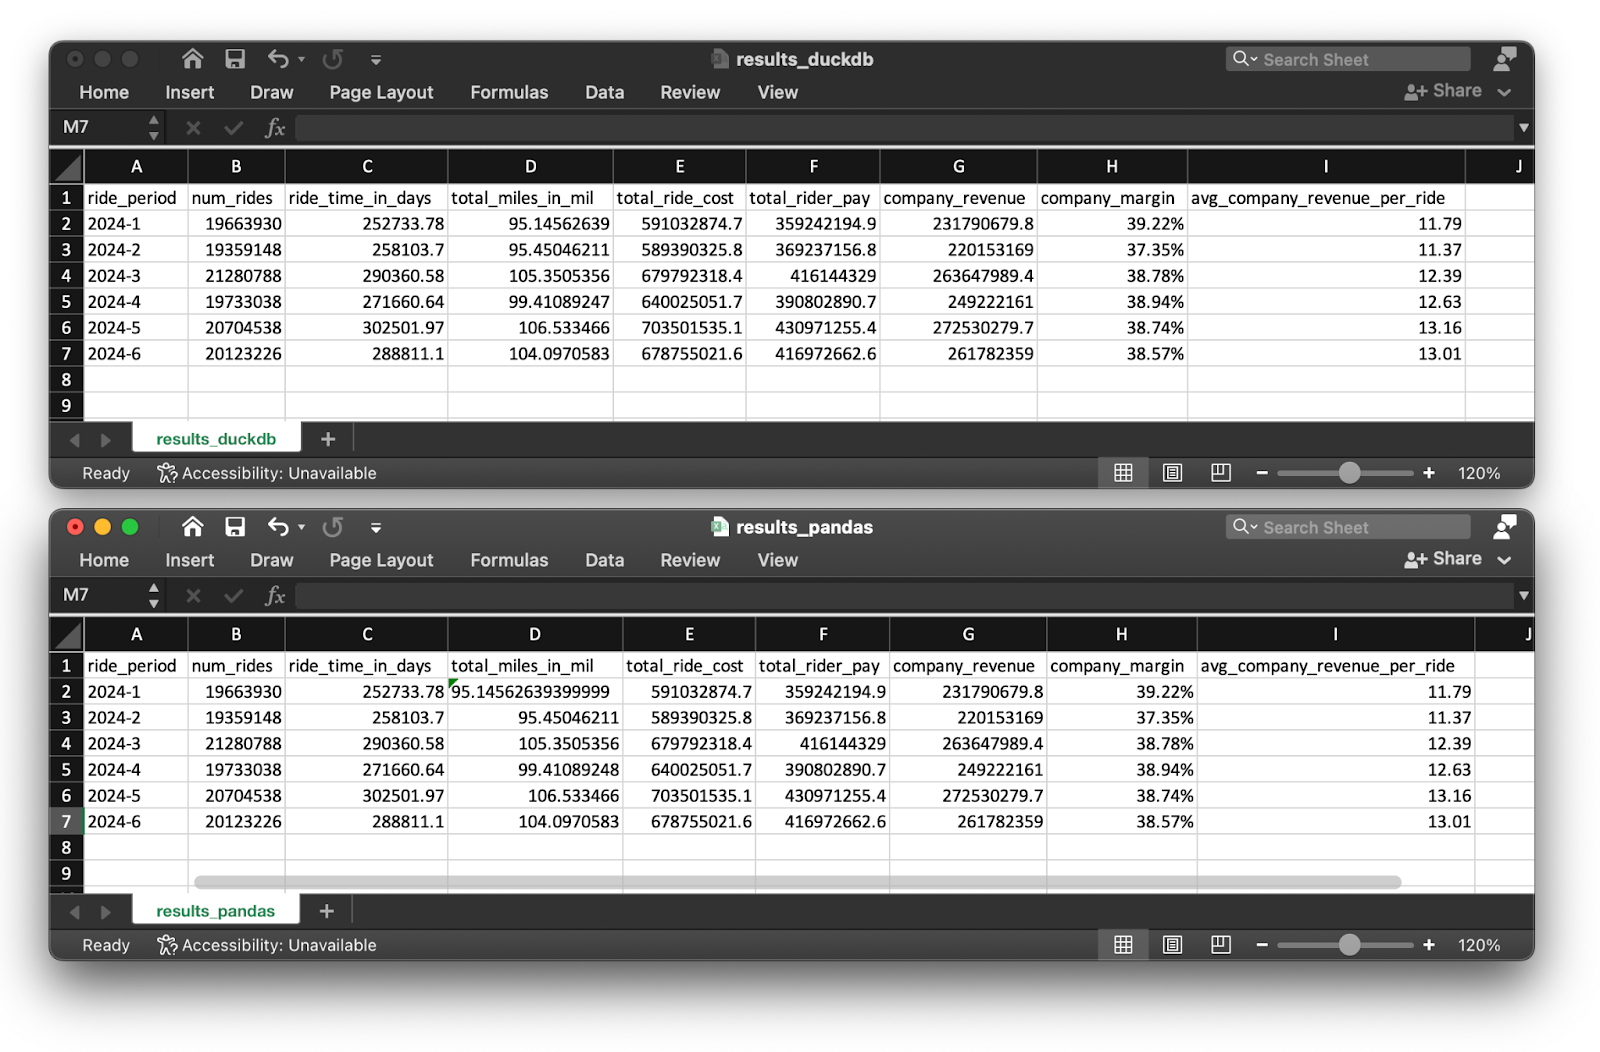
Kết quả pipeline cho DuckDB và pandas
Đầu tiên, hãy xem cách triển khai pipeline bằng pandas.
Dù thử nhiều cách, tôi không thể xử lý cả 6 tệp Parquet cùng lúc. Thông báo cảnh báo hệ thống như dưới xuất hiện chỉ sau vài giây:
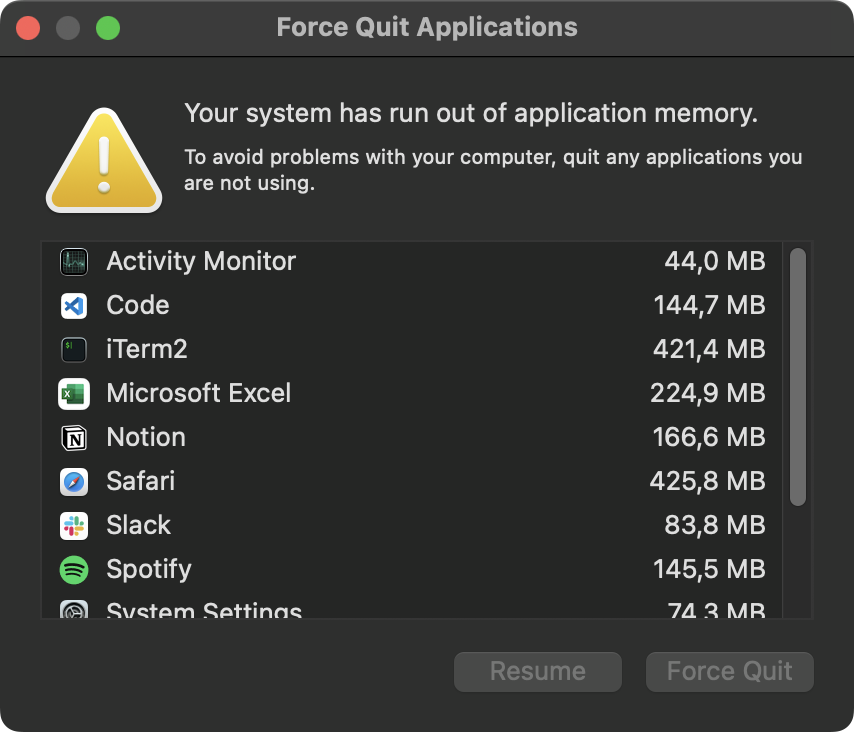
Lỗi bộ nhớ hệ thống
Có vẻ 36GB bộ nhớ không đủ để xử lý 120 triệu dòng cùng lúc. Kết quả là script Python bị kill:
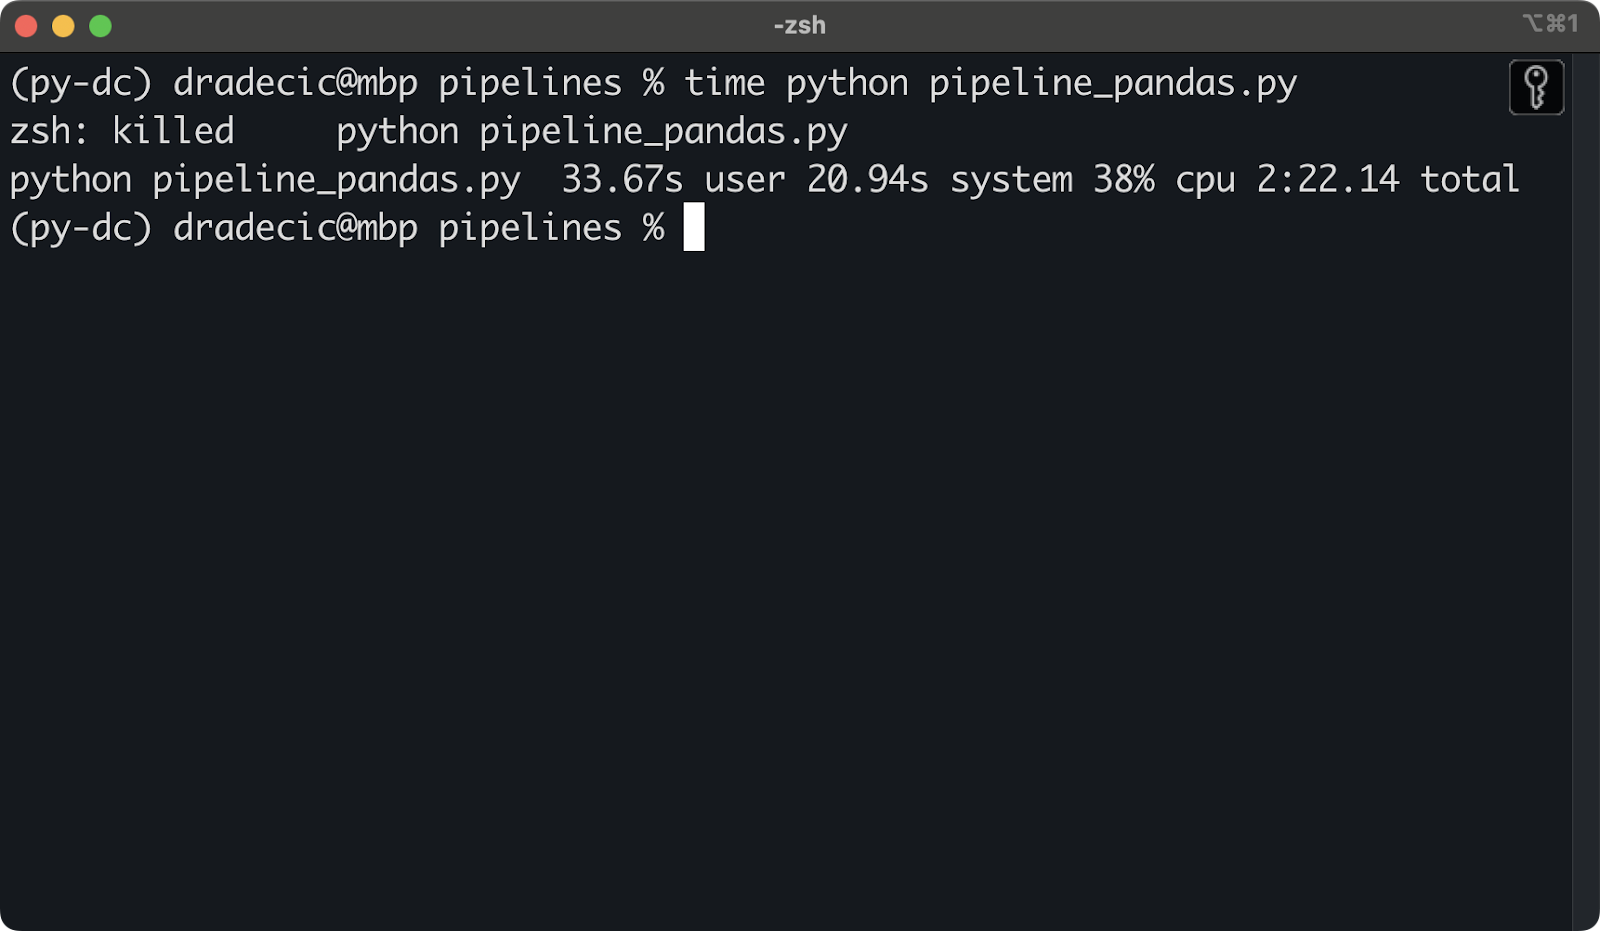
Script Python bị kill do thiếu bộ nhớ
Để khắc phục, tôi phải xử lý các tệp Parquet tuần tự. Đây là code tôi dùng cho pipeline dữ liệu:
import os
import pandas as pd
def calculate_monthly_stats_per_file(file_path: str) -> pd.DataFrame:
    # Read a single Parquet file
    df = pd.read_parquet(file_path)
    # Extract ride year and month
    df["ride_year"] = df["pickup_datetime"].dt.year
    df["ride_month"] = df["pickup_datetime"].dt.month
    # Remove data points that don"t fit in the time period
    df = df[(df["ride_year"] == 2024) & (df["ride_month"] >= 1) & (df["ride_month"] <= 6)]
    # Combine ride year and month
    df["ride_period"] = df["ride_year"].astype(str) + "-" + df["ride_month"].astype(str)
    # Calculate total ride cost
    df["total_ride_cost"] = (
        df["base_passenger_fare"] + df["tolls"] + df["bcf"] +
        df["sales_tax"] + df["congestion_surcharge"] + df["airport_fee"] + df["tips"]
    )
    # Aggregations
    summary = df.groupby("ride_period").agg(
        num_rides=("pickup_datetime", "count"),
        ride_time_in_days=("trip_time", lambda x: round(x.sum() / 86400, 2)),
        total_miles=("trip_miles", "sum"),
        total_ride_cost=("total_ride_cost", "sum"),
        total_rider_pay=("driver_pay", "sum")
    ).reset_index()
    # Additional attributes
    summary["total_miles_in_mil"] = summary["total_miles"] / 1000000
    summary["company_revenue"] = round(summary["total_ride_cost"] - summary["total_rider_pay"], 2)
    summary["company_margin"] = round((1 - (summary["total_rider_pay"] / summary["total_ride_cost"])) * 100, 2).astype(str) + "%"
    summary["avg_company_revenue_per_ride"] = round(summary["company_revenue"] / summary["num_rides"], 2)
    # Remove columns that aren't needed anymore
    summary.drop(["total_miles"], axis=1, inplace=True)
    return summary
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    # Read data from multiple Parquet files
    files = [os.path.join(file_dir, f) for f in os.listdir(file_dir) if f.endswith(".parquet")]

    df = pd.DataFrame()
    for file in files:
        print(file)
        file_stats = calculate_monthly_stats_per_file(file_path=file)
        # Check if df is empty
        if df.empty:
            df = file_stats
        else:
            # Concat row-wise
            df = pd.concat([df, file_stats], axis=0)
    # Sort the dataset
    df = df.sort_values(by="ride_period")
    # Change column order
    cols = ["ride_period", "num_rides", "ride_time_in_days", "total_miles_in_mil", "total_ride_cost",
            "total_rider_pay", "company_revenue", "company_margin", "avg_company_revenue_per_ride"]
    return df[cols]
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_pandas.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Triển khai pipeline bằng DuckDB hy vọng sẽ hoàn thành mà không gặp vấn đề bộ nhớ.
Bạn đã quen với phần lớn code DuckDB.
Điểm mới duy nhất là SELECT trên cùng, vì nó tính thêm vài thống kê. Mọi thứ khác giữ nguyên:
import duckdb
import pandas as pd
def calculate_monthly_stats(file_dir: str) -> pd.DataFrame:
    query = f"""
        SELECT
            ride_period,
            num_rides,
            ride_time_in_days,
            total_miles / 1000000 AS total_miles_in_mil,
            total_ride_cost,
            total_rider_pay,
            ROUND(total_ride_cost - total_rider_pay, 2) AS company_revenue,
            ROUND((1 - total_rider_pay / total_ride_cost) * 100, 2) || '%' AS company_margin,
            ROUND((total_ride_cost - total_rider_pay) / num_rides, 2) AS avg_company_revenue_per_ride
        FROM (
            SELECT
                ride_year || '-' || ride_month AS ride_period,
                COUNT(*) AS num_rides,
                ROUND(SUM(trip_time) / 86400, 2) AS ride_time_in_days,
                ROUND(SUM(trip_miles), 2) AS total_miles,
                ROUND(SUM(base_passenger_fare + tolls + bcf + sales_tax + congestion_surcharge + airport_fee + tips), 2) AS total_ride_cost,
                ROUND(SUM(driver_pay), 2) AS total_rider_pay
            FROM (
                SELECT
                    DATE_PART('year', pickup_datetime) AS ride_year,
                    DATE_PART('month', pickup_datetime) AS ride_month,
                    trip_time,
                    trip_miles,
                    base_passenger_fare,
                    tolls,
                    bcf,
                    sales_tax,
                    congestion_surcharge,
                    airport_fee,
                    tips,
                    driver_pay
                FROM PARQUET_SCAN("{file_dir}/*.parquet")
                WHERE
                    ride_year = 2024
                AND ride_month >= 1
                AND ride_month <= 6
            )
            GROUP BY ride_period
            ORDER BY ride_period
        )
    """
    conn = duckdb.connect()
    df = conn.sql(query).df()
    conn.close()
    return df
if __name__ == "__main__":
    data_dir = "nyc-taxi-data"
    output_dir = "pipeline_results"
    output_file_name = "results_duckdb.csv"
    # Run the pipeline
    monthly_stats = calculate_monthly_stats(file_dir=data_dir)
    # Save to CSV
    monthly_stats.to_csv(f"{output_dir}/{output_file_name}", index=False)
Tiếp theo, tôi sẽ cho thấy khác biệt thời gian chạy.
Sau khi chạy cả hai pipeline 5 lần và lấy trung bình, đây là thời gian tôi thu được:
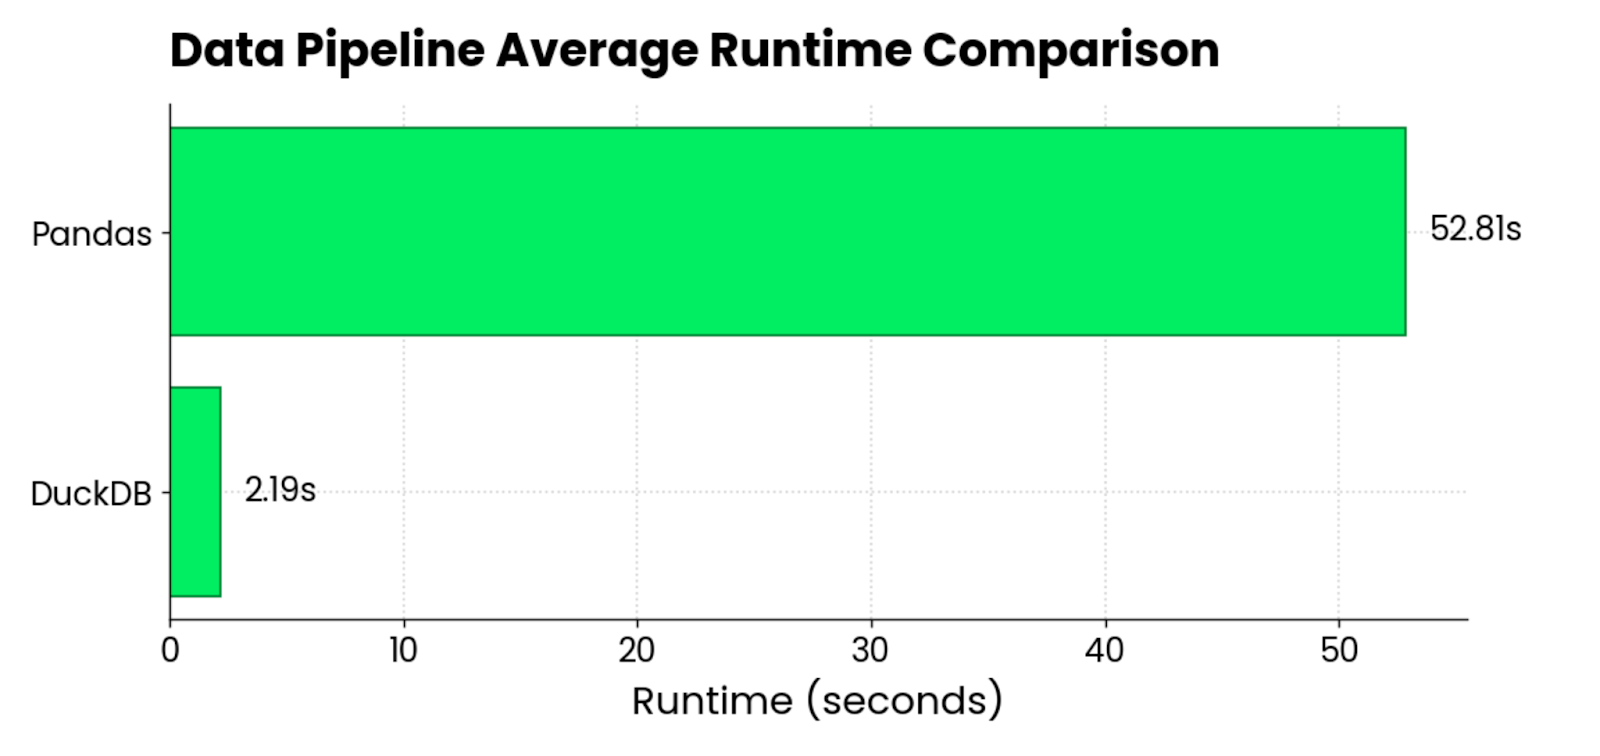
Biểu đồ so sánh thời gian chạy DuckDB vs. pandas
Trung bình, pandas chậm hơn 24 lần so với DuckDB khi nạp và xử lý khoảng 120 triệu dòng (~3GB), phân bổ trong 6 tệp Parquet.
So sánh này chưa hoàn toàn công bằng, vì tôi không thể xử lý tất cả tệp Parquet cùng lúc với pandas. Tuy nhiên, kết quả vẫn có giá trị vì bạn sẽ gặp những khó khăn tương tự trong công việc hàng ngày.
Nếu một thư viện không làm được điều bạn cần, hãy thử thư viện khác. Và lựa chọn thường hoàn thành nhanh nhất đa phần thời gian là DuckDB.
Trước khi để bạn tự khám phá DuckDB, tôi muốn chia sẻ vài thực hành tốt chung và liên quan đến kỹ sư dữ liệu:
SELECT. Bạn nên tránh dùng trong quy trình phụ thuộc nhiều vào INSERT và UPDATE. Nếu vậy, hãy dùng SQLite thay vào đó.Kết lại, tôi nghĩ bạn nên thử DuckDB nếu bạn là kỹ sư dữ liệu phụ trách xây dựng và tối ưu pipeline dữ liệu.
Bạn không mất gì mà được rất nhiều. Công cụ này gần như chắc chắn nhanh hơn bất cứ thứ gì Python cung cấp. Nó chạy cực nhanh trên laptop và cho phép bạn xử lý các tập dữ liệu mà nếu không sẽ gây lỗi bộ nhớ. Nó còn có thể kết nối các nền tảng lưu trữ đám mây trong trường hợp bạn không muốn hoặc không được phép lưu dữ liệu cục bộ.
Tuy vậy, DuckDB không nên là tối ưu duy nhất bạn mang đến. Hãy luôn tối ưu dữ liệu đưa vào hệ thống. Ví dụ, bỏ CSV để dùng Parquet sẽ tiết kiệm cả thời gian tính toán và lưu trữ. Một tối ưu khác nên cân nhắc là áp dụng các nguyên tắc của kiến trúc dữ liệu hiện đại vào quy trình và pipeline của bạn.
DuckDB chỉ là một công cụ. Nhưng là công cụ rất mạnh.
Tìm hiểu thêm về kỹ sư dữ liệu với những khóa học này!
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
