{count, plural, one {Kursus} other {Kursus}}
Supervised Learning di R: Regresi
{hours} jam
46.8K
Pernah ingin membangun ensemble machine learning, tetapi tidak tahu harus mulai dari mana? Tutorial ini akan membantu Anda memulai dengan SuperLearner. Paket R ini menyediakan cara mudah untuk membuat ensemble machine learning dengan fungsi tingkat tinggi melalui pembungkus standar untuk menyesuaikan ensemble menggunakan pustaka machine learning R populer seperti glmnet, knn, randomForest, dan banyak lagi!
Di tutorial ini, Anda akan mempelajari topik-topik berikut:
SuperLearner dan apa sebenarnya yang dilakukan paket ini?SuperLearner: di bagian ini, Anda akan belajar cara menginstal paket yang diperlukan, menyiapkan data, dan membuat model ensemble pertama Anda! Anda juga akan melihat cara melatih model dan membuat prediksi dengannya. Dalam proses ini, Anda akan membahas Kernel Support Vector Machines, Bayes Generalized Linear Models, dan Bagging. Terakhir, Anda akan melihat cara menyetel hyperparameter untuk lebih meningkatkan kinerja model!Setelah selesai, Anda akan berhasil menyesuaikan ensemble pertama, memprediksi data baru, dan menyetel sebagian komponen ensemble.
Semuanya terdengar menarik, tetapi apa sebenarnya yang dimaksud dengan ensemble?
Ensemble terjadi ketika prediksi probabilitas atau prediksi numerik dari beberapa model mesin digabungkan dengan cara dirata-ratakan, diberi bobot untuk setiap model lalu dijumlahkan, atau menggunakan observasi yang paling umum di antara model. Ini menghasilkan skenario “pemungutan suara” jamak yang cenderung mendorong prediksi ke kelas yang benar atau mendekati angka yang benar pada model regresi. Ensemble biasanya bekerja paling baik ketika ada perbedaan pendapat di antara model yang dipasangkan. Konsep menggabungkan banyak model juga terbukti bekerja baik dalam praktik, sering kali melampaui implementasi algoritme tunggal.
Ensemble dapat dibuat secara manual dengan menyesuaikan beberapa model, membuat prediksi dengan masing-masing model, lalu menggabungkannya.
SuperLearner?Setelah Anda melihat apa itu ensemble, Anda mungkin bertanya-tanya apa yang sebenarnya dilakukan pustaka SuperLearner. Secara sederhana, SuperLearner adalah algoritme yang menggunakan cross-validation untuk memperkirakan kinerja beberapa model machine learning, atau model yang sama dengan pengaturan berbeda. Lalu, ia membuat rata-rata berbobot optimal dari model-model tersebut, yang juga disebut “ensemble”, berdasarkan kinerja pada data uji.
Tetapi mengapa Anda menggunakan SuperLearner?
Walaupun Anda akan mempelajari lebih lanjut tentang kekuatan paket R ini sepanjang tutorial, Anda sudah bisa mempertimbangkan daftar keunggulan berikut:
SuperLearner memungkinkan Anda menyesuaikan model ensemble hanya dengan menambahkan algoritmeSuperLearner menggunakan cross-validation, yang secara inheren digunakan untuk memperkirakan risiko semua model. Ini membuat SuperLearner sangat cocok untuk membandingkan model!SuperLearner membuat proses ensembling menjadi efisien dengan secara otomatis memperkirakan bobot ensemble. Biasanya ini tugas yang bisa sangat melelahkan dan membutuhkan banyak eksperimen.SuperLearner secara otomatis menghapus model yang tidak berkontribusi pada daya prediksi ensemble, sehingga Anda bebas bereksperimen dengan banyak algoritme!Mari kita lihat proses menggunakan SuperLearner.
SuperLearnerSuperLearnerSuperLearner dapat diinstal dari CRAN dengan fungsi install.packages() lalu dimuat ke ruang kerja Anda menggunakan fungsi library():
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Untuk mengilustrasikan SuperLearner, Anda akan menggunakan himpunan data Pima Indian Women dari paket MASS. Paket MASS berisi himpunan latih, yang digunakan untuk melatih model, dan himpunan uji, yang digunakan untuk menilai kinerja model pada data yang belum terlihat. Himpunan data ini menyediakan sejumlah faktor deskriptif tentang Pima Indian Women seperti jumlah kehamilan dan usia, serta apakah mereka menderita diabetes atau tidak. Tujuannya adalah mencoba memprediksi diabetes.
Kolom type adalah kolom yang menunjukkan keberadaan diabetes. Ini merupakan kolom biner Yes atau No, yang berarti mengikuti distribusi binomial.
Catatan tanpa terlalu teoretis: distribusi binomial adalah kumpulan uji Bernoulli, yakni uji sukses atau gagal dalam probabilitas. Distribusi binomial mudah diidentifikasi karena hanya ada dua kemungkinan respons, dalam hal ini Yes atau No. Mengapa Anda membahas ini? Karena SuperLearner mengharuskan Anda menentukan family masalah yang harus diikuti model Anda. Anda akan melihat lebih detail saat menyesuaikan model nanti di tutorial ini.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Tip: jika Anda ingin mendapatkan informasi lebih lanjut tentang variabel dalam himpunan data ini, gunakan fungsi help(), seperti berikut:
help(Pima.tr)Dengan menjalankan perintah di atas, Anda dapat menyimpulkan bahwa kolom type menunjukkan diabetes.
SuperLearner juga mengharuskan variabel respons dikodekan jika ini adalah masalah klasifikasi. Karena Anda menyelesaikan masalah klasifikasi binomial, Anda akan mengodekan faktor untuk variabel type menjadi pengodean 0-1:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Karena kolom type berupa faktor, R akan mengodekannya menjadi 1 dan 2, tetapi ini bukan yang Anda inginkan: idealnya, Anda ingin bekerja dengan tipe yang dikodekan sebagai 0 dan 1, masing-masing untuk "No" dan "Yes". Pada potongan kode di atas, Anda mengurangkan 1 dari seluruh set untuk mendapatkan pengodean 0-1. R juga akan mengodekannya mengikuti urutan faktor.
Paket ini juga mengharuskan prediktor (X) dan respons (Y) berada pada struktur data masing-masing. Anda telah memisahkan Y di atas, sekarang Anda perlu memisahkan X. Anda juga akan memisahkan himpunan uji:
     x <- data.frame(train[,1:7])
    xtest <- data.frame(test[,1:7])
Catatan bahwa beberapa algoritme tidak hanya memerlukan data frame, tetapi membutuhkan model matrix yang disimpan sebagai data frame. Contohnya adalah algoritme nnet. Saat menyelesaikan masalah regresi, Anda hampir selalu menggunakan model matrix untuk menyimpan data Anda bagi SuperLearner. Model matrix hanya memisahkan variabel faktor ke kolomnya masing-masing dan mengodekannya sebagai nilai 0-1 alih-alih nilai teks. Ini tidak memengaruhi kolom numerik. Model matrix akan menambah jumlah kolom yang harus ditangani algoritme, sehingga dapat meningkatkan waktu komputasi. Untuk himpunan data kecil seperti ini, dampaknya minimal, namun himpunan data yang lebih besar bisa sangat terdampak. Intinya adalah putuskan algoritme apa yang ingin Anda coba sebelum menyesuaikan model. Untuk contoh sederhana ini, Anda akan menggunakan data frame dari struktur data yang ada.
SuperLearnerUntuk mulai membuat model pertama, Anda dapat menggunakan perintah berikut untuk melihat pratinjau model apa saja yang tersedia di paket:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Anda akan melihat ada pembungkus algoritme prediksi dan pembungkus algoritme screening. Ada beberapa pustaka populer di sini yang dapat digunakan untuk klasifikasi, regresi, atau keduanya. Algoritme screening digunakan untuk seleksi variabel otomatis oleh SuperLearner.
Ketika Anda ingin menggunakan algoritme dari daftar di atas, Anda harus memasang paket tersebut di lingkungan Anda. Itu karena SuperLearner sebenarnya memanggil paket-paket ini lalu menyesuaikan model saat metodenya digunakan. Artinya, jika Anda tidak pernah menggunakan metode SL.caret, misalnya, Anda tidak perlu memasang paket caret.
Menyesuaikan model itu sederhana, tetapi Anda akan melalui langkah ini selangkah demi selangkah dengan contoh model tunggal.
Anda akan menyesuaikan algoritme Ranger, yang merupakan implementasi lebih cepat dari Random Forest yang terkenal.
Ingat bahwa Random Forest adalah metode yang kuat yang sebenarnya merupakan ensembling dari decision tree. Decision tree bekerja dengan mengamati data Anda dan menghitung pemisahan probabilitas di antara setiap variabel dalam model, memberi Anda jalur menuju prediksi. Decision tree cenderung overfitting terhadap datanya, yang berarti tidak menggeneralisasi dengan baik ke data baru. Random Forest memecahkan masalah ini dengan menumbuhkan banyak decision tree berdasarkan banyak sampel data lalu merata-ratakan prediksinya untuk menemukan prediksi yang benar. Ia juga hanya memilih subset fitur untuk setiap sampel, yang membedakannya dari tree bagging. Ini menciptakan model yang tidak overfitting terhadap data. Keren, bukan?
Dalam kasus ini, bisa jadi Anda perlu terlebih dahulu memasang pustaka ranger dengan fungsi install.packages() sebelum mulai menyesuaikan model.
Jika sudah, Anda dapat melanjutkan dan menggunakan SL.ranger di fungsi SuperLearner().
Karena Random Forest —dan karenanya Ranger— mengandung pengambilan sampel acak dalam algoritme, Anda tidak akan mendapatkan hasil yang sama jika menyesuaikannya lebih dari sekali. Oleh karena itu, untuk latihan ini, Anda akan menetapkan seed agar dapat mereproduksi contoh dan juga membandingkan beberapa model pada baseline seed acak yang sama. R menggunakan set.seed() untuk menetapkan random seed. Seed bisa berupa angka apa pun; dalam hal ini Anda akan menggunakan 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner memerlukan variabel Y, yaitu respons atau keluaran yang Anda inginkan, variabel X, yaitu variabel prediktor, family yang digunakan, yang dapat berupa gaussian atau binomial, dan pustaka yang digunakan dalam bentuk list. Dalam kasus ini adalah SL.ranger.
Masih ingat pembahasan distribusi binomial yang Anda baca sebelumnya? Sekarang Anda melihat mengapa itu diperlukan: menggunakan model gaussian tidak akan menghasilkan prediksi yang tepat dalam rentang 0-1 Anda.
Selanjutnya, cukup mencetak model akan menampilkan koefisien, yaitu bobot algoritme dalam model, dan faktor risiko yang merupakan galat yang dihasilkan algoritme. Di balik layar, paket menyesuaikan setiap algoritme yang digunakan dalam ensemble untuk menghasilkan faktor risiko.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1Dalam kasus ini, faktor risiko Anda kurang dari 0,20. Tentu saja, ini perlu diuji melalui cross-validation eksternal dan pada himpunan uji, tetapi ini awal yang baik. Keunggulan SuperLearner adalah berupaya membangun ensemble secara otomatis melalui cross-validation. Tentu saja, jika hanya ada satu model, maka model tersebut mendapatkan bobot penuh dari ensemble.
Jadi model tunggal ini bagus, tetapi Anda bisa melakukannya tanpa SuperLearner. Bagaimana Anda bisa menyesuaikan model ensemble?
Membuat ensemble dengan SuperLearner semudah memilih algoritme yang akan digunakan. Dalam kasus ini, mari tambahkan Kernel Support Vector Machines (KSVM) dari paket kernlab, Bayes Generalized Linear Models (GLM) dari paket arm, dan bagging dari paket ipred.
Tetapi apa itu KSVM dan Bayes GLM?
KSVM menggunakan sesuatu yang disebut “trik kernel” untuk menghitung jarak antar titik. Alih-alih harus memetakan fitur dan menghitung koordinat, metode kernel menghitung inner product antar titik. Ini memungkinkan komputasi yang lebih cepat. Kemudian support vector machine digunakan untuk mempelajari batas non-linear antar titik dalam klasifikasi. Support vector machine berusaha membuat celah antara dua kelas dalam masalah machine learning yang sering kali non-linear. Lalu mengklasifikasikan titik baru di salah satu sisi celah tersebut berdasarkan posisinya di ruang fitur.
Model Bayes GLM sederhananya adalah implementasi dari regresi logistik. Setidaknya dalam kasus ini, di mana Anda mengklasifikasikan masalah 0-1. Bayes GLM berbeda dengan KSVM karena menggunakan algoritme regresi yang ditambah (augmented) untuk memperbarui koefisien di setiap langkah. Bagging mirip dengan random forest di atas tanpa melakukan subsetting fitur. Artinya, Anda akan menumbuhkan banyak decision tree dari sampel acak dan merata-ratakannya untuk mendapatkan prediksi.
Sekarang mari sesuaikan ensemble pertama Anda!
Tip: jangan lupa memasang paket-paket ini jika Anda belum memilikinya! Selain itu, Anda mungkin juga akan diminta memasang paket lain yang diperlukan.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Penambahan algoritme ini meningkatkan model Anda dan mengubah lanskapnya. Ranger dan KVSM memiliki koefisien nol, yang berarti tidak lagi diberi bobot sebagai bagian dari ensemble. Bayes GLM dan Bagging membentuk sisa bobot model. Anda akan melihat SuperLearner menghitung risiko ini untuk Anda dan memutuskan kombinasi model optimal yang akan mengurangi galat.
Untuk memahami kontribusi spesifik setiap model terhadap model dan variasinya, Anda dapat menggunakan fungsi cross-validation internal SuperLearner, yaitu CV.SuperLearner(). Untuk menetapkan jumlah lipatan (fold), Anda dapat menggunakan argumen V. Dalam kasus ini, Anda akan menetapkannya menjadi 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022Ringkasan cross-validation menunjukkan risiko rata-rata model, variasi model, dan rentang risikonya.
Memplot ini juga menghasilkan visual yang bagus dari model yang digunakan dan variasinya:
plot(cv.model)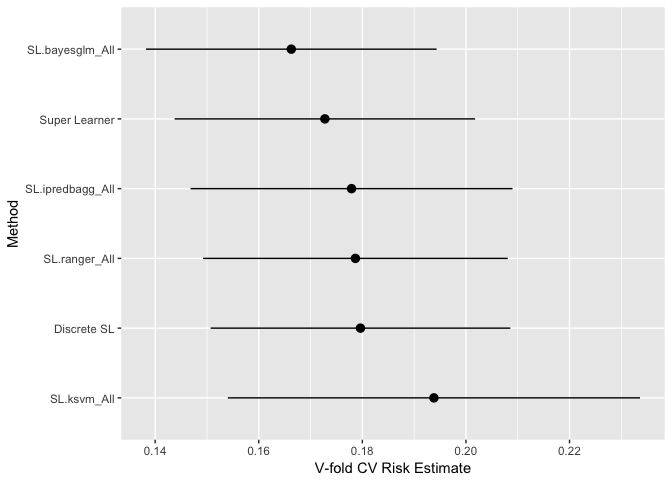
Mudah dilihat bahwa Bayes GLM berkinerja terbaik rata-rata sementara KSVM berkinerja terburuk dan mengandung banyak variasi dibanding model lainnya. Keunggulan SuperLearner adalah jika suatu model tidak pas atau tidak banyak berkontribusi, bobotnya cukup dibuat nol! Tidak perlu menghapusnya dan melatih ulang kecuali Anda berencana melatih ulang model di masa depan. Ingatlah bahwa pelatihan model yang tepat melibatkan cross-validation atas keseluruhan model. Dalam situasi nyata, seperti itulah Anda menentukan risiko model sebelum memprediksi data baru.
Dengan perintah khusus predict.SuperLearner() Anda dapat dengan mudah membuat prediksi pada himpunan data baru. Artinya Anda tidak dapat menggunakan fungsi predict() yang biasa!
predictions <- predict.SuperLearner(model, newdata=xtest)Fungsi predict.SuperLearner() menerima argumen model (model hasil SuperLearner) dan data baru untuk diprediksi. Prediksi pertama-tama akan mengembalikan prediksi ensemble keseluruhan:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Ia juga akan mengembalikan prediksi dari setiap pustaka secara individual:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Ini memungkinkan Anda melihat bagaimana setiap model mengklasifikasikan setiap observasi. Ini bisa berguna untuk men-debug model atau menyesuaikan banyak model sekaligus untuk melihat mana yang akan digunakan lebih lanjut.
Anda mungkin memperhatikan nilai prediksi yang dikembalikan. Nilainya berupa probabilitas. Itu berarti Anda memerlukan ambang batas untuk menentukan apakah harus mengklasifikasikan satu atau nol. Ini hanya perlu dilakukan pada kasus klasifikasi binomial, bukan regresi.
Biasanya, Anda akan menentukannya saat pelatihan dengan cross-validation, tetapi untuk kesederhanaan, Anda akan menggunakan ambang 0,50. Karena ini adalah masalah binomial sederhana, Anda akan menggunakan fungsi ifelse() dari dplyr untuk mengodekan ulang probabilitas Anda:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Sekarang Anda dapat membangun confusion matrix dengan caret untuk meninjau hasilnya:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Anda memperoleh akurasi sekitar 0,7921687 pada himpunan data ini, yang merupakan kinerja yang baik untuk himpunan data ini. Banyak algoritme mencetak lebih tinggi, tetapi ini sudah bagus untuk ensemble cepat. Dengan pelatihan yang tepat menggunakan cross-validation dan mencoba beberapa model berbeda, mudah dilihat bagaimana Anda dapat dengan cepat meningkatkan skor ini.
Walaupun kinerja model tidak buruk, Anda dapat mencoba meningkatkannya dengan menyetel beberapa hyperparameter dari beberapa model dalam ensemble. Ranger tidak diberi bobot besar dalam model Anda, tetapi mungkin itu karena Anda memerlukan lebih banyak tree dan perlu menyetel parameter mtry. Mungkin Anda juga dapat meningkatkan bagging dengan menaikkan parameter nbagg menjadi 250 dari nilai baku 25.
Ada dua metode untuk melakukan ini: Anda mendefinisikan fungsi yang memanggil learner dan mengubah parameter, atau Anda menggunakan fungsi create.Learner(). Di bagian selanjutnya, Anda akan mempelajari lebih lanjut tentang opsi-opsi ini.
Yang pertama dengan bantuan function(). Di sini, Anda mendefinisikan fungsi yang memanggil learner dan mengubah parameter. Panggilan fungsi menggunakan ellipsis ... untuk meneruskan argumen tambahan ke sebuah fungsi. Tiga titik kecil itu memungkinkan modifikasi pada formula tanpa harus menentukan di dalam fungsi apa saja modifikasi tersebut. Ini berarti jika Anda mengubah 10 parameter, Anda tidak memerlukan 10 objek di dalam fungsi untuk dipetakan. Ini cara yang dapat digeneralisasi untuk menulis fungsi.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune adalah nama metode ranger yang Anda modifikasi dan SL.ipredbagg.tune adalah nama metode ipredbagg yang Anda modifikasi. Setelah Anda memiliki fungsi learner baru, Anda dapat meneruskannya ke formula cross-validation untuk melihat apakah kinerjanya meningkat.
Catatan bahwa Anda akan mempertahankan fungsi SL.ranger dan SL.ipredbagg asli dalam algoritme untuk melihat apakah kinerja meningkat pada versi fungsi yang disetel.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)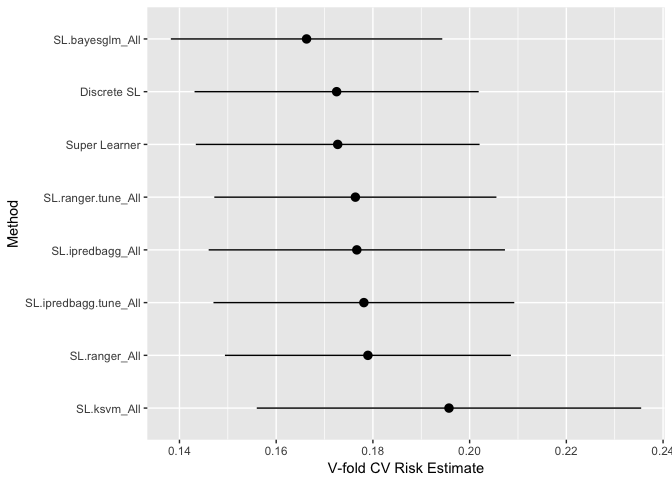
Dari plot ini Anda dapat melihat bahwa ipredbagg tampak membaik saat Anda menaikkan parameter nbagg seperti pada SL.ipredbagg.tune. Ranger tampak memburuk dengan penyetelan parameter, tetapi mari biarkan dan lihat apakah SuperLearner menganggapnya relevan.
Sekali lagi, keunggulannya adalah SuperLearner akan mengaturnya menjadi nol jika tidak relevan. Ingat, ensemble terbaik bukan tersusun dari algoritme yang berkinerja terbaik, melainkan algoritme yang paling saling melengkapi untuk mengklasifikasikan prediksi.
Mari sesuaikan model baru dengan parameter yang disetel dan lihat bagaimana bobotnya:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577SL.bayesglm dan SL.ipredbagg.tune kini menjadi satu-satunya algoritme yang diberi bobot dalam ensemble. Melakukan prediksi pada himpunan uji memberikan hasil berikut:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Ini memberi Anda sedikit peningkatan pada himpunan uji dan mengilustrasikan konsep penggunaan SuperLearner untuk penyetelan model.
create.Learner()Metode kedua untuk menyetel hyperparameter adalah menggunakan fungsi create.Learner(). Ini memungkinkan Anda menyesuaikan SuperLearner yang sudah ada:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
String karakter learner adalah argumen pertama untuk fungsi create.Learner(). Lalu Anda meneruskan daftar parameter yang ingin diubah. Ini akan membuat sebuah objek:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Sekarang, saat meneruskan learner ke SuperLearner, Anda menggunakan objek names pada objek learner:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)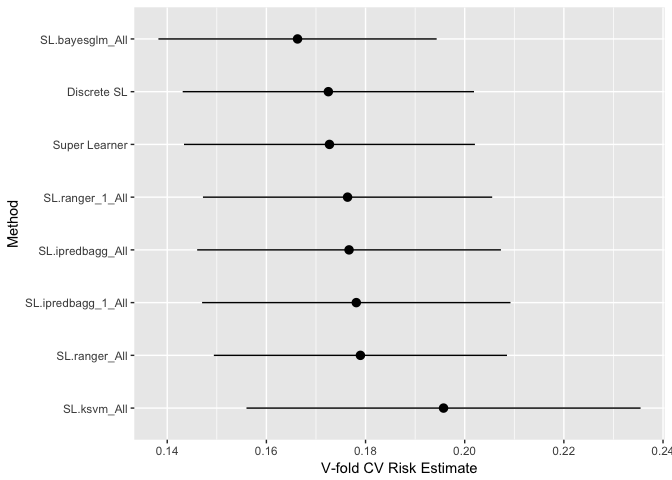
Hasil akhirnya sama seperti jika Anda menggunakan metode pertama. Terserah Anda ingin menggunakan metode yang mana.
Wah, Anda telah menjelajah banyak hal! Sejauh ini, Anda seharusnya sudah cukup memahami SuperLearner dan berhasil menyesuaikan ensemble pertama dengan SuperLearner. Paket ini memudahkan dan mempercepat penambahan model. Ada beberapa kekhususan terkait metode dan bentuk data yang digunakan. Namun, saat ragu, model matrix yang disimpan sebagai data frame hampir selalu berhasil.
Sebagai pengingat, Anda telah memasang dan memuat SuperLearner, memformat himpunan data Anda, menyesuaikan model tunggal, menyesuaikan ensemble pertama Anda, membuat prediksi dengan ensemble, dan menyetel beberapa hyperparameter!
Langkah berikutnya adalah membahas topik yang lebih lanjut dengan paket ini, seperti paralelisasi, seleksi fitur dan screening, menggunakan model matrix, menulis SuperLearner Anda sendiri, dan cross-validation ensemble.
Lihat tutorial DataCamp Machine Learning di R untuk pemula.
Pelajari lebih lanjut tentang R dan Machine Learning
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



