Curso
Aprendizaje supervisado en R: Regresión
4 h
46.7K
¿Alguna vez has querido crear un ensamble de machine learning pero no sabías por dónde empezar? Este tutorial te pone en marcha con SuperLearner. Este paquete de R te ofrece una forma sencilla de crear ensambles de machine learning mediante funciones de alto nivel, con un contenedor estandarizado para ajustar un ensamble usando librerías populares de machine learning en R como glmnet, knn, randomForest y muchas más.
En este tutorial, abordarás los siguientes temas:
SuperLearner y qué hace exactamente este paquete.SuperLearner: aprenderás a instalar los paquetes que necesitas, preparar los datos y crear tu primer modelo en ensamble. También verás cómo entrenar el modelo y hacer predicciones. Por el camino, cubrirás máquinas de vectores soporte con kernel, modelos lineales generalizados bayesianos y bagging. Para terminar, verás cómo ajustar los hiperparámetros para mejorar aún más el rendimiento.Al terminar, habrás ajustado tu primer ensamble, predicho nuevos datos y ajustado partes del ensamble.
Todo esto suena genial, pero ¿qué es exactamente un ensamble?
Un ensamble se da cuando se combinan las predicciones probabilísticas o numéricas de varios modelos de machine learning, ya sea promediándolas, ponderando cada modelo y sumándolos, o usando la observación más frecuente entre modelos. Esto crea un escenario de “votación múltiple” que tiende a llevar la predicción a la clase correcta o, en regresión, a un valor más cercano al real. Los ensambles suelen funcionar mejor cuando hay desacuerdo entre los modelos que se ajustan. La idea de combinar múltiples modelos también funciona muy bien en la práctica, a menudo superando a implementaciones de algoritmos individuales.
Los ensambles se pueden crear manualmente ajustando múltiples modelos, prediciendo con cada uno y combinándolos después.
SuperLearner?Ahora que ya sabes qué son los ensambles, quizá te preguntes qué hace exactamente la librería SuperLearner. En pocas palabras, SuperLearner es un algoritmo que usa validación cruzada para estimar el rendimiento de múltiples modelos de machine learning (o del mismo modelo con distintas configuraciones). Luego crea un promedio ponderado óptimo de esos modelos, es decir, un “ensamble”, usando el rendimiento en los datos de test.
Pero, ¿por qué usar SuperLearner?
Aunque verás su potencial a lo largo del tutorial, ya puedes considerar estas ventajas:
SuperLearner te permite ajustar un modelo en ensamble simplemente añadiendo algoritmos.SuperLearner usa validación cruzada para estimar el riesgo de todos los modelos. ¡Perfecto para comparar modelos!SuperLearner hace eficiente el ensembling al estimar automáticamente los pesos del ensamble. Normalmente, esta tarea es tediosa y requiere mucha experimentación.SuperLearner elimina automáticamente los modelos que no aportan al poder predictivo del ensamble, dejándote libertad para experimentar con muchos algoritmos.Veamos el proceso para usar SuperLearner.
SuperLearnerSuperLearnerPuedes instalar SuperLearner desde CRAN con la función install.packages() y cargarlo en tu espacio de trabajo con library():
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Para ilustrar SuperLearner, usarás el conjunto de datos de mujeres Pima del paquete MASS. Este paquete contiene un conjunto de entrenamiento, para ajustar el modelo, y uno de prueba, para evaluar su rendimiento en datos no vistos. El conjunto proporciona factores descriptivos sobre las mujeres Pima, como número de embarazos y edad, y si tienen diabetes o no. El objetivo es predecir la presencia de diabetes.
La columna type indica la presencia de diabetes. Es binaria, con valores Yes o No, por lo que sigue una distribución binomial.
Nota: sin ponernos demasiado teóricos, una distribución binomial es una colección de ensayos de Bernoulli (éxito o fracaso). Se identifica fácilmente porque solo hay dos respuestas posibles; en este caso, Yes o No. ¿Por qué te contamos esto? Porque SuperLearner requiere que definas la familia del problema al que pertenece tu modelo. Lo verás en detalle cuando ajustes el modelo más adelante.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Truco: si quieres más información sobre las variables de este conjunto, usa la función help(), así:
help(Pima.tr)Al ejecutar el comando anterior, verás que la columna type indica la diabetes.
SuperLearner también requiere codificar la variable respuesta si se trata de un problema de clasificación. Como estás resolviendo una clasificación binomial, codificarás el factor de la variable type a 0-1:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Como type era un factor, R lo codifica como 1 y 2, pero no es lo que quieres: idealmente, trabajarás con 0 y 1, que corresponden a "No" y "Yes", respectivamente. En el bloque anterior restas 1 a todo el conjunto para obtener la codificación 0-1. R también respetará el orden del factor.
El paquete también exige que los predictores (X) y la respuesta (Y) estén en estructuras separadas. Ya separaste Y; ahora separa X. También harás lo propio con el conjunto de prueba:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Nota: algunos algoritmos no solo requieren un data frame, sino una matriz de modelo guardada como data frame. Por ejemplo, el algoritmo nnet. Cuando resuelves un problema de regresión, casi siempre usarás la matriz de modelo para almacenar tus datos para SuperLearner. Una matriz de modelo divide las variables factor en columnas propias y las recodifica como 0-1 en lugar de texto. No afecta a las columnas numéricas. La matriz de modelo aumenta el número de columnas con las que el algoritmo trabaja y podría incrementar el tiempo de cómputo. En un conjunto pequeño como este, el impacto es mínimo, pero en otros más grandes puede ser notable. La idea es decidir qué algoritmos quieres probar antes de ajustar el modelo. En este ejemplo sencillo, usaremos el data frame tal cual.
SuperLearnerPara empezar a crear tu primer modelo, usa el siguiente comando para ver qué modelos hay disponibles en el paquete:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Verás que hay contenedores de algoritmos de predicción y de cribado. Aquí tienes librerías populares que sirven para clasificación, regresión o ambas. Los algoritmos de cribado se usan para la selección automática de variables en SuperLearner.
Cuando quieras usar un algoritmo de la lista, debes tener instalado su paquete en tu entorno. SuperLearner invoca estos paquetes para ajustar los modelos cuando utilizas cada método. Eso significa que, si nunca usas por ejemplo SL.caret, no necesitas tener instalado el paquete caret.
Ajustar el modelo es sencillo, pero lo haremos paso a paso con un ejemplo de un solo modelo.
Ajustarás el algoritmo Ranger, una implementación más rápida del conocido Random Forest.
Recuerda que Random Forest es un método potente que en realidad es un ensamble de árboles de decisión. Los árboles observan tus datos y calculan divisiones de probabilidad entre variables, generando una ruta hacia la predicción. Tienden a sobreajustarse, es decir, no generalizan bien a datos nuevos. Random Forest soluciona esto creciendo múltiples árboles a partir de numerosas muestras de datos y promediando sus predicciones. Además, selecciona un subconjunto de características para cada muestra, lo que lo diferencia del bagging de árboles. Así se evita el sobreajuste. Interesante, ¿verdad?
En este caso, puede que primero tengas que instalar la librería ranger con install.packages() antes de ajustar el modelo.
Si ya lo has hecho, puedes usar SL.ranger en la función SuperLearner().
Como Random Forest —y por tanto Ranger— incorpora muestreo aleatorio, no obtendrás el mismo resultado si lo ajustas varias veces. Para este ejercicio, fijaremos la semilla para poder reproducir los ejemplos y comparar varios modelos con la misma base aleatoria. R usa set.seed() para ello. La semilla puede ser cualquier número; aquí usaremos 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner requiere una variable Y (la respuesta), una X (los predictores), la family a usar (gaussian o binomial) y la librería en forma de lista. En este caso, SL.ranger.
¿Recuerdas la discusión sobre la distribución binomial? Ahora ves por qué era necesaria: usar el modelo gaussian no habría dado predicciones adecuadas en el rango 0-1.
Al imprimir el modelo, verás el coeficiente (el peso del algoritmo en el modelo) y el riesgo (el error que produce el algoritmo). Internamente, el paquete ajusta cada algoritmo usado en el ensamble para obtener el riesgo.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1En este caso, el riesgo es menor que 0,20. Por supuesto, habrá que contrastarlo con validación cruzada externa y en el conjunto de prueba, pero es un buen comienzo. La ventaja de SuperLearner es que intenta construir automáticamente un ensamble mediante validación cruzada. Si solo hay un modelo, se lleva todo el peso.
Este modelo único está bien, pero podrías hacerlo sin SuperLearner. ¿Cómo ajustamos modelos en ensamble?
Hacer ensambles con SuperLearner es tan simple como elegir los algoritmos. En este caso, añadamos máquinas de vectores soporte con kernel (KSVM) del paquete kernlab, modelos lineales generalizados bayesianos (GLM) del paquete arm y bagging del paquete ipred.
Pero, ¿qué son KSVM y Bayes GLM?
KSVM utiliza el “truco del kernel” para calcular distancias entre puntos. En lugar de mapear las características y calcular coordenadas, el método del kernel calcula productos internos entre puntos, lo que acelera el cómputo. Luego, la máquina de vectores soporte aprende la frontera no lineal entre puntos en clasificación. Intenta crear un margen entre dos clases (a menudo no lineal) y clasifica nuevos puntos a uno u otro lado según su posición.
El modelo Bayes GLM es, en este caso (clasificación 0-1), una implementación de la regresión logística. Se diferencia de KSVM en que usa un algoritmo de regresión aumentado para actualizar los coeficientes en cada paso. El bagging es similar a Random Forest pero sin seleccionar subconjuntos de características: se crecen múltiples árboles de decisión a partir de muestras aleatorias y se promedian para obtener la predicción.
¡Vamos a ajustar tu primer ensamble!
Truco: no olvides instalar estos paquetes si aún no los tienes. Además, puede que se te solicite instalar dependencias adicionales.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Añadir estos algoritmos ha mejorado tu modelo y cambiado el panorama. Ranger y KVSM tienen coeficiente cero, por lo que ya no ponderan en el ensamble. Bayes GLM y bagging componen el resto del peso. Verás que SuperLearner calcula el riesgo y decide la combinación óptima para reducir el error.
Para entender la contribución específica de cada modelo y su variación, puedes usar la función de validación cruzada interna CV.SuperLearner(). Para fijar el número de pliegues, usa el argumento V. En este caso, 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022El resumen de la validación cruzada muestra el riesgo medio del modelo, su variación y el rango del riesgo.
Si lo representas, obtendrás un gráfico claro de los modelos usados y su variación:
plot(cv.model)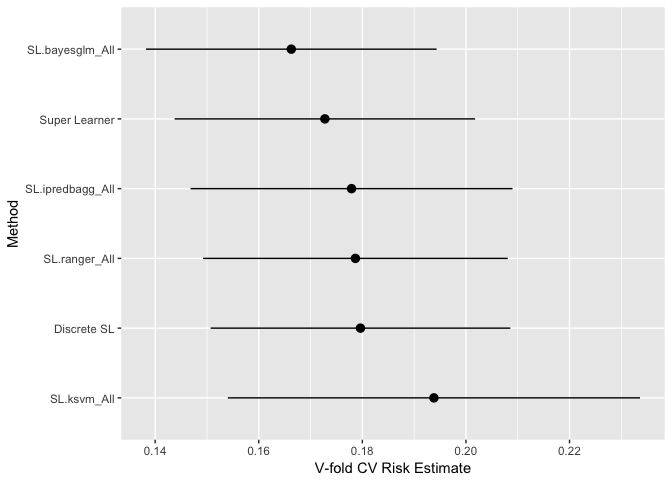
Se ve fácil que Bayes GLM rinde mejor de media mientras que KSVM es el peor y presenta mucha variación respecto a los demás. La ventaja de SuperLearner es que, si un modelo no encaja bien o aporta poco, ¡se pondera a cero! No hace falta quitarlo y reentrenar, salvo que vayas a reentrenar en el futuro. Recuerda que un entrenamiento adecuado implica validación cruzada del modelo completo. En un entorno real, así determinarías el riesgo antes de predecir nuevos datos.
Con el comando específico predict.SuperLearner() puedes predecir fácilmente sobre nuevos conjuntos de datos. Esto significa que no usarás la función estándar predict().
predictions <- predict.SuperLearner(model, newdata=xtest)La función predict.SuperLearner() recibe un modelo (un ajuste de SuperLearner) y los nuevos datos para predecir. Primero devuelve las predicciones generales del ensamble:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451También devuelve las predicciones individuales de cada librería:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Así puedes ver cómo cada modelo clasifica cada observación. Útil para depurar o para comparar varios modelos a la vez y decidir con cuáles seguir.
Habrás notado que las predicciones devueltas son probabilidades. Necesitarás un umbral para decidir si clasificar como 1 o 0. Esto solo aplica a clasificación binomial, no a regresión.
Normalmente lo decidirías durante el entrenamiento con validación cruzada, pero para simplificar usaremos un umbral de 0,50. Como es un problema binomial sencillo, usaremos ifelse() de dplyr para recodificar las probabilidades:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Ahora puedes construir una matriz de confusión con caret para revisar los resultados:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Obtienes una exactitud de ~0,7922 en este conjunto, un rendimiento bueno para estos datos. Muchos algoritmos han logrado más, pero es un buen resultado para un ensamble rápido. Con un entrenamiento adecuado con validación cruzada y probando modelos distintos, es fácil mejorar esta puntuación.
Aunque el rendimiento no es malo, puedes intentar mejorarlo ajustando algunos hiperparámetros de los modelos del ensamble. Ranger no fue muy ponderado en tu modelo, quizá porque necesita más árboles y ajustar el parámetro mtry. También puedes mejorar el bagging aumentando el parámetro nbagg a 250 desde el valor por defecto 25.
Hay dos formas de hacerlo: definir una función que llame al learner y modifique un parámetro, o usar la función create.Learner(). En las siguientes secciones verás ambas opciones.
La primera opción usa function(). Definirás una función que llama al learner y modifica un parámetro. La llamada usa los puntos suspensivos ... para pasar argumentos adicionales a la función. Esos tres puntos permiten modificar la fórmula sin especificar en la propia función cuáles son dichas modificaciones. Es decir, si cambias 10 parámetros, no necesitas 10 objetos en la función; es una forma generalizable de escribirla.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune es el nombre de tu método ranger modificado y SL.ipredbagg.tune el del método ipredbagg modificado. Con estos nuevos learners, pásalos a la validación cruzada para ver si mejora el rendimiento.
Nota: mantendrás las funciones originales SL.ranger y SL.ipredbagg en el conjunto de algoritmos para comprobar si tus versiones ajustadas mejoran.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)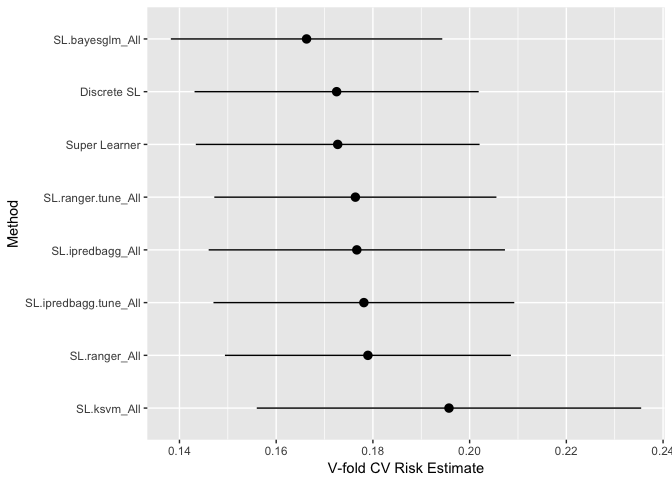
En este gráfico se ve que ipredbagg mejora al aumentar nbagg, como en SL.ipredbagg.tune. Ranger parece empeorar al ajustar parámetros, pero dejémoslo y veamos si SuperLearner lo considera relevante.
De nuevo, la ventaja es que SuperLearner lo pondrá a cero si no es relevante. Recuerda: los mejores ensambles no están formados por los algoritmos con mejor rendimiento individual, sino por los que mejor se complementan para clasificar.
Ajustemos el nuevo modelo con parámetros sintonizados y veamos los pesos:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577Ahora SL.bayesglm y SL.ipredbagg.tune son los únicos algoritmos ponderados en el ensamble. Predecir sobre el conjunto de prueba da el siguiente resultado:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Esto te da una pequeña mejora en el conjunto de prueba e ilustra cómo usar SuperLearner para ajustar modelos.
create.Learner()El segundo método para ajustar hiperparámetros es usar la función create.Learner(). Te permite personalizar un SuperLearner existente:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
La cadena del learner es el primer argumento de create.Learner(). Luego pasas una lista con los parámetros a modificar. Esto creará un objeto:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Ahora, al pasar el learner a SuperLearner, usa el elemento names del objeto learner:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)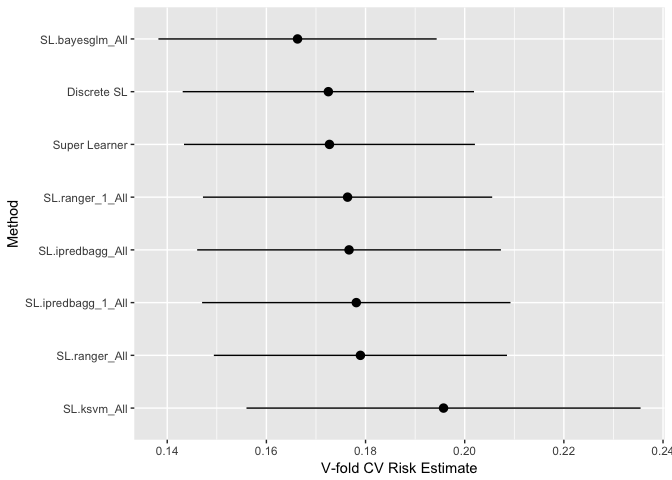
El resultado final es el mismo que con el primer método. Elige el que te resulte más cómodo.
¡Has cubierto mucho! A estas alturas deberías manejar bien SuperLearner y haber ajustado con éxito tu primer ensamble. Este paquete facilita añadir modelos con rapidez. Hay matices según los métodos y el formato de los datos; cuando tengas dudas, una matriz de modelo guardada como data frame casi siempre funciona.
Recapitulando: instalaste y cargaste SuperLearner, diste formato a tu conjunto de datos, ajustaste un único modelo, construiste tu primer ensamble, predeciste con él y ajustaste algunos hiperparámetros.
Los siguientes pasos serían abordar temas más avanzados como paralelización, selección y cribado de características, uso de matrices de modelo, escribir tu propio SuperLearner y validación cruzada de ensambles.
Consulta el tutorial de DataCamp Machine Learning en R para principiantes.
Aprende más sobre R y machine learning
Curso
Curso
Curso
Tutorial
Arunn Thevapalan
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Joanne Xiong
11 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eugenia Anello
8 min
Tutorial
Abid Ali Awan
11 min





