Curso
Aprendizado Supervisionado em R: Regressão
4 h
46.7K
Você já quis criar um ensemble de machine learning, mas não sabia por onde começar? Este tutorial vai te colocar no caminho certo com o SuperLearner. Este pacote de R oferece uma forma simples de criar ensembles de machine learning usando funções de alto nível, com um wrapper padronizado para ajustar um ensemble a partir de bibliotecas populares de machine learning em R, como glmnet, knn, randomForest e muitas outras!
Neste tutorial, você vai passar pelos seguintes tópicos:
SuperLearner e o que exatamente este pacote faz?SuperLearner: nesta seção, você vai aprender a instalar os pacotes necessários, preparar os dados e criar seu primeiro modelo de ensemble. Também vai ver como treinar o modelo e fazer previsões com ele. Nesse processo, você conhecerá Kernel Support Vector Machines, Bayes Generalized Linear Models e Bagging. Por fim, verá como ajustar hiperparâmetros para melhorar ainda mais o desempenho do seu modelo.Ao terminar, você terá ajustado seu primeiro ensemble, previsto novos dados e feito o tuning de partes do ensemble.
Tudo isso é ótimo, mas o que exatamente é um ensemble?
Um ensemble acontece quando as previsões probabilísticas ou numéricas de vários modelos de machine learning são combinadas, seja por média, por ponderação de cada modelo e soma dos resultados, ou ainda pelo voto majoritário entre os modelos. Isso cria um cenário de “voto múltiplo” que tende a levar a previsão à classe correta ou, em regressão, a um número mais próximo do valor real. Ensembles costumam funcionar melhor quando há desacordo entre os modelos ajustados. Na prática, combinar vários modelos costuma trazer bons resultados, muitas vezes superando implementações de algoritmos isolados.
Ensembles podem ser criados manualmente ajustando múltiplos modelos, prevendo com cada um deles e depois combinando os resultados.
SuperLearner?Agora que você já viu o que são ensembles, pode estar se perguntando o que a biblioteca SuperLearner faz exatamente. Em poucas palavras, SuperLearner é um algoritmo que usa validação cruzada para estimar o desempenho de vários modelos de machine learning (ou do mesmo modelo com configurações diferentes). Em seguida, ele cria uma média ponderada ótima desses modelos, formando um “ensemble”, com base no desempenho em dados de teste.
Mas por que usar o SuperLearner?
Embora você vá explorar mais o poder deste pacote de R ao longo do tutorial, já vale considerar estas vantagens:
SuperLearner permite ajustar um ensemble simplesmente adicionando algoritmos.SuperLearner usa validação cruzada para estimar o risco de todos os modelos. Isso o torna excelente para comparar modelos.SuperLearner torna o ensembling eficiente ao estimar automaticamente os pesos do ensemble — uma tarefa que normalmente é trabalhosa e exige muita experimentação.SuperLearner remove automaticamente modelos que não contribuem para o poder preditivo do ensemble, deixando você livre para experimentar com vários algoritmos.Vamos ver o processo de uso do SuperLearner.
SuperLearnerSuperLearnerSuperLearner pode ser instalado a partir do CRAN com a função install.packages() e carregado no seu ambiente com a função library():
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Para ilustrar o SuperLearner, você vai usar o conjunto de dados Pima Indian Women do pacote MASS. O pacote MASS contém um conjunto de treino, usado para treinar o modelo, e um conjunto de teste, usado para avaliar o desempenho do modelo em dados não vistos. O conjunto traz fatores descritivos sobre as mulheres Pima, como número de gestações e idade, e se elas têm ou não diabetes. O objetivo é prever a presença de diabetes.
A coluna type indica a presença de diabetes. É uma coluna binária Yes ou No, portanto segue uma distribuição binomial.
Observação: sem entrar demais na teoria, uma distribuição binomial é uma coleção de ensaios de Bernoulli, que são testes de sucesso ou fracasso em probabilidade. Você identifica facilmente uma distribuição binomial porque há apenas duas respostas possíveis — neste caso, Yes ou No. Por que isso importa? Porque o SuperLearner exige que você defina a família do problema a que seu modelo pertence. Você verá isso em detalhes ao ajustar o modelo mais adiante.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Dica: se quiser mais informações sobre as variáveis do conjunto de dados, use a função help(), como aqui:
help(Pima.tr)Ao executar o comando acima, você confirma que a coluna type indica diabetes.
SuperLearner também exige que a variável resposta seja codificada quando o problema é de classificação. Como você está resolvendo um problema de classificação binomial, vai recodificar o fator da variável type para 0-1:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Como a coluna type era um fator, o R a codificará como 1 e 2, mas isso não é o ideal: o melhor é trabalhar com 0 e 1, representando "No" e "Yes", respectivamente. No código acima, você subtrai 1 do conjunto para obter a codificação 0-1. O R também segue a ordem do fator.
O pacote também requer que preditores (X) e respostas (Y) estejam em estruturas separadas. Você já separou Y; agora precisa separar X. Vamos também separar o conjunto de teste:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Observação: alguns algoritmos não aceitam apenas um data frame; eles exigem uma model matrix salva como data frame. Um exemplo é o algoritmo nnet. Em problemas de regressão, quase sempre você usará a model matrix para armazenar seus dados no SuperLearner. A model matrix apenas desmembra variáveis fator em colunas próprias e as recodifica como 0-1 em vez de texto. Não afeta colunas numéricas. Como aumenta o número de colunas, pode elevar o tempo de computação. Em um conjunto pequeno como este, o impacto é mínimo, mas conjuntos grandes podem ser bastante afetados. Moral da história: decida quais algoritmos quer testar antes de ajustar o modelo. Para este exemplo simples, vamos usar o data frame como está.
SuperLearnerPara começar a criar seu primeiro modelo, use o comando abaixo para ver quais modelos estão disponíveis no pacote:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Você vai notar que existem wrappers de algoritmos de predição e de seleção (screening). Há bibliotecas populares aqui que podem ser usadas para classificação, regressão ou ambos. Os algoritmos de screening são usados pelo SuperLearner para seleção automática de variáveis.
Quando quiser usar um algoritmo da lista acima, é necessário ter o pacote instalado no seu ambiente. Isso porque o SuperLearner chama essas bibliotecas para ajustar os modelos quando você escolhe o método. Ou seja, se você nunca usar o método SL.caret, por exemplo, não precisa ter o pacote caret instalado.
Ajustar o modelo é simples, mas vamos passar passo a passo com um exemplo de modelo único.
Vamos ajustar o algoritmo Ranger, uma implementação mais rápida do famoso Random Forest.
Lembre que Random Forest é um método poderoso que, na prática, é um ensemble de árvores de decisão. Árvores de decisão funcionam analisando seus dados e calculando divisões probabilísticas entre as variáveis do modelo, definindo caminhos até a previsão. Árvores tendem a sobreajustar aos dados, ou seja, não generalizam bem para novos dados. Random Forest resolve isso ao crescer múltiplas árvores a partir de várias amostras e, depois, fazer a média das previsões para chegar ao resultado. Ele também seleciona apenas um subconjunto de features para cada amostra, diferenciando-se do bagging de árvores. Assim, cria um modelo que não sobreajusta. Legal, né?
Neste caso, pode ser que você precise primeiro instalar a biblioteca ranger com install.packages() antes de ajustar o modelo.
Feito isso, use SL.ranger na função SuperLearner().
Como Random Forest — e, portanto, Ranger — envolve amostragem aleatória, você não terá sempre o mesmo resultado ao ajustar mais de uma vez. Então, para este exercício, vamos fixar a semente para reproduzir os exemplos e comparar múltiplos modelos com a mesma base aleatória. O R usa set.seed() para isso. A semente pode ser qualquer número; aqui, usamos 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner exige uma variável Y (a resposta), uma variável X (os preditores), a family a ser usada (gaussian ou binomial) e a biblioteca a usar em forma de lista — neste caso, SL.ranger.
Lembra da discussão sobre distribuição binomial? Agora dá para ver por quê: usar o modelo gaussian não geraria previsões adequadas no intervalo 0-1.
Ao imprimir o modelo, você vê o coeficiente (o peso do algoritmo no ensemble) e o risco (o erro que o algoritmo produz). Por trás dos panos, o pacote ajusta cada algoritmo usado no ensemble para calcular o risco.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1Neste caso, o risco ficou abaixo de 0,20. Claro que isso precisa ser testado com validação cruzada externa e no conjunto de teste, mas é um bom começo. A beleza do SuperLearner é tentar construir automaticamente um ensemble via validação cruzada. Se há apenas um modelo, ele recebe todo o peso do ensemble.
Um único modelo é ótimo, mas você faria isso sem o SuperLearner. Como ajustar ensembles de verdade?
Fazer ensembling com SuperLearner é tão simples quanto escolher os algoritmos. Vamos adicionar Kernel Support Vector Machines (KSVM) do kernlab package, Bayes Generalized Linear Models (GLM) do arm package e bagging do ipred package.
Mas o que são KSVM e Bayes GLM?
KSVM usa o “kernel trick” para calcular a distância entre pontos. Em vez de mapear as features e calcular coordenadas, o método de kernel calcula produtos internos entre pontos, acelerando o processamento. Em seguida, a support vector machine aprende a fronteira não linear entre pontos na classificação. Uma SVM tenta criar um “gap” entre duas classes em problemas geralmente não lineares, e classifica novos pontos de acordo com o lado desse gap em que eles caem.
O modelo Bayes GLM, neste caso, é uma implementação de regressão logística para um problema 0-1. Ele difere do KSVM por usar um algoritmo de regressão com atualização bayesiana dos coeficientes a cada passo. Já o bagging é parecido com o random forest, mas sem o sorteio de subconjunto de variáveis: você cresce várias árvores de decisão a partir de amostras aleatórias e faz a média das previsões.
Bora ajustar seu primeiro ensemble!
Dica: não esqueça de instalar esses pacotes, se ainda não tiver. Você pode ser solicitado a instalar dependências adicionais.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Adicionar esses algoritmos melhorou seu modelo e mudou o cenário. Ranger e KSVM ficaram com coeficiente zero, ou seja, não entram mais ponderados no ensemble. Bayes GLM e Bagging compõem o restante do peso. Note que o SuperLearner calcula o risco e decide a mistura ótima de modelos para reduzir o erro.
Para entender a contribuição específica de cada modelo e sua variação, use a função interna de validação cruzada CV.SuperLearner(). Para definir o número de folds, use o argumento V. Aqui, vamos definir como 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022O sumário da validação cruzada mostra o risco médio do modelo, a variação e a faixa de risco.
O gráfico também ilustra bem os modelos usados e sua variação:
plot(cv.model)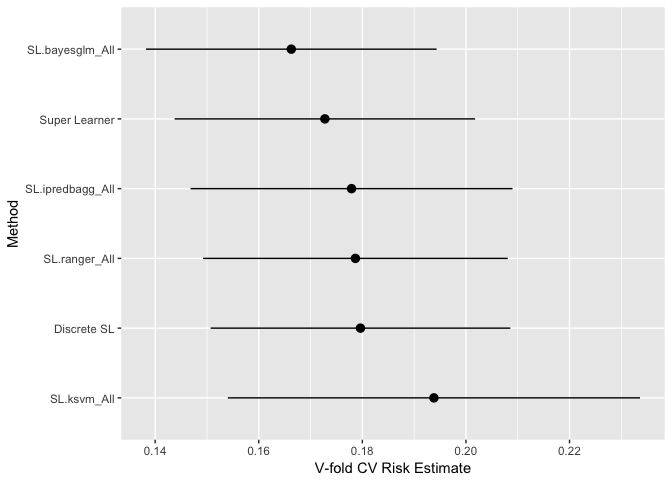
Dá para ver que Bayes GLM tem o melhor desempenho médio, enquanto KSVM é o pior e apresenta muita variação em comparação aos demais. A beleza do SuperLearner é que, se um modelo não se ajusta bem ou pouco contribui, ele simplesmente recebe peso zero. Não há necessidade de removê-lo e reentreinar — a não ser que você planeje um novo treinamento no futuro. Só lembre que um treinamento adequado envolve validação cruzada do modelo inteiro. Em um cenário real, é assim que você estimaria o risco antes de prever novos dados.
Com o comando específico predict.SuperLearner() você faz previsões facilmente em novos conjuntos de dados. Ou seja, você não deve usar a função predict() normal.
predictions <- predict.SuperLearner(model, newdata=xtest)A função predict.SuperLearner() recebe um modelo (um ajuste do SuperLearner) e novos dados para prever. As previsões retornam primeiro as saídas gerais do ensemble:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Ela também retorna as previsões individuais de cada biblioteca:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Isso permite ver como cada modelo classificou cada observação. Pode ser útil para depurar o modelo ou ajustar vários de uma vez para decidir quais seguir explorando.
Você deve ter notado que as previsões são probabilidades. Isso significa que você precisa de um limiar (threshold) para decidir se classifica como 1 ou 0. Isso só é necessário em classificação binária, não em regressão.
Normalmente, você definiria isso no treino com validação cruzada, mas, para simplificar, vamos usar um corte de 0,50. Como este é um problema binário simples, vamos usar a função ifelse() do dplyr para recodificar as probabilidades:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Agora crie uma matriz de confusão com o caret para revisar os resultados:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Você obteve cerca de 0,7921687 de acurácia neste conjunto, um bom desempenho para esses dados. Muitos algoritmos podem pontuar mais alto, mas isso já é um bom resultado para um ensemble rápido. Com um treinamento adequado com validação cruzada e testando outros modelos, dá para melhorar esse score com facilidade.
Embora o desempenho não esteja ruim, dá para tentar melhorar ajustando alguns hiperparâmetros dos modelos do ensemble. Ranger não teve muito peso no seu modelo — talvez por precisar de mais árvores e de um ajuste em mtry. Talvez você também consiga melhorar o bagging aumentando o parâmetro nbagg de 25 (padrão) para 250.
Há duas formas de fazer isso: definir uma função que chama o learner e modifica um parâmetro, ou usar a função create.Learner(). Nas próximas seções, você verá essas opções.
A primeira forma usa function(). Você define uma função que chama o learner e altera um parâmetro. A chamada usa a reticência ... para repassar argumentos adicionais. Esses três pontinhos permitem modificar a fórmula sem precisar declarar cada modificação explicitamente. Assim, se você mudar 10 parâmetros, não precisa de 10 objetos mapeados dentro da função. É uma forma generalizável de escrever a função.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune é o nome do seu método ranger modificado e SL.ipredbagg.tune é o método ipredbagg modificado. Com os novos learners criados, você pode passá-los à fórmula de validação cruzada para ver se o desempenho melhora.
Observação: vamos manter as funções originais SL.ranger e SL.ipredbagg no conjunto para comparar com as versões tunadas.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)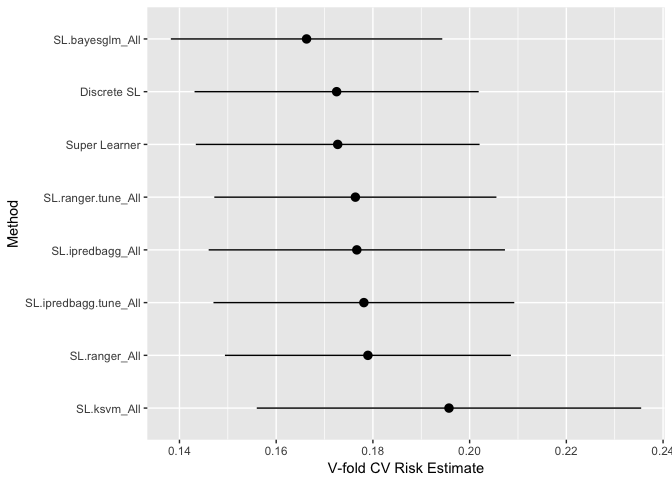
O gráfico mostra que ipredbagg parece melhorar ao aumentar nbagg, como em SL.ipredbagg.tune. Ranger parece piorar com o tuning, mas vamos mantê-lo e ver se o SuperLearner o considera relevante.
De novo: o SuperLearner vai atribuir peso zero se não for relevante. Lembre que os melhores ensembles não são formados pelos melhores algoritmos isolados, e sim pelos que melhor se complementam para classificar.
Vamos ajustar o novo modelo com parâmetros tunados e ver os pesos:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577Agora, SL.bayesglm e SL.ipredbagg.tune são os únicos com peso no ensemble. Prevendo no conjunto de teste, temos:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Isso traz uma pequena melhora no conjunto de teste e ilustra como usar o SuperLearner para tuning de modelos.
create.Learner()A segunda forma de ajustar hiperparâmetros é usando a função create.Learner(). Ela permite customizar um SuperLearner existente:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
O primeiro argumento de create.Learner() é a string com o learner. Depois, você passa uma lista com os parâmetros a modificar. Isso cria um objeto:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Ao passar o learner para o SuperLearner, use o elemento names do objeto:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)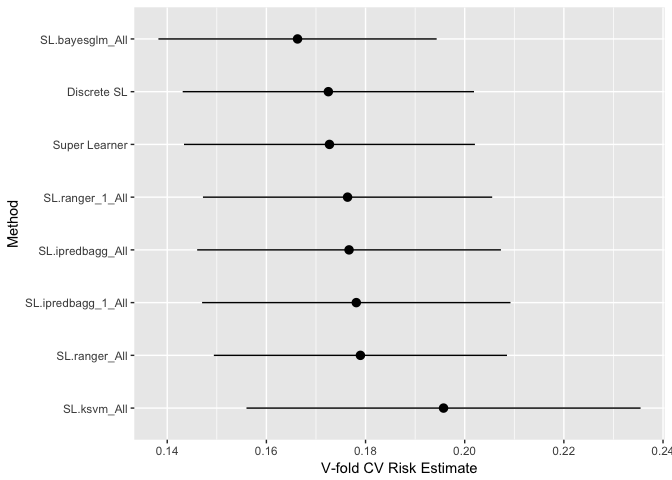
O resultado final é o mesmo da primeira abordagem. Fica a seu critério escolher o método que preferir.
Uau, você avançou bastante! Agora, você já deve ter boa noção do SuperLearner e ter ajustado seu primeiro ensemble. Este pacote facilita muito a adição rápida de modelos. Existem sutilezas nos métodos e no formato dos dados; porém, quando estiver em dúvida, uma model matrix salva como data frame quase sempre funciona.
Recapitulando: você instalou e carregou o SuperLearner, formatou o dataset, ajustou um modelo único, montou seu primeiro ensemble, previu com o ensemble e fez tuning de alguns hiperparâmetros.
Os próximos passos seriam explorar tópicos mais avançados do pacote, como paralelização, seleção e screening de features, uso de model matrices, escrever seu próprio SuperLearner e validação cruzada de ensembles.
Confira o tutorial da DataCamp Machine Learning em R para iniciantes.
Aprenda mais sobre R e machine learning
Curso
Curso
Curso
Tutorial
Arunn Thevapalan
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Eugenia Anello
8 min
Tutorial
DataCamp Team
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min


