Kurs
Überwachtes Lernen in R: Regression
4 Std.
46.7K
Wolltest du schon immer ein Ensemble für Machine Learning bauen, wusstest aber nicht, wo du anfangen sollst? Dieses Tutorial bringt dich mit SuperLearner auf Kurs. Das R-Paket bietet dir einen einfachen Weg, Ensembles mit High-Level-Funktionen zu erstellen – dank eines standardisierten Wrappers, der Ensembles mit beliebten R-Bibliotheken wie glmnet, knn, randomForest und vielen weiteren fitten kann!
In diesem Tutorial behandelst du unter anderem:
SuperLearner und was leistet das Paket konkret?SuperLearner: Du lernst, wie du die nötigen Pakete installierst, Daten vorbereitest und dein erstes Ensemblemodell erstellst. Außerdem siehst du, wie du das Modell trainierst und Vorhersagen triffst. Dabei deckst du Kernel Support Vector Machines, Bayes’sche Generalized Linear Models und Bagging ab. Zum Schluss erfährst du, wie du Hyperparameter tuningst, um die Performance weiter zu steigern.Am Ende hast du dein erstes Ensemble gefittet, neue Daten vorhergesagt und Teile des Ensembles getunt.
Alles klingt super – aber was genau ist eigentlich ein Ensemble?
Ein Ensemble entsteht, wenn die Wahrscheinlichkeits- oder Zahlenvorhersagen mehrerer Modelle kombiniert werden, etwa durch Mittelung, gewichtetes Addieren oder die Mehrheitsentscheidung. So entsteht eine Mehrheitsabstimmung, die Vorhersagen wahrscheinlicher in die richtige Klasse oder – bei Regressionsmodellen – näher an den korrekten Wert bringt. Ensembles funktionieren besonders gut, wenn sich die einzelnen Modelle in ihren Ergebnissen unterscheiden. Das Kombinieren mehrerer Modelle bewährt sich in der Praxis häufig und übertrifft oft einzelne Algorithmen.
Du kannst Ensembles manuell erstellen, indem du mehrere Modelle fitten, mit jedem vorhersagen und die Ergebnisse anschließend kombinieren.
SuperLearner?Nachdem du weißt, was Ensembles sind, fragst du dich vielleicht, was die SuperLearner-Bibliothek genau macht. Kurz gesagt: SuperLearner ist ein Algorithmus, der via Cross-Validation die Performance mehrerer Machine-Learning-Modelle – oder desselben Modells mit unterschiedlichen Einstellungen – schätzt. Anschließend erstellt er eine optimal gewichtete Kombination dieser Modelle, also ein „Ensemble“, basierend auf der Testdaten-Performance.
Warum solltest du SuperLearner einsetzen?
Auch wenn du die Stärken dieses R-Pakets im Verlauf noch genauer kennenlernst, hier schon einige Vorteile:
SuperLearner lässt dich ein Ensemblemodell bauen, indem du einfach passende Algorithmen hinzufügst.SuperLearner Cross-Validation und schätzt damit das Risiko für alle Modelle. Ideal für Modellvergleiche!SuperLearner macht Ensembling effizient, indem es die Gewichte automatisch bestimmt – eine Aufgabe, die sonst mühsam ist und viel Trial-and-Error erfordert.SuperLearner entfernt automatisch Modelle, die keinen Beitrag zur Vorhersageleistung leisten. So kannst du unbesorgt mit vielen Algorithmen experimentieren.Schauen wir uns an, wie du SuperLearner in der Praxis nutzt.
SuperLearnerSuperLearner-PaketSuperLearner kannst du mit install.packages() von CRAN installieren und anschließend mit library() laden:
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Zur Veranschaulichung von SuperLearner nutzen wir den Datensatz „Pima Indian Women“ aus dem MASS-Paket. MASS enthält einen Trainingssatz zum Trainieren des Modells und einen Testsatz zur Bewertung der Performance auf ungesehenen Daten. Der Datensatz liefert beschreibende Faktoren wie Anzahl der Schwangerschaften, Alter und ob Diabetes vorliegt. Ziel ist es, Diabetes vorherzusagen.
Die Spalte type zeigt an, ob Diabetes vorliegt. Sie ist binär (Yes/No) und folgt daher einer binomialen Verteilung.
Hinweis: Ohne zu theoretisch zu werden – eine binomiale Verteilung besteht aus Bernoulli-Versuchen (Erfolg/Misserfolg). Man erkennt sie daran, dass es genau zwei mögliche Antworten gibt, hier Yes oder No. Warum ist das wichtig? SuperLearner verlangt, dass du die „family“ des Problems angibst. Du siehst später beim Fitten, wie das eingesetzt wird.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Tipp: Wenn du mehr Infos zu den Variablen des Datensatzes brauchst, nutze help() wie hier:
help(Pima.tr)Über den obigen Befehl erfährst du unter anderem, dass type Diabetes anzeigt.
SuperLearner verlangt bei Klassifikationsproblemen außerdem eine geeignete Kodierung der Zielvariable. Da du ein binäres Problem löst, kodierst du den Faktor type in 0-1:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Da type ein Faktor war, kodiert R die Werte sonst als 1 und 2 – das willst du nicht. Ideal ist 0 und 1, entsprechend „No“ und „Yes“. Durch das Subtrahieren von 1 erhältst du die 0-1-Kodierung. R nutzt dabei die Faktor-Reihenfolge.
Das Paket erwartet außerdem, dass Prädiktoren (X) und Ziel (Y) in eigenen Objekten vorliegen. Y hast du oben abgetrennt, jetzt folgt X. Wir trennen auch direkt das Testset:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Hinweis: Manche Algorithmen erwarten statt eines Data Frames eine Modellmatrix als Data Frame, z. B. nnet. Bei Regressionsproblemen nutzt man für SuperLearner fast immer eine Modellmatrix. Sie spaltet Faktorvariablen in Dummy-Spalten auf und kodiert sie als 0-1 statt als Text. Numerische Spalten bleiben unangetastet. Eine Modellmatrix erhöht die Spaltenanzahl und kann die Rechenzeit steigern. Bei kleinen Datensätzen ist das vernachlässigbar, bei großen spürbar. Entscheide daher vorab, welche Algorithmen du testen möchtest. Für dieses einfache Beispiel genügt der bestehende Data Frame.
SuperLearnerUm zu sehen, welche Modelle verfügbar sind, hilft folgender Befehl:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Es gibt Wrapper für Vorhersage-Algorithmen und für Screening-Algorithmen. Viele bekannte Bibliotheken sind vertreten – für Klassifikation, Regression oder beides. Screening-Algorithmen nutzt SuperLearner für die automatische Variablenauswahl.
Wenn du einen Algorithmus aus der Liste verwenden willst, muss das entsprechende Paket installiert sein. SuperLearner ruft diese Pakete intern auf und fitten die Modelle. Nutzt du zum Beispiel nie SL.caret, musst du caret nicht installieren.
Das Fitten ist einfach – wir gehen es schrittweise mit einem Einzelmodell durch.
Wir fitten den Ranger-Algorithmus, eine schnelle Implementierung des bekannten Random Forest.
Zur Erinnerung: Random Forest ist ein starkes Verfahren und im Kern ein Ensemble aus Entscheidungsbäumen. Entscheidungsbäume berechnen Splits über die Variablen und leiten so zur Vorhersage. Sie neigen jedoch zum Overfitting. Random Forest begegnet dem, indem viele Bäume auf unterschiedlichen Stichproben wachsen und die Vorhersagen gemittelt werden. Zudem wird pro Stichprobe nur ein Teil der Features genutzt – im Unterschied zu reinem Tree-Bagging. So entsteht ein Modell, das nicht überfitten soll.
Gegebenenfalls musst du zuerst die ranger-Bibliothek via install.packages() installieren.
Dann kannst du SL.ranger in der Funktion SuperLearner() verwenden.
Da Random Forest – und damit Ranger – Zufallsstichproben nutzt, erhältst du bei mehrfacher Schätzung unterschiedliche Ergebnisse. Setze daher einen Seed für Reproduzierbarkeit und faire Vergleiche. In R nutzt du set.seed(), hier mit 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner erwartet die Zielvariable Y, die Prädiktoren X, die family (gaussian oder binomial) und die zu nutzende Bibliothek als Liste – hier SL.ranger.
Jetzt wird klar, warum die binomiale Verteilung oben wichtig war: Mit einem gaußschen Modell würdest du in deinem 0-1-Setting keine sinnvollen Vorhersagen erhalten.
Ein einfaches Ausgeben des Modells liefert den Koeffizienten (das Gewicht des Algorithmus im Ensemble) und den Risk-Wert (den vom Algorithmus erzeugten Fehler). Im Hintergrund fitten die genutzten Algorithmen, um den Risk-Wert zu bestimmen.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1Hier liegt der Risk-Wert unter 0,20. Das musst du natürlich via externer Cross-Validation und im Testset prüfen, aber es ist ein guter Start. Die Stärke von SuperLearner ist, Ensembles automatisch per Cross-Validation zu bauen. Gibt es nur ein Modell, erhält es das volle Gewicht.
Ein Einzelmodell ist nett – aber das ginge auch ohne SuperLearner. Wie fitten wir ein echtes Ensemble?
Mit SuperLearner ist Ensembling so einfach wie das Auswählen der Algorithmen. Wir fügen Kernel Support Vector Machines (KSVM) aus dem kernlab-Paket, Bayes’sche Generalized Linear Models (GLM) aus dem arm-Paket und Bagging aus dem ipred-Paket hinzu.
Was sind KSVM und Bayes-GLM?
KSVM nutzt den „Kernel-Trick“, um Abstände zwischen Punkten zu berechnen. Anstatt die Feature-Räume explizit abzubilden, berechnet die Kernelmethode Skalarprodukte zwischen Punkten – das spart Rechenzeit. Die Support-Vector-Machine lernt dann die (oft nichtlineare) Entscheidungsgrenze und klassifiziert neue Punkte je nach Seite dieser Grenze.
Das Bayes-GLM ist hier im Kern eine Implementierung der logistischen Regression für das 0-1-Problem. Es unterscheidet sich von KSVM dadurch, dass es einen augmentierten Regressionsalgorithmus nutzt, um die Koeffizienten schrittweise zu aktualisieren. Bagging ähnelt Random Forest, nur ohne die Feature-Subset-Auswahl: Es werden mehrere Entscheidungsbäume auf Zufallsstichproben trainiert und gemittelt.
Dann fitten wir dein erstes Ensemble!
Tipp: Installiere diese Pakete vorher, falls nötig. Eventuell wirst du zusätzlich zum Installieren von Abhängigkeiten aufgefordert.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Durch die zusätzlichen Algorithmen verbessert sich dein Modell und die Gewichte verschieben sich. Ranger und KSVM haben nun Gewicht 0 und tragen nicht mehr zum Ensemble bei. Bayes-GLM und Bagging machen den Rest aus. SuperLearner berechnet das Risiko und findet die optimale Mischung, um den Fehler zu senken.
Um den Beitrag und die Varianz der einzelnen Modelle zu verstehen, nutzt du die interne Cross-Validation CV.SuperLearner(). Die Anzahl der Folds setzt du mit dem Argument V, hier auf 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022Die Zusammenfassung zeigt den durchschnittlichen Risk-Wert, die Streuung und die Spannweite.
Ein Plot visualisiert die Modelle und ihre Variation übersichtlich:
plot(cv.model)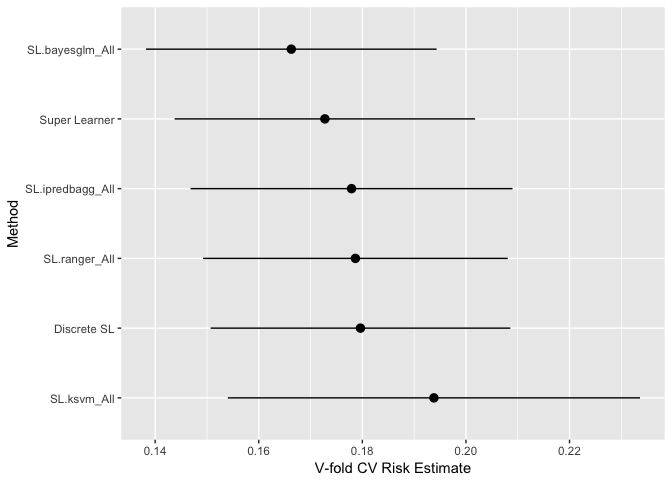
Du siehst: Bayes-GLM schneidet im Mittel am besten ab, KSVM am schlechtesten und mit hoher Varianz. Die Stärke von SuperLearner: Passt ein Modell nicht, wird es einfach mit Gewicht 0 berücksichtigt. Entfernen und neu trainieren ist nicht nötig – außer du planst, das Modell künftig erneut zu trainieren. Denke daran: Sauberes Training umfasst Cross-Validation des gesamten Modells. So bestimmst du im realen Einsatz das Risiko vor neuen Vorhersagen.
Mit predict.SuperLearner() triffst du bequem Vorhersagen auf neuen Daten. Verwende dafür nicht die generische predict()-Funktion!
predictions <- predict.SuperLearner(model, newdata=xtest)predict.SuperLearner() erwartet das Modellobjekt (ein SuperLearner-Fit) und die neuen Daten. Zuerst erhältst du die Vorhersagen des Gesamtensembles:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Außerdem bekommst du die Vorhersagen der einzelnen Bibliotheken:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132So erkennst du, wie jedes Modell einzelne Beobachtungen klassifiziert. Das ist hilfreich fürs Debugging oder um mehrere Modelle parallel zu testen.
Dir ist sicher aufgefallen, dass Wahrscheinlichkeiten zurückgegeben werden. Für binäre Klassifikation brauchst du daher einen Schwellenwert, um 0 oder 1 zuzuordnen. Bei Regression entfällt das.
Normalerweise bestimmst du den Cut-off im Training via Cross-Validation. Zur Vereinfachung nutzen wir 0,50. Für das simple binäre Problem kodieren wir mit dplyr und ifelse() um:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Jetzt bauen wir eine Confusion Matrix mit caret, um die Ergebnisse zu prüfen:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Du erreichst hier rund 0,7921687 Genauigkeit – für diesen Datensatz ein ordentlicher Wert. Viele Algorithmen erzielen höheres, aber als schnelles Ensemble ist das solide. Mit sauberem Cross-Validation-Training und weiteren Modellen lässt sich das schnell steigern.
Die Performance ist nicht schlecht, lässt sich aber über Hyperparameter-Tuning weiter verbessern. Ranger hatte im Ensemble wenig Gewicht – vielleicht brauchst du mehr Bäume und eine Anpassung von mtry. Bagging ließe sich z. B. verbessern, indem du nbagg von 25 auf 250 erhöhst.
Es gibt zwei Wege: Entweder definierst du eine Funktion, die den Learner aufruft und Parameter ändert, oder du nutzt create.Learner(). In den nächsten Abschnitten lernst du beide Optionen kennen.
Variante eins nutzt function(). Du definierst eine Funktion, die den Learner aufruft und Parameter anpasst. Mit der Ellipse ... reichst du zusätzliche Argumente weiter. Diese drei Punkte erlauben flexible Änderungen, ohne jeden Parameter explizit als Objekt in der Funktion zu führen.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune ist die getunte Variante von ranger, SL.ipredbagg.tune die von ipredbagg. Mit den neuen Funktionen kannst du die Cross-Validation erneut ausführen und die Performance vergleichen.
Hinweis: Wir behalten SL.ranger und SL.ipredbagg im Set, um die getunten Varianten fair zu vergleichen.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)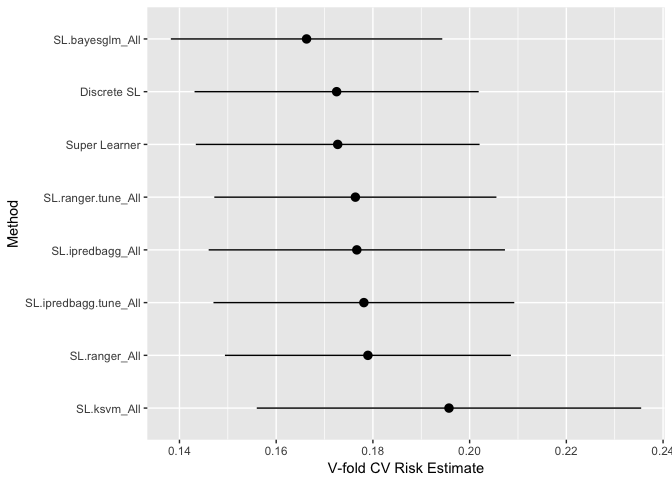
Der Plot zeigt: ipredbagg profitiert vom erhöhten nbagg (siehe SL.ipredbagg.tune). Ranger wird durch das Tuning hier eher schlechter – wir lassen es dennoch drin und überlassen SuperLearner die Gewichtung.
Das Schöne: Ist ein Algorithmus nicht relevant, setzt SuperLearner sein Gewicht einfach auf 0. Denk daran: Die besten Ensembles bestehen nicht aus den jeweils besten Einzelmodellen, sondern aus Modellen, die sich gegenseitig optimal ergänzen.
Fitten wir das neue Modell mit getunten Parametern und sehen uns die Gewichte an:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577SL.bayesglm und SL.ipredbagg.tune sind nun die einzigen gewichteten Algorithmen. Vorhersagen auf dem Testset liefern folgendes Bild:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Das bringt eine kleine Verbesserung im Testset und zeigt, wie du SuperLearner für Tuning nutzen kannst.
create.Learner()Die zweite Tuning-Variante nutzt create.Learner(). So passt du bestehende SuperLearner-Algorithmen an:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
Das erste Argument ist der Name des Learners als String. Danach übergibst du eine Liste der zu ändernden Parameter. Ergebnis ist ein Objekt:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Wenn du den Learner an SuperLearner übergibst, nutzt du den Eintrag names aus dem Objekt:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)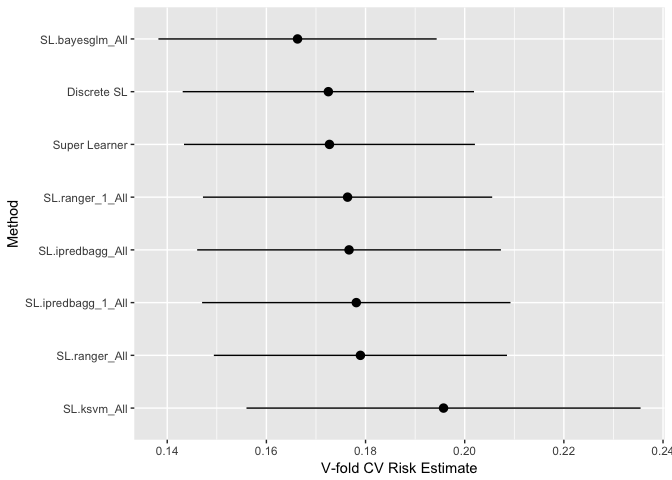
Das Ergebnis entspricht Methode eins. Welche du nutzt, ist Geschmackssache.
Ganz schön viel geschafft! Du hast jetzt ein gutes Gefühl für SuperLearner und dein erstes Ensemble erfolgreich gefittet. Das Paket macht es einfach, schnell weitere Modelle hinzuzufügen. Es gibt ein paar Feinheiten bei Methoden und Datenformaten. Im Zweifel funktioniert eine als Data Frame gespeicherte Modellmatrix fast immer.
Zur Erinnerung: Du hast SuperLearner installiert und geladen, den Datensatz aufbereitet, ein Einzelmodell gefittet, dein erstes Ensemble gebaut, Vorhersagen getroffen und Hyperparameter getunt.
Als Nächstes kannst du fortgeschrittene Themen angehen: Parallelisierung, Feature Selection und Screening, Modellmatrizen, eigene SuperLearner schreiben und Ensemble-Cross-Validation.
Schau dir auch DataCamps Tutorial Machine Learning in R für Einsteiger an.
Erfahre mehr über R und Machine Learning
Kurs
Kurs
Kurs
Blog
Tutorial
DataCamp Team
3 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
Satyabrata Pal
15 Min.





