{count, plural, one {Cursus} other {Cursussen}}
Supervised Learning in R: Regressie
{hours} uur
46.8K
Wilde je ooit een machine learning-ensemble bouwen, maar wist je niet waar te beginnen? Deze tutorial helpt je op weg met SuperLearner. Deze R-package geeft je een makkelijke manier om machine learning-ensembles te maken met behulp van high-level functies en biedt een gestandaardiseerde wrapper om een ensemble te fitten met populaire R-machinelearningbibliotheken zoals glmnet, knn, randomForest en nog veel meer!
In deze tutorial behandel je het volgende:
SuperLearner en wat doet deze package precies?SuperLearner: in dit onderdeel leer je hoe je de benodigde packages installeert, de data voorbereidt en je eerste ensemblemodel maakt! Je ziet ook hoe je het model traint en er voorspellingen mee doet. Daarbij komen Kernel Support Vector Machines, Bayesiaanse gegeneraliseerde lineaire modellen en bagging aan bod. Tot slot zie je hoe je hyperparameters kunt tunen om de prestaties van je model verder te verbeteren!Als je klaar bent, heb je je eerste ensemble gefit, nieuwe data voorspeld en onderdelen van het ensemble getuned.
Allemaal leuk en aardig, maar wat is een ensemble nu precies?
Een ensemble ontstaat wanneer de kansvoorspellingen of numerieke voorspellingen van meerdere machine learning-modellen worden gecombineerd door te middelen, door elk model te wegen en ze op te tellen, of door de meest voorkomende uitkomst tussen modellen te nemen. Dit levert een soort meervoudige stemmingssituatie op die de voorspelling waarschijnlijk naar de juiste klasse of dichter bij het juiste getal in regressiemodellen stuurt. Ensembles werken meestal het best wanneer er meningsverschillen zijn tussen de gefitte modellen. Het combineren van meerdere modellen blijkt in de praktijk vaak goed te presteren, vaak beter dan implementaties van losse algoritmen.
Ensembles kun je handmatig maken door meerdere modellen te fitten, met elk van hen te voorspellen en die vervolgens te combineren.
SuperLearner?Nu je hebt gezien wat ensembles zijn, vraag je je misschien af wat de SuperLearner-bibliotheek precies doet. Simpel gezegd: SuperLearner is een algoritme dat cross-validatie gebruikt om de prestaties te schatten van meerdere machine learning-modellen, of van hetzelfde model met verschillende instellingen. Vervolgens maakt het een optimale gewogen gemiddelde van die modellen, ook wel een “ensemble” genoemd, op basis van de prestaties op de testdata.
Maar waarom zou je SuperLearner gebruiken?
Hoewel je in de loop van de tutorial meer leert over de kracht van deze R-package, kun je deze voordelen alvast meenemen:
SuperLearner laat je een ensemblemodel fitten door simpelweg algoritmen toe te voegenSuperLearner cross-validatie, wat inherent wordt gebruikt om het risico voor alle modellen te schatten. Dit maakt SuperLearner geweldig voor modelvergelijking!SuperLearner maakt ensembling efficiënt door automatisch de gewichten van het ensemble te schatten. Dit is normaal gesproken een tijdrovende taak die veel experimenteren vereist.SuperLearner verwijdert automatisch modellen die niet bijdragen aan de voorspellende kracht van het ensemble, zodat jij vrij kunt experimenteren met talloze algoritmen!Laten we eens kijken naar het proces om SuperLearner te gebruiken.
SuperLearnerSuperLearner-packageSuperLearner kun je installeren vanaf CRAN met de functie install.packages() en vervolgens in je workspace laden met de functie library():
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Om SuperLearner te illustreren gebruik je de Pima Indian Women-dataset uit de MASS-package. De MASS-package bevat een trainingsset, die je gebruikt om een model te trainen, en een testset, die je gebruikt om de prestaties van het model op onzichtbare data te beoordelen. De dataset bevat enkele beschrijvende factoren van de Pima Indian Women, zoals aantal zwangerschappen en leeftijd, en of ze wel of niet diabetes hebben. Het doel is om diabetes te voorspellen.
De kolom type geeft aan of er sprake is van diabetes. Dit is een binaire kolom met Yes of No, wat betekent dat deze een binomiale verdeling volgt.
Opmerking: zonder al te theoretisch te worden, een binomiale verdeling is een verzameling Bernoulli-proeven, oftewel succes- of mislukkingstesten in kansrekening. Een binomiale verdeling herken je makkelijk omdat er slechts twee mogelijke uitkomsten zijn, in dit geval Yes of No. Waarom is dit relevant? SuperLearner vraagt je om de familie van het probleem te definiëren waar je model onder valt. Dat zie je later in deze tutorial wanneer je het model fit.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Tip: als je meer informatie wilt over de variabelen van deze dataset, gebruik dan de functie help(), zoals hier:
help(Pima.tr)Door bovenstaand commando uit te voeren, kun je afleiden dat de kolom type diabetes aangeeft.
SuperLearner vereist ook dat de responsvariabele gecodeerd is als het om een classificatieprobleem gaat. Omdat je een binomiaal classificatieprobleem oplost, codeer je de factor voor de variabele type naar 0-1-encodering:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Aangezien de kolom type een factor was, zal R deze coderen als 1 en 2, maar dat wil je niet: idealiter werk je met een type dat gecodeerd is als 0 en 1, respectievelijk "No" en "Yes". In de bovenstaande code trek je 1 van de hele set af om je 0-1-encodering te krijgen. R codeert dit ook in de volgorde van de factor.
De package vereist ook dat de predictoren (X) en de respons (Y) elk in hun eigen datastructuur staan. Je hebt hierboven Y al uitgesplitst, nu moet je X uitsplitsen. We splitsen ook meteen je testset uit:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Opmerking: sommige algoritmen vereisen niet alleen een data frame, maar een modelmatrix die als data frame is opgeslagen. Een voorbeeld is het nnet-algoritme. Bij een regressieprobleem gebruik je bijna altijd de modelmatrix om je data voor SuperLearner op te slaan. Een modelmatrix splitst factorvariabelen uit naar eigen kolommen en recodeert ze als 0-1 in plaats van tekstwaarden. Numerieke kolommen worden niet beïnvloed. De modelmatrix verhoogt het aantal kolommen waar een algoritme mee moet werken en kan daardoor de rekentijd verhogen. Voor een kleine dataset zoals deze is de impact minimaal, maar grotere datasets kunnen er sterk door worden beïnvloed. De moraal van het verhaal: bedenk vooraf welke algoritmen je wilt proberen voordat je je model fit. Voor dit eenvoudige voorbeeld gebruiken we gewoon het data frame als bestaande datastructuur.
SuperLearnerOm te beginnen met je eerste model kun je het volgende commando gebruiken om te bekijken welke modellen beschikbaar zijn in de package:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Je ziet dat er prediction-algoritmewrappers en screening-algoritmewrappers zijn. Er zitten populaire bibliotheken tussen die je kunt gebruiken voor classificatie, regressie of beide. De screeningalgoritmen worden door SuperLearner gebruikt voor automatische variabelenselectie.
Als je een algoritme uit de bovenstaande lijst wilt gebruiken, moet je de betreffende package in je omgeving geïnstalleerd hebben. Dat komt omdat SuperLearner deze packages daadwerkelijk aanroept en de modellen fit wanneer de methode wordt gebruikt. Dat betekent ook dat je, als je de methode SL.caret nooit gebruikt, de package caret niet hoeft te installeren.
Het model fitten is eenvoudig, maar we lopen stap voor stap door een voorbeeld met één model.
Je gaat het Ranger-algoritme fitten, een snellere implementatie van de bekende Random Forest.
Onthoud dat een Random Forest een krachtig model is dat bestaat uit een ensemble van beslissingsbomen. Beslissingsbomen werken door je data te bekijken en een waarschijnlijkheidssplitsing te berekenen tussen elke variabele in het model, waardoor je een pad naar je voorspelling krijgt. Beslissingsbomen hebben de neiging om te overfitten op hun data, wat betekent dat ze niet goed generaliseren naar nieuwe data. Random Forest lost dit op door meerdere beslissingsbomen te laten groeien op basis van talrijke steekproeven van de data en die voorspellingen te middelen om tot de juiste voorspelling te komen. Het selecteert ook slechts een subset van de features voor elke steekproef, wat het onderscheidt van tree bagging. Dit levert een model op dat niet overfit op de data. Klinkt goed, toch?
In dit geval kan het zijn dat je eerst de ranger-package moet installeren met de functie install.packages() voordat je het model kunt fitten.
Als je dat hebt gedaan, kun je SL.ranger gebruiken in de functie SuperLearner().
Omdat Random Forest - en dus ook Ranger - willekeurige steekproeven in het algoritme bevat, krijg je niet hetzelfde resultaat als je het meerdere keren fittet. Daarom zet je voor deze oefening de seed zodat je de voorbeelden kunt reproduceren en meerdere modellen op dezelfde random seed-baseline kunt vergelijken. R gebruikt set.seed() om de random seed te zetten. De seed kan elk getal zijn; in dit geval gebruik je 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner verwacht een variabele Y, de respons of uitkomst die je wilt, een variabele X, de predictoren, de te gebruiken family, die gaussian of binomial kan zijn, en de te gebruiken bibliotheek in de vorm van een lijst. In dit geval is dat SL.ranger.
Weet je nog de discussie over de binomiale verdeling van eerder? Nu zie je waarom je dat moest weten: het gebruik van het gaussian-model had geen juiste voorspellingen in je 0-1-bereik opgeleverd.
Vervolgens geeft het simpelweg printen van het model de coëfficiënt, de weging van het algoritme in het model, en de risicofactor, de fout die het algoritme produceert. Onder de motorkap fittet de package elk algoritme dat in het ensemble wordt gebruikt om de risicofactor te bepalen.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1In dit geval is je risicofactor minder dan 0,20. Natuurlijk moet dit worden getest via externe cross-validatie en in de testset, maar het is een goed begin. Het mooie van SuperLearner is dat het via cross-validatie automatisch een ensemble probeert te bouwen. Als er natuurlijk maar één model is, krijgt dat het volledige gewicht van het ensemble.
Dit enkele model is prima, maar dit kun je ook zonder SuperLearner doen. Hoe fit je ensemblemodellen?
Ensembling met SuperLearner is zo eenvoudig als de algoritmen selecteren die je wilt gebruiken. Laten we in dit geval Kernel Support Vector Machines (KSVM) uit de kernlab-package toevoegen, Bayesiaanse gegeneraliseerde lineaire modellen (GLM) uit de arm-package en bagging uit de ipred-package.
Maar wat zijn KSVM en Bayes GLM?
KSVM gebruikt iets dat de "kerneltruc" heet om afstanden tussen punten te berekenen. In plaats van een kaart van de features te moeten tekenen en coördinaten te berekenen, berekent de kernelmethode de inproducten tussen punten. Dit maakt snellere berekening mogelijk. Vervolgens wordt de support vector machine gebruikt om de niet-lineaire grens tussen punten in classificatie te leren. Een support vector machine probeert een scheidingsvlak te creëren tussen twee klassen in een vaak niet-lineair machine learning-probleem. Nieuwe punten worden dan aan een van de zijden van die grens geclassificeerd op basis van hun positie in de ruimte.
Het Bayes GLM-model is simpelweg een implementatie van logistische regressie. Tenminste in dit geval, waarin je een 0-1-probleem classificeert. Bayes GLM verschilt van KSVM doordat het een uitgebreide regressie-algoritme gebruikt om de coëfficiënten bij elke stap te updaten. Bagging lijkt op random forest hierboven, maar zonder het subsetten van features. Dit betekent dat je meerdere beslissingsbomen laat groeien uit willekeurige steekproeven en die middelt om je voorspelling te krijgen.
Laten we nu je eerste ensemble fitten!
Tip: vergeet niet deze packages te installeren als je ze nog niet hebt! Mogelijk word je ook gevraagd om andere vereiste packages te installeren.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Door deze algoritmen toe te voegen is je model verbeterd en is het speelveld veranderd. Ranger en KVSM hebben een coëfficiënt van nul, wat betekent dat ze niet langer meewegen in het ensemble. Bayes GLM en bagging vormen de rest van het gewicht van het model. Je ziet dat SuperLearner dit risico voor je berekent en de optimale mix van modellen bepaalt die de fout verlaagt.
Om de specifieke bijdrage en variatie van elk model te begrijpen, kun je de interne cross-validatiefunctie CV.SuperLearner() van SuperLearner gebruiken. Met het argument V stel je het aantal folds in. In dit geval zet je het op 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022De samenvatting van de cross-validatie toont het gemiddelde risico van het model, de variatie van het model en het bereik van het risico.
Dit plotten levert ook een nette grafiek op van de gebruikte modellen en hun variatie:
plot(cv.model)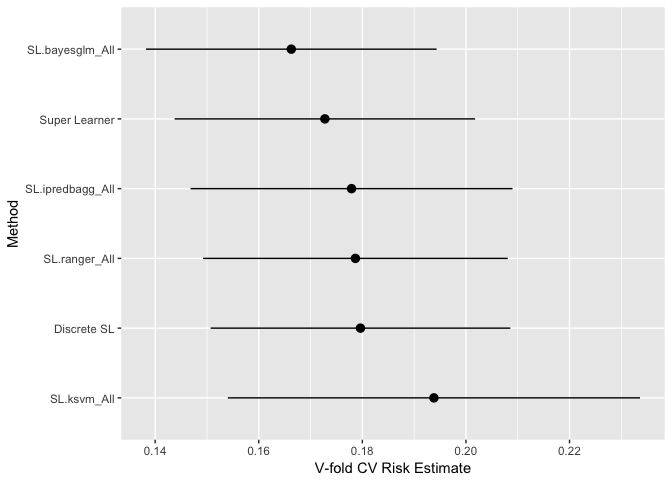
Je ziet gemakkelijk dat Bayes GLM gemiddeld het best presteert, terwijl KSVM het slechtst presteert en veel variatie vertoont vergeleken met de andere modellen. Het mooie van SuperLearner is dat, als een model niet goed fit of weinig bijdraagt, het simpelweg op nul wordt gewogen! Je hoeft het niet te verwijderen en opnieuw te trainen, tenzij je het model in de toekomst toch opnieuw wilt trainen. Onthoud wel dat goed modeltrainen inhoudt dat je het volledige model cross-valideert. In een echte setting is dat hoe je het risico van het model bepaalt voordat je nieuwe data voorspelt.
Met het specifieke commando predict.SuperLearner() kun je eenvoudig voorspellingen doen op nieuwe datasets. Dat betekent dat je niet de gewone functie predict() kunt gebruiken!
predictions <- predict.SuperLearner(model, newdata=xtest)De functie predict.SuperLearner() neemt een modelargument (een SuperLearner-fit) en nieuwe data om op te voorspellen. Voorspellingen geven eerst de algemene ensemblevoorspellingen terug:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Ook krijg je de individuele library-voorspellingen:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Hiermee kun je zien hoe elk model elke observatie classificeerde. Dit kan handig zijn bij het debuggen van het model of om meerdere modellen tegelijk te fitten en te bekijken welke je verder wilt gebruiken.
Je hebt misschien gemerkt dat de voorspellingen als kansen worden teruggegeven. Dat betekent dat je een drempel nodig hebt om te bepalen of je een één of nul moet classificeren. Dit hoeft alleen in het binomiale classificatiegeval, niet bij regressie.
Normaal gesproken bepaal je dit tijdens training met cross-validatie, maar voor de eenvoud gebruik je een drempel van 0,50. Omdat dit een eenvoudig binomiaal probleem is, gebruik je de functie ifelse() uit dplyr om je kansen te hercoderen:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Nu kun je met caret een confusion matrix bouwen om de resultaten te bekijken:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Je haalt ongeveer 0,7921687 nauwkeurigheid op deze dataset, wat een goede prestatie is voor deze data. Veel algoritmen hebben hoger gescoord, maar dit is goed voor een snel ensemble. Met goede training via cross-validatie en het proberen van andere modellen is het eenvoudig te zien hoe je deze score snel kunt verbeteren.
Hoewel de modelprestatie niet slecht is, kun je proberen je prestaties te verbeteren door hyperparameters te tunen van enkele modellen in het ensemble. Ranger woog niet zwaar mee in je model, maar misschien komt dat omdat je meer bomen nodig hebt en de parameter mtry moet tunen. Misschien kun je bagging ook verbeteren door de parameter nbagg te verhogen naar 250 in plaats van de standaardwaarde 25.
Er zijn twee manieren om dit te doen: ofwel definieer je een functie die de learner aanroept en een parameter wijzigt, of je gebruikt de functie create.Learner(). In de volgende secties leer je meer over deze opties.
De eerste manier is met behulp van function(). Hierbij definieer je een functie die de learner aanroept en een parameter wijzigt. De functiedeclaratie gebruikt de ellipsis ... om extra argumenten aan een functie door te geven. Die drie puntjes maken het mogelijk om een formule te wijzigen zonder in de functie te hoeven specificeren wat die wijzigingen zijn. Dit betekent dat, als je 10 parameters wijzigt, je geen 10 objecten in de functie nodig hebt om in de functie te mappen. Het is een generaliseerbare manier om een functie te schrijven.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune is de naam van je aangepaste ranger-methode en SL.ipredbagg.tune is de naam van je aangepaste ipredbagg-methode. Nu je nieuwe learner-functies hebt gemaakt, kun je deze doorgeven aan de cross-validatieformule om te zien of de prestaties verbeteren.
Opmerking: je houdt de originele functies SL.ranger en SL.ipredbagg in het algoritme om te zien of de prestaties verbeteren ten opzichte van je getunede versies.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)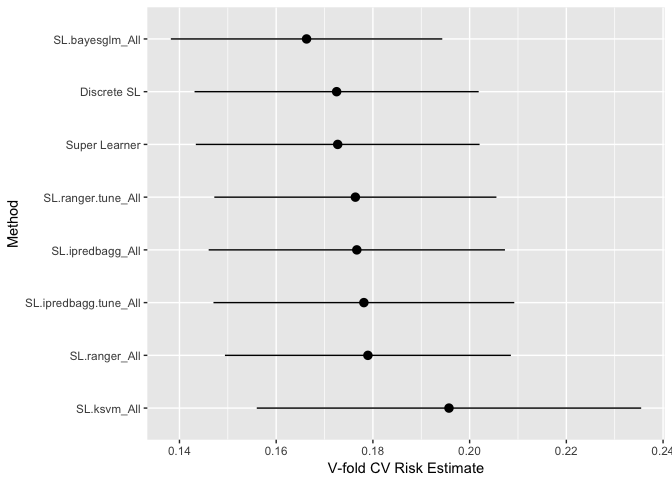
Uit deze grafiek kun je opmaken dat ipredbagg lijkt te verbeteren als je de parameter nbagg verhoogt, zoals te zien in SL.ipredbagg.tune. Ranger lijkt slechter te worden bij het tunen van de parameters, maar laten we hem toch meenemen en kijken of SuperLearner hem relevant vindt.
Nogmaals, het mooie is: SuperLearner zet het gewoon op nul als het niet relevant is. Onthoud dat de beste ensembles niet bestaan uit de best presterende algoritmen, maar uit de algoritmen die elkaar het beste aanvullen om een voorspelling te classificeren.
Laten we het nieuwe model met getunede parameters fitten en zien hoe ze wegen:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577SL.bayesglm en SL.ipredbagg.tune zijn nu de enige algoritmen die wegen in het ensemble. Voorspellen op de testset geeft het volgende resultaat:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Dit levert je een kleine verbetering op de testset op en illustreert de concepten van het gebruik van SuperLearner voor modeltuning.
create.Learner()De tweede methode om hyperparameters te tunen is het gebruik van de functie create.Learner(). Hiermee kun je een bestaande SuperLearner aanpassen:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
De tekenreeks met de learner is het eerste argument van de functie create.Learner(). Daarna geef je een lijst met te wijzigen parameters door. Dit creëert een object:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Wanneer je de learner aan SuperLearner doorgeeft, gebruik je de names-waarde in het learner-object:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)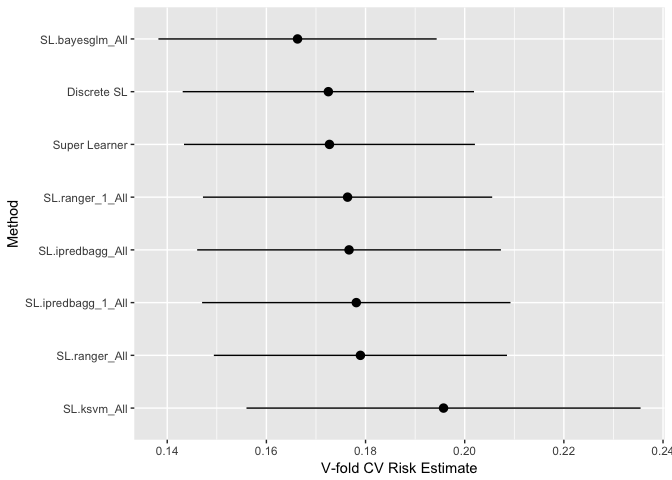
Het eindresultaat is hetzelfde als wanneer je de eerste methode gebruikte. Het is aan jou welke methode je kiest.
Wauw, je hebt veel behandeld! Tegen nu zou je een goed begrip van SuperLearner moeten hebben en je eerste ensemble met SuperLearner succesvol hebben gefit. Deze package maakt het lekker eenvoudig om snel modellen toe te voegen. Er zijn wat subtiliteiten met methoden en welke datavorm je gebruikt. Maar als je twijfelt, werkt een modelmatrix die als data frame is opgeslagen bijna altijd.
Ter herinnering: je hebt SuperLearner geïnstalleerd en geladen, je dataset geformatteerd, een enkel model gefit, je eerste ensemble gefit, met het ensemble voorspeld en wat hyperparameters getuned!
De volgende stappen zijn om meer geavanceerde onderwerpen met deze package aan te pakken, zoals parallelisatie, featureselectie en screening, het gebruik van modelmatrices, je eigen SuperLearner schrijven en cross-validatie van ensembles.
Bekijk DataCamps tutorial Machine Learning in R voor beginners.
Leer meer over R en machine learning
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

