Cours
Apprentissage supervisé en R : Régression
4 h
46.7K
Vous avez déjà voulu créer un ensemble de modèles en machine learning sans savoir par où commencer ? Ce tutoriel va vous guider pas à pas avec SuperLearner. Ce package R vous permet de construire facilement des ensembles de modèles via des fonctions de haut niveau, grâce à un wrapper standardisé pour entraîner un ensemble en s’appuyant sur des bibliothèques R populaires de machine learning comme glmnet, knn, randomForest et bien d’autres !
Dans ce tutoriel, vous allez aborder les thèmes suivants :
SuperLearner et que fait exactement ce package ?SuperLearner : vous apprendrez à installer les packages nécessaires, préparer les données et créer votre premier modèle d’ensemble. Vous verrez aussi comment l’entraîner et en tirer des prédictions. Ce faisant, vous couvrirez les SVM à noyau, les modèles linéaires généralisés bayésiens et le bagging. Enfin, vous verrez comment ajuster les hyperparamètres pour améliorer encore les performances.À la fin, vous aurez entraîné votre premier ensemble, prédit sur de nouvelles données et affiné certaines composantes de l’ensemble.
Tout cela est prometteur, mais qu’appelle-t-on précisément un ensemble ?
Un ensemble correspond à la combinaison des prédictions probabilistes ou numériques de plusieurs modèles de machine learning, par moyennage, pondération des modèles et sommation, ou encore en retenant l’observation majoritaire entre les modèles. On obtient ainsi un vote multiple qui a davantage de chances de conduire à la bonne classe en classification, ou de se rapprocher de la bonne valeur en régression. Les ensembles fonctionnent particulièrement bien lorsque les modèles qui les composent ne sont pas toujours d’accord. Dans la pratique, cette combinaison de modèles surpasse souvent les implémentations isolées d’algorithmes uniques.
On peut créer un ensemble manuellement en ajustant plusieurs modèles, en prédisant avec chacun, puis en combinant les sorties.
SuperLearner ?Maintenant que vous voyez ce qu’est un ensemble, vous vous demandez peut-être ce que fait concrètement la bibliothèque SuperLearner. En bref, SuperLearner est un algorithme qui utilise la validation croisée pour estimer les performances de plusieurs modèles de machine learning, ou d’un même modèle avec des réglages différents. Il crée ensuite une moyenne pondérée optimale de ces modèles, autrement dit un « ensemble », en s’appuyant sur les performances observées sur les jeux de test.
Mais pourquoi utiliser SuperLearner ?
Vous découvrirez toute la puissance de ce package R au fil du tutoriel, mais voici déjà quelques avantages :
SuperLearner vous permet d’ajuster un modèle d’ensemble en ajoutant simplement des algorithmes.SuperLearner s’appuie sur la validation croisée, utilisée nativement pour estimer le risque de tous les modèles. C’est idéal pour comparer des modèles.SuperLearner rend l’assemblage efficace en estimant automatiquement les poids de l’ensemble, une tâche habituellement fastidieuse et très expérimentale.SuperLearner élimine automatiquement les modèles qui ne contribuent pas au pouvoir prédictif de l’ensemble, ce qui vous laisse toute liberté pour expérimenter de nombreux algorithmes.Voyons le processus d’utilisation de SuperLearner.
SuperLearnerSuperLearnerSuperLearner s’installe depuis CRAN avec la fonction install.packages(), puis se charge dans votre session avec library() :
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Pour illustrer SuperLearner, vous allez utiliser le jeu de données Pima Indian Women du package MASS. Ce package propose un jeu d’entraînement pour ajuster un modèle et un jeu de test pour évaluer ses performances sur des données inédites. Le jeu de données fournit des variables descriptives sur des femmes Pima, comme le nombre de grossesses ou l’âge, ainsi que la présence ou non de diabète. L’objectif est de prédire le diabète.
La colonne type indique la présence de diabète. C’est une variable binaire Yes/No, c’est-à-dire qu’elle suit une loi binomiale.
Remarque : sans entrer dans la théorie, une loi binomiale correspond à une séquence d’épreuves de Bernoulli (succès/échec). On l’identifie facilement car il n’y a que deux modalités possibles, ici Yes ou No. Pourquoi ce rappel ? Parce que SuperLearner exige de définir la famille statistique du problème. Vous le verrez en détail lors de l’ajustement du modèle plus loin dans ce tutoriel.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Astuce : pour en savoir plus sur les variables de ce jeu de données, utilisez la fonction help(), comme ceci :
help(Pima.tr)En exécutant cette commande, vous confirmerez que la colonne type indique le diabète.
SuperLearner exige également que la variable réponse soit encodée pour les problèmes de classification. Puisqu’il s’agit ici d’une classification binomiale, vous allez encoder le facteur type en 0-1 :
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Comme type est un facteur, R l’encode en 1 et 2, ce qui n’est pas idéal : on préfère travailler avec 0 et 1, correspondant respectivement à "No" et "Yes". Dans le code ci-dessus, vous soustrayez 1 pour obtenir un encodage 0-1. R respecte aussi l’ordre des modalités du facteur.
Le package demande également de séparer les prédicteurs (X) et la réponse (Y) dans des structures distinctes. Vous avez isolé Y ci-dessus, il faut maintenant isoler X. Faites-le aussi pour le jeu de test :
     x <- data.frame(train[,1:7])
    xtest <- data.frame(test[,1:7])
Remarque : certains algorithmes ne se contentent pas d’un data frame, ils exigent une matrice de modèle (model matrix) enregistrée comme data frame. C’est le cas par exemple de nnet. En régression, vous utiliserez presque toujours une matrice de modèle avec SuperLearner. Une matrice de modèle décompose les variables factorielles en colonnes indicatrices 0-1 au lieu de valeurs textuelles. Les colonnes numériques ne sont pas affectées. Le nombre de colonnes augmente, ce qui peut rallonger les temps de calcul. Sur un petit jeu comme celui-ci, l’impact est minime, mais il peut être important sur de gros volumes. Moralité : choisissez vos algorithmes cibles avant l’ajustement. Pour cet exemple simple, nous conservons le data frame tel quel.
SuperLearnerPour démarrer, utilisez la commande suivante pour lister les modèles disponibles dans le package :
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Vous verrez des wrappers d’algorithmes de prédiction et des wrappers de sélection (screening). On y retrouve des bibliothèques populaires utilisables en classification, en régression ou les deux. Les algorithmes de screening servent à la sélection automatique de variables dans SuperLearner.
Pour utiliser un algorithme de la liste, vous devez avoir installé son package dans votre environnement. En effet, SuperLearner appelle ces packages pour ajuster les modèles lorsque vous sélectionnez la méthode. Si vous n’utilisez jamais, par exemple, SL.caret, vous n’avez pas besoin d’installer caret.
L’ajustement est simple, mais parcourons-le pas à pas avec un exemple unitaire.
Nous allons ajuster l’algorithme Ranger, une implémentation plus rapide du célèbre Random Forest.
Rappel : Random Forest est une méthode puissante qui est elle-même un ensemble d’arbres de décision. Un arbre de décision segmente les données en calculant des seuils de probabilité sur chaque variable du modèle, traçant un chemin vers la prédiction. Les arbres ont tendance à sur‑apprendre, c’est‑à‑dire à mal se généraliser sur de nouvelles données. Random Forest résout ce problème en faisant croître de multiples arbres sur des échantillons bootstrap et en moyennant leurs prédictions. Il ne retient aussi qu’un sous-ensemble de variables à chaque échantillon, ce qui le distingue du pur bagging d’arbres. On obtient un modèle moins sujet au sur‑apprentissage. Plutôt malin, non ?
Ici, vous devrez peut‑être installer la bibliothèque ranger avec install.packages() avant d’ajuster le modèle.
Une fois fait, utilisez SL.ranger dans la fonction SuperLearner().
Comme Random Forest (et donc Ranger) intègre de l’aléatoire, vous n’obtiendrez pas exactement le même résultat à chaque entraînement. Pour cette démonstration, fixez la graine aléatoire afin de reproduire les exemples et comparer plusieurs modèles sur la même base. En R, on utilise set.seed(). Ici, nous prendrons 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner requiert une variable Y (la réponse), une variable X (les prédicteurs), la family (gaussienne ou binomiale) et la bibliothèque sous forme de liste. Ici, c’est SL.ranger.
Vous comprenez maintenant l’intérêt de la discussion sur la loi binomiale : utiliser un modèle gaussien n’aurait pas produit des prédictions cohérentes dans l’intervalle 0‑1.
Afficher simplement le modèle renvoie le coefficient (poids de l’algorithme dans l’ensemble) et le risque (erreur produite). En coulisses, le package ajuste chaque algorithme de l’ensemble pour estimer ce risque.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1Ici, le risque est inférieur à 0,20. Il faudra bien sûr le valider par une validation croisée externe et sur le jeu de test, mais c’est un bon départ. La force de SuperLearner, c’est de construire automatiquement un ensemble via la validation croisée. Évidemment, s’il n’y a qu’un modèle, il porte tout le poids.
Très bien pour un seul modèle, mais sans SuperLearner on pourrait déjà en faire autant. Comment ajuster de vrais ensembles ?
Assembler avec SuperLearner revient à choisir les algorithmes à combiner. Ajoutons les SVM à noyau (KSVM) du kernlab, les modèles linéaires généralisés bayésiens (GLM) du arm et le bagging du ipred.
Mais que sont les KSVM et Bayes GLM ?
Les KSVM utilisent le « kernel trick » pour calculer les distances entre points. Plutôt que de projeter explicitement les variables dans un espace de caractéristiques, la méthode à noyau calcule les produits scalaires entre points, ce qui accélère les calculs. Le SVM apprend ensuite une frontière de décision (souvent non linéaire) entre classes, et classe les nouveaux points de part et d’autre de cette frontière selon leur position.
Le modèle Bayes GLM est ici une implémentation de la régression logistique pour un problème 0‑1. Il diffère des KSVM en ce qu’il met à jour les coefficients via un algorithme de régression augmentée. Le bagging ressemble au Random Forest décrit plus haut, mais sans sous‑échantillonnage des variables : on fait croître plusieurs arbres sur des échantillons aléatoires puis on moyenne leurs prédictions.
Passons à l’ajustement de votre premier ensemble !
Astuce : n’oubliez pas d’installer ces packages s’ils ne sont pas déjà présents. D’autres dépendances pourront aussi être nécessaires.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818L’ajout de ces algorithmes a amélioré votre modèle et changé l’équilibre : Ranger et KVSM ont désormais un coefficient nul, donc ne pèsent plus dans l’ensemble. Bayes GLM et le bagging constituent tout le poids. SuperLearner calcule pour vous le risque et choisit le mix optimal pour réduire l’erreur.
Pour comprendre la contribution spécifique de chaque modèle et sa variabilité, utilisez la validation croisée interne via CV.SuperLearner(). Le nombre de folds se règle avec l’argument V. Ici, prenez 5 :
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022Le résumé de la validation croisée montre le risque moyen du modèle, sa variation et l’étendue des risques.
On peut aussi tracer un graphique lisible des modèles et de leur variabilité :
plot(cv.model)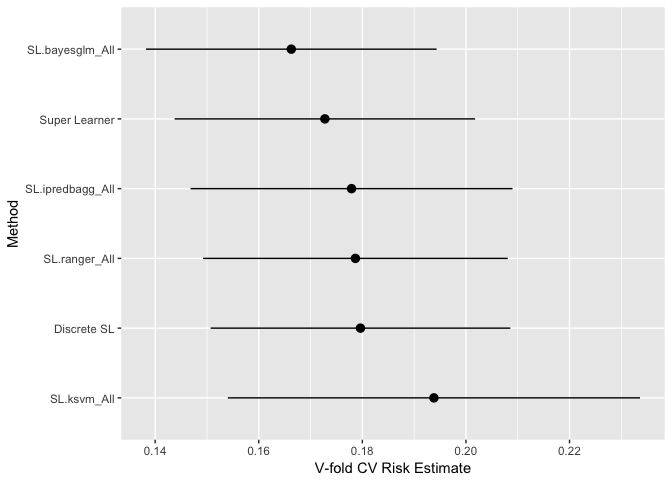
On voit facilement que Bayes GLM est en moyenne le plus performant, tandis que KSVM est le moins performant et présente davantage de variabilité. L’atout de SuperLearner, c’est que si un modèle s’ajuste mal ou contribue peu, son poids est ramené à zéro. Inutile de l’enlever et de réentraîner, sauf si vous prévoyez de réentraîner plus tard. Gardez en tête qu’un entraînement rigoureux implique la validation croisée de l’ensemble complet. En production, c’est ainsi qu’on estime le risque avant toute prédiction.
Avec la fonction dédiée predict.SuperLearner(), vous pouvez facilement prédire sur de nouveaux jeux de données. Cela signifie que vous ne pouvez pas utiliser la fonction predict() standard.
predictions <- predict.SuperLearner(model, newdata=xtest)La fonction predict.SuperLearner() prend un modèle (ajusté par SuperLearner) et de nouvelles données. Elle renvoie d’abord les prédictions globales de l’ensemble :
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Elle renvoie aussi les prédictions individuelles de chaque bibliothèque :
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Cela vous permet de voir comment chaque modèle a classé chaque observation. Utile pour déboguer ou comparer plusieurs modèles à la fois.
Vous avez sans doute remarqué que les sorties sont des probabilités. Il faut donc définir un seuil pour classer en 1 ou 0 (uniquement en classification binaire, pas en régression).
Normalement, ce seuil se choisit à l’entraînement via la validation croisée, mais pour faire simple, prenons 0,50. Comme il s’agit d’un problème binaire, utilisez la fonction ifelse() de dplyr pour recoder les probabilités :
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Vous pouvez maintenant construire une matrice de confusion avec caret pour examiner les résultats :
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Vous obtenez une exactitude d’environ 0,7921687 sur ce jeu, ce qui est correct. D’autres algorithmes font mieux, mais c’est un bon résultat pour un ensemble rapide. Avec une validation croisée rigoureuse et d’autres modèles, vous pouvez améliorer ce score.
Même si les performances sont honorables, vous pouvez tenter de les améliorer en ajustant certains hyperparamètres des modèles de l’ensemble. Ranger est peu pondéré dans votre modèle ; peut‑être faut‑il plus d’arbres et ajuster mtry. Vous pouvez aussi améliorer le bagging en augmentant nbagg à 250 (par défaut : 25).
Deux méthodes : définir une fonction qui appelle l’apprenant et modifie un paramètre, ou utiliser create.Learner(). Vous allez voir ces deux options.
Première approche avec function() : vous définissez une fonction qui appelle l’apprenant et modifie un paramètre. L’appel utilise l’ellipse ... pour transmettre des arguments supplémentaires. Ces trois petits points autorisent des modifications sans devoir les énumérer dans la définition. Si vous changez 10 paramètres, vous n’avez pas besoin de 10 objets dans la fonction : c’est une manière généralisable d’écrire.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune est le nom de votre variante de ranger, et SL.ipredbagg.tune celui de la variante ipredbagg. Vous pouvez maintenant passer ces nouveaux apprenants à la formule de validation croisée pour voir si les performances s’améliorent.
Remarque : conservez aussi les fonctions originales SL.ranger et SL.ipredbagg pour comparer avec vos versions ajustées.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)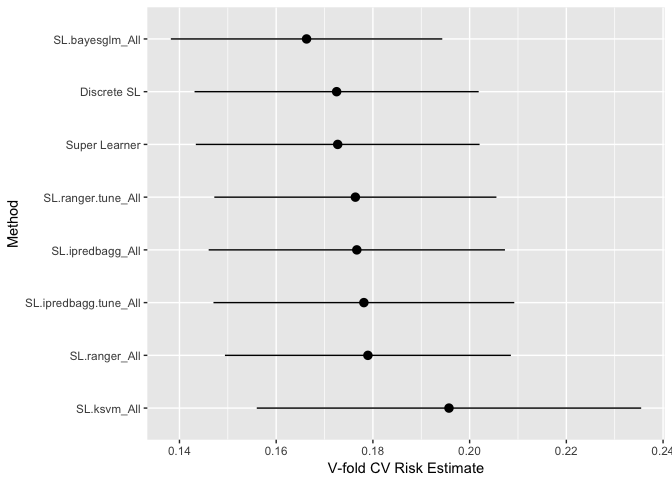
Vous voyez sur ce graphique que ipredbagg s’améliore en augmentant nbagg (voir SL.ipredbagg.tune). Ranger semble moins bien se comporter avec ces réglages, mais laissons-le : SuperLearner jugera de sa pertinence.
Encore une fois, l’avantage est que SuperLearner ramènera simplement son poids à zéro si ce n’est pas pertinent. N’oubliez pas : les meilleurs ensembles ne sont pas une somme des meilleurs algorithmes, mais la combinaison la plus complémentaire pour bien classer.
Entraînons le nouvel ensemble avec ces paramètres ajustés et voyons les pondérations :
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577SL.bayesglm et SL.ipredbagg.tune sont désormais les seuls algorithmes pondérés dans l’ensemble. La prédiction sur le jeu de test donne :
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##On observe un léger gain sur le jeu de test, ce qui illustre bien l’usage de SuperLearner pour l’ajustement de modèles.
create.Learner()La seconde méthode pour régler les hyperparamètres consiste à utiliser create.Learner(). Elle vous permet de personnaliser un SuperLearner existant :
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
Le premier argument de create.Learner() est le nom de l’apprenant, puis vous passez la liste des paramètres à modifier. Cela crée un objet :
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Ensuite, pour passer l’apprenant à SuperLearner, utilisez l’élément names de cet objet :
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)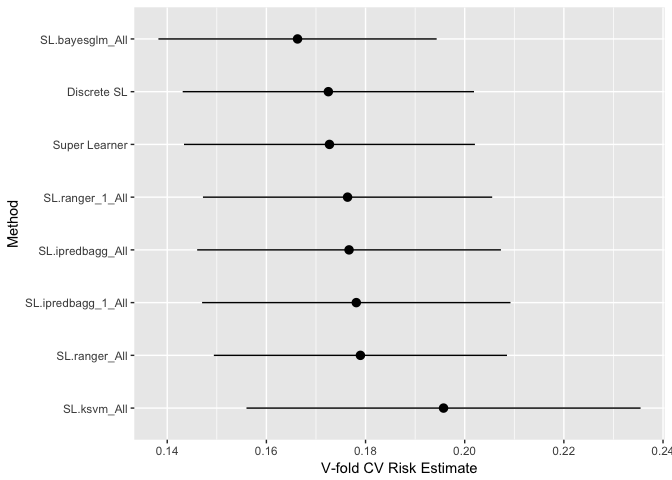
Le résultat final est identique à la première méthode. À vous de choisir celle qui vous convient le mieux.
Vous avez bien avancé ! Vous devriez maintenant être à l’aise avec SuperLearner et avoir entraîné avec succès votre premier ensemble. Ce package facilite l’ajout et la combinaison rapide de modèles. Il y a quelques subtilités liées aux méthodes et aux formats de données, mais en cas de doute, une matrice de modèle enregistrée comme data frame fonctionne presque toujours.
Pour récapituler, vous avez installé et chargé SuperLearner, formaté votre jeu de données, ajusté un modèle unique, construit votre premier ensemble, prédit avec l’ensemble et ajusté quelques hyperparamètres.
Les prochaines étapes pourraient inclure des sujets plus avancés : parallélisation, sélection et screening de variables, utilisation des matrices de modèle, écriture de vos propres apprenants SuperLearner et validation croisée d’ensembles.
Consultez le tutoriel de DataCamp Machine Learning in R for beginners.
Approfondir R et le machine learning
Cours
Cours
Cours