
Last chance! 50% off DataCamp Premium
Sale ends in
Hai mai voluto costruire un ensemble di machine learning ma non sapevi da dove cominciare? Questo tutorial ti mette sulla strada giusta con SuperLearner. Questo pacchetto R ti offre un modo semplice per creare ensemble di machine learning tramite funzioni di alto livello, fornendo un wrapper standardizzato per adattare un ensemble usando librerie R popolari per il machine learning come glmnet, knn, randomForest e molte altre!
In questo tutorial affronterai i seguenti argomenti:
SuperLearner e cosa fa esattamente questo pacchetto?SuperLearner: in questa sezione imparerai a installare i pacchetti necessari, preparare i dati e creare il tuo primo modello ensemble! Vedrai anche come addestrare il modello e usarlo per fare previsioni. In questo modo toccherai le Kernel Support Vector Machines, i modelli Bayes Generalized Linear e il Bagging. Infine, vedrai come regolare gli iperparametri per migliorare ulteriormente le prestazioni del modello!Al termine avrai adattato il tuo primo ensemble, effettuato previsioni su nuovi dati e ottimizzato alcune parti dell’ensemble.
Tutto questo è fantastico, ma cos’è esattamente un ensemble?
Un ensemble si ha quando le previsioni di probabilità o le previsioni numeriche di più modelli di machine learning vengono combinate facendo una media, pesando ogni modello e sommando i risultati, oppure usando l’osservazione più comune tra i modelli. Questo crea uno scenario a “voto multiplo” che tende a spingere la previsione verso la classe corretta o, nei modelli di regressione, verso un valore più vicino a quello corretto. Gli ensemble funzionano al meglio quando ci sono disaccordi tra i modelli adattati. Il concetto di combinare più modelli si dimostra efficace in pratica, spesso superando le implementazioni di singoli algoritmi.
Gli ensemble possono essere creati manualmente adattando più modelli, facendo previsioni con ognuno di essi e poi combinandole.
SuperLearner?Ora che hai visto cosa sono gli ensemble, potresti chiederti cosa faccia esattamente la libreria SuperLearner. In poche parole, SuperLearner è un algoritmo che usa la cross-validation per stimare le prestazioni di più modelli di machine learning, o dello stesso modello con impostazioni diverse. Quindi crea una media pesata ottimale di tali modelli, chiamata anche “ensemble”, utilizzando le prestazioni sui dati di test.
Ma perché dovresti usare SuperLearner?
Anche se nel corso del tutorial scoprirai meglio la potenza di questo pacchetto R, puoi già considerare questi vantaggi:
SuperLearner ti permette di adattare un modello ensemble semplicemente aggiungendo algoritmiSuperLearner utilizza la cross-validation, impiegata intrinsecamente per stimare il rischio di tutti i modelli. Questo rende SuperLearner ottimo per il confronto tra modelli!SuperLearner rende efficiente l’ensembling stimando automaticamente i pesi dell’ensemble. Normalmente è un compito noioso e richiede molti esperimenti.SuperLearner rimuove automaticamente i modelli che non contribuiscono al potere predittivo dell’ensemble, lasciandoti libero di sperimentare con numerosi algoritmi!Vediamo il processo per usare SuperLearner.
SuperLearnerSuperLearner PackageSuperLearner può essere installato da CRAN con la funzione install.packages() e poi caricato nell’ambiente di lavoro con la funzione library():
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")Per illustrare SuperLearner, userai il dataset Pima Indian Women dal pacchetto MASS. Il pacchetto MASS contiene un training set, usato per addestrare un modello, e un test set, usato per valutarne le prestazioni su dati non visti. Il dataset fornisce alcuni fattori descrittivi sulle donne Pima Indian come numero di gravidanze e età e se hanno o meno il diabete. Lo scopo del dataset è cercare di predire il diabete.
La colonna type indica la presenza di diabete. È una colonna binaria Yes o No, quindi segue una distribuzione binomiale.
Nota: senza entrare troppo nella teoria, una distribuzione binomiale è una collezione di prove di Bernoulli, che sono test di successo o insuccesso in probabilità. Una distribuzione binomiale è facilmente riconoscibile perché ci sono solo due possibili risposte, in questo caso Yes o No. Perché serve? SuperLearner richiede di definire la famiglia del problema a cui appartiene il tuo modello. Lo vedrai in dettaglio quando adatterai il modello più avanti nel tutorial.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00Suggerimento: se vuoi maggiori informazioni sulle variabili di questo dataset, usa la funzione help(), come qui:
help(Pima.tr)Eseguendo il comando sopra, puoi dedurre che la colonna type indica il diabete.
SuperLearner richiede anche che la variabile risposta sia codificata se si tratta di un problema di classificazione. Poiché stai risolvendo un problema di classificazione binomiale, codificherai il fattore per la variabile type in una codifica 0-1:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
Poiché la colonna type era un fattore, R la codificherà come 1 e 2, ma non è ciò che vuoi: idealmente, vorresti lavorare con type codificato come 0 e 1, che corrispondono rispettivamente a "No" e "Yes". Nel blocco di codice sopra, sottrai 1 all’intero vettore per ottenere la codifica 0-1. R manterrà anche l’ordine del fattore.
Il pacchetto richiede inoltre che i predittori (X) e le risposte (Y) siano in strutture dati separate. Sopra hai separato Y, ora devi separare X. Procederai anche a separare il set di test:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Nota: alcuni algoritmi non richiedono solo un data frame, ma necessitano di una model matrix salvata come data frame. Un esempio è l’algoritmo nnet. Quando risolvi un problema di regressione, quasi sempre userai la model matrix per memorizzare i dati per SuperLearner. Una model matrix non fa altro che suddividere le variabili fattoriali in colonne proprie e ricodificarle in valori 0-1 invece che testuali. Non influisce sulle colonne numeriche. La model matrix aumenterà il numero di colonne con cui l’algoritmo deve confrontarsi e quindi potrebbe aumentare i tempi computazionali. Per un dataset piccolo come questo, l’impatto è minimo, ma dataset più grandi potrebbero essere pesantemente influenzati. La morale è decidere quali algoritmi vuoi provare prima di adattare il modello. Per questo semplice esempio, userai semplicemente il data frame come struttura dati esistente.
SuperLearnerPer iniziare a creare il tuo primo modello, puoi usare il seguente comando per vedere quali modelli sono disponibili nel pacchetto:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Noterai che ci sono wrapper per algoritmi di previsione e wrapper per algoritmi di screening. Qui ci sono alcune librerie popolari che possono essere usate per classificazione, regressione o entrambe. Gli algoritmi di screening sono usati da SuperLearner per la selezione automatica delle variabili.
Quando vuoi usare un algoritmo dall’elenco sopra, devi avere il pacchetto installato nel tuo ambiente. Questo perché SuperLearner richiama realmente questi pacchetti per adattare i modelli quando il metodo è usato. Significa anche che, se per esempio non usi mai il metodo SL.caret, non hai bisogno di avere installato il pacchetto caret.
Adattare il modello è semplice, ma percorrerai questo passaggio passo dopo passo con un esempio a singolo modello.
Adatterai l’algoritmo Ranger, un’implementazione più veloce del famoso Random Forest.
Ricorda che una Random Forest è un metodo potente che in realtà è un ensemble di alberi decisionali. Gli alberi decisionali analizzano i dati e calcolano una soglia di probabilità tra ciascuna variabile del modello, fornendo un percorso verso la previsione. Gli alberi decisionali tendono a overfittare i loro dati, cioè non generalizzano bene a nuovi dati. La Random Forest risolve questo problema facendo crescere più alberi decisionali basati su numerosi campioni di dati e poi mediando tali previsioni per trovare quella corretta. Inoltre seleziona solo un sottoinsieme di feature per ogni campione, differenziandosi così dal bagging di alberi. Questo crea un modello che non overfitta i dati. Fantastico, no?
In questo caso, potresti dover prima installare la libreria ranger con la funzione install.packages() prima di iniziare ad adattare il modello.
Fatto ciò, puoi procedere e usare SL.ranger nella funzione SuperLearner().
Poiché Random Forest – e quindi Ranger – include campionamento casuale nell’algoritmo, non otterrai lo stesso risultato se lo adatti più volte. Pertanto, per questo esercizio imposterai il seed in modo da poter riprodurre gli esempi e confrontare anche più modelli sulla stessa base casuale. R usa set.seed() per impostare il seed. Il seed può essere qualsiasi numero; in questo caso userai 150.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner richiede una variabile Y, cioè la risposta o l’esito desiderato, una variabile X, cioè le variabili predittive, la family da usare, che può essere gaussian o binomial, e la libreria da usare sotto forma di lista. In questo caso è SL.ranger.
Ricordi la discussione sulla distribuzione binomiale che hai letto prima? Ecco perché serviva: usare il modello gaussian non avrebbe prodotto previsioni corrette nel tuo intervallo 0-1.
Successivamente, la semplice stampa del modello fornisce il coefficiente, cioè il peso dell’algoritmo nel modello, e il fattore di rischio, ossia l’errore prodotto dall’algoritmo. Dietro le quinte, il pacchetto adatta ciascun algoritmo usato nell’ensemble per calcolare il fattore di rischio.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1In questo caso, il tuo fattore di rischio è inferiore a 0,20. Ovviamente andrà testato tramite cross-validation esterna e sul test set, ma è un buon inizio. Il bello di SuperLearner è che prova ad assemblare automaticamente un ensemble tramite la cross-validation. Naturalmente, se c’è un solo modello, allora ottiene tutto il peso dell’ensemble.
Questo singolo modello è ottimo, ma potresti farlo senza SuperLearner. Come puoi adattare modelli ensemble?
Creare un ensemble con SuperLearner è semplice come selezionare gli algoritmi da usare. In questo caso, aggiungiamo le Kernel Support Vector Machines (KSVM) dal pacchetto kernlab, i Bayes Generalized Linear Models (GLM) dal pacchetto arm e il bagging dal pacchetto ipred.
Ma cosa sono KSVM e Bayes GLM?
Le KSVM usano la cosiddetta “kernel trick” per calcolare la distanza tra i punti. Invece di dover disegnare una mappa delle feature e calcolarne le coordinate, il metodo kernel calcola i prodotti interni tra i punti. Questo consente un calcolo più veloce. Poi la support vector machine viene usata per apprendere il confine non lineare tra i punti in classificazione. Una support vector machine tenta di creare un divario tra due classi in un problema di machine learning spesso non lineare. Classifica quindi i nuovi punti da un lato o dall’altro di quel divario in base alla loro posizione nello spazio.
Il modello Bayes GLM è semplicemente un’implementazione della regressione logistica. Almeno in questo caso, in cui stai classificando un problema 0-1. Bayes GLM differisce da KSVM perché usa un algoritmo di regressione aumentata per aggiornare i coefficienti a ogni passo. Il bagging è simile alla random forest descritta sopra, ma senza il sottoinsieme di feature. Ciò significa che farai crescere più alberi decisionali da campioni casuali e ne farai la media per ottenere la previsione.
Ora adattiamo il tuo primo ensemble!
Suggerimento: non dimenticare di installare questi pacchetti se non li hai ancora! Inoltre, potresti essere invitato a installare altri pacchetti richiesti.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818L’aggiunta di questi algoritmi ha migliorato il modello e cambiato lo scenario. Ranger e KVSM hanno coefficiente zero, il che significa che non sono più pesati nell’ensemble. Bayes GLM e Bagging costituiscono il resto del peso del modello. Noterai che SuperLearner calcola per te questo rischio e decide il mix di modelli ottimale per ridurre l’errore.
Per capire il contributo specifico di ciascun modello e la variazione, puoi usare la funzione di cross-validation interna di SuperLearner, CV.SuperLearner(). Per impostare il numero di fold, usa l’argomento V. In questo caso lo imposterai a 5:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022Il riepilogo della cross-validation mostra il rischio medio del modello, la sua variabilità e l’intervallo del rischio.
Tracciandolo ottieni anche un bel grafico dei modelli usati e della loro variazione:
plot(cv.model)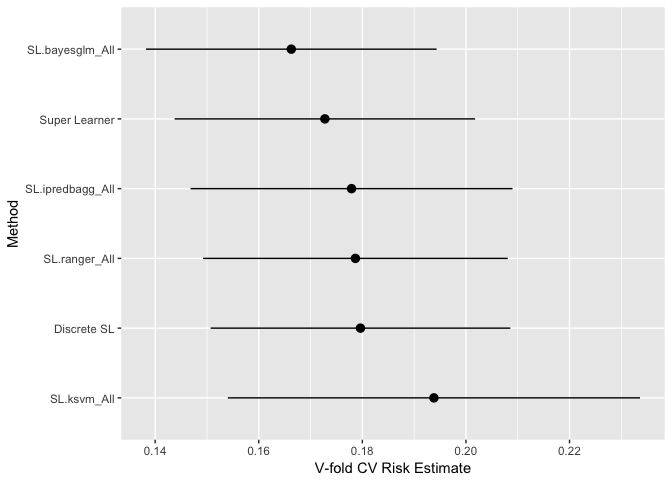
È facile vedere che Bayes GLM in media offre le prestazioni migliori, mentre KSVM è il peggiore e presenta molta variabilità rispetto agli altri modelli. Il bello di SuperLearner è che, se un modello non si adatta bene o contribuisce poco, viene semplicemente pesato a zero! Non serve rimuoverlo e riaddestrare, a meno che tu non abbia in programma di riaddestrare il modello in futuro. Ricorda solo che un corretto addestramento del modello comporta la cross-validation dell’intero modello. In un contesto reale, è così che determineresti il rischio del modello prima di prevedere nuovi dati.
Con il comando specifico predict.SuperLearner() puoi facilmente fare previsioni su nuovi dataset. Ciò significa che non puoi usare la normale funzione predict()!
predictions <- predict.SuperLearner(model, newdata=xtest)La funzione predict.SuperLearner() accetta un argomento model (un modello adattato SuperLearner) e nuovi dati su cui prevedere. Le previsioni restituiranno prima le previsioni complessive dell’ensemble:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Restituirà anche le previsioni dei singoli modelli della libreria:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Questo ti consente di vedere come ogni modello ha classificato ciascuna osservazione. Può essere utile per il debug del modello o per adattare più modelli contemporaneamente e vedere quali approfondire.
Potresti aver notato che le quantità previste sono restituite come probabilità. Ciò significa che ti serve una soglia di taglio per decidere se classificare come uno o zero. Questo va fatto solo nei casi di classificazione binomiale, non in regressione.
Normalmente lo determineresti in addestramento con la cross-validation, ma per semplicità userai una soglia di 0,50. Poiché questo è un semplice problema binomiale, userai la funzione ifelse() di dplyr per ricodificare le probabilità:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Ora puoi costruire una matrice di confusione con caret per rivedere i risultati:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Stai ottenendo un’accuratezza di circa 0,7921687 su questo dataset, che è una buona prestazione. Molti algoritmi hanno ottenuto punteggi più alti, ma questo è buono per un ensemble rapido. Con un adeguato addestramento tramite cross-validation e provando modelli diversi, è facile vedere come migliorare rapidamente questo punteggio.
Anche se le prestazioni non sono pessime, puoi provare a migliorarle regolando alcuni iperparametri dei modelli presenti nell’ensemble. Ranger non era pesato molto nel tuo modello, ma magari è perché servono più alberi e va regolato il parametro mtry. Forse puoi migliorare anche il bagging aumentando il parametro nbagg a 250 rispetto al valore predefinito di 25.
Ci sono due metodi per farlo: o definisci una funzione che richiama il learner e modifica un parametro, oppure usi la funzione create.Learner(). Nelle prossime sezioni imparerai di più su queste opzioni.
Il primo metodo sfrutta function(). Qui definisci una funzione che richiama il learner e modifica un parametro. La chiamata alla funzione usa l’ellissi ... per passare argomenti aggiuntivi. Quei tre puntini consentono di apportare modifiche a una formula senza dover specificare nella funzione quali siano tali modifiche. Ciò significa che, se stai cambiando 10 parametri, non ti servono 10 oggetti nella funzione da mappare al suo interno. È un modo generalizzabile di scrivere una funzione.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune è il nome del tuo metodo ranger modificato e SL.ipredbagg.tune è il nome del tuo metodo ipredbagg modificato. Ora che hai creato alcune nuove funzioni learner, puoi passarle alla formula di cross-validation per vedere se le prestazioni migliorano.
Nota: manterrai le funzioni originali SL.ranger e SL.ipredbagg nell’algoritmo per vedere se le prestazioni migliorano rispetto alle versioni ottimizzate.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)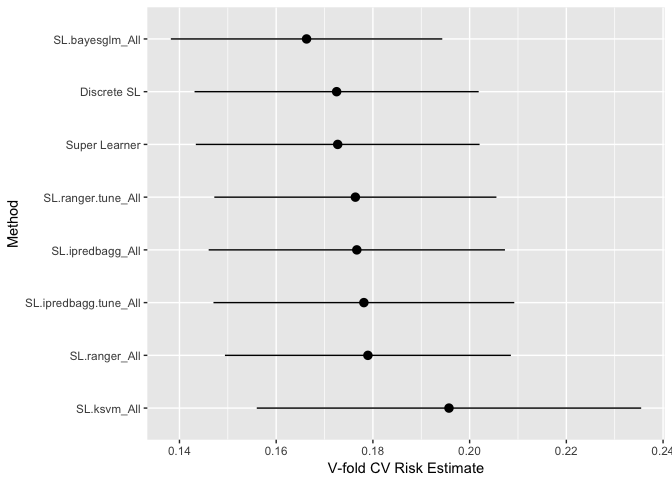
Da questo grafico puoi vedere che ipredbagg sembra migliorare aumentando il parametro nbagg, come si vede in SL.ipredbagg.tune. Ranger sembra peggiorare con la regolazione dei parametri, ma lasciamolo e vediamo se SuperLearner lo considera rilevante.
Di nuovo, il bello è che SuperLearner lo imposterà semplicemente a zero se non è rilevante. Ricorda che i migliori ensemble non sono composti dagli algoritmi migliori in assoluto, ma dagli algoritmi che si completano meglio a vicenda per classificare una previsione.
Adattiamo il nuovo modello con parametri ottimizzati e vediamo come vengono pesati:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577SL.bayesglm e SL.ipredbagg.tune sono ora gli unici algoritmi pesati nell’ensemble. Predire sul test set dà il seguente risultato:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Questo ti dà un piccolo miglioramento sul test set e illustra i concetti di utilizzo di SuperLearner per l’ottimizzazione dei modelli.
create.Learner()Il secondo metodo per regolare gli iperparametri è usare la funzione create.Learner(). Ti consente di personalizzare un SuperLearner esistente:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
La stringa del learner è il primo argomento della funzione create.Learner(). Poi passi una lista dei parametri da modificare. Questo creerà un oggetto:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Ora, quando passi il learner a SuperLearner, usa l’elemento names dell’oggetto learner:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)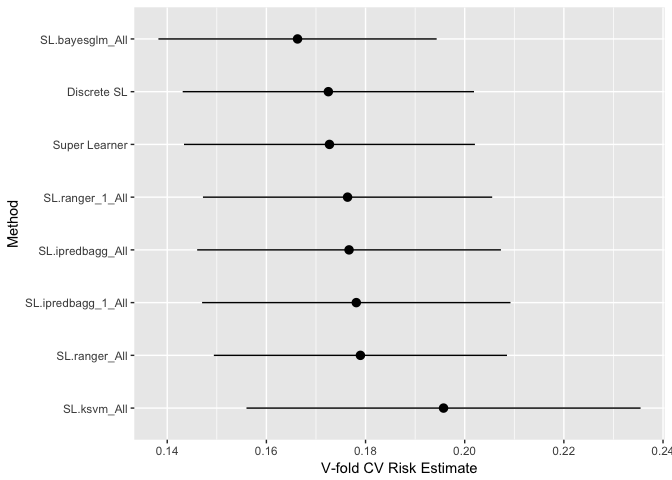
Il risultato finale è lo stesso del primo metodo. Sta a te scegliere il metodo che preferisci.
Wow, hai coperto un sacco di terreno! A questo punto dovresti avere una buona padronanza di SuperLearner e aver adattato con successo il tuo primo ensemble con SuperLearner. Questo pacchetto rende semplice e veloce aggiungere modelli. Ci sono alcune sottigliezze sui metodi e sulla forma dei dati da usare. Tuttavia, nel dubbio, una model matrix salvata come data frame funziona quasi sempre.
In sintesi, hai installato e caricato SuperLearner, formattato il tuo dataset, adattato un singolo modello, creato il tuo primo ensemble, fatto previsioni con l’ensemble e regolato alcuni iperparametri!
I prossimi passi potrebbero essere affrontare argomenti più avanzati con questo pacchetto, come parallelizzazione, selezione e screening delle feature, uso delle model matrix, scrivere un tuo SuperLearner e cross-validation dell’ensemble.
Dai un’occhiata al tutorial di DataCamp Machine Learning in R per principianti.
Approfondisci R e il Machine Learning
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



