{count, plural, one {Kurs} other {Kurs}}
R'de Supervised Learning: Regresyon
{hours} sa
46.8K
Hiç bir makine öğrenimi topluluğu (ensemble) oluşturmak isteyip nereden başlayacağınızı bilemediniz mi? Bu eğitim, SuperLearner ile yol gösterecek. Bu R paketi, glmnet, knn, randomForest ve daha birçok popüler R makine öğrenimi kütüphanesini kullanarak yüksek seviyeli fonksiyonlarla standartlaştırılmış bir sarmalayıcı sunar ve böylece makine öğrenimi topluluklarını kolayca oluşturmanızı sağlar!
Bu eğitimde şu konulara değineceksiniz:
SuperLearner ve bu paket tam olarak ne yapar?SuperLearner kullanarak Topluluk Öğrenimi: Bu bölümde, gerekli paketleri nasıl kuracağınızı, verileri nasıl hazırlayacağınızı ve ilk topluluk modelinizi nasıl oluşturacağınızı öğreneceksiniz! Ayrıca modeli nasıl eğitebileceğinizi ve onunla nasıl tahmin yapabileceğinizi göreceksiniz. Bunu yaparken Çekirdek Destek Vektör Makineleri, Bayes Genelleştirilmiş Doğrusal Modeller ve Bagging konularını ele alacaksınız. Son olarak, modelinizin performansını daha da iyileştirmek için hiperparametreleri nasıl ayarlayabileceğinizi göreceksiniz!Bitirdiğinizde, ilk topluluğunuzu eğitmiş, yeni veriler üzerinde tahmin yapmış ve topluluğun bazı parçalarını ayarlamış olacaksınız.
Tüm bunlar harika, peki topluluk tam olarak nedir?
Topluluk, birden fazla makine öğrenimi modelinin olasılık veya sayısal tahminlerinin ortalama alınarak, her modele ağırlık verilip toplanarak ya da modeller arasındaki en yaygın gözlemin kullanılmasıyla birleştirilmesiyle oluşur. Bu, birden fazla oyun olduğu ve tahmini doğru sınıfa yönlendirme ya da regresyon modellerinde doğru sayıya yaklaştırma olasılığını artıran bir oylama durumu sağlar. Topluluklar, genellikle birbirinden farklı sonuçlar veren modeller olduğunda en iyi şekilde çalışır. Birden fazla modeli birleştirme fikri uygulamada da genellikle tek algoritma uygulamalarının üzerinde performans gösterir.
Topluluklar, birden fazla modeli uydurup her biriyle tahmin yaparak ve ardından bunları birleştirerek manuel olarak da oluşturulabilir.
SuperLearner?Artık toplulukların ne olduğunu gördüğünüze göre, SuperLearner kütüphanesinin tam olarak ne yaptığını merak ediyor olabilirsiniz. Kısaca, SuperLearner birden fazla makine öğrenimi modelinin ya da aynı modelin farklı ayarlarla çalışmasının performansını çapraz doğrulama ile tahmin eden bir algoritmadır. Ardından test verisi performansını kullanarak bu modellerin optimal ağırlıklı ortalamasını, yani bir “topluluk” oluşturur.
Peki neden SuperLearner kullanmalısınız?
Bu R paketinin gücü hakkında eğitim boyunca daha çok şey öğrenecek olsanız da, şimdiden şu avantajları düşünebilirsiniz:
SuperLearner, yalnızca algoritmalar ekleyerek bir topluluk modeli uydurmanıza olanak tanır.SuperLearner içkin olarak tüm modeller için riski tahmin etmekte kullanılan çapraz doğrulamayı kullanır. Bu, SuperLearner'ı model karşılaştırması için harika kılar!SuperLearner, topluluğun ağırlıklarını otomatik olarak tahmin ederek topluluk kurmayı verimli hale getirir. Bu normalde oldukça zahmetli ve çok deney gerektiren bir görevdir.SuperLearner, topluluk tahmin gücüne katkıda bulunmayan modelleri otomatik olarak çıkarır; bu da sizi çok sayıda algoritma ile özgürce deneme yapmaya bırakır!Şimdi SuperLearner kullanım sürecine bir göz atalım.
SuperLearner Kullanarak Topluluk ÖğrenimiSuperLearner Paketini KurunSuperLearner, install.packages() fonksiyonu ile CRAN'dan kurulabilir ve ardından library() fonksiyonu ile çalışma alanınıza yüklenebilir:
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")SuperLearner'ı örneklendirmek için MASS paketindeki Pima Indian Women veri setini kullanacaksınız. MASS paketi, bir modeli eğitmek için kullanılan bir eğitim seti ve modeli görülmemiş veriler üzerinde değerlendirmek için kullanılan bir test seti içerir. Veri seti, Pima Indian Women hakkında hamilelik sayısı ve yaş gibi bazı tanımlayıcı faktörleri ve diyabet durumunu içerir. Veri setinin amacı diyabeti tahmin etmektir.
type sütunu diyabetin varlığını gösterir. Bu sütun ikili Yes veya No değerlerinden oluşur; bu da binom dağılımını izlediği anlamına gelir.
Not: Çok teorikleşmeden söylemek gerekirse, binom dağılımı, her biri başarı-başarısızlık testi olan Bernoulli denemelerinin bir koleksiyonudur. Binom dağılımı, sadece iki olası yanıt olduğu için kolayca tanınır; bu durumda Yes veya No. Peki bunu neden anlatıyoruz? Çünkü SuperLearner, modelinizin ait olacağı problem ailesini tanımlamanızı ister. Bunu bu eğitimde modeli daha sonra uydururken daha ayrıntılı göreceksiniz.
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00İpucu: Bu veri setinin değişkenleri hakkında daha fazla bilgi almak isterseniz, burada olduğu gibi help() fonksiyonunu kullanın:
help(Pima.tr)Yukarıdaki komutu çalıştırarak, type sütununun diyabeti gösterdiğini çıkarsayabilirsiniz.
Sınıflandırma problemi söz konusu olduğunda SuperLearner, yanıt değişkeninin kodlanmasını da ister. Binom sınıflandırma problemi çözdüğünüz için, type değişkeni için faktörü 0-1 kodlamasına çevireceksiniz:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
type sütunu bir faktör olduğundan, R bunu 1 ve 2 olarak kodlayacaktır; ancak bu istediğiniz şey değildir: ideal olarak, türün sırasıyla "No" ve "Yes" olacak şekilde 0 ve 1 olarak kodlanmasını istersiniz. Yukarıdaki kod bloğunda, 0-1 kodlamasını elde etmek için tüm kümeden 1 çıkarıyorsunuz. R bunu faktör sırasına göre de kodlayacaktır.
Paket ayrıca yordayıcıların (X) ve yanıtların (Y) kendi veri yapılarında bulunmasını gerektirir. Yukarıda Y'yi ayırdınız, şimdi de X'i ayırmanız gerekiyor. Test setinizi de ayırabilirsiniz:
     x <- data.frame(train[,1:7])
xtest <- data.frame(test[,1:7])Not: Bazı algoritmalar yalnızca bir veri çerçevesi değil, veri çerçevesi olarak kaydedilmiş bir model matrisine ihtiyaç duyar. Örneğin nnet algoritması böyledir. Bir regresyon problemi çözerken, SuperLearner için verilerinizi saklamak üzere neredeyse her zaman model matrisini kullanırsınız. Bir model matrisi, faktör değişkenlerini kendi sütunlarına ayırır ve metin değerler yerine 0-1 olarak yeniden kodlar. Sayısal sütunları etkilemez. Model matrisi, bir algoritmanın uğraşacağı sütun sayısını artırır; bu da hesaplama süresini uzatabilir. Bu gibi küçük bir veri setinde etkisi asgari düzeydedir, ancak büyük veri setlerinde ciddi etkisi olabilir. Çıkarılacak ders, modelinizi uydurmadan önce hangi algoritmaları denemek istediğinize karar vermektir. Bu basit örnekte mevcut veri yapısı için veri çerçevesini kullanacaksınız.
SuperLearner ile İlk Topluluk Modelinizİlk modelinizi oluşturmaya başlamak için, pakette hangi modellerin mevcut olduğunu önizlemek üzere şu komutu kullanabilirsiniz:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"Tahmin algoritması sarmalayıcıları ve tarama (screening) algoritması sarmalayıcıları olduğunu fark edeceksiniz. Burada, sınıflandırma, regresyon veya her ikisi için kullanılabilecek bazı popüler kütüphaneler vardır. Tarama algoritmaları SuperLearner tarafından otomatik değişken seçimi için kullanılır.
Yukarıdaki listeden bir algoritma kullanmak istediğinizde, paketin ortamınızda kurulu olması gerekir. Çünkü SuperLearner aslında bu paketleri çağırır ve yöntem kullanıldığında modelleri uydurur. Bu aynı zamanda, örneğin hiç SL.caret yöntemini kullanmazsanız, caret paketinin kurulu olmasına gerek olmadığı anlamına gelir.
Modeli uydurmak basittir; ancak bunu tek model örneğiyle adım adım ele alacağız.
Ünlü Random Forest'ın daha hızlı bir uygulaması olan Ranger algoritmasını uyduracaksınız.
Unutmayın, Random Forest aslında karar ağaçlarının bir toplulaştırılması (ensembling) olan güçlü bir yöntemdir. Karar ağaçları, verilerinizi gözlemleyerek ve modeldeki her değişken arasında bir olasılık bölünmesi hesaplayarak tahmininize giden bir yol oluşturur. Karar ağaçları verilerine aşırı uyum sağlama eğilimindedir; bu da yeni verilere iyi genellenmedikleri anlamına gelir. Random Forest, verilerin çok sayıda örneğine dayanarak birden çok karar ağacı büyütüp bu tahminlerin ortalamasını alarak doğru tahmini bulur ve böylece bu sorunu çözer. Ayrıca her örnek için özelliklerin yalnızca bir alt kümesini seçer; bu yönüyle ağaç bagging'inden ayrılır. Bu da veriye aşırı uyum sağlamayan bir model oluşturur. Harika, değil mi?
Bu durumda, modeli uydurmaya başlamadan önce install.packages() fonksiyonu ile ranger kütüphanesini kurmanız gerekebilir.
Bunu yaptıysanız, SuperLearner() fonksiyonunda SL.ranger kullanmaya devam edebilirsiniz.
Random Forest —dolayısıyla Ranger— algoritmada rastgele örnekleme içerdiğinden, modeli birden fazla kez uydurursanız aynı sonucu alamazsınız. Bu nedenle, bu alıştırma için, örnekleri tekrar üretmek ve aynı rastgele tohum temelinde birden çok modeli karşılaştırmak için tohum (seed) ayarlayacaksınız. R, rastgele tohumu ayarlamak için set.seed() kullanır. Tohum herhangi bir sayı olabilir; burada 150 kullanacaksınız.
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
SL.library=list("SL.ranger"))SuperLearner, hedef veya istenen çıktıyı temsil eden bir Y değişkeni, yordayıcı değişkenleri içeren bir X değişkeni, kullanılacak family (gaussian veya binomial olabilir) ve liste şeklinde kütüphane ister. Bu durumda SL.ranger.
Az önce okuduğunuz binom dağılımı tartışmasını hatırlıyor musunuz? Şimdi neden bunu bilmeniz gerektiğini görüyorsunuz: gaussian modeli kullanmak, 0-1 aralığınızdaki uygun tahminleri vermezdi.
Ardından, modeli basitçe yazdırmak, modelde algoritmanın ağırlığı olan katsayıyı ve algoritmanın ürettiği hatayı temsil eden risk faktörünü verir. Paket, perde arkasında, risk faktörünü üretmek için toplulukta kullanılan her algoritmayı uydurur.
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1Bu durumda risk faktörünüz 0,20'den küçüktür. Elbette bu, harici çapraz doğrulama ve test setiyle sınanmalıdır, ancak iyi bir başlangıçtır. SuperLearner'ın güzelliği, çapraz doğrulama kullanarak otomatik olarak bir topluluk oluşturmaya çalışmasıdır. Elbette, yalnızca bir model varsa, topluluğun tüm ağırlığını o alır.
Bu tek model güzel, ancak bunu SuperLearner olmadan da yapabilirsiniz. Peki topluluk modellerini nasıl uydurursunuz?
SuperLearner ile topluluk oluşturmak, kullanılacak algoritmaları seçmek kadar basittir. Bu durumda, kernlab paketinden Çekirdek Destek Vektör Makineleri (KSVM), arm paketinden Bayes Genelleştirilmiş Doğrusal Modeller (GLM) ve ipred paketinden bagging ekleyelim.
Peki KSVM ve Bayes GLM nedir?
KSVM, noktalar arasındaki mesafeyi hesaplamak için “çekirdek hilesi”ni kullanır. Özelliklerin haritasını çizip koordinatları hesaplamak yerine, çekirdek yöntemi noktalar arasındaki iç çarpımları hesaplar. Bu, daha hızlı hesaplama sağlar. Ardından sınıflandırmada noktalar arasındaki doğrusal olmayan sınırı öğrenmek için destek vektör makinesi kullanılır. Bir destek vektör makinesi, genellikle doğrusal olmayan bir makine öğrenimi probleminde iki sınıf arasında bir boşluk oluşturmaya çalışır. Daha sonra uzaydaki konumlarına göre yeni noktaları bu boşluğun iki yanında sınıflandırır.
Bayes GLM modeli, basitçe bir lojistik regresyon uygulamasıdır. En azından bu 0-1 sınıflandırma durumunda öyledir. Bayes GLM, her adımda katsayıları güncellemek için artırımlı bir regresyon algoritması kullanması bakımından KSVM'den farklıdır. Bagging ise, özellikleri alt kümeye ayırmadan yapılan, yukarıdaki random forest’a benzer bir yöntemdir. Bu, rastgele örneklerden birden çok karar ağacı büyüteceğiniz ve tahmininizi elde etmek için bunların ortalamasını alacağınız anlamına gelir.
Şimdi ilk topluluğunuzu uyduralım!
İpucu: Bu paketler sizde yoksa kurmayı unutmayın! Ayrıca diğer gerekli paketleri kurmanız için de uyarı alabilirsiniz.
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818Bu algoritmaları eklemek modelinizi iyileştirdi ve tabloyu değiştirdi. Ranger ve KVSM'nin katsayısı sıfır; bu da artık topluluğun bir parçası olarak ağırlıklandırılmadıkları anlamına gelir. Bayes GLM ve Bagging, modelin geri kalan ağırlığını oluşturur. SuperLearner'ın riski sizin için hesapladığını ve hatayı azaltacak en iyi model karışımına karar verdiğini fark edeceksiniz.
Her bir modelin modele özgü katkısını ve değişkenliğini anlamak için SuperLearner'ın dahili çapraz doğrulama fonksiyonu CV.SuperLearner()'ı kullanabilirsiniz. Kat sayısını ayarlamak için V argümanını kullanabilirsiniz. Bu durumda 5 olarak ayarlayacaksınız:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022Çapraz doğrulama özeti, modelin ortalama riskini, modelin değişkenliğini ve risk aralığını gösterir.
Bunu çizmek de kullanılan modellerin ve bunların varyasyonlarının güzel bir görselleştirmesini üretir:
plot(cv.model)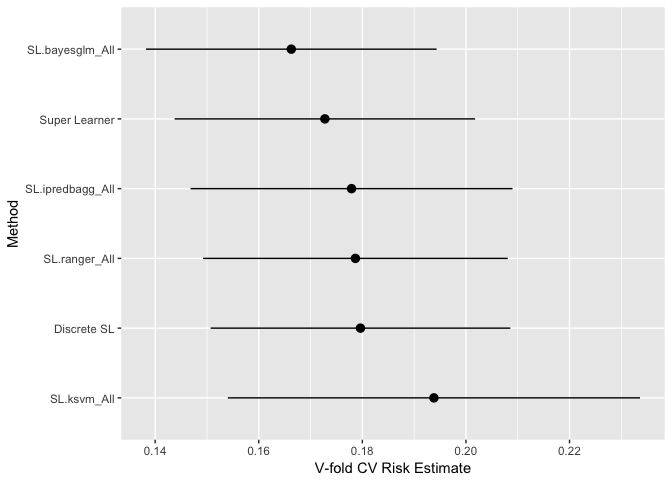
Ortalama olarak Bayes GLM'nin en iyi performansı gösterdiğini, KSVM'nin ise en kötü performansı gösterip diğer modellere kıyasla çok fazla varyasyon içerdiğini kolayca görebilirsiniz. SuperLearner'ın güzelliği şudur: Bir model iyi uymuyor veya fazla katkı sağlamıyorsa, ağırlığı sıfıra düşürülür! Onu kaldırmanıza ve yeniden eğitmenize gerek yoktur, ta ki modeli gelecekte yeniden eğitmeyi planlamadığınız sürece. Yalnızca uygun model eğitiminin tüm modelin çapraz doğrulamasını içerdiğini unutmayın. Gerçek dünyada, yeni verileri tahmin etmeden önce modelin riskini bu şekilde belirlersiniz.
Özel predict.SuperLearner() komutuyla yeni veri setleri üzerinde kolayca tahmin yapabilirsiniz. Bu, normal predict() fonksiyonunu kullanamayacağınız anlamına gelir!
predictions <- predict.SuperLearner(model, newdata=xtest)predict.SuperLearner() fonksiyonu bir model argümanı (bir SuperLearner fit modeli) ve üzerinde tahmin yapılacak yeni veriyi alır. Tahminler önce genel topluluk tahminlerini döndürecektir:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451Ayrıca bireysel kütüphane tahminlerini de döndürecektir:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132Bu, her modelin her bir gözlemi nasıl sınıflandırdığını görmenizi sağlar. Modeli hata ayıklamada veya aynı anda birden fazla modeli uydurup hangisini daha ileri götüreceğinize karar vermede yararlı olabilir.
Döndürülen tahmin büyüklüklerini fark etmiş olabilirsiniz. Bunlar olasılık biçimindedir. Bu, bir veya sıfır olarak sınıflandırmanız gerekip gerekmediğini belirlemek için bir eşik değeri gerekeceği anlamına gelir. Bu yalnızca binom sınıflandırma durumunda yapılmalıdır; regresyonda değil.
Normalde bunu eğitim sırasında çapraz doğrulamayla belirlersiniz; ancak basitlik adına 0,50 eşiğini kullanacaksınız. Bu basit binom probleminde, olasılıkları yeniden kodlamak için dplyr'ın ifelse() fonksiyonunu kullanacaksınız:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
Şimdi sonuçları incelemek için caret ile bir karışıklık matrisi (confusion matrix) oluşturabilirsiniz:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
Bu veri setinde yaklaşık 0,7921687 doğruluk elde ediyorsunuz; bu, bu veri seti için iyi bir performanstır. Daha yüksek puan alan birçok algoritma oldu, ancak bu hızlı bir topluluk için iyidir. Uygun bir çapraz doğrulama eğitimi ve farklı modelleri denemeyle bu skoru nasıl hızlıca iyileştirebileceğinizi görmek kolay.
Model performansı fena olmasa da, topluluktaki bazı modellerin hiperparametrelerini ayarlayarak performansı artırmayı deneyebilirsiniz. Ranger modelinizde ağırlık yüksek değildi; ancak belki de daha fazla ağaca ihtiyaç duyuyorsunuz ve mtry parametresini ayarlamalısınız. Belki bagging'i de varsayılan 25 yerine 250 olacak şekilde nbagg parametresini artırarak iyileştirebilirsiniz.
Bunu yapmanın iki yöntemi vardır: Ya öğreniciyi çağırıp bir parametreyi değiştiren bir fonksiyon tanımlarsınız ya da create.Learner() fonksiyonunu kullanırsınız. Sonraki bölümlerde bu seçenekler hakkında daha fazla bilgi edineceksiniz.
İlki, function()'dan yararlanmaktır. Burada, öğreniciyi çağıran ve bir parametreyi değiştiren bir fonksiyon tanımlarsınız. Fonksiyon çağrısı, bir fonksiyona ek argümanları iletmek için üç nokta ... kullanır. Bu üç küçük nokta, fonksiyon içinde bu değişikliklerin ne olduğunu belirtmek zorunda kalmadan bir formülde değişiklik yapılmasına izin verir. Yani 10 parametre değiştiriyorsanız, fonksiyonda eşleştirmek için 10 nesneye ihtiyacınız yoktur. Bu, fonksiyon yazmanın genelleştirilebilir bir yoludur.
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
}SL.ranger.tune, değiştirilmiş ranger yönteminizin adı; SL.ipredbagg.tune ise değiştirilmiş ipredbagg yönteminizin adı. Artık yeni öğrenici fonksiyonlarınız olduğuna göre, performansın iyileşip iyileşmediğini görmek için bunları çapraz doğrulama formülüne iletebilirsiniz.
Not: Ayarlanmış sürümlerinizde performansın iyileşip iyileşmediğini görmek için algoritmada orijinal SL.ranger ve SL.ipredbagg fonksiyonlarını tutacaksınız.
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)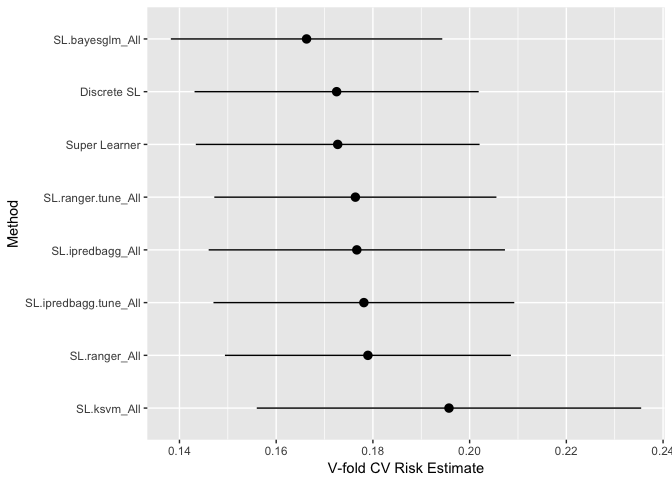
Bu grafikten, SL.ipredbagg.tune'da görüldüğü gibi nbagg parametresini artırdıkça ipredbagg'in iyileşiyor gibi göründüğünü görebilirsiniz. Ranger ise parametreleri ayarlayınca daha kötüleşiyor gibi görünüyor; ancak bunu bırakalım ve SuperLearner'ın onu ilgili bulup bulmadığına bakalım.
Yine güzellik şu ki, SuperLearner ilgili değilse onu sıfıra ayarlayacaktır. En iyi toplulukların en iyi performans gösteren algoritmalardan değil, bir tahmini sınıflandırmada birbirini en iyi şekilde tamamlayan algoritmalardan oluştuğunu unutmayın.
Şimdi ayarlanmış parametrelerle yeni modeli uyduralım ve ağırlıklarının nasıl dağıldığını görelim:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577Artık toplulukta yalnızca SL.bayesglm ve SL.ipredbagg.tune ağırlıklandırılıyor. Test setinde tahmin yapmak aşağıdaki sonucu verir:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##Bu, test setinde küçük bir iyileşme sağlar ve model ayarı için SuperLearner kullanımının kavramlarını gösterir.
create.Learner()Hiperparametreleri ayarlamanın ikinci yöntemi create.Learner() fonksiyonunu kullanmaktır. Bu, mevcut bir SuperLearner'ı özelleştirmenizi sağlar:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
create.Learner() fonksiyonunun ilk argümanı öğrenici karakter dizgesidir. Ardından değiştirilecek parametrelerin bir listesini iletirsiniz. Bu, bir nesne oluşturur:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2Artık öğreniciyi SuperLearner'a geçirirken, öğrenici nesnesindeki names öğesini kullanırsınız:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)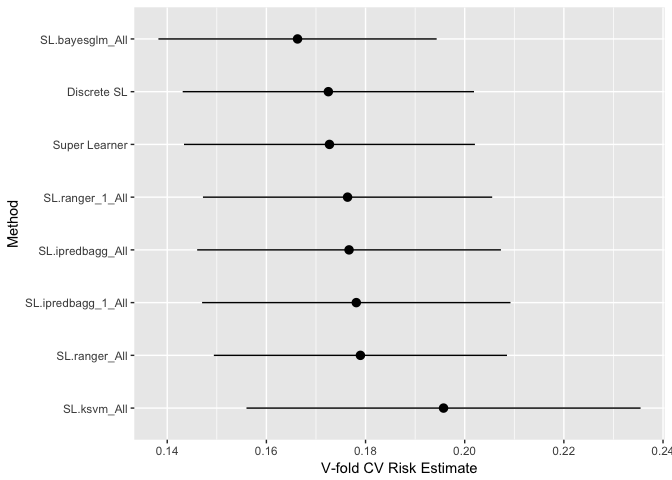
Sonuç, ilk yöntemi kullansaydınız elde edeceğinizle aynıdır. Hangi yöntemi tercih edeceğiniz size kalmış.
Vay, bir hayli yol kat ettiniz! Artık SuperLearner’ı iyi kavramış olmalı ve SuperLearner ile ilk topluluğunuzu başarıyla uydurmuş olmalısınız. Bu paket, modellere çok hızlı bir şekilde ekleme yapmayı kolaylaştırır. Yöntemlerle ve hangi veri biçiminin kullanılacağıyla ilgili bazı incelikler vardır. Ancak emin olmadığınızda, veri çerçevesi olarak kaydedilmiş bir model matrisi neredeyse her zaman işe yarar.
Hatırlatma olarak, SuperLearner'ı kurup yüklediniz, veri setinizi biçimlendirdiniz, tek bir model uydurdunuz, ilk topluluğunuzu uydurdunuz, toplulukla tahmin yaptınız ve bazı hiperparametreleri ayarladınız!
Sonraki adımlar, bu paketle paralelleştirme, özellik seçimi ve tarama, model matrisleri kullanımı, kendi SuperLearner’ınızı yazma ve topluluk çapraz doğrulaması gibi daha gelişmiş konulara eğilmek olacaktır.
DataCamp’in Yeni başlayanlar için R ile Makine Öğrenimi eğitimine göz atın.
R ve Makine Öğrenimi hakkında daha fazlasını öğrenin
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




