
Last chance! 50% off DataCamp Premium
Sale ends in
क्या आपने कभी मशीन लर्निंग एंसेंबल बनाना चाहा है, पर शुरुआत कैसे करें यह नहीं जानते थे? यह ट्यूटोरियल आपको SuperLearner के साथ शुरुआत करने में मदद करेगा। यह R पैकेज आपको लोकप्रिय R मशीन लर्निंग लाइब्रेरीज़ जैसे glmnet, knn, randomForest और कई अन्य के साथ एक मानकीकृत रैपर देकर उच्च-स्तरीय फ़ंक्शनों की मदद से मशीन लर्निंग एंसेंबल बनाने का आसान तरीका देता है!
इस ट्यूटोरियल में, आप निम्नलिखित विषयों से निपटेंगे:
SuperLearner और यह पैकेज वास्तव में करता क्या है?SuperLearner के साथ एंसेंबल लर्निंग: इस खंड में, आप ज़रूरी पैकेज इंस्टॉल करना, डेटा तैयार करना और अपना पहला एंसेंबल मॉडल बनाना सीखेंगे! आप यह भी देखेंगे कि आप मॉडल को कैसे ट्रेन कर सकते हैं और उससे प्रिडिक्शन कैसे कर सकते हैं। ऐसा करते हुए, आप Kernel Support Vector Machines, Bayes Generalized Linear Models और Bagging को कवर करेंगे। आख़िर में, आप देखेंगे कि अपने मॉडल के प्रदर्शन को और बेहतर करने के लिए हाइपरपैरामीटर्स को कैसे ट्यून करें!जब आप समाप्त करेंगे, तब तक आप अपना पहला एंसेंबल फ़िट कर चुके होंगे, नए डेटा की भविष्यवाणी कर चुके होंगे और एंसेंबल के कुछ भागों को ट्यून कर चुके होंगे।
यह सब बढ़िया है, लेकिन एंसेंबल वास्तव में है क्या?
एंसेंबल तब बनता है जब कई मशीन लर्निंग मॉडलों की प्रायिकता-आधारित या संख्यात्मक भविष्यवाणियों को औसत करके, प्रत्येक मॉडल को वज़न देकर जोड़कर, या मॉडलों के बीच सबसे आम अवलोकन का उपयोग करके संयोजित किया जाता है। इससे बहु-मतदान जैसी स्थिति बनती है जो किसी प्रिडिक्शन को सही वर्ग तक पहुँचाने या रिग्रेशन मॉडलों में सही संख्या के क़रीब ले जाने की संभावना बढ़ाती है। एंसेंबल तब सबसे अच्छा काम करते हैं जब फ़िट किए जा रहे मॉडल आपस में असहमत हों। कई मॉडलों को जोड़ने की यह अवधारणा व्यवहार में अक्सर अच्छा प्रदर्शन करती है, अक्सर एकल एल्गोरिदम के इम्प्लीमेंटेशन से बेहतर।
एंसेंबल को मैन्युअली भी बनाया जा सकता है: कई मॉडल फ़िट करके, प्रत्येक से प्रिडिक्शन लेकर और फिर उन्हें संयोजित करके।
SuperLearner?अब जब आपने देख लिया कि एंसेंबल क्या होते हैं, तो आप सोच सकते हैं कि SuperLearner लाइब्रेरी वास्तव में करती क्या है। सरल शब्दों में, SuperLearner एक ऐसा एल्गोरिदम है जो क्रॉस-वैलिडेशन का उपयोग करके कई मशीन लर्निंग मॉडलों (या एक ही मॉडल के अलग-अलग सेटिंग्स) के प्रदर्शन का अनुमान लगाता है। फिर यह टेस्ट डेटा के प्रदर्शन के आधार पर उन मॉडलों का एक आदर्श वेटेड एवरेज बनाता है, जिसे “एंसेंबल” भी कहा जाता है।
लेकिन आप SuperLearner का उपयोग क्यों करेंगे?
हालाँकि आप इस ट्यूटोरियल में इस R पैकेज की ताकत के बारे में और जानेंगे, फिर भी आप पहले से ही इन फायदों पर विचार कर सकते हैं:
SuperLearner आपको बस एल्गोरिदम जोड़कर एंसेंबल मॉडल फ़िट करने देता हैSuperLearner क्रॉस-वैलिडेशन का उपयोग करता है, जो सभी मॉडलों के लिए जोखिम का अनुमान लगाने के लिए स्वाभाविक रूप से प्रयोग होता है। यह SuperLearner को मॉडल तुलना के लिए शानदार बनाता है!SuperLearner एंसेंबलिंग को कुशल बनाता है क्योंकि यह एंसेंबल के वेट्स को स्वतः अनुमानित करता है। यह आम तौर पर बहुत थकाऊ काम होता है और बहुत सारे प्रयोगों की ज़रूरत पड़ती है।SuperLearner स्वतः उन मॉडलों को हटा देता है जो एंसेंबल की प्रिडिक्शन क्षमता में योगदान नहीं देते—इससे आप ढेर सारे एल्गोरिदम के साथ निःसंकोच प्रयोग कर सकते हैं!आइए देखें कि SuperLearner का उपयोग करने की प्रक्रिया कैसी दिखती है।
SuperLearner के साथ एंसेंबल लर्निंगSuperLearner पैकेज इंस्टॉल करेंSuperLearner को CRAN से install.packages() फ़ंक्शन के ज़रिए इंस्टॉल किया जा सकता है और फिर library() फ़ंक्शन के उपयोग से अपने वर्कस्पेस में लोड किया जा सकता है:
 # Install the package
install.packages("SuperLearner")

# Load the package
library("SuperLearner")SuperLearner को समझाने के लिए, आप MASS पैकेज के Pima Indian Women डेटा सेट का उपयोग करेंगे। MASS पैकेज में एक ट्रेनिंग सेट है, जिसका उपयोग मॉडल को ट्रेन करने के लिए किया जाता है, और एक टेस्ट सेट है, जिसका उपयोग अनदेखे डेटा पर मॉडल के प्रदर्शन का आकलन करने के लिए किया जाता है। डेटा सेट में Pima Indian Women के बारे में कुछ वर्णनात्मक कारक दिए गए हैं जैसे गर्भधारण की संख्या और उम्र, तथा यह कि उन्हें डायबिटीज़ है या नहीं। इस डेटा सेट का उद्देश्य डायबिटीज़ की भविष्यवाणी करना है।
type कॉलम वह कॉलम है जो डायबिटीज़ की उपस्थिति को दर्शाता है। यह बाइनरी Yes या No कॉलम है, जिसका मतलब है कि यह बायनॉमियल वितरण का अनुसरण करता है।
ध्यान दें कि, बहुत सैद्धांतिक हुए बिना, बायनॉमियल वितरण Bernoulli ट्रायल्स का संग्रह है, जो प्रायिकता में सफलता या असफलता की जाँच होते हैं। बायनॉमियल वितरण को आसानी से पहचाना जा सकता है क्योंकि केवल दो संभावित प्रतिक्रियाएँ होती हैं, इस मामले में Yes या No। यह क्यों ज़रूरी है? क्योंकि SuperLearner आपसे यह परिभाषित करने की अपेक्षा करता है कि आपका मॉडल किस परिवार की समस्या से संबंधित है। आप इसे इस ट्यूटोरियल में आगे मॉडल फ़िट करते समय विस्तार से देखेंगे।
     # Get the `MASS` library
    library(MASS)

    # Train and test sets
    train <- Pima.tr
    test <- Pima.te

    # Print out the first lines of `train`
    head(train)
## npreg glu bp skin bmi ped age type
## 1 5 86 68 28 30.2 0.364 24 No
## 2 7 195 70 33 25.1 0.163 55 Yes
## 3 5 77 82 41 35.8 0.156 35 No
## 4 0 165 76 43 47.9 0.259 26 No
## 5 0 107 60 25 26.4 0.133 23 No
## 6 5 97 76 27 35.6 0.378 52 Yes # Get a summary of `train`
summary(train) ## npreg glu bp skin
## Min. : 0.00 Min. : 56.0 Min. : 38.00 Min. : 7.00
## 1st Qu.: 1.00 1st Qu.:100.0 1st Qu.: 64.00 1st Qu.:20.75
## Median : 2.00 Median :120.5 Median : 70.00 Median :29.00
## Mean : 3.57 Mean :124.0 Mean : 71.26 Mean :29.21
## 3rd Qu.: 6.00 3rd Qu.:144.0 3rd Qu.: 78.00 3rd Qu.:36.00
## Max. :14.00 Max. :199.0 Max. :110.00 Max. :99.00
## bmi ped age type
## Min. :18.20 Min. :0.0850 Min. :21.00 No :132
## 1st Qu.:27.57 1st Qu.:0.2535 1st Qu.:23.00 Yes: 68
## Median :32.80 Median :0.3725 Median :28.00
## Mean :32.31 Mean :0.4608 Mean :32.11
## 3rd Qu.:36.50 3rd Qu.:0.6160 3rd Qu.:39.25
## Max. :47.90 Max. :2.2880 Max. :63.00टिप: अगर आप इस डेटा सेट के वेरिएबल्स पर अधिक जानकारी चाहते हैं, तो help() फ़ंक्शन का उपयोग करें, जैसे यहाँ:
help(Pima.tr)ऊपर दिए गए कमांड को चलाकर, आप निष्कर्ष निकाल सकते हैं कि type कॉलम डायबिटीज़ को इंगित करता है।
अगर यह एक क्लासिफिकेशन समस्या है, तो SuperLearner यह भी अपेक्षा करता है कि रिस्पॉन्स वेरिएबल एन्कोडेड हो। चूँकि आप बायनॉमियल क्लासिफिकेशन समस्या हल कर रहे हैं, आप type वेरिएबल के फ़ैक्टर को 0-1 एन्कोडिंग में बदलेंगे:
     y <- as.numeric(train[,8])-1
    ytest <- as.numeric(test[,8])-1
क्योंकि type कॉलम फ़ैक्टर था, R इसे 1 और 2 में एन्कोड करेगा, पर यह आपकी चाहत नहीं है: आदर्श रूप से, आप 0 और 1 की एन्कोडिंग के साथ काम करना चाहेंगे, जो क्रमशः "No" और "Yes" हैं। ऊपर के कोड में, आप पूरे सेट से 1 घटाते हैं ताकि 0-1 एन्कोडिंग मिल सके। R इसे फ़ैक्टर ऑर्डर में एन्कोड करेगा।
पैकेज यह भी अपेक्षा करता है कि प्रेडिक्टर्स (X) और रिस्पॉन्स (Y) अपनी-अपनी डेटा संरचनाओं में हों। आपने ऊपर Y को अलग कर लिया है, अब आपको X को अलग करना है। आप अपने टेस्ट सेट को भी अलग कर देंगे:
     x <- data.frame(train[,1:7])
    xtest <- data.frame(test[,1:7])
ध्यान दें कि कुछ एल्गोरिदम सिर्फ़ डेटा फ़्रेम ही नहीं, बल्कि एक मॉडल मैट्रिक्स (जो डेटा फ़्रेम के रूप में सेव हो) की माँग करते हैं। एक उदाहरण nnet एल्गोरिदम है। जब आप रिग्रेशन समस्या हल कर रहे हों, तो आप लगभग हमेशा SuperLearner के लिए अपने डेटा को स्टोर करने हेतु मॉडल मैट्रिक्स का उपयोग करेंगे। मॉडल मैट्रिक्स बस फ़ैक्टर वेरिएबल्स को उनकी अलग-अलग कॉलम्स में बाँटता है और उन्हें टेक्स्ट वैल्यूज़ के बजाय 0-1 वैल्यूज़ में रीकैड करता है। यह संख्यात्मक कॉलम्स को प्रभावित नहीं करता। मॉडल मैट्रिक्स एल्गोरिदम को डील करने वाली कॉलम्स की संख्या बढ़ा देगा, इसलिए यह कम्प्यूटेशनल समय बढ़ा सकता है। इस जैसे छोटे डेटा सेट के लिए इसका असर न्यूनतम है, लेकिन बड़े डेटा सेट्स पर प्रभाव ज़्यादा हो सकता है। निष्कर्ष यह है कि आपको अपना मॉडल फ़िट करने से पहले तय कर लेना चाहिए कि आप कौन-से एल्गोरिदम आज़माना चाहेंगे। इस सरल उदाहरण के लिए, आप मौजूदा डेटा संरचना के लिए डेटा फ़्रेम का ही उपयोग करेंगे।
SuperLearner के साथ आपका पहला एंसेंबल मॉडलअपना पहला मॉडल बनाना शुरू करने के लिए, आप पैकेज में उपलब्ध मॉडलों का पूर्वावलोकन करने हेतु निम्न कमांड का उपयोग कर सकते हैं:
listWrappers() ## All prediction algorithm wrappers in SuperLearner:
## [1] "SL.bartMachine" "SL.bayesglm" "SL.biglasso"
## [4] "SL.caret" "SL.caret.rpart" "SL.cforest"
## [7] "SL.dbarts" "SL.earth" "SL.extraTrees"
## [10] "SL.gam" "SL.gbm" "SL.glm"
## [13] "SL.glm.interaction" "SL.glmnet" "SL.ipredbagg"
## [16] "SL.kernelKnn" "SL.knn" "SL.ksvm"
## [19] "SL.lda" "SL.leekasso" "SL.lm"
## [22] "SL.loess" "SL.logreg" "SL.mean"
## [25] "SL.nnet" "SL.nnls" "SL.polymars"
## [28] "SL.qda" "SL.randomForest" "SL.ranger"
## [31] "SL.ridge" "SL.rpart" "SL.rpartPrune"
## [34] "SL.speedglm" "SL.speedlm" "SL.step"
## [37] "SL.step.forward" "SL.step.interaction" "SL.stepAIC"
## [40] "SL.svm" "SL.template" "SL.xgboost"
##
## All screening algorithm wrappers in SuperLearner:
## [1] "All"
## [1] "screen.corP" "screen.corRank" "screen.glmnet"
## [4] "screen.randomForest" "screen.SIS" "screen.template"
## [7] "screen.ttest" "write.screen.template"आप देखेंगे कि यहाँ प्रिडिक्शन एल्गोरिदम रैपर और स्क्रीनिंग एल्गोरिदम रैपर हैं। इनमें कुछ लोकप्रिय लाइब्रेरीज़ शामिल हैं जिन्हें क्लासिफिकेशन, रिग्रेशन या दोनों के लिए इस्तेमाल किया जा सकता है। स्क्रीनिंग एल्गोरिदम का उपयोग SuperLearner द्वारा स्वतः वेरिएबल चयन के लिए किया जाता है।
जब आप ऊपर दी गई सूची से किसी एल्गोरिदम का उपयोग करना चाहते हैं, तो आपके वातावरण में वह पैकेज इंस्टॉल होना चाहिए। ऐसा इसलिए है क्योंकि SuperLearner वास्तव में इन पैकेजों को कॉल करता है और जब मेथड का उपयोग किया जाता है, तब मॉडल फ़िट करता है। इसका यह भी मतलब है कि अगर आप, उदाहरण के लिए, कभी SL.caret मेथड का उपयोग नहीं करते, तो आपको caret पैकेज इंस्टॉल करने की ज़रूरत नहीं है।
मॉडल फ़िट करना सरल है, पर आप इसे एक सिंगल मॉडल उदाहरण के साथ चरणबद्ध तरीक़े से देखेंगे।
आप Ranger एल्गोरिदम फ़िट करेंगे, जो प्रसिद्ध Random Forest का तेज़ इम्प्लीमेंटेशन है।
याद रखें कि Random Forest एक शक्तिशाली विधि है जो वास्तव में निर्णय वृक्षों का एंसेंबल है। निर्णय वृक्ष आपके डेटा का अवलोकन करके और मॉडल में प्रत्येक वेरिएबल के बीच प्रायिकता-आधारित विभाजन की गणना करके काम करते हैं, जिससे प्रिडिक्शन तक एक रास्ता बनता है। निर्णय वृक्ष अपने डेटा पर ओवरफ़िट होने की आदत रखते हैं, यानी वे नए डेटा पर अच्छी तरह से जनरलाइज़ नहीं करते। Random Forest इस समस्या को कई सैंपल्स पर कई निर्णय वृक्ष उगाकर और फिर उन प्रिडिक्शनों को औसत करके हल करता है। यह प्रत्येक सैंपल के लिए फीचर्स का एक सबसेट भी चुनता है, जो इसे ट्री बैगिंग से अलग करता है। इससे ऐसा मॉडल बनता है जो डेटा पर ओवरफ़िट नहीं होता। बढ़िया, है न?
इस मामले में, संभव है कि आपको मॉडल फ़िट करने से पहले install.packages() फ़ंक्शन के साथ ranger लाइब्रेरी इंस्टॉल करनी पड़े।
यदि आपने यह कर लिया है, तो आप SuperLearner() फ़ंक्शन में SL.ranger का उपयोग कर सकते हैं।
क्योंकि Random Forest—और इसलिए Ranger—एल्गोरिदम में रैंडम सैम्पलिंग शामिल होती है, आप इसे एक से अधिक बार फ़िट करेंगे तो वही परिणाम नहीं मिलेंगे। इसलिए, इस अभ्यास के लिए, आप सीड सेट करेंगे ताकि आप उदाहरणों को दोहरा सकें और एक ही रैंडम सीड बेसलाइन पर कई मॉडलों की तुलना कर सकें। R set.seed() का उपयोग रैंडम सीड सेट करने के लिए करता है। सीड कोई भी संख्या हो सकती है, इस मामले में, आप 150 का उपयोग करेंगे।
    set.seed(150)
    single.model <- SuperLearner(y,
                                 x,
                                 family=binomial(),
                                 SL.library=list("SL.ranger"))
SuperLearner को एक Y वेरिएबल चाहिए, जो वह रिस्पॉन्स या आउटकम है जिसे आप चाहते हैं, एक X वेरिएबल, जो प्रेडिक्टर वेरिएबल्स हैं, उपयोग करने के लिए family, जो gaussian या binomial हो सकता है, और लाइब्रेरी, जिसे एक सूची के रूप में दिया जाता है। इस मामले में वह SL.ranger है।
क्या आपको पहले पढ़ी गई बायनॉमियल वितरण की चर्चा याद है? अब आप देखते हैं कि यह जानना क्यों ज़रूरी था: gaussian मॉडल का उपयोग करने पर आपके 0-1 रेंज में सही प्रिडिक्शन नहीं मिलते।
अगला, मॉडल को बस प्रिंट करने से कोएफ़िशिएंट (जो मॉडल में एल्गोरिदम का वज़न है) और रिस्क फैक्टर (जो एल्गोरिदम द्वारा उत्पन्न त्रुटि है) मिल जाता है। पर्दे के पीछे, पैकेज एंसेंबल में उपयोग किए प्रत्येक एल्गोरिदम को फ़िट करता है ताकि रिस्क फैक्टर निकाला जा सके।
single.model ##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1759541 1इस मामले में, आपका रिस्क फैक्टर 0.20 से कम है। बेशक, इसे बाहरी क्रॉस-वैलिडेशन और टेस्ट सेट के माध्यम से जाँचना होगा, लेकिन यह अच्छी शुरुआत है। SuperLearner की ख़ूबसूरती यह है कि यह क्रॉस-वैलिडेशन का उपयोग करके स्वतः एंसेंबल बनाने की कोशिश करता है। बेशक, अगर केवल एक मॉडल है, तो उसे एंसेंबल का पूरा वज़न मिलता है।
तो यह सिंगल मॉडल बढ़िया है, पर आप यह SuperLearner के बिना भी कर सकते थे। एंसेंबल मॉडल कैसे फ़िट करें?
SuperLearner के साथ एंसेंबलिंग उतना ही आसान है जितना कि उपयोग करने के लिए एल्गोरिदम चुनना। इस मामले में, आइए kernlab पैकेज से Kernel Support Vector Machines (KSVM), arm पैकेज से Bayes Generalized Linear Models (GLM) और ipred पैकेज से बैगिंग जोड़ें।
लेकिन KSVM और Bayes GLM क्या हैं?
KSVM “कर्नेल ट्रिक” नाम की तकनीक का उपयोग बिंदुओं के बीच दूरी निकालने के लिए करता है। फीचर्स का नक्शा बनाकर निर्देशांक निकालने के बजाय, कर्नेल विधि बिंदुओं के बीच आंतरिक गुणनफल (inner products) की गणना करती है। इससे गणना तेज़ होती है। फिर सपोर्ट वेक्टर मशीन का उपयोग क्लासिफिकेशन में बिंदुओं के बीच गैर-रेखीय सीमा सीखने के लिए किया जाता है। सपोर्ट वेक्टर मशीन मशीन लर्निंग समस्या में दो वर्गों के बीच एक गैप बनाने की कोशिश करती है, जो अक्सर नॉन-लीनियर होता है। फिर यह स्पेस में उनकी स्थिति के आधार पर नए बिंदुओं को उस गैप के किसी एक ओर वर्गीकृत करती है।
Bayes GLM मॉडल मूलतः लॉजिस्टिक रिग्रेशन का एक इम्प्लीमेंटेशन है—कम से कम इस मामले में, जहाँ आप 0-1 समस्या का वर्गीकरण कर रहे हैं। Bayes GLM KSVM से इस मायने में अलग है कि यह प्रत्येक स्टेप पर कोएफ़िशिएंट्स को अपडेट करने के लिए एक ऑगमेंटेड रिग्रेशन एल्गोरिदम का उपयोग करता है। बैगिंग ऊपर बताए गए रैंडम फ़ॉरेस्ट के समान है, बस इसमें फीचर्स का सबसेट नहीं लिया जाता। इसका मतलब है कि आप रैंडम सैम्पल्स से कई निर्णय वृक्ष उगाएँगे और अपनी प्रिडिक्शन पाने के लिए उन्हें औसत करेंगे।
अब आइए अपना पहला एंसेंबल फ़िट करें!
टिप: अगर आपके पास ये पैकेज अभी नहीं हैं, तो इन्हें इंस्टॉल करना न भूलें! साथ ही, आपसे अन्य आवश्यक पैकेज इंस्टॉल करने के लिए भी कहा जा सकता है।
     # Set the seed
    set.seed(150)

    # Fit the ensemble model
    model <- SuperLearner(y,
                          x,
                          family=binomial(),
                          SL.library=list("SL.ranger",
                                          "SL.ksvm",
                                          "SL.ipredbagg",
                                          "SL.bayesglm"))

    # Return the model
    model
##
## Call:
## SuperLearner(Y = y, X = x, family = binomial(), SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
##
## Risk Coef
## SL.ranger_All 0.1756230 0.000000
## SL.ksvm_All 0.1838340 0.000000
## SL.ipredbagg_All 0.1664828 0.524182
## SL.bayesglm_All 0.1677593 0.475818इन एल्गोरिदम को जोड़ने से आपका मॉडल बेहतर हुआ और परिदृश्य बदल गया। Ranger और KVSM का कोएफ़िशिएंट शून्य है, यानी अब उन्हें एंसेंबल का हिस्सा नहीं वेट किया गया है। Bayes GLM और बैगिंग मॉडल के शेष वज़न को बनाते हैं। आप देखेंगे कि SuperLearner आपके लिए यह रिस्क निकाल रहा है और त्रुटि कम करने वाले इष्टतम मॉडल मिश्रण का निर्णय कर रहा है।
प्रत्येक मॉडल के विशिष्ट योगदान और वैरिएशन को समझने के लिए, आप SuperLearner का आंतरिक क्रॉस-वैलिडेशन फ़ंक्शन CV.SuperLearner() उपयोग कर सकते हैं। फोल्ड्स की संख्या सेट करने के लिए आप V आर्ग्युमेंट का उपयोग कर सकते हैं। इस मामले में, आप इसे 5 पर सेट करेंगे:
     # Set the seed
    set.seed(150)

    # Get V-fold cross-validated risk estimate
    cv.model <- CV.SuperLearner(y,
                                x,
                                V=5,
                                SL.library=list("SL.ranger",
                                                "SL.ksvm",
                                                "SL.ipredbagg",
                                                "SL.bayesglm"))

    # Print out the summary statistics
    summary(cv.model)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm"))
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17277 0.014801 0.16250 0.19557
## Discrete SL 0.17964 0.014761 0.16363 0.19244
## SL.ranger_All 0.17866 0.015004 0.14811 0.20518
## SL.ksvm_All 0.19382 0.020301 0.15685 0.26215
## SL.ipredbagg_All 0.17791 0.015858 0.15831 0.19244
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022क्रॉस-वैलिडेशन का सारांश मॉडल के औसत रिस्क, मॉडल के वैरिएशन और रिस्क की रेंज दिखाता है।
इसे प्लॉट करने पर उपयोग किए गए मॉडलों और उनके वैरिएशन का एक अच्छा प्लॉट भी मिलता है:
plot(cv.model)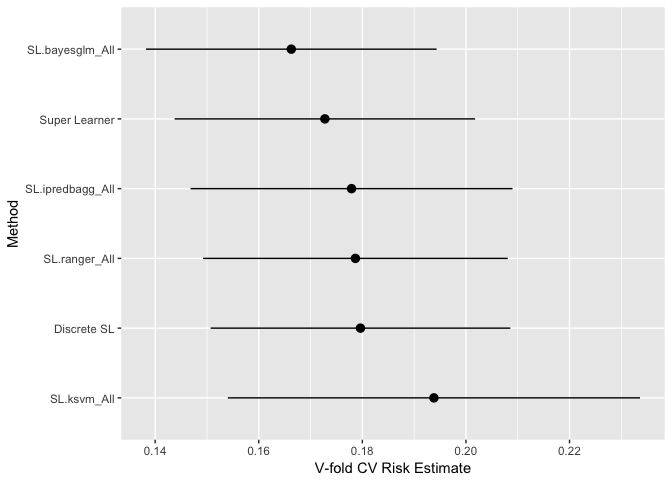
आसानी से दिखता है कि औसतन Bayes GLM सबसे अच्छा प्रदर्शन करता है जबकि KSVM सबसे ख़राब करता है और अन्य मॉडलों की तुलना में काफ़ी वैरिएशन रखता है। SuperLearner की खूबी यह है कि अगर कोई मॉडल अच्छी तरह फ़िट नहीं होता या योगदान नहीं देता, तो उसे बस शून्य वेट दे दिया जाता है! जब तक आप भविष्य में मॉडल को फिर से ट्रेन करने की योजना नहीं बनाते, तब तक उसे हटाने और दोबारा ट्रेन करने की ज़रूरत नहीं। बस याद रखें कि उचित मॉडल ट्रेनिंग में पूरे मॉडल की क्रॉस-वैलिडेशन शामिल होती है। वास्तविक दुनिया में, नए डेटा पर प्रिडिक्शन से पहले आप इसी तरह मॉडल का रिस्क तय करेंगे।
विशिष्ट कमांड predict.SuperLearner() के साथ आप नए डेटा सेट्स पर आसानी से प्रिडिक्शन कर सकते हैं। इसका मतलब है कि आप सामान्य predict() फ़ंक्शन का उपयोग नहीं कर सकते!
predictions <- predict.SuperLearner(model, newdata=xtest)predict.SuperLearner() फ़ंक्शन एक मॉडल आर्ग्युमेंट (SuperLearner से फ़िट किया गया मॉडल) और नया डेटा लेता है जिस पर प्रिडिक्ट करना है। प्रिडिक्शन सबसे पहले समग्र एंसेंबल प्रिडिक्शन लौटाएगा:
head(predictions$pred) ## [,1]
## [1,] 0.79322181
## [2,] 0.11895658
## [3,] 0.04612200
## [4,] 0.05928159
## [5,] 0.68824522
## [6,] 0.54373451यह व्यक्तिगत लाइब्रेरी प्रिडिक्शन भी लौटाएगा:
head(predictions$library.predict) ## SL.ranger_All SL.ksvm_All SL.ipredbagg_All SL.bayesglm_All
## [1,] 0.796 0.8089502 0.82086658 0.76276712
## [2,] 0.129 0.1580203 0.18586049 0.04525230
## [3,] 0.016 0.1579566 0.06255427 0.02801949
## [4,] 0.102 0.1885473 0.07238268 0.04484885
## [5,] 0.638 0.7108875 0.58791672 0.79877149
## [6,] 0.550 0.6898737 0.37488066 0.72975132इससे आप देख सकते हैं कि प्रत्येक मॉडल ने प्रत्येक ऑब्ज़र्वेशन को कैसे क्लासिफाई किया। यह मॉडल को डिबग करने या एक साथ कई मॉडल फ़िट करने में उपयोगी हो सकता है ताकि यह तय कर सकें कि किसे आगे उपयोग करना है।
आपने देखा होगा कि प्रिडिक्शन प्रायिकता के रूप में लौटाए जाते हैं। इसका मतलब है कि आपको एक कटऑफ़ थ्रेशहोल्ड चाहिए होगा ताकि यह तय किया जा सके कि आपको एक या शून्य क्लासिफाई करना चाहिए। यह केवल बायनॉमियल क्लासिफिकेशन के मामले में करना होता है, रिग्रेशन में नहीं।
आमतौर पर, आप इसे ट्रेनिंग में क्रॉस-वैलिडेशन के साथ तय करते हैं, लेकिन सरलता के लिए, आप 0.50 का कटऑफ़ उपयोग करेंगे। चूँकि यह एक सरल बायनॉमियल समस्या है, आप dplyr के ifelse() फ़ंक्शन का उपयोग करके अपनी प्रायिकताओं को रिकोड करेंगे:
     # Load the package
    library(dplyr)

    # Recode probabilities
    conv.preds <- ifelse(predictions$pred>=0.5,1,0)
अब आप परिणामों की समीक्षा के लिए caret के साथ एक कन्फ्यूज़न मैट्रिक्स बना सकते हैं:
     # Load in `caret`
    library(caret)

    # Create the confusion matrix
    cm <- confusionMatrix(conv.preds, ytest)

    # Return the confusion matrix
    cm
    ## Confusion Matrix and Statistics
    ##
    ##           Reference
    ## Prediction   0   1
    ##          0 199  45
    ##          1  24  64
    ##
    ##                Accuracy : 0.7922
    ##                  95% CI : (0.7445, 0.8345)
    ##     No Information Rate : 0.6717
    ##     P-Value [Acc > NIR] : 8.166e-07
    ##
    ##                   Kappa : 0.5044
    ##  Mcnemar's Test P-Value : 0.01605
    ##
    ##             Sensitivity : 0.8924
    ##             Specificity : 0.5872
    ##          Pos Pred Value : 0.8156
    ##          Neg Pred Value : 0.7273
    ##              Prevalence : 0.6717
    ##          Detection Rate : 0.5994
    ##    Detection Prevalence : 0.7349
    ##       Balanced Accuracy : 0.7398
    ##
    ##        'Positive' Class : 0
    ##
आपको इस डेटा सेट पर लगभग 0.7921687 एक्यूरेसी मिल रही है, जो इस डेटा सेट के लिए अच्छा प्रदर्शन है। कई एल्गोरिदम ने इससे ज़्यादा स्कोर किया है, लेकिन एक त्वरित एंसेंबल के लिए यह अच्छा है। क्रॉस-वैलिडेशन के साथ सही ट्रेनिंग और कुछ अलग-अलग मॉडलों को आज़माने से यह देखना आसान है कि आप इस स्कोर को कितनी जल्दी बेहतर कर सकते हैं।
भले ही मॉडल का प्रदर्शन बुरा नहीं है, आप एंसेंबल में शामिल कुछ मॉडलों के हाइपरपैरामीटर्स ट्यून करके अपने प्रदर्शन में सुधार करने की कोशिश कर सकते हैं। Ranger को आपके मॉडल में अधिक वज़न नहीं मिला, पर शायद ऐसा इसलिए है क्योंकि आपको और पेड़ चाहिए और mtry पैरामीटर को ट्यून करना चाहिए। शायद आप बैगिंग को भी nbagg पैरामीटर को डिफ़ॉल्ट 25 से बढ़ाकर 250 करके सुधार सकते हैं।
यह करने के दो तरीके हैं: या तो आप एक फ़ंक्शन परिभाषित करें जो लर्नर को कॉल करे और पैरामीटर को बदले, या आप create.Learner() फ़ंक्शन का उपयोग करें। अगले भागों में, आप इन विकल्पों के बारे में और सीखेंगे।
पहला तरीका function() की मदद से है। यहाँ, आप एक फ़ंक्शन परिभाषित करेंगे जो लर्नर को कॉल करेगा और पैरामीटर बदलेगा। फ़ंक्शन कॉल में एलिप्सिस ... का उपयोग किसी फ़ंक्शन को अतिरिक्त आर्ग्युमेंट्स पास करने के लिए होता है। ये तीन बिंदु फ़ॉर्मूला में संशोधन पास करने की अनुमति देते हैं बिना उन्हें फ़ंक्शन में स्पष्ट रूप से परिभाषित किए। इसका मतलब है कि अगर आप 10 पैरामीटर बदल रहे हैं, तो आपको फ़ंक्शन में उन्हें मैप करने के लिए 10 ऑब्जेक्ट्स की ज़रूरत नहीं है। यह फ़ंक्शन लिखने का एक सामान्यीकृत तरीका है।
     SL.ranger.tune <- function(...){
      SL.ranger(..., num.trees=1000, mtry=2)
    }

    SL.ipredbagg.tune <- function(...){
      SL.ipredbagg(..., nbagg=250)
    }
SL.ranger.tune आपके संशोधित ranger मेथड का नाम है और SL.ipredbagg.tune आपके संशोधित ipredbagg मेथड का नाम है। अब जब आपने कुछ नए लर्नर फ़ंक्शन बना लिए हैं, तो आप इन्हें क्रॉस-वैलिडेशन फ़ॉर्मूला में पास कर सकते हैं ताकि देखें कि प्रदर्शन सुधरता है या नहीं।
ध्यान दें कि आप मूल SL.ranger और SL.ipredbagg फ़ंक्शनों को एल्गोरिदम सूची में रखेंगे ताकि देख सकें कि आपके ट्यून किए गए वर्शन पर प्रदर्शन बेहतर होता है या नहीं।
     # Set the seed
    set.seed(150)

    # Tune the model
    cv.model.tune <- CV.SuperLearner(y,
                                     x,
                                     V=5,
                                     SL.library=list("SL.ranger",
                                                     "SL.ksvm",
                                                     "SL.ipredbagg","SL.bayesglm",
                                                     "SL.ranger.tune",
                                                     "SL.ipredbagg.tune"))

    # Get summary statistics
    summary(cv.model.tune)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger.tune_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg.tune_All 0.17813 0.015869 0.16455 0.19260 # Plot the tuned model
plot(cv.model.tune)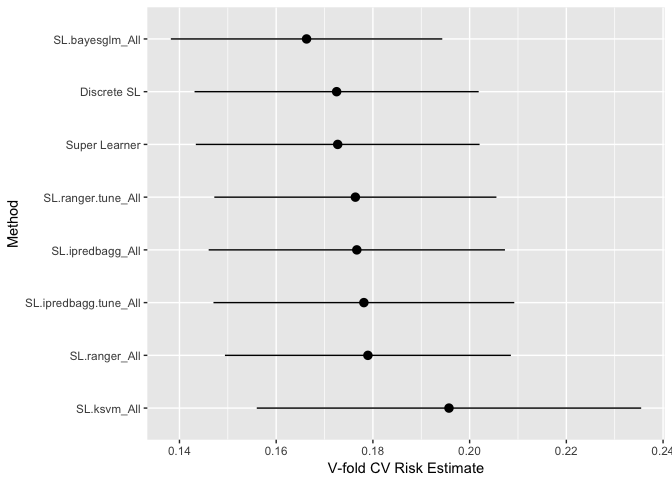
आप इस प्लॉट से देख सकते हैं कि ipredbagg में SL.ipredbagg.tune के अनुसार nbagg पैरामीटर बढ़ाने पर सुधार दिखता है। Ranger पैरामीटर्स ट्यून करने पर थोड़ा ख़राब होता दिखता है, लेकिन इसे रहने दें और देखें कि SuperLearner इसे प्रासंगिक मानता है या नहीं।
फिर से, खूबी यह है कि SuperLearner अगर इसे प्रासंगिक नहीं पाता तो बस शून्य वेट दे देगा। याद रखें, सबसे अच्छे एंसेंबल्स सबसे अच्छे प्रदर्शन करने वाले एल्गोरिदम से नहीं बनते, बल्कि उन एल्गोरिदम से बनते हैं जो एक-दूसरे को सबसे अच्छी तरह पूरक करते हुए प्रिडिक्शन को वर्गीकृत करते हैं।
आइए ट्यून किए गए पैरामीटर्स के साथ नया मॉडल फ़िट करें और देखें कि उनके वेट्स कैसे आते हैं:
     # Set the seed
    set.seed(150)

    # Create the tuned model
    model.tune <- SuperLearner(y,
                              x,
                              SL.library=list("SL.ranger",
                                              "SL.ksvm",
                                              "SL.ipredbagg",
                                              "SL.bayesglm",
                                              "SL.ranger.tune",
                                              "SL.ipredbagg.tune"))

    # Return the tuned model
    model.tune
##
## Call:
## SuperLearner(Y = y, X = x, SL.library = list("SL.ranger", "SL.ksvm",
## "SL.ipredbagg", "SL.bayesglm", "SL.ranger.tune", "SL.ipredbagg.tune"))
##
##
##
## Risk Coef
## SL.ranger_All 0.1748247 0.0000000
## SL.ksvm_All 0.1974033 0.0000000
## SL.ipredbagg_All 0.1745503 0.0000000
## SL.bayesglm_All 0.1634855 0.7162423
## SL.ranger.tune_All 0.1725514 0.0000000
## SL.ipredbagg.tune_All 0.1711161 0.2837577अब एंसेंबल में केवल SL.bayesglm और SL.ipredbagg.tune को वेट मिला है। टेस्ट सेट पर प्रिडिक्ट करने पर निम्न परिणाम मिलता है:
     # Gather predictions for the tuned model
    predictions.tune <- predict.SuperLearner(model.tune, newdata=xtest)

    # Recode predictions
    conv.preds.tune <- ifelse(predictions.tune$pred>=0.5,1,0)

    # Return the confusion matrix
    confusionMatrix(conv.preds.tune,ytest)
## Confusion Matrix and Statistics
##
## Reference
## Prediction 0 1
## 0 200 43
## 1 23 66
##
## Accuracy : 0.8012
## 95% CI : (0.7542, 0.8428)
## No Information Rate : 0.6717
## P-Value [Acc > NIR] : 1.116e-07
##
## Kappa : 0.5271
## Mcnemar's Test P-Value : 0.01935
##
## Sensitivity : 0.8969
## Specificity : 0.6055
## Pos Pred Value : 0.8230
## Neg Pred Value : 0.7416
## Prevalence : 0.6717
## Detection Rate : 0.6024
## Detection Prevalence : 0.7319
## Balanced Accuracy : 0.7512
##
## 'Positive' Class : 0
##यह आपको टेस्ट सेट पर थोड़ा सुधार देता है और SuperLearner के साथ मॉडल ट्यूनिंग के सिद्धांतों को दर्शाता है।
create.Learner()हाइपरपैरामीटर्स ट्यून करने का दूसरा तरीका create.Learner() फ़ंक्शन का उपयोग करना है। यह आपको मौजूदा SuperLearner को कस्टमाइज़ करने देता है:
     learner <- create.Learner("SL.ranger", params=list(num.trees=1000, mtry=2))
    learner2 <- create.Learner("SL.ipredbagg", params=list(nbagg=250))
create.Learner() फ़ंक्शन का पहला आर्ग्युमेंट लर्नर का कैरेक्टर स्ट्रिंग होता है। फिर आप बदलने के लिए पैरामीटर्स की सूची पास करते हैं। यह एक ऑब्जेक्ट बनाएगा:
learner ## $grid
## NULL
##
## $names
## [1] "SL.ranger_1"
##
## $base_learner
## [1] "SL.ranger"
##
## $params
## $params$num.trees
## [1] 1000
##
## $params$mtry
## [1] 2अब, लर्नर को SuperLearner में पास करते समय, आप लर्नर ऑब्जेक्ट में मौजूद names ऑब्जेक्ट का उपयोग करते हैं:
     # Set the seed
    set.seed(150)

    # Create a second tuned model
    cv.model.tune2 <- CV.SuperLearner(y,
                                      x,
                                      V=5,
                                      SL.library=list("SL.ranger",
                                                      "SL.ksvm",
                                                      "SL.ipredbagg",
                                                      "SL.bayesglm",
                                                      learner$names,
                                                      learner2$names))

    # Get summary statistics
    summary(cv.model.tune2)
##
## Call:
## CV.SuperLearner(Y = y, X = x, V = 5, SL.library = list("SL.ranger",
## "SL.ksvm", "SL.ipredbagg", "SL.bayesglm", learner$names, learner2$names))
##
##
## Risk is based on: Mean Squared Error
##
## All risk estimates are based on V = 5
##
## Algorithm Ave se Min Max
## Super Learner 0.17272 0.014969 0.15849 0.19844
## Discrete SL 0.17250 0.014989 0.15645 0.18430
## SL.ranger_All 0.17897 0.015084 0.15388 0.19920
## SL.ksvm_All 0.19573 0.020278 0.16095 0.26304
## SL.ipredbagg_All 0.17667 0.015629 0.16473 0.18898
## SL.bayesglm_All 0.16628 0.014318 0.15322 0.18022
## SL.ranger_1_All 0.17637 0.014882 0.15218 0.19793
## SL.ipredbagg_1_All 0.17813 0.015869 0.16455 0.19260 # Plot `cv.model.tune2`
plot(cv.model.tune2)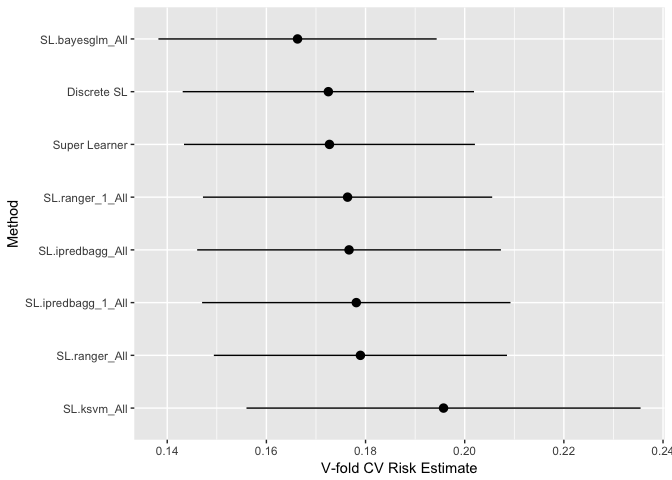
अंततः परिणाम पहले तरीके जैसा ही है। आप जिस भी तरीके का उपयोग करना चाहें, आपकी मर्ज़ी।
वाह, आपने बहुत कुछ कवर कर लिया! अब तक, आपके पास SuperLearner की अच्छी समझ होनी चाहिए और आपने SuperLearner के साथ अपना पहला एंसेंबल सफलतापूर्वक फ़िट कर लिया होगा। यह पैकेज मॉडलों को बहुत जल्दी जोड़ना आसान बना देता है। विधियों और किस डेटा फ़ॉर्म का उपयोग करना है, इसमें कुछ बारीकियाँ हैं। फिर भी, संदेह होने पर, डेटा फ़्रेम के रूप में सेव किया गया मॉडल मैट्रिक्स लगभग हमेशा काम करता है।
याद दिलाने के लिए, आपने SuperLearner इंस्टॉल और लोड किया, अपने डेटा सेट को फ़ॉर्मैट किया, एक सिंगल मॉडल फ़िट किया, अपना पहला एंसेंबल फ़िट किया, एंसेंबल से प्रिडिक्ट किया और कुछ हाइपरपैरामीटर्स ट्यून किए!
अगले कदमों में इस पैकेज के साथ कुछ और उन्नत विषयों को लेना होगा, जैसे पैरेललाइज़ेशन, फीचर चयन और स्क्रीनिंग, मॉडल मैट्रिक्स का उपयोग, अपना खुद का SuperLearner लिखना और एंसेंबल क्रॉस-वैलिडेशन।
DataCamp के शुरुआती लोगों के लिए R में मशीन लर्निंग ट्यूटोरियल पर नज़र डालें।
R और मशीन लर्निंग के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}