
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek-R1-0528 adalah iterasi terbaru dari model DeepSeek R1, dengan kemampuan penalaran dan inferensi yang ditingkatkan. Model ini sekelas dengan model terkemuka seperti o3 dan Gemini 2.5 Pro, menjadikannya model penalaran open-source terbaik di dunia.
Dalam tutorial ini, kita akan melakukan fine-tuning model DeepSeek-R1-0528-Qwen3-8B pada dataset Soal Pilihan Ganda Penalaran Medis (MCQ). Proses fine-tuning memperkenalkan gaya penalaran baru dan pembangkitan jawaban dalam bentuk opsi A, B, C, D.
Bagian terbaiknya? Ini dapat dilakukan pada GPU konsumen seperti RTX 4090, sehingga Anda dapat melakukan fine-tuning model secara lokal tanpa kendala. Anda dapat melihat panduan lengkap kami tentang DeepSeek-R1 dan panduan fine-tuning kami untuk mempelajari lebih lanjut.
 Gambar oleh Penulis
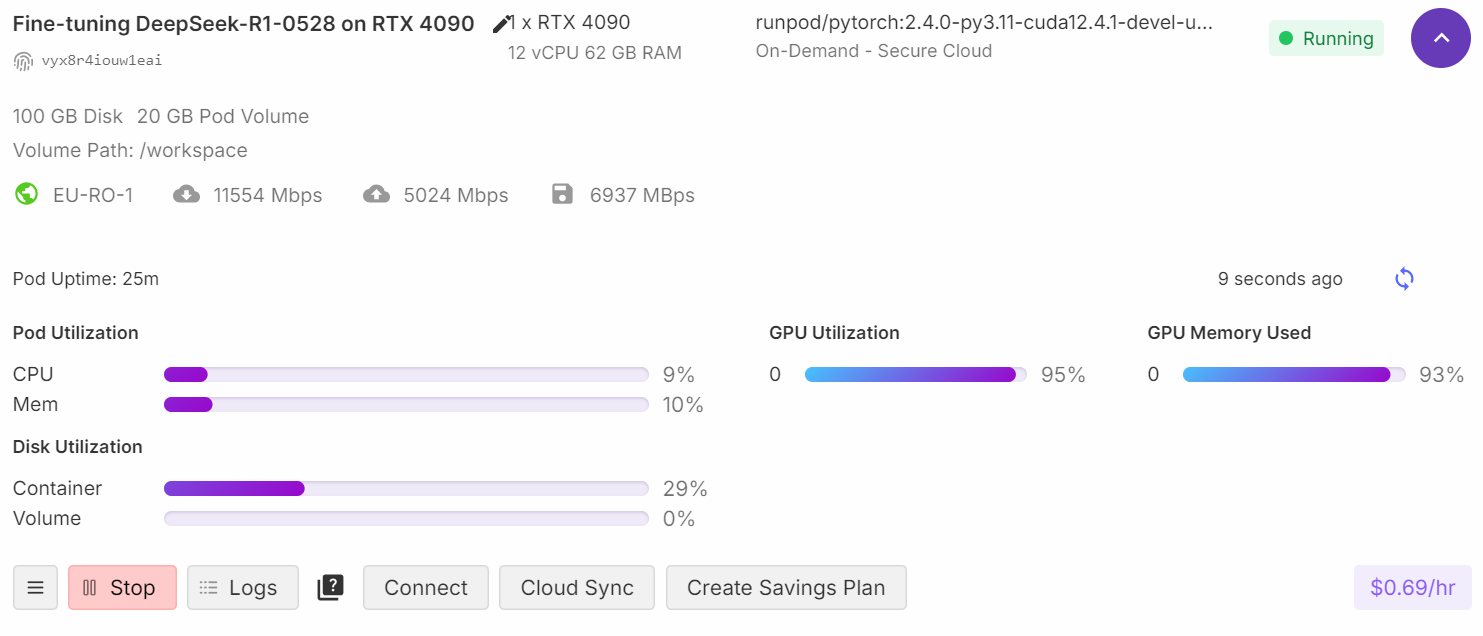
Kita akan menyiapkan instance RunPod dengan GPU RTX 4090 dan image PyTorch 2.4.0.
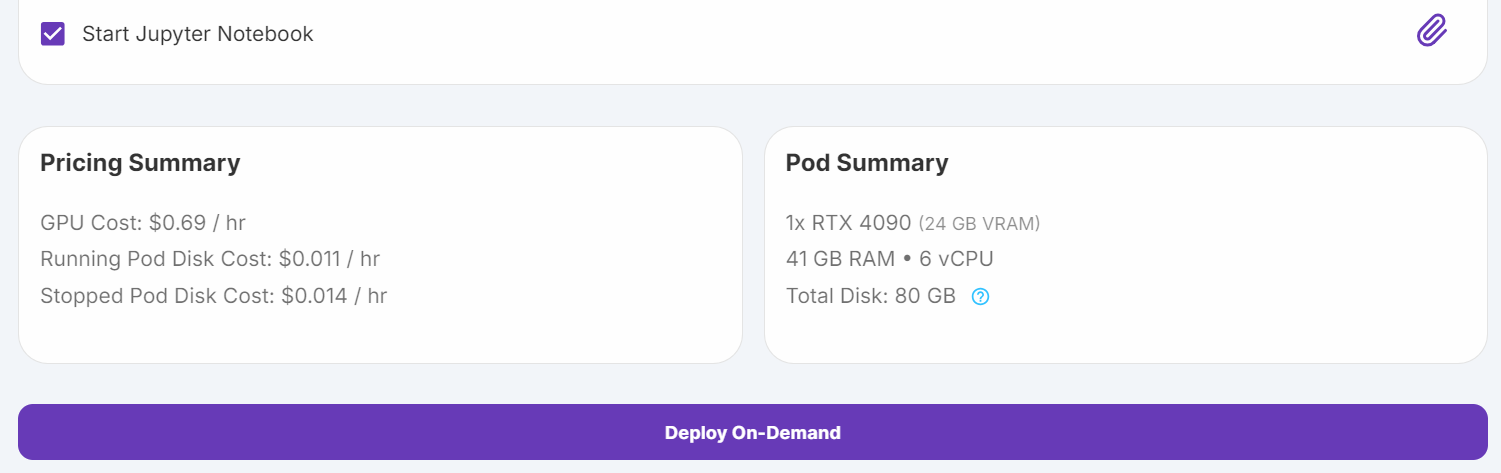
Sumber: My Pods
Buka bagian "My Pods" di konsol RunPod. Edit konfigurasi pod:
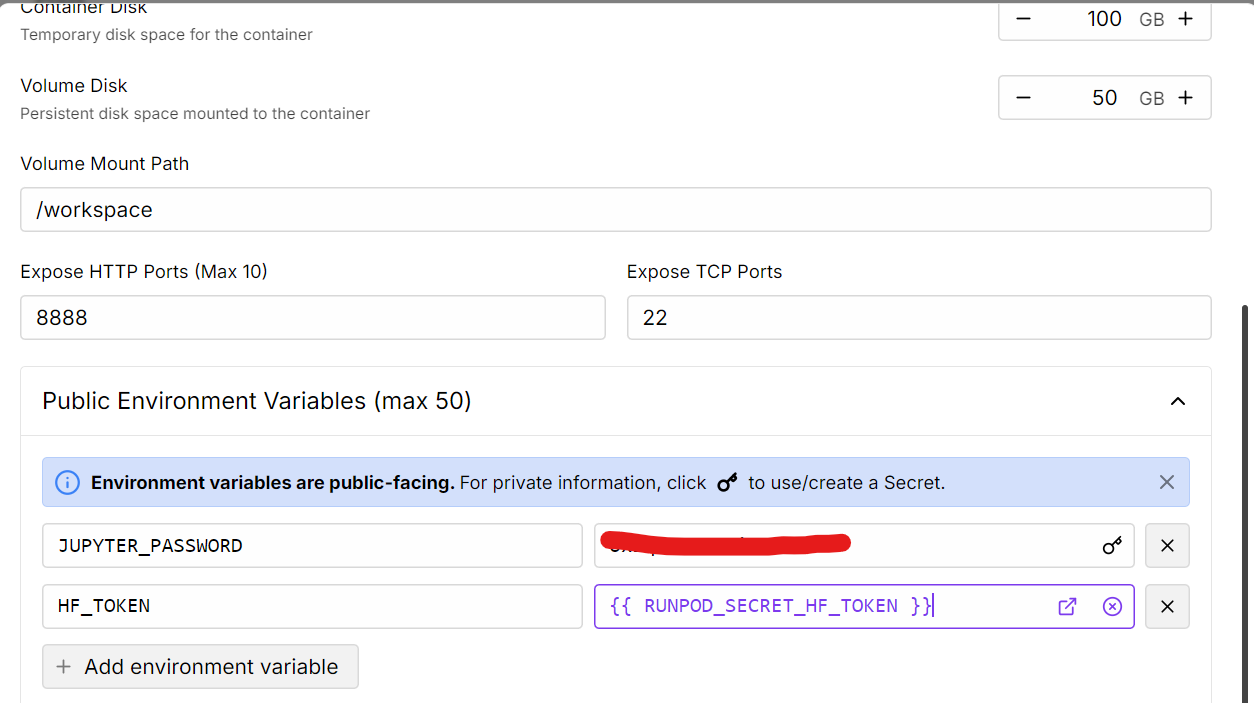
Sumber: My Pods
Setelah pod berjalan, instal paket Python yang diperlukan.
Catatan bahwa versi terbaru library Transformers memiliki beberapa masalah yang diketahui, jadi kita akan memasang versi yang lebih lama dan stabil.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Untuk memuat model atau mendorong pembaruan ke Hugging Face Hub, masuk ke CLI Hugging Face menggunakan kunci API Anda
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Meskipun kita memiliki 24GB VRAM, yang cukup untuk memuat model penuh, kita akan menggunakan kuantisasi 4-bit untuk menyisakan lebih banyak memori bagi fine-tuning dan memastikan stabilitas. Pendekatan ini memungkinkan kita mengoptimalkan penggunaan VRAM sambil mempertahankan kinerja.
Kita akan mengunduh dan memuat model serta tokenizer DeepSeek-R1-0528-Qwen3-8B dari Hugging Face Hub. Anda dapat mempelajari lebih lanjut tentang bekerja dengan Hugging Face dan panduan Hub melalui kursus kami.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
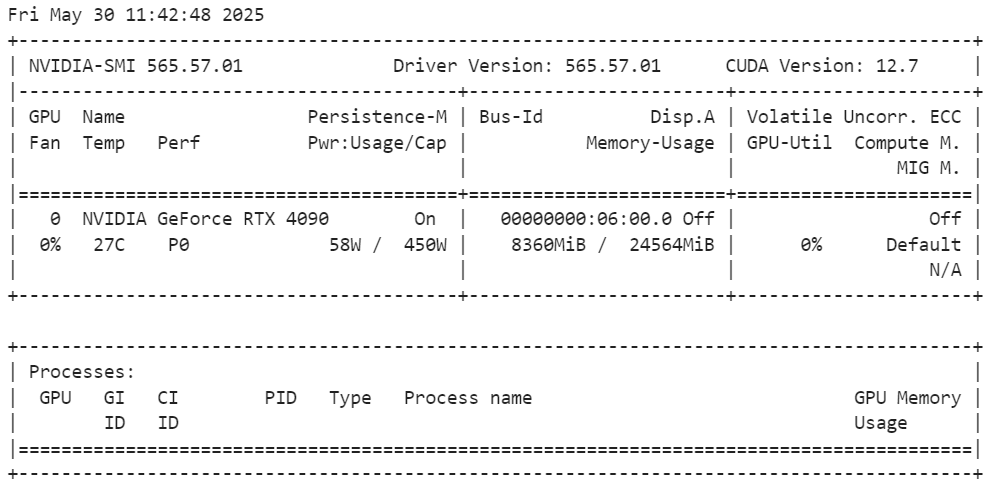
Untuk memeriksa penggunaan VRAM setelah memuat model, jalankan perintah berikut:
!nvidia-smiPenggunaan VRAM sekitar 8,3GB, menyisakan dua pertiga memori untuk fine-tuning.
Pada langkah ini, kita akan menyiapkan prompt pelatihan dengan membuat templat yang memiliki placeholder untuk pertanyaan dan respons. Kita juga akan mendefinisikan fungsi Python untuk memformat dataset sesuai gaya prompt dan membuat kolom “text” baru.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Selanjutnya, kita akan memuat mamachang/medical-reasoning, menerapkan fungsi formatting_prompts_func, dan menampilkan kolom “text” dari sampel ke-11.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
Kolom teks memuat prompt sistem, pertanyaan, penalaran, dan jawaban dalam format berikut:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Sebelum melakukan fine-tuning model, kita akan menguji kinerja dasarnya untuk menetapkan tolok ukur perbandingan. Ini mencakup membuat prompt inferensi, memilih pertanyaan sampel dari dataset, dan menghasilkan respons menggunakan model dasar.
Kita akan membuat templat prompt untuk inferensi yang mencakup placeholder untuk pertanyaan.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Lalu, kita akan memilih pertanyaan dari sampel ke-11 dan memberikannya ke model setelah diformat dan diubah menjadi token.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
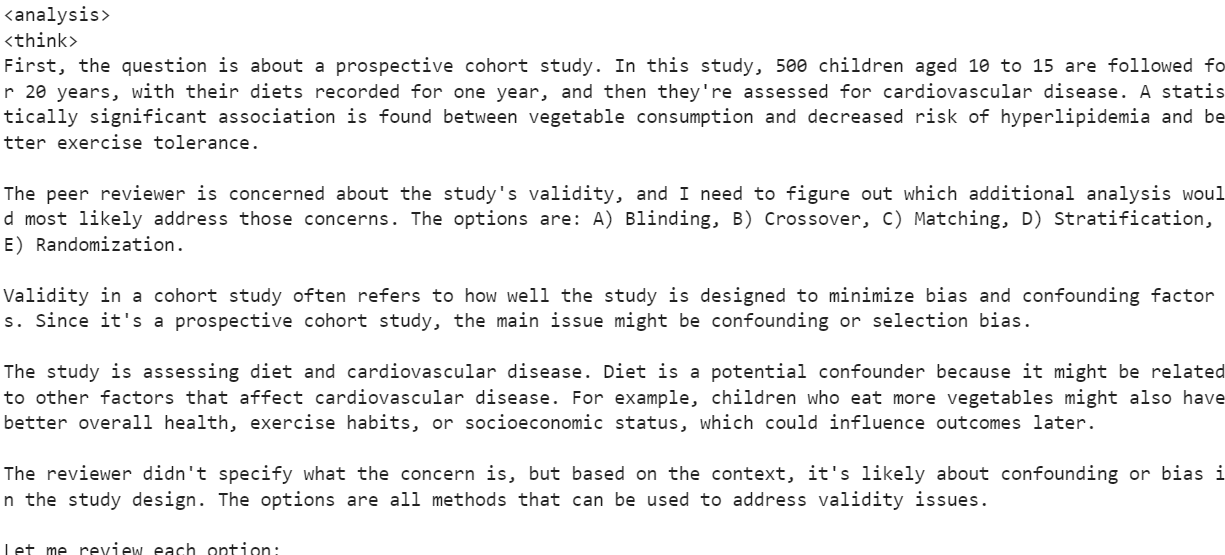
Respons model kurang memuaskan. Bagian analisis terlalu panjang, menghabiskan batas token, dan bagian jawaban tidak pernah dihasilkan karena penalaran yang berlarut-larut.
Pada langkah ini, kita akan menyiapkan model dan tokenizer untuk fine-tuning.
1. SFTTrainer tidak menerima tokenizer secara langsung. Sebagai gantinya, kita akan mengonversi tokenizer menjadi data collator menggunakan kelas DataCollatorForLanguageModeling dari library transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Kita akan menggunakan LoRA (Low-Rank Adaptation) untuk melakukan fine-tuning model. LoRA hanya memodifikasi sebagian kecil parameter model, sehingga sangat efisien dalam penggunaan memori dan lebih cepat dibandingkan fine-tuning penuh.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Kelas TrainingArguments memungkinkan kita mengonfigurasi proses fine-tuning dan SFTTrainer menyederhanakan proses fine-tuning dengan mengintegrasikan model, dataset, data collator, argumen pelatihan, dan konfigurasi LoRA ke dalam satu alur kerja.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Sebelum memulai proses pelatihan, penting untuk membersihkan cache dan menghapus jejak memori dan VRAM yang tidak diinginkan untuk menghindari kesalahan Out of Memory (OOM).
Setelah memori dibersihkan, kita dapat memulai proses pelatihan menggunakan SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
Selama pelatihan, Anda dapat memantau GPU melalui dasbor RunPod. Anda seharusnya melihat utilisasi GPU mendekati 100%, yang menunjukkan bahwa model dilatih pada GPU (bukan CPU).
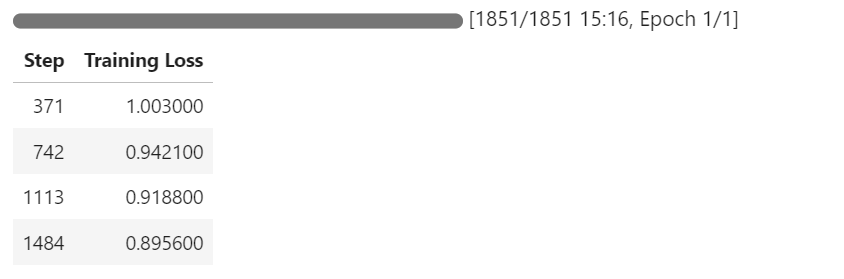
Seiring pelatihan berlangsung, Anda akan melihat bahwa training loss menurun secara bertahap. Ini menandakan model belajar dan fine-tuning berjalan dengan baik.
Setelah fine-tuning, kita akan menguji kinerjanya dengan memberikan pertanyaan sampel ke-11 yang sama dari dataset. Ini memungkinkan kita membandingkan hasil dengan model dasar dan mengevaluasi peningkatan yang dicapai melalui fine-tuning.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Respons model yang telah di-fine-tune menunjukkan peningkatan signifikan:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Untuk mengevaluasi lebih lanjut model yang telah di-fine-tune, kita akan mengujinya pada sampel lain dari dataset dan mengamati hasilnya.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Model yang telah di-fine-tune berkinerja sempurna pada sampel ini:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>Langkah berikutnya adalah menyimpan model yang telah di-fine-tune dan mendorongnya ke Hugging Face Hub. Ini memungkinkan orang lain mengakses dan menggunakan model untuk inferensi atau fine-tuning lebih lanjut.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Setelah model berhasil didorong, model akan tersedia di Hugging Face Hub: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Setelah menyimpan model dan adapter yang telah di-fine-tune ke Hugging Face Hub, kini kita akan menguji apakah model bekerja seperti yang diharapkan dengan memuatnya kembali. Ini mencakup membersihkan memori GPU, memuat model dasar dan adapter LoRA, serta menjalankan inferensi pada sebuah prompt sampel.
1. Bersihkan memori GPU untuk menghindari potensi masalah Out of Memory (OOM). Ini memastikan lingkungan bersih untuk memuat model.
del model
del trainer
torch.cuda.empty_cache()
2. muat model dasar dan adapter LoRA yang telah di-fine-tune dari Hugging Face Hub. Model dasar akan dimuat dalam kuantisasi 4-bit untuk mengoptimalkan penggunaan memori, dan adapter LoRA akan digabungkan dengannya.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Sekarang kita akan menguji model yang telah di-fine-tune dengan memberikan sebuah prompt sampel. Prompt akan ditokenisasi, diproses oleh model, dan responsnya akan didekode.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Model yang telah di-fine-tune menghasilkan respons yang mirip dengan dataset, yang menegaskan bahwa model dan adapter dimuat dengan benar.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Jika Anda menemui kendala saat menjalankan kode di atas, lihat notebook fine-tuning-Deepseek-new-R1.ipynb. Notebook ini telah diuji berkali-kali dan seharusnya langsung bekerja saat dimuat ke RunPod atau lingkungan serupa.
Model DeepSeek-R1-0528 adalah salah satu model penalaran open-source terbaik saat ini. Kemampuannya dalam melakukan tugas penalaran yang kompleks, dipadukan dengan sifatnya yang open-source, menjadikannya pilihan unggulan bagi pengembang dan peneliti. Meskipun model yang telah di-fine-tune sudah memberikan hasil yang mengesankan, ada beberapa cara untuk lebih meningkatkan hasil fine-tuning:
Selain itu, panduan ini dapat digunakan untuk melakukan fine-tuning model DeepSeek R1 pada dataset penalaran apa pun, termasuk dataset sintetis yang dibuat menggunakan model lain seperti o3 dari OpenAI. Anda juga dapat mempraktikkan beberapa teknik yang ditunjukkan di sini dalam kursus Fine-Tuning With Llama 3 kami. Jika Anda tertarik melakukan fine-tuning model lain dengan dataset medis, lihat tutorial kami, Fine-Tuning MedGemma pada Dataset MRI Otak.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt





