Curso
Ajuste Fino com Llama 3
2 h
4K
O DeepSeek-R1-0528 é a iteração mais recente do modelo DeepSeek R1, com capacidades aprimoradas de raciocínio e inferência. Ele está no mesmo nível de modelos líderes como o o3 e o Gemini 2.5 Pro, o que o torna o melhor modelo open source de raciocínio do mundo.
Neste tutorial, vamos fazer fine-tuning do modelo DeepSeek-R1-0528-Qwen3-8B em um dataset de questões de múltipla escolha com raciocínio médico (MCQ). O fine-tuning introduz um novo estilo de raciocínio e geração de respostas no formato de opções A, B, C, D.
A melhor parte? Dá para fazer isso em uma GPU de consumo como a RTX 4090, permitindo que você faça o fine-tuning localmente sem complicações. Confira nosso guia completo sobre DeepSeek-R1 e nosso guia de fine-tuning para saber mais.
 Imagem do autor
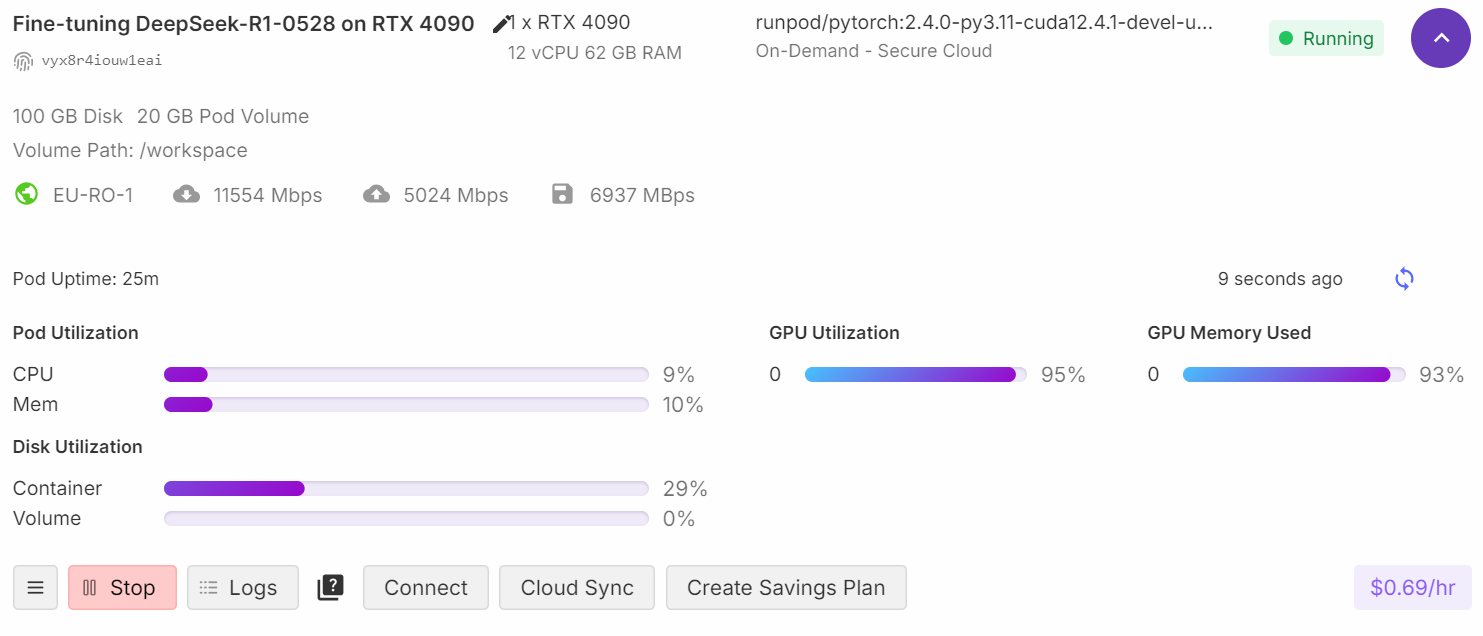
Vamos configurar uma instância no RunPod com uma GPU RTX 4090 e a imagem do PyTorch 2.4.0.
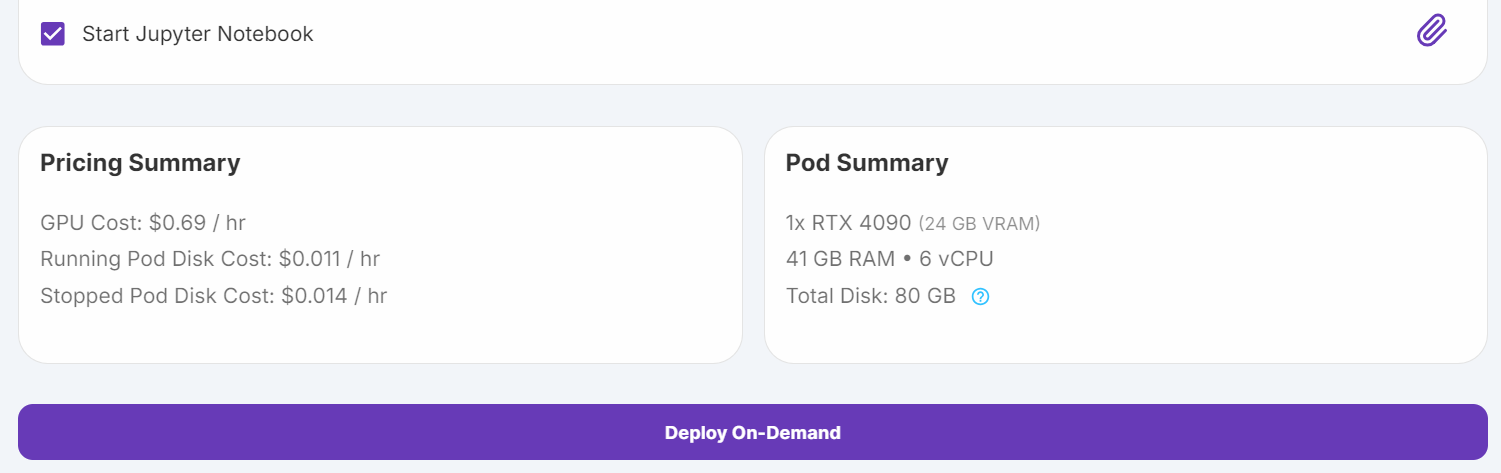
Fonte: My Pods
Acesse a seção "My Pods" no console do RunPod. Edite a configuração do pod:
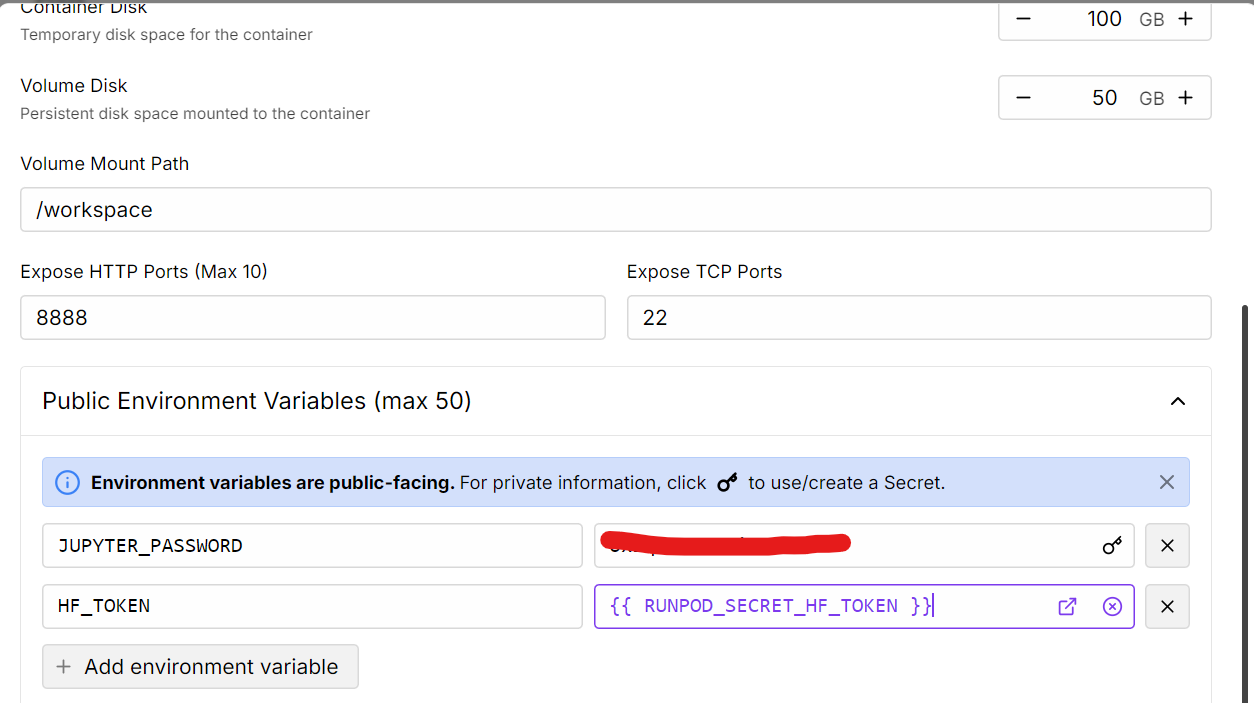
Fonte: My Pods
Com o pod em execução, instale os pacotes Python necessários.
Observação: a versão mais recente da biblioteca Transformers tem alguns problemas conhecidos, então vamos instalar uma versão estável anterior.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Para carregar modelos ou enviar atualizações ao Hugging Face Hub, faça login no CLI do Hugging Face usando sua chave de API
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Embora tenhamos 24 GB de VRAM, o que é suficiente para carregar o modelo completo, vamos usar quantização em 4 bits para deixar mais memória livre para o fine-tuning e garantir estabilidade. Essa abordagem otimiza o uso da VRAM mantendo o desempenho.
Vamos baixar e carregar o modelo e o tokenizer DeepSeek-R1-0528-Qwen3-8B do Hugging Face Hub. Você pode aprender mais sobre como trabalhar com o Hugging Face e o Hub no nosso curso.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
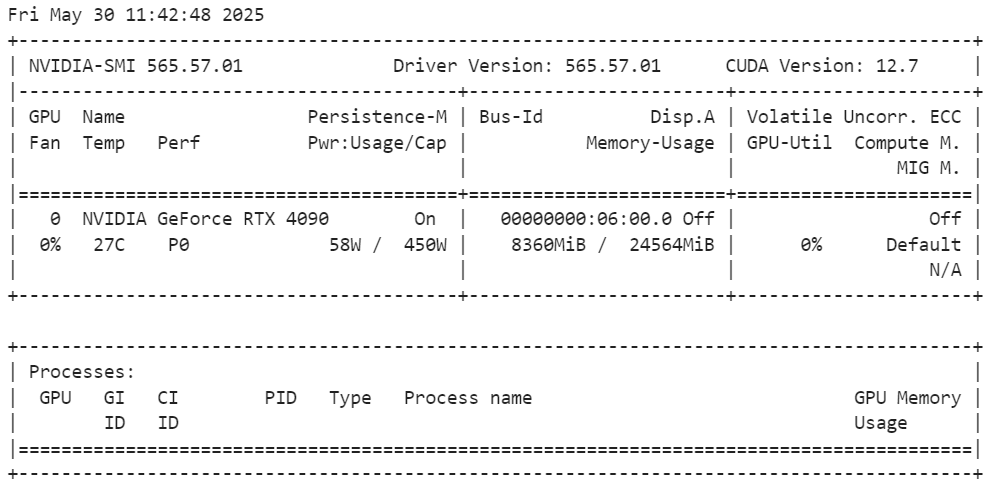
Para verificar o uso de VRAM após carregar o modelo, execute o comando:
!nvidia-smiO uso de VRAM fica em torno de 8,3 GB, deixando dois terços da memória disponíveis para o fine-tuning.
Nesta etapa, vamos preparar os prompts de treino criando um template com placeholders para a pergunta e a resposta. Também vamos definir uma função em Python para formatar o dataset conforme o estilo do prompt e criar uma nova coluna “text”.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Em seguida, vamos carregar o mamachang/medical-reasoning, aplicar a função formatting_prompts_func e exibir a coluna “text” da 11ª amostra.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
A coluna de texto contém o prompt de sistema, a pergunta, o raciocínio e a resposta no seguinte formato:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Antes do fine-tuning, vamos testar o desempenho base do modelo para estabelecer um baseline de comparação. Isso envolve criar um prompt de inferência, escolher uma pergunta de amostra do dataset e gerar uma resposta usando o modelo base.
Vamos criar um template de prompt para inferência com um placeholder para a pergunta.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Depois, vamos selecionar a pergunta da 11ª amostra, formatá-la, tokenizá-la e fornecê-la ao modelo.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
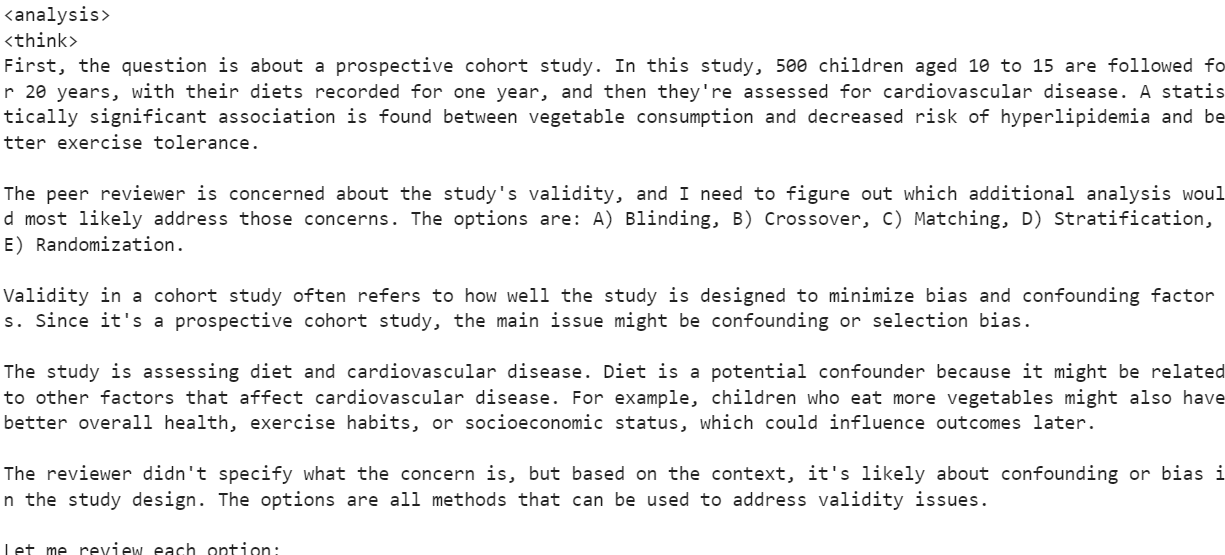
A resposta do modelo não foi satisfatória. A seção de análise ficou longa demais, consumindo o limite de tokens, e a seção de resposta não foi gerada por conta do raciocínio excessivo.
Nesta etapa, vamos preparar o modelo e o tokenizer para o fine-tuning.
1. O SFTTrainer não aceita um tokenizer diretamente. Em vez disso, vamos convertê-lo em um data collator usando a classe DataCollatorForLanguageModeling da biblioteca transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Vamos usar LoRA (Low-Rank Adaptation) para fazer o fine-tuning. O LoRA modifica apenas um pequeno subconjunto dos parâmetros do modelo, tornando o processo muito mais eficiente em memória e rápido em comparação ao fine-tuning completo.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
O TrainingArguments permite configurar o processo de fine-tuning, e o SFTTrainer simplifica tudo ao integrar modelo, dataset, data collator, argumentos de treino e configuração LoRA em um único fluxo.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Antes de iniciar o treinamento, é importante limpar o cache e remover resíduos de memória e VRAM para evitar erros de falta de memória (OOM).
Com a memória limpa, podemos iniciar o processo de treinamento usando o SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
Durante o treinamento, você pode monitorar a GPU no dashboard do RunPod. A utilização deve ficar próxima de 100%, indicando que o treino está rodando na GPU (não na CPU).
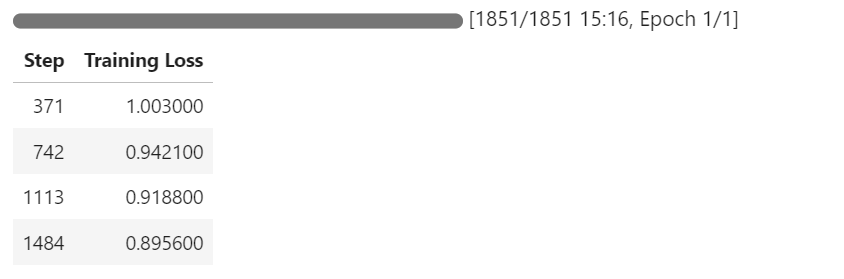
Conforme o treino avança, a loss de treinamento deve diminuir gradualmente, indicando que o modelo está aprendendo e o fine-tuning está funcionando.
Depois do fine-tuning, vamos testar o desempenho fornecendo a mesma 11ª pergunta do dataset. Assim, comparamos os resultados com o modelo base e avaliamos as melhorias obtidas.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
A resposta do modelo ajustado mostra melhorias claras:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Para avaliar mais a fundo o modelo ajustado, vamos testá-lo em outra amostra do dataset e observar os resultados.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
O modelo ajustado vai muito bem nesta amostra:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>O próximo passo é salvar o modelo ajustado e publicá-lo no Hugging Face Hub. Assim, outras pessoas podem acessá-lo e usá-lo para inferência ou para novos ajustes.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Quando o envio for concluído, o modelo ficará disponível no Hugging Face Hub: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Depois de salvar o modelo e o adapter no Hugging Face Hub, vamos testá-lo carregando-o de volta. Isso envolve limpar a memória da GPU, carregar o modelo base e o adapter LoRA e rodar a inferência em um prompt de exemplo.
1. Limpe a memória da GPU para evitar possíveis erros de falta de memória (OOM). Isso garante um ambiente limpo para carregar o modelo.
del model
del trainer
torch.cuda.empty_cache()
2. carregue o modelo base e o adapter LoRA ajustado a partir do Hugging Face Hub. O modelo base será carregado com quantização em 4 bits para otimizar memória, e o adapter LoRA será acoplado a ele.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Agora vamos testar o modelo ajustado com um prompt de exemplo. O prompt será tokenizado, passado pelo modelo e a resposta será decodificada.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
O modelo ajustado produz uma resposta alinhada ao dataset, confirmando que o modelo e o adapter foram carregados corretamente.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Se você encontrar problemas ao executar o código acima, consulte o notebook fine-tuning-Deepseek-new-R1.ipynb. Ele foi testado várias vezes e deve funcionar imediatamente no RunPod ou ambiente similar.
O DeepSeek-R1-0528 é um dos melhores modelos open source de raciocínio disponíveis hoje. Sua capacidade de executar tarefas complexas de raciocínio, aliada ao caráter open source, o torna uma excelente opção para desenvolvedores e pesquisadores. Embora o modelo ajustado já traga resultados expressivos, há várias formas de melhorar ainda mais o fine-tuning:
Além disso, este guia pode ser usado para ajustar o DeepSeek R1 em qualquer dataset de raciocínio, incluindo datasets sintéticos criados com outros modelos, como o o3 da OpenAI. Você também pode colocar em prática algumas das técnicas mostradas aqui no nosso curso Fine-Tuning With Llama 3. Se quiser ajustar outros modelos com datasets médicos, confira nosso tutorial Fine-Tuning MedGemma on a Brain MRI Dataset.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min
Tutorial
Aashi Dutt
14 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
13 min