
Cours
Ajustement fin avec Llama 3
2 h
4K
DeepSeek-R1-0528 est la dernière itération du modèle DeepSeek R1, avec des capacités de raisonnement et d'inférence renforcées. Il rivalise avec des modèles de pointe comme o3 et Gemini 2.5 Pro, ce qui en fait le meilleur modèle de raisonnement open source au monde.
Dans ce tutoriel, nous allons ajuster finement le modèle DeepSeek-R1-0528-Qwen3-8B sur un jeu de données de questions de raisonnement médical à choix multiples (QCM). L'ajustement fin introduit un nouveau style de raisonnement et de génération de réponses sous forme d'options A, B, C, D.
Le meilleur dans tout ça ? Cela peut se faire sur un GPU grand public comme la RTX 4090, ce qui vous permet d'ajuster le modèle en local sans difficulté. Vous pouvez consulter notre guide complet sur DeepSeek-R1 et notre guide d'ajustement fin pour en savoir plus.
 Image par l'auteur
Nous allons configurer une instance RunPod avec un GPU RTX 4090 et l'image PyTorch 2.4.0.
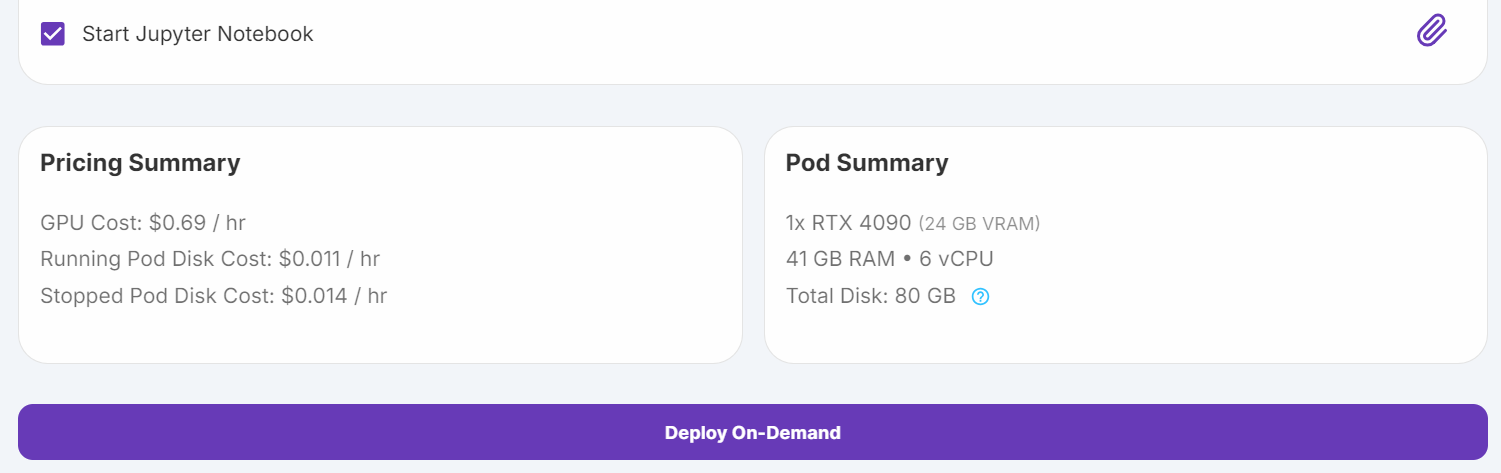
Source : My Pods
Accédez à la section "My Pods" dans la console RunPod. Modifiez la configuration du pod :
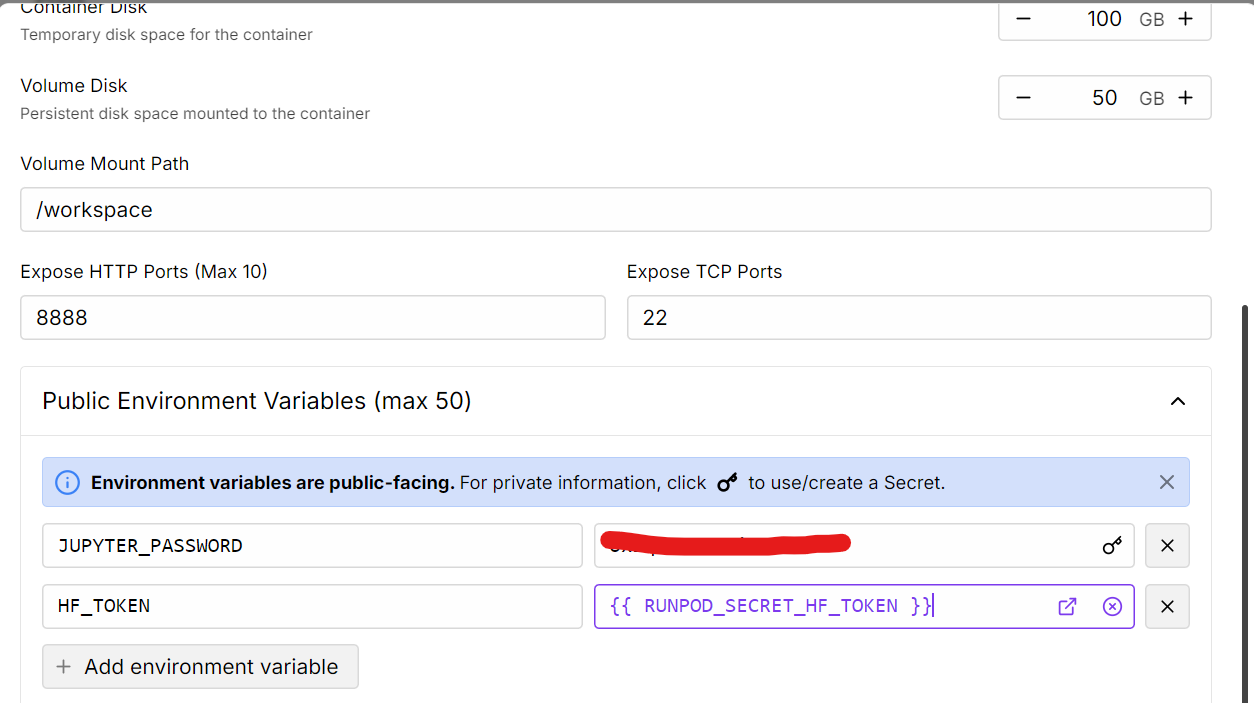
Source : My Pods
Une fois le pod lancé, installez les packages Python nécessaires.
Remarque : la dernière version de la bibliothèque Transformers présente quelques problèmes connus, nous installerons donc une version antérieure et stable à la place.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Pour charger des modèles ou pousser des mises à jour vers le Hub Hugging Face, connectez-vous au CLI Hugging Face avec votre clé API
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Même si nous disposons de 24 Go de VRAM, suffisants pour charger le modèle complet, nous utiliserons une quantification en 4 bits afin de libérer plus de mémoire pour l'ajustement fin et d'assurer la stabilité. Cette approche optimise l'usage de la VRAM tout en conservant les performances.
Nous allons télécharger et charger le modèle et le tokenizer DeepSeek-R1-0528-Qwen3-8B depuis le Hugging Face Hub. Pour en savoir plus sur l'utilisation de Hugging Face et un guide du Hub, consultez notre cours.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
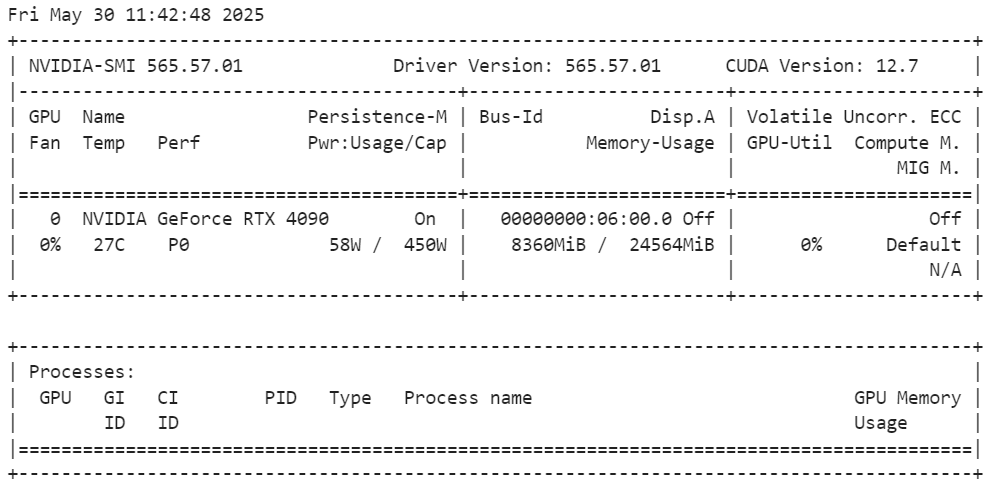
Pour vérifier l'utilisation de la VRAM après le chargement du modèle, exécutez la commande suivante :
!nvidia-smiL'utilisation de la VRAM est d'environ 8,3 Go, laissant les deux tiers de la mémoire disponibles pour l'ajustement fin.
À cette étape, nous allons préparer les invites d'entraînement en créant un modèle avec des espaces réservés pour la question et la réponse. Nous définirons également une fonction Python pour mettre en forme le jeu de données selon le style de l'invite et créer une nouvelle colonne « text ».
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Ensuite, nous chargerons mamachang/medical-reasoning, appliquerons la fonction formatting_prompts_func et afficherons la colonne « text » du 11e échantillon.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
La colonne text contient l'invite système, la question, le raisonnement et la réponse dans le format suivant :
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Avant d'ajuster le modèle, nous allons évaluer ses performances de base pour établir un point de comparaison. Cela implique de créer une invite d'inférence, de sélectionner une question exemple du jeu de données et de générer une réponse avec le modèle de base.
Nous allons créer un gabarit d'invite pour l'inférence incluant un espace réservé pour la question.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Nous sélectionnerons ensuite la question du 11e échantillon, puis nous la fournirons au modèle après mise en forme et conversion en jetons.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
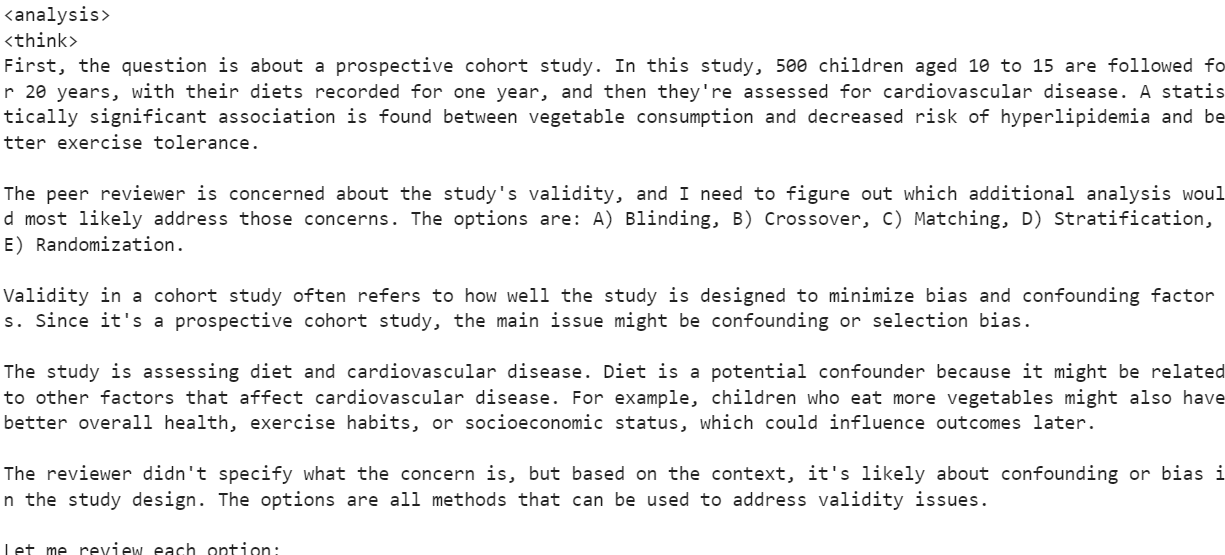
La réponse du modèle n'était pas satisfaisante. La section d'analyse était beaucoup trop longue, consommant la limite de jetons, et la section réponse n'a jamais été générée en raison d'un raisonnement trop verbeux.
À cette étape, nous allons préparer le modèle et le tokenizer pour l'ajustement fin.
1. SFTTrainer n'accepte pas directement un tokenizer. Nous le convertirons donc en « data collator » via la classe DataCollatorForLanguageModeling de la bibliothèque transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Nous utiliserons LoRA (Low-Rank Adaptation) pour ajuster le modèle. LoRA ne modifie qu'un petit sous-ensemble de paramètres, ce qui est très économe en mémoire et plus rapide qu'un ajustement complet.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Les TrainingArguments nous permettent de configurer le processus d'ajustement fin, et le SFTTrainer simplifie l'ensemble en intégrant modèle, jeu de données, « data collator », arguments d'entraînement et configuration LoRA dans un flux unique.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Avant de démarrer l'entraînement, il est important de vider le cache et de supprimer les traces mémoire inutiles (RAM et VRAM) pour éviter les erreurs de type Out of Memory (OOM).
Une fois la mémoire nettoyée, nous pouvons lancer l'entraînement avec le SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
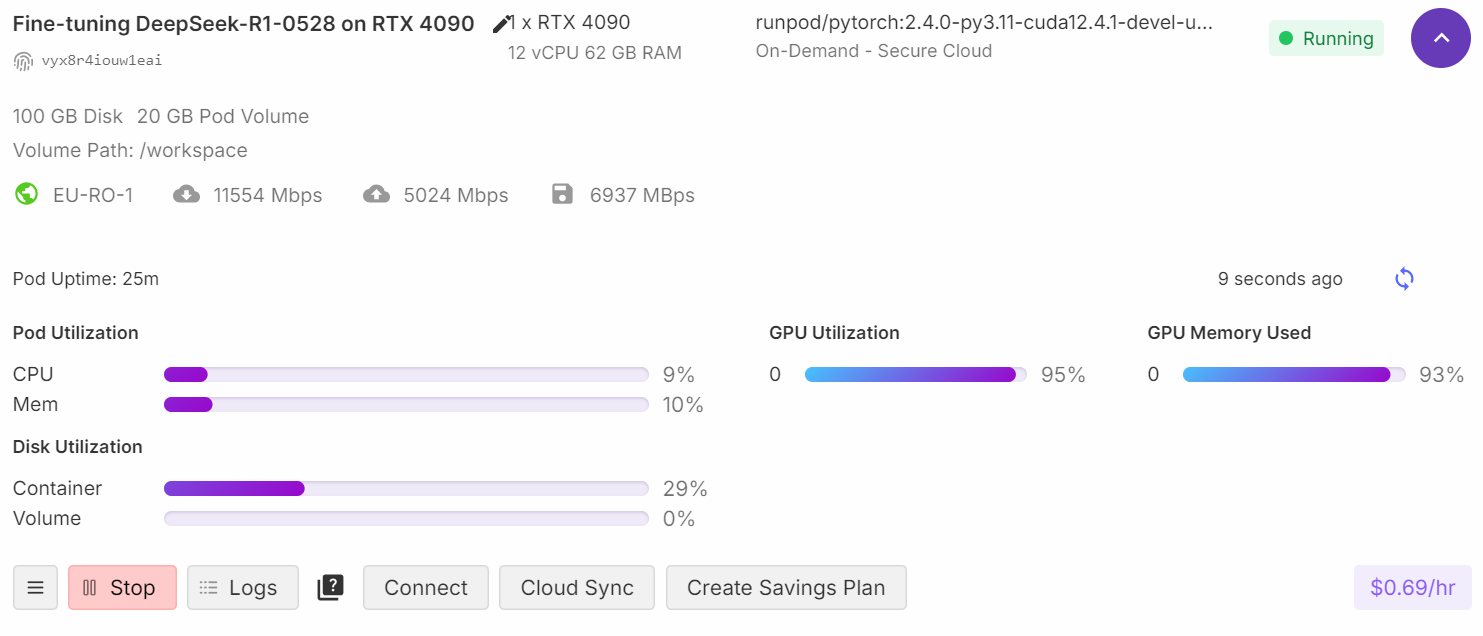
Pendant l'entraînement, vous pouvez surveiller le GPU depuis votre tableau de bord RunPod. Vous devriez observer une utilisation GPU proche de 100 %, signe que l'entraînement s'effectue bien sur le GPU (et non sur le CPU).
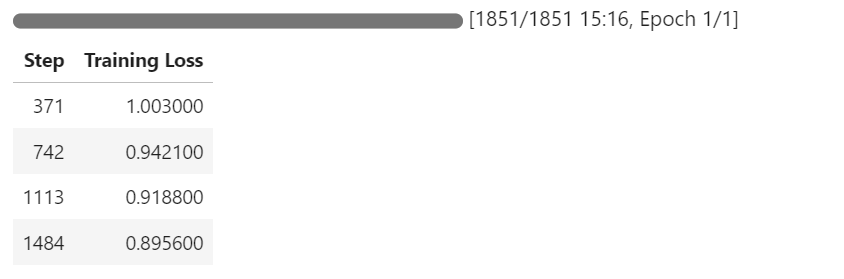
Au fil des itérations, vous devriez constater une baisse progressive de la perte d'entraînement, signe que le modèle apprend et s'ajuste correctement.
Après l'ajustement, nous testerons le modèle avec la même 11e question du jeu de données. Cela permet de comparer avec le modèle de base et d'évaluer les gains obtenus.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
La réponse du modèle ajusté montre des améliorations nettes :
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Pour aller plus loin dans l'évaluation, nous testerons le modèle sur un autre échantillon du jeu de données et observerons les résultats.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Le modèle ajusté réussit parfaitement sur cet exemple :
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>L'étape suivante consiste à enregistrer le modèle ajusté finement et à le pousser sur le Hugging Face Hub. Cela permet à d'autres d'y accéder pour l'inférence ou un ajustement complémentaire.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Une fois le push terminé, le modèle sera disponible sur le Hugging Face Hub : kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Après avoir enregistré le modèle et l'adaptateur sur le Hub Hugging Face, nous allons vérifier son bon fonctionnement en le rechargeant. Il s'agit de nettoyer la mémoire GPU, de charger le modèle de base et l'adaptateur LoRA, puis d'exécuter une inférence sur une invite d'exemple.
1. Nettoyez la mémoire GPU pour éviter d'éventuels problèmes d'Out of Memory (OOM) et repartir d'un environnement propre.
del model
del trainer
torch.cuda.empty_cache()
2. Chargez le modèle de base et l'adaptateur LoRA ajusté depuis le Hugging Face Hub. Le modèle de base sera chargé en quantification 4 bits pour optimiser la mémoire, et l'adaptateur LoRA sera fusionné avec lui.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Testez maintenant le modèle ajusté en lui fournissant une invite d'exemple. L'invite sera tokenisée, passée au modèle, puis la réponse sera décodée.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Le modèle ajusté produit une réponse similaire au jeu de données, ce qui confirme que le modèle et l'adaptateur ont été chargés correctement.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Si vous rencontrez des problèmes lors de l'exécution du code ci-dessus, reportez-vous au notebook fine-tuning-Deepseek-new-R1.ipynb. Ce notebook a été testé à plusieurs reprises et devrait fonctionner tel quel sur RunPod ou un environnement similaire.
Le modèle DeepSeek-R1-0528 fait partie des meilleurs modèles open source de raisonnement disponibles aujourd'hui. Sa capacité à réaliser des tâches de raisonnement complexes, alliée à son caractère open source, en fait un choix de premier plan pour les développeurs et les chercheurs. Même si le modèle ajusté livre déjà d'excellents résultats, plusieurs leviers permettent d'améliorer encore l'ajustement fin :
Par ailleurs, ce guide peut servir à ajuster le modèle DeepSeek R1 sur tout jeu de données de raisonnement, y compris des jeux synthétiques créés avec d'autres modèles comme o3 d'OpenAI. Vous pouvez aussi mettre en pratique certaines des techniques présentées ici dans notre cours Fine-Tuning With Llama 3. Si vous souhaitez ajuster d'autres modèles sur des jeux de données médicaux, consultez notre tutoriel : Fine-Tuning MedGemma on a Brain MRI Dataset.
Les meilleurs cours DataCamp
Cours
Cours
Cours